
Iccv Poster Villa Video Reasoning Segmentation With Large Language Model

ICCV Poster ViLLa: Video Reasoning Segmentation with Large Language Model

ViLLa: Video Reasoning Segmentation with Large Language Model | AI ...
ViLLa: Video Reasoning Segmentation with Large Language Model
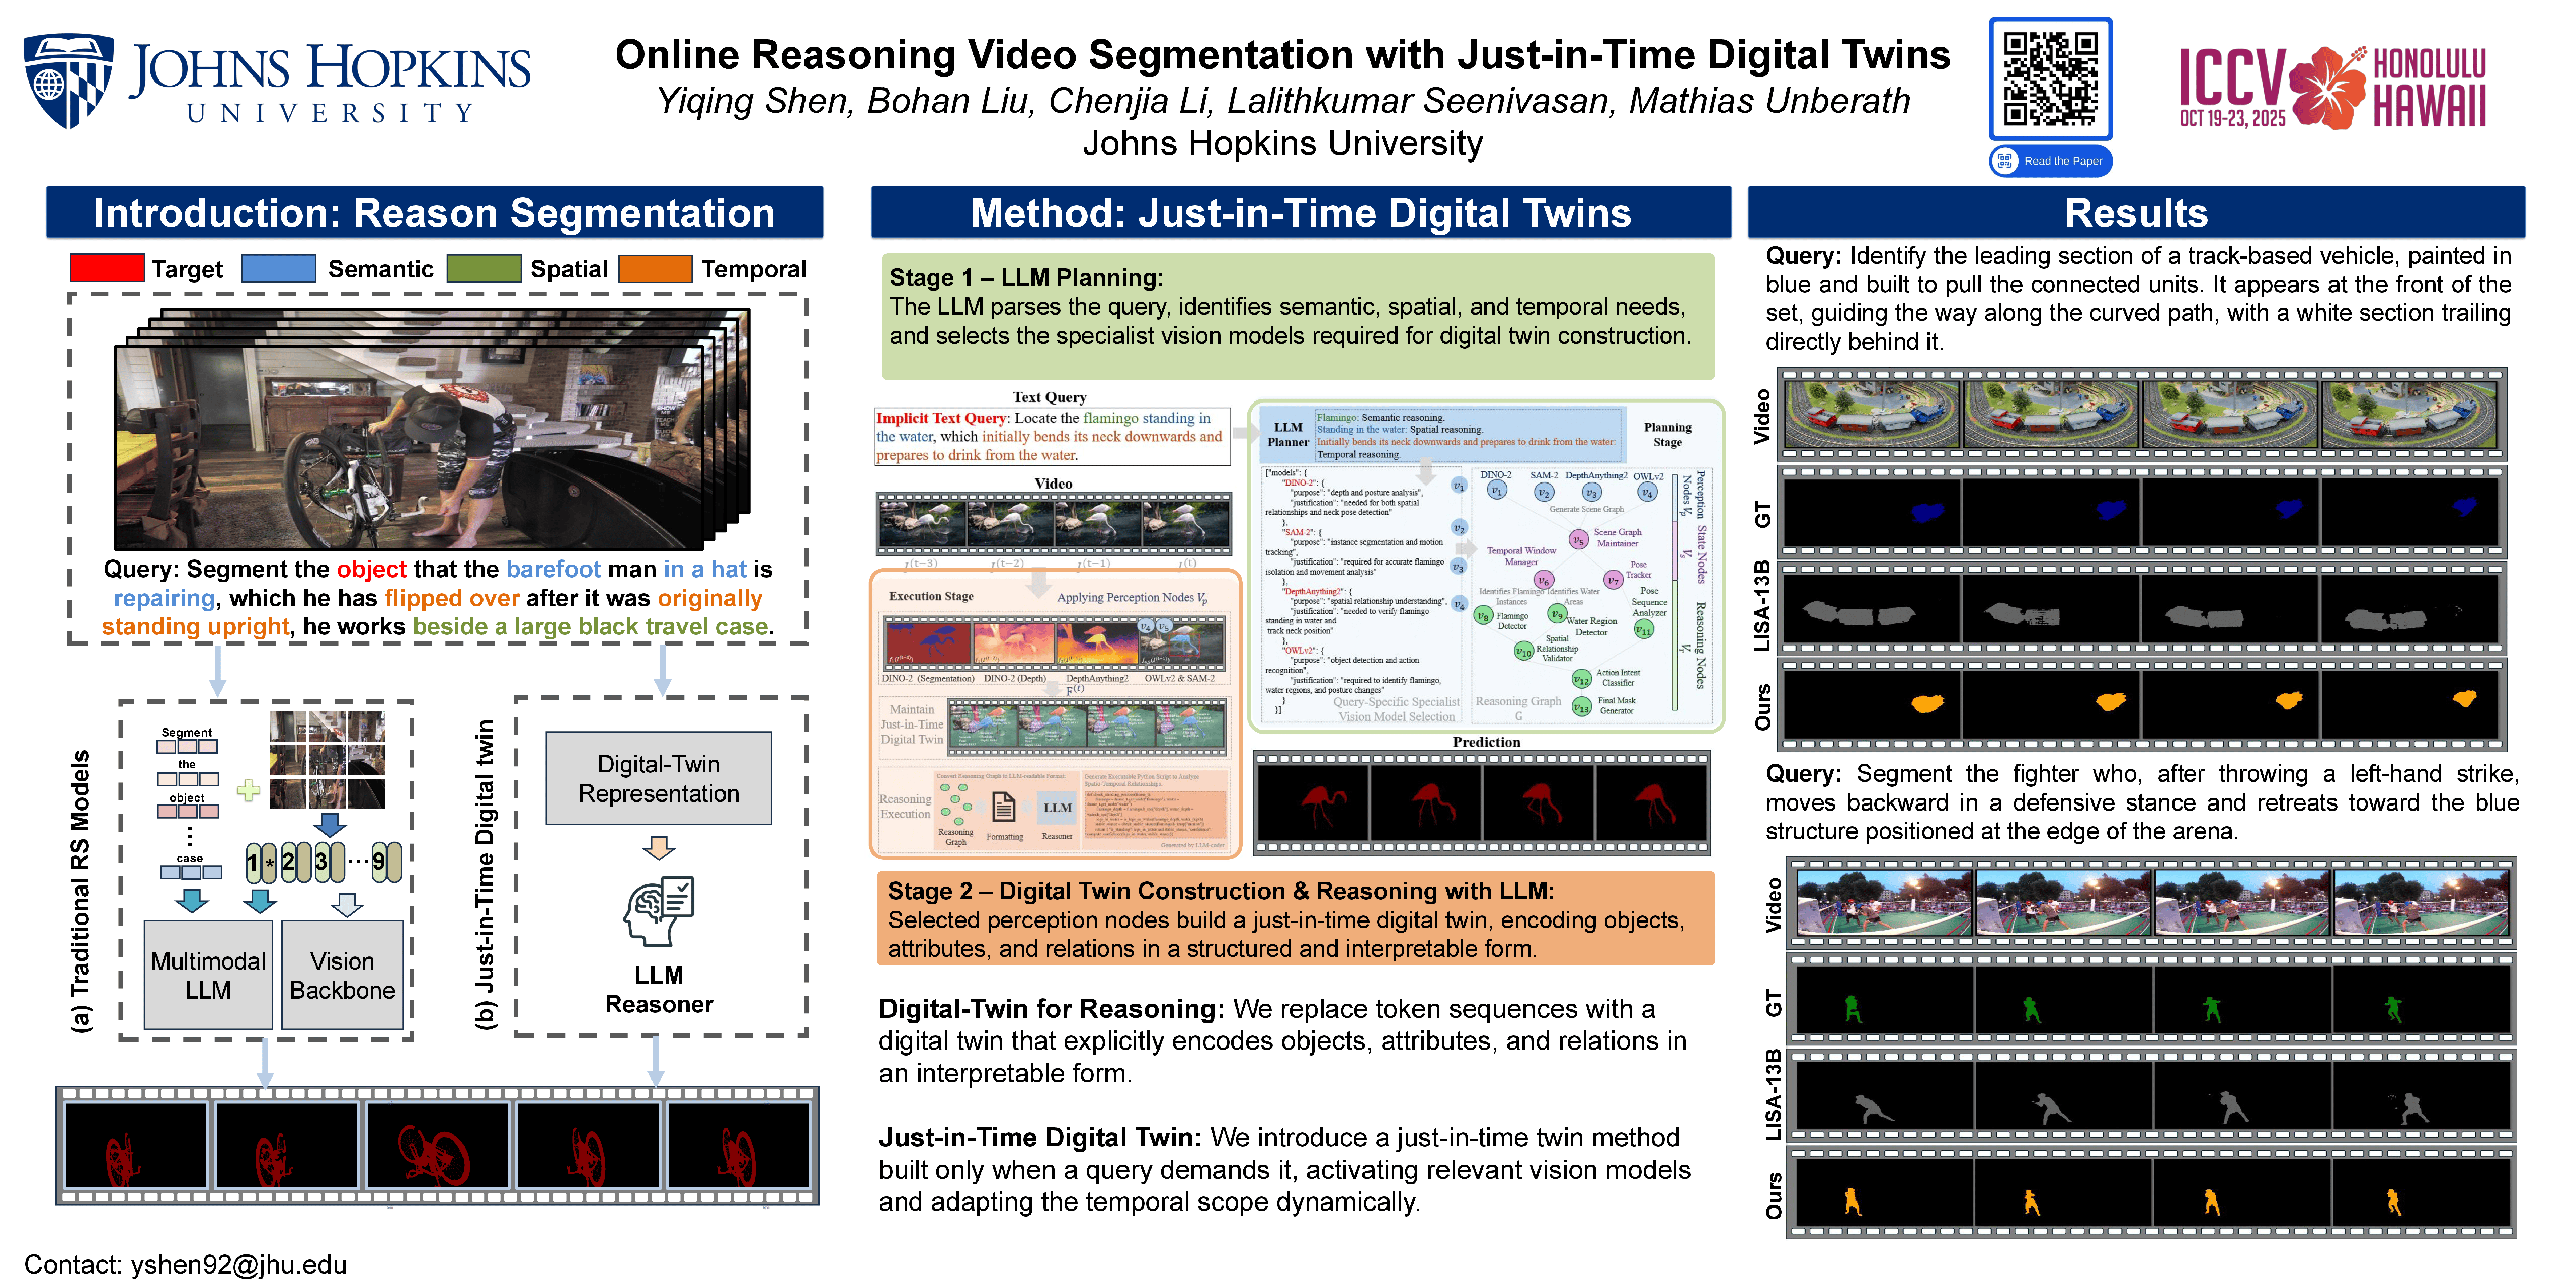
ICCV Poster Online Reasoning Video Segmentation with Just-in-Time ...

ECCV Poster VISA: Reasoning Video Object Segmentation via Large ...
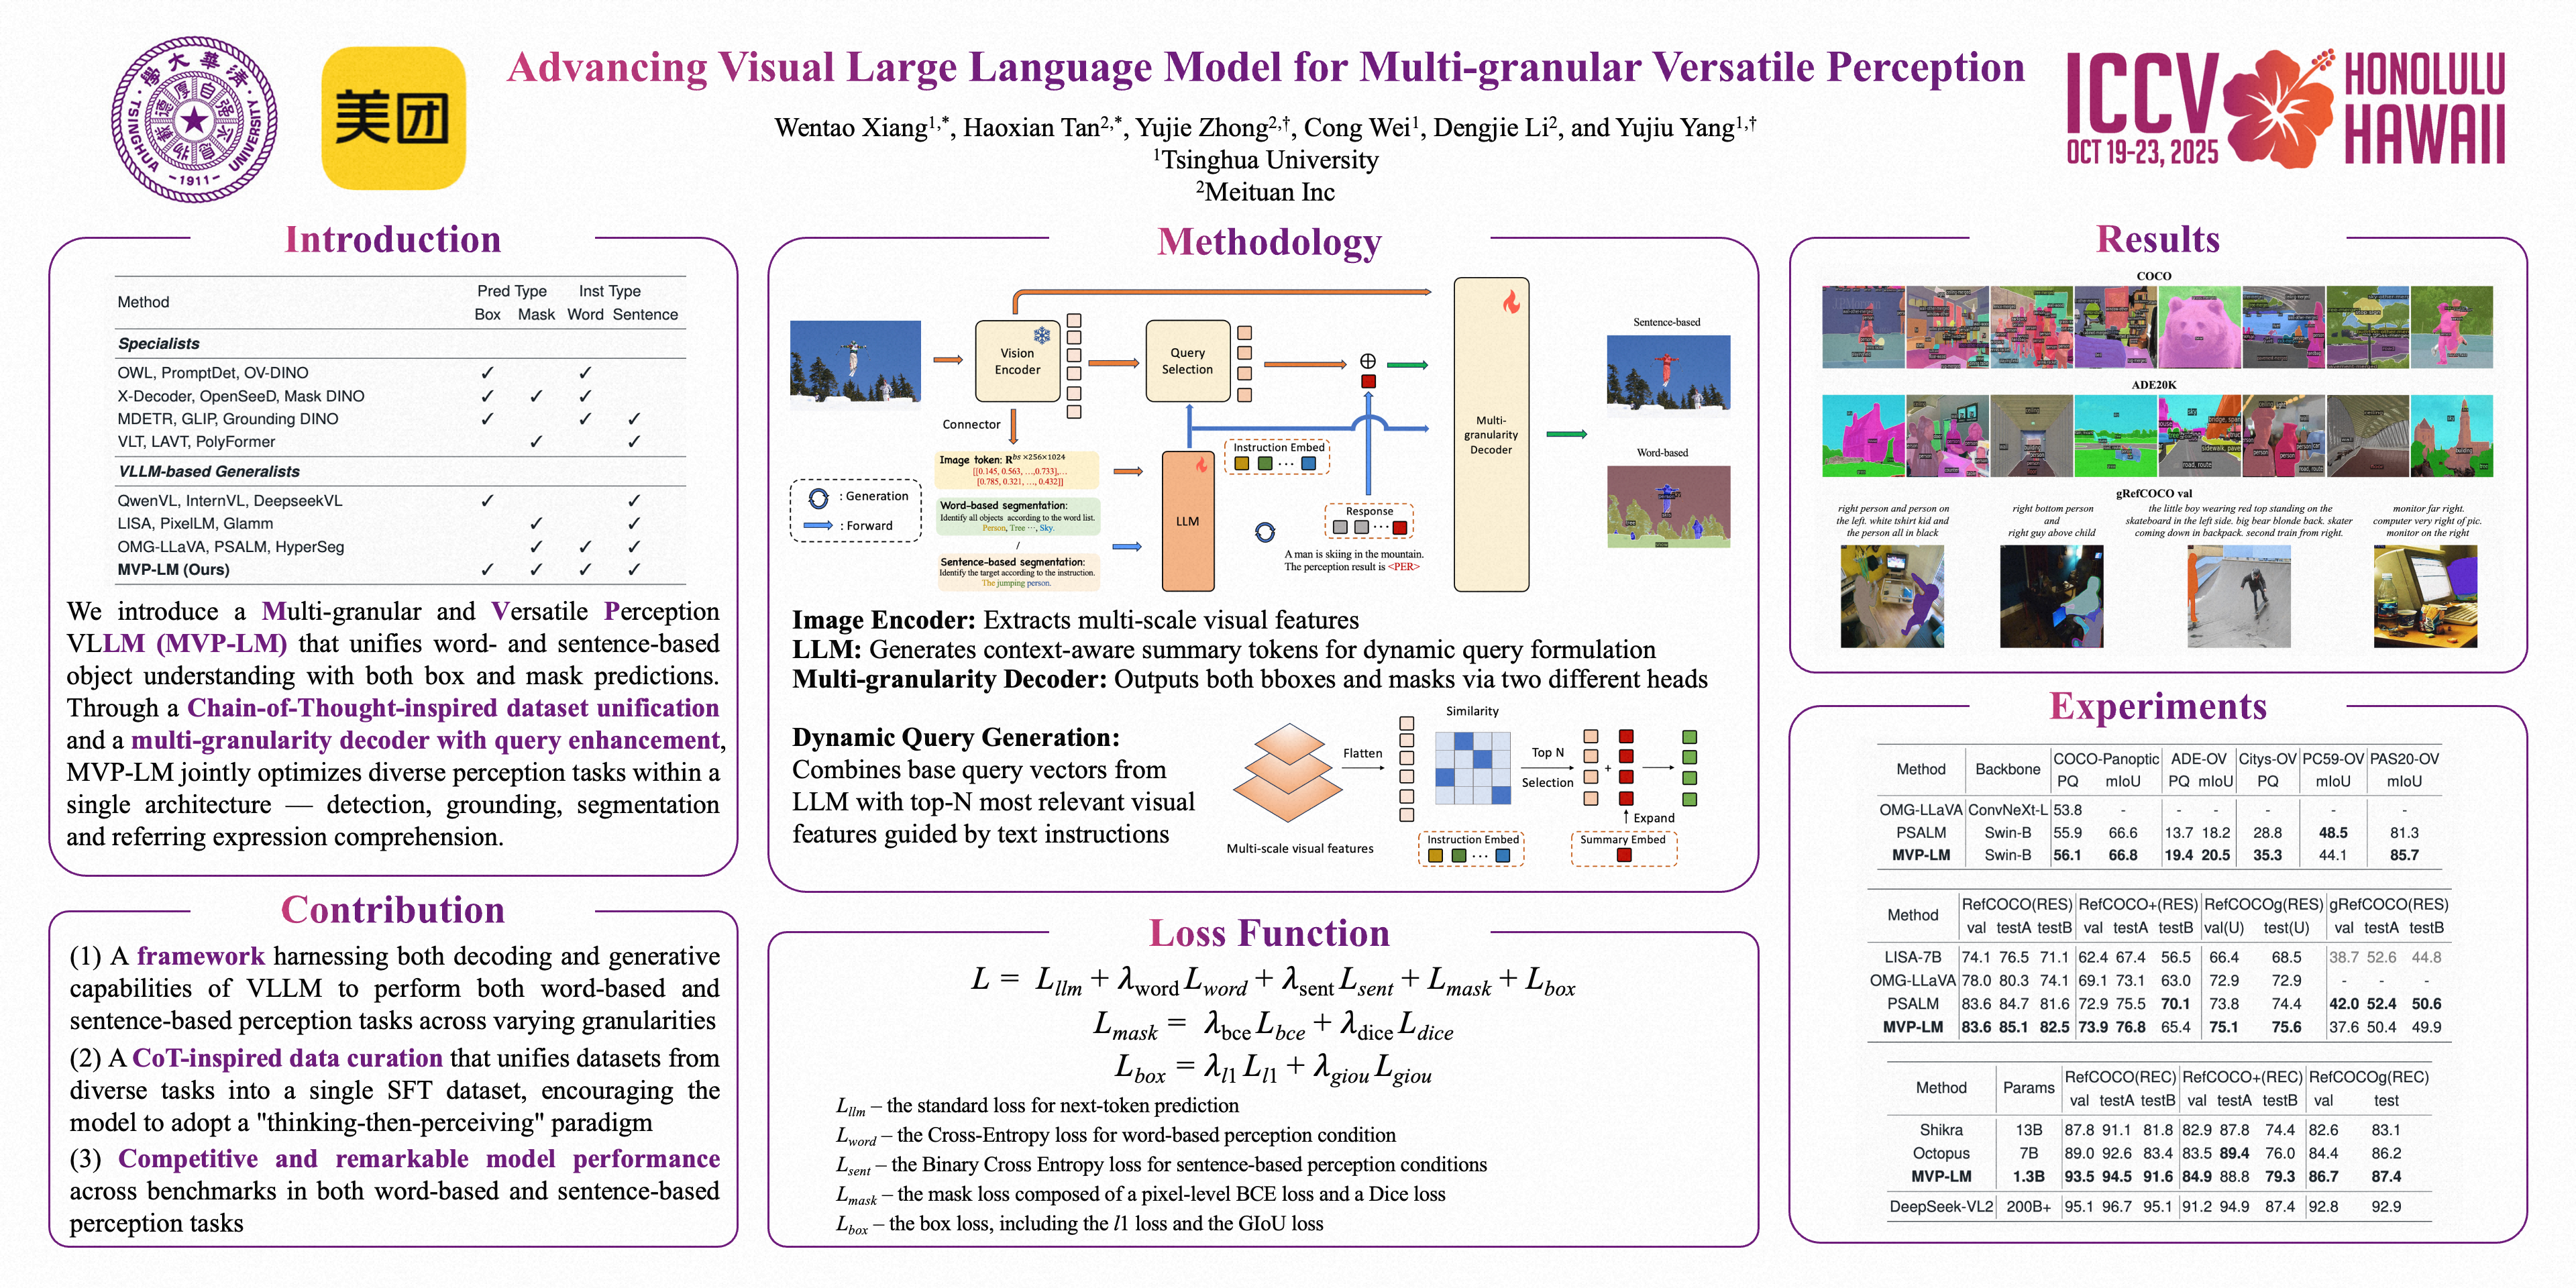
ICCV Poster Advancing Visual Large Language Model for Multi-granular ...
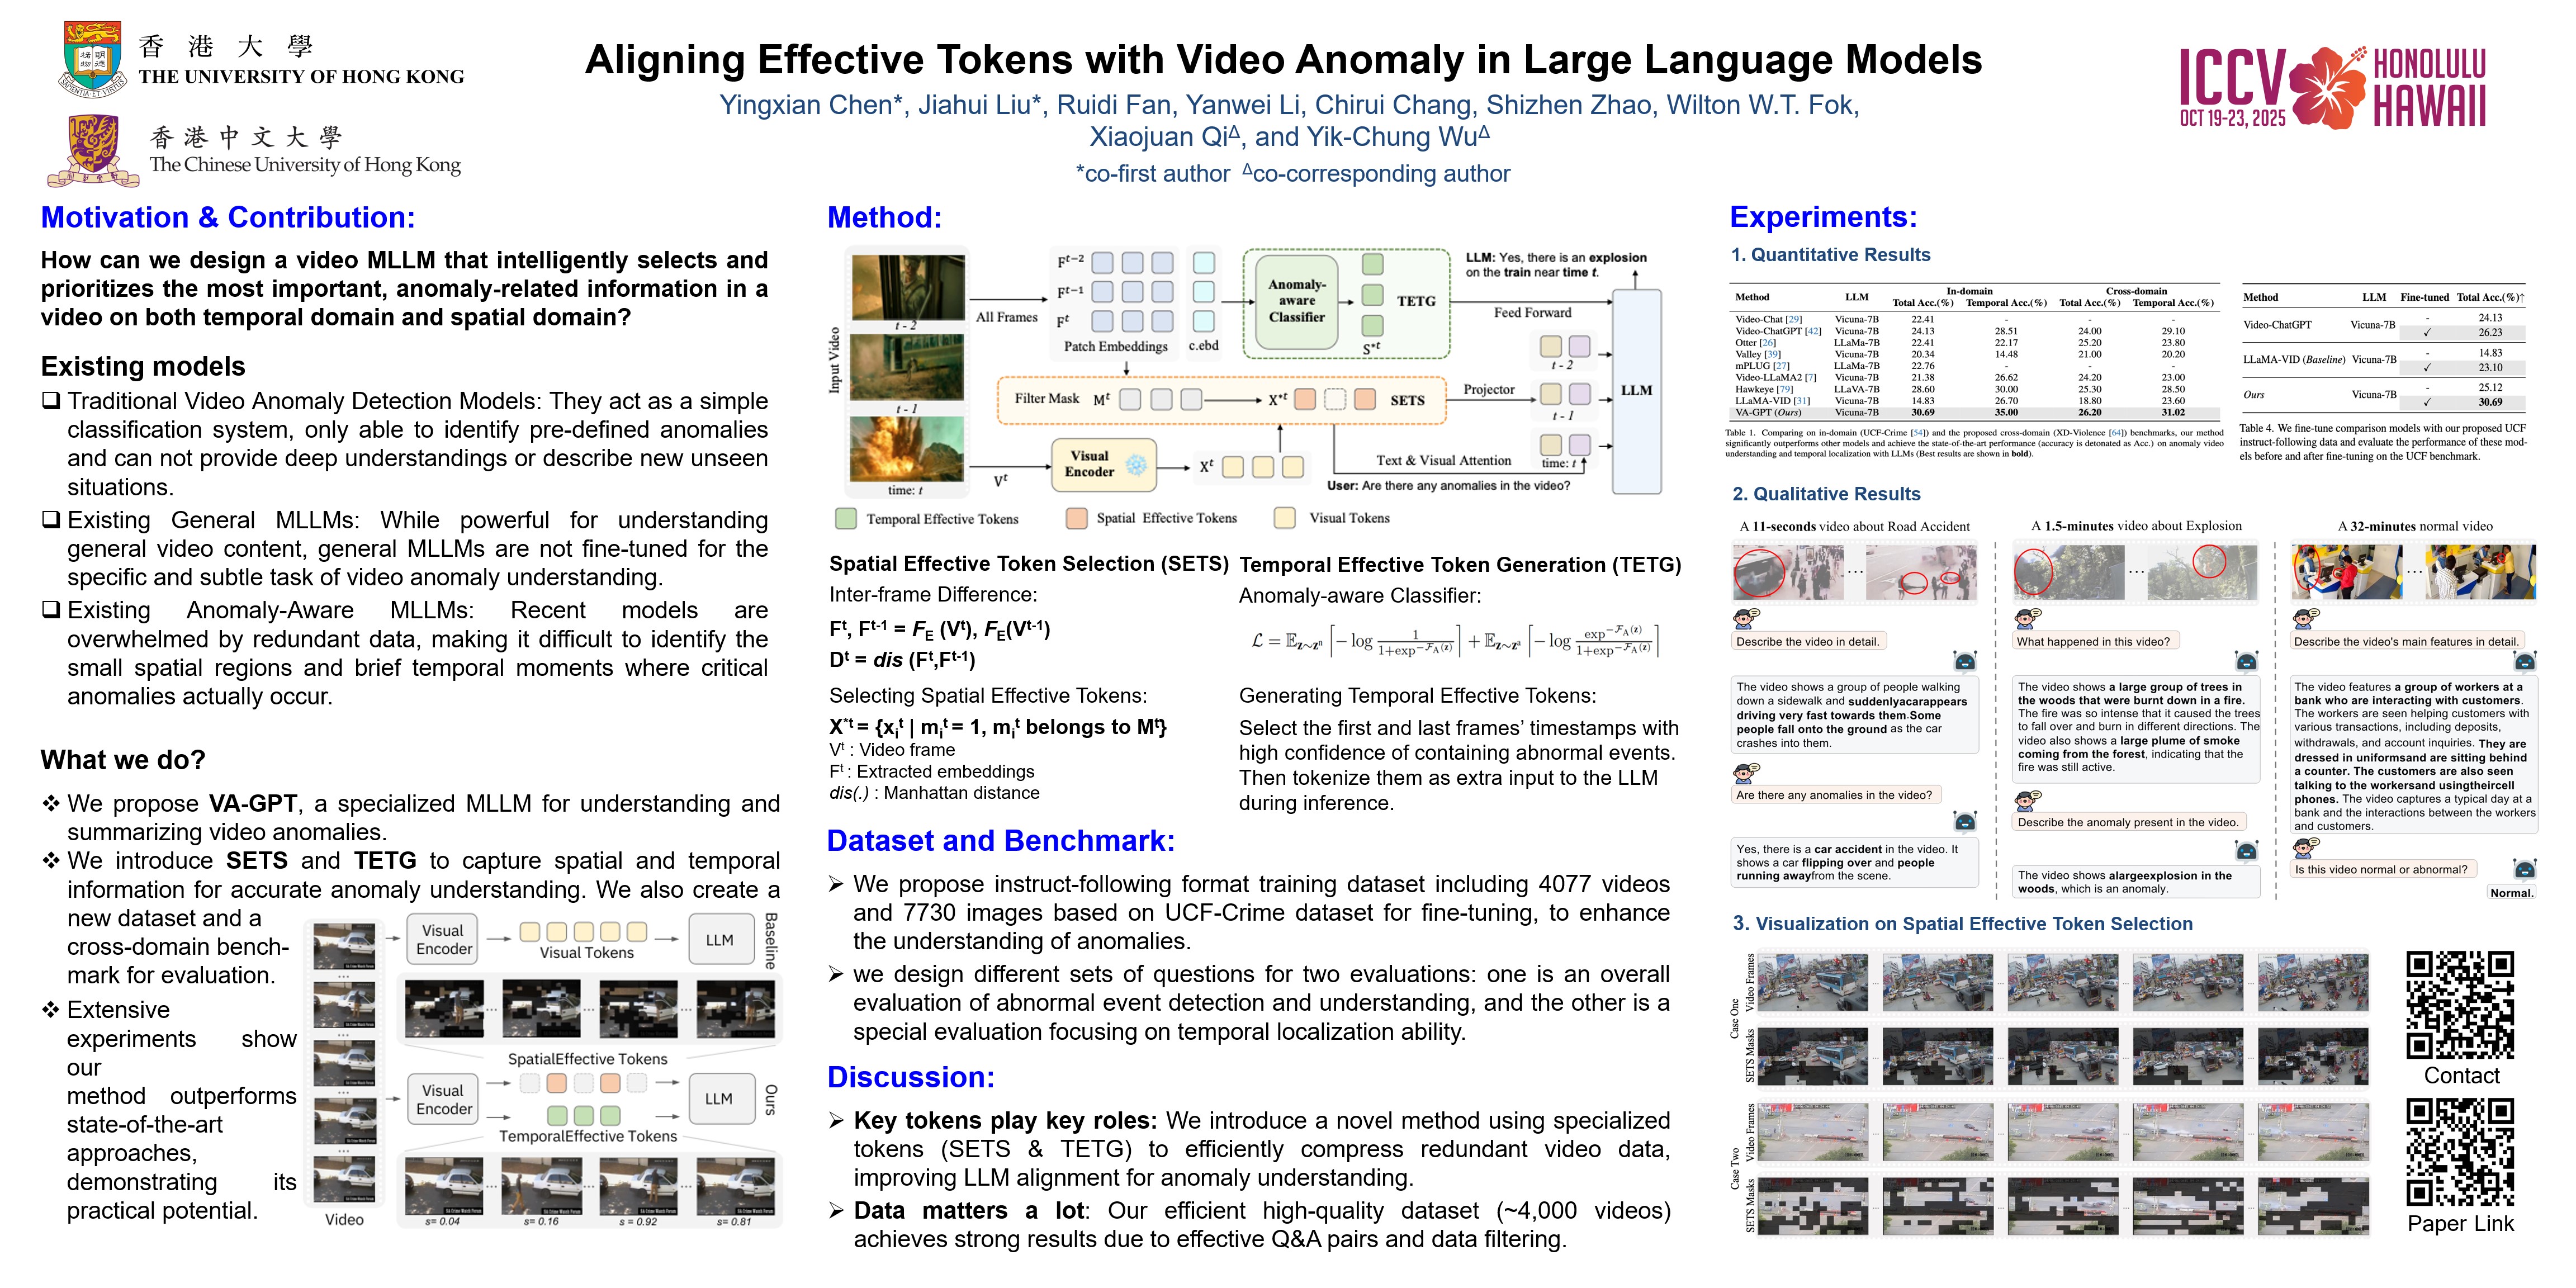
ICCV Poster Aligning Effective Tokens with Video Anomaly in Large ...

ECCV Poster Making Large Language Models Better Planners with Reasoning ...
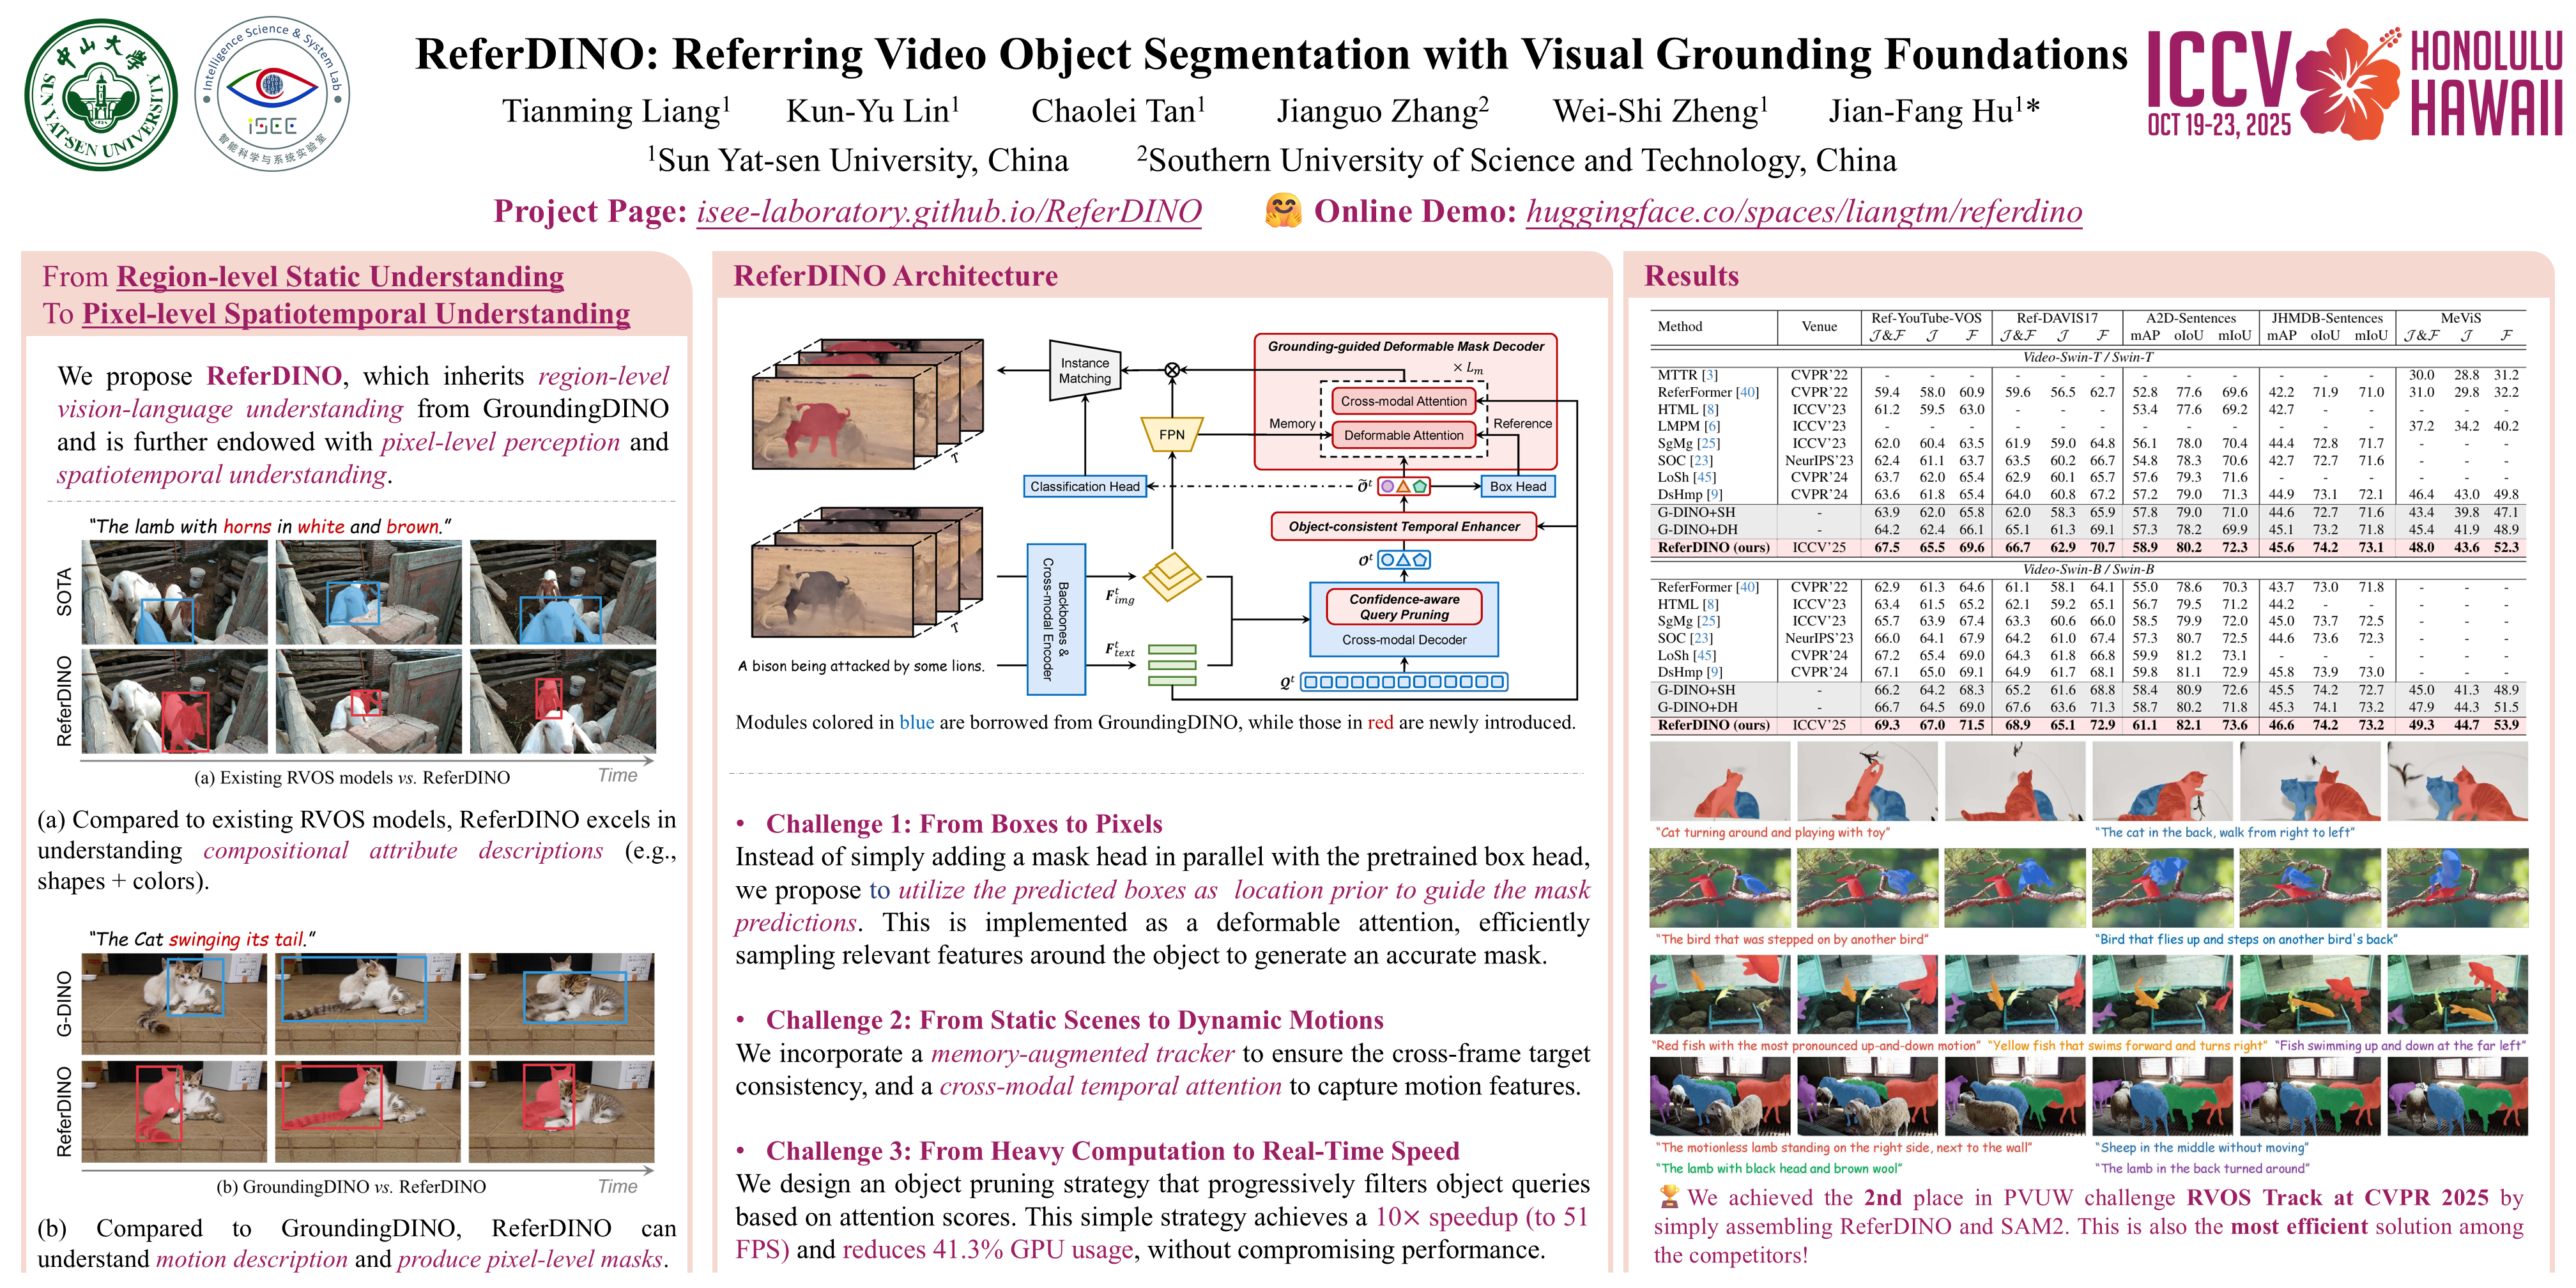
ICCV Poster ReferDINO: Referring Video Object Segmentation with Visual ...

(PDF) LISA: Reasoning Segmentation via Large Language Model
Advertisement Space (300x250)
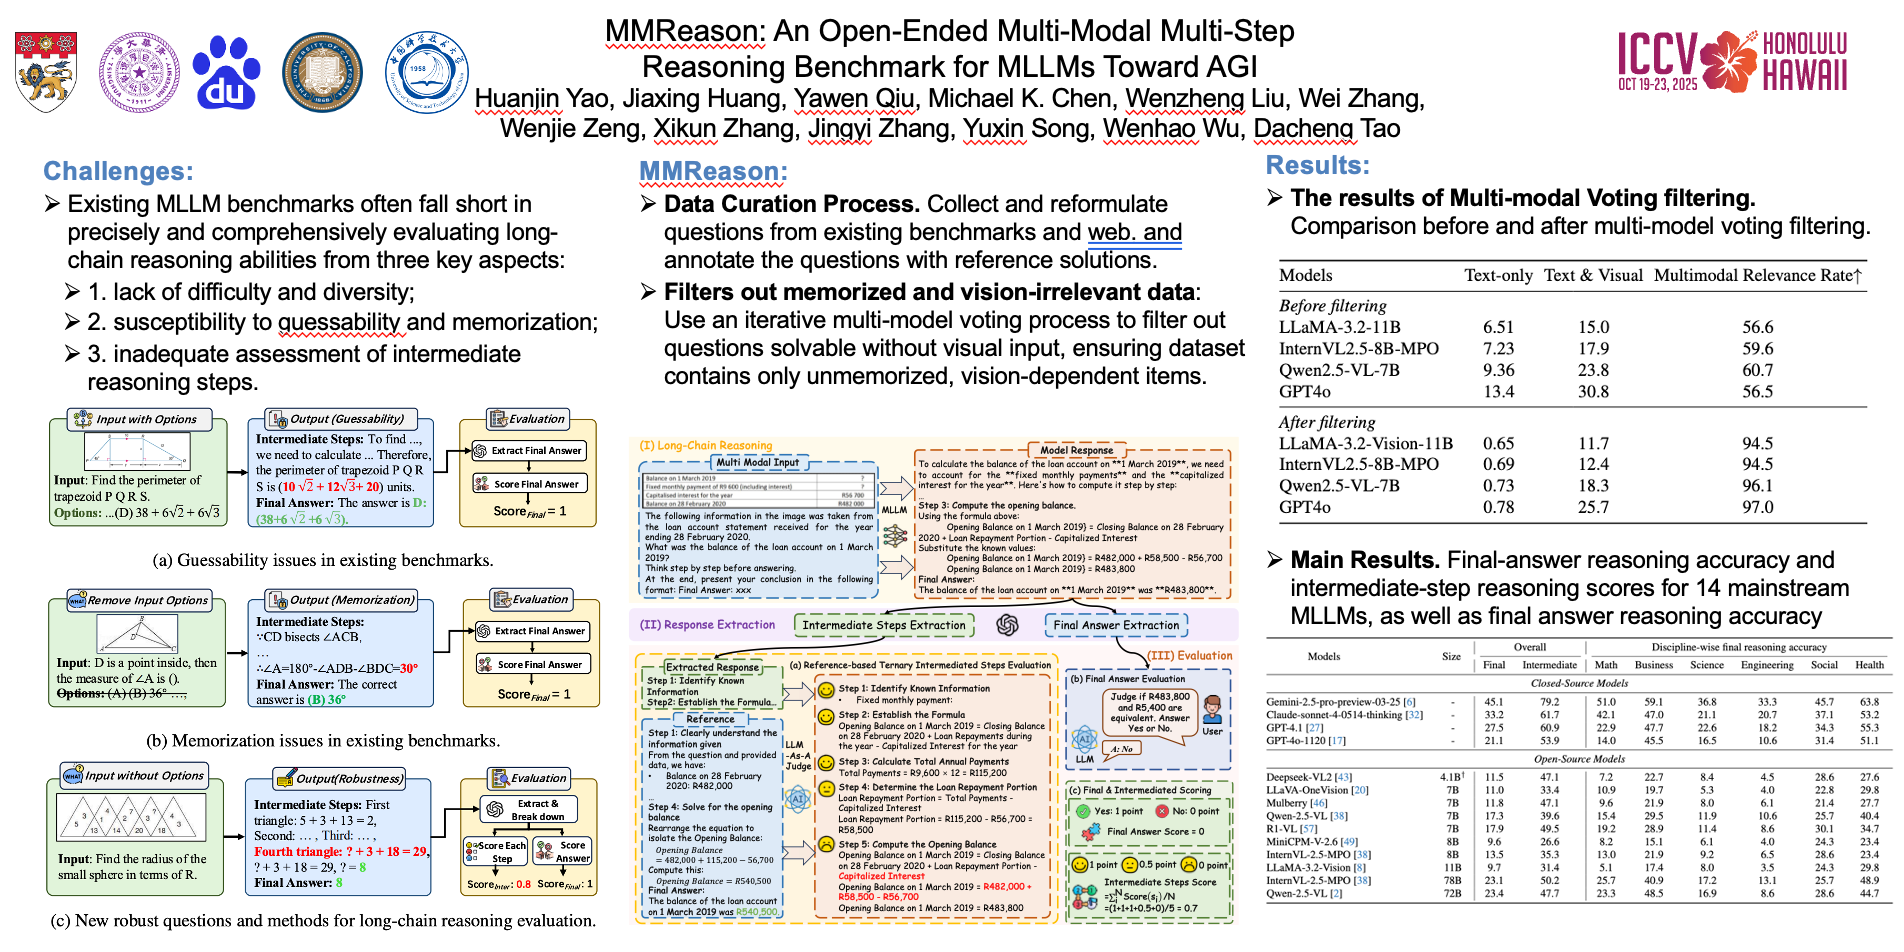
ICCV Poster R1-VL: Learning to Reason with Multimodal Large Language ...

Lai LISA Reasoning Segmentation Via Large Language Model CVPR 2024 ...
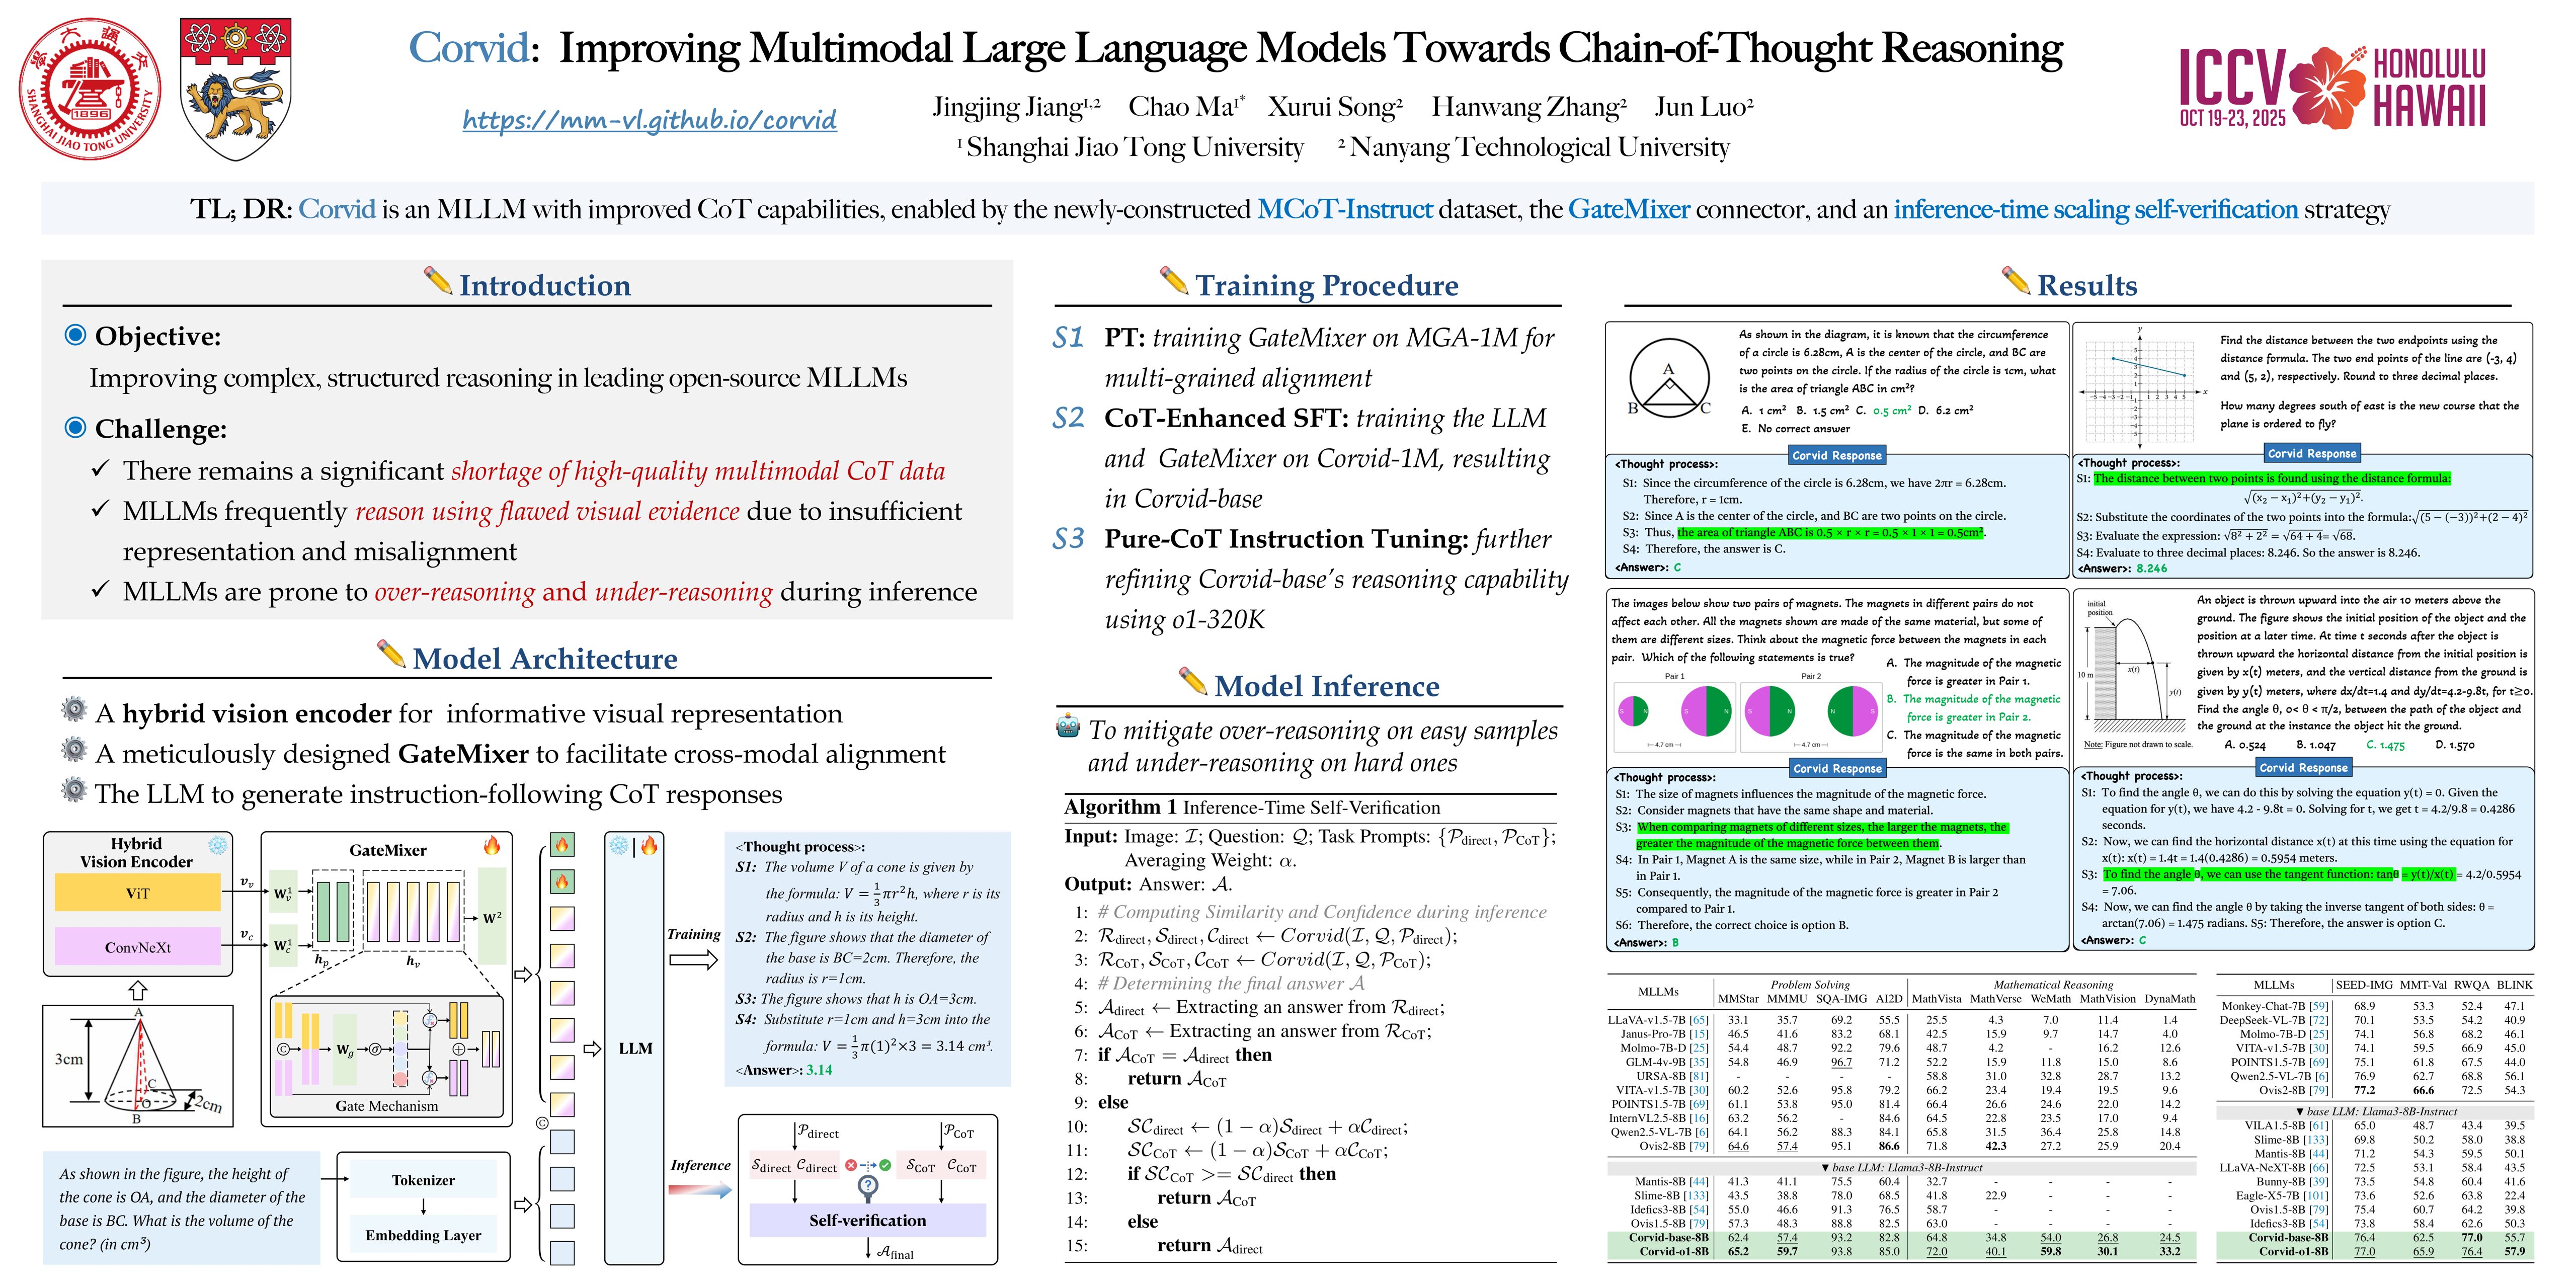
ICCV Poster Corvid: Improving Multimodal Large Language Models Towards ...
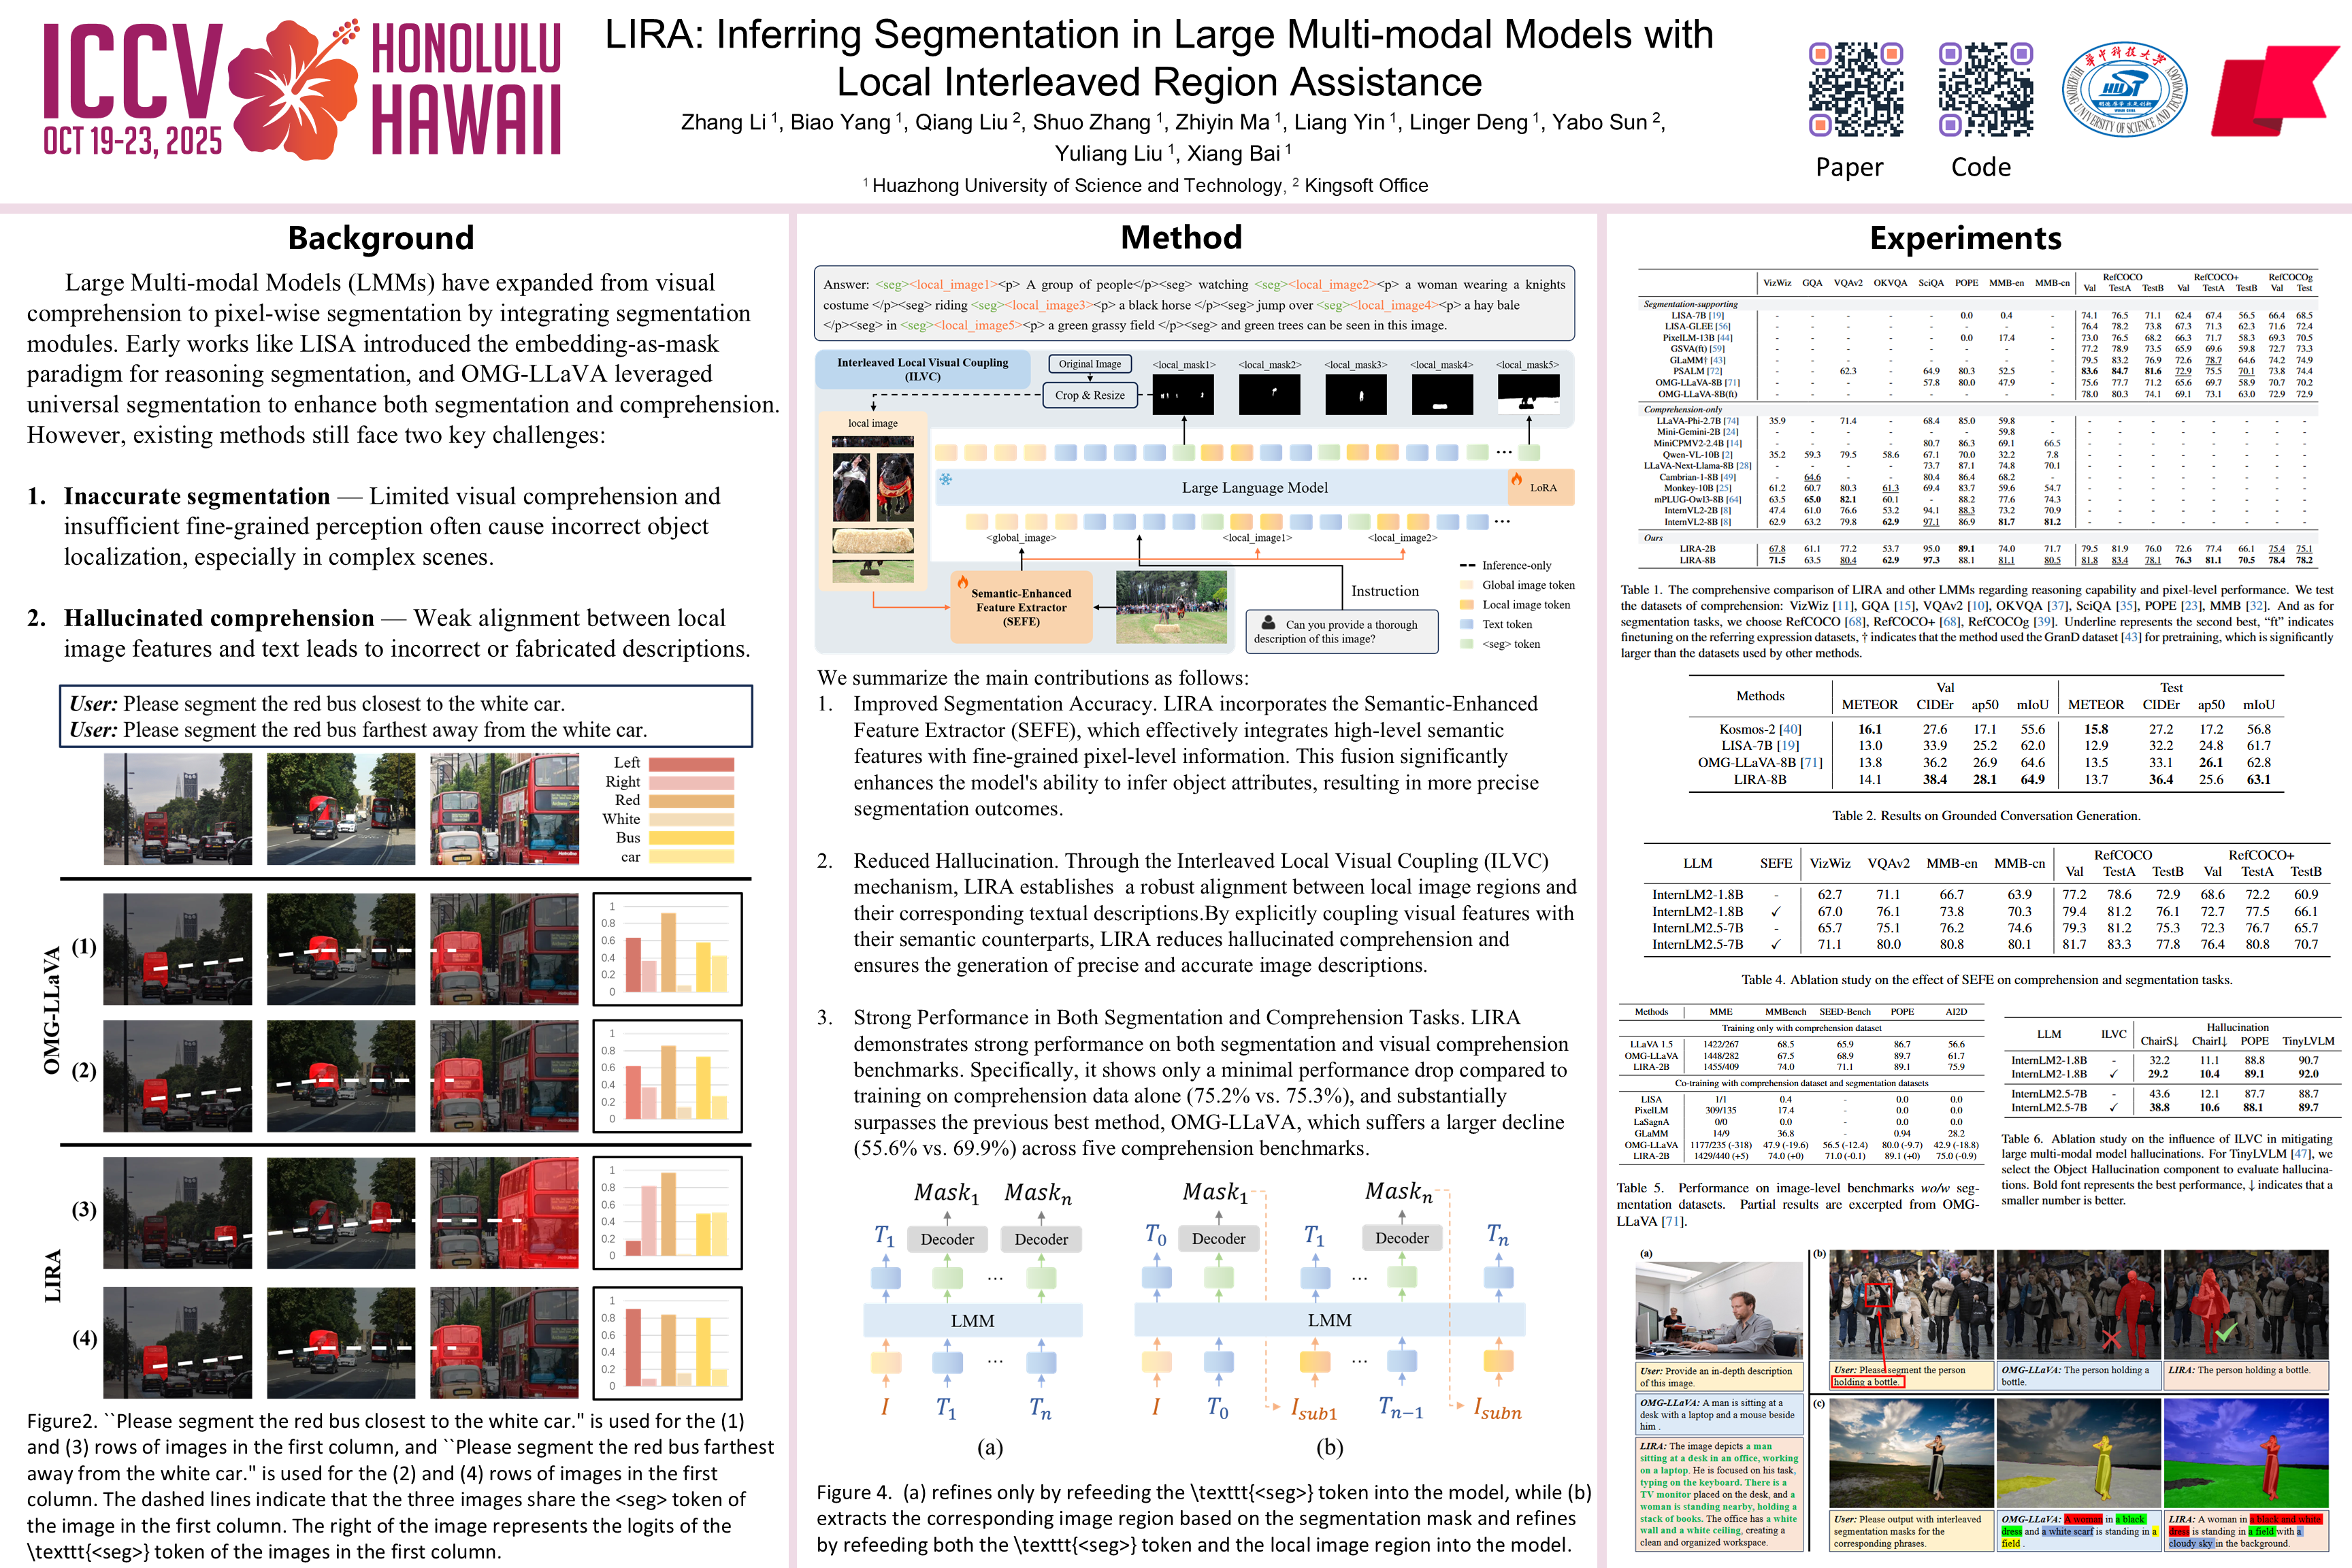
ICCV Poster LIRA: Inferring Segmentation in Large Multi-modal Models ...
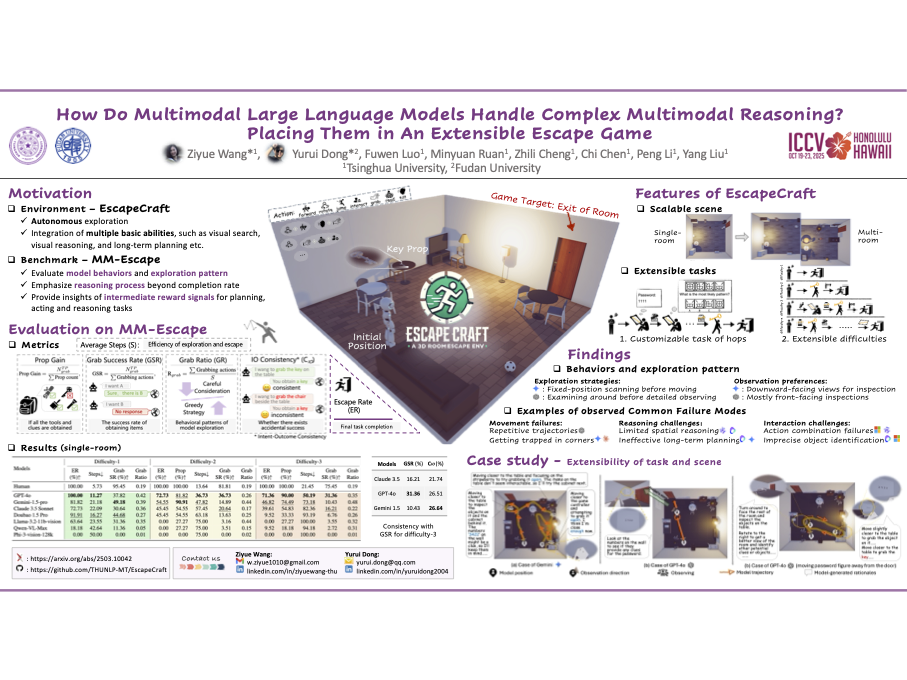
ICCV Poster How Do Multimodal Large Language Models Handle Complex ...
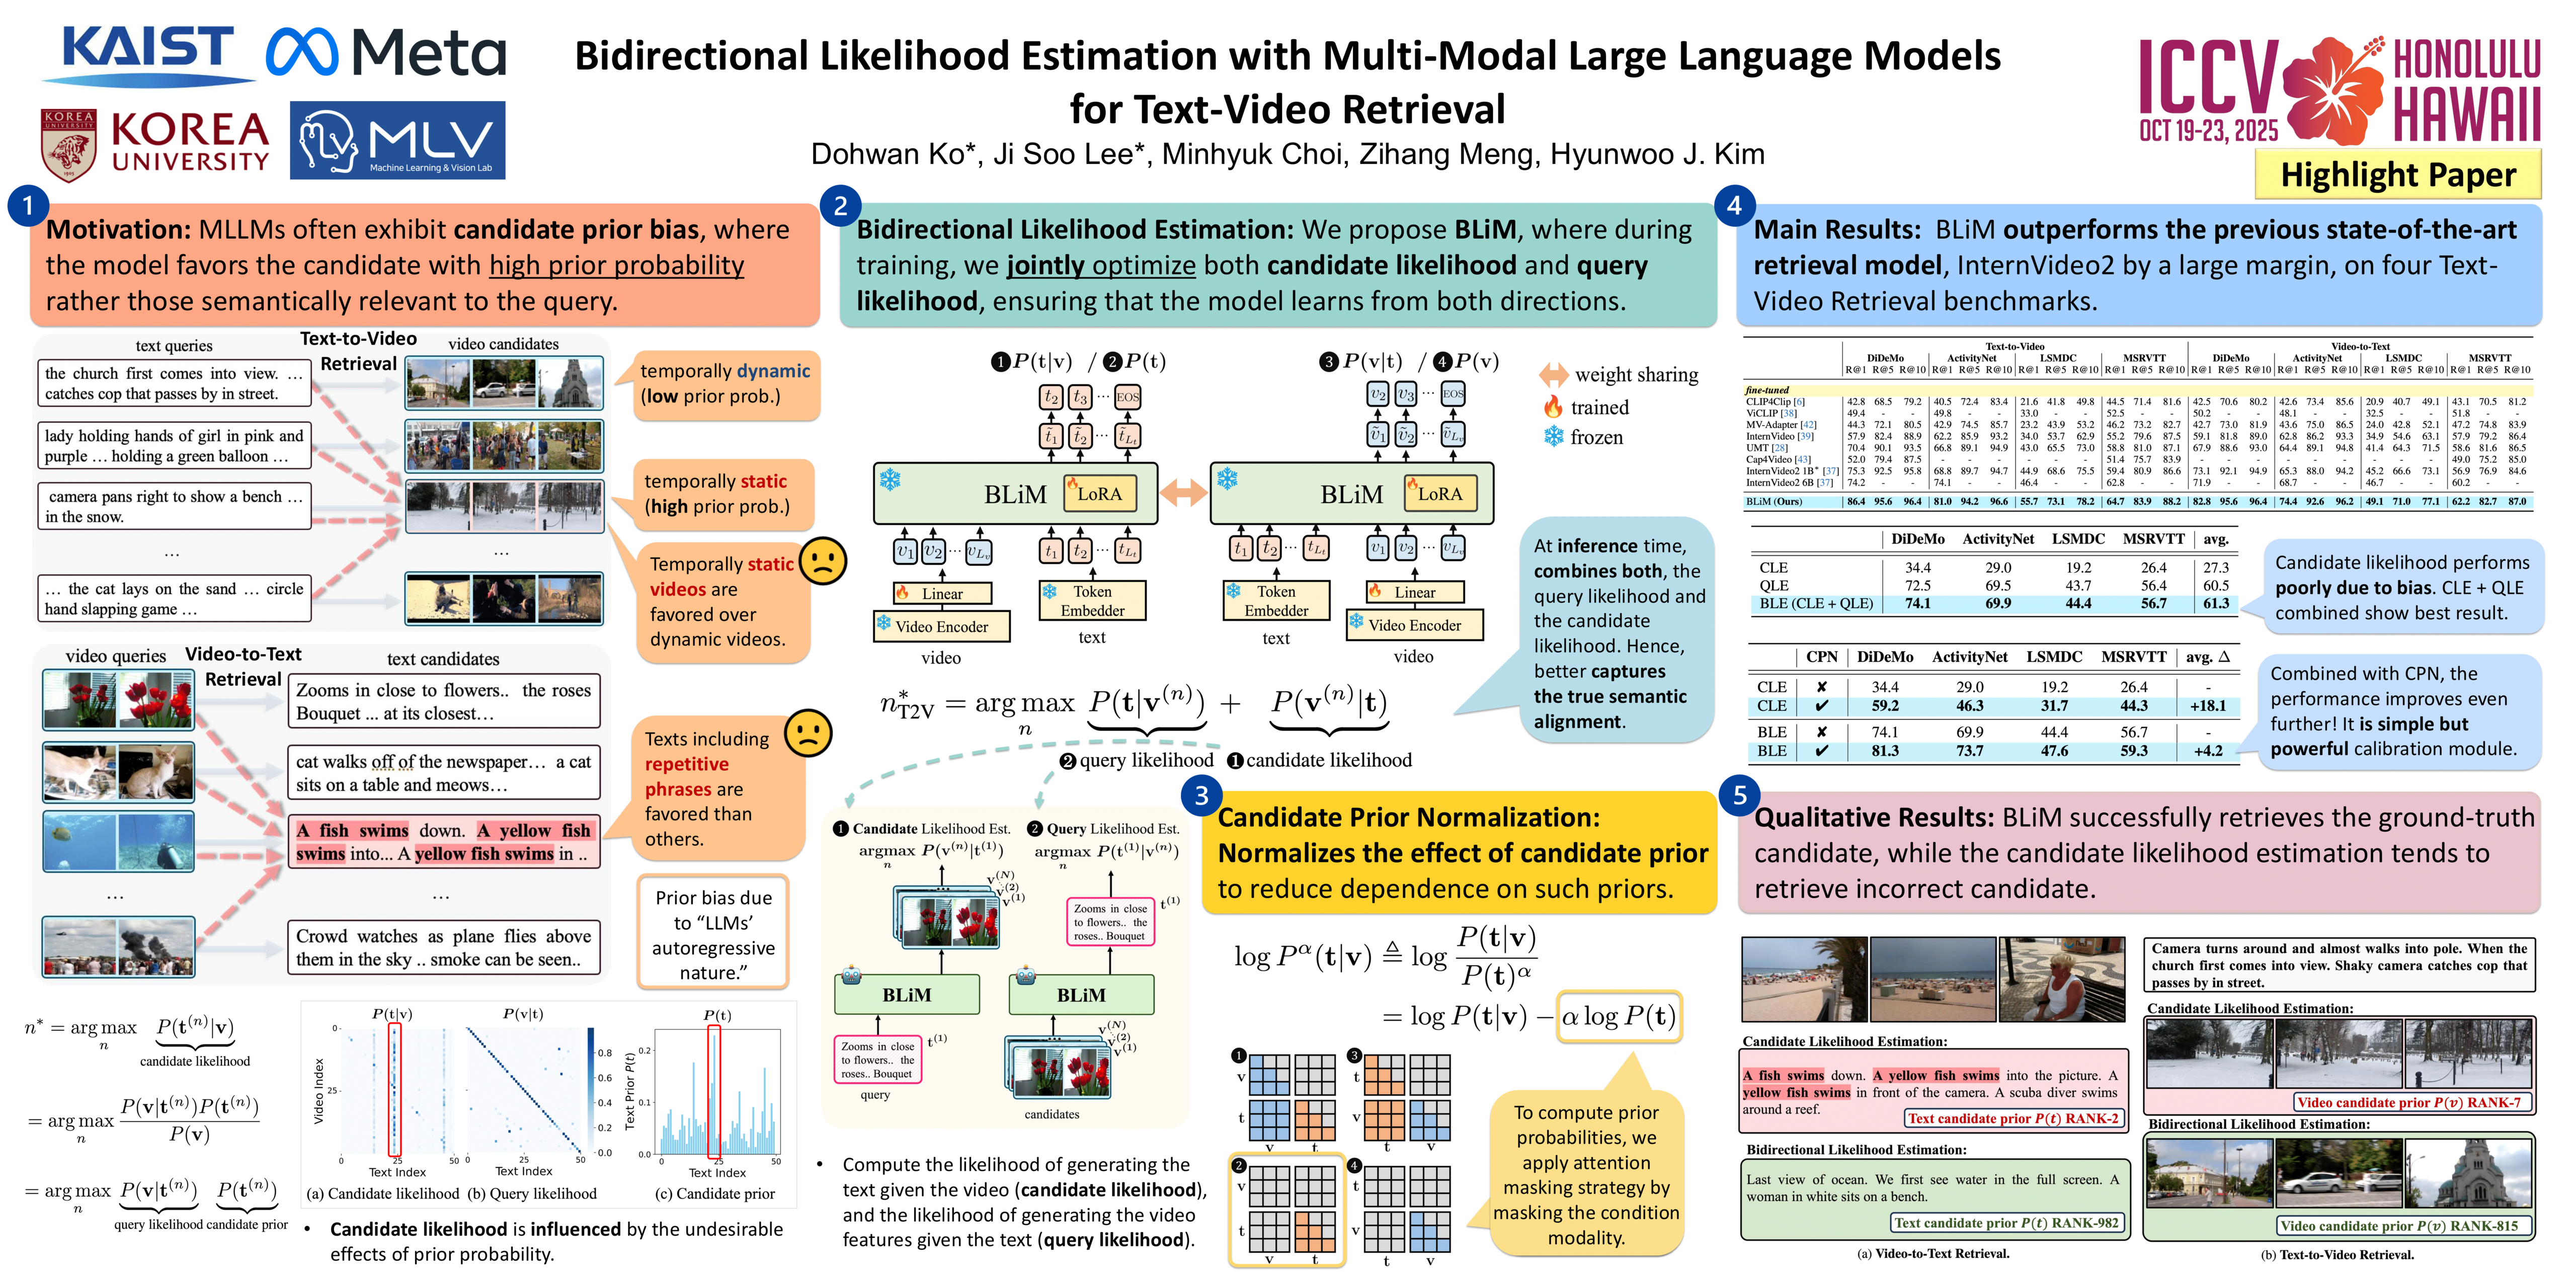
ICCV Poster Bidirectional Likelihood Estimation with Multi-Modal Large ...
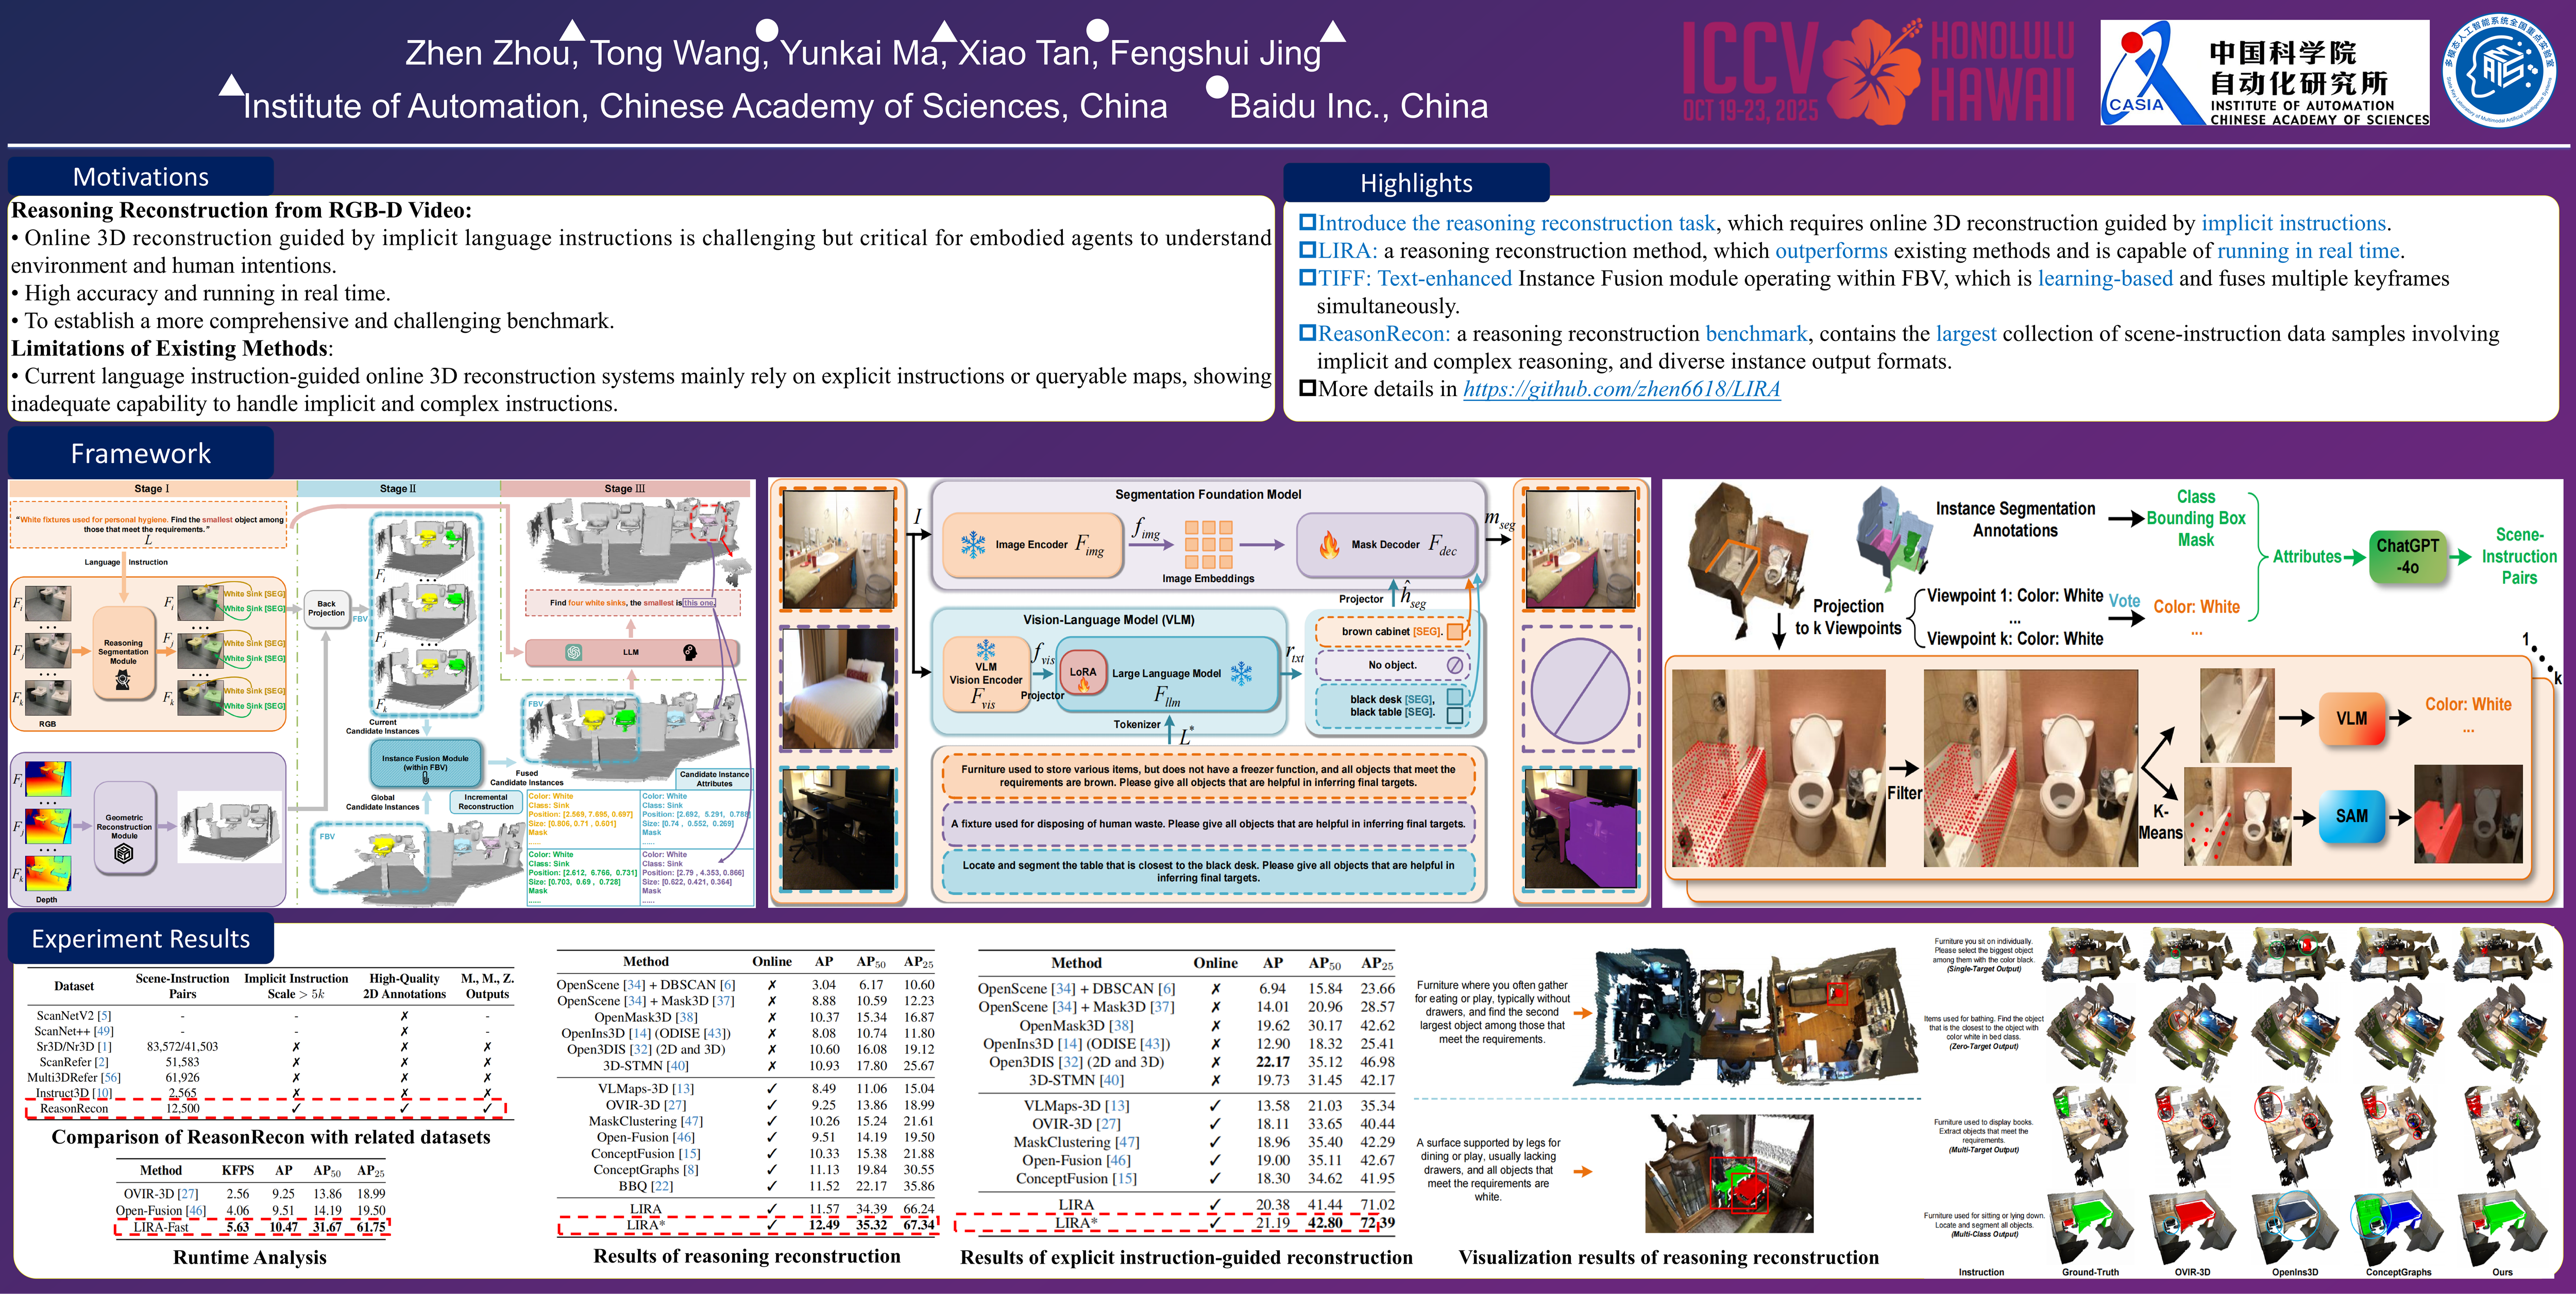
ICCV Poster LIRA: Reasoning Reconstruction via Multimodal Large ...
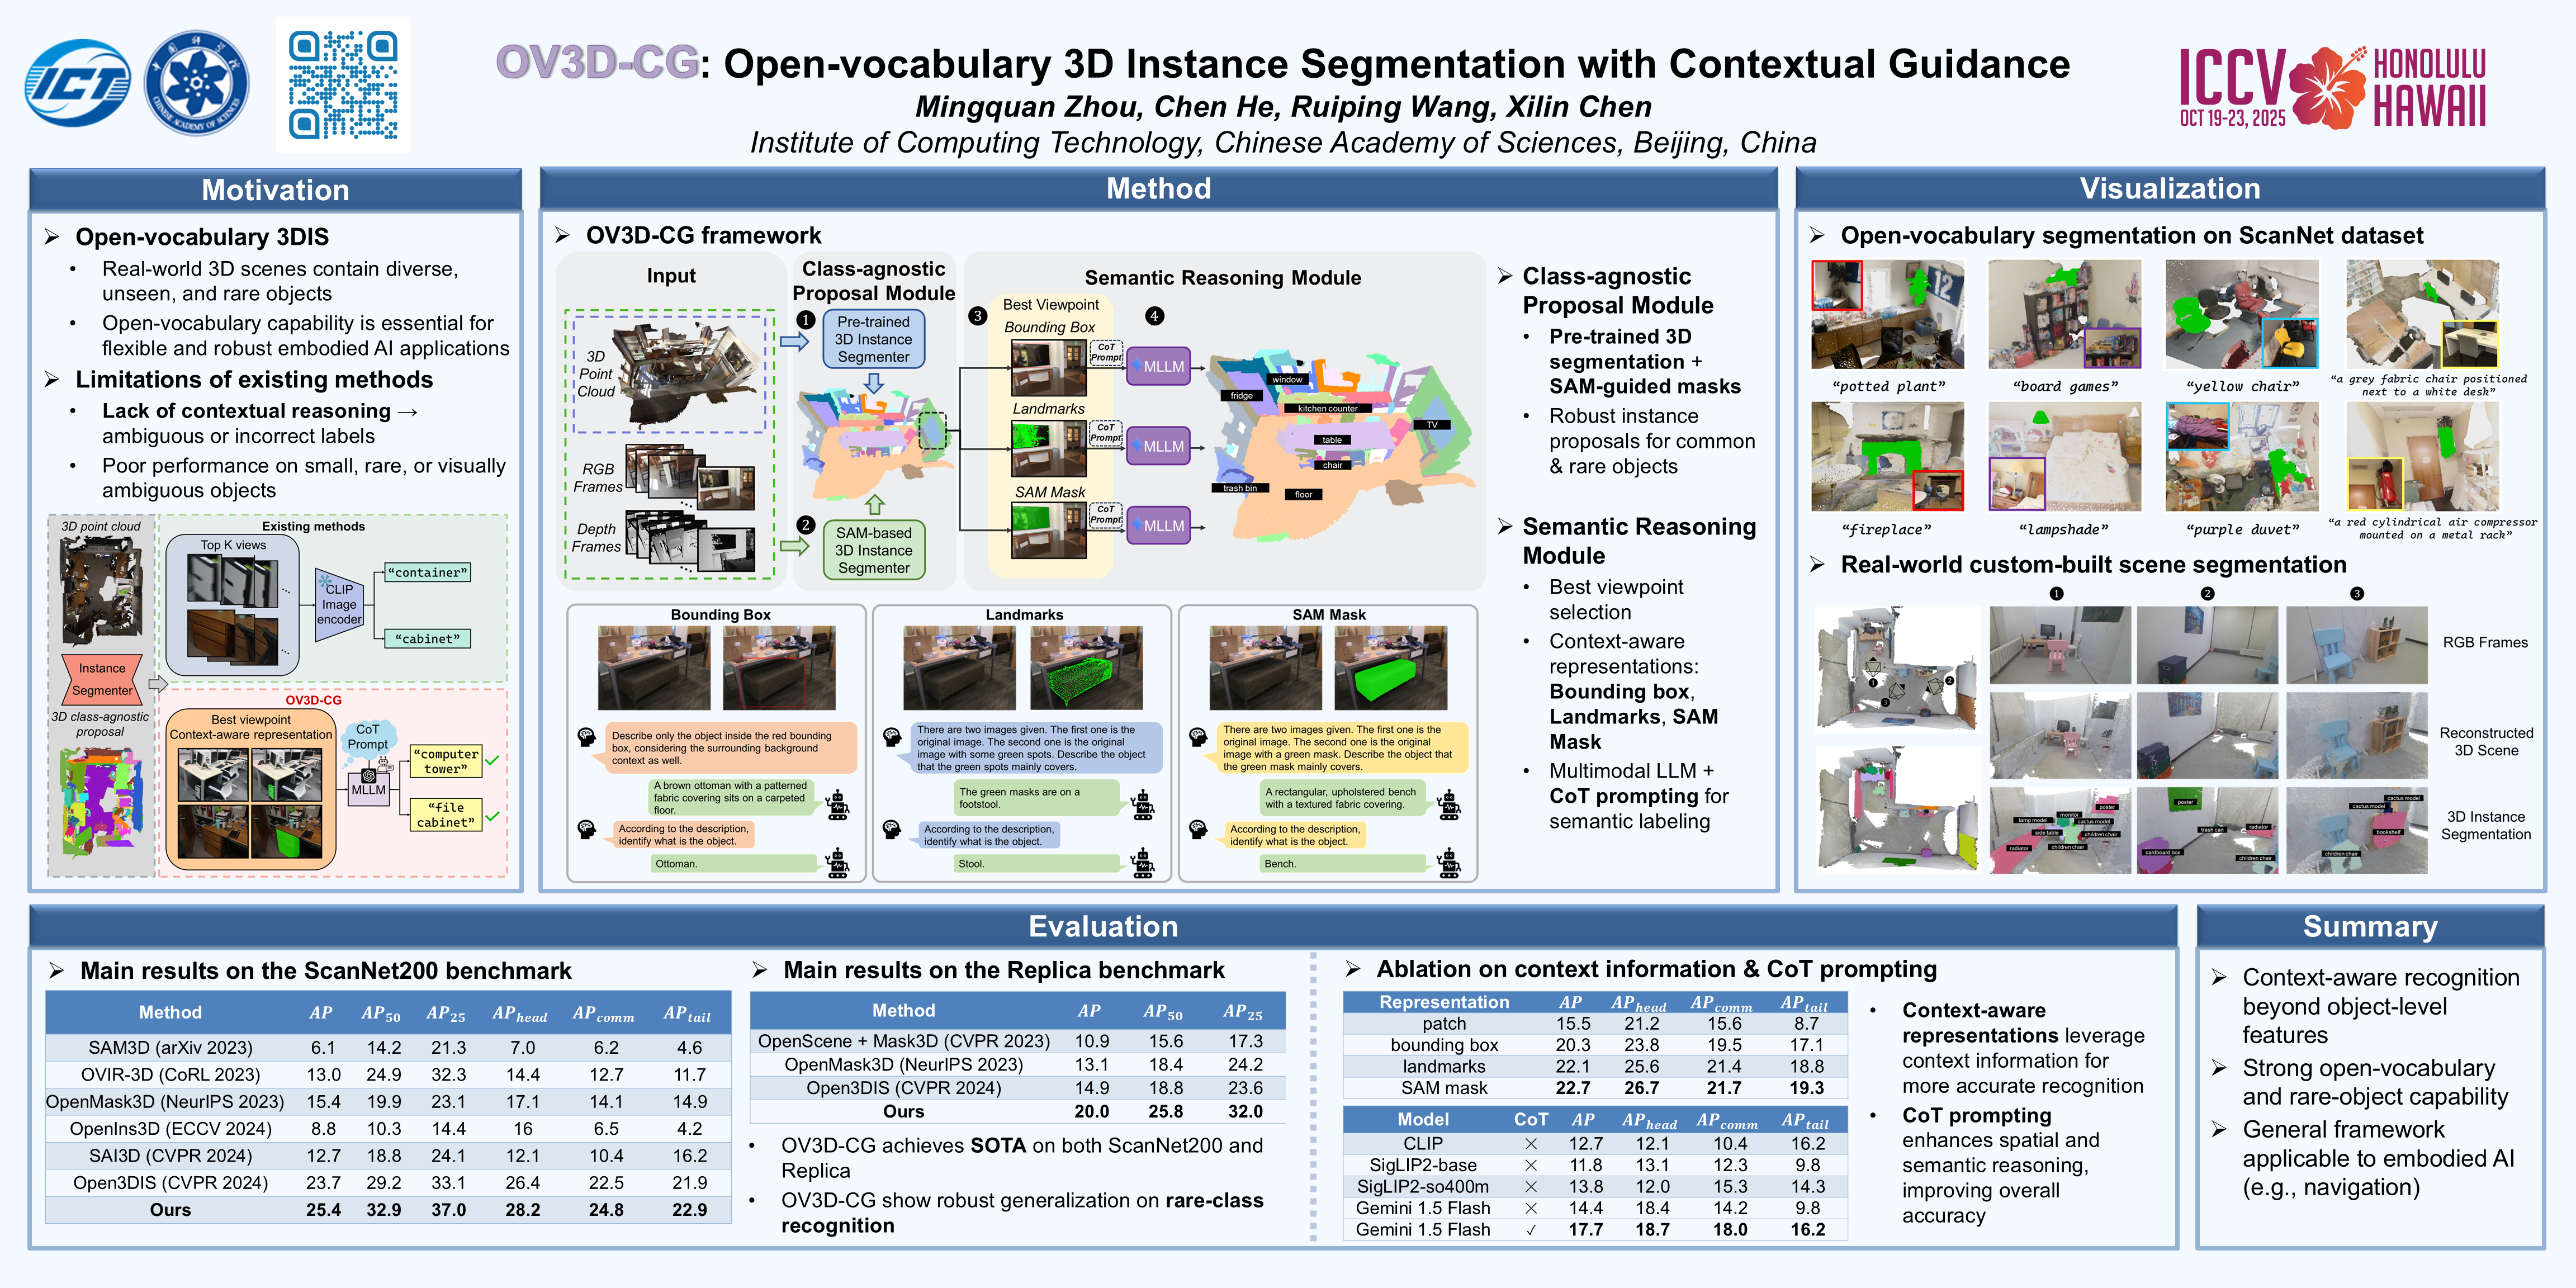
ICCV Poster OV3D-CG: Open-vocabulary 3D Instance Segmentation with ...

ICCV Poster Adapt Foundational Segmentation Models with Heterogeneous ...
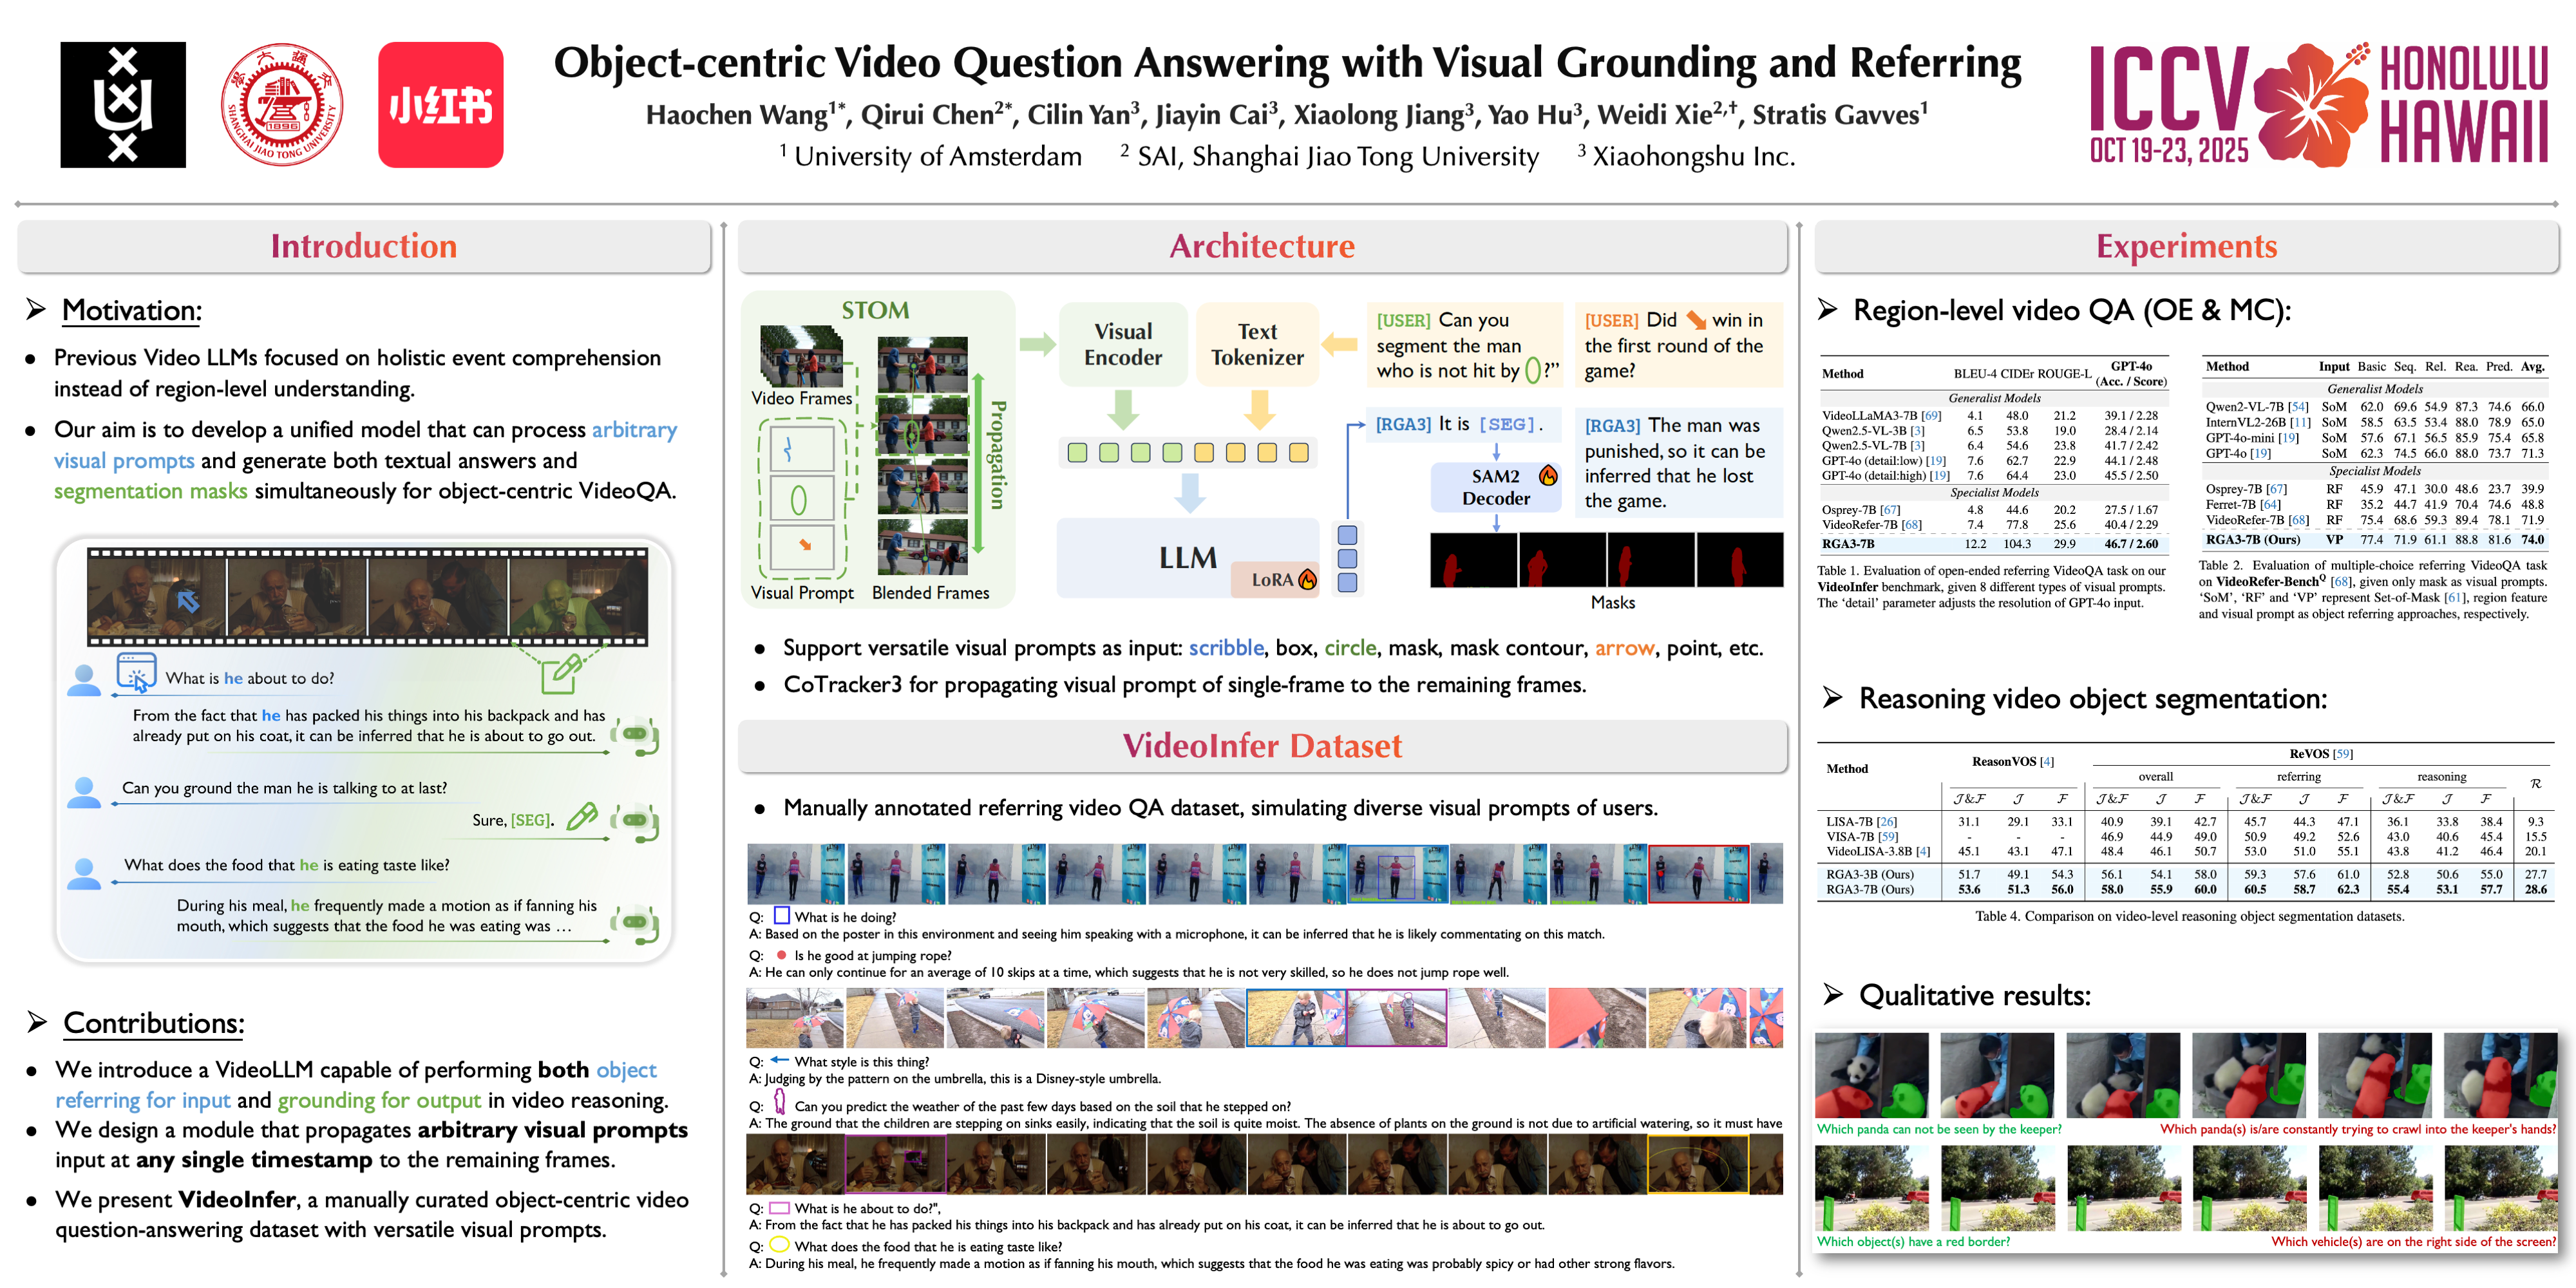
ICCV Poster Object-centric Video Question Answering with Visual ...
Advertisement Space (336x280)

ICCV Poster PVChat: Personalized Video Chat with One-Shot Learning

ICCV Poster CAPTURE: Evaluating Spatial Reasoning in Vision Language ...
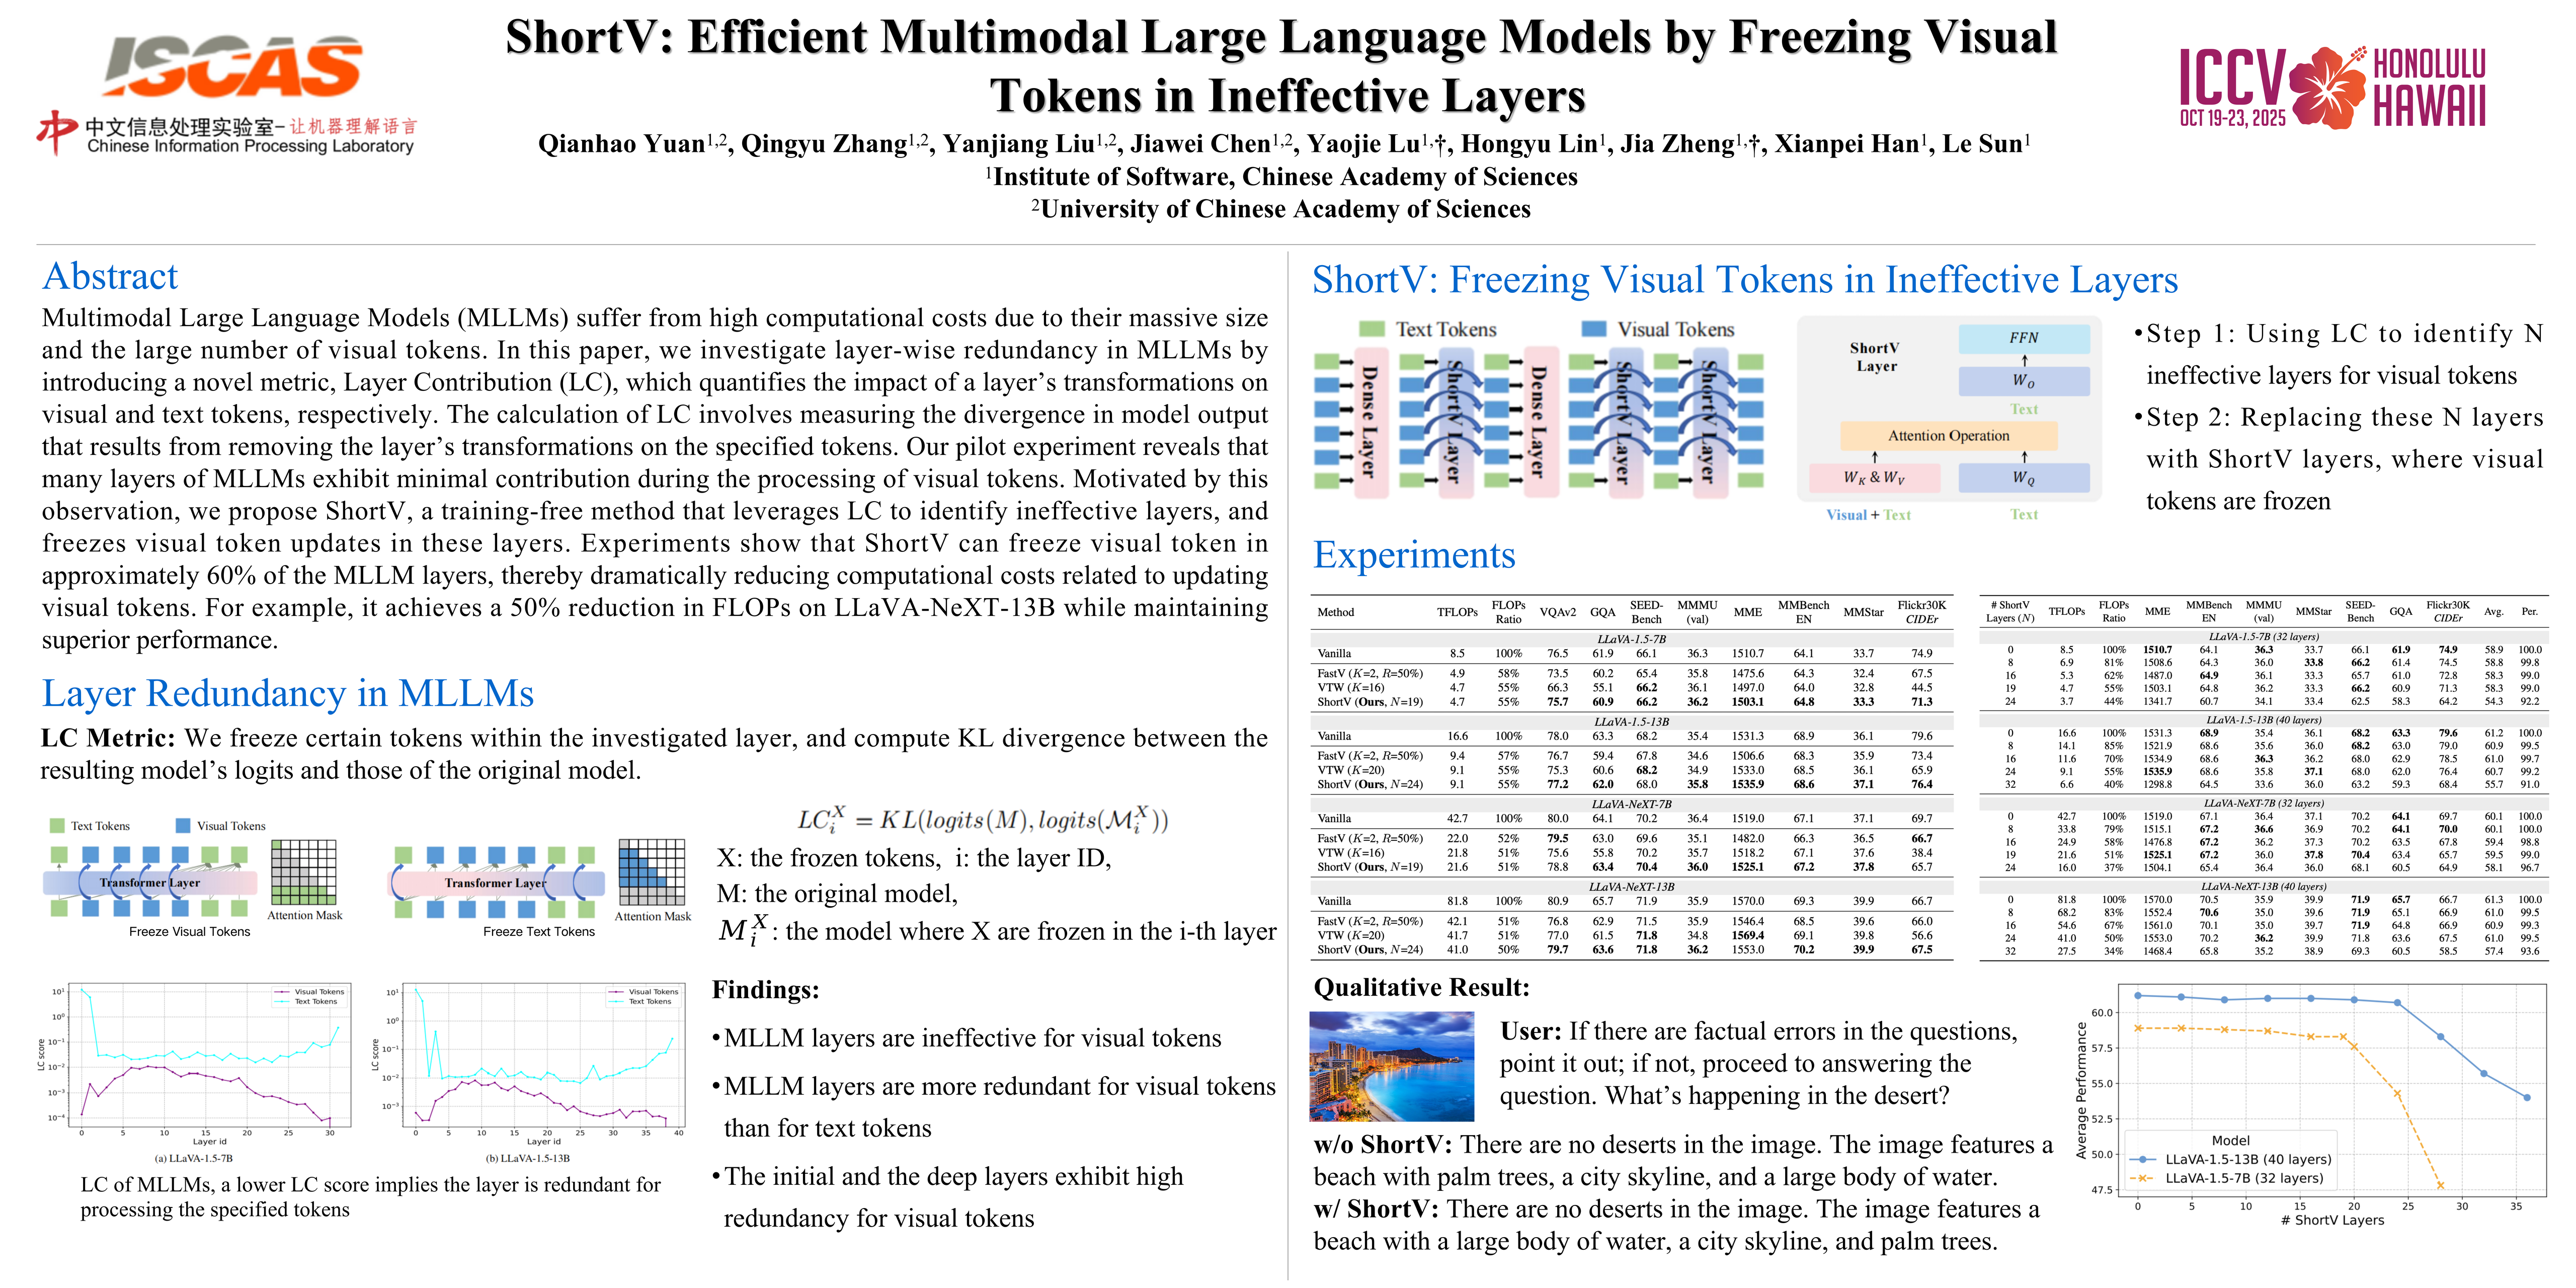
ICCV Poster ShortV: Efficient Multimodal Large Language Models by ...

ICCV Poster MINERVA: Evaluating Complex Video Reasoning
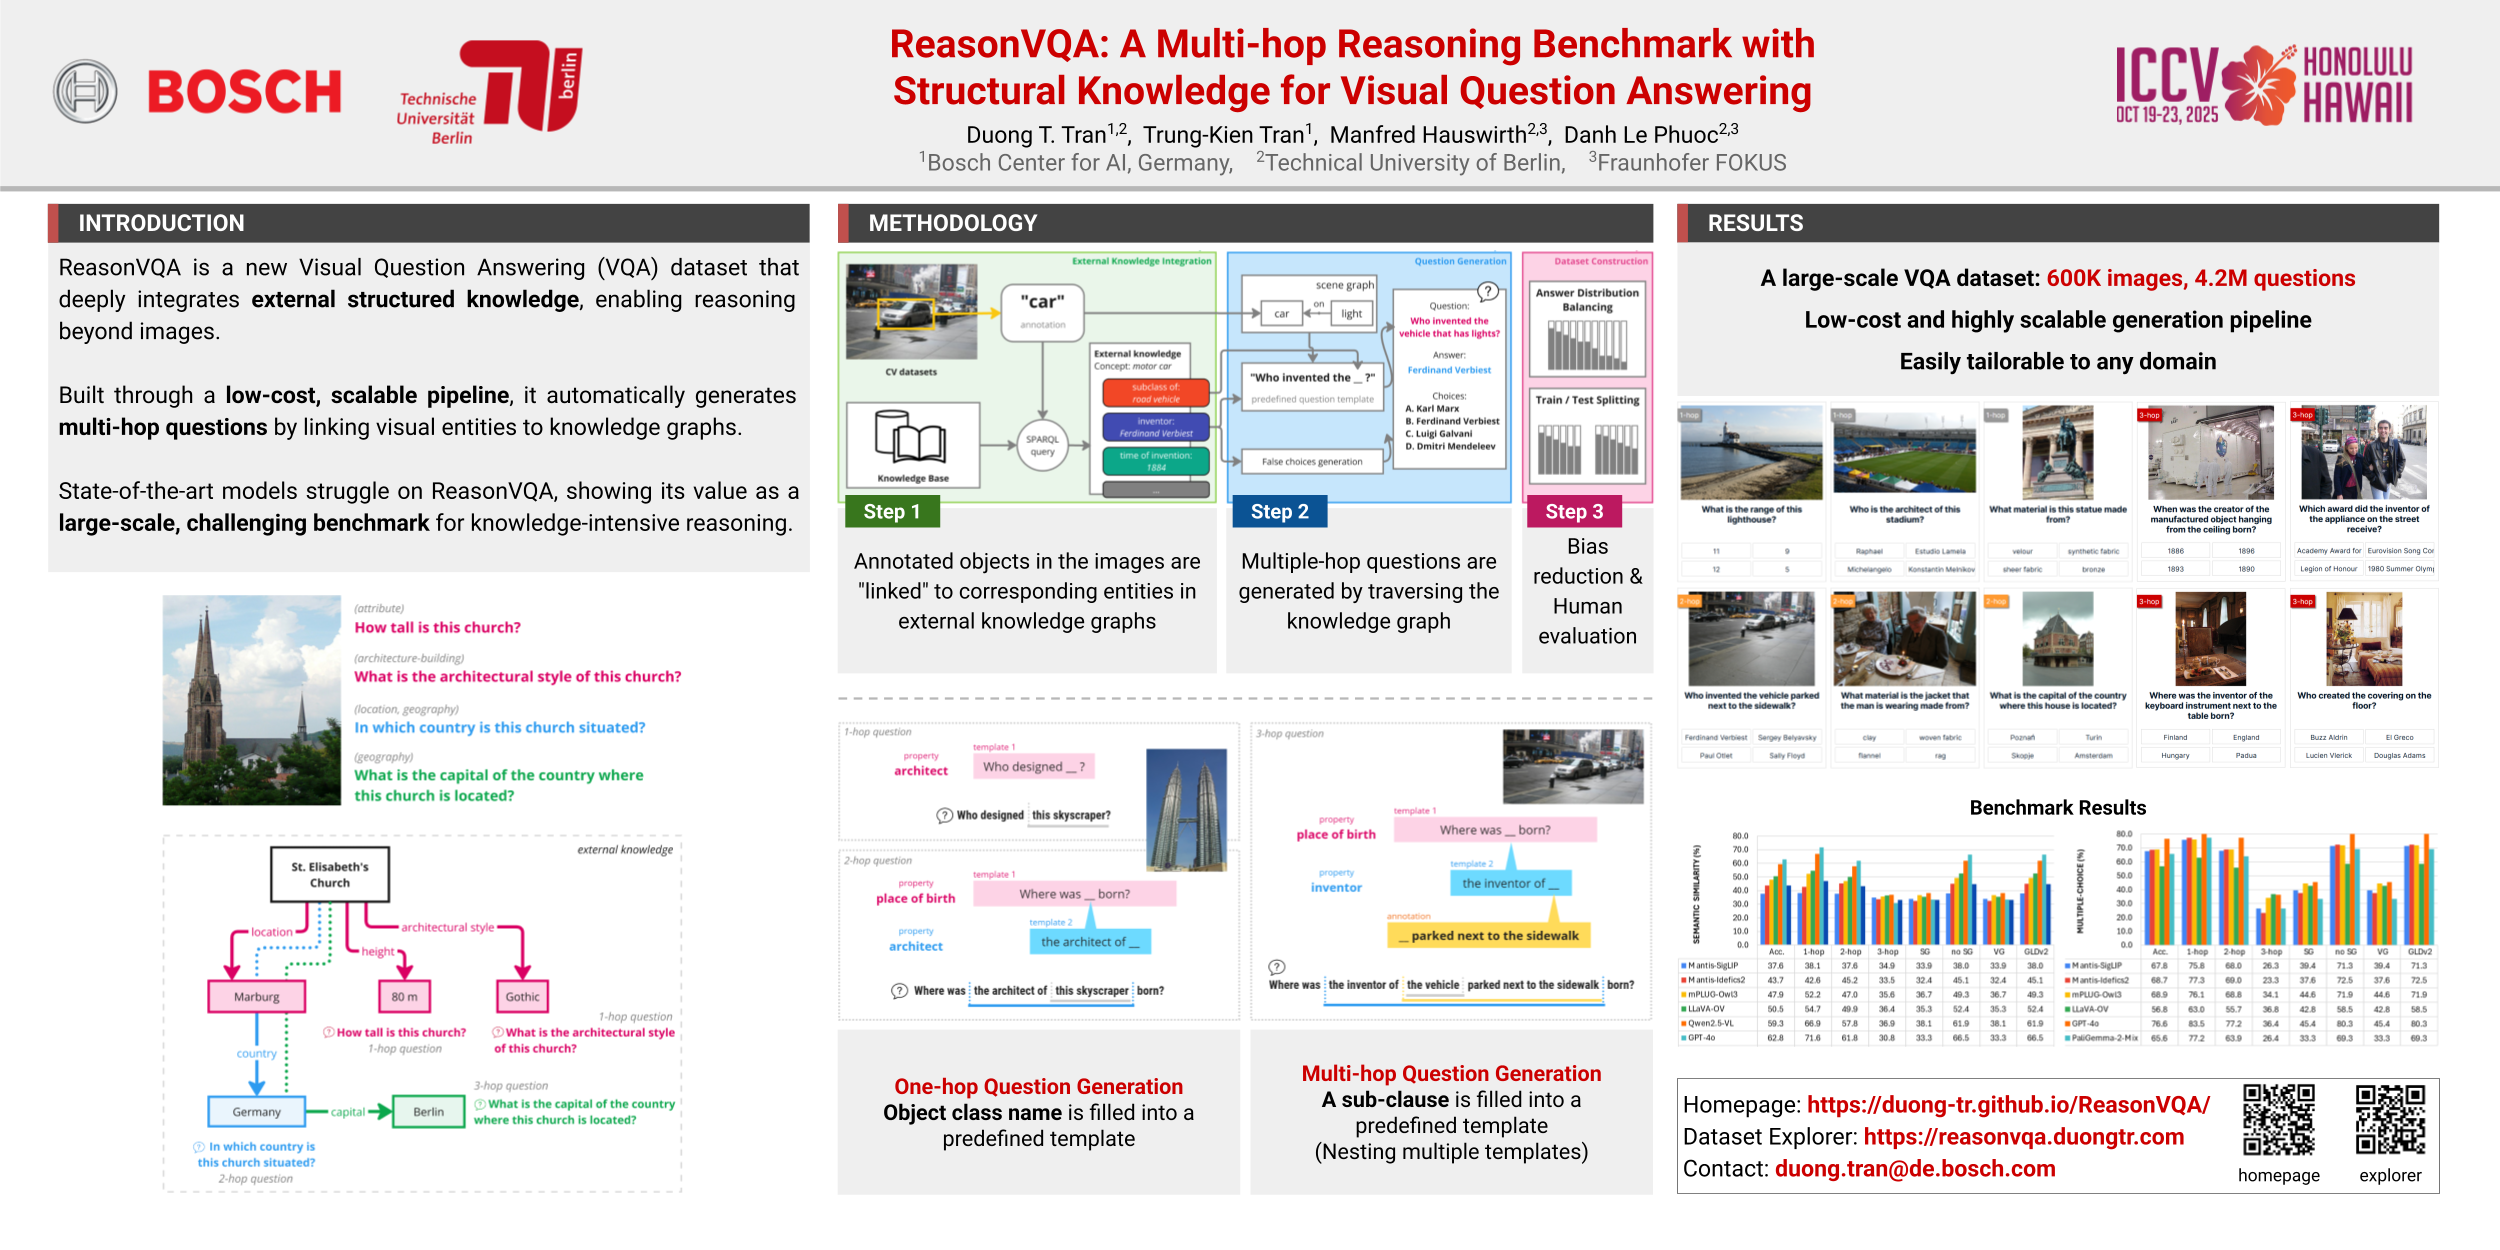
ICCV Poster ReasonVQA: A Multi-hop Reasoning Benchmark with Structural ...

ECCV Poster SegPoint: Segment Any Point Cloud via Large Language Model

ICCV Poster Perspective-Aware Reasoning in Vision-Language Models via ...
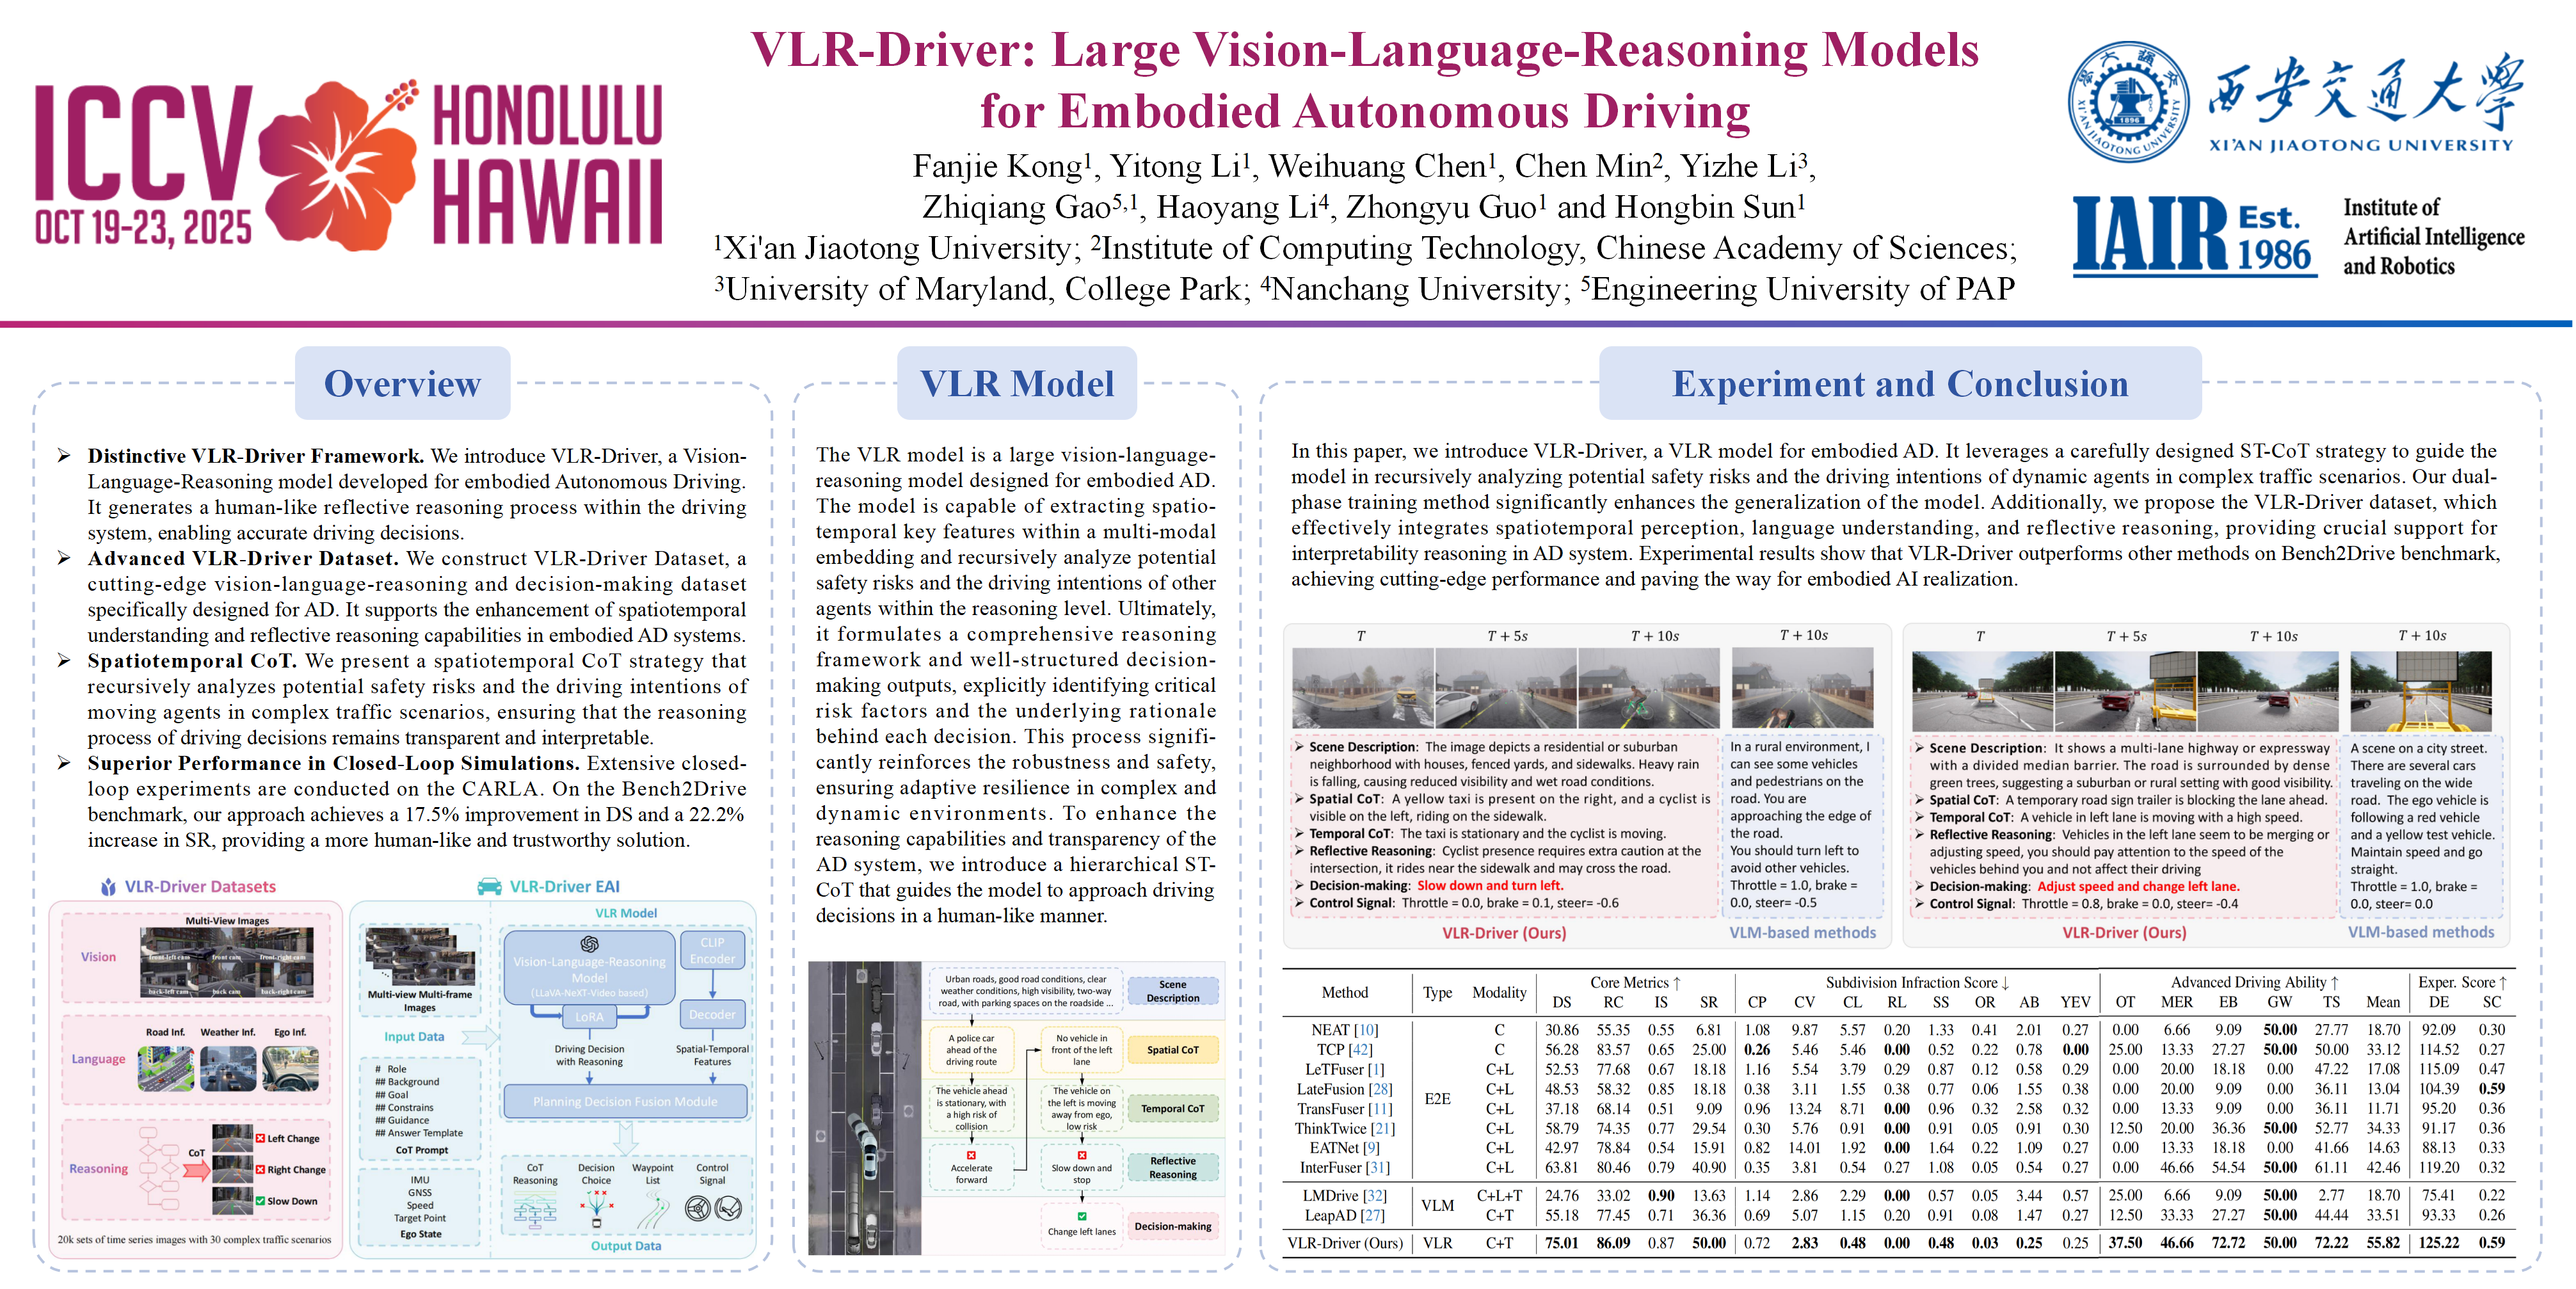
ICCV Poster VLR-Driver: Large Vision-Language-Reasoning Models for ...
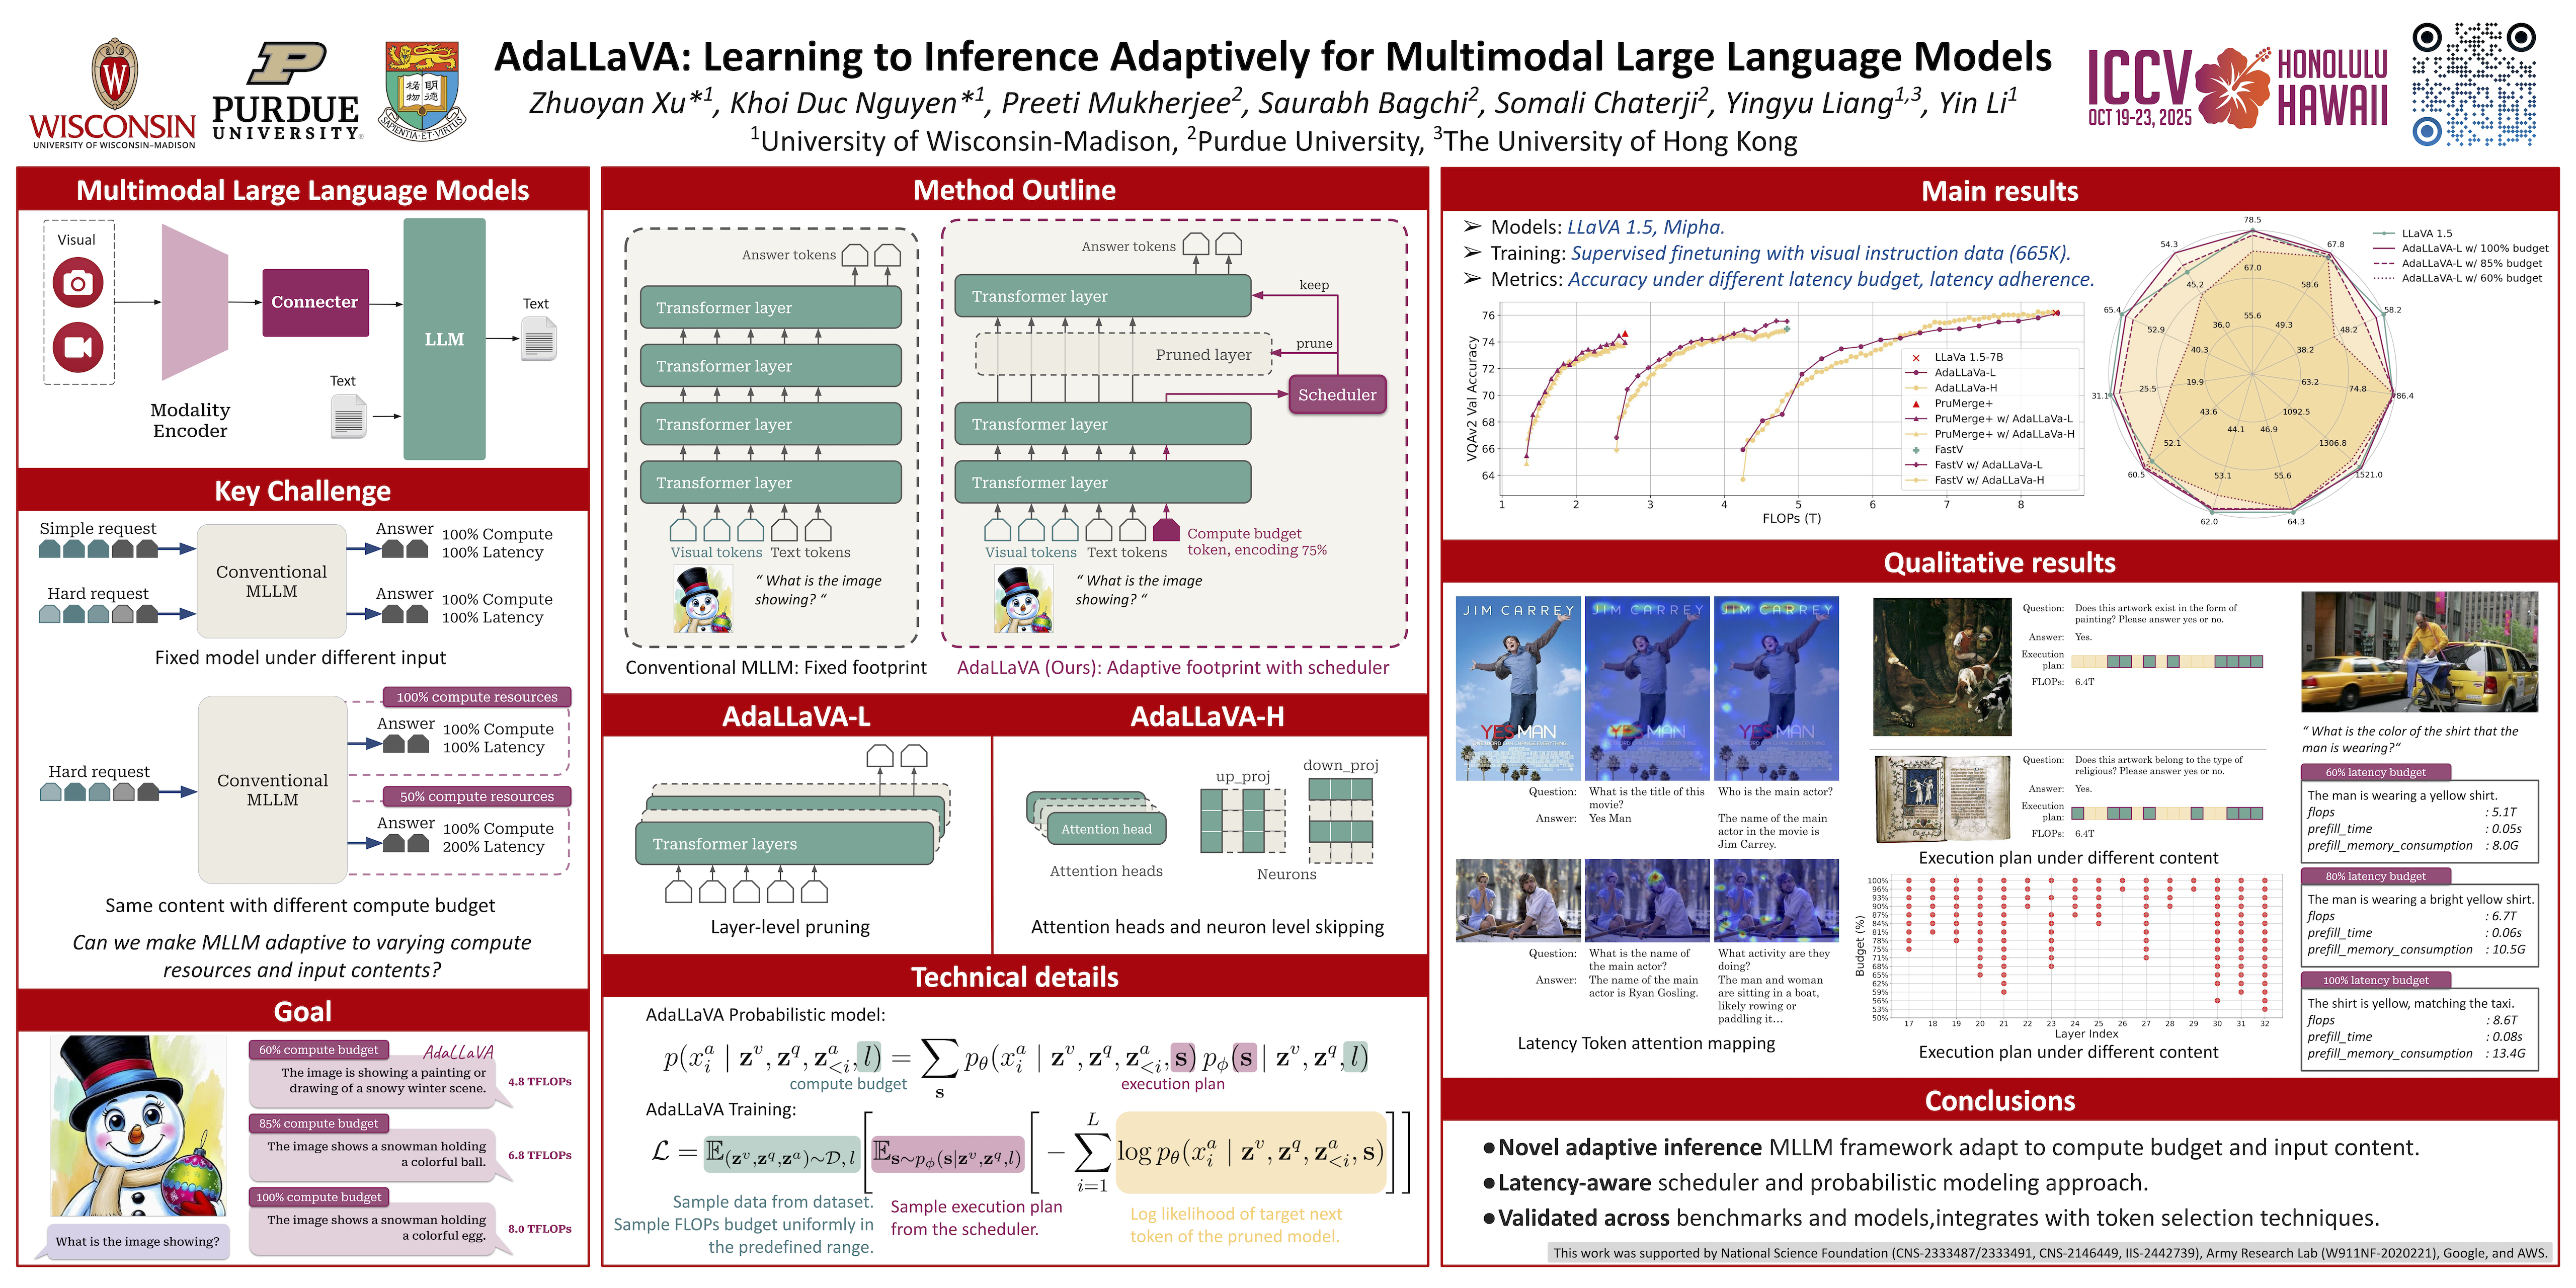
ICCV Poster Learning to Inference Adaptively for Multimodal Large ...
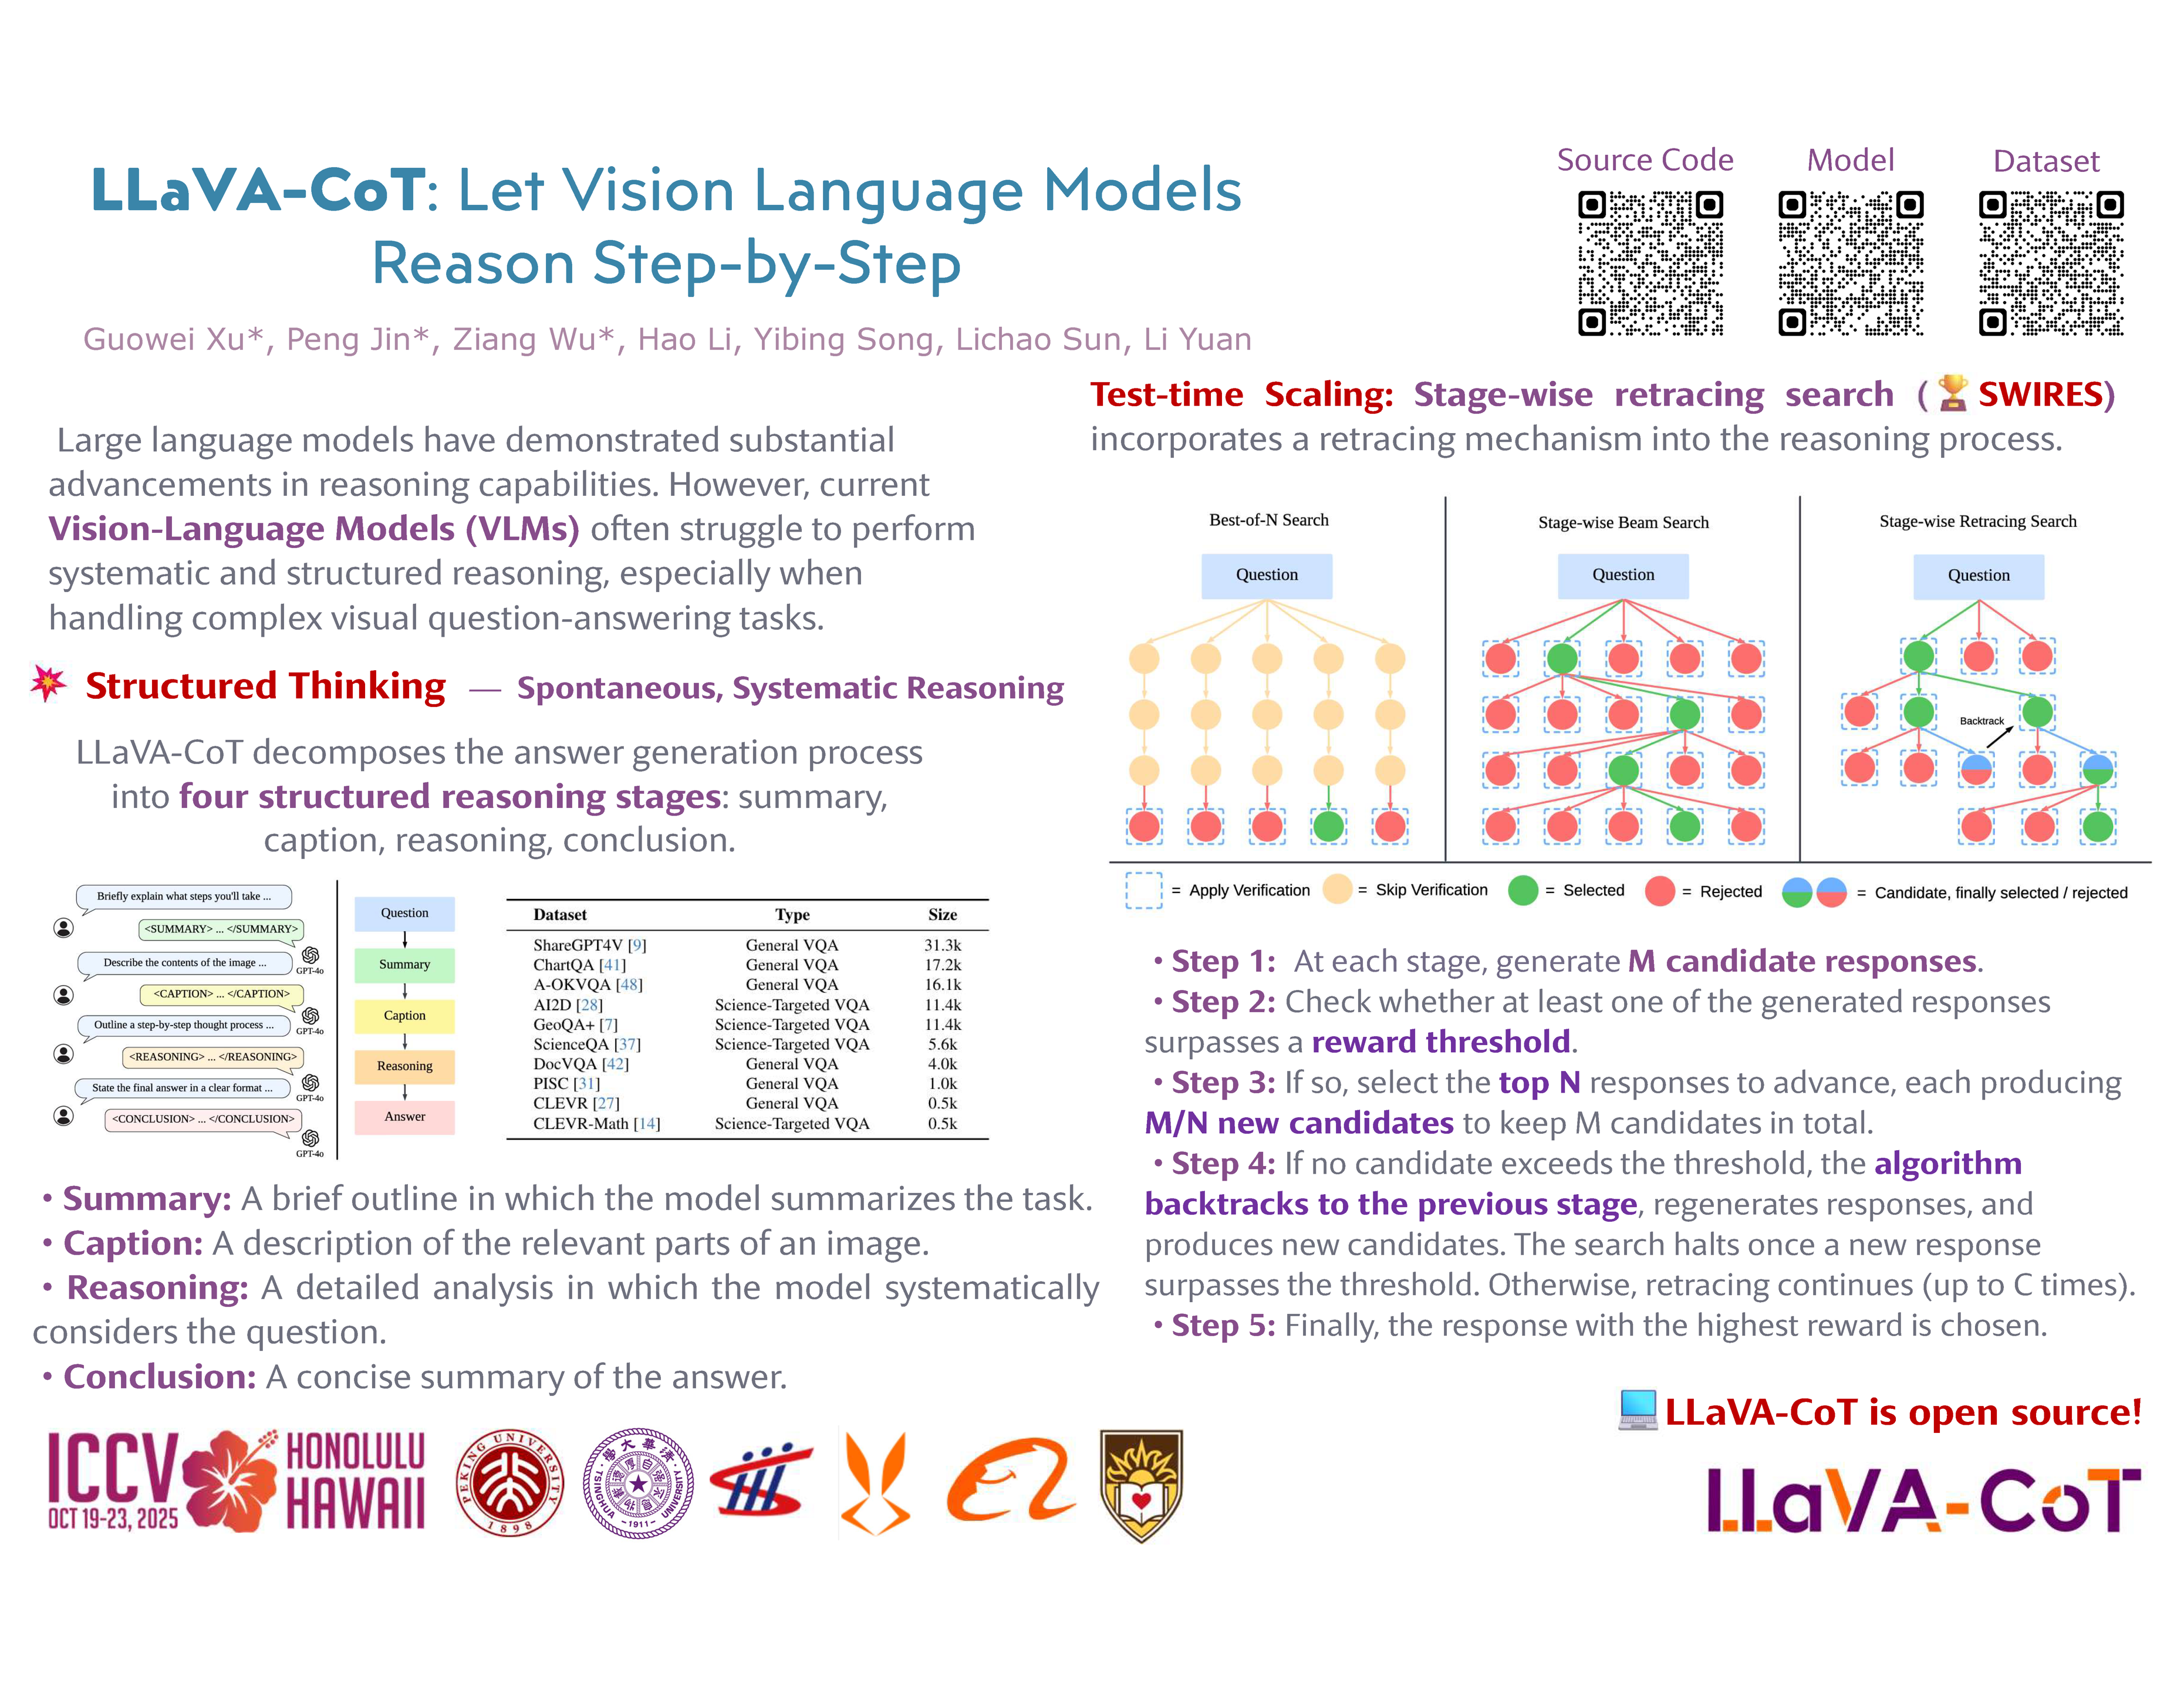
ICCV Poster LLaVA-CoT: Let Vision Language Models Reason Step-by-Step
Advertisement Space (336x280)
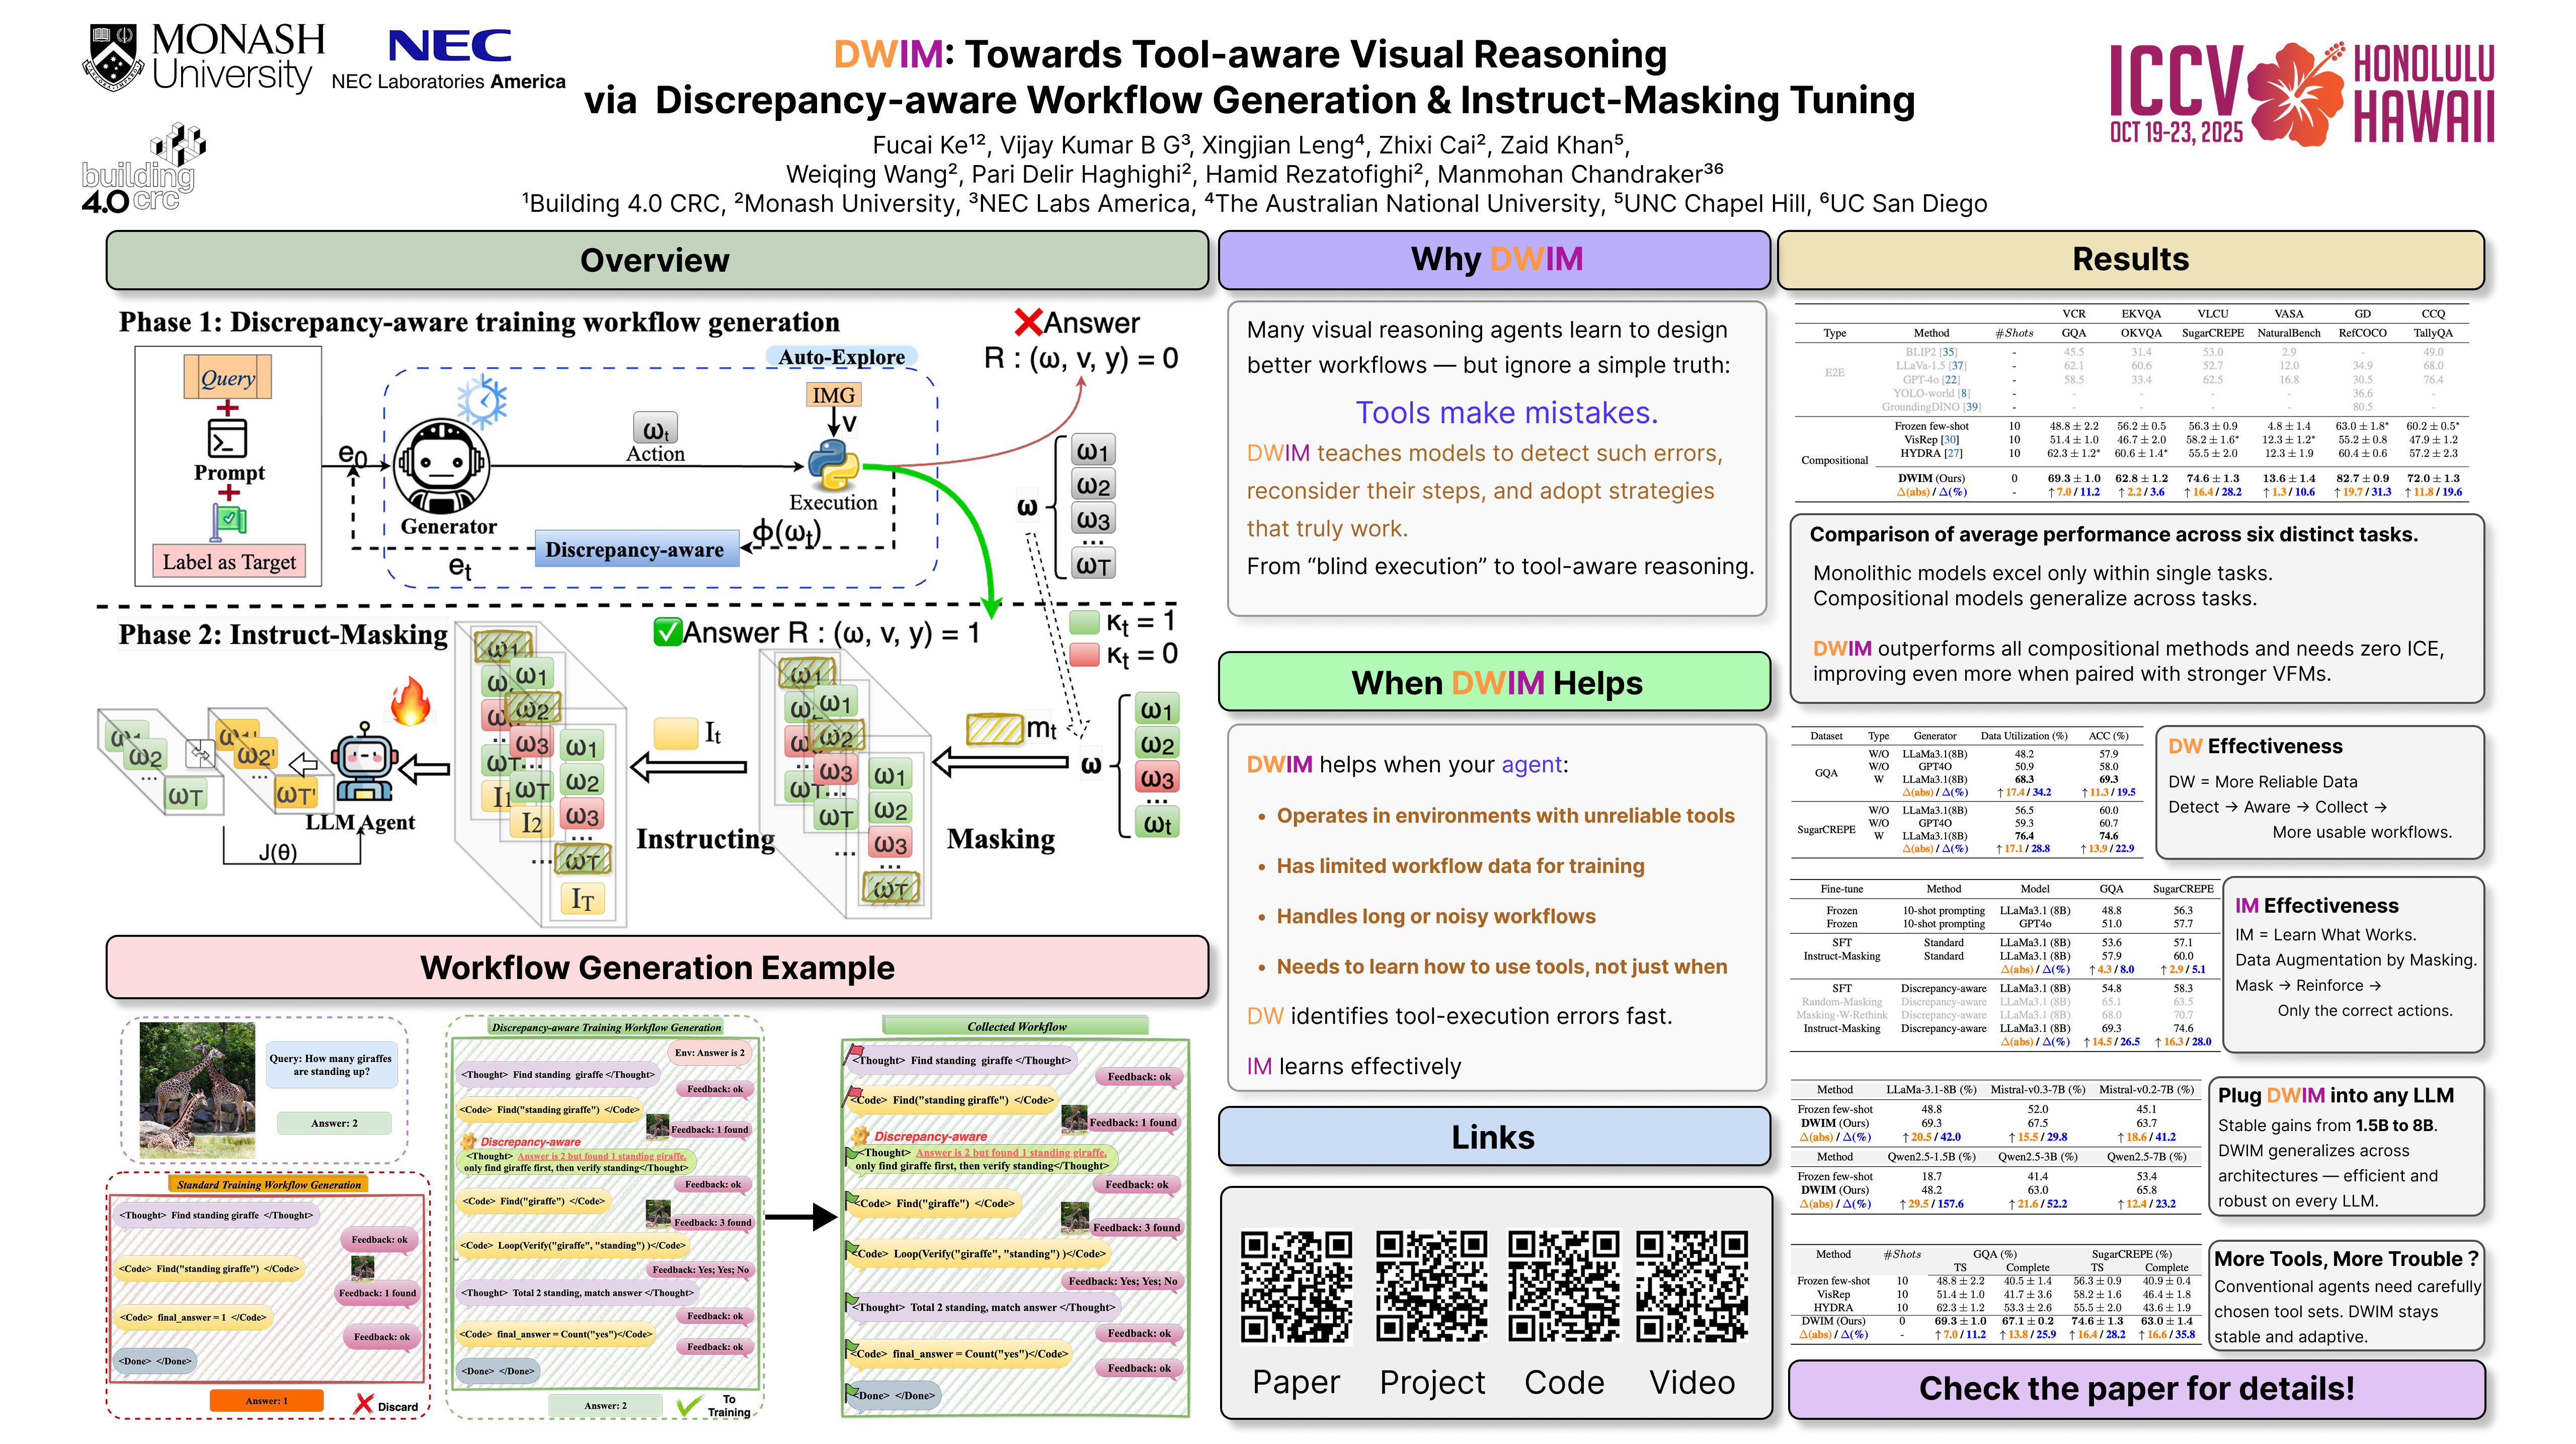
ICCV Poster DWIM: Towards Tool-aware Visual Reasoning via Discrepancy ...
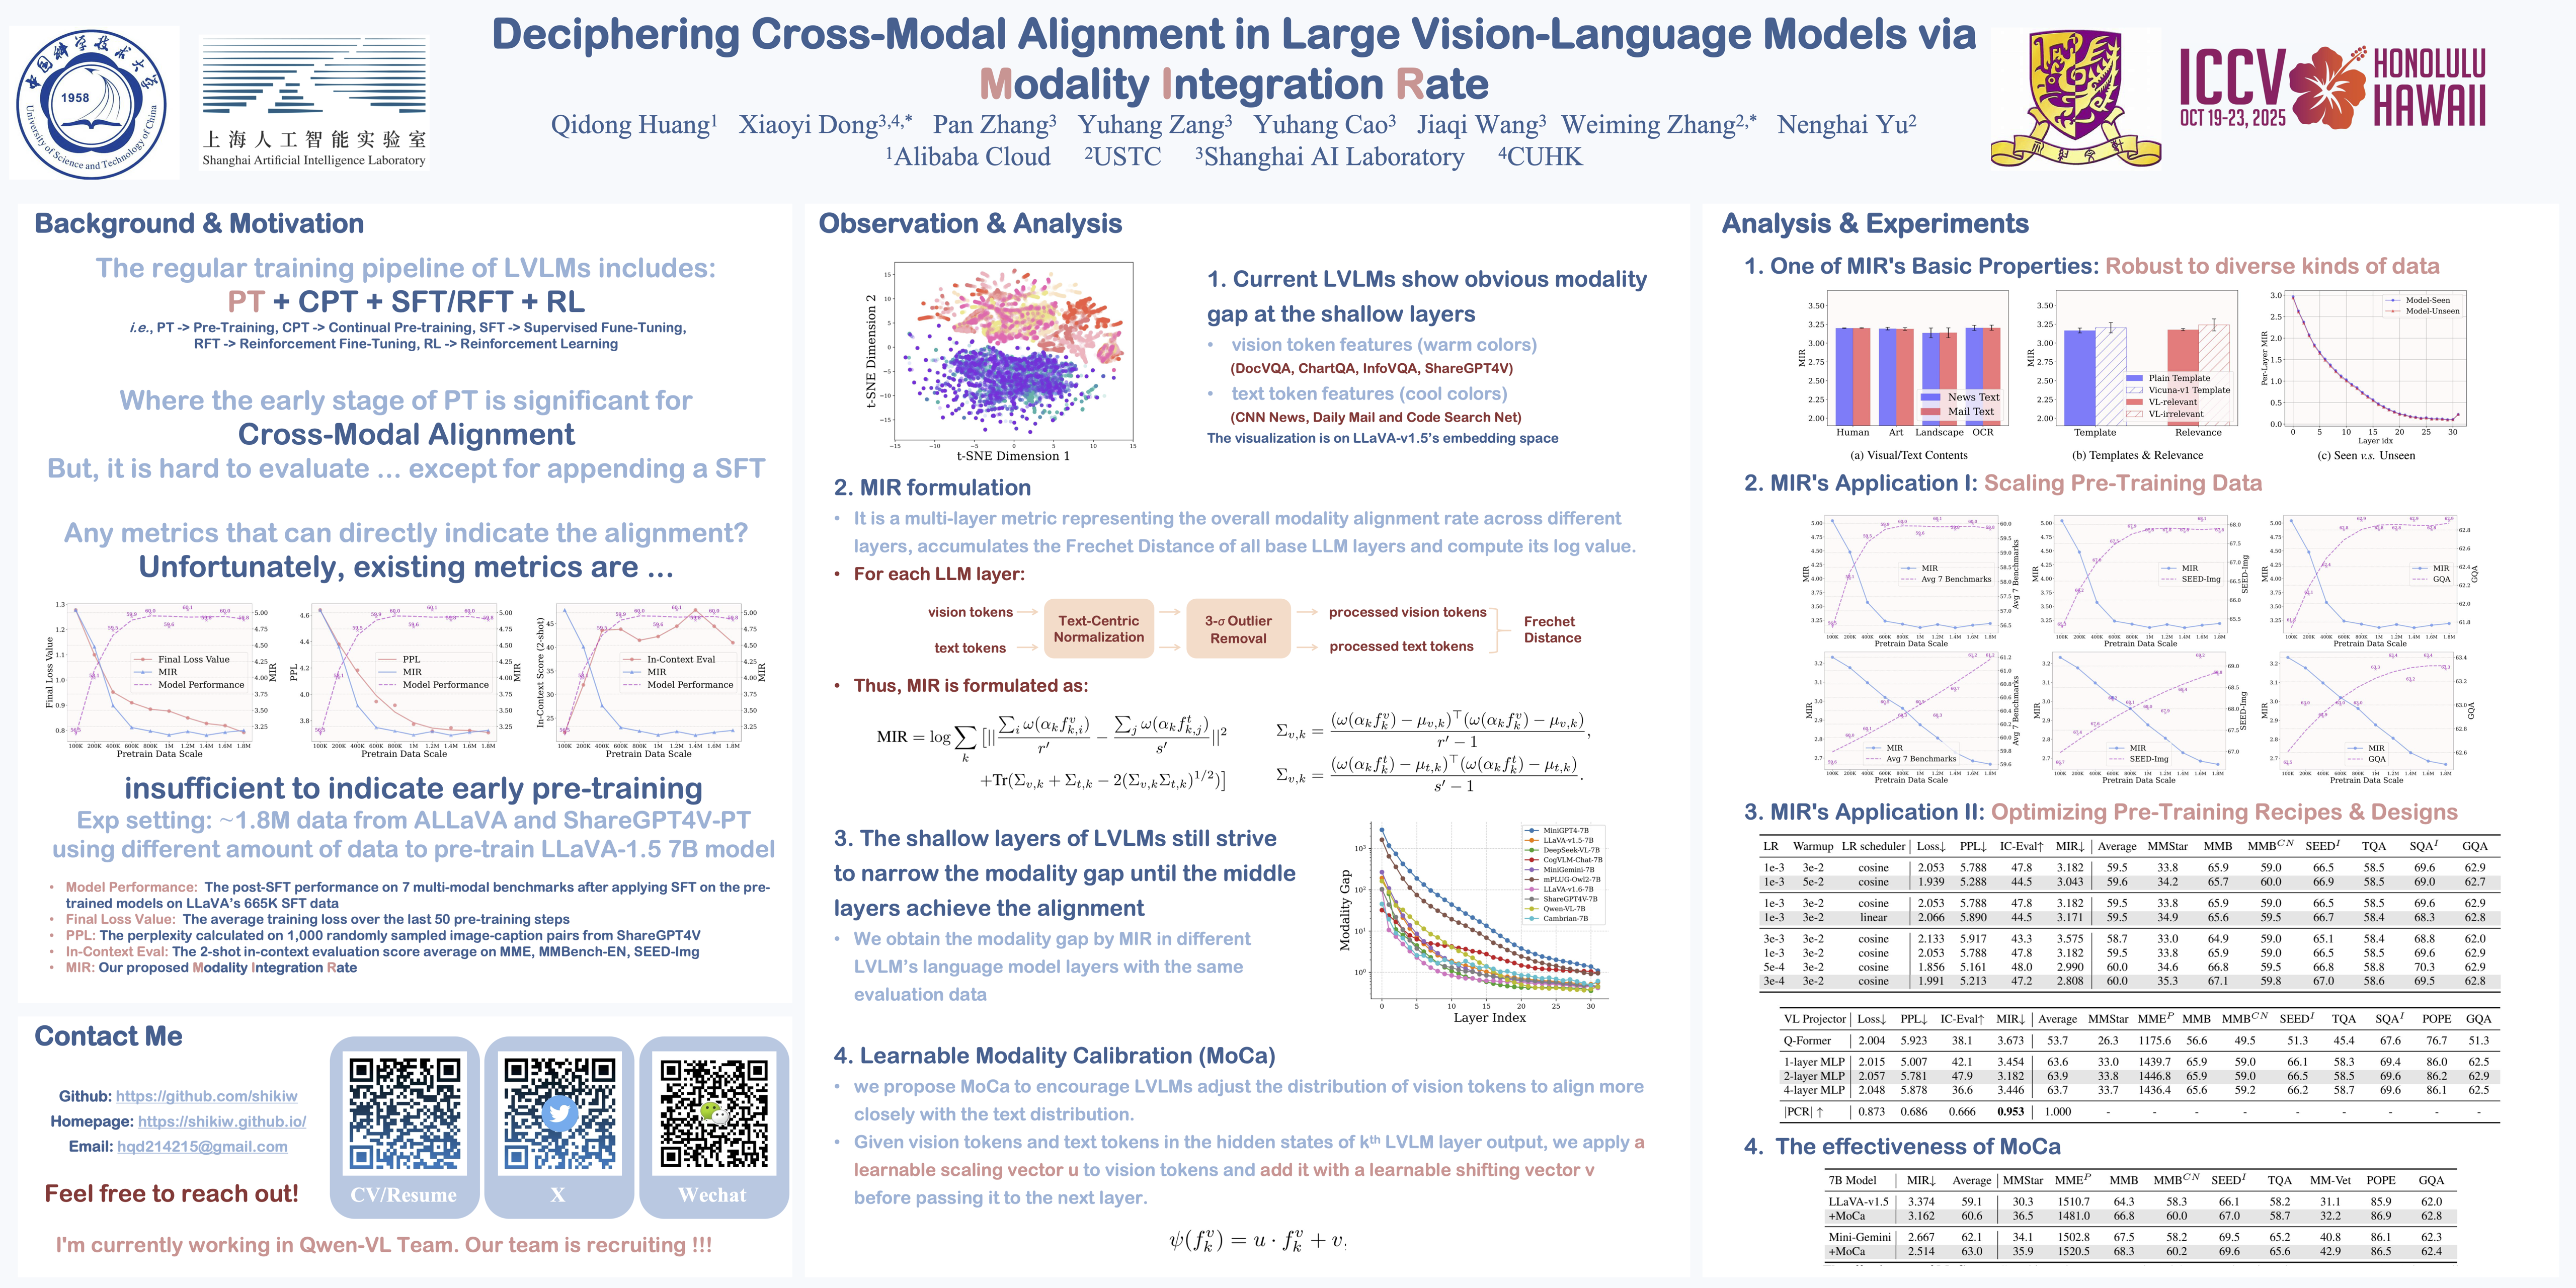
ICCV Poster Deciphering Cross-Modal Alignment in Large Vision-Language ...

ICCV Poster Fine-Grained Evaluation of Large Vision-Language Models in ...

ICCV Poster Knowledge-Guided Part Segmentation
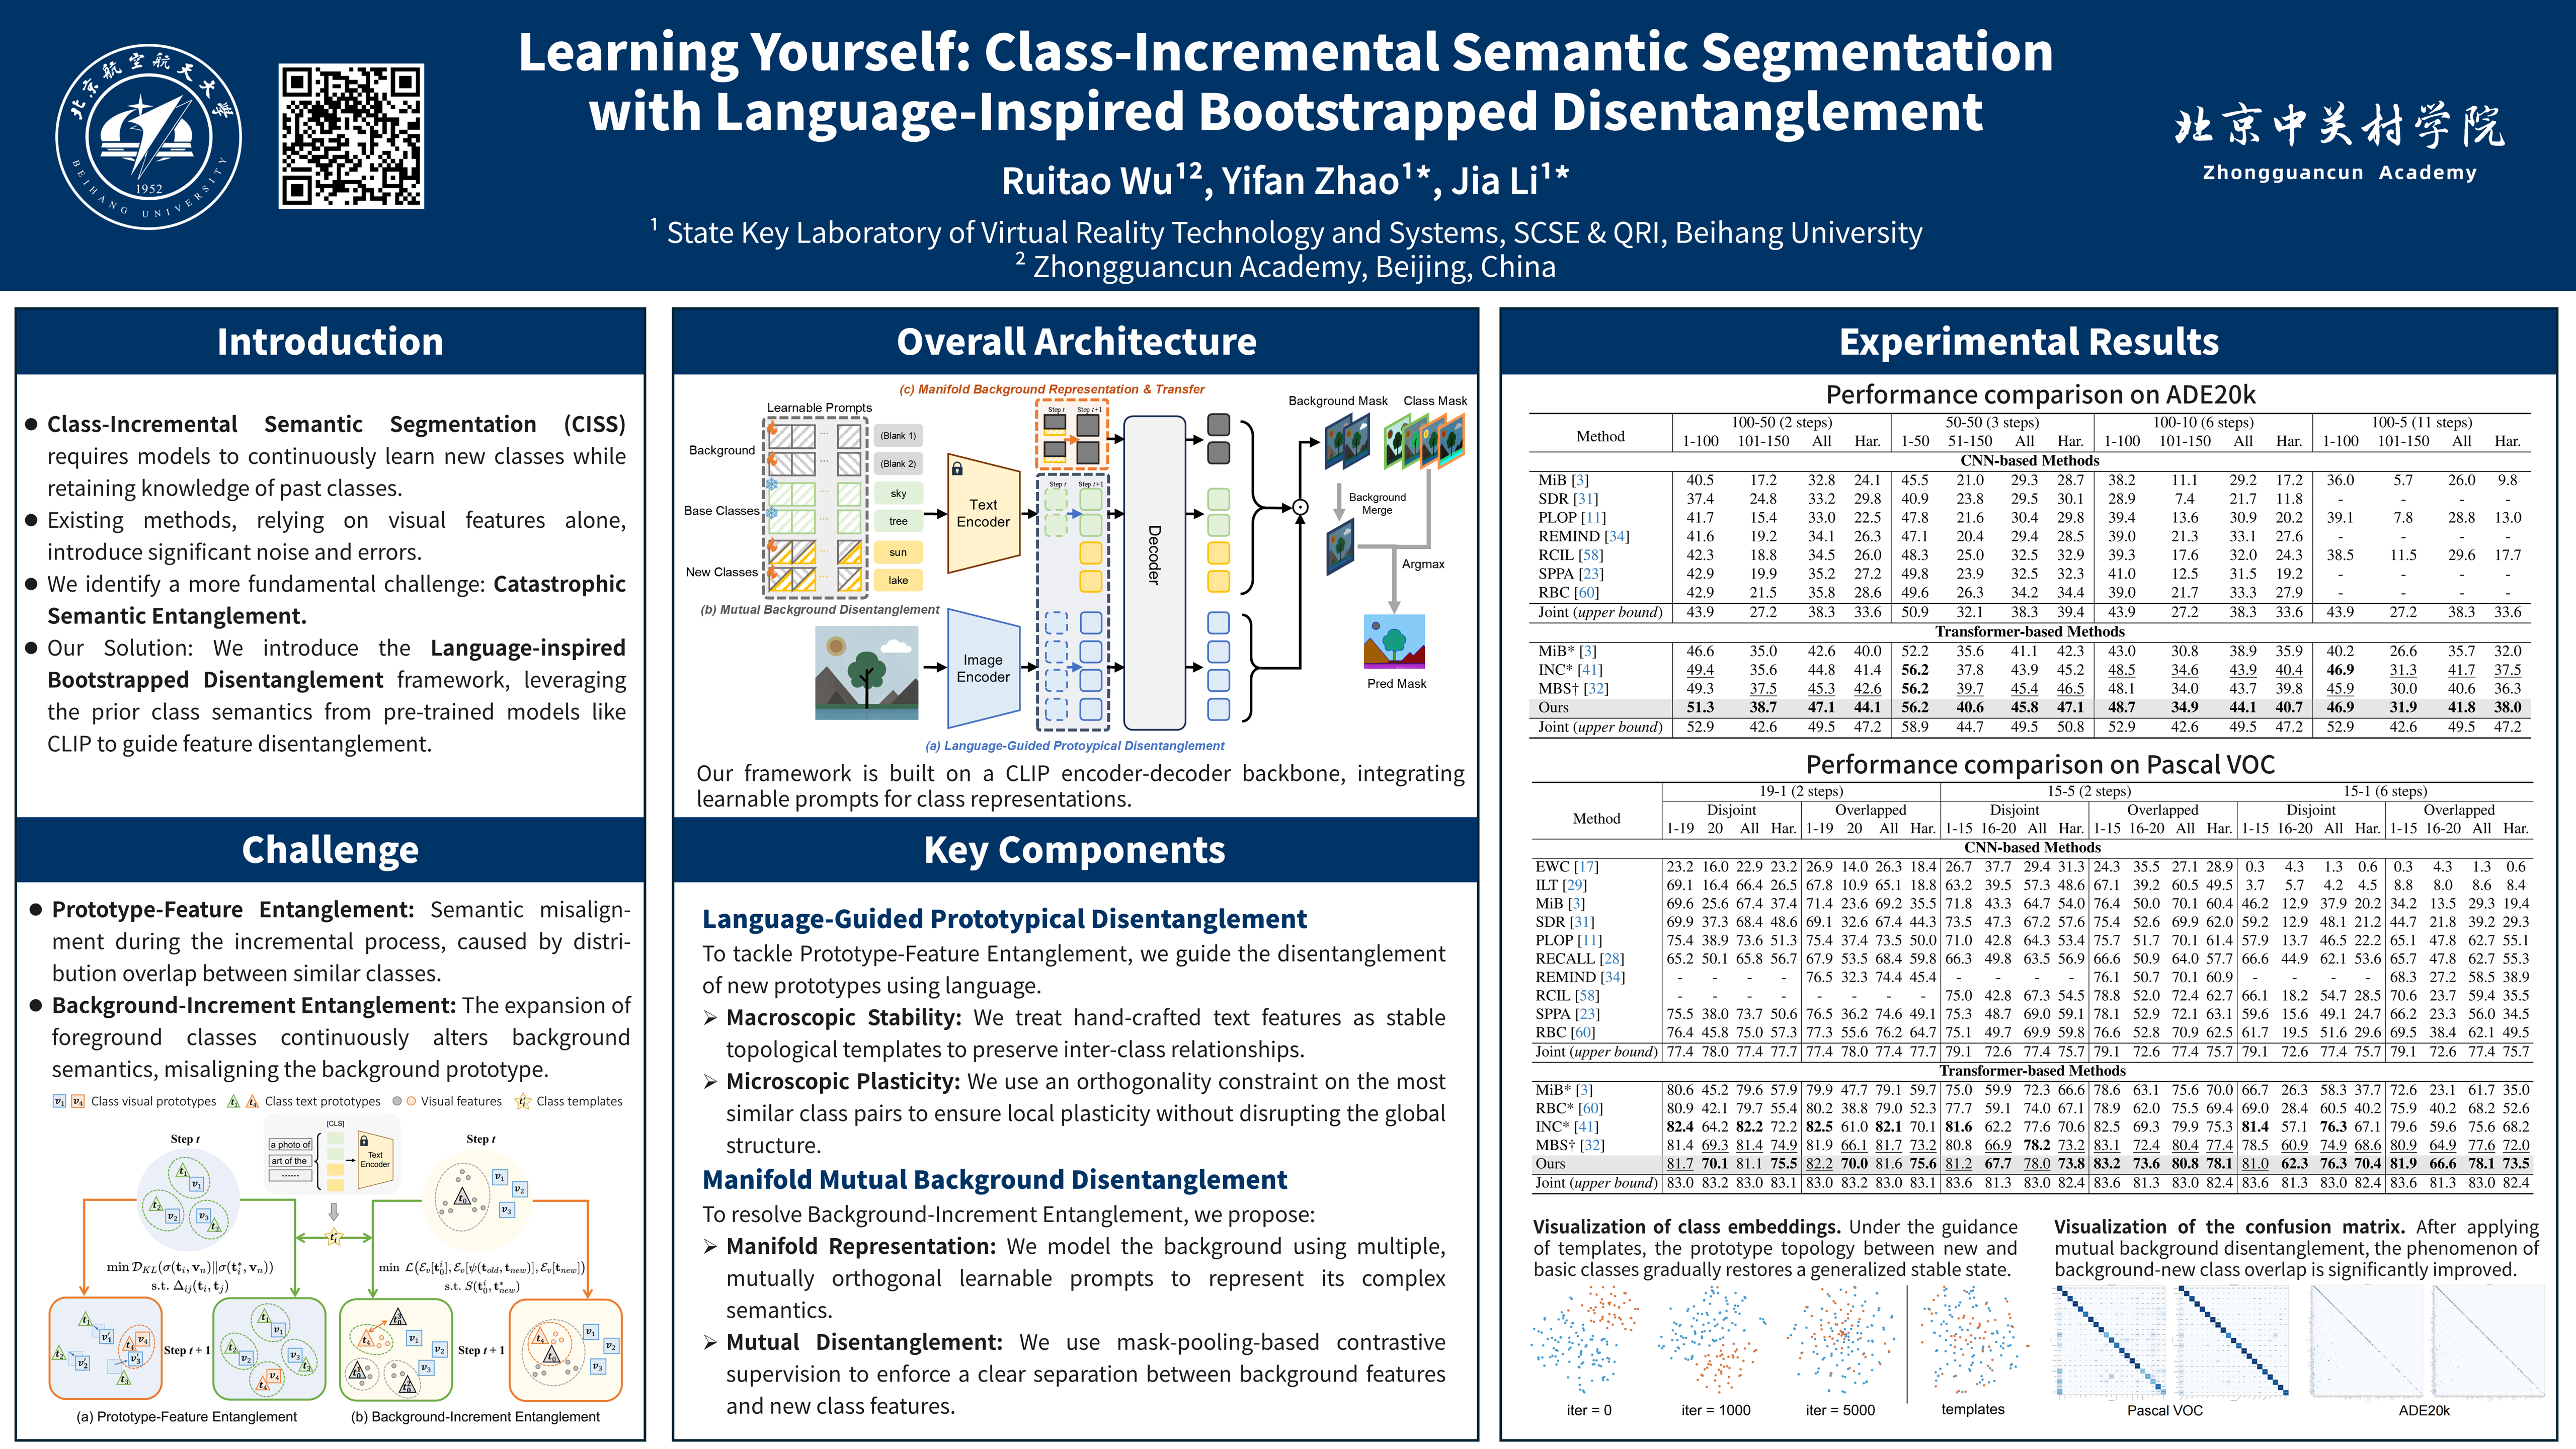
ICCV Poster Learning Yourself: Class-Incremental Semantic Segmentation ...
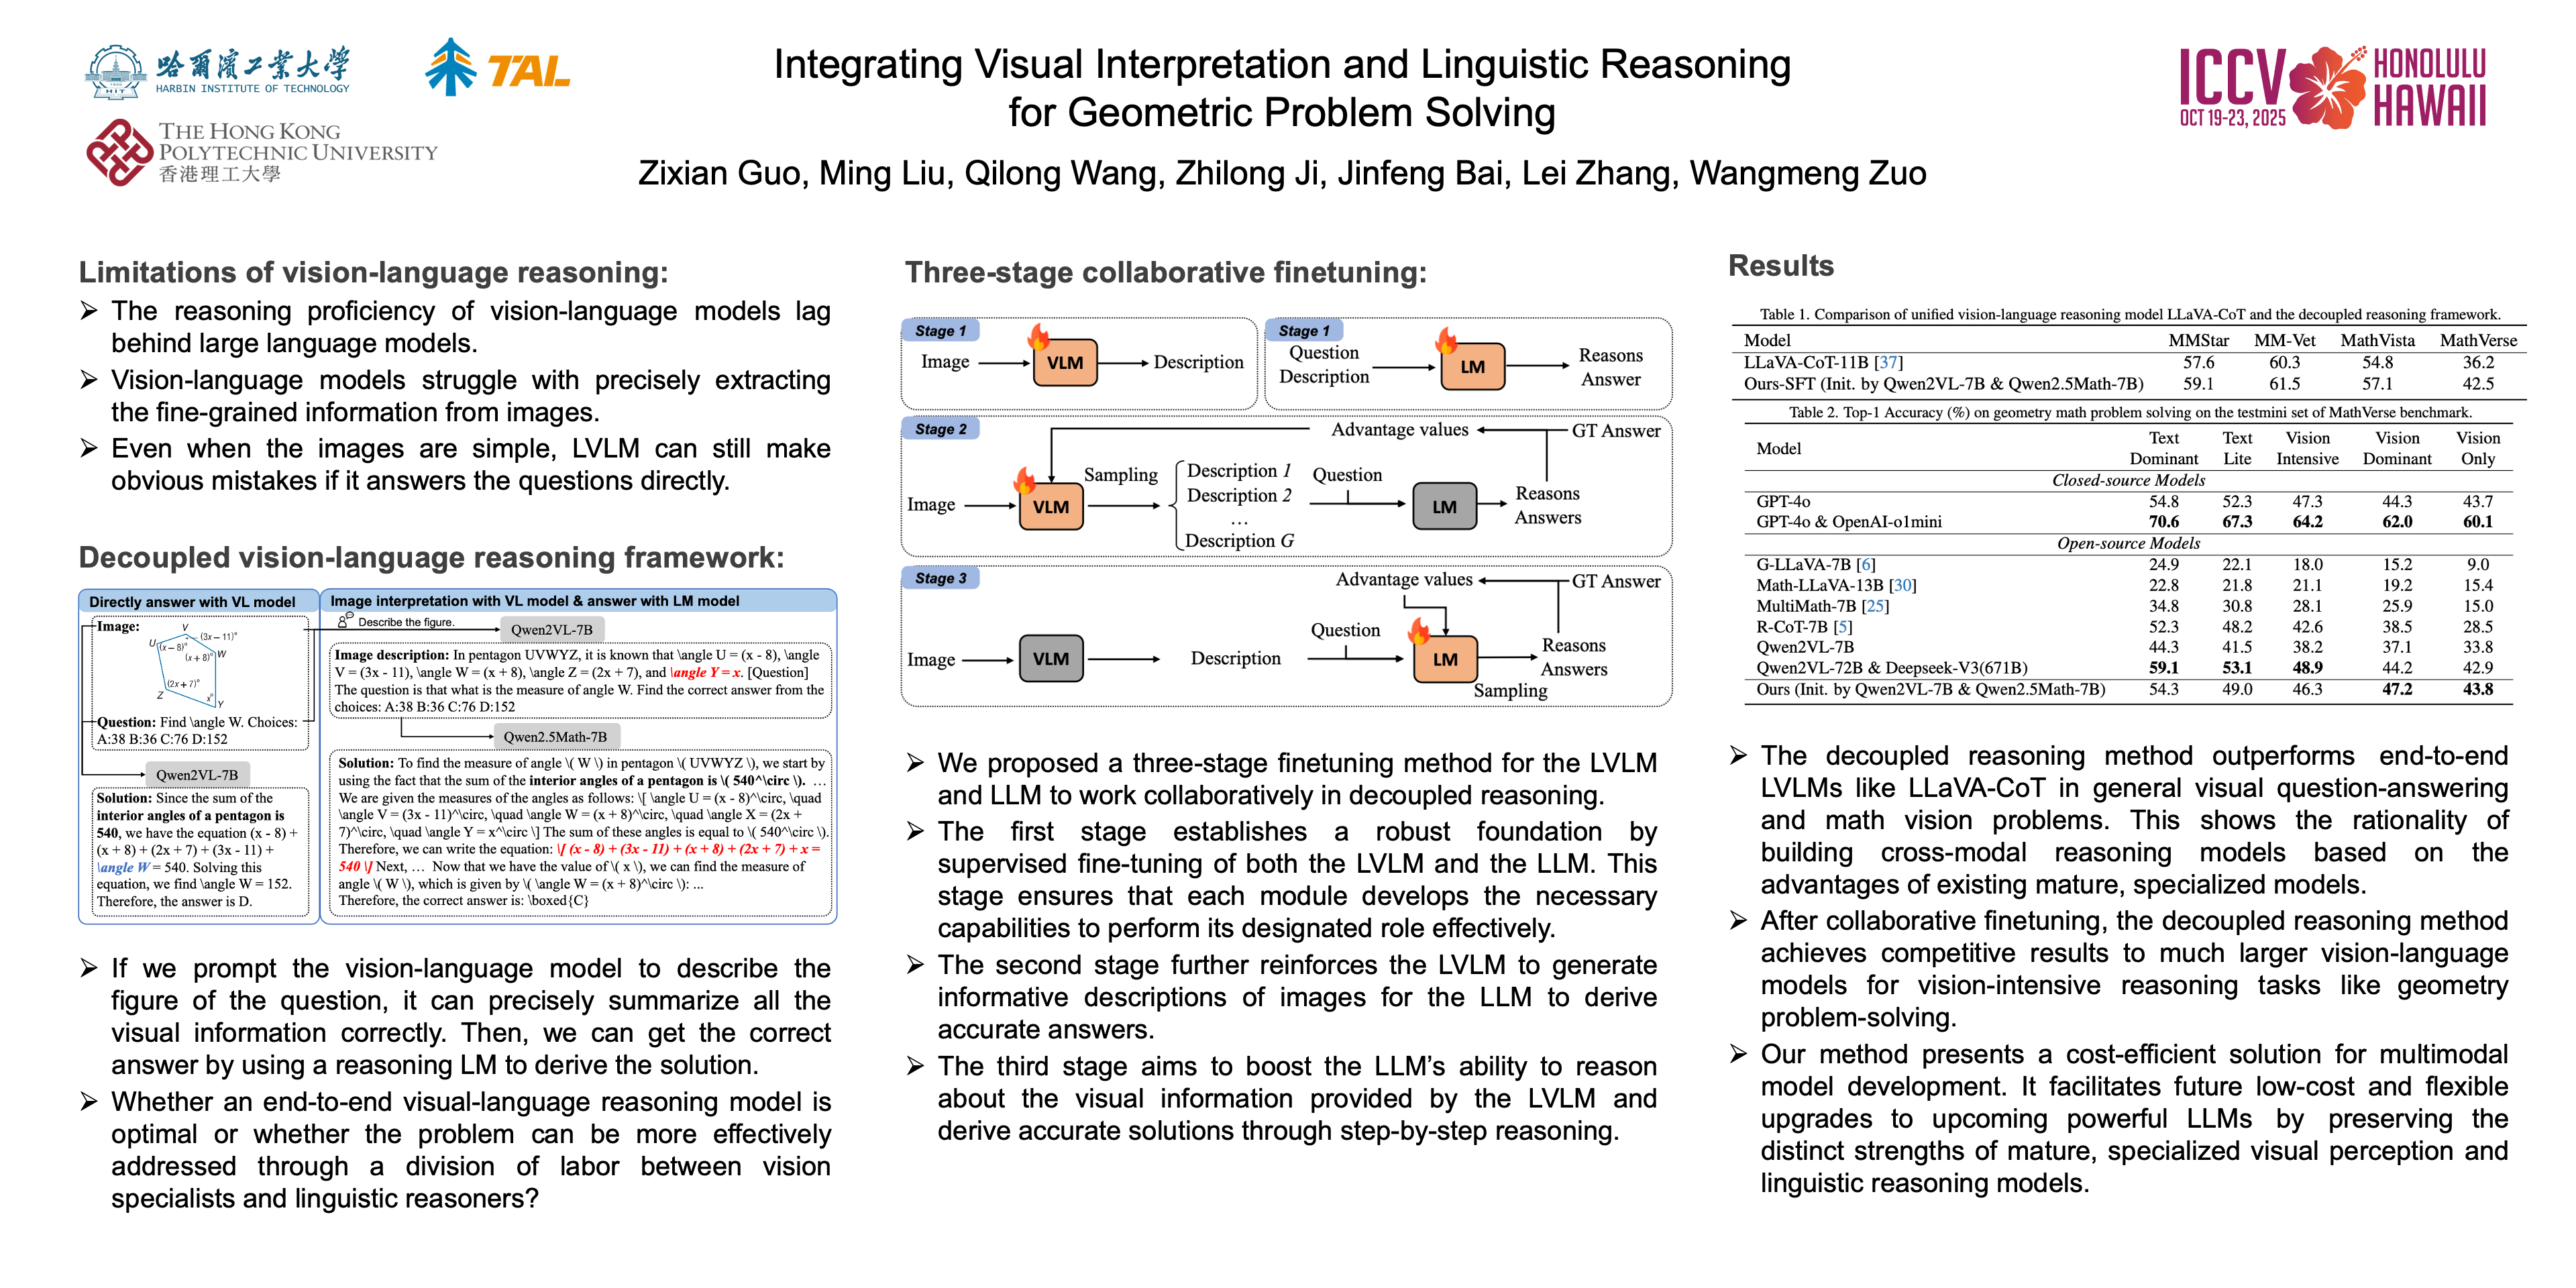
ICCV Poster Integrating Visual Interpretation and Linguistic Reasoning ...