
Instance Aware Group Quantization For Vision Transformers Csdn
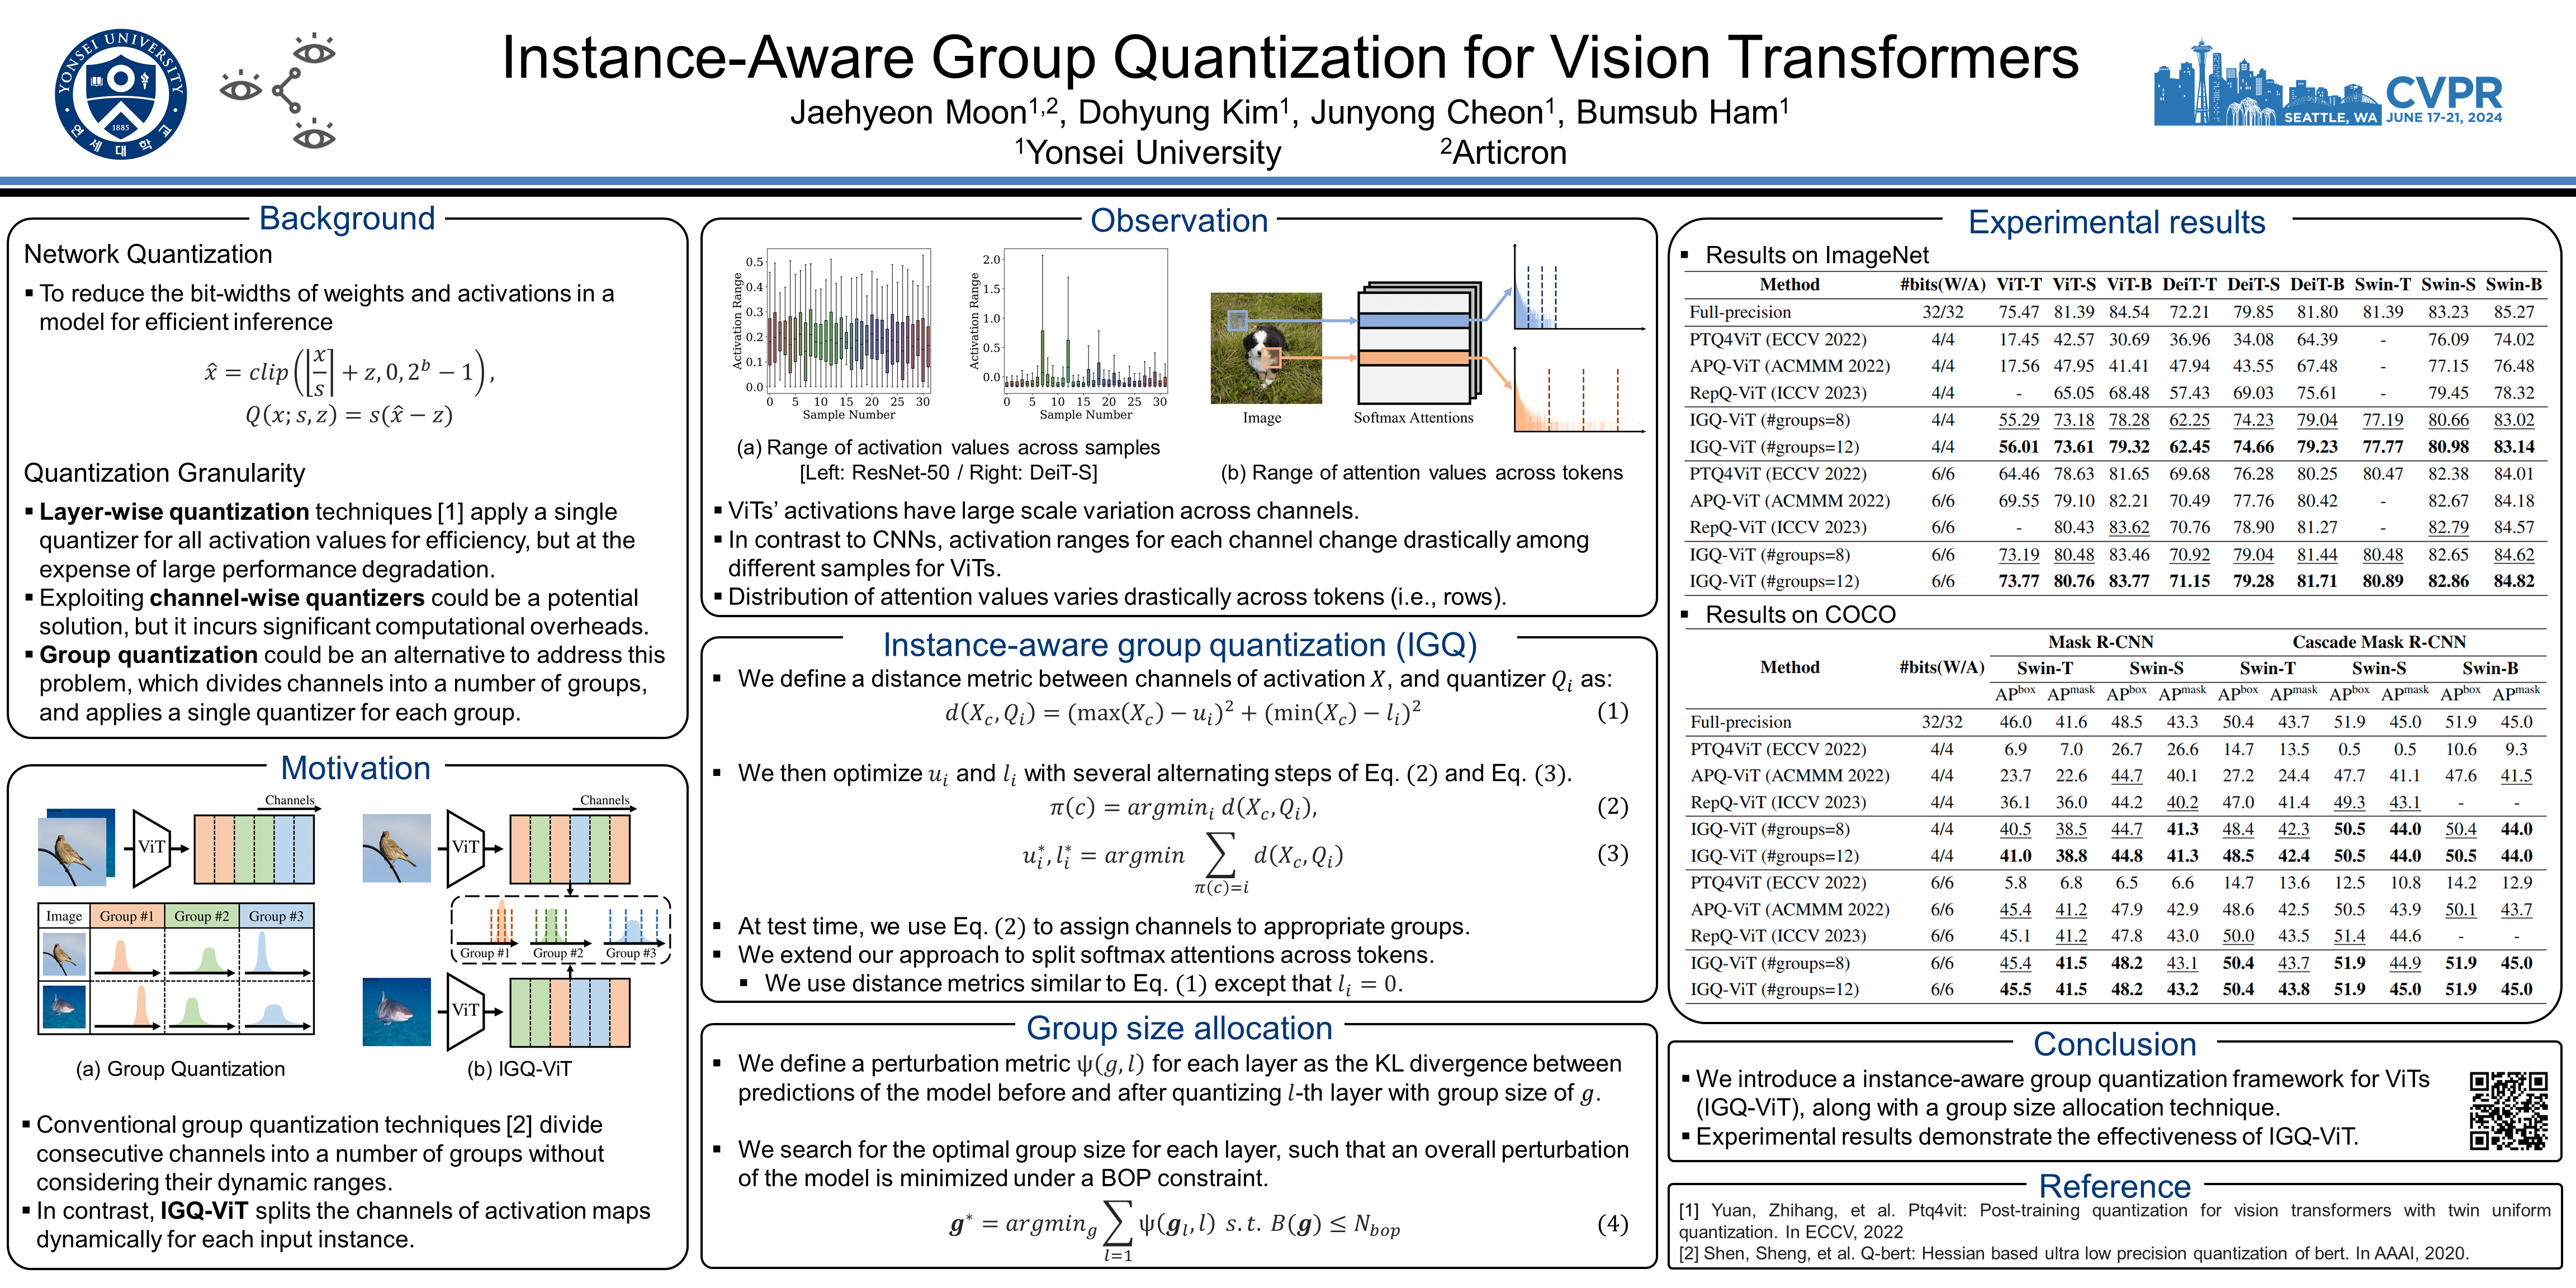
CVPR Poster Instance-Aware Group Quantization for Vision Transformers
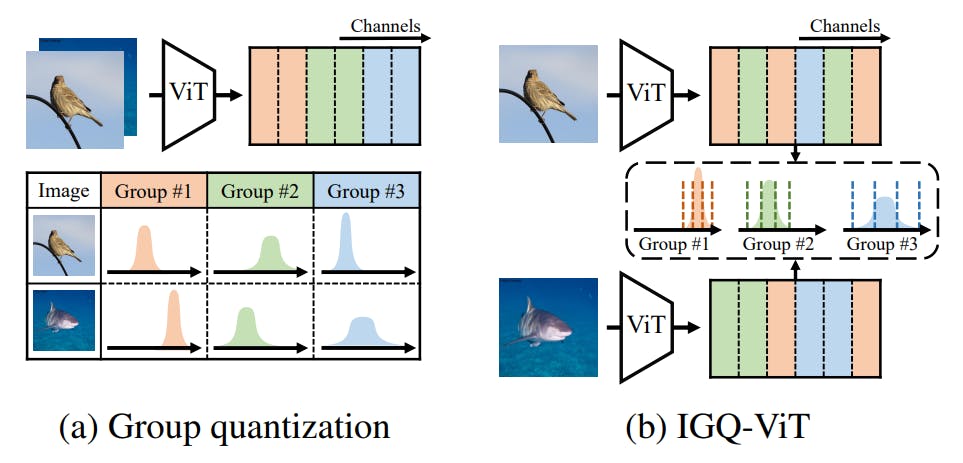
Instance-Aware Group Quantization for Vision Transformers | HackerNoon
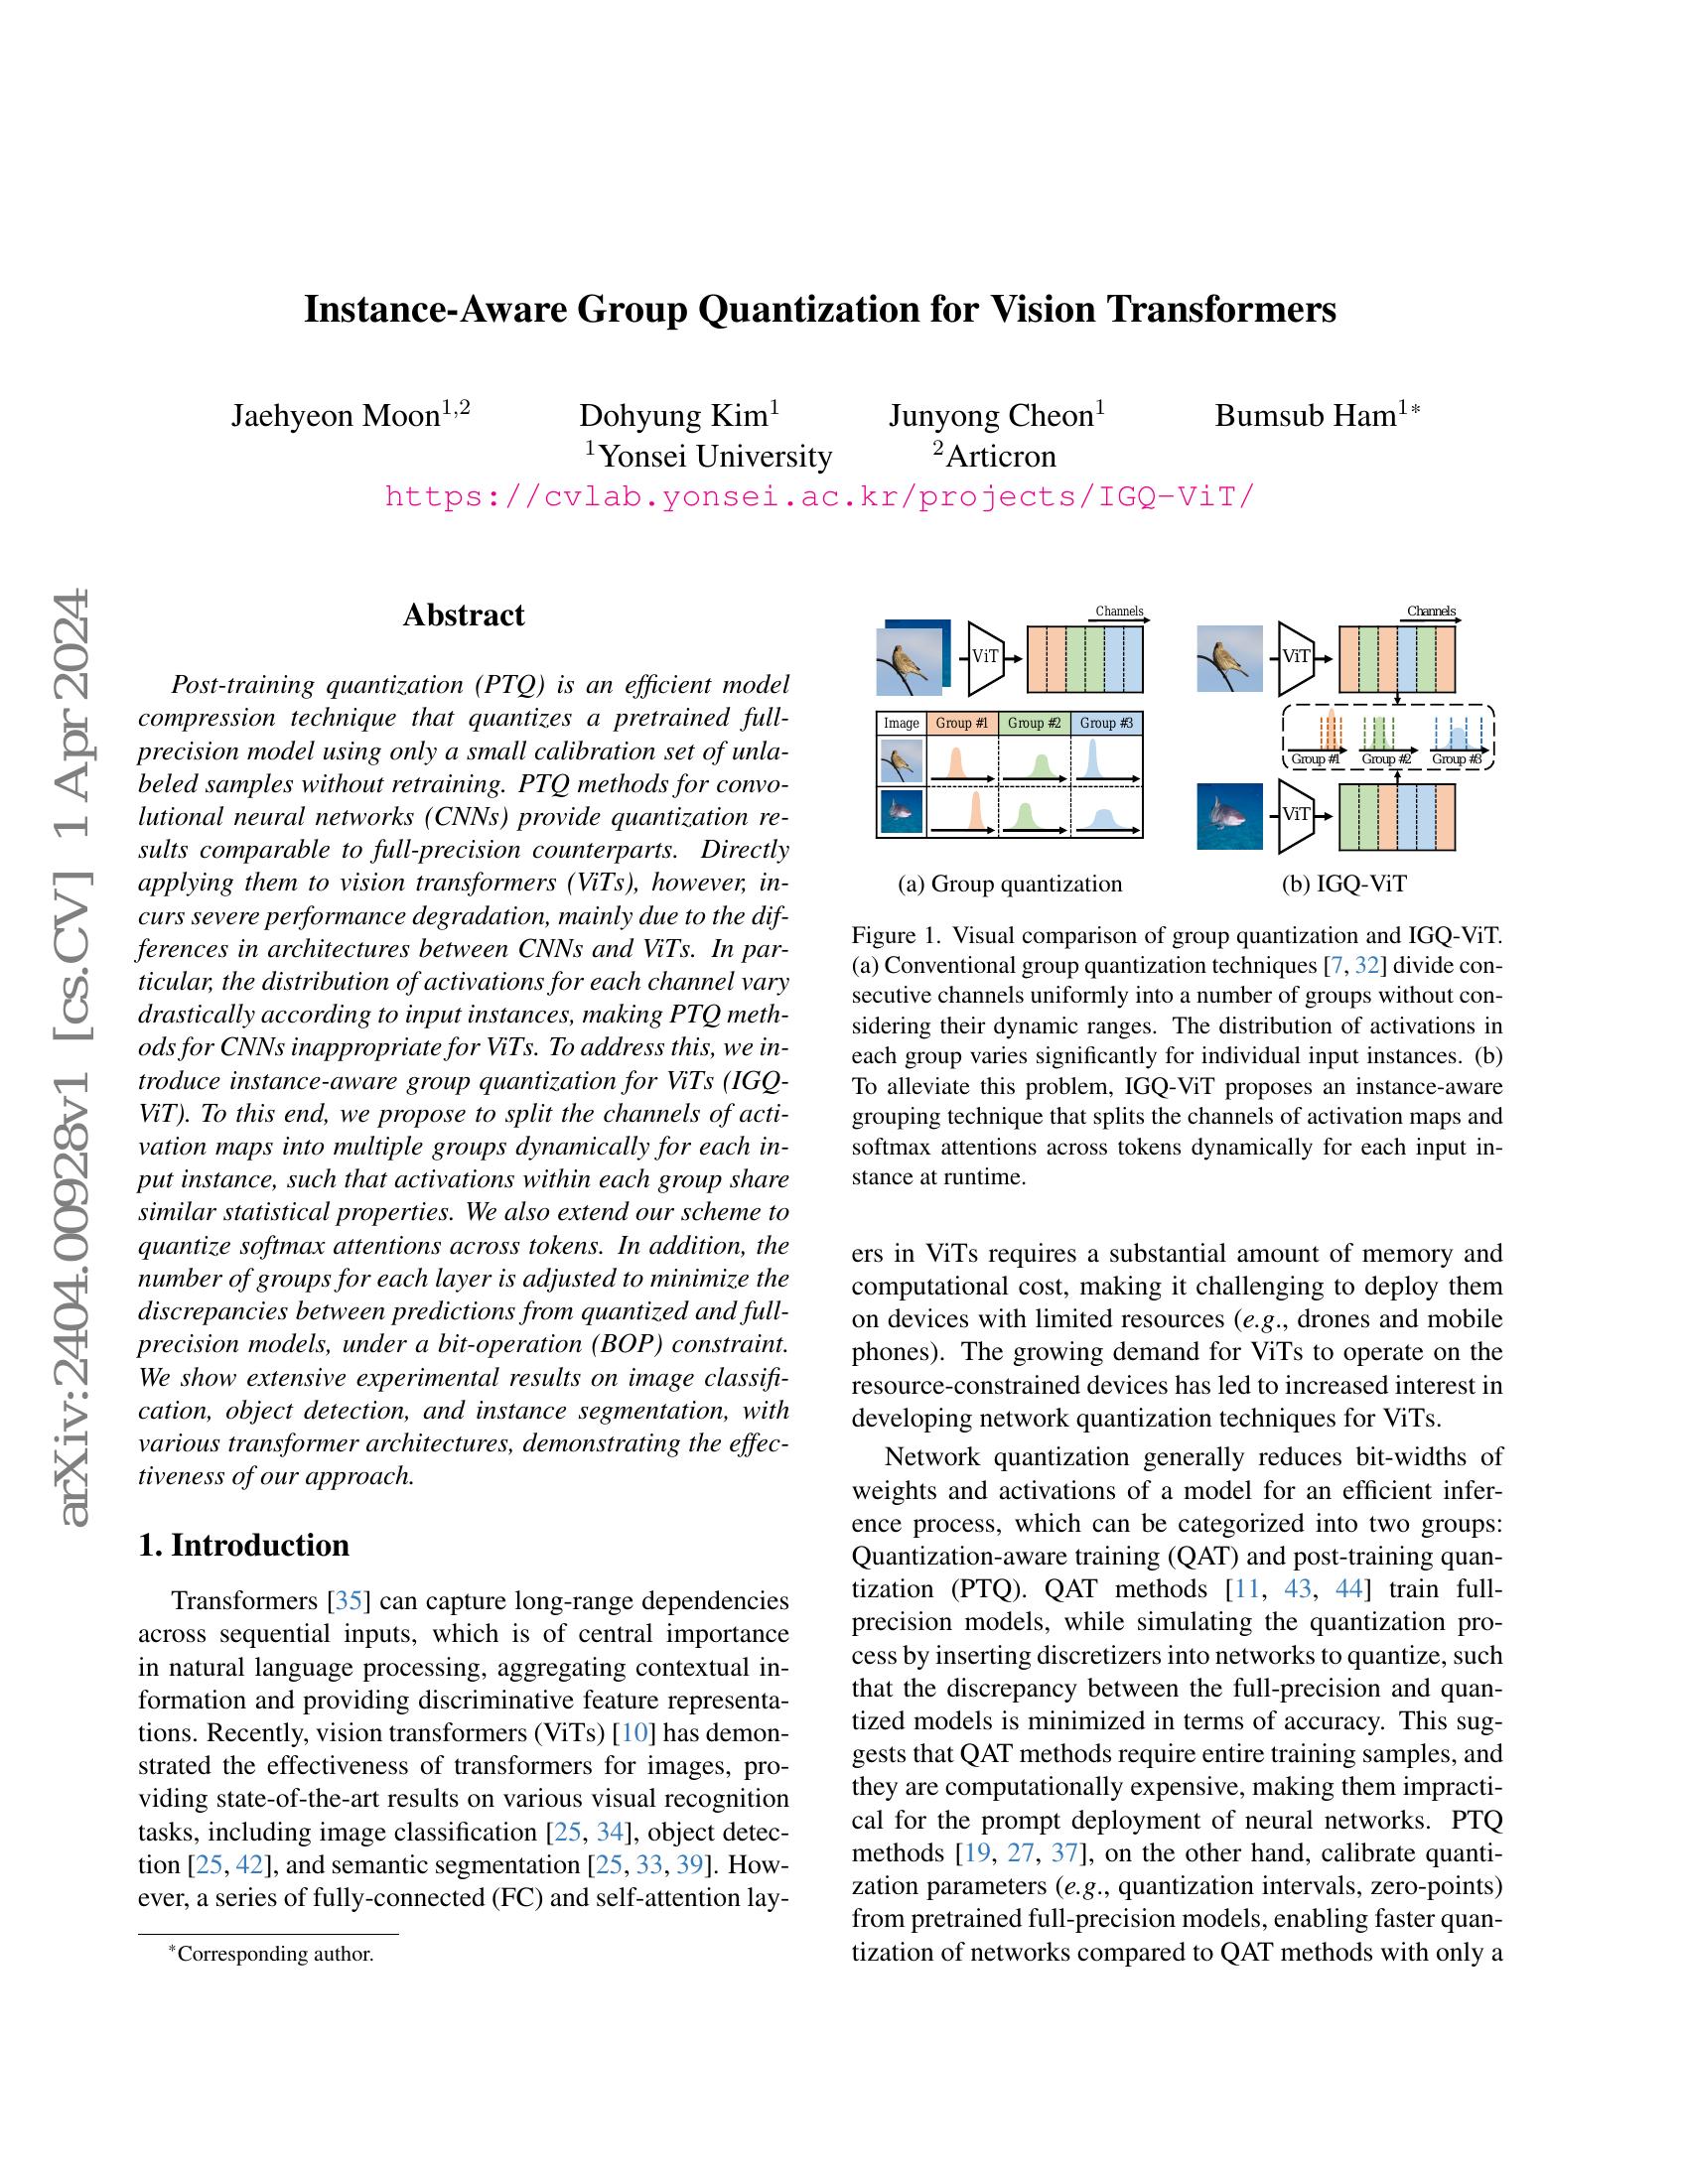
Instance-Aware Group Quantization for Vision Transformers - 智源社区论文
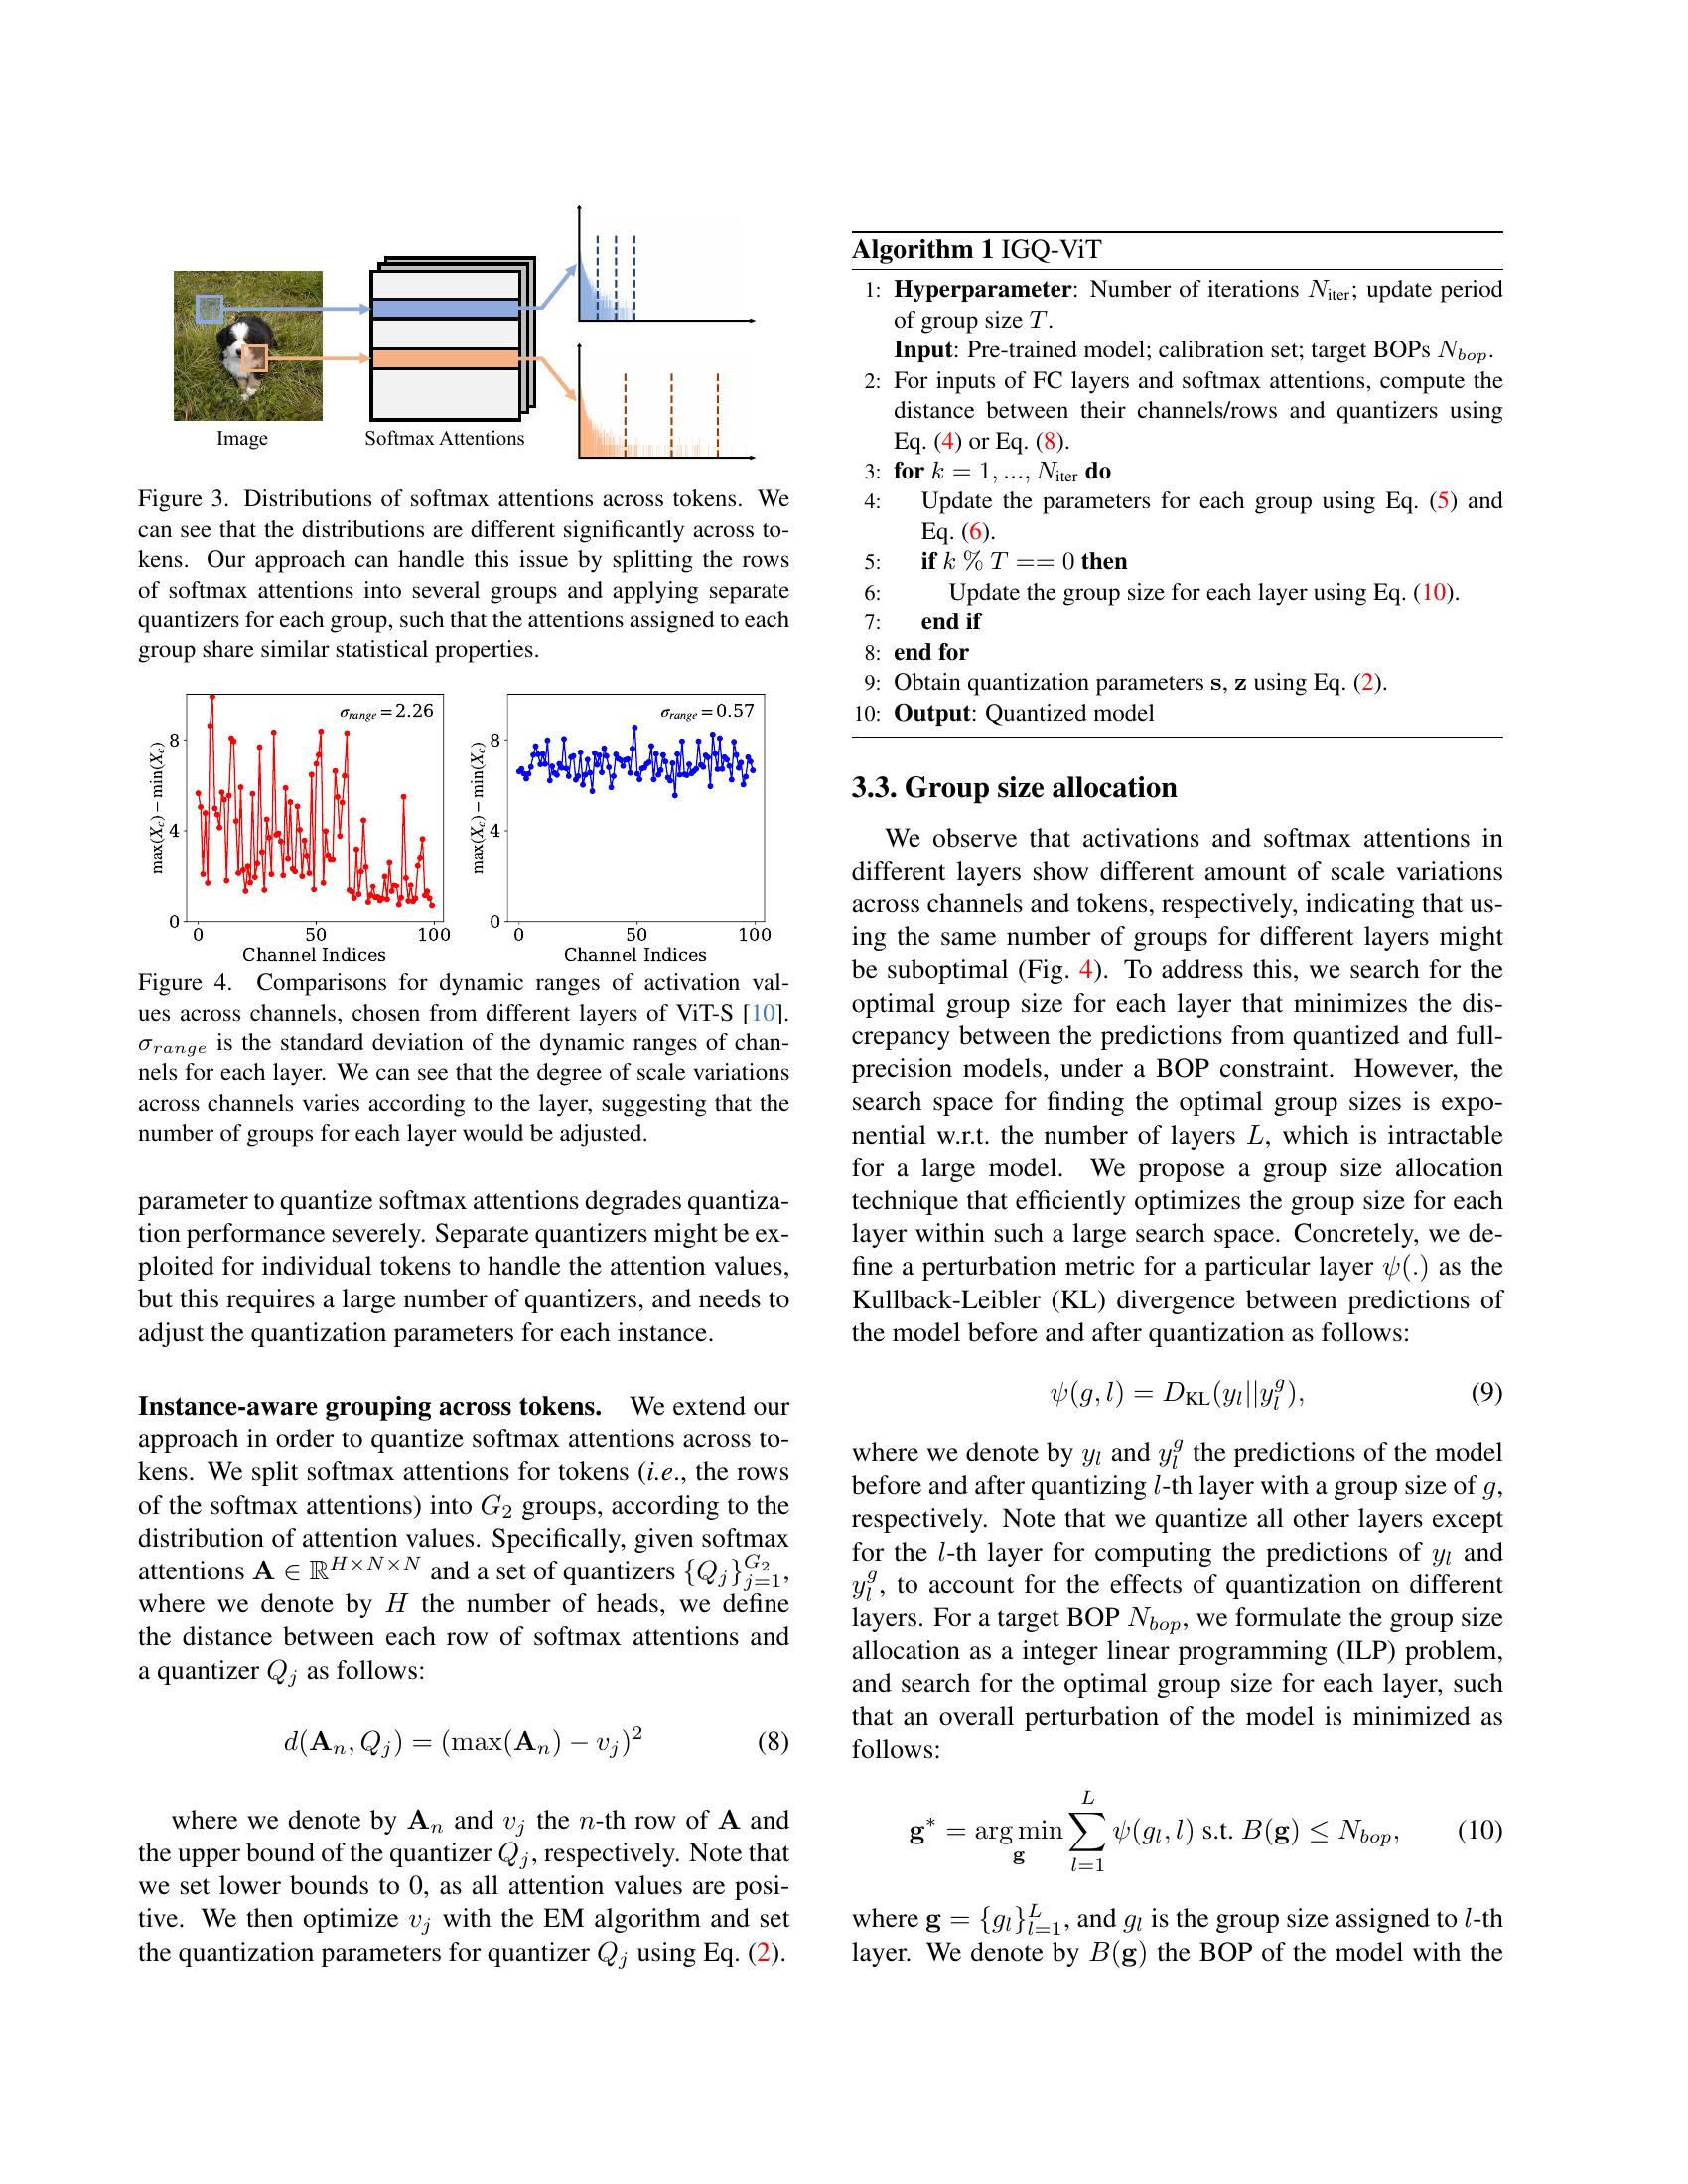
Instance-Aware Group Quantization for Vision Transformers - 智源社区论文

【量化】Instance-Aware Group Quantization for Vision Transformers.-CSDN博客

PTQ4ViT: Post-Training Quantization for Vision Transformers with Twin ...

【量化】PTQ4ViT: Post-Training Quantization for Vision Transformers with ...

(PDF) TAQ: Top-K Attention-Aware Quantization for Vision Transformers

TAQ: TOP-K ATTENTION-AWARE QUANTIZATION FOR VISION TRANSFORMERS | SPS ...

[2203.02250] Patch Similarity Aware Data-Free Quantization for Vision ...
Advertisement Space (300x250)

AdaLog: Post-Training Quantization for Vision Transformers with ...

AdaLog: Post-Training Quantization for Vision Transformers with ...

Paper page - AdaLog: Post-Training Quantization for Vision Transformers ...

VIT quantization相关论文阅读_post-training quantization for vision ...

Figure 1 from Post-Training Quantization for Vision Transformer in ...
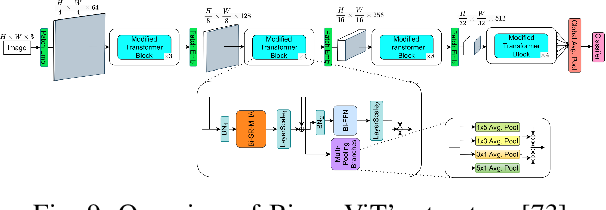
Figure 9 from Model Quantization and Hardware Acceleration for Vision ...
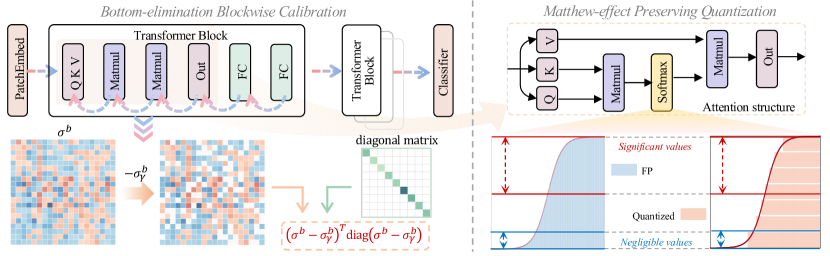
[2303.14341] Towards Accurate Post-Training Quantization for Vision ...

FQ-ViT: Post-Training Quantization for Fully Quantized Vision ...
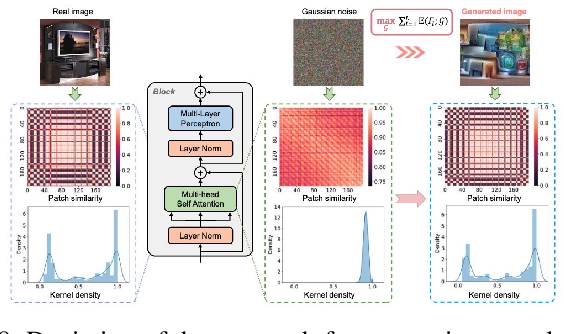
Figure 8 from Model Quantization and Hardware Acceleration for Vision ...
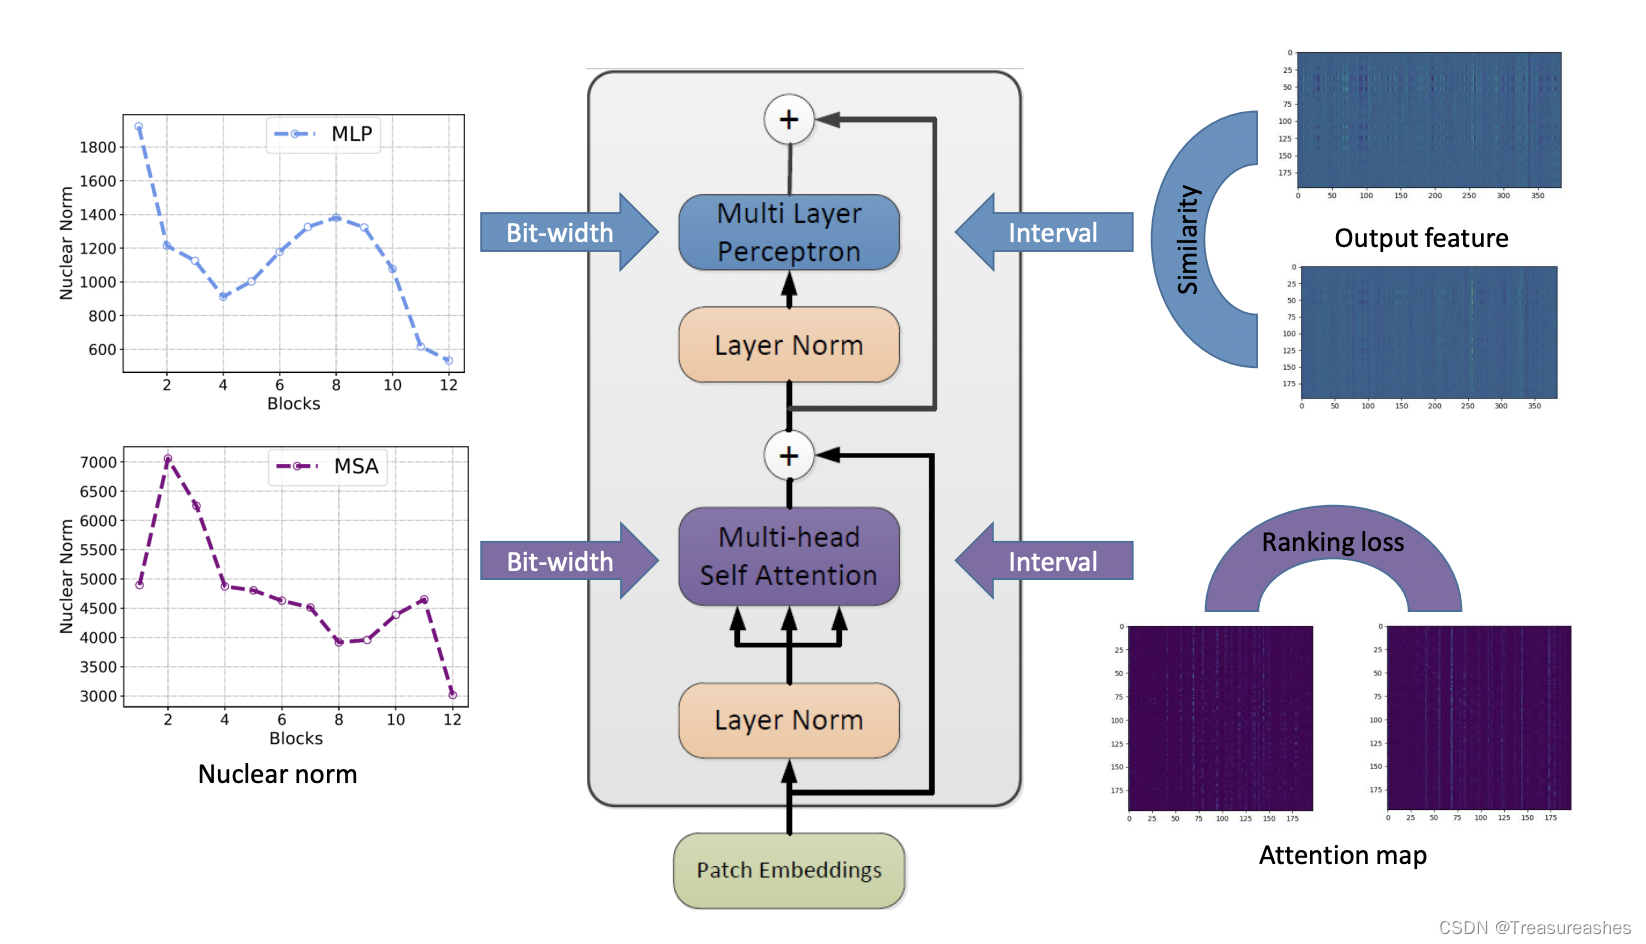
【量化】Post-Training Quantization for Vision Transformer-CSDN博客
Advertisement Space (336x280)
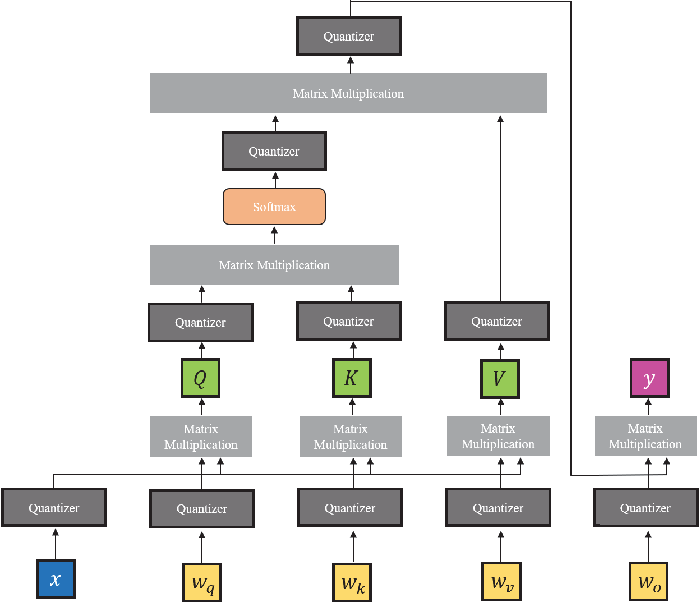
Figure 1 from Fixed-point Quantization for Vision Transformer ...
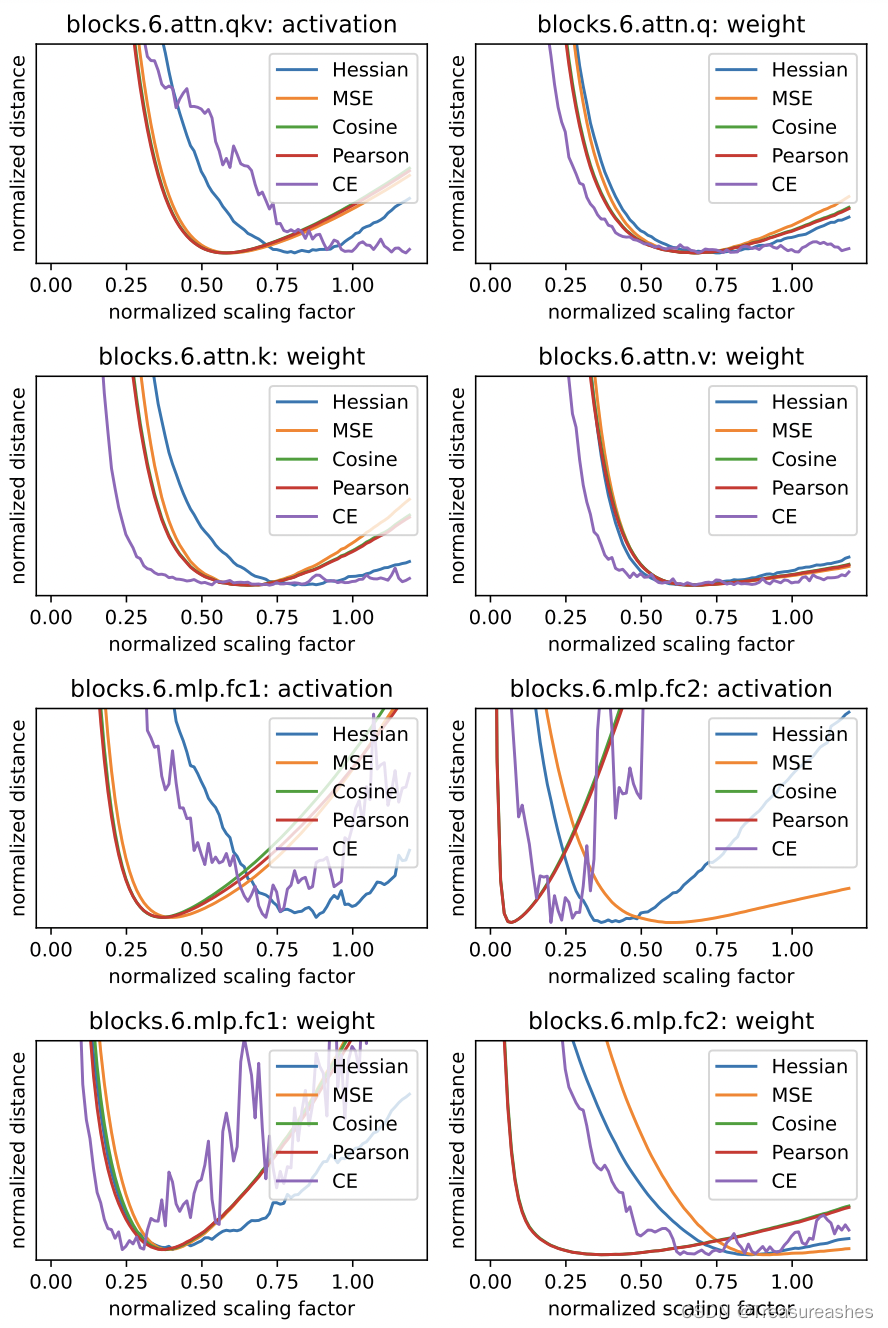
【量化】PTQ4ViT: Post-Training Quantization Framework for Vision ...

(PDF) Scaled Quantization for the Vision Transformer
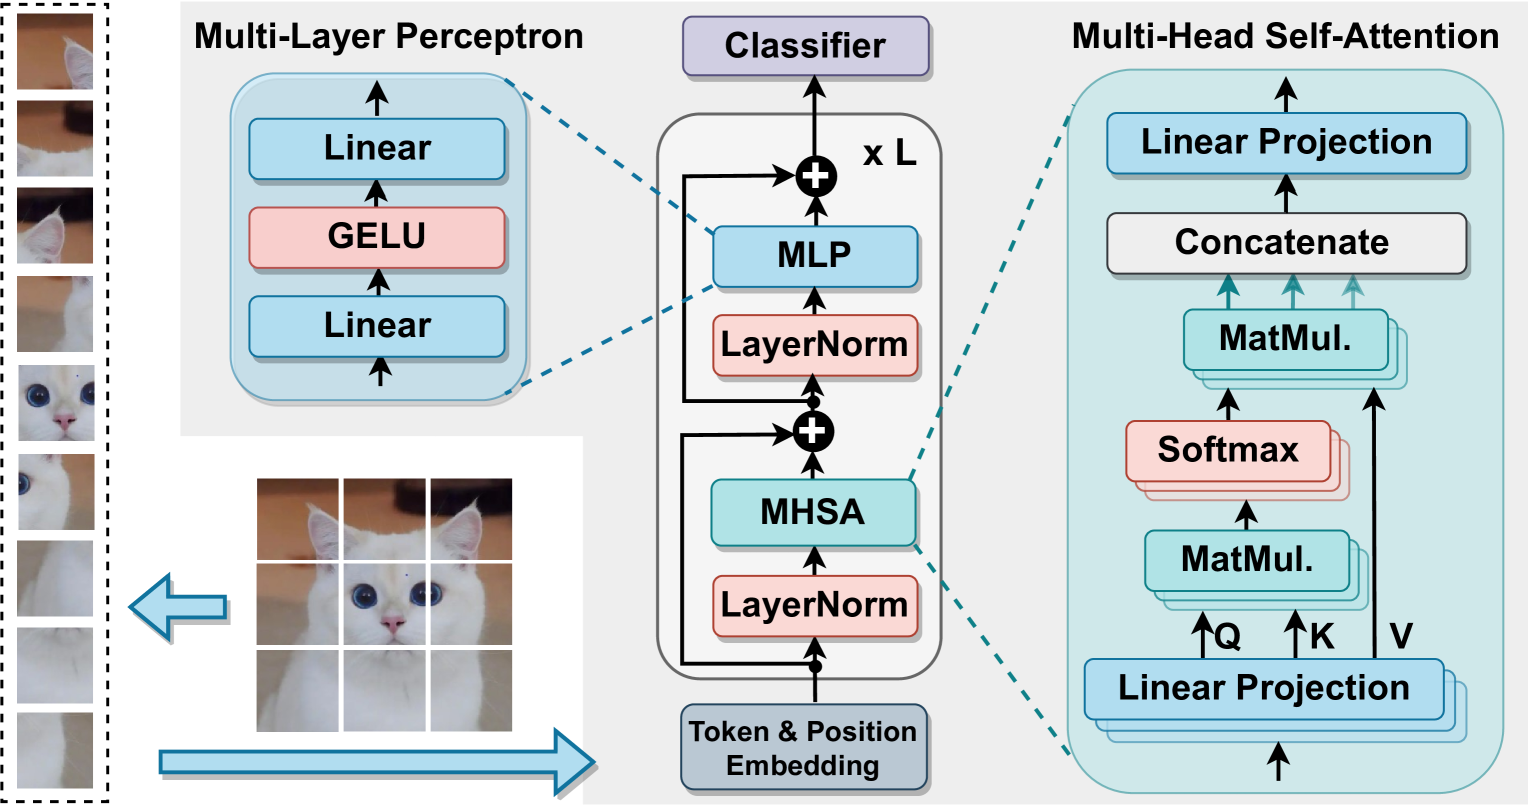
Model Quantization and Hardware Acceleration for Vision Transformers: A ...

(PDF) TSPTQ-ViT: Two-scaled post-training quantization for vision ...

VIT quantization相关论文阅读_post-training quantization for vision ...

FQ-ViT: Post-Training Quantization for Fully Quantized Vision ...
TSPTQ-ViT: TWO-SCALED POST-TRAINING QUANTIZATION FOR VISION TRANSFORMER ...
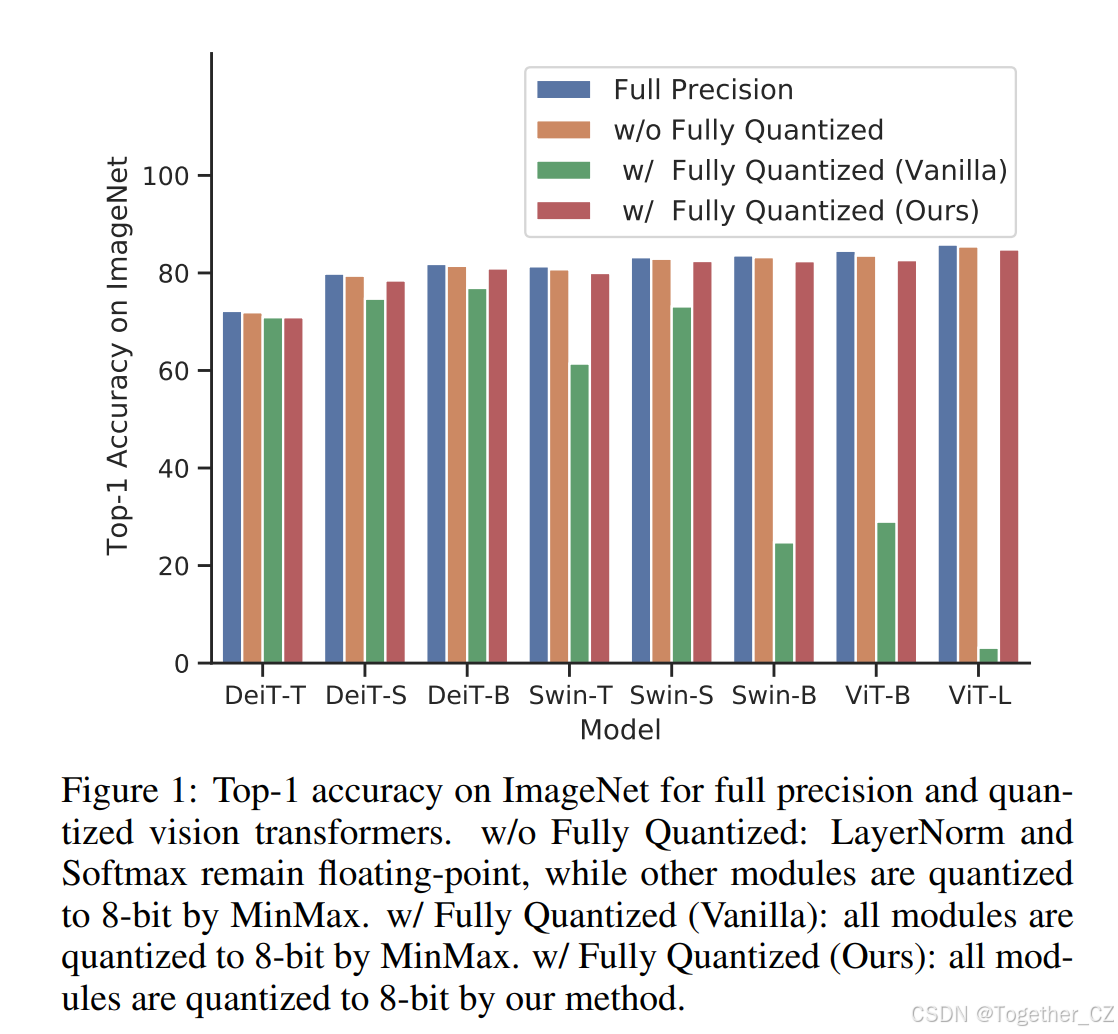
FQ-ViT: Post-Training Quantization for Fully Quantized Vision ...

(PDF) Q-ViT: Fully Differentiable Quantization for Vision Transformer
Advertisement Space (336x280)
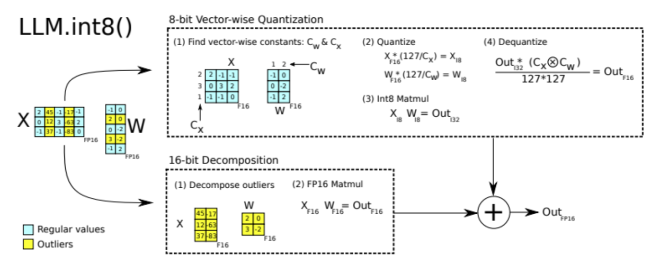
Fast and Accurate GPU Quantization for Transformers

Joint Post-Training Quantization of Vision Transformers with Learned ...

MGRQ: Post-Training Quantization For Vision Transformer With Mixed ...

Vision Transformers for Image Classification: A Comparative Survey

Figure 1 from Fixed-point Quantization for Vision Transformer ...

Figure 4 from Model Quantization and Hardware Acceleration for Vision ...