
Learning Text Image Joint Embedding For Efficient Cross Modal Retrieval

Learning Text-Image Joint Embedding for Efficient Cross-Modal Retrieval ...

Figure 1 from Learning Text-image Joint Embedding for Efficient Cross ...

Learning Text-Image Joint Embedding for Efficient Cross-Modal Retrieval ...

Figure 1 from Learning Joint Embedding for Cross-Modal Retrieval ...

(PDF) Learning Joint Embedding for Cross-Modal Retrieval

Learning TFIDF Enhanced Joint Embedding for Recipe-Image Cross-Modal ...
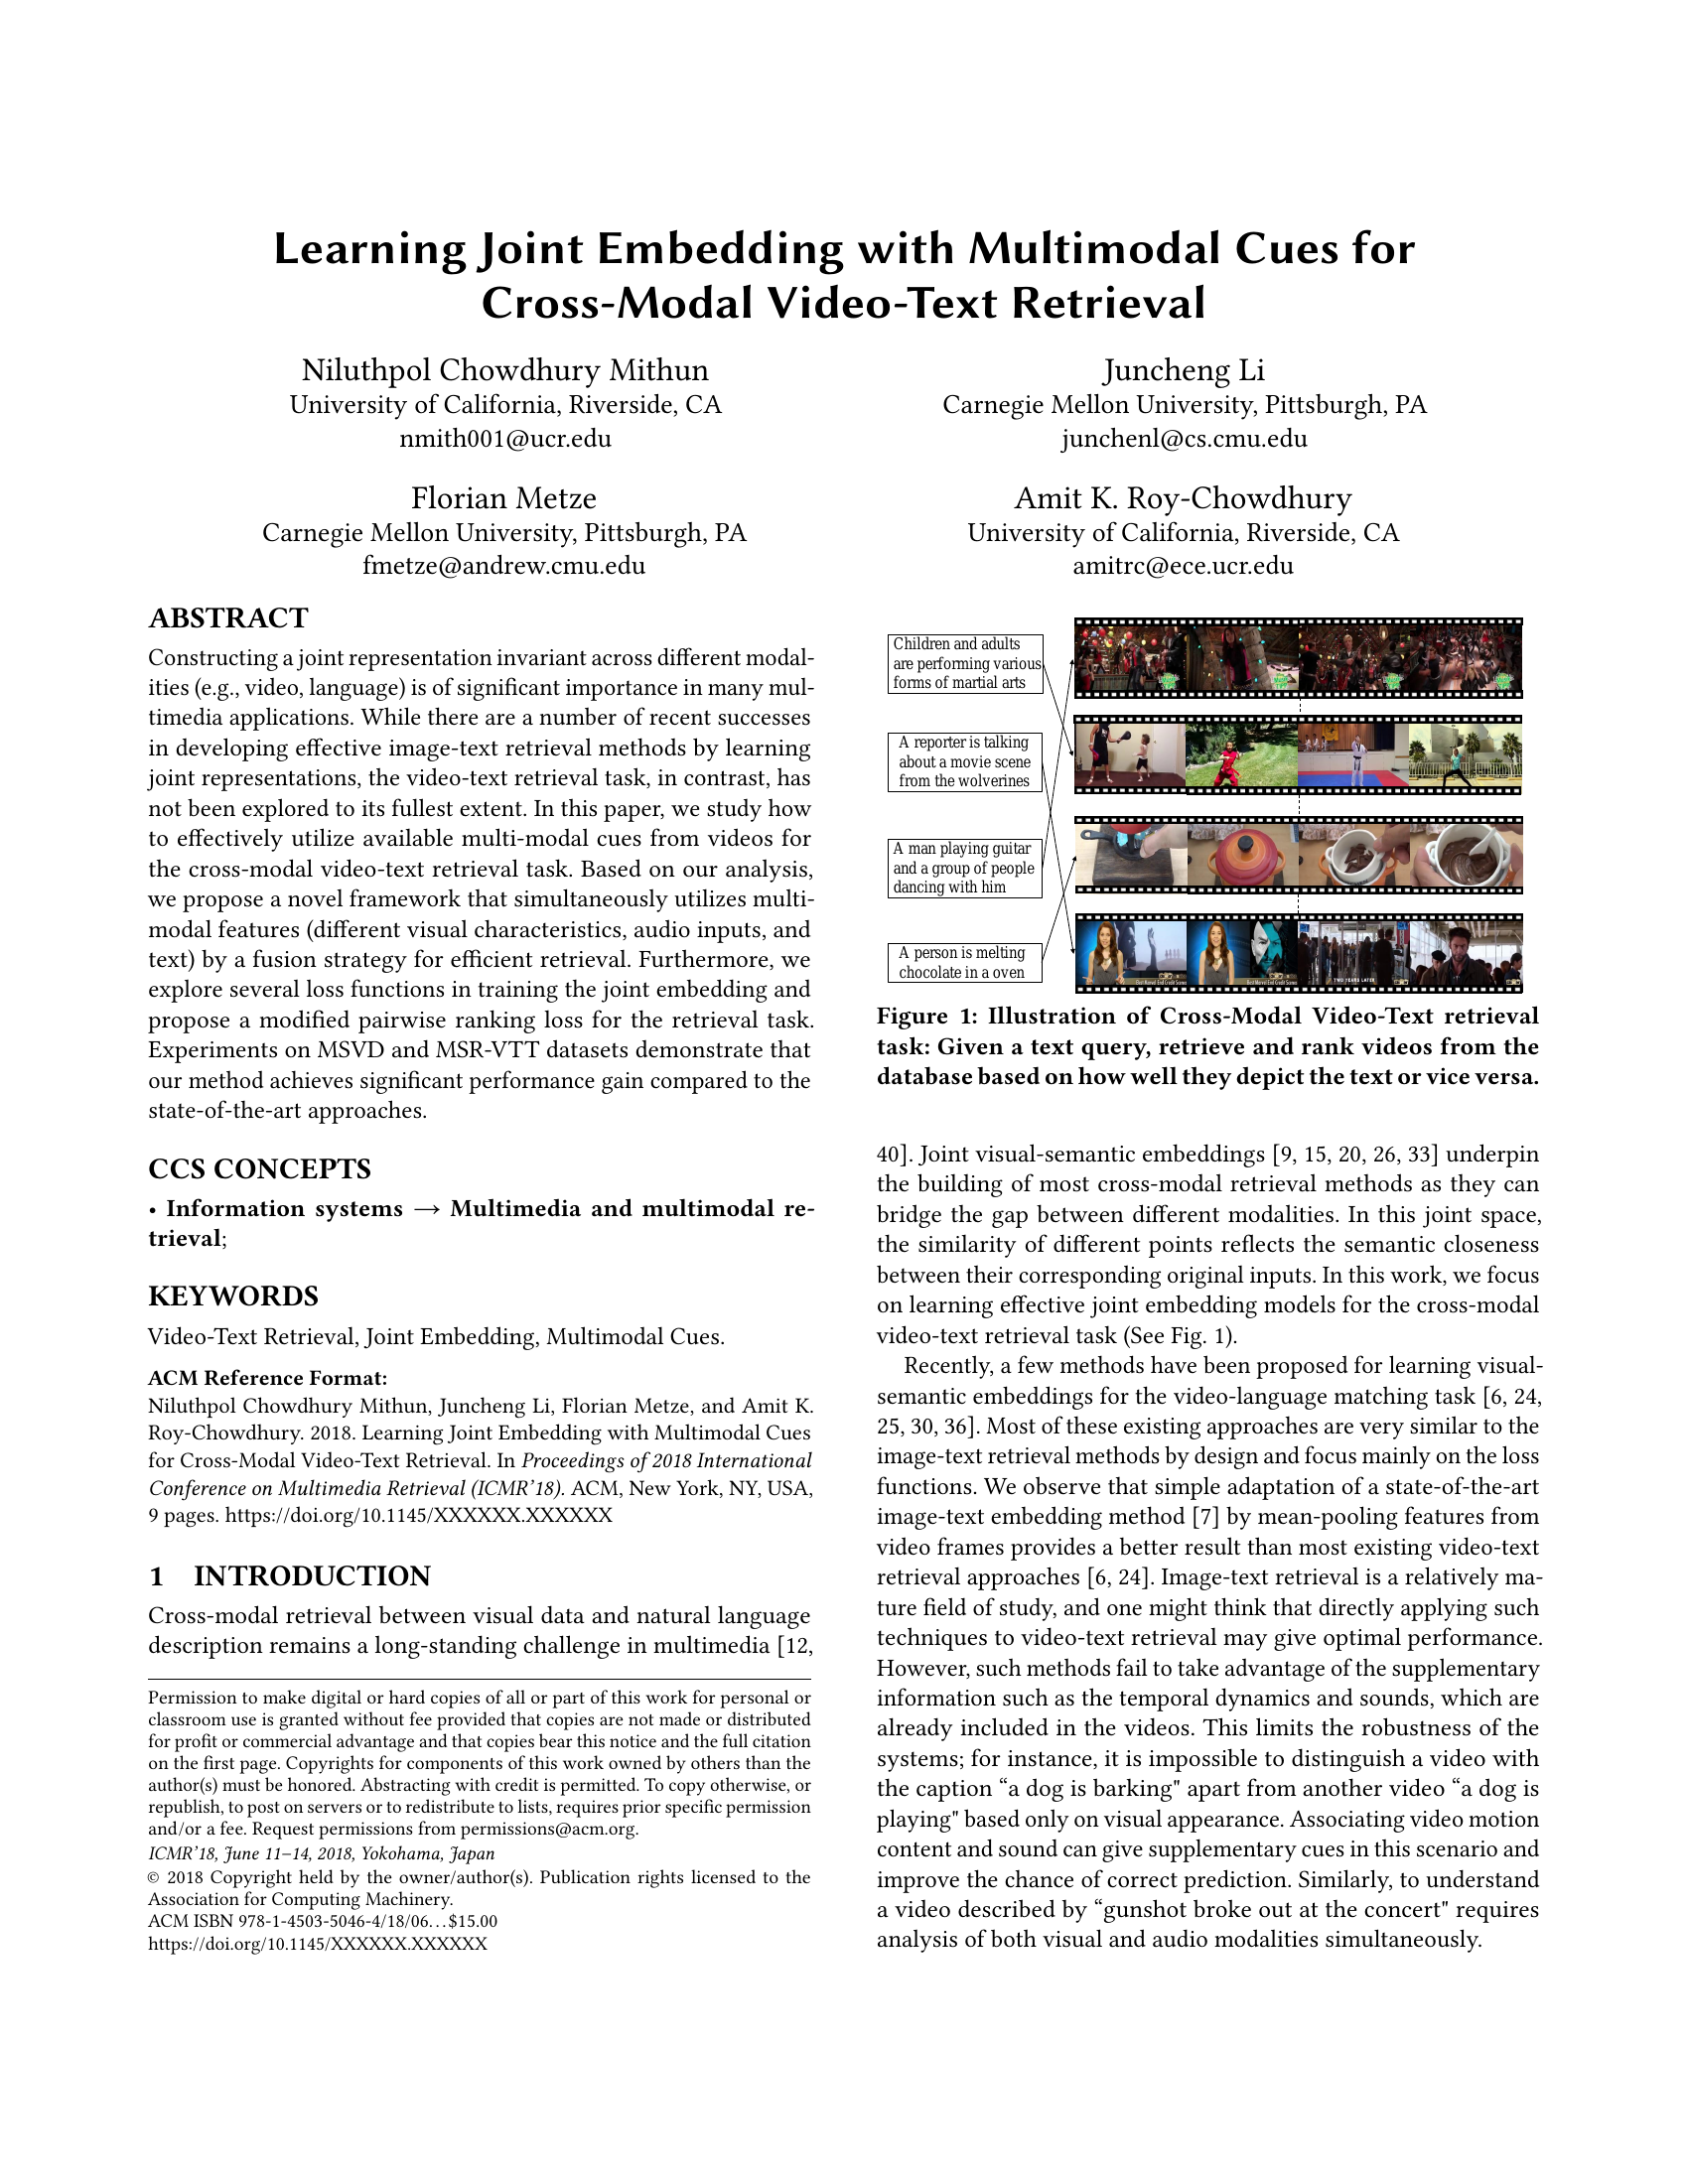
Learning Joint Embedding with Multimodal Cues for Cross-Modal Video ...

A Cross‐Modal Image and Text Retrieval Method Based on Efficient ...

Learning Joint Embedding with Multimodal Cues for Cross-Modal Video ...

Cross-modal Contrastive Learning for Generalizable and Efficient Image ...
Advertisement Space (300x250)

(PDF) Webly Supervised Joint Embedding for Cross-Modal Image-Text Retrieval

(PDF) A Cross-Modal Image and Text Retrieval Method Based on Efficient ...

Cross-modal Contrastive Learning for Generalizable and Efficient Image ...

Learning Cross-Modal Deep Embeddings for Multi-Object Image Retrieval ...

(PDF) Adversarial Attentive Multi-Modal Embedding Learning for Image ...

Tri-Modal Motion Retrieval by Learning a Joint Embedding Space

VISTA: Visualized Text Embedding For Universal Multi-Modal Retrieval ...
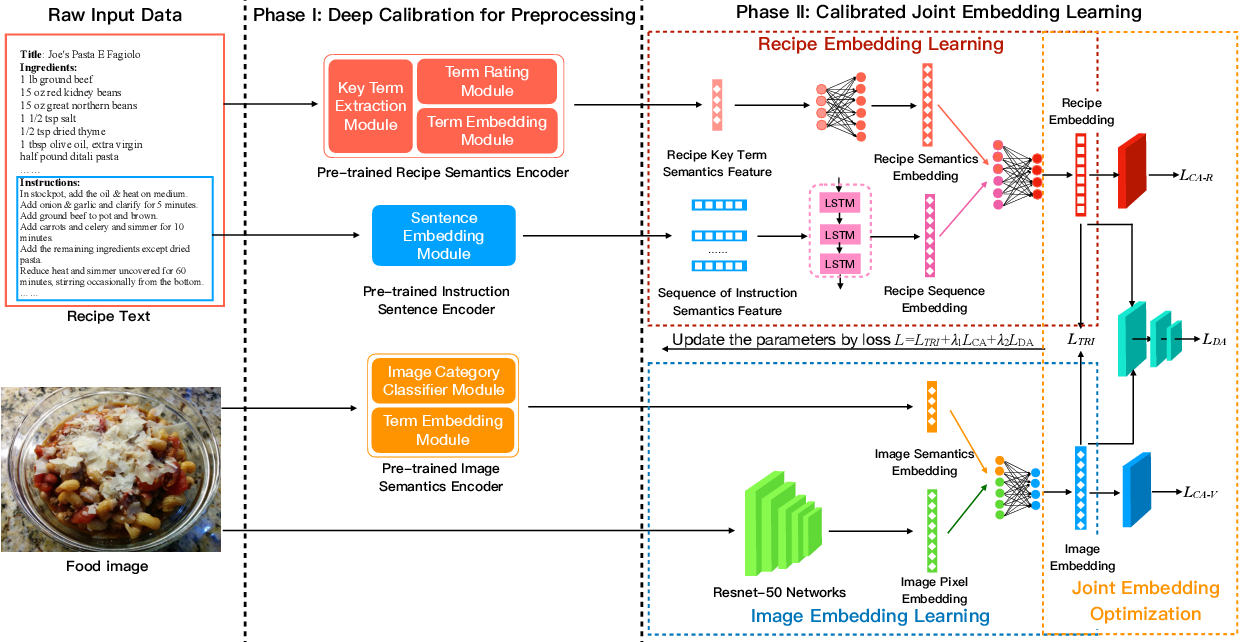
Figure 1 from Efficient Deep Feature Calibration for Cross-Modal Joint ...

Figure 2 from Adversarial Multi-Grained Embedding Network for Cross ...

Cross-Modal Retrieval for Motion and Text via DropTriple Loss
Advertisement Space (336x280)

[논문 리뷰] VISTA: Visualized Text Embedding For Universal Multi-Modal ...

(PDF) Memory Enhanced Embedding Learning for Cross-Modal Video-Text ...

(PDF) Learning Cross-Modal Deep Embeddings for Multi-Object Image ...

Robust Dual Embedding Contrastive Learning for Text-to-Image Person Re ...

The cross-modal retrieval task includes image retrieving text and text ...
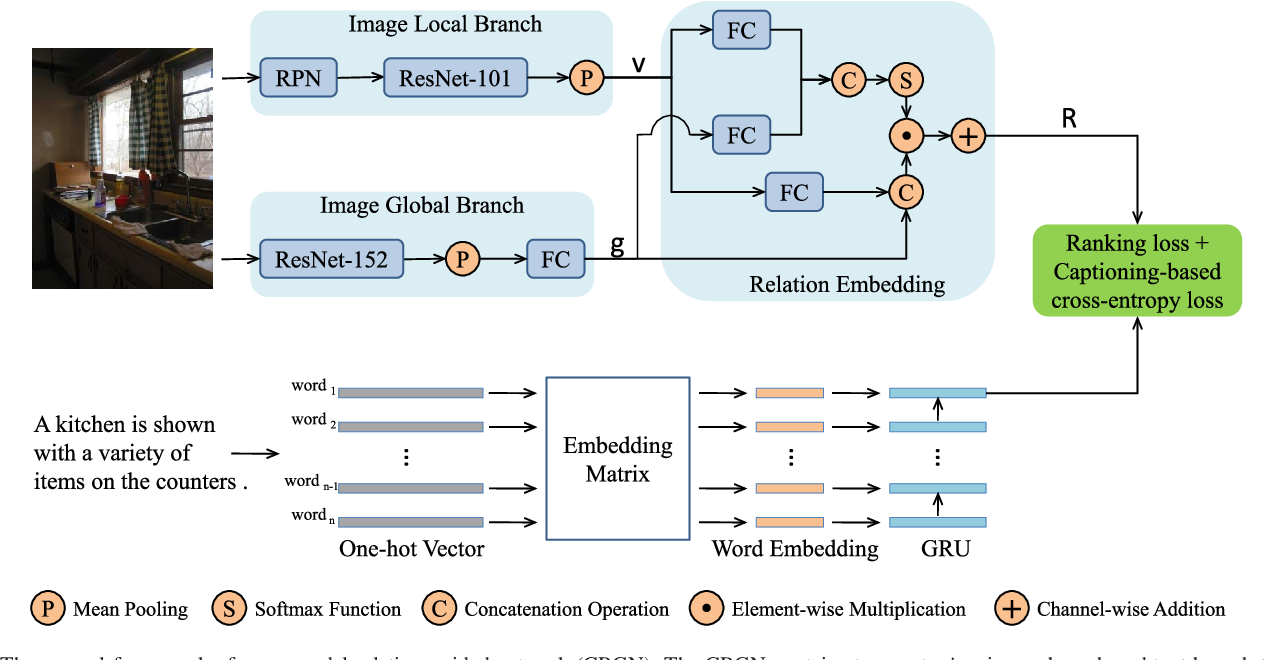
Figure 1 from Deep Relation Embedding for Cross-Modal Retrieval ...

Joint feature fusion hashing for cross-modal retrieval

Illustration of the joint embedding technique for code retrieval. Two ...

(PDF) Learning Disentangled Representation for Cross-Modal Retrieval ...

(PDF) Deep Neural Architecture for Multi-Modal Retrieval based on Joint ...
Advertisement Space (336x280)
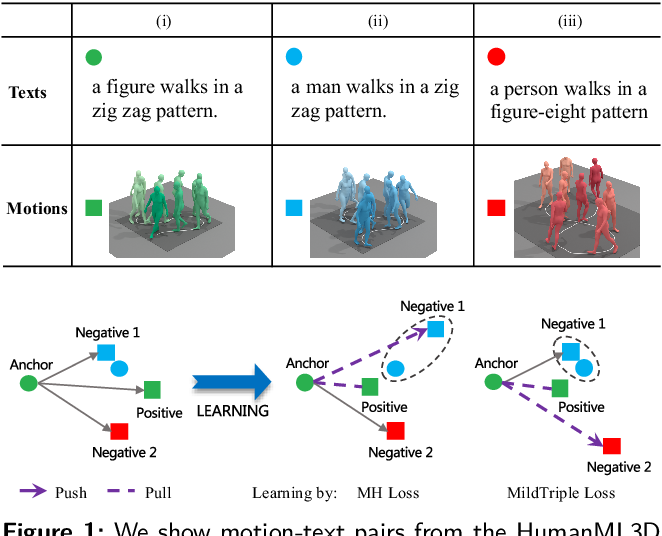
Figure 1 from Cross-Modal Retrieval for Motion and Text via MildTriple ...

Image retrieval task. A tweet’s components are projected in the joint ...

Cross-Modal Retrieval for Motion and Text via MildTriple Loss
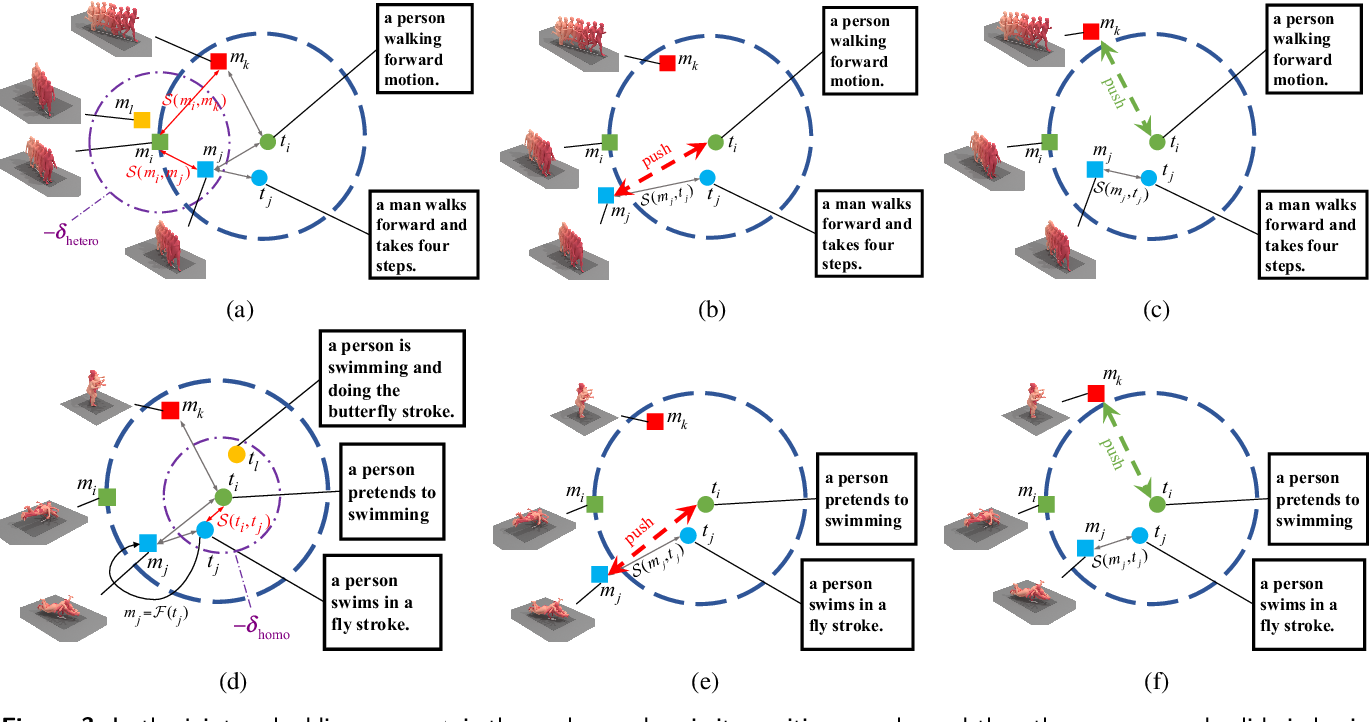
Figure 3 from Cross-Modal Retrieval for Motion and Text via MildTriple ...

CrossCLR: cross-modal contrastive learning for multi-modal video ...

A brief illustration of our proposed framework for learning ...