
Llm Inference Optimization Part 2 Kv Cache Optimization Sotaaz Blog
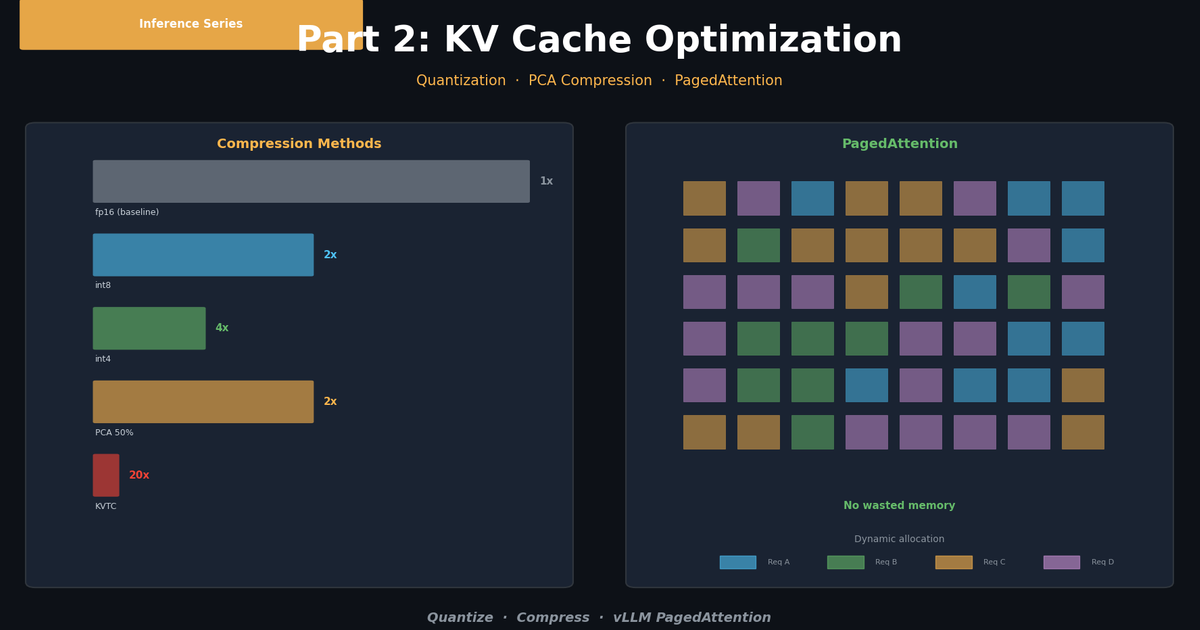
LLM Inference Optimization Part 2 — KV Cache Optimization | SOTAAZ Blog
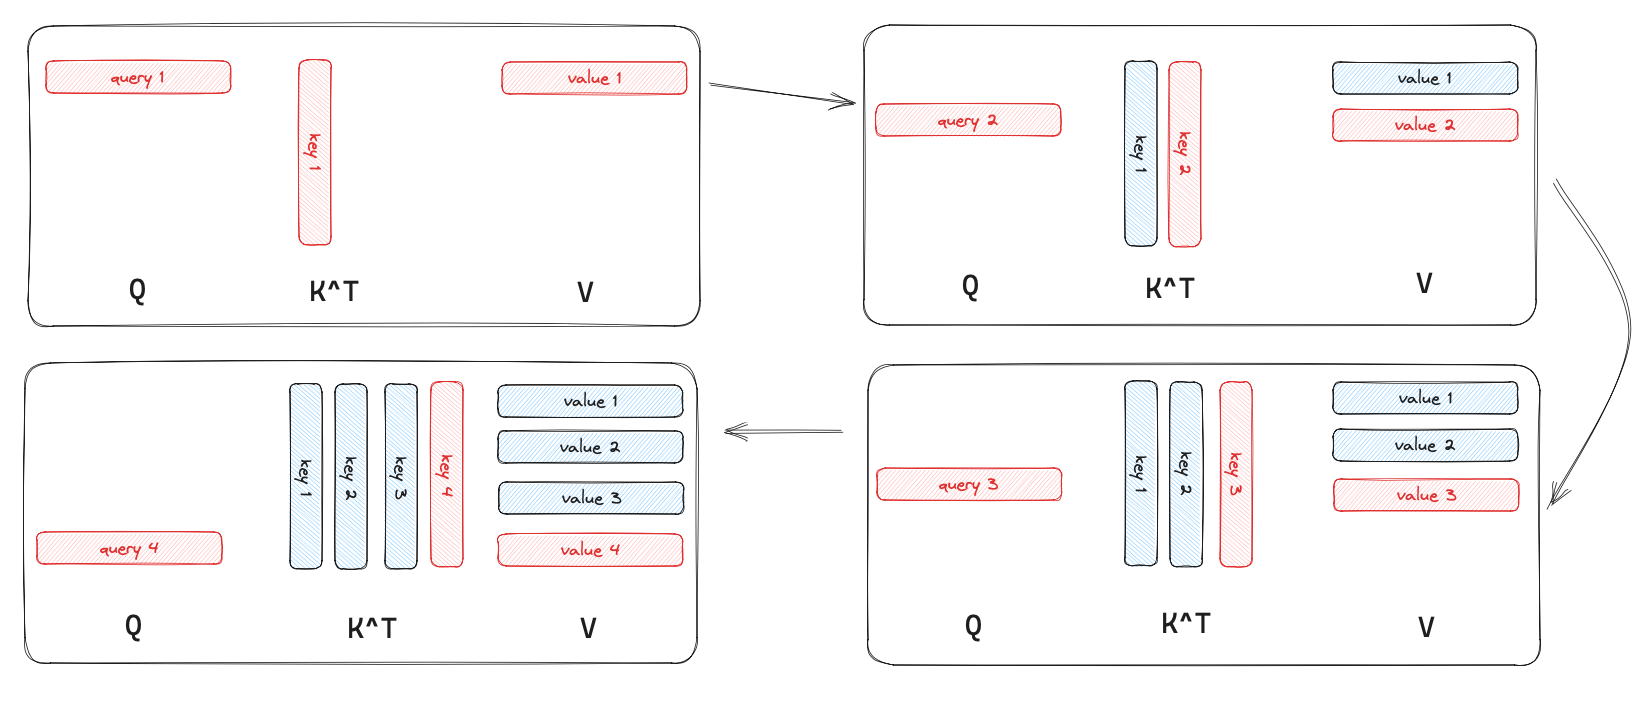
LLM inference optimization (1): KV Cache - MartinLwx's Blog

KV Cache Optimization Strategies for Scalable and Efficient LLM Inference

KV Cache Optimization Strategies for Scalable and Efficient LLM Inference

KV Cache Optimization Strategies for Scalable and Efficient LLM Inference

KV Cache Offload Accelerates LLM Inference - NADDOD Blog
What is KV Cache? | LLM Inference Optimization | Inference Systems
KV Cache & Inference Optimization | cmu-l3/anlp-spring2026-code | DeepWiki

KV Cache Optimization — Why Inference Memory Explodes and How to Fix It ...
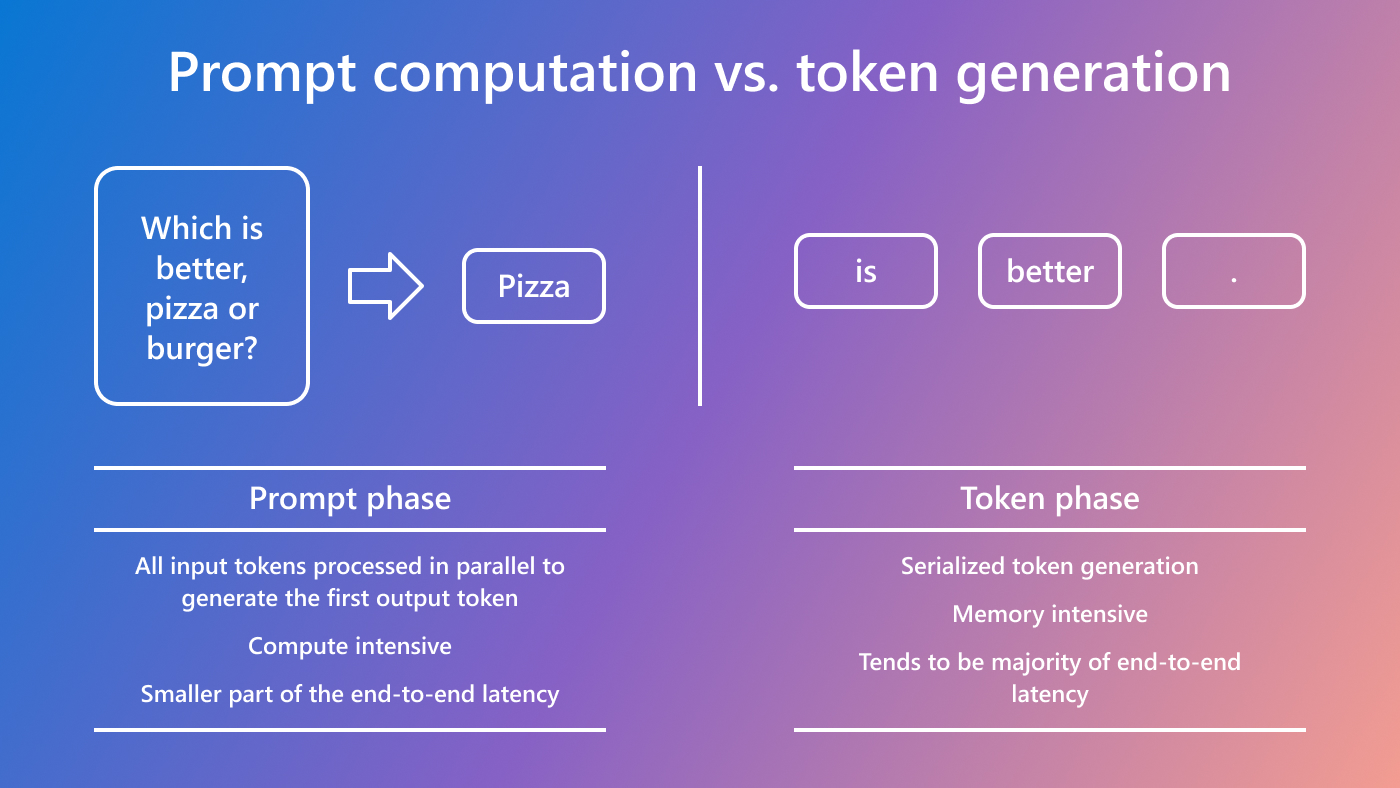
LLM profiling guides KV cache optimization - Microsoft Research
Advertisement Space (300x250)
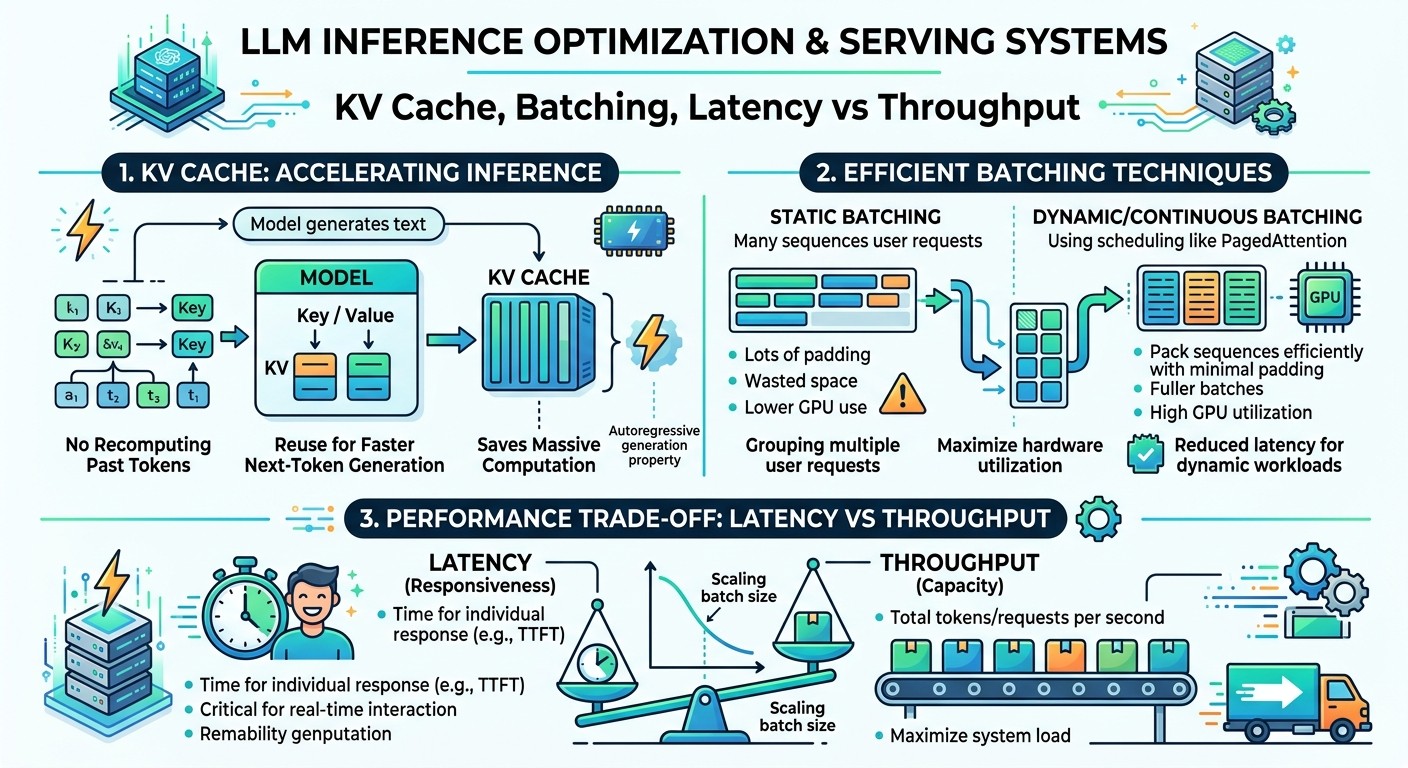
LLM Inference Optimization & Serving Systems – Billion Hopes
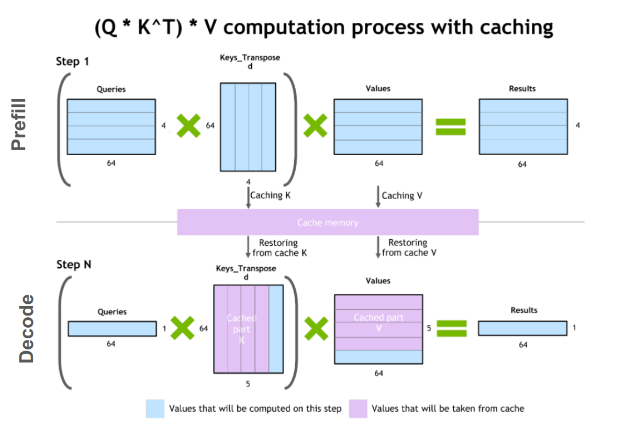
Mastering LLM Techniques: Inference Optimization – GIXtools

LLM inference optimization: Architecture, KV cache and Flash attention ...

LLM Inference Optimization Production Guide 2026 | Iterathon
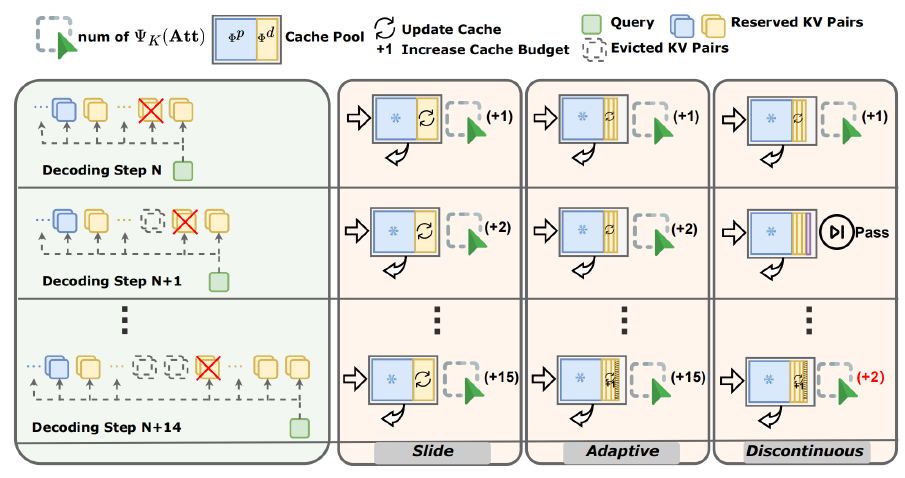
SCOPE: KV Cache optimization framework for long-context generation in ...

LLM Inference Optimization 101 | DigitalOcean
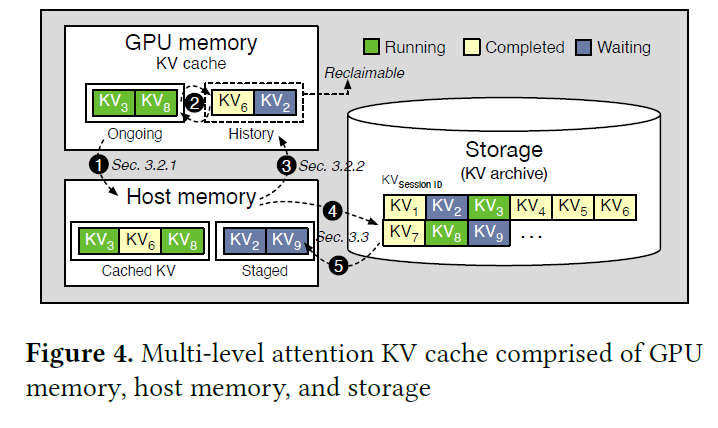
LLM Inference — Optimizing the KV Cache for High-Throughput, Long ...

LLM Inference Optimization Overview - From Data to System Architecture
KV Cache State: Definition & Role in LLM Inference | Inference Systems
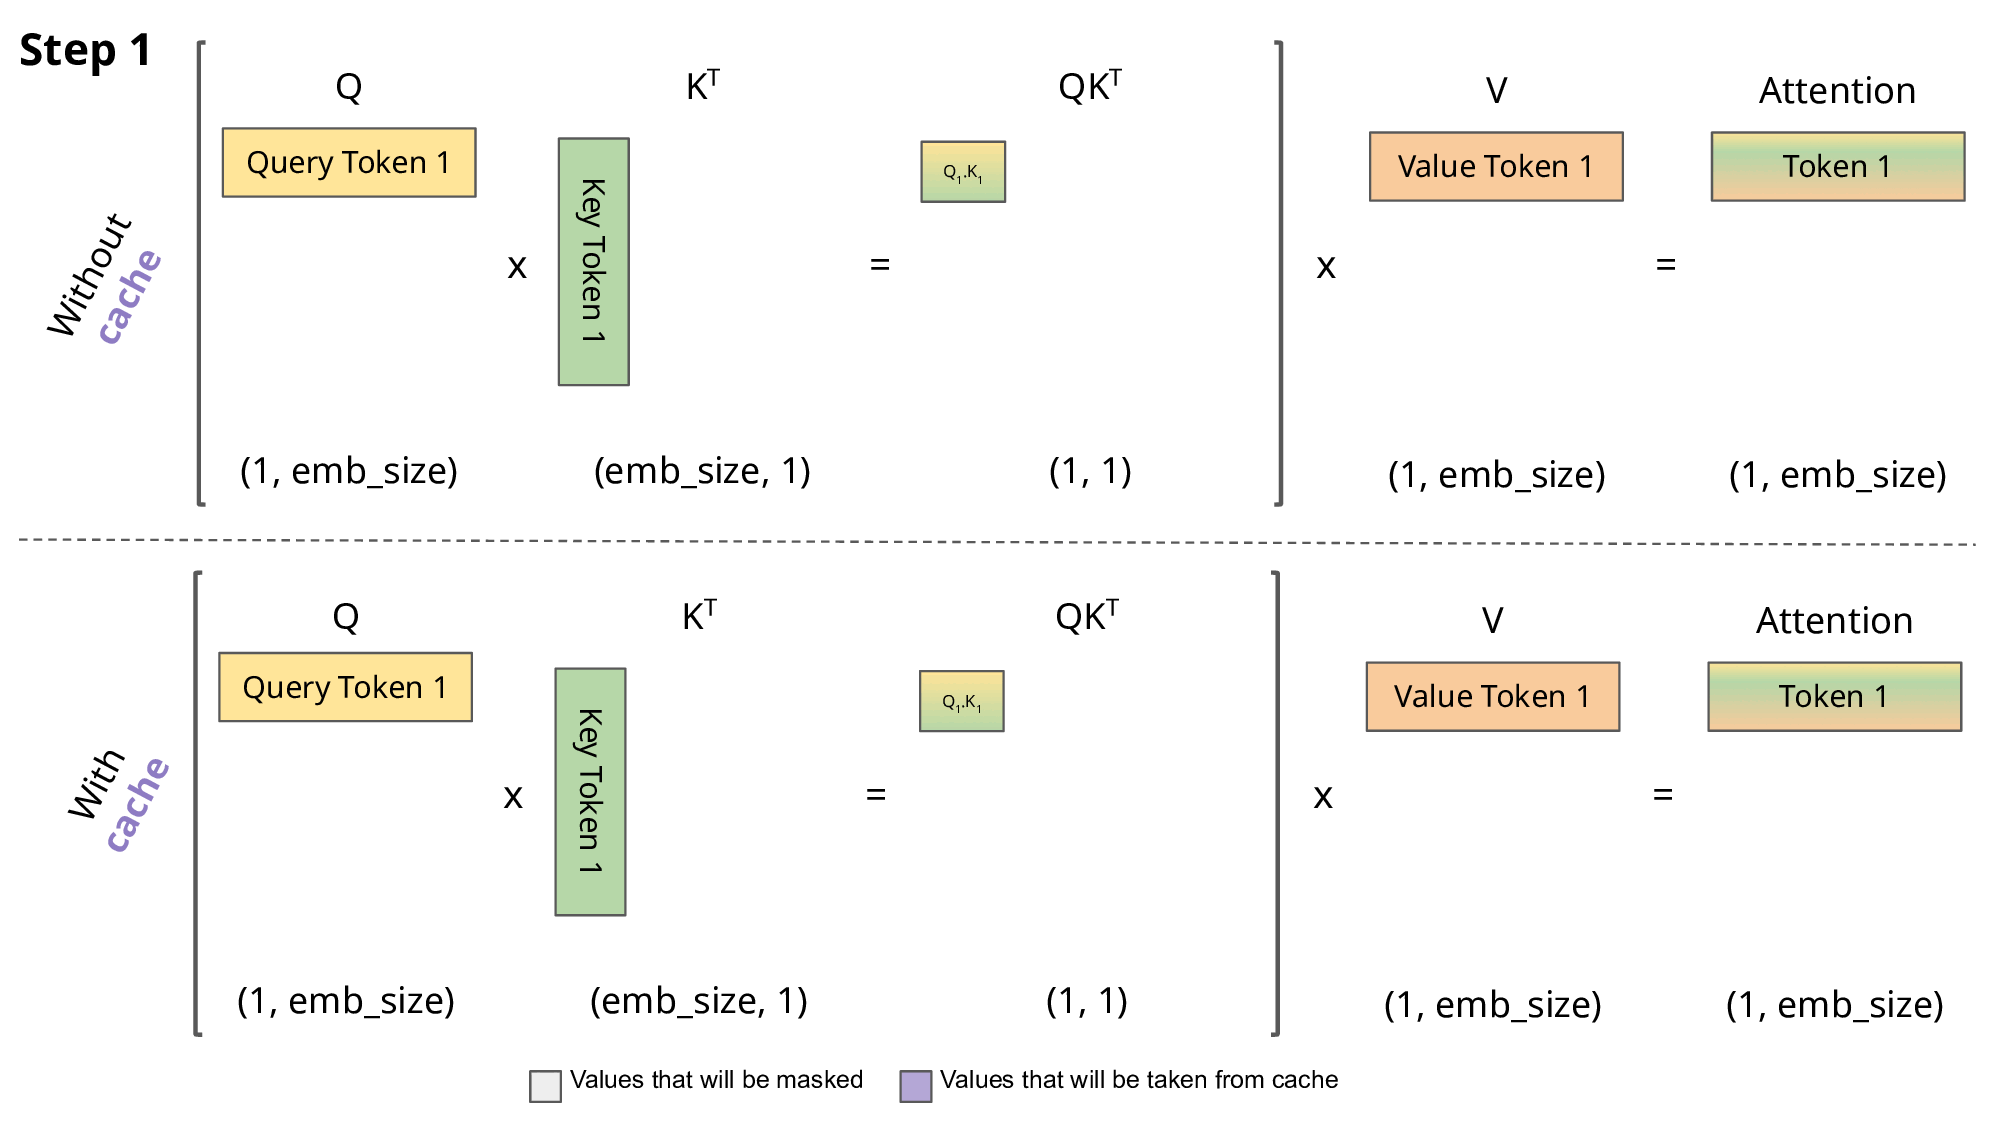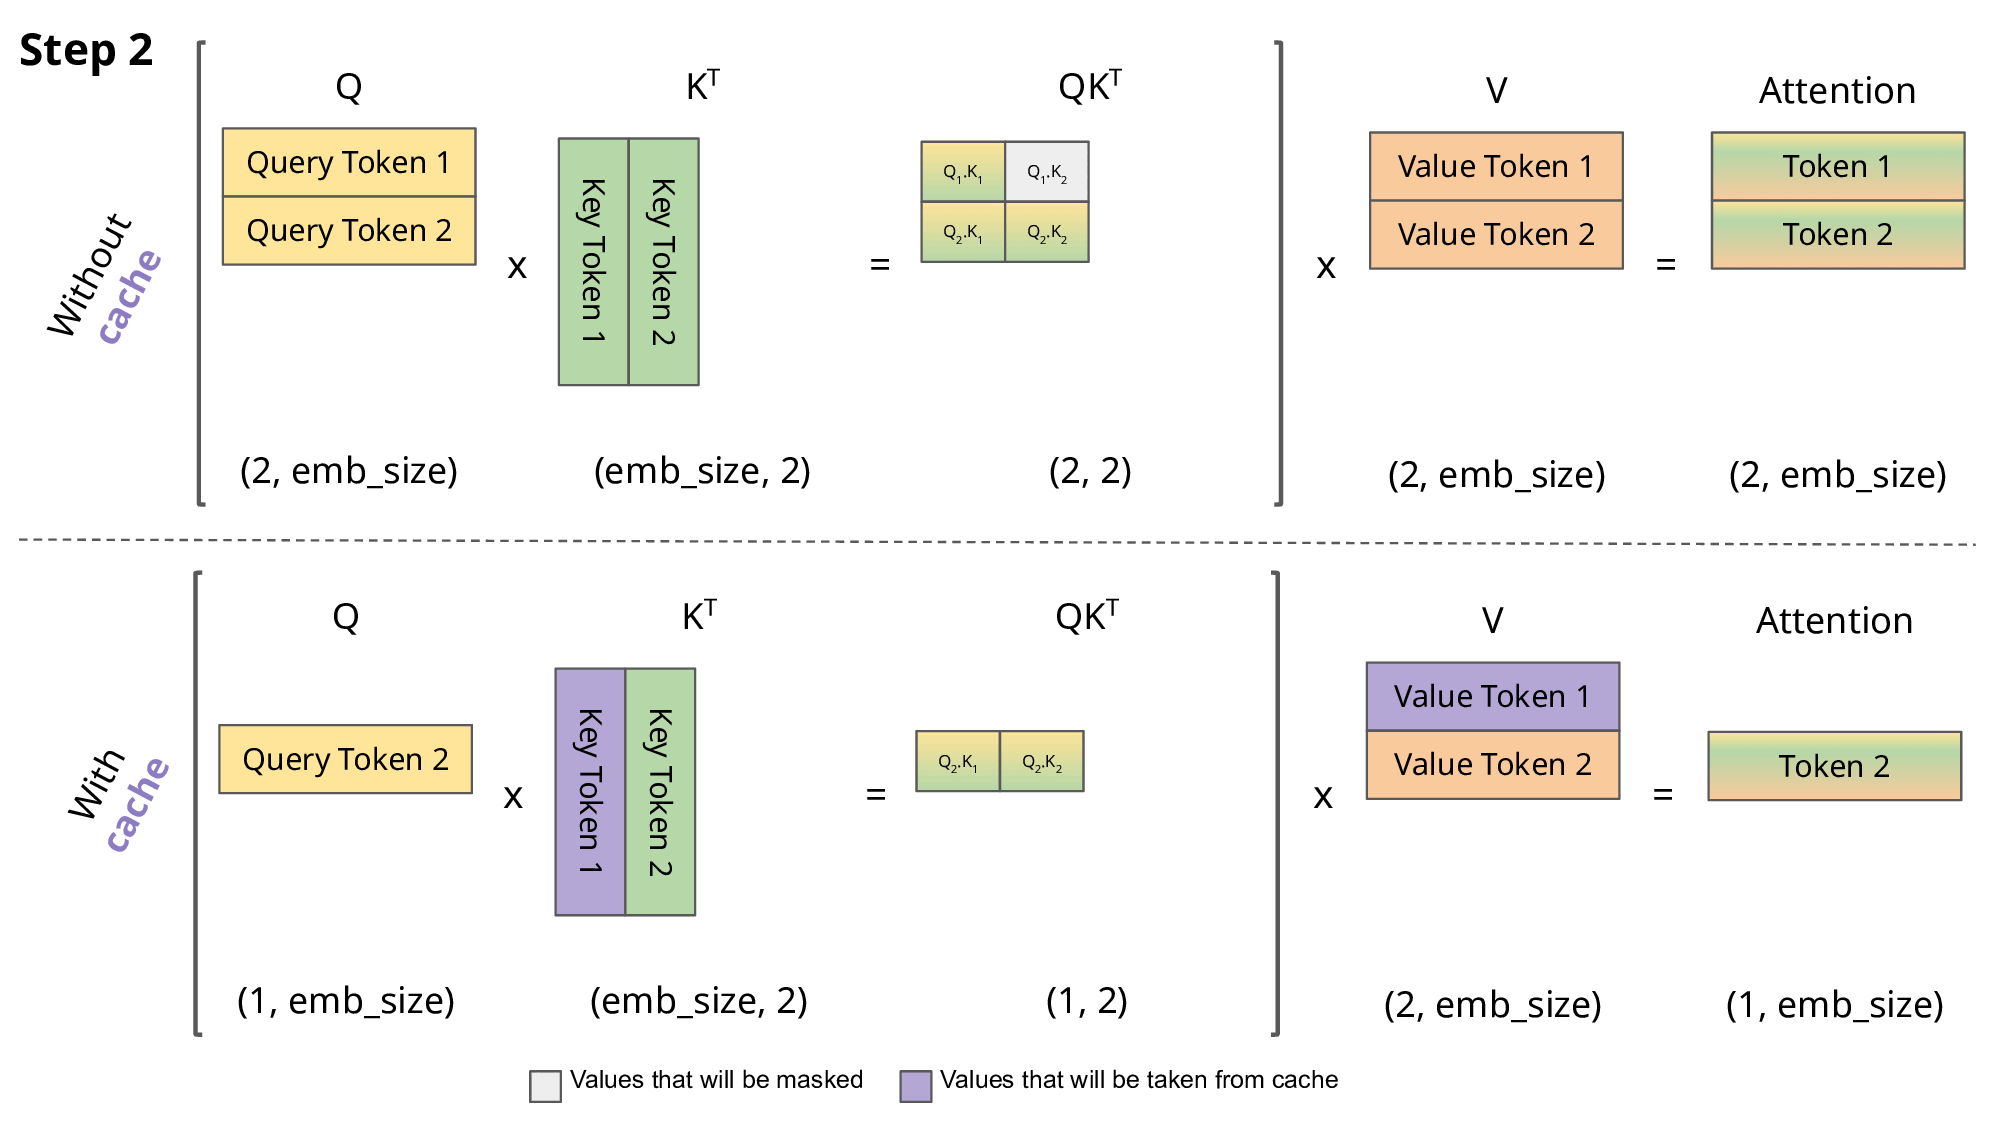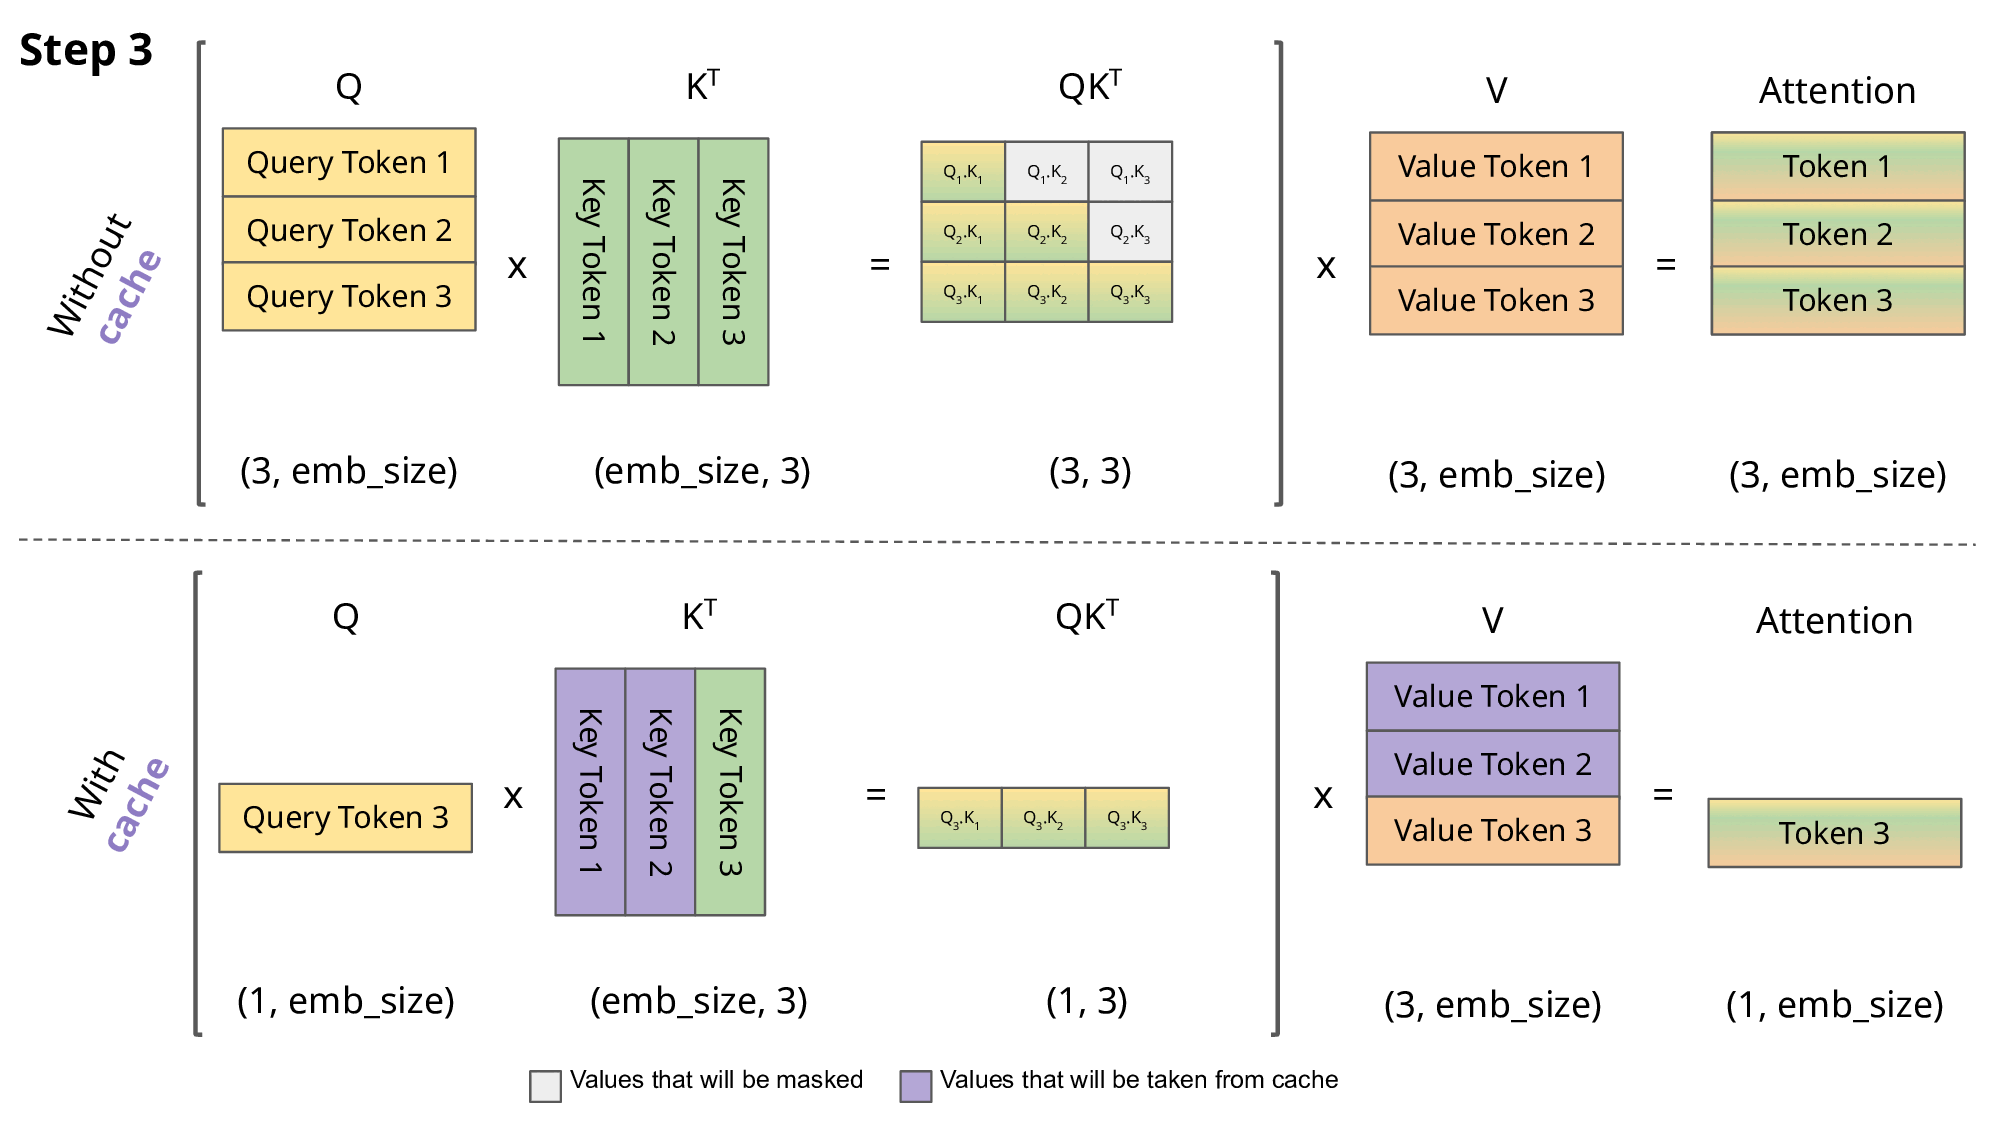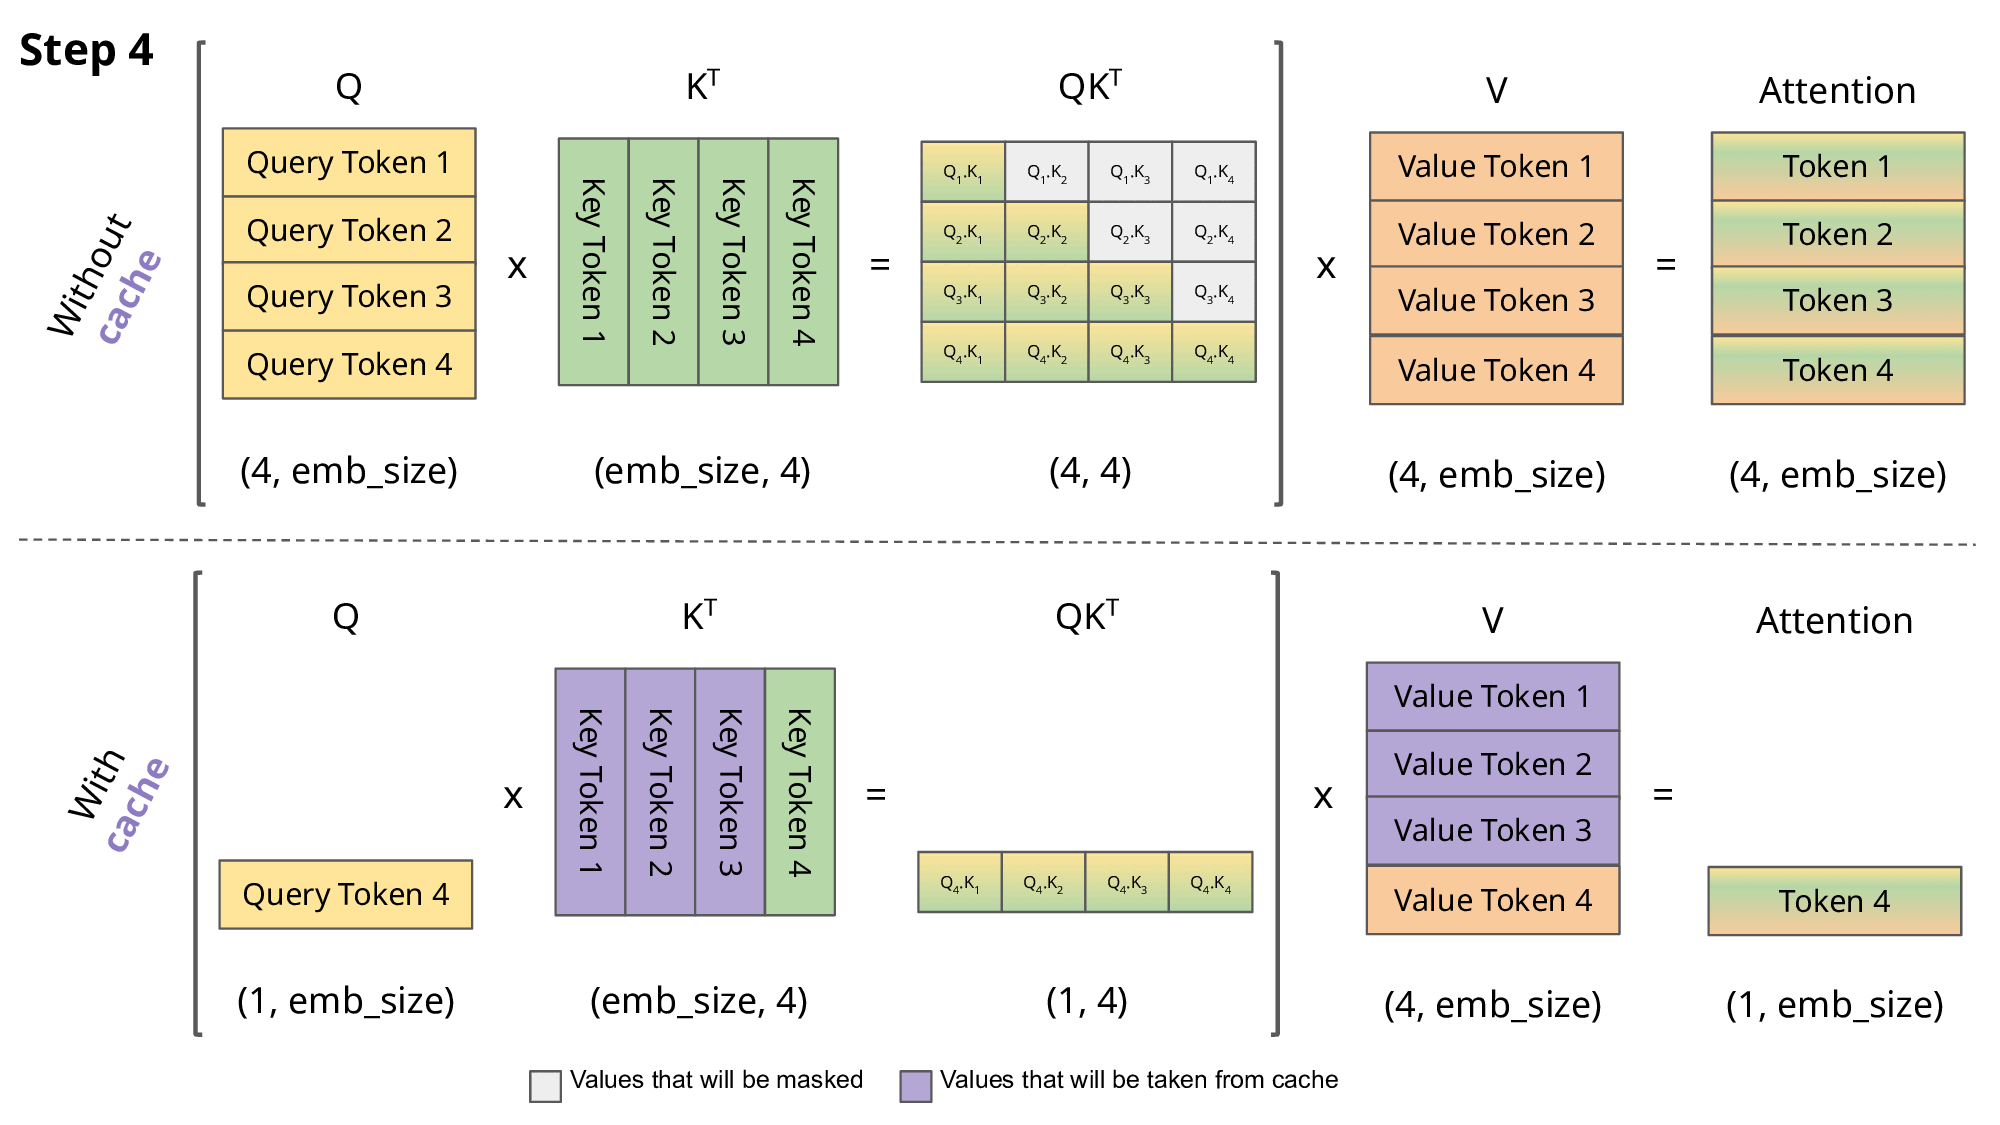
LLM Inference — Optimizing the KV Cache for High-Throughput, Long ...
Advertisement Space (336x280)

Figure 1 from KV Cache Optimization Strategies for Scalable and ...
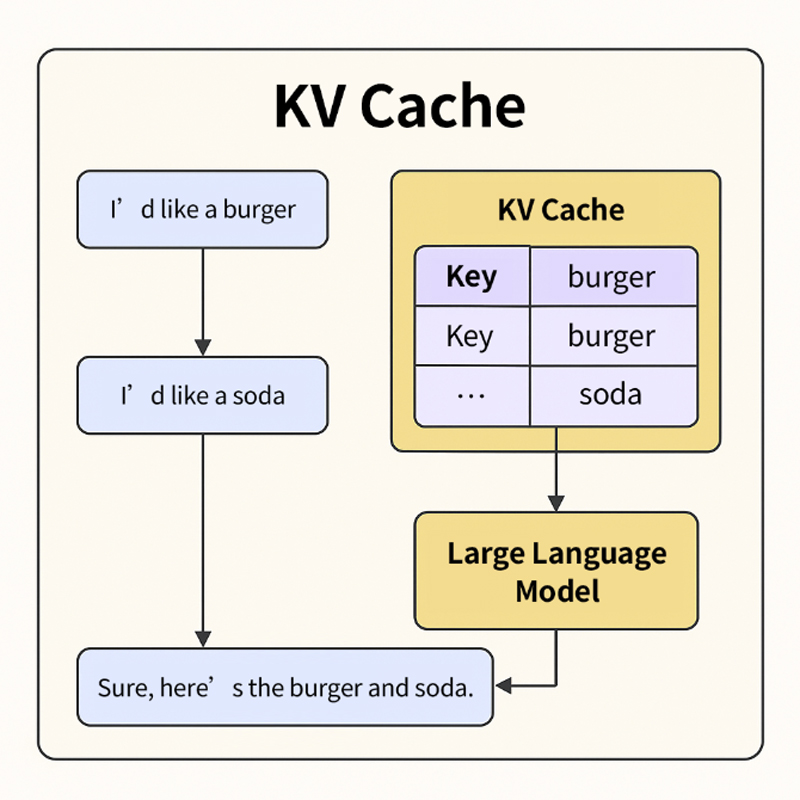
KV Cache Meets NVMe: The Key to Accelerating LLM Inference
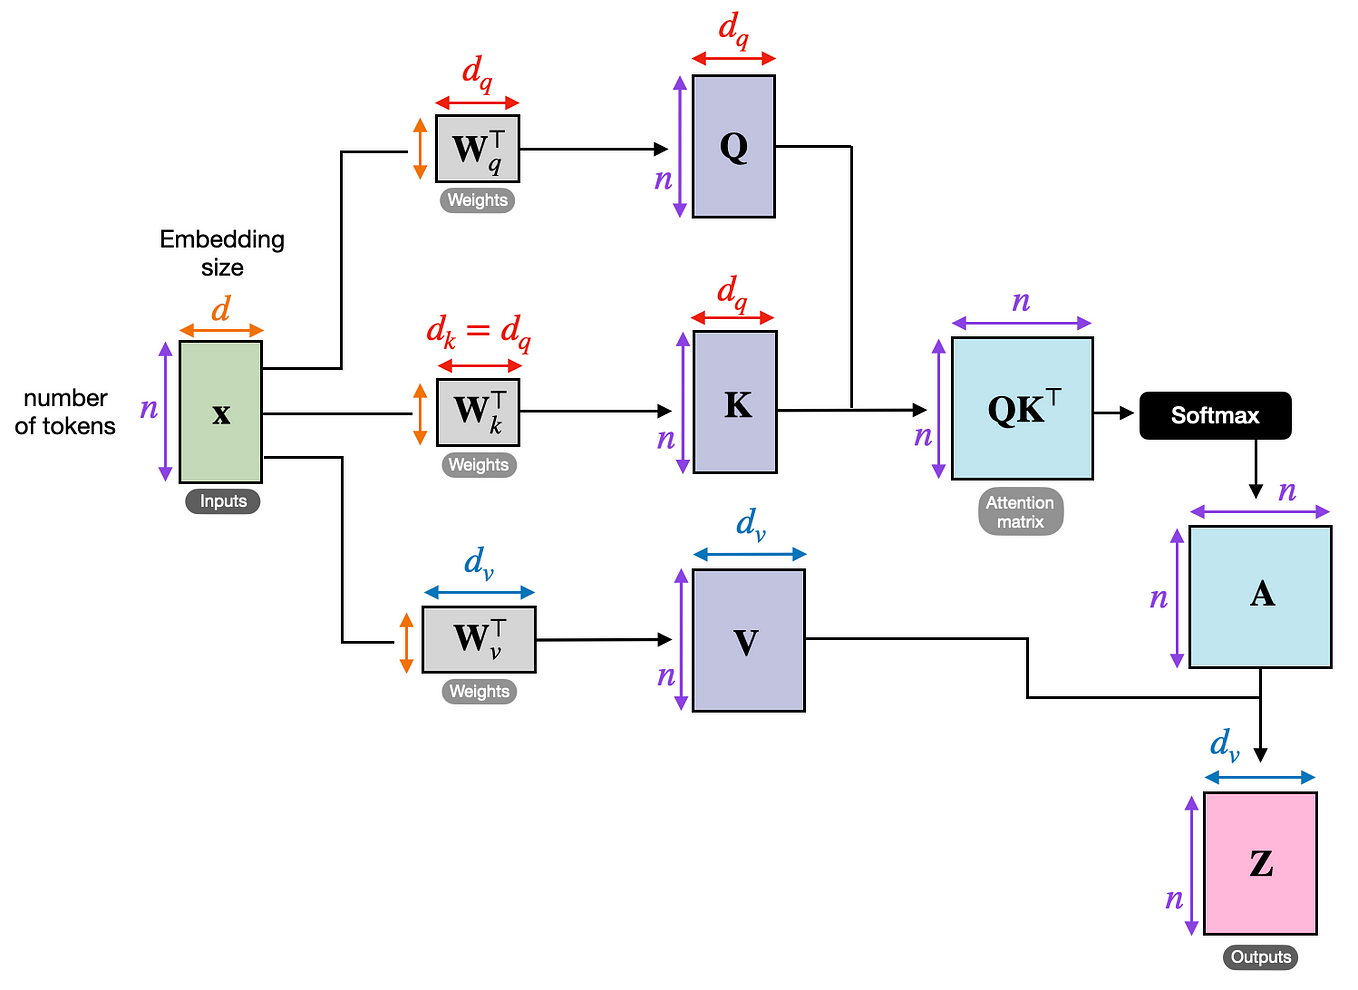
LLM Inference — Optimizing the KV Cache for High-Throughput, Long ...

KV Cache in LLM Inference - Complete Technical Deep Dive - YouTube
KV Cache Optimization for LLMs 2026: Engineering Guide

LLM Inference Optimization. Coherence in KV Cache Management. LLM Intra ...
KV Cache Explained for LLM Inference

Accelerating LLM Inference Throughput via Asynchronous KV Cache Prefetching

KV Cache Transform Coding for Compact Storage in LLM Inference

Pushing the Limits of LLM Inference via 2-Bit Layer-Discriminative KV Cache
Advertisement Space (336x280)
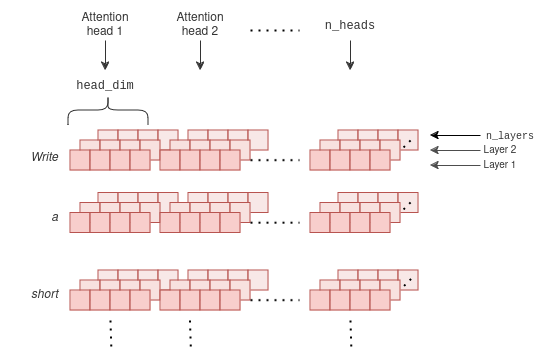
Techniques for KV Cache Optimization in Large Language Models

KVSharer: method for efficient LLM inference via dissimilar KV Cache ...

[论文评述] Accelerating LLM Inference Throughput via Asynchronous KV Cache ...

Identify Critical KV Cache in LLM Inference from an Output Perturbation ...
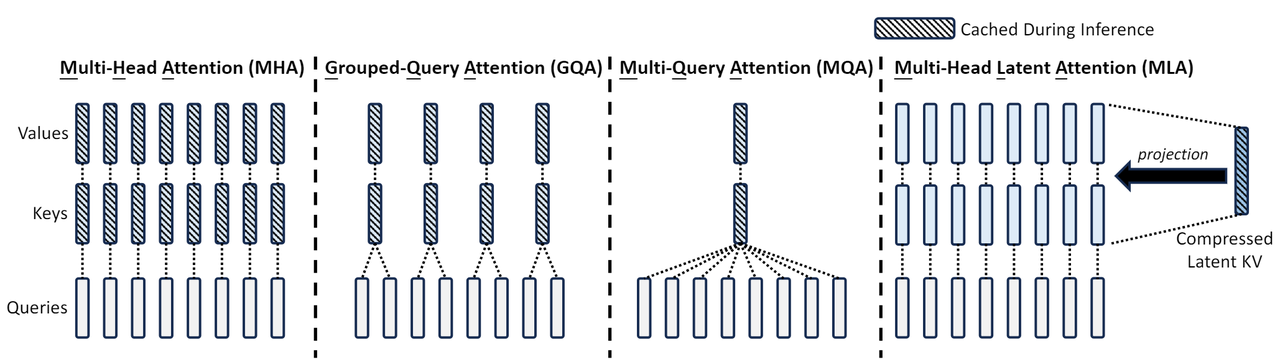
LLM Inference Optimization Overview - From Data to System Architecture ...
Speculative KV Cache: Definition & Optimization | Inference Systems