
Llm Serving Segmentfault

人工智能 - LLM 训练能不能少跑一点?Nous Research 的 TST 方法 - 七牛开发者 - SegmentFault 思否

人工智能 - LLM Serving有效吞吐量的最大化实现 - 业界观点 - SegmentFault 思否

关于 LLM 和图数据库、知识图谱的那些事 - Nebula 的图数据库世界 - SegmentFault 思否

UELLM: A Unified and Efficient Approach for LLM Inference Serving | AI ...

[논문 리뷰] Tackling the Dynamicity in a Production LLM Serving System with ...
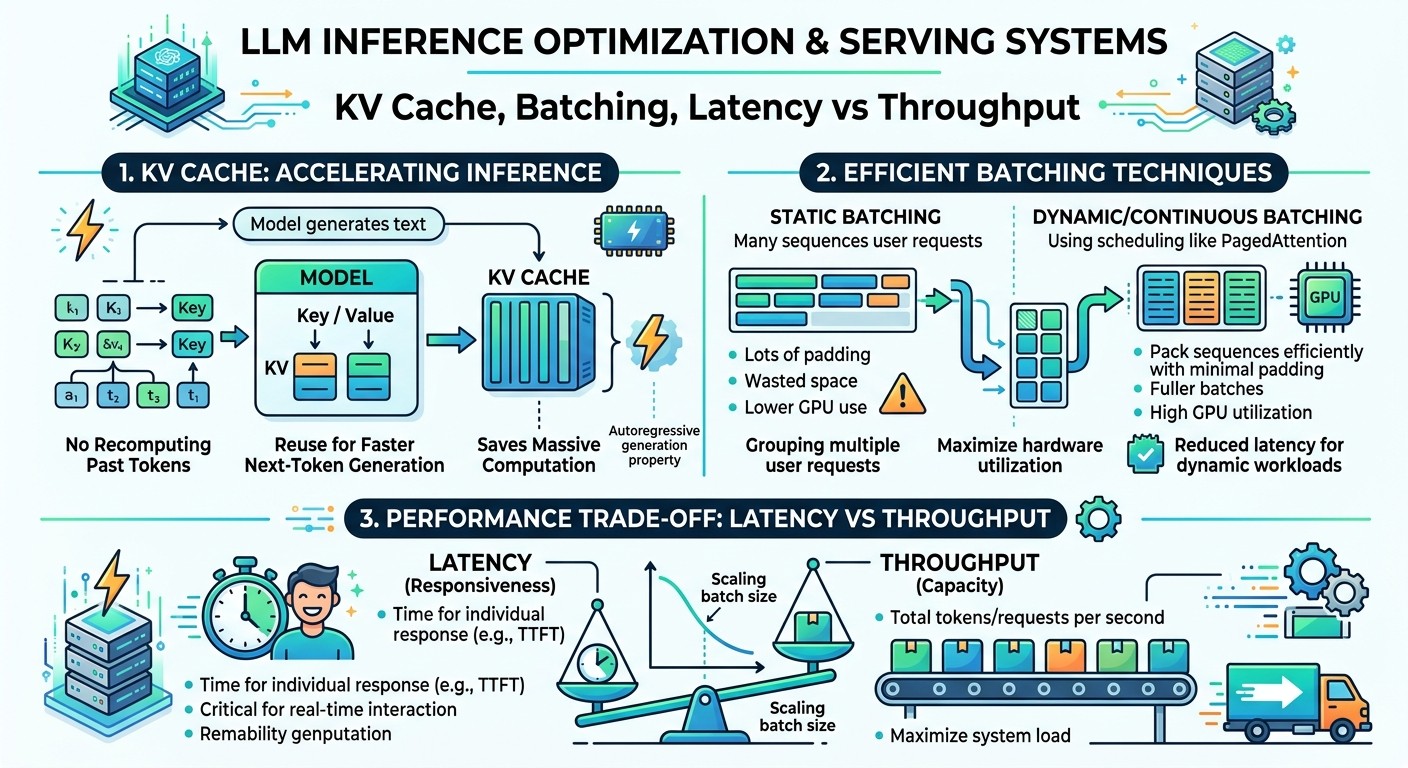
LLM Inference Optimization & Serving Systems – Billion Hopes

人工智能 - LLM Serving有效吞吐量的最大化实现 - 业界观点 - SegmentFault 思否

[논문 리뷰] TimelyLLM: Segmented LLM Serving System for Time-sensitive ...

Optimizing Long-context LLM Serving via Fine-grained Sequence ...
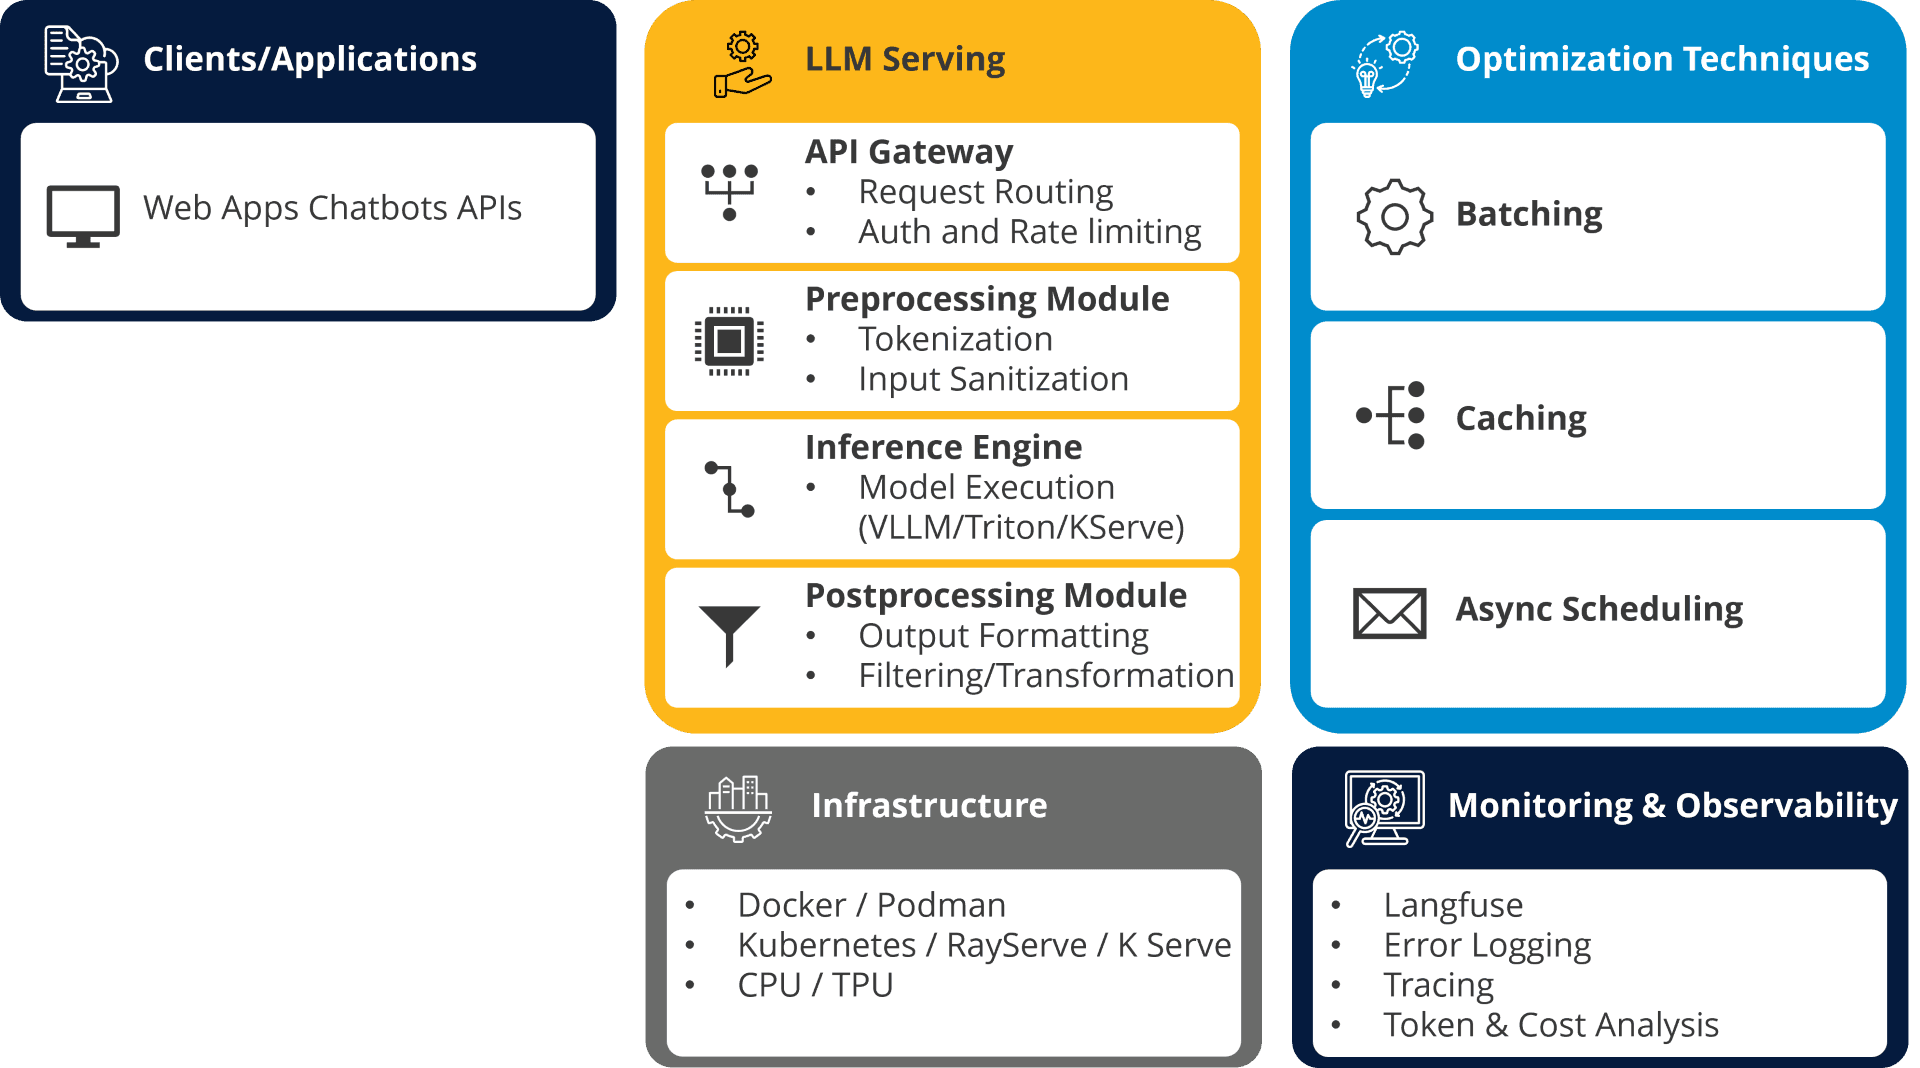
Scaling AI in production: A practical guide to LLM Serving - Fractal ...
Advertisement Space (300x250)

人工智能 - LLM Serving有效吞吐量的最大化实现 - 业界观点 - SegmentFault 思否
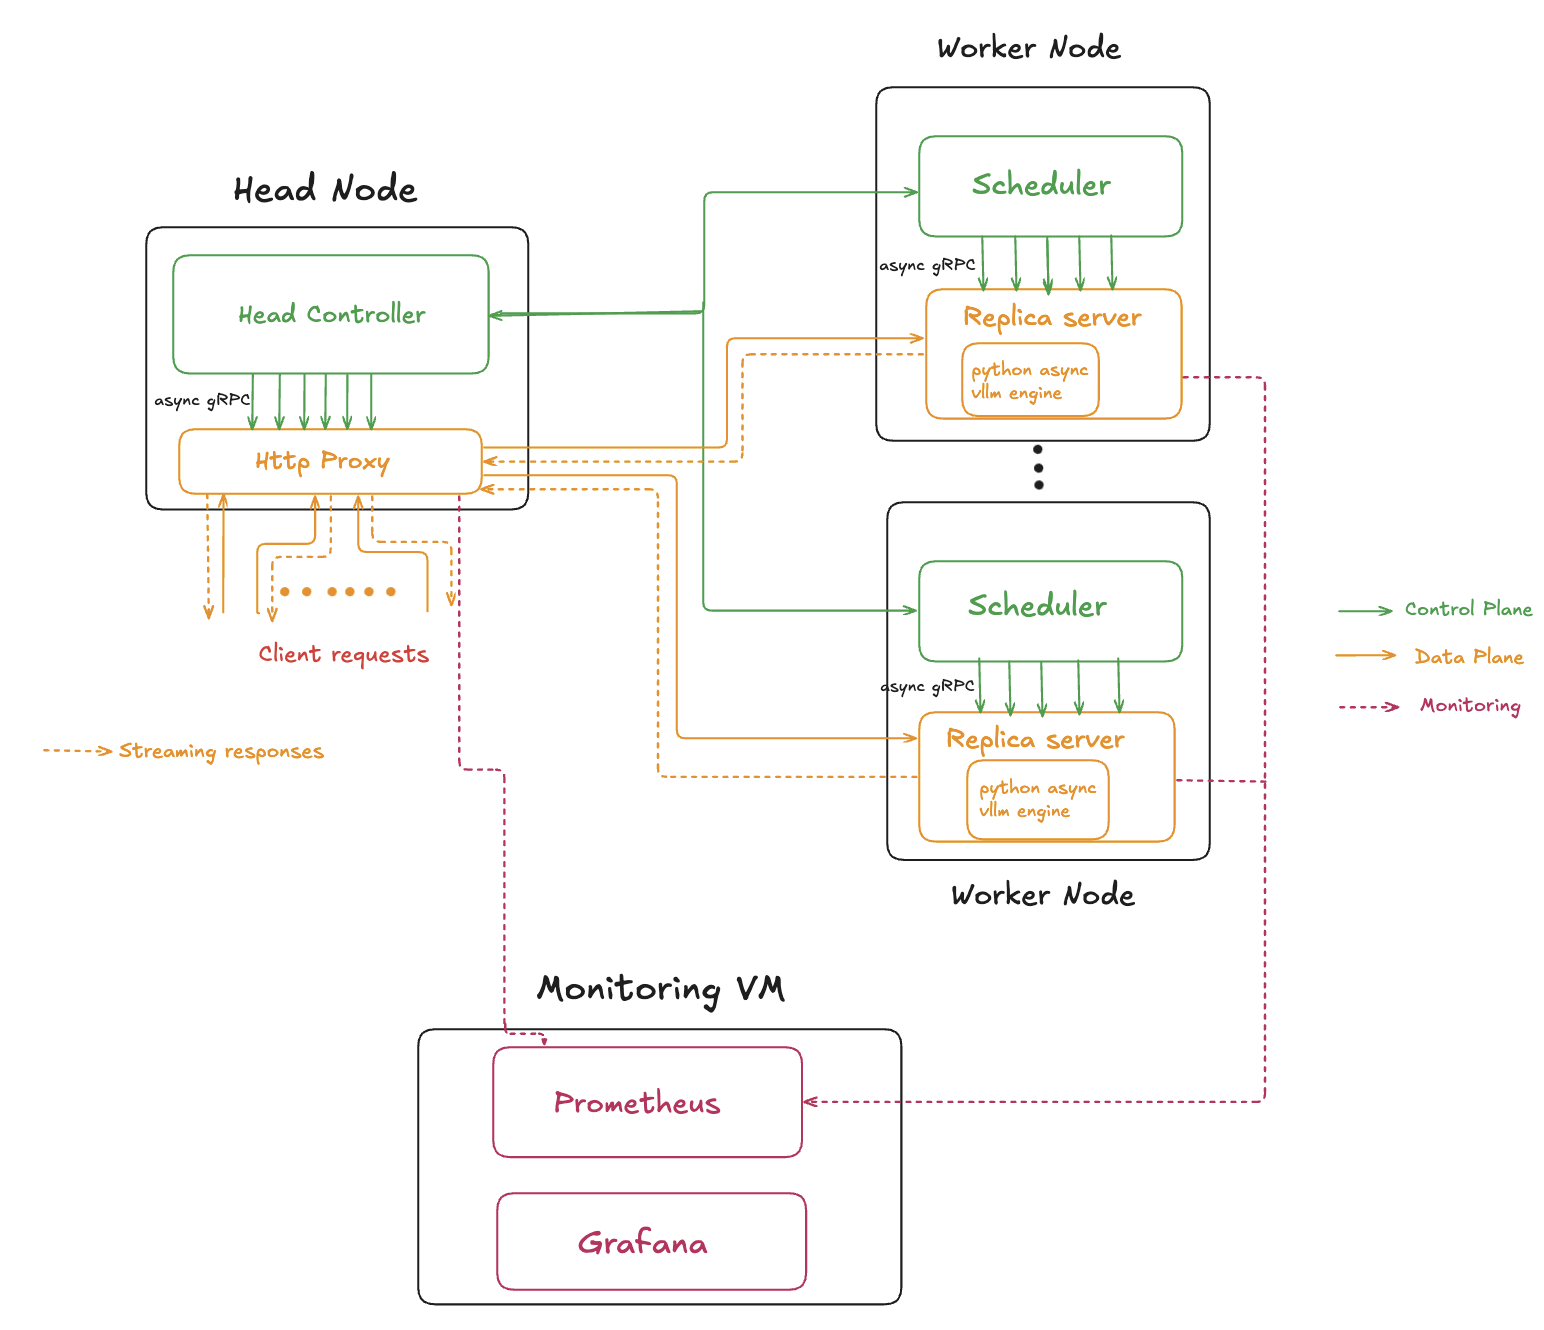
LLM Serving System

人工智能 - LLM Serving有效吞吐量的最大化实现 - 业界观点 - SegmentFault 思否
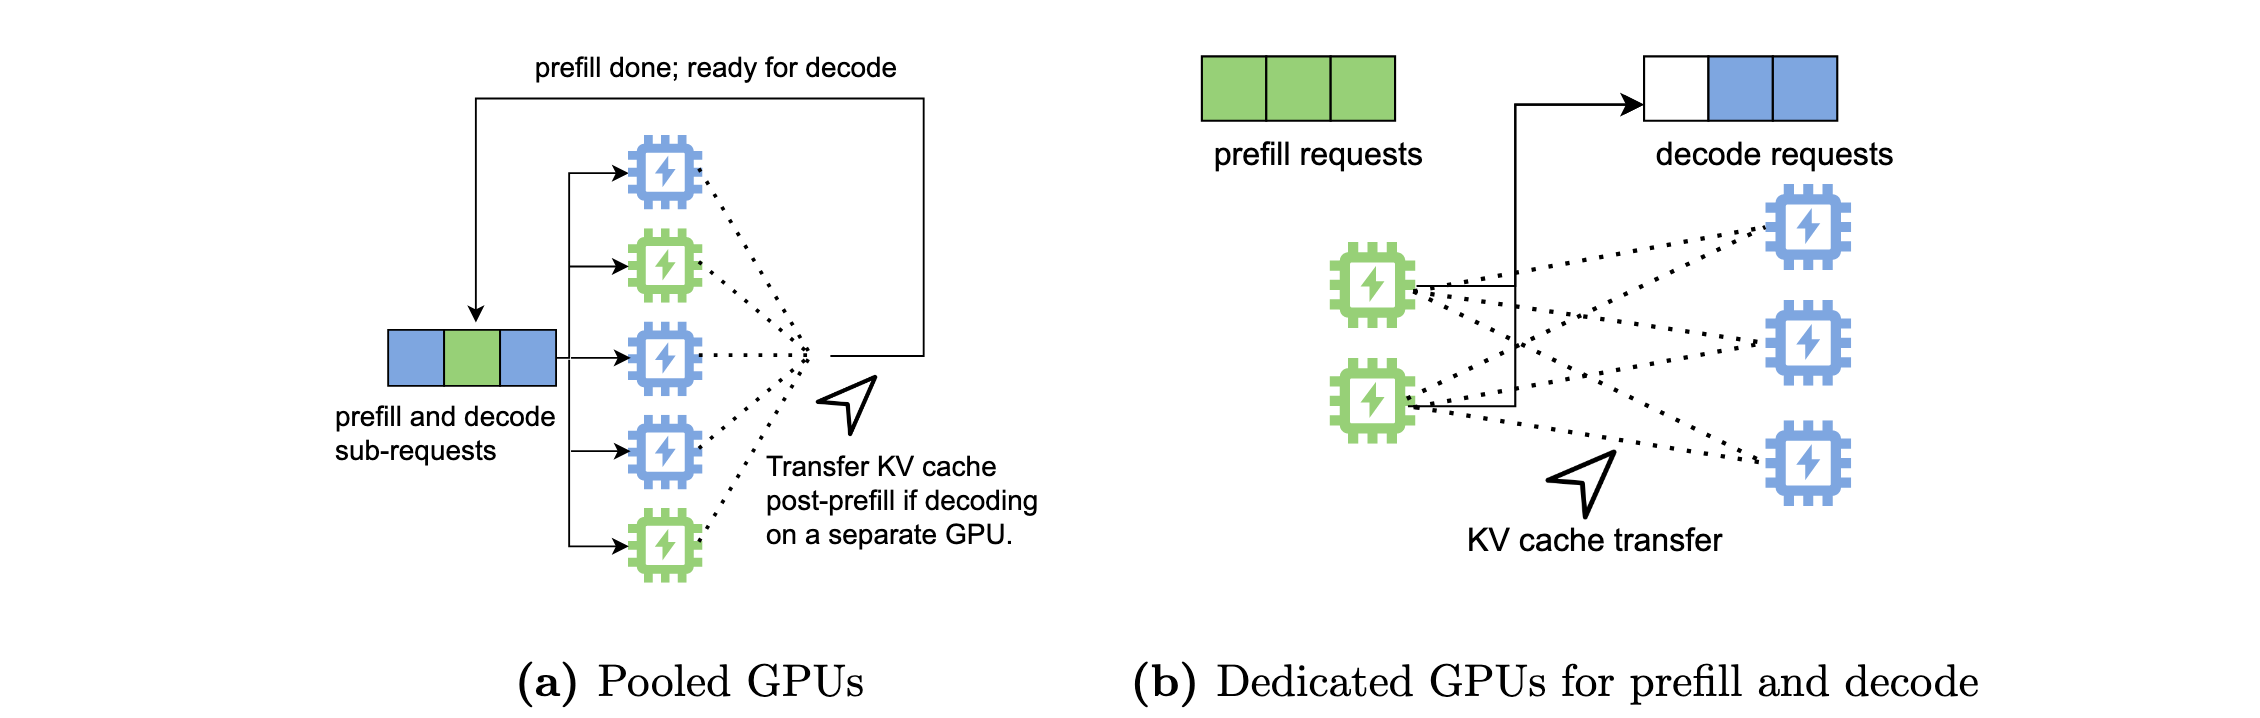
LLM Serving | l1l
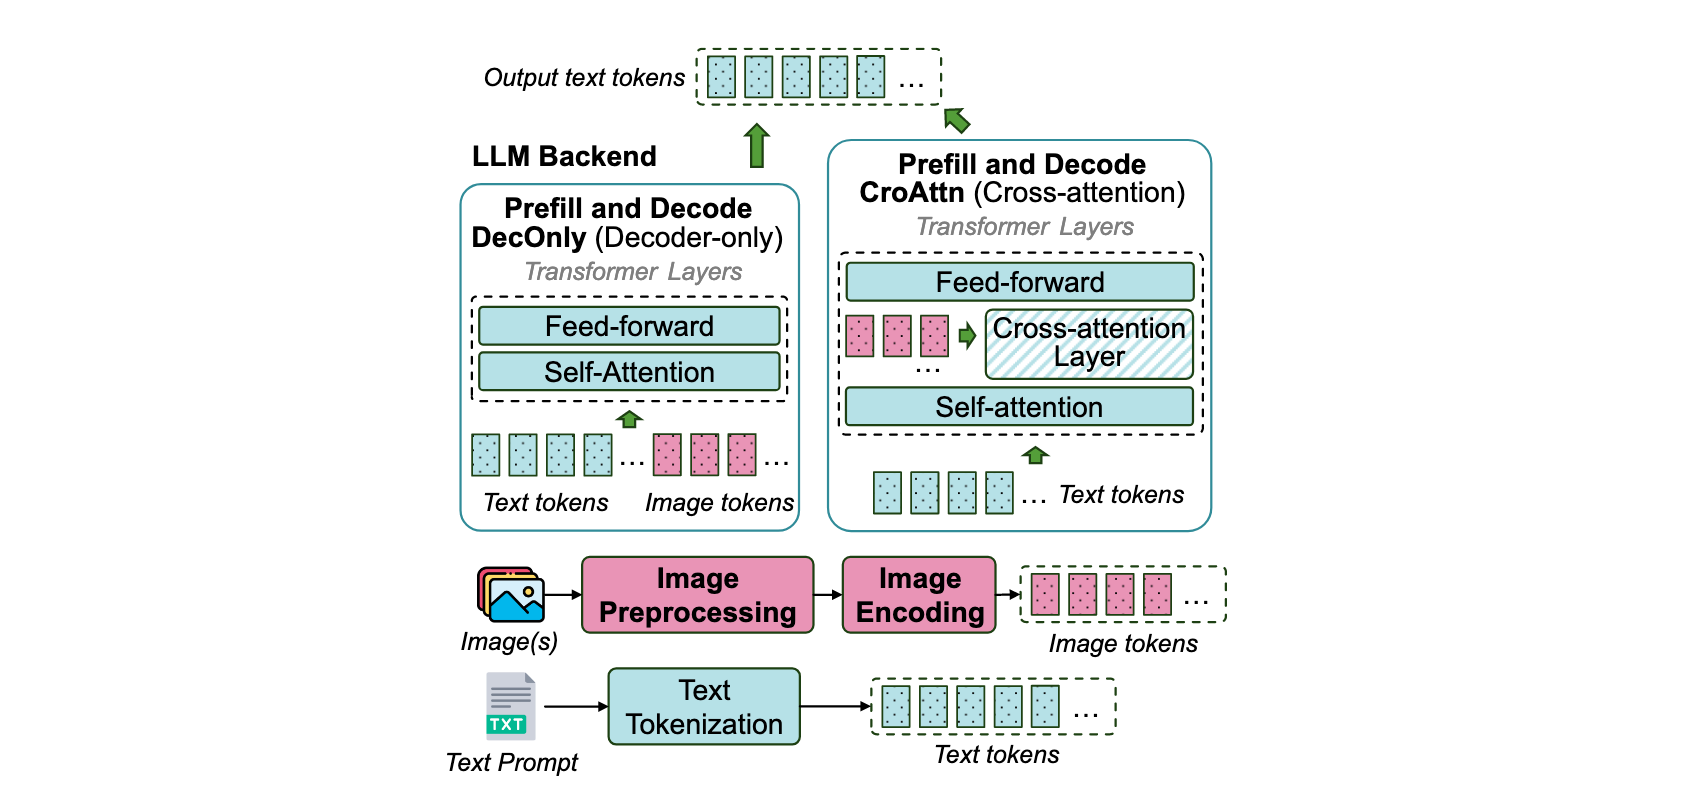
LLM Serving | l1l
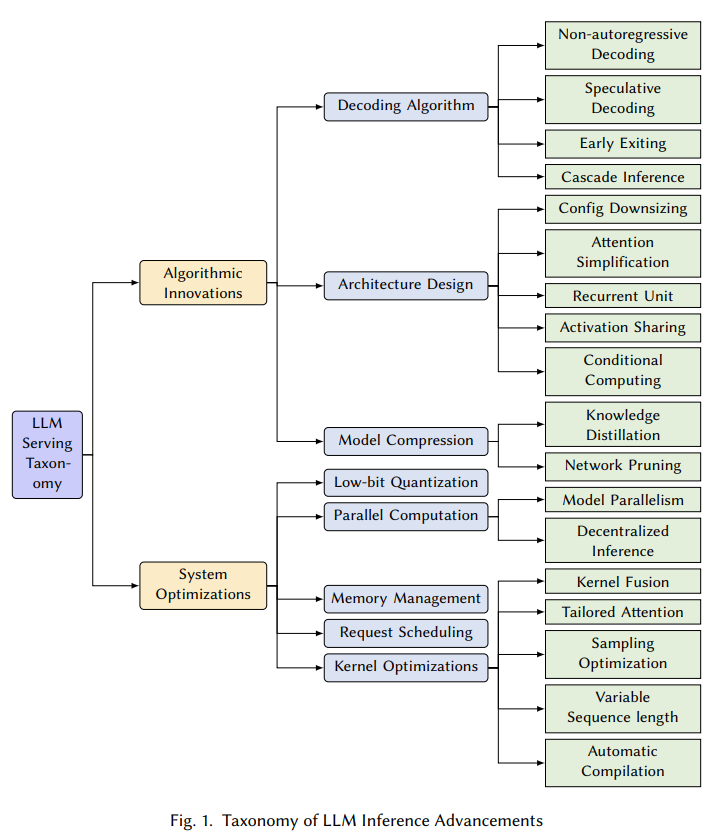
Tutorial: Towards Efficient Generative LLM Serving
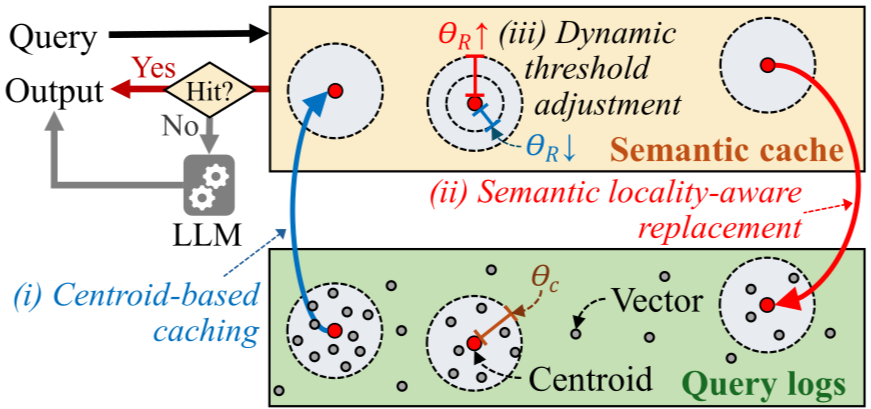
[논문 리뷰] Rethinking Caching for LLM Serving Systems: Beyond Traditional ...

人工智能 - LLM Serving有效吞吐量的最大化实现 - 业界观点 - SegmentFault 思否

System Design: Multi-Tenant LLM Serving Platform
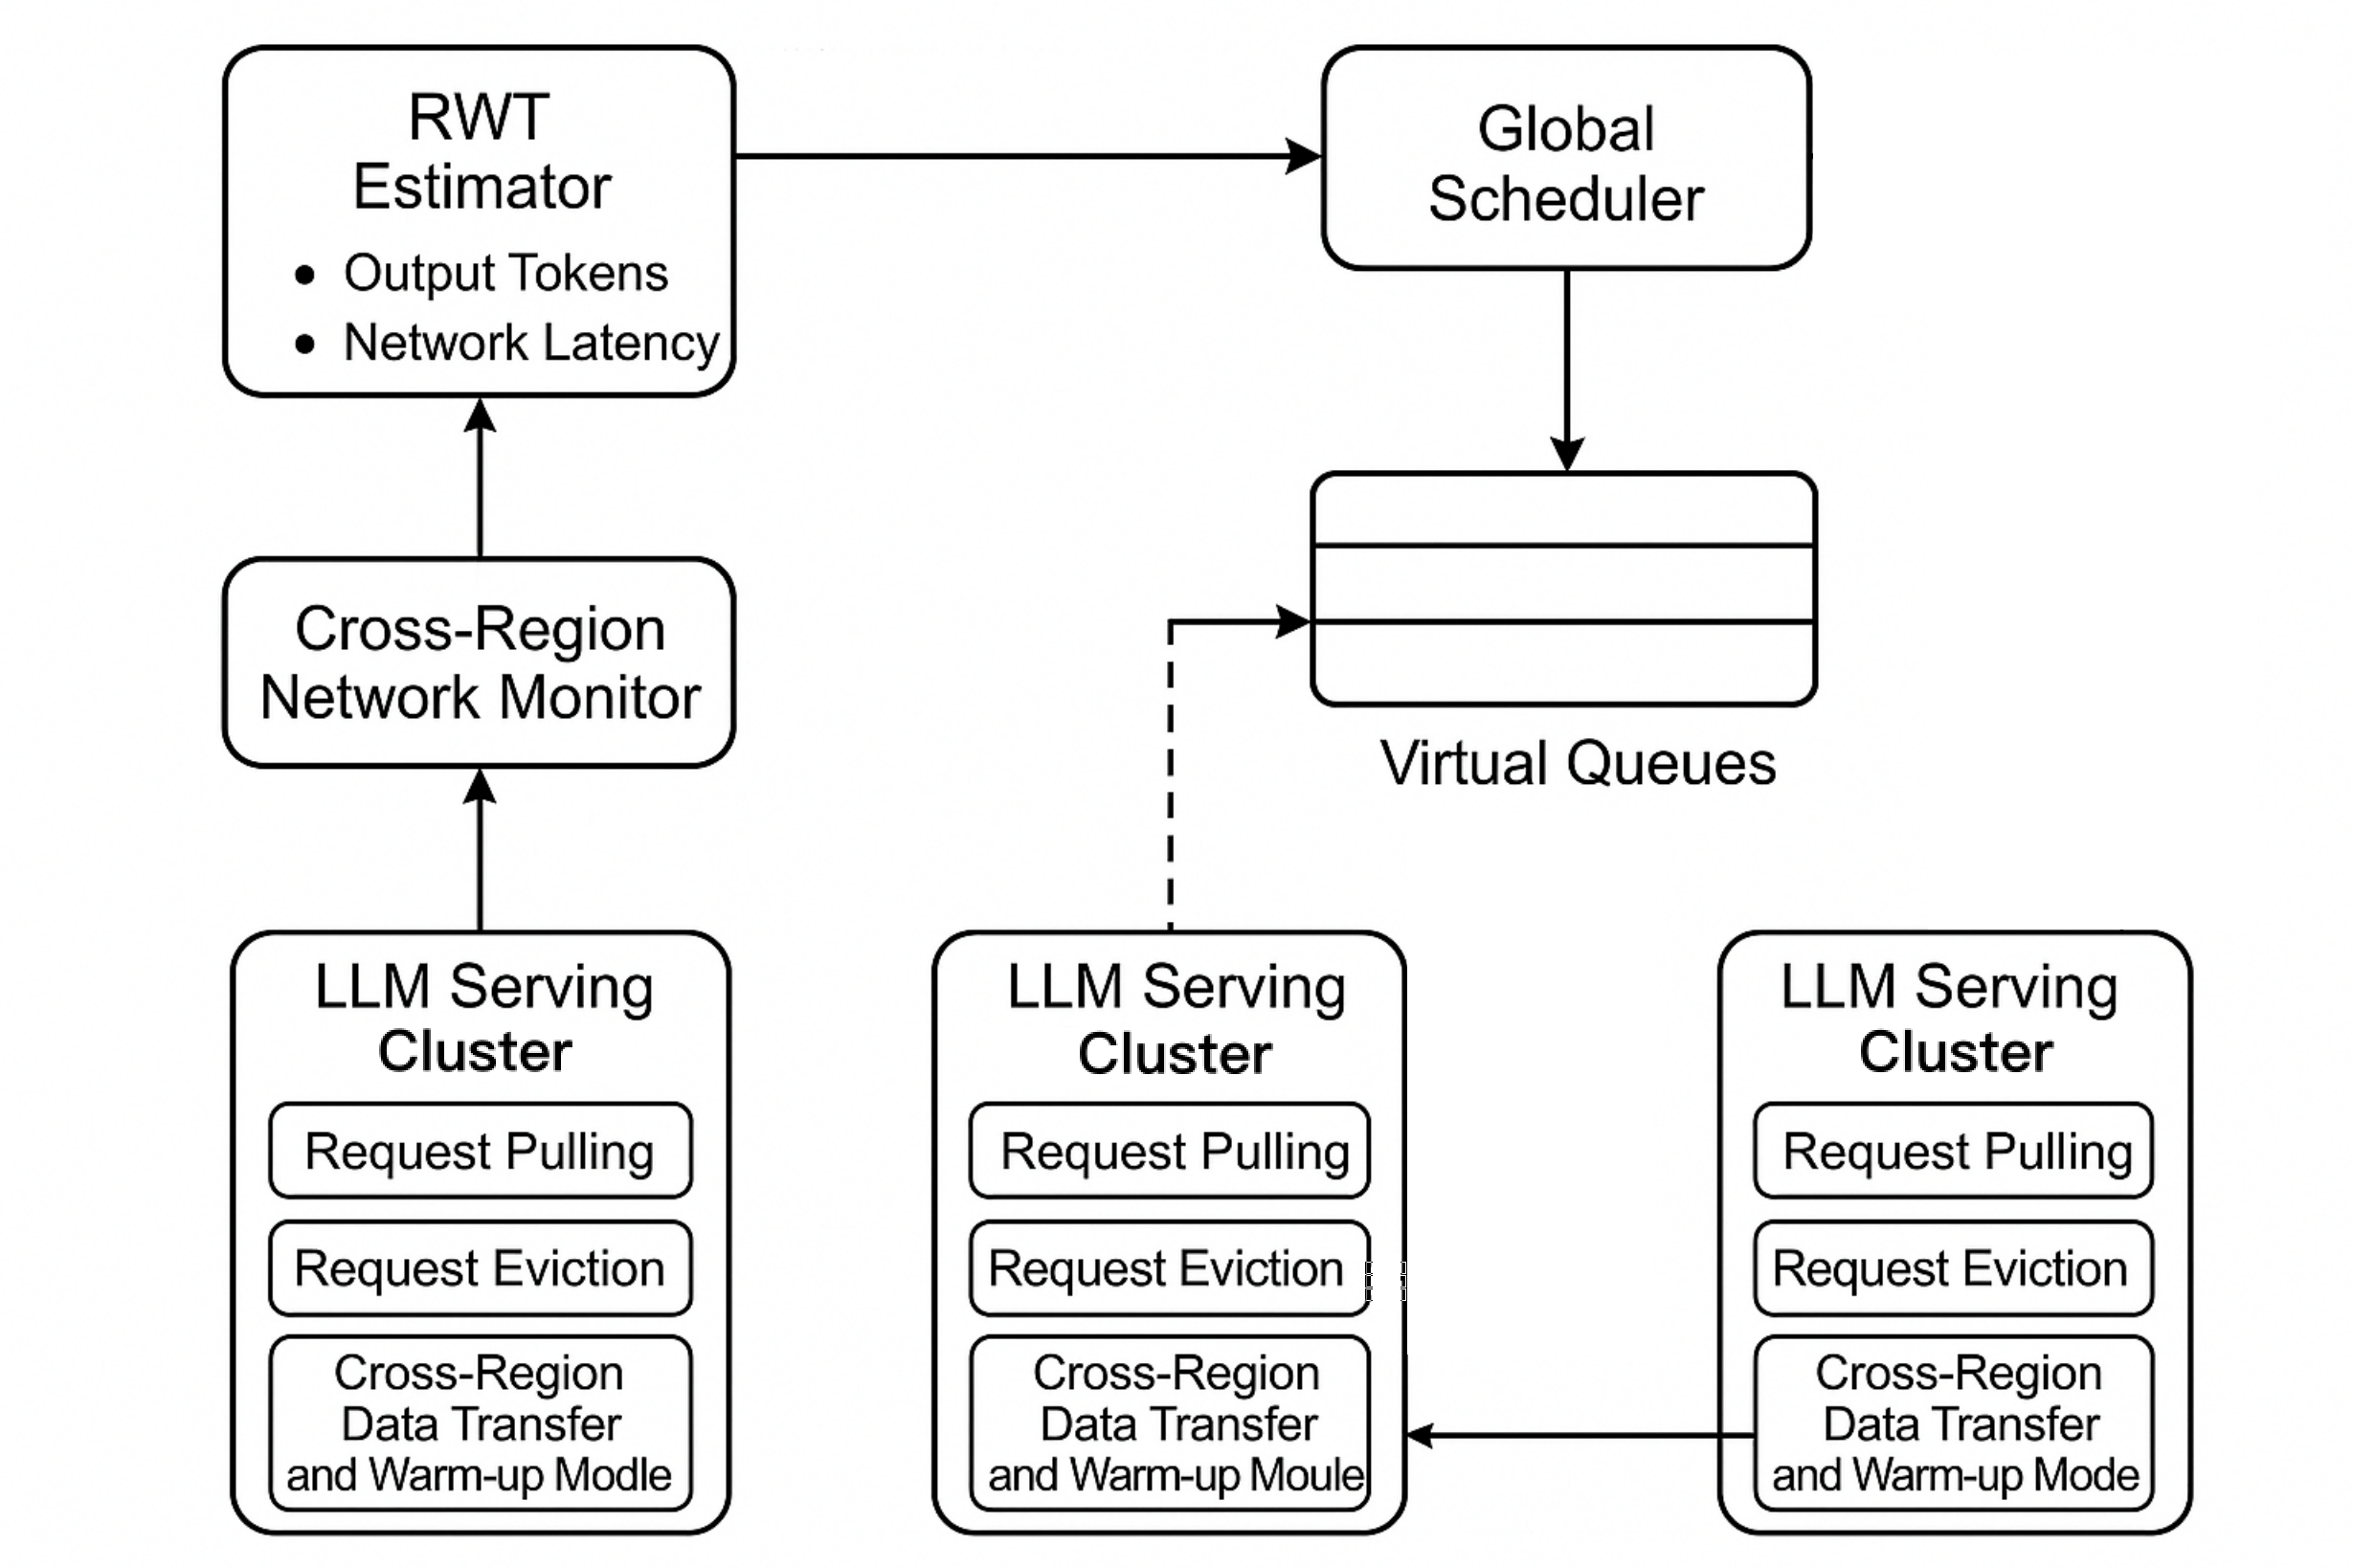
LLM Serving | l1l
Advertisement Space (336x280)

人工智能 - LLM Serving有效吞吐量的最大化实现 - 业界观点 - SegmentFault 思否

Must-Know Facts Before Studying LLM Serving | by Avacodo | Medium
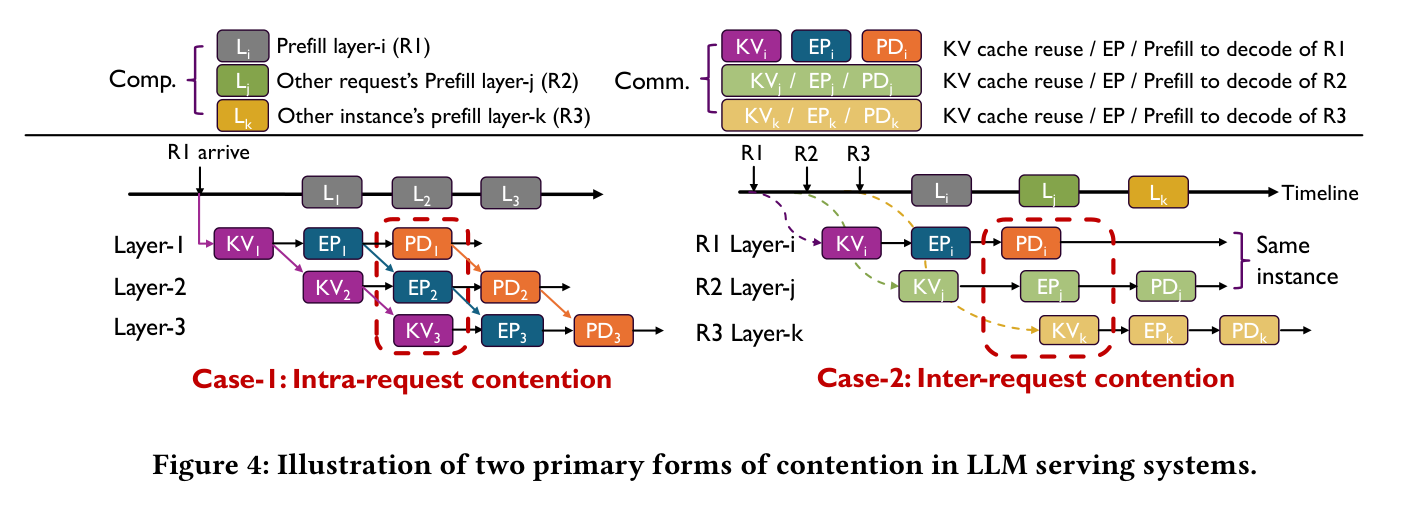
MFS: Multi-stage Flow Scheduling for LLM Serving — Feiyue KB
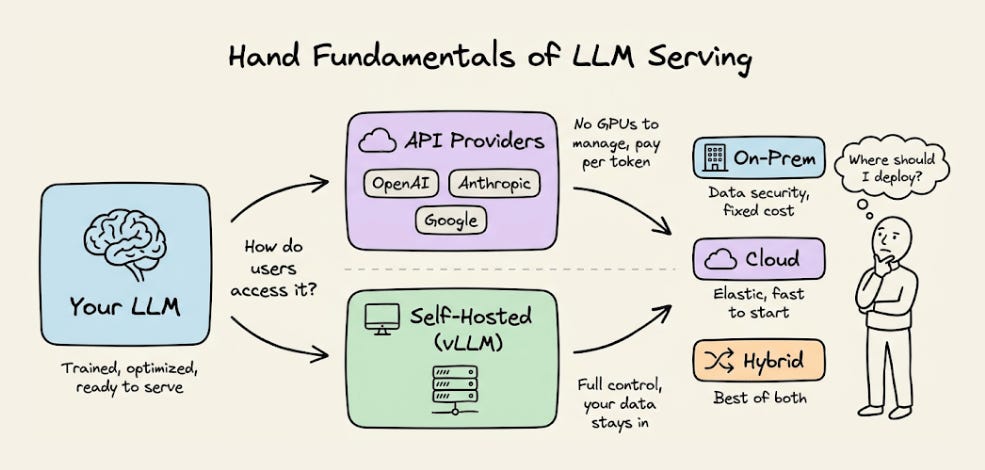
Concepts of LLM Serving in LLMOps - by Avi Chawla

人工智能 - LLM Serving有效吞吐量的最大化实现 - 业界观点 - SegmentFault 思否

[论文评述] EdgeLoRA: An Efficient Multi-Tenant LLM Serving System on Edge ...
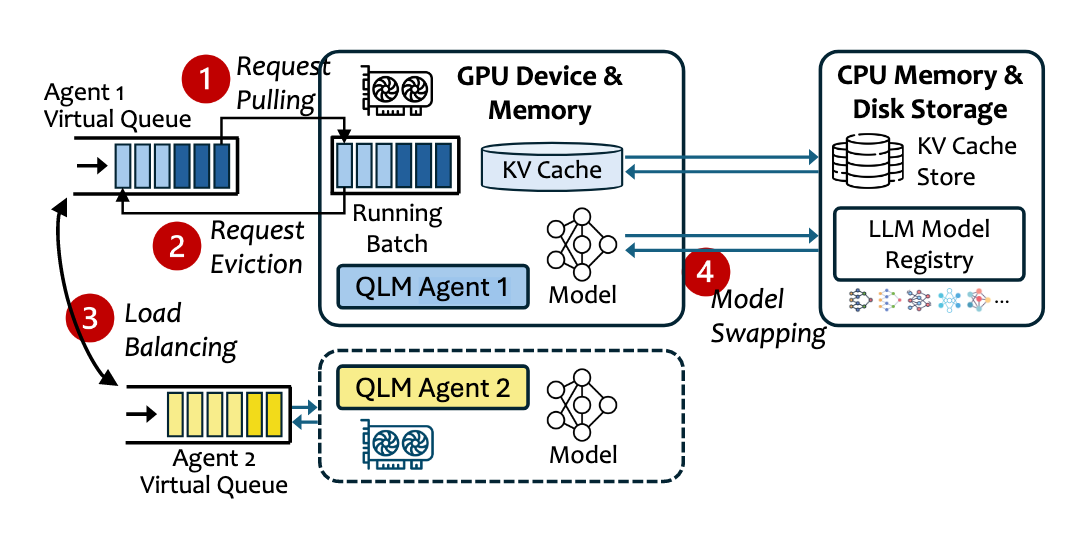
LLM Serving | l1l
LLM Serving Frameworks
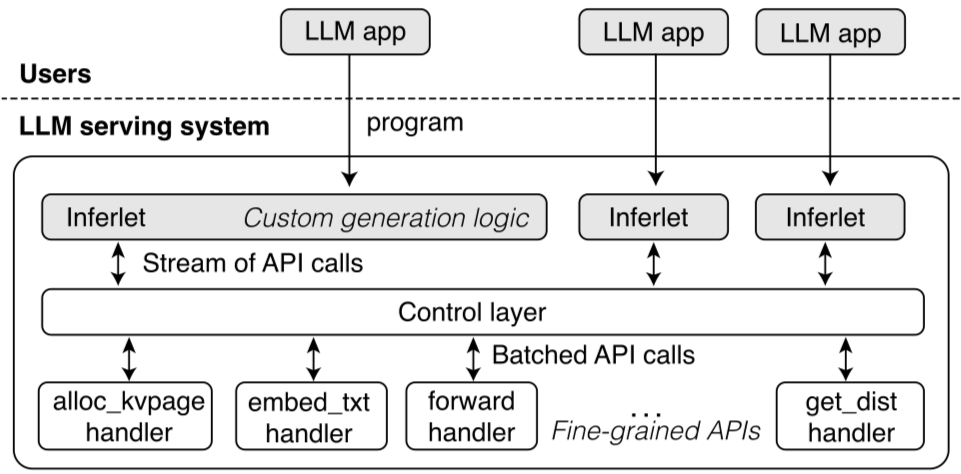
[论文评述] Pie: A Programmable Serving System for Emerging LLM Applications
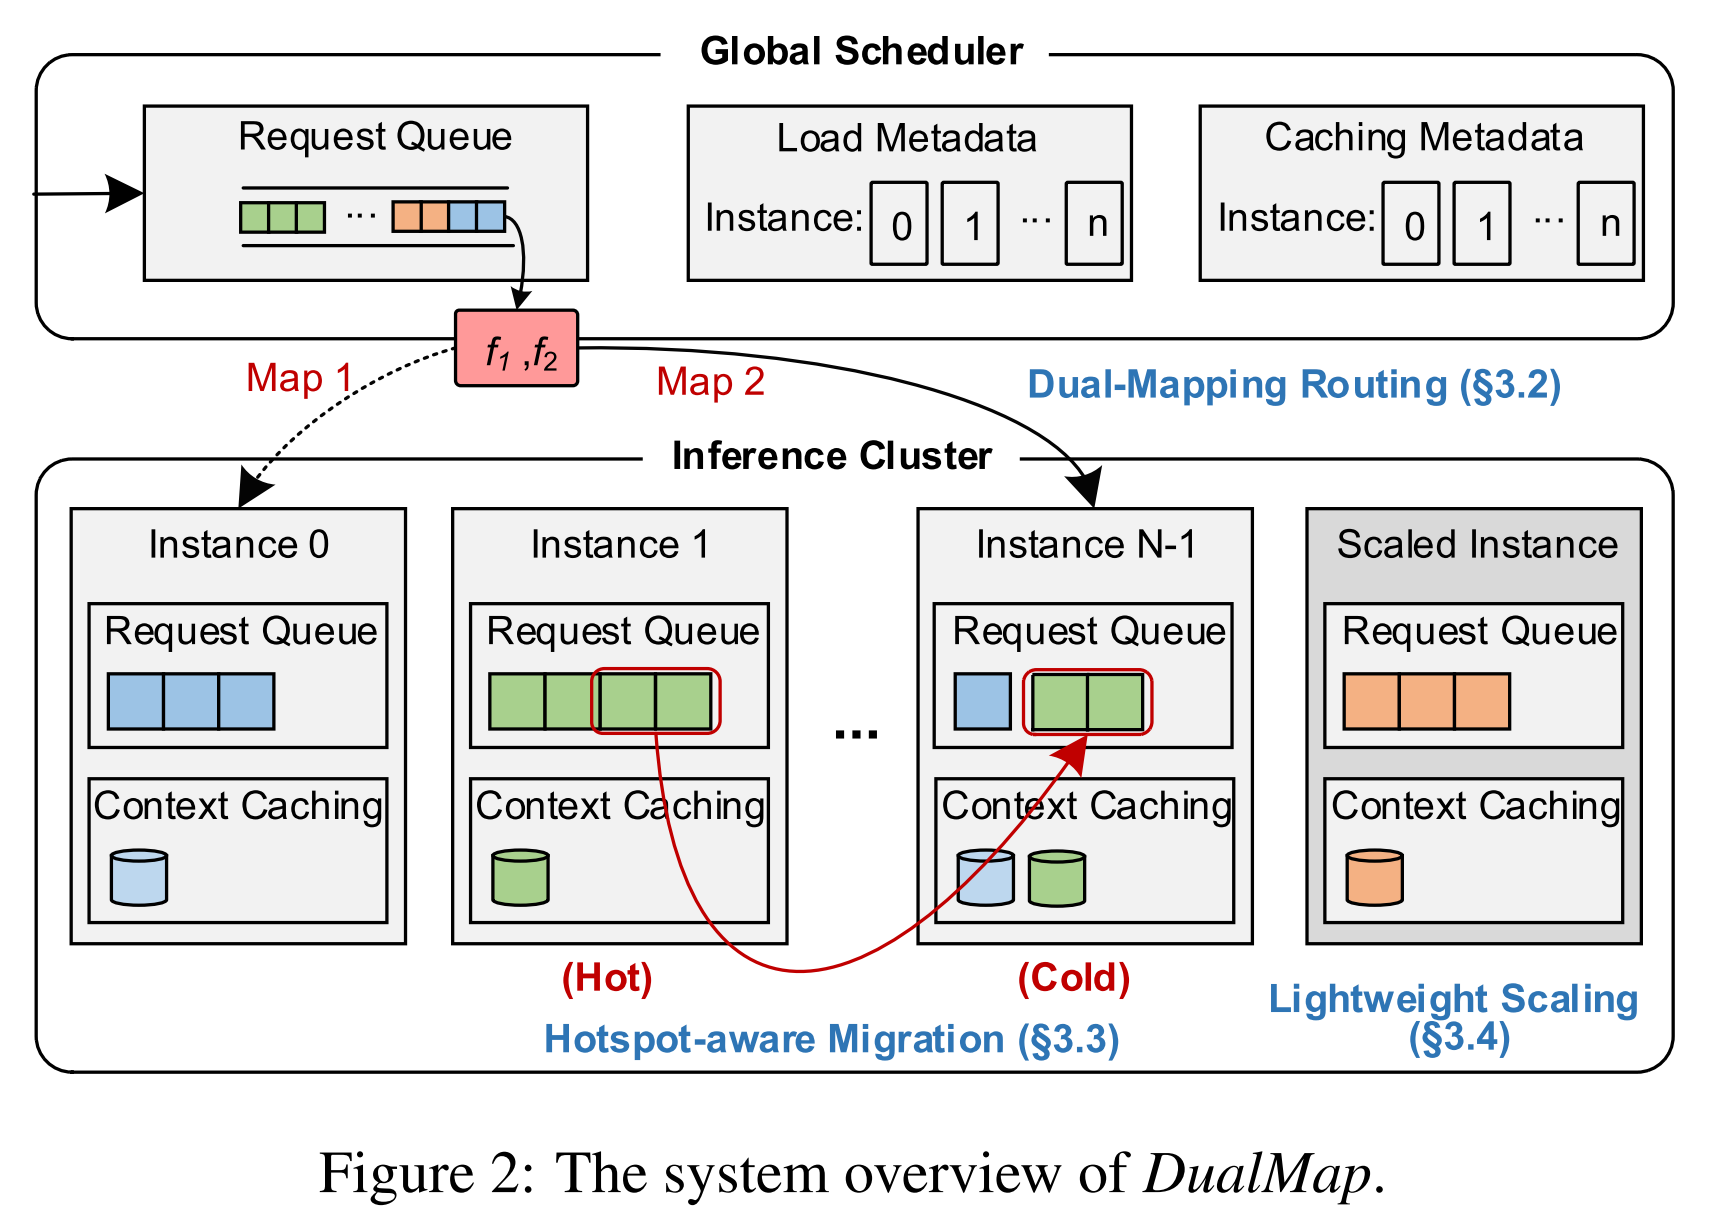
读论文:Distributed LLM Serving Scheduling - arcsin2 的个人博客
Advertisement Space (336x280)
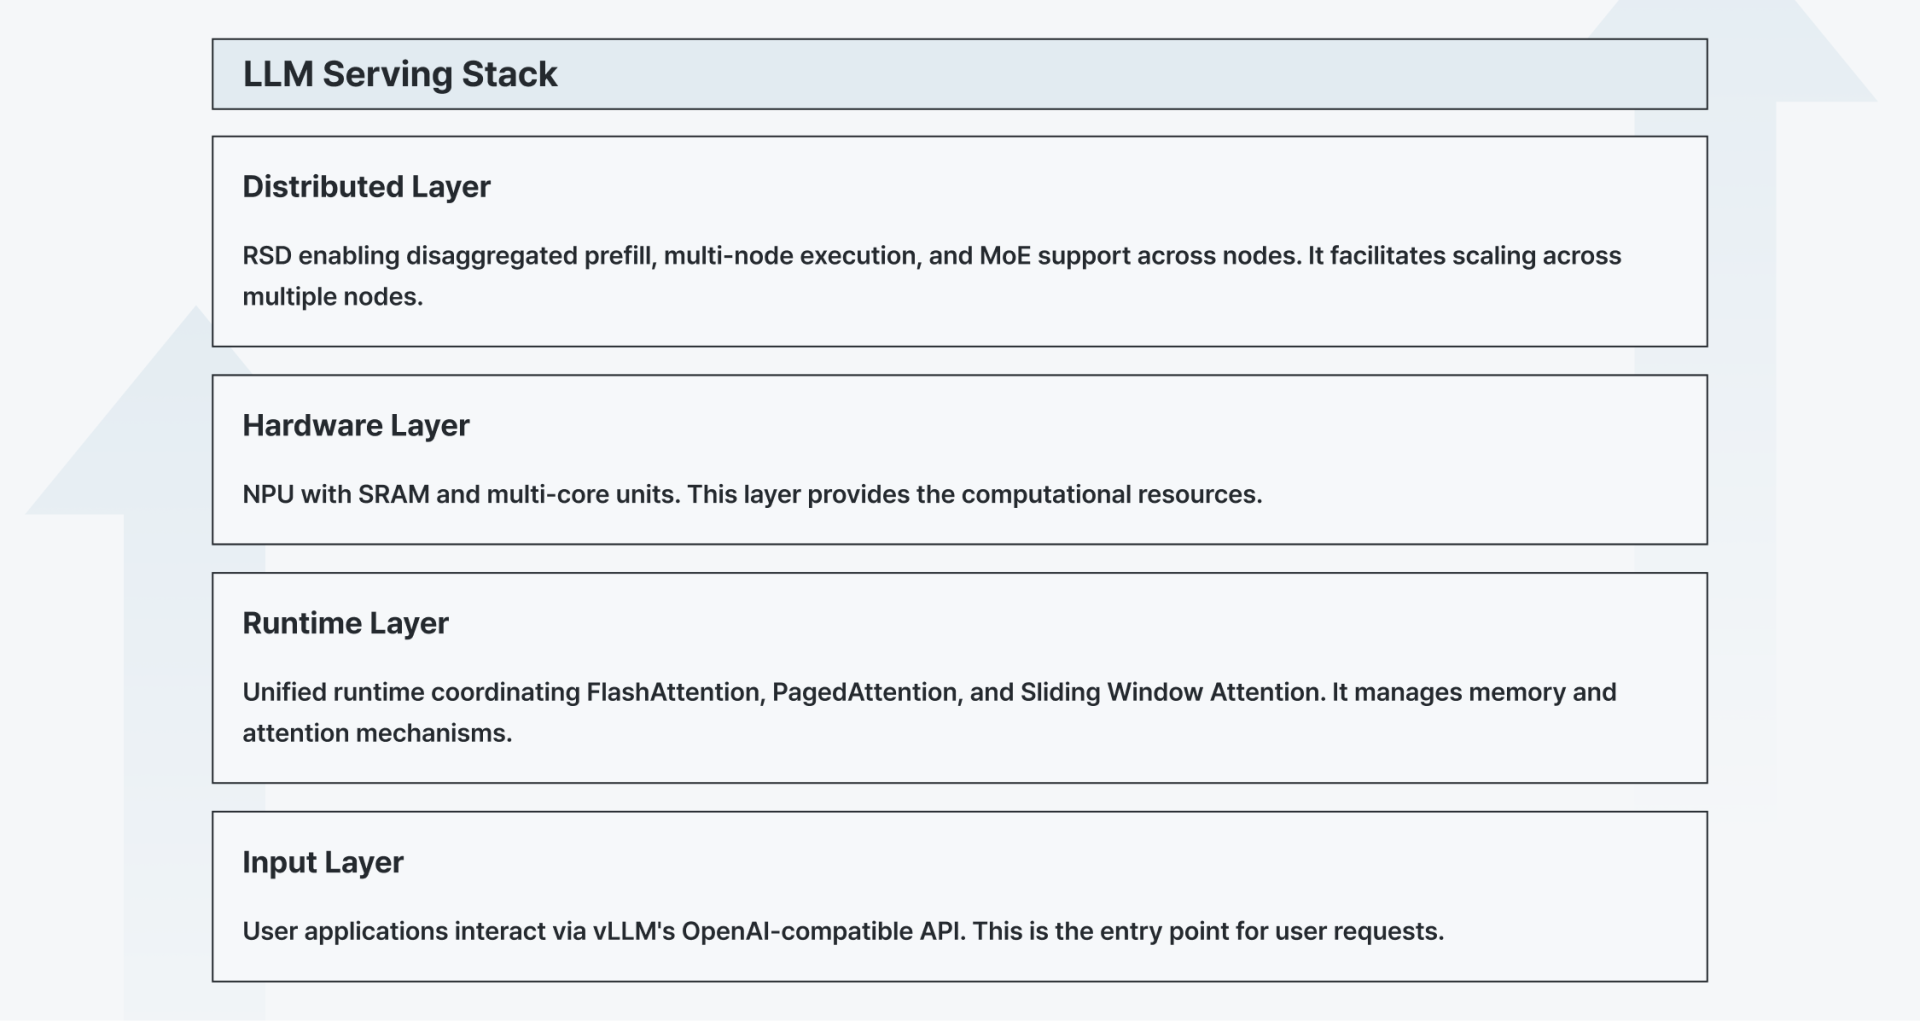
LLM Serving with NPU: Re-engineered, Built for Scale and Efficiency ...

Figure 1 from OServe: Accelerating LLM Serving via Spatial-Temporal ...

llm - Transformer 从零开始 - GoCoding - SegmentFault 思否

人工智能 - 以 Nano-vLLM 为例,深入理解 LLM 推理引擎(Part 2) - IDP技术干货 - SegmentFault 思否
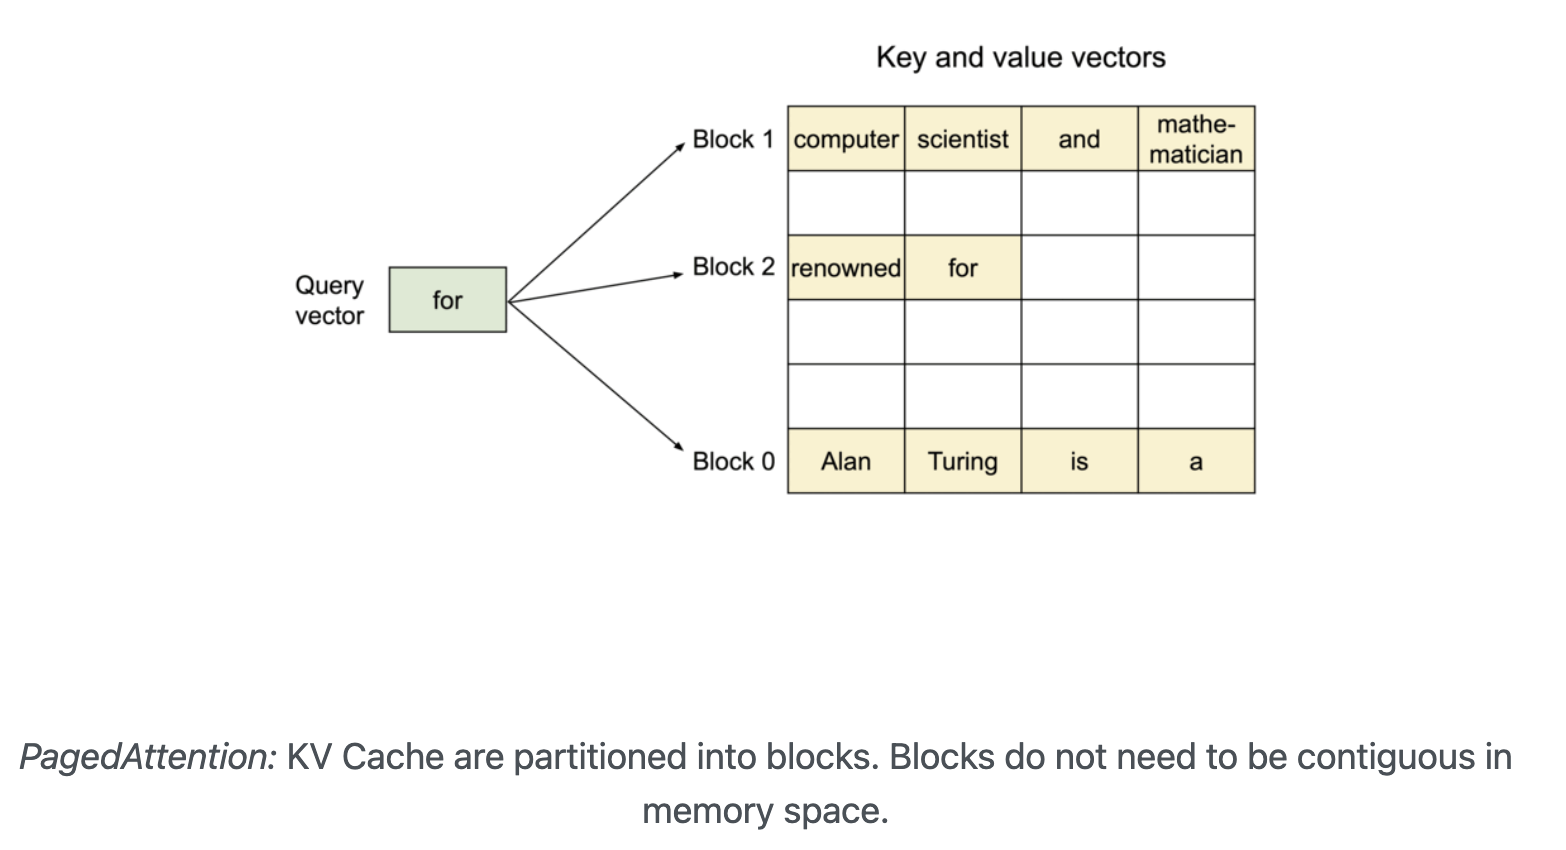
vLLM으로 LLM 모델 Serving