
Maskedkd Efficient Distillation Of Vision Transformers With Masked

MaskedKD: Efficient Distillation of Vision Transformers with Masked ...

MaskedKD: Efficient Distillation of Vision Transformers with Masked ...
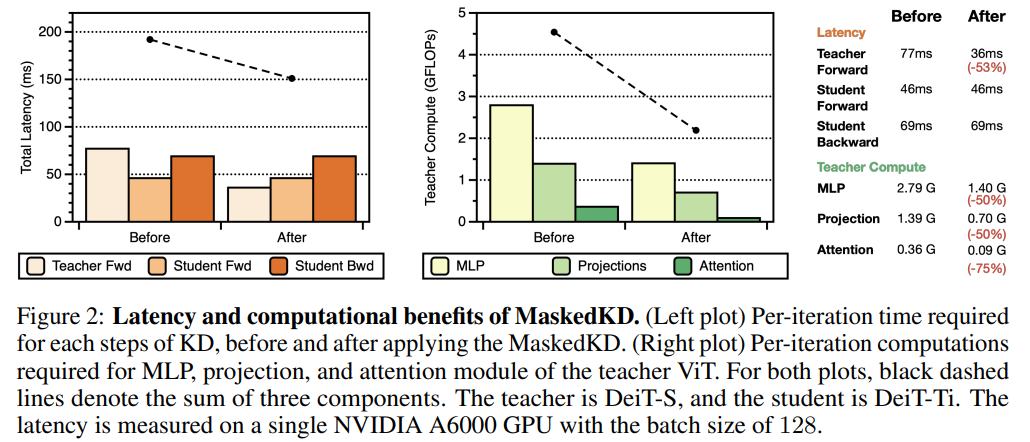
MaskedKD: Efficient Distillation of Vision Transformers with Masked ...
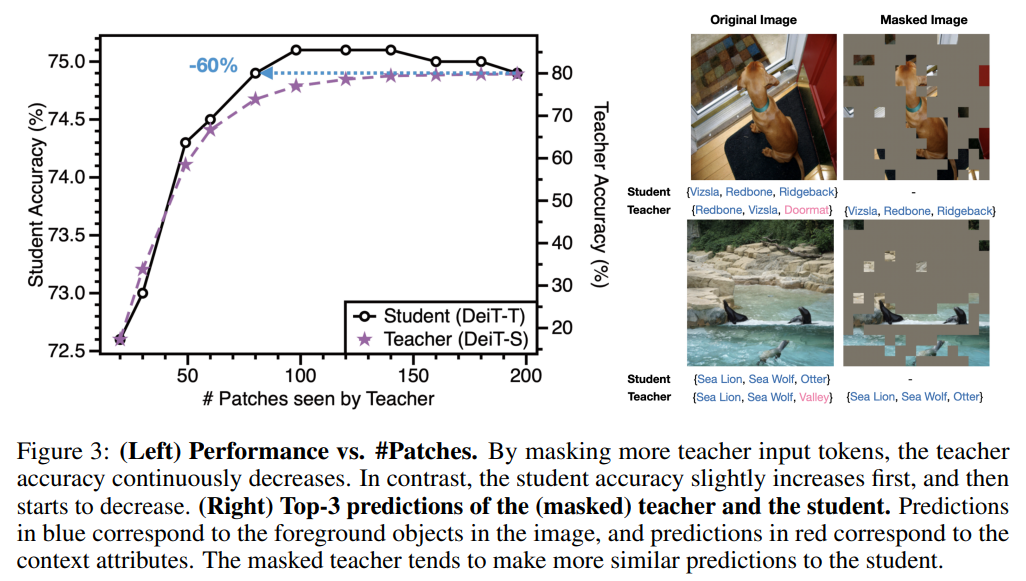
MaskedKD: Efficient Distillation of Vision Transformers with Masked ...
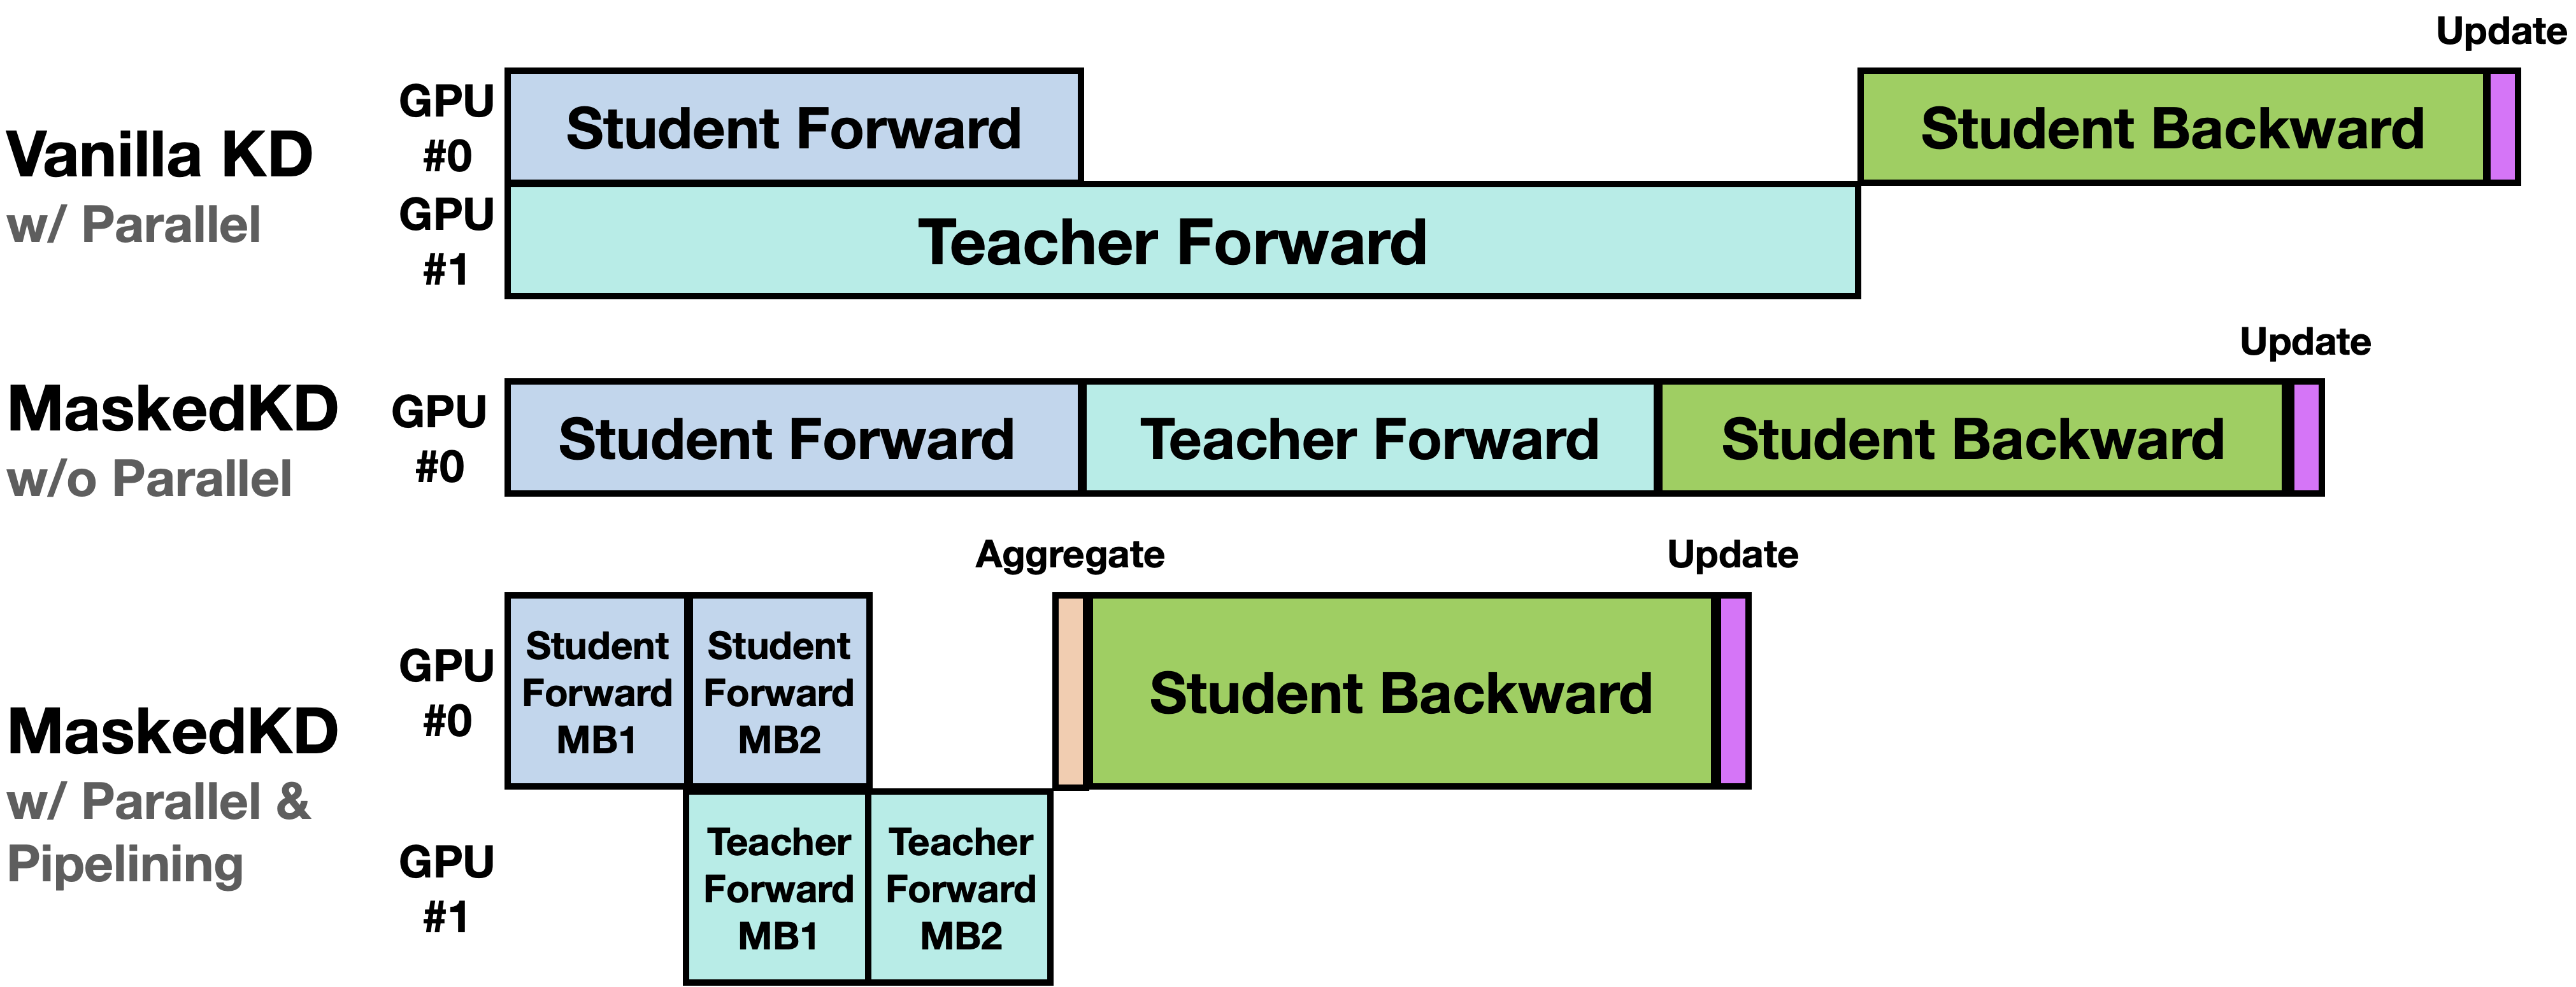
[2302.10494] MaskedKD: Efficient Distillation of Vision Transformers ...
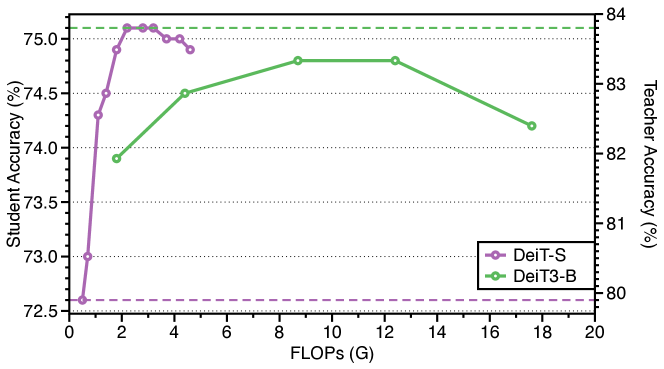
[2302.10494] MaskedKD: Efficient Distillation of Vision Transformers ...

(PDF) Fast Training of Diffusion Models with Masked Transformers

Fast Training of Diffusion Models with Masked Transformers | DeepAI
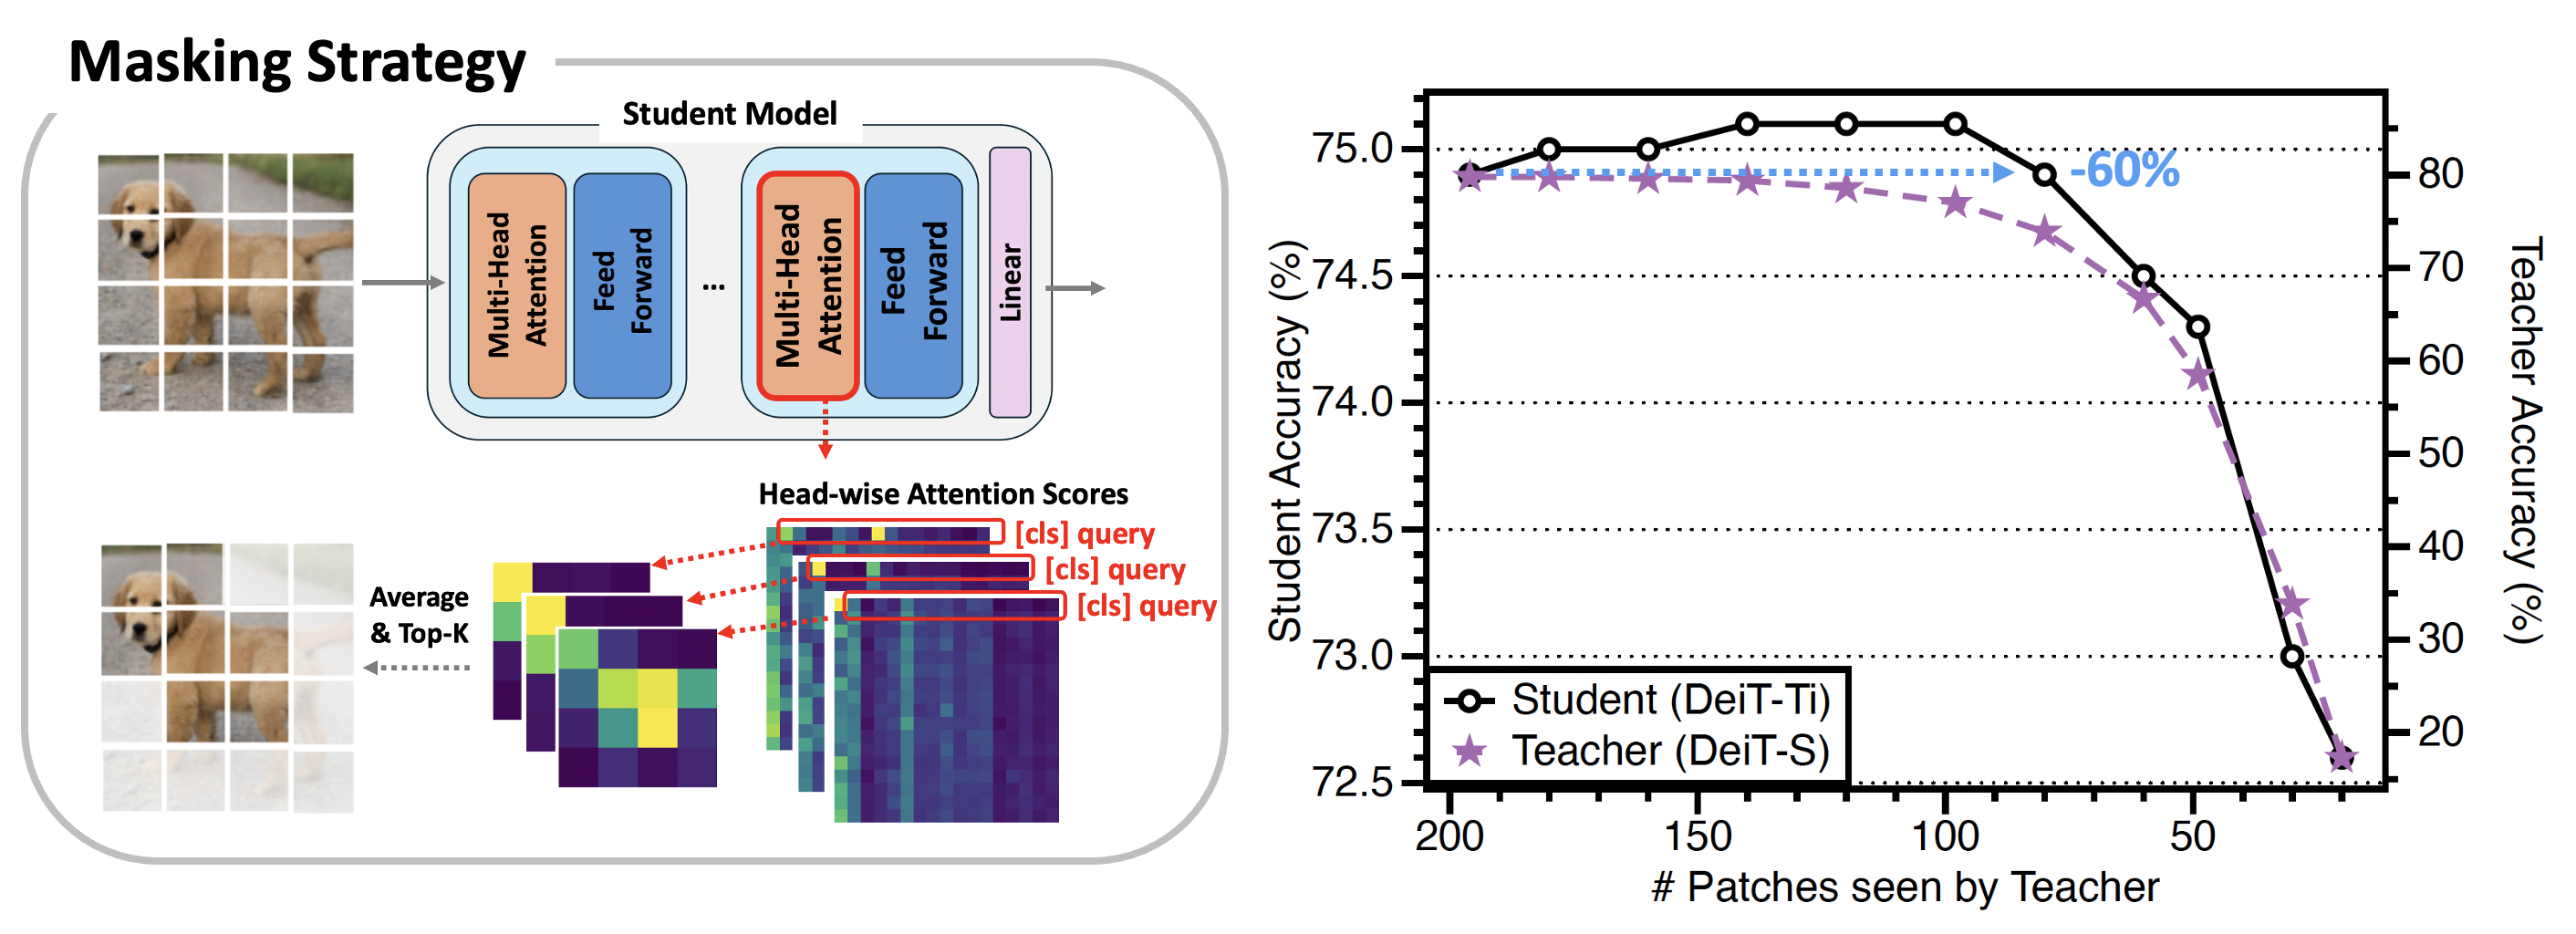
The Role of Masking for Efficient Supervised Knowledge Distillation of ...
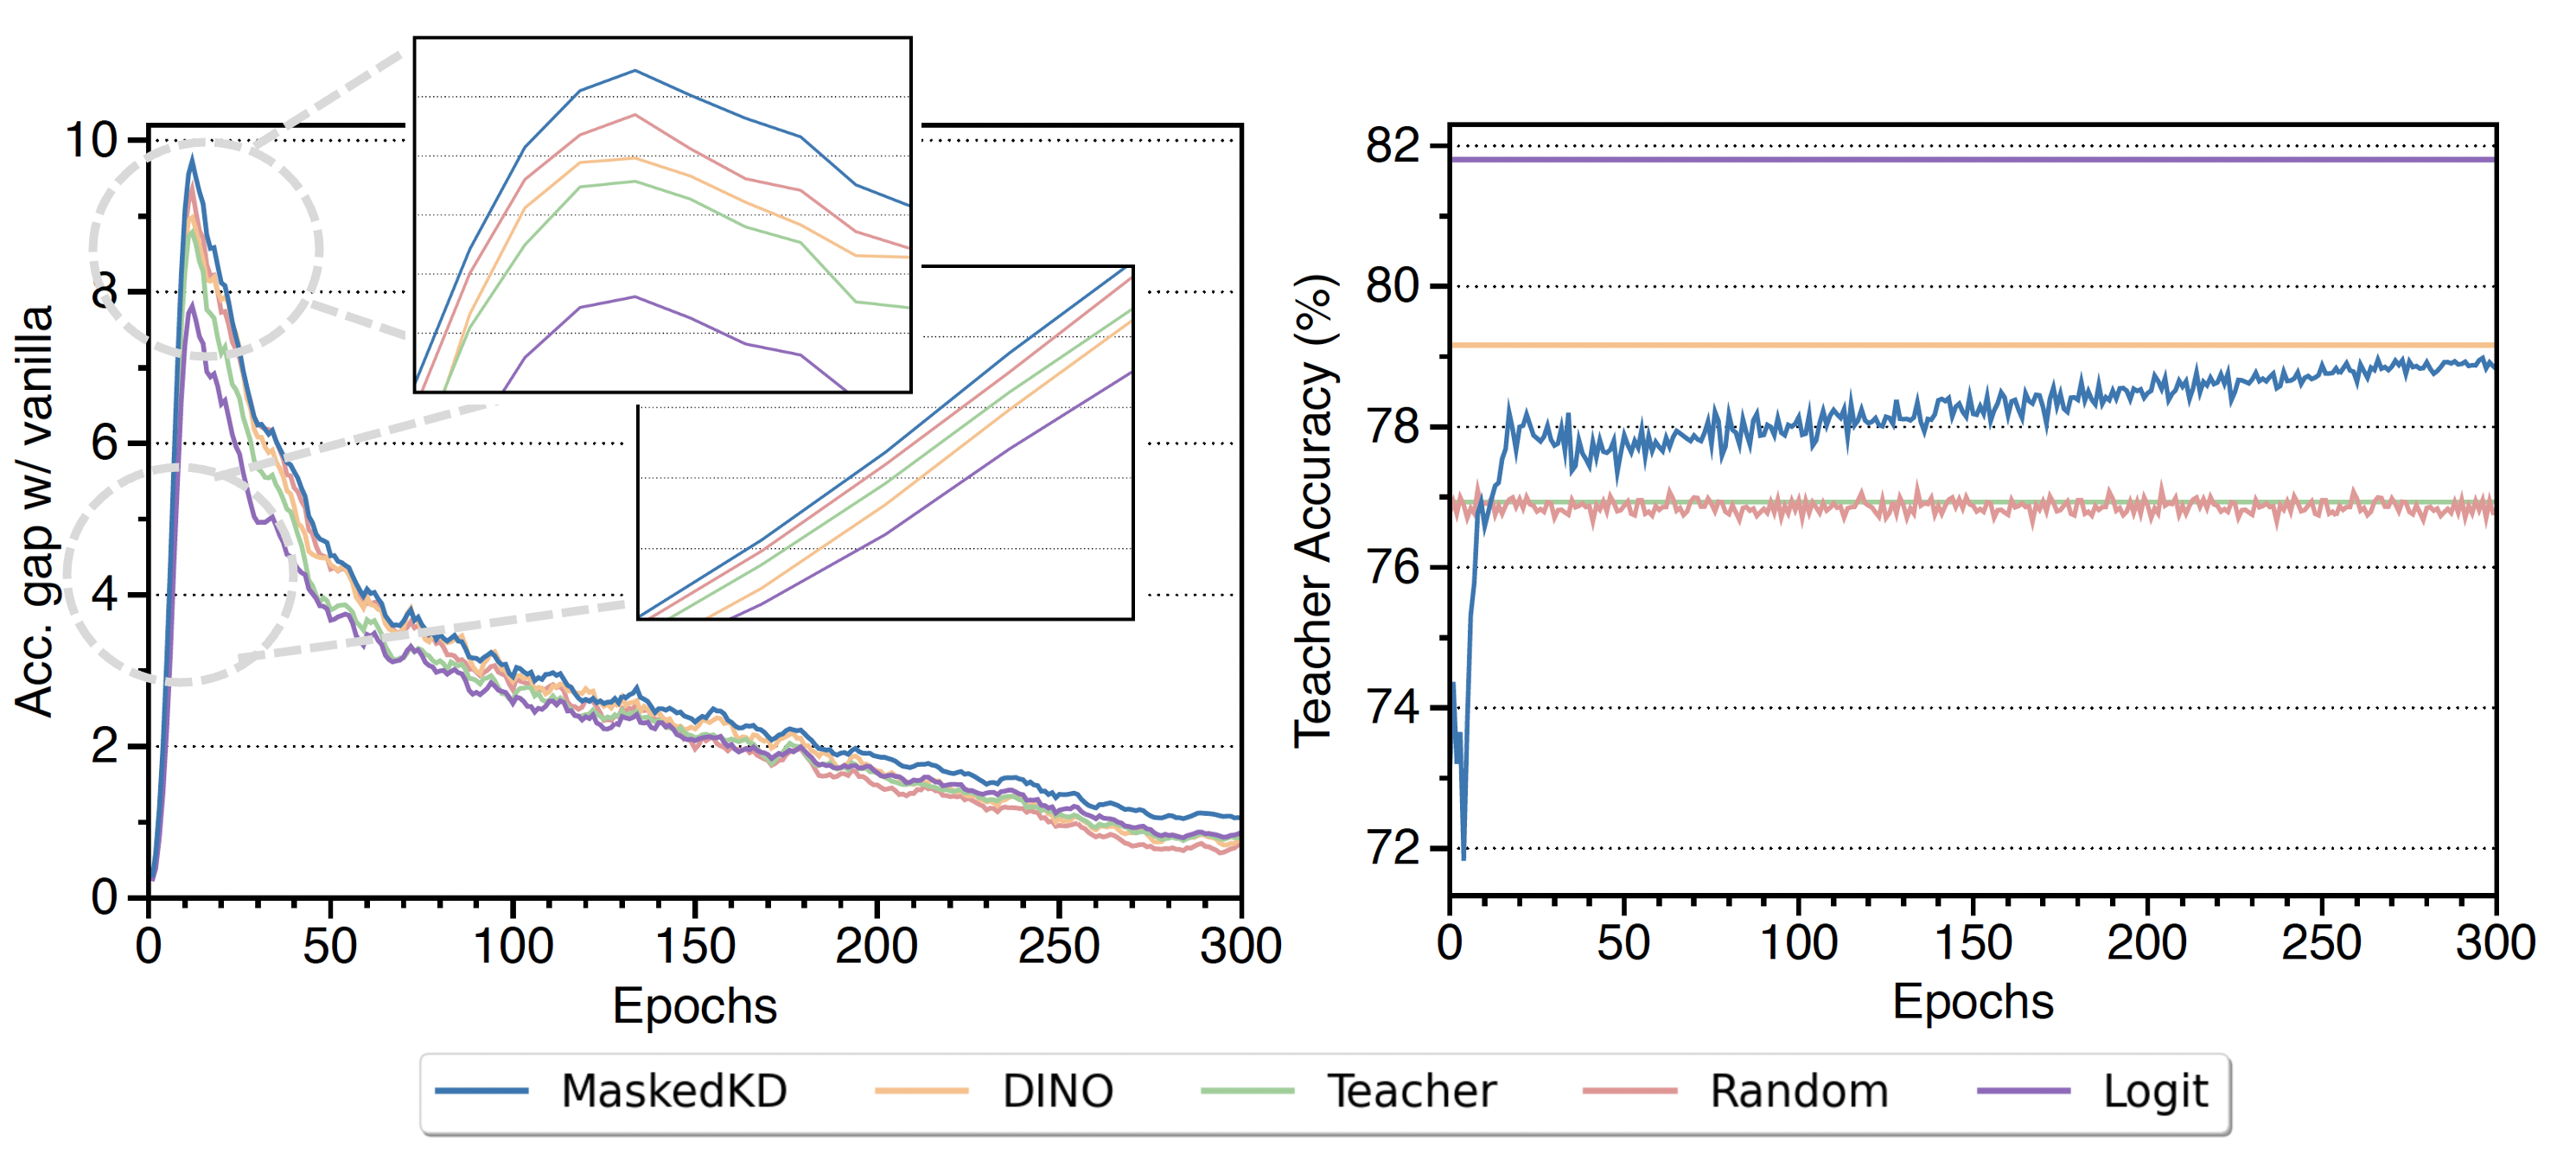
The Role of Masking for Efficient Supervised Knowledge Distillation of ...
Advertisement Space (300x250)
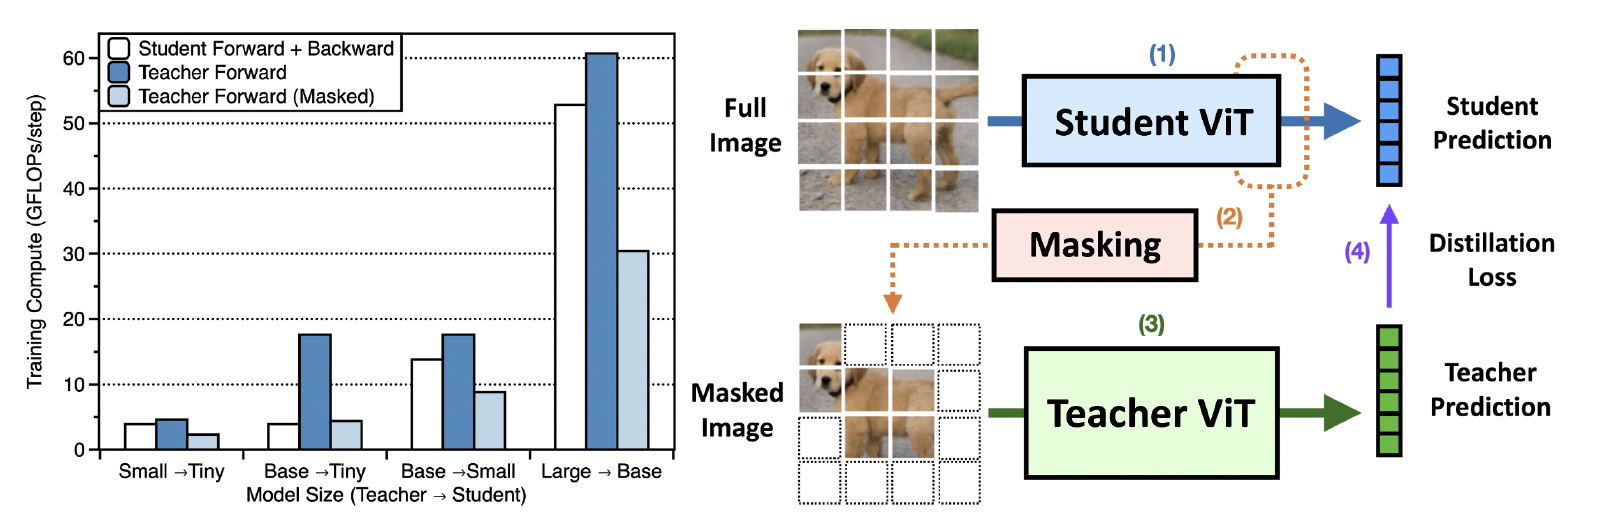
The Role of Masking for Efficient Supervised Knowledge Distillation of ...

Figure 1 from Masked Vision Transformers for Hyperspectral Image ...
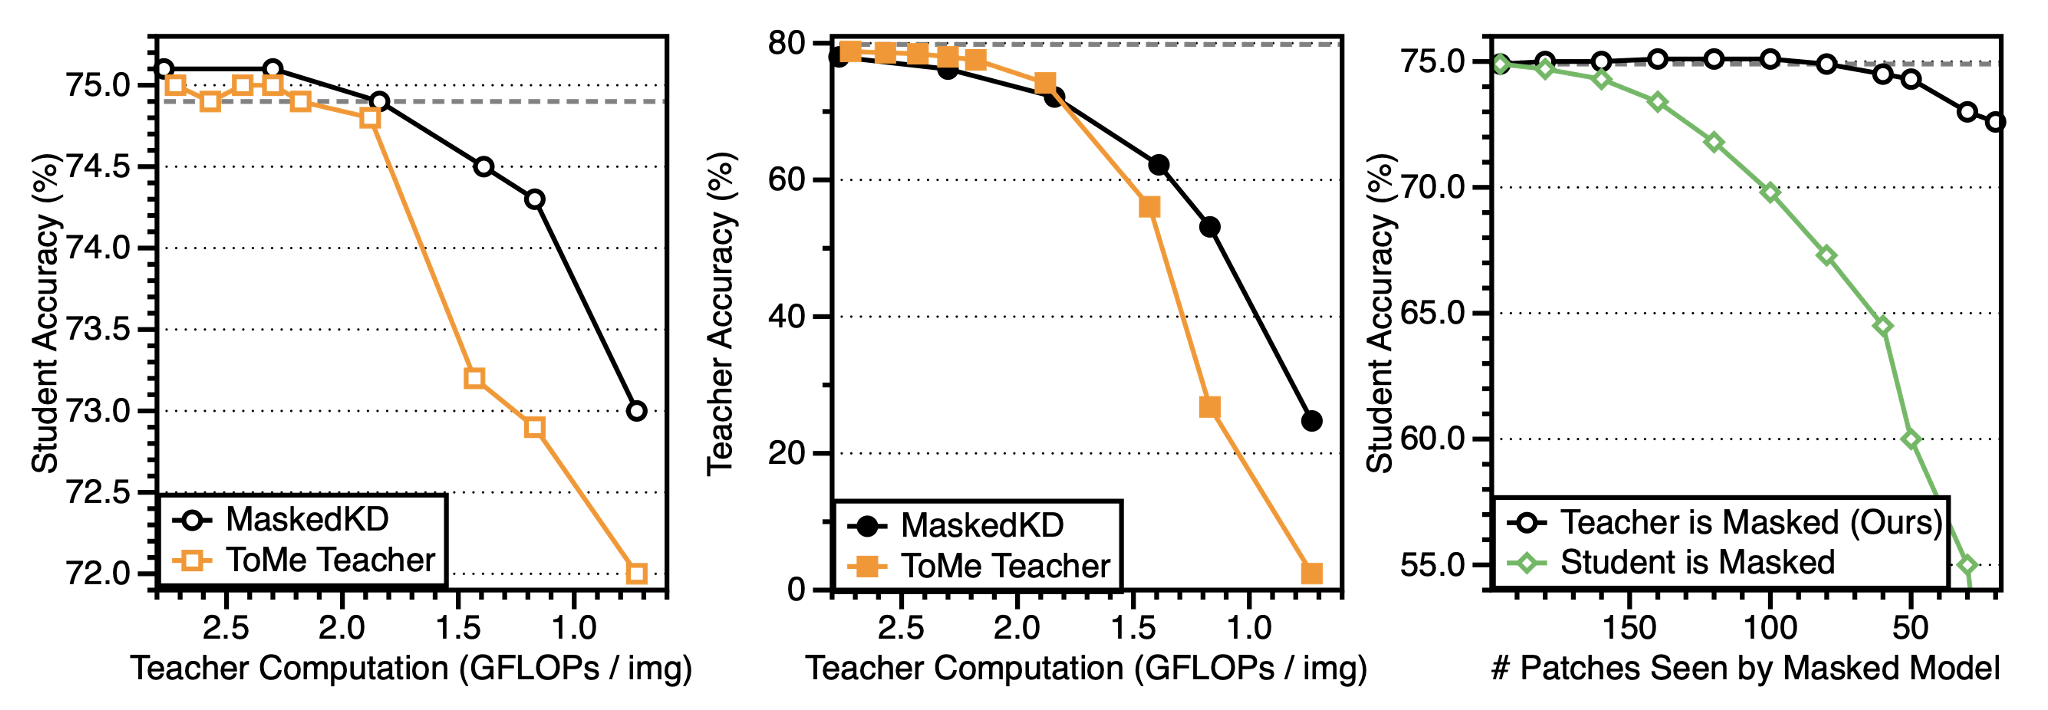
The Role of Masking for Efficient Supervised Knowledge Distillation of ...

Masked Channel Modeling Enables Vision Transformers to Learn Better ...

Figure 1 from Masked Vision Transformers for Hyperspectral Image ...

Semi-MAE: Masked Autoencoders for Semi-supervised Vision Transformers ...
The Role of Masking for Efficient Supervised Knowledge Distillation of ...
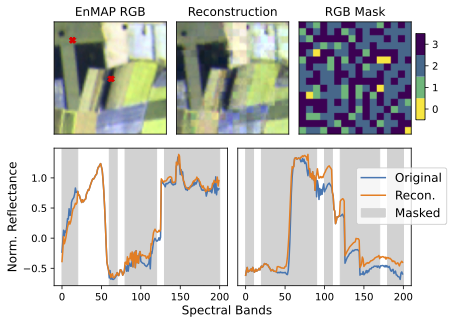
Masked Vision Transformers for Hyperspectral Image Classification | HSG ...

Figure 2 from Disjoint Masking With Joint Distillation for Efficient ...

(PDF) Supervised Masked Knowledge Distillation for Few-Shot Transformers
Advertisement Space (336x280)

(PDF) Effectiveness of masked autoencoder in vision transformer models ...
The Role of Masking for Efficient Supervised Knowledge Distillation of ...
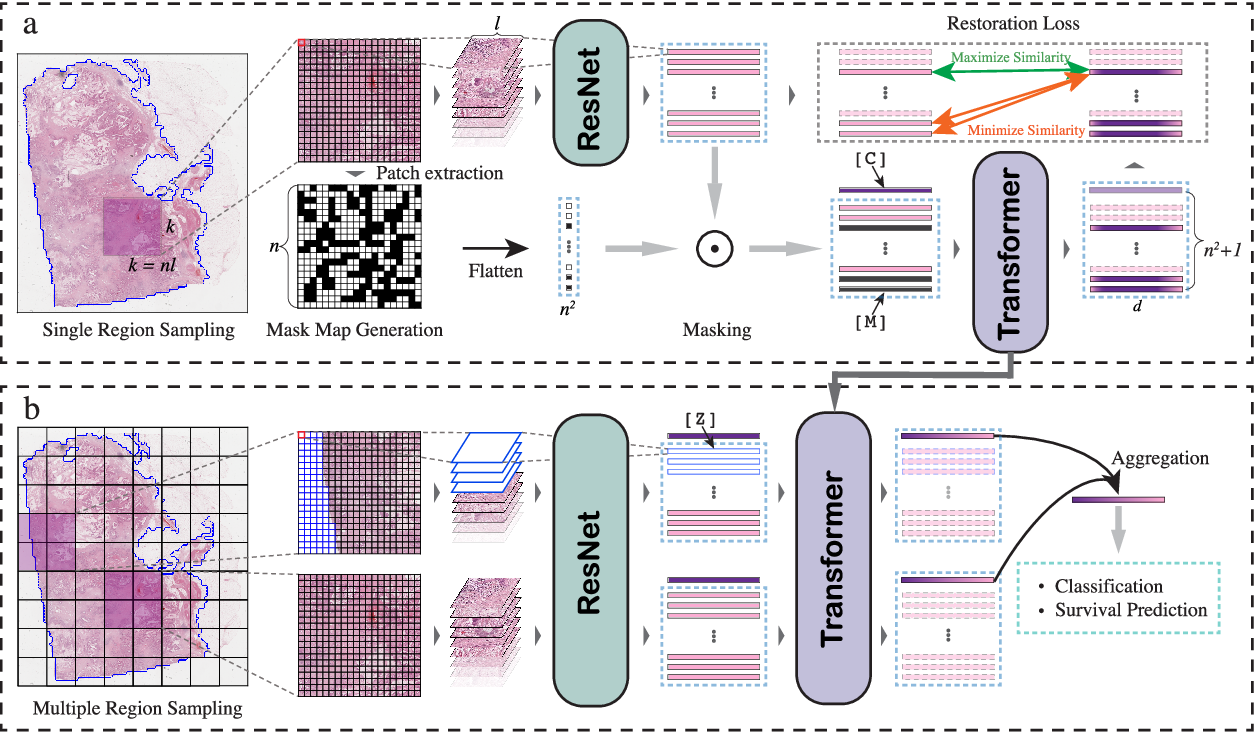
Figure 1 from Masked Pre-Training of Transformers for Histology Image ...

(PDF) MS-DINO: Efficient Distributed Training of Vision Transformer ...
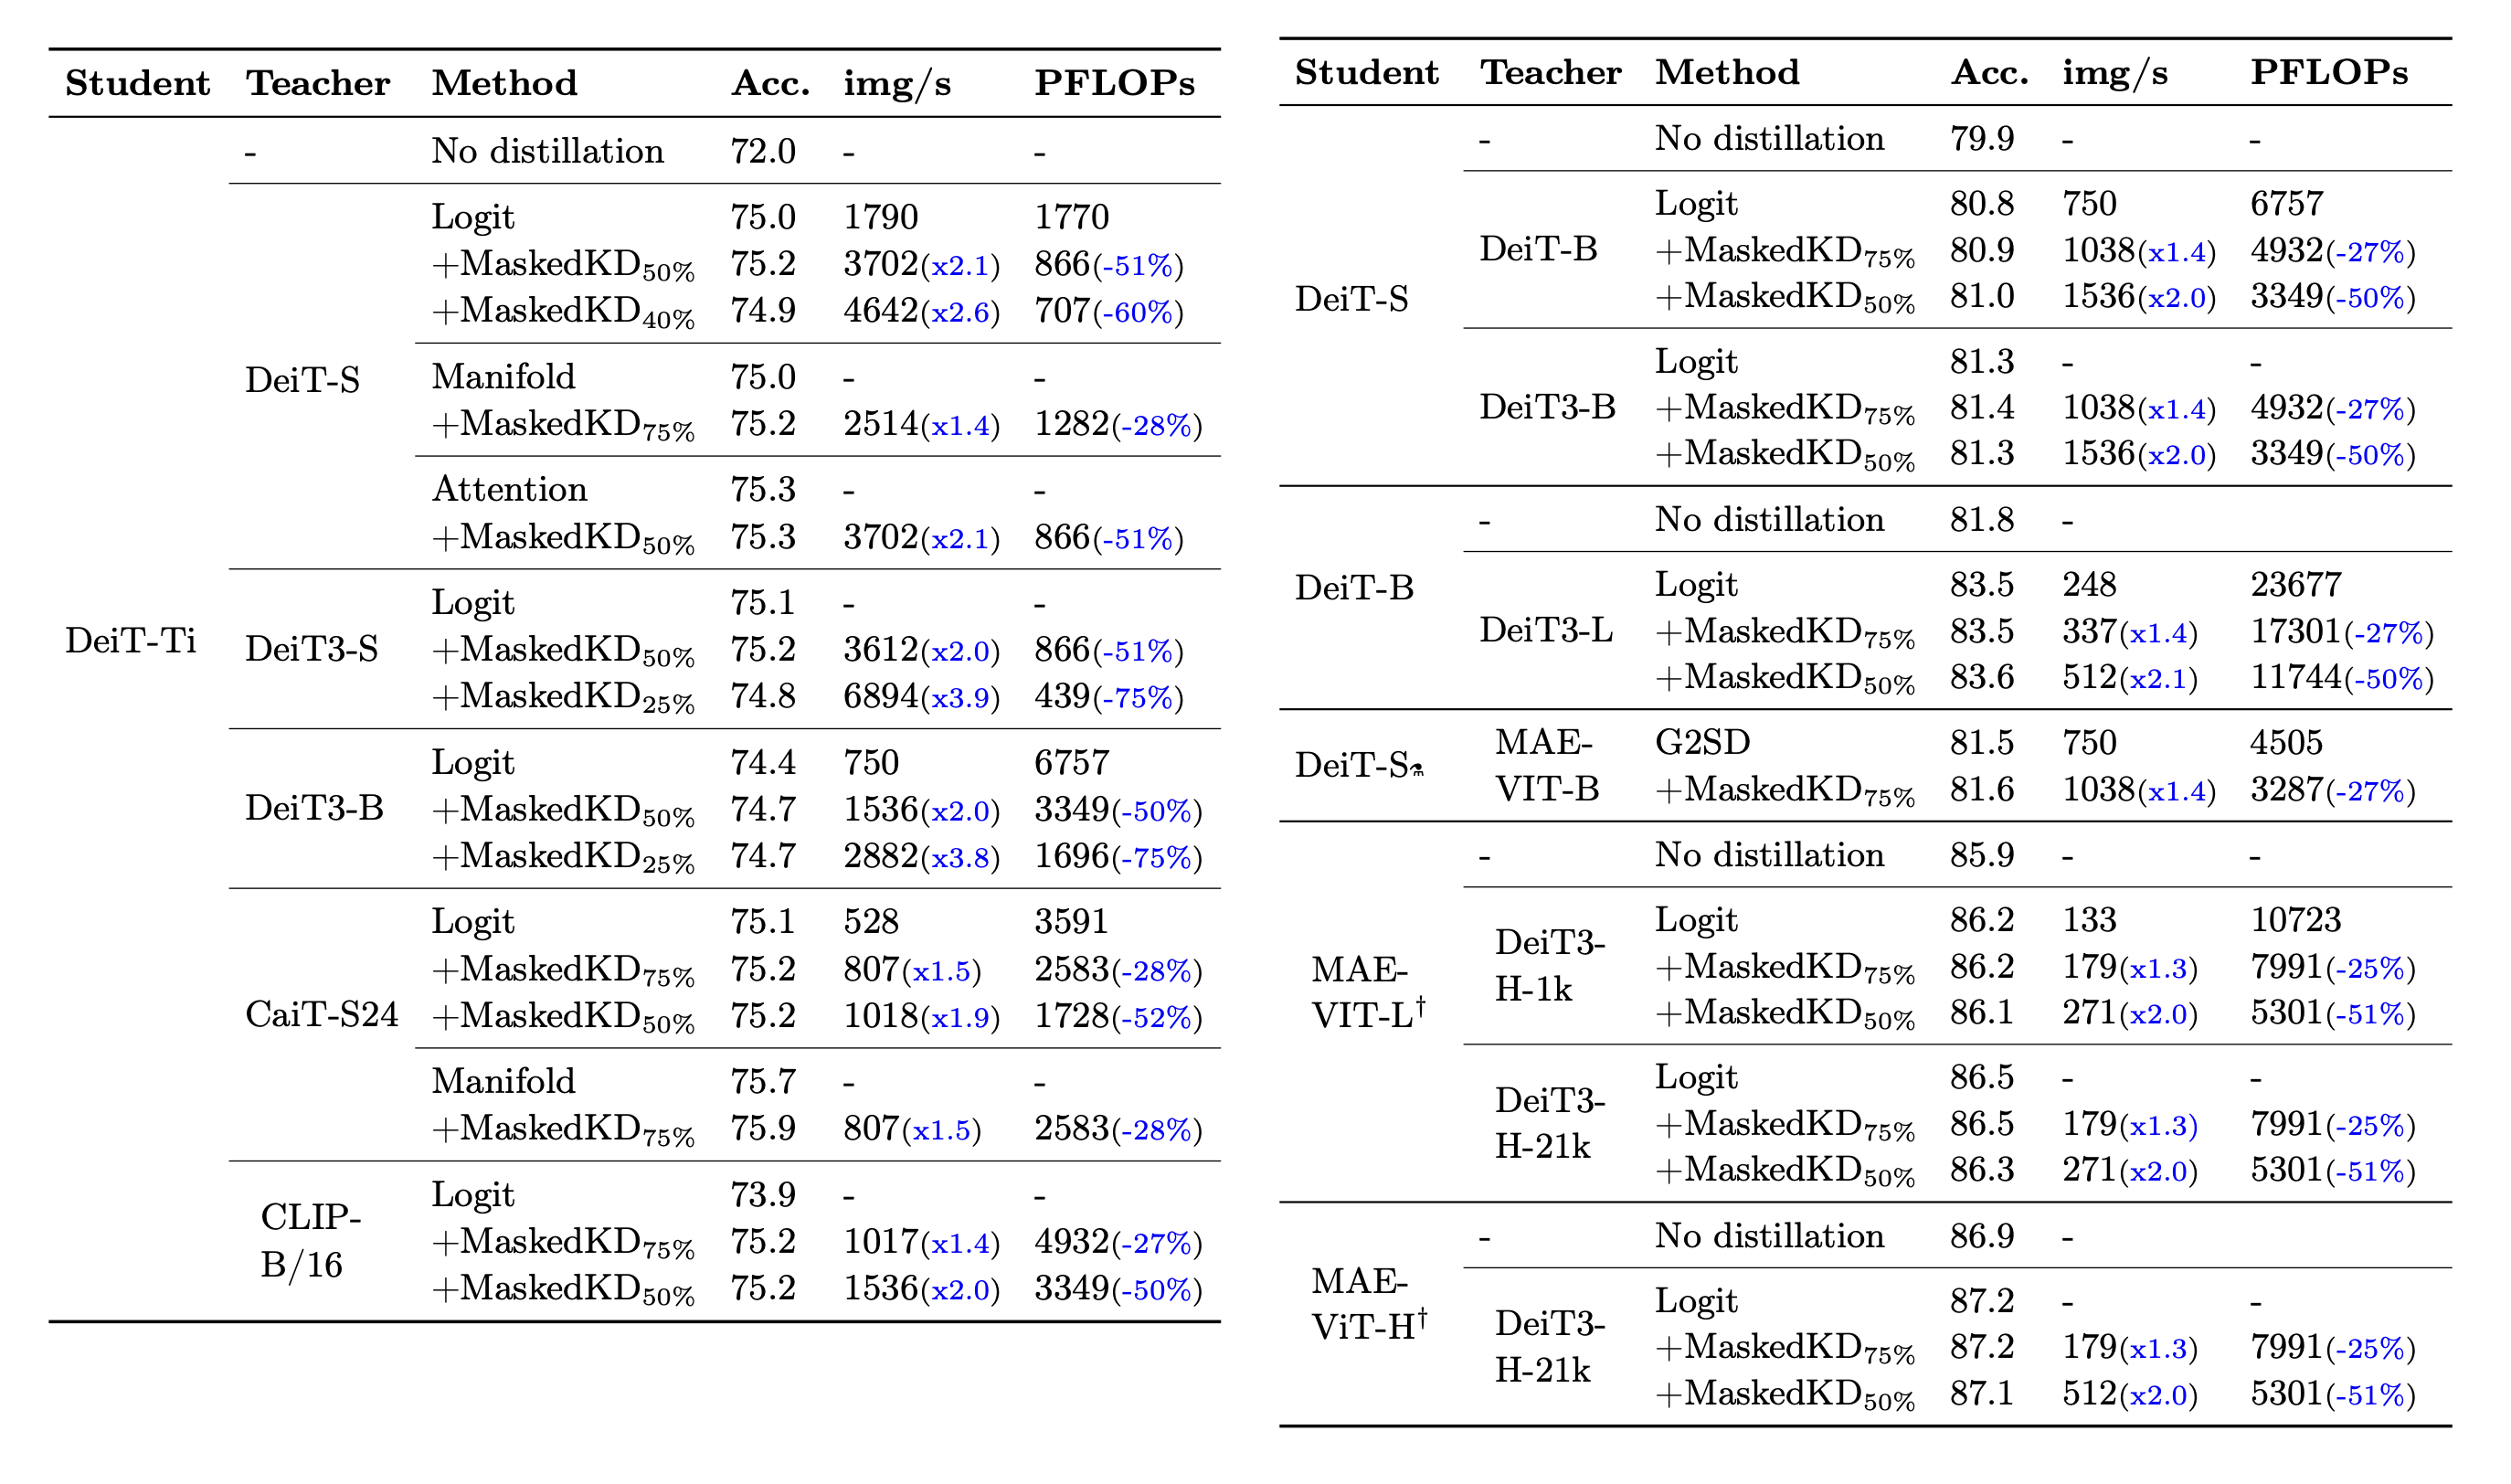
The Role of Masking for Efficient Supervised Knowledge Distillation of ...

Figure 2 from Learning Efficient Vision Transformers via Fine-Grained ...

Figure 1 from Vision transformer with masked autoencoders for referable ...

MS-DINO: Efficient Distributed Training of Vision Transformer ...

Day 11 of 30 – Masked Autoencoders (MAE): Self-Supervised Transformers ...

Masked Channel Modeling Enables Vision Transformers to Learn Better ...
Advertisement Space (336x280)

(PDF) E-MD3C: Taming Masked Diffusion Transformers for Efficient Zero ...

Paper page - Disjoint Masking with Joint Distillation for Efficient ...

Figure 2 from Disjoint Masking With Joint Distillation for Efficient ...

Figure 2 from Disjoint Masking with Joint Distillation for Efficient ...
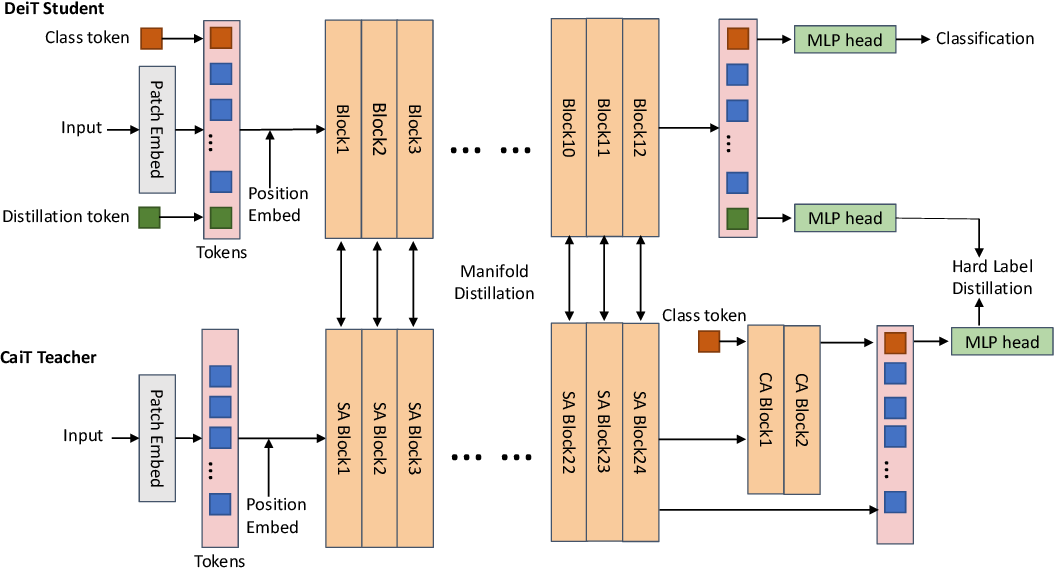
Figure 1 from Efficient Vision Transformers via Fine-Grained Manifold ...
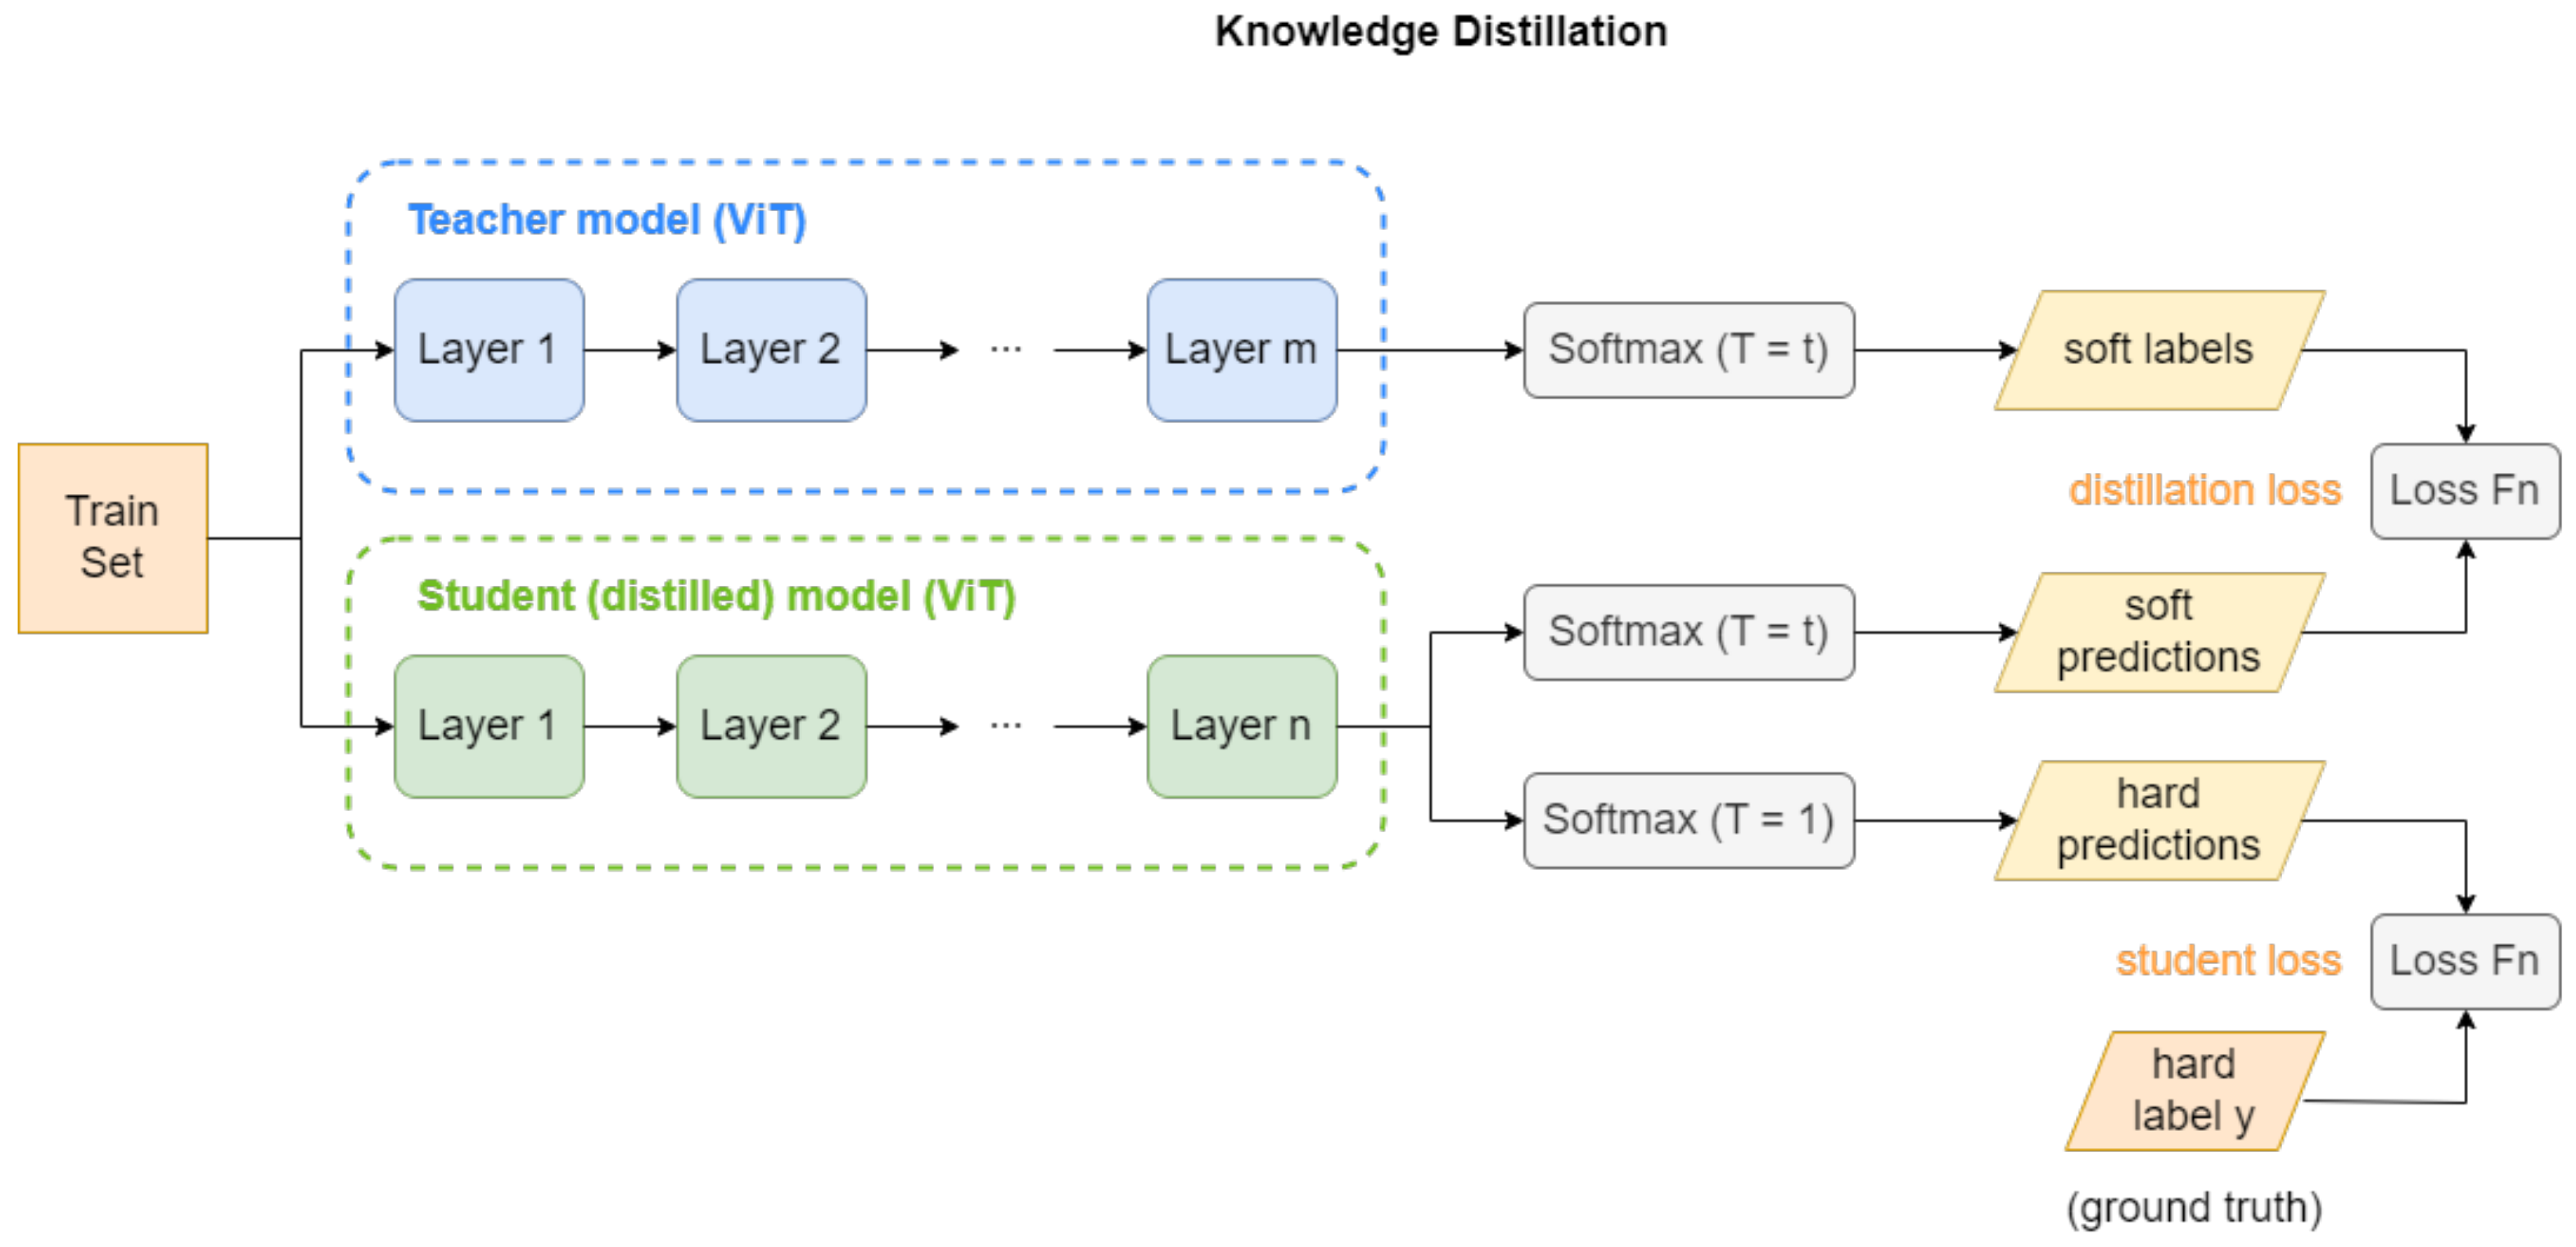
SDViT: Stacking of Distilled Vision Transformers for Hand Gesture ...