
Mixed Precision Graph Neural Quantization For Low Bit Large Language Models

Mixed-Precision Graph Neural Quantization for Low Bit Large Language Models

[论文评述] Mixed-Precision Graph Neural Quantization for Low Bit Large ...

Paper page - Mixed-Precision Graph Neural Quantization for Low Bit ...
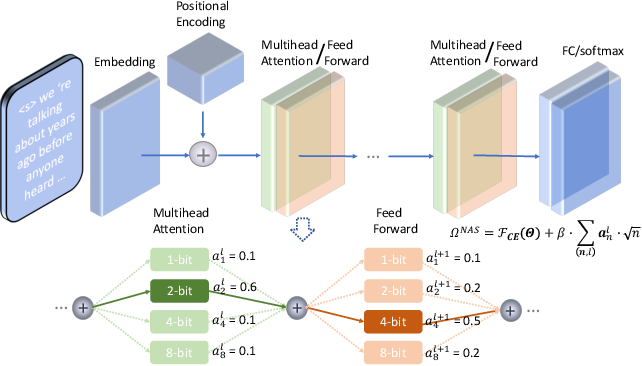
Mixed Precision Low-bit Quantization of Neural Network Language Models ...
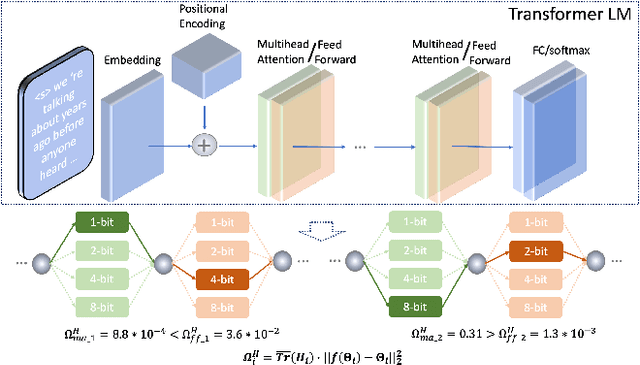
Mixed Precision Low-bit Quantization of Neural Network Language Models ...

[论文评述] Scaling Laws for Mixed quantization in Large Language Models

[논문 리뷰] Large Language Models Meet Graph Neural Networks for Text ...

[论文评述] Gradient-based Automatic Mixed Precision Quantization for Neural ...
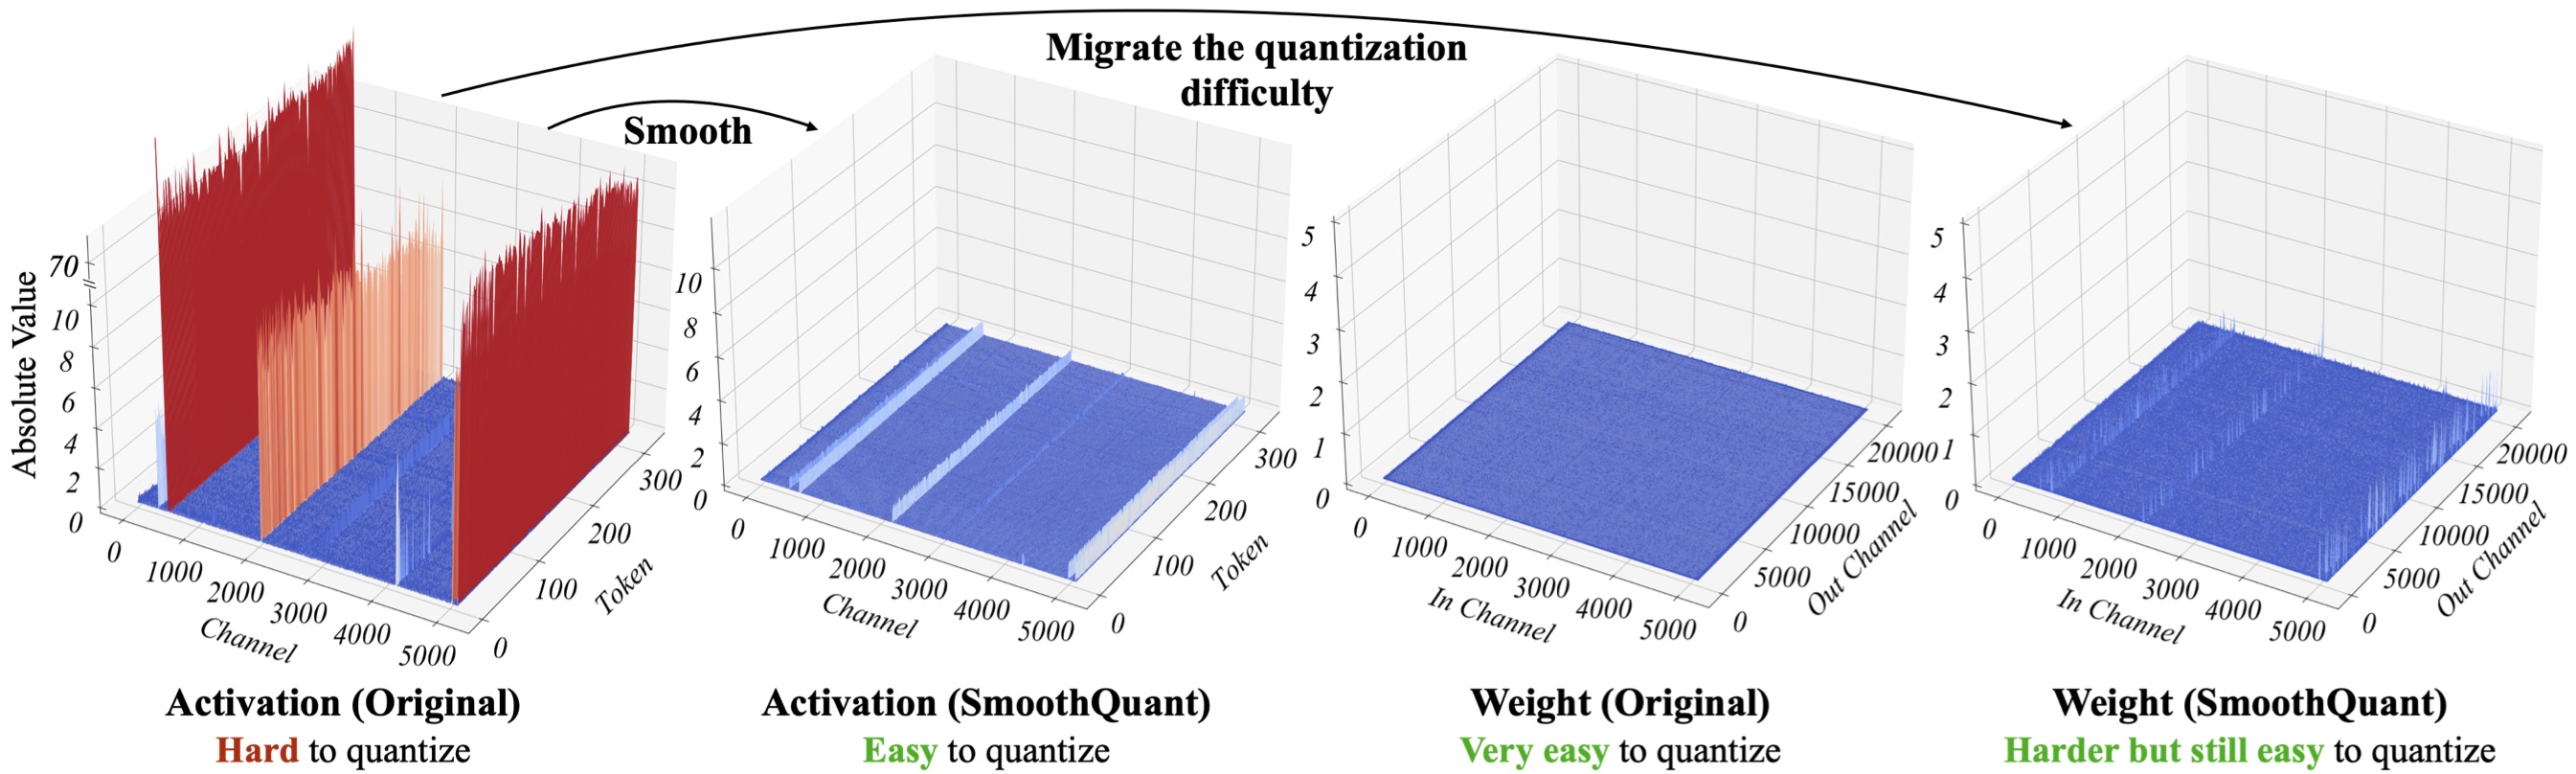
Ithy - Quantizing Large Language Models for Low VRAM
Microscaling Quantization for Large Language Models — AI Post Transformers
Advertisement Space (300x250)

(PDF) Memory-Driven Mixed Low Precision Quantization For Enabling Deep ...

Figure 1 from A New Mixed Precision Quantization Algorithm for Neural ...

[论文评述] Channel-Wise Mixed-Precision Quantization for Large Language Models

LUQ: Layerwise Ultra-Low Bit Quantization for Multimodal Large Language ...
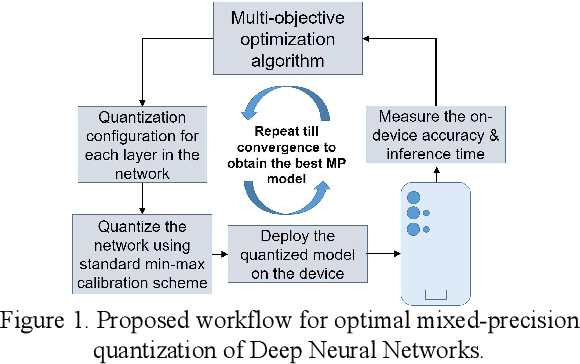
Figure 1 from Mixed Precision Neural Quantization with Multi-Objective ...

[논문 리뷰] ResQ: Mixed-Precision Quantization of Large Language Models ...
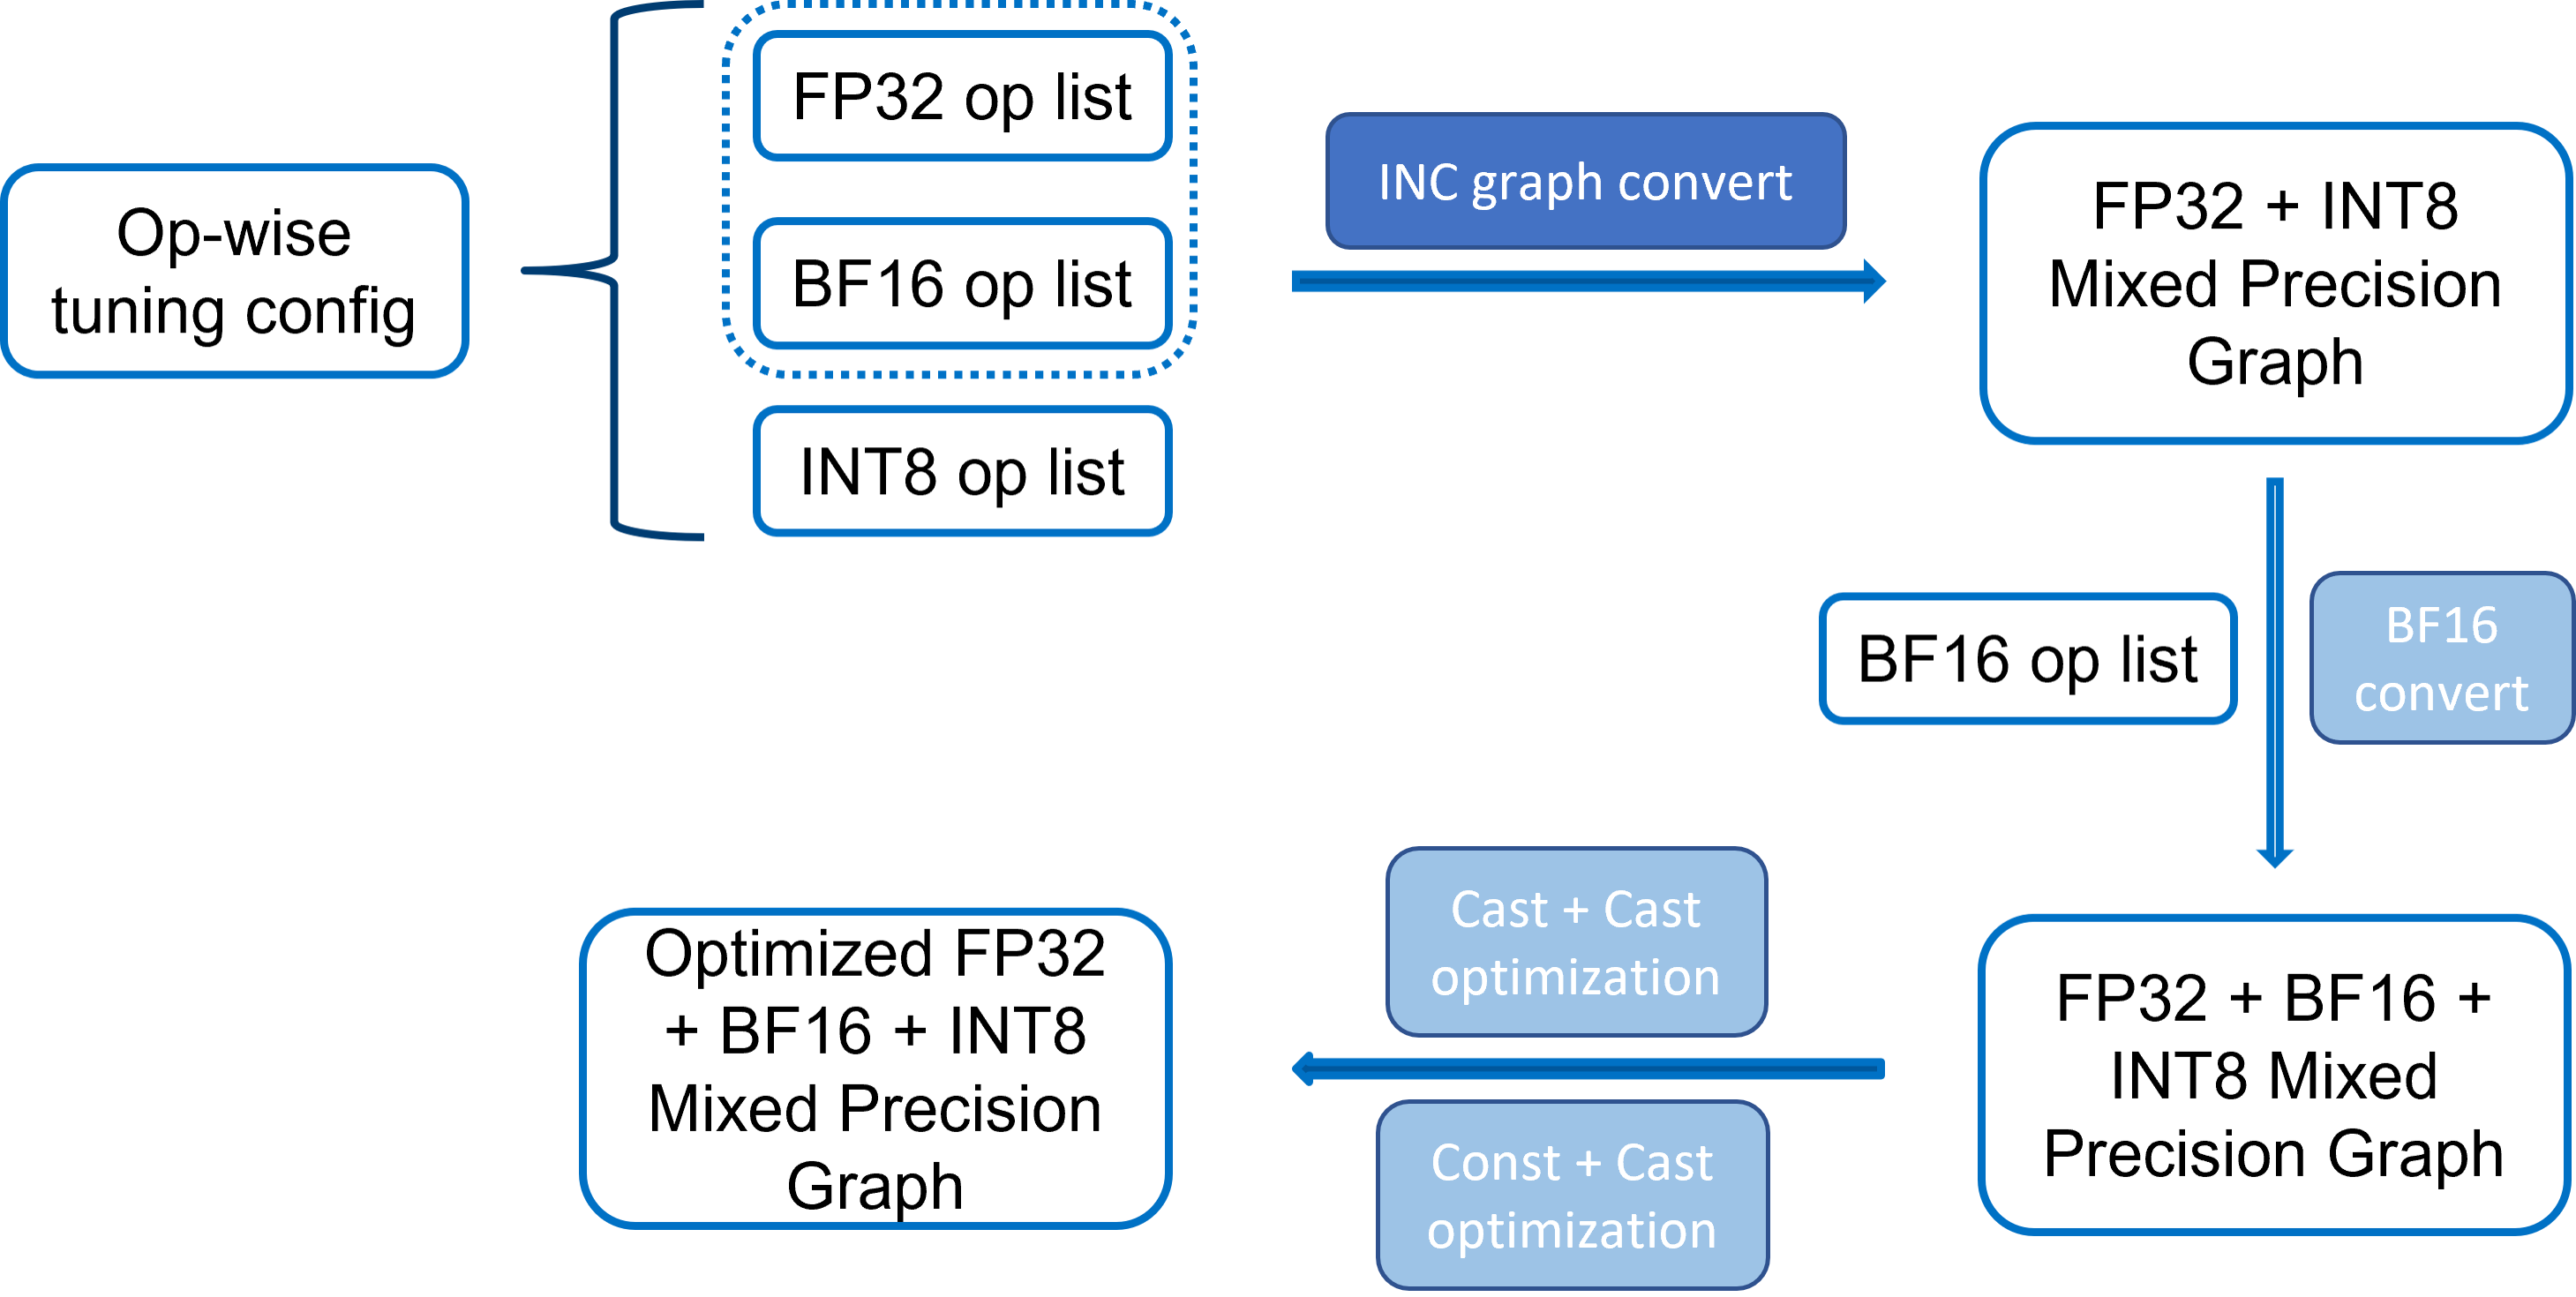
Turn ON Auto Mixed Precision during Quantization — Intel® Neural ...

Understanding Model Quantization in Large Language Models | DigitalOcean

Enhancing Ultra-Low-Bit Quantization of Large Language Models Through ...

Paper page - Mixed Precision Post Training Quantization of Neural ...
Advertisement Space (336x280)
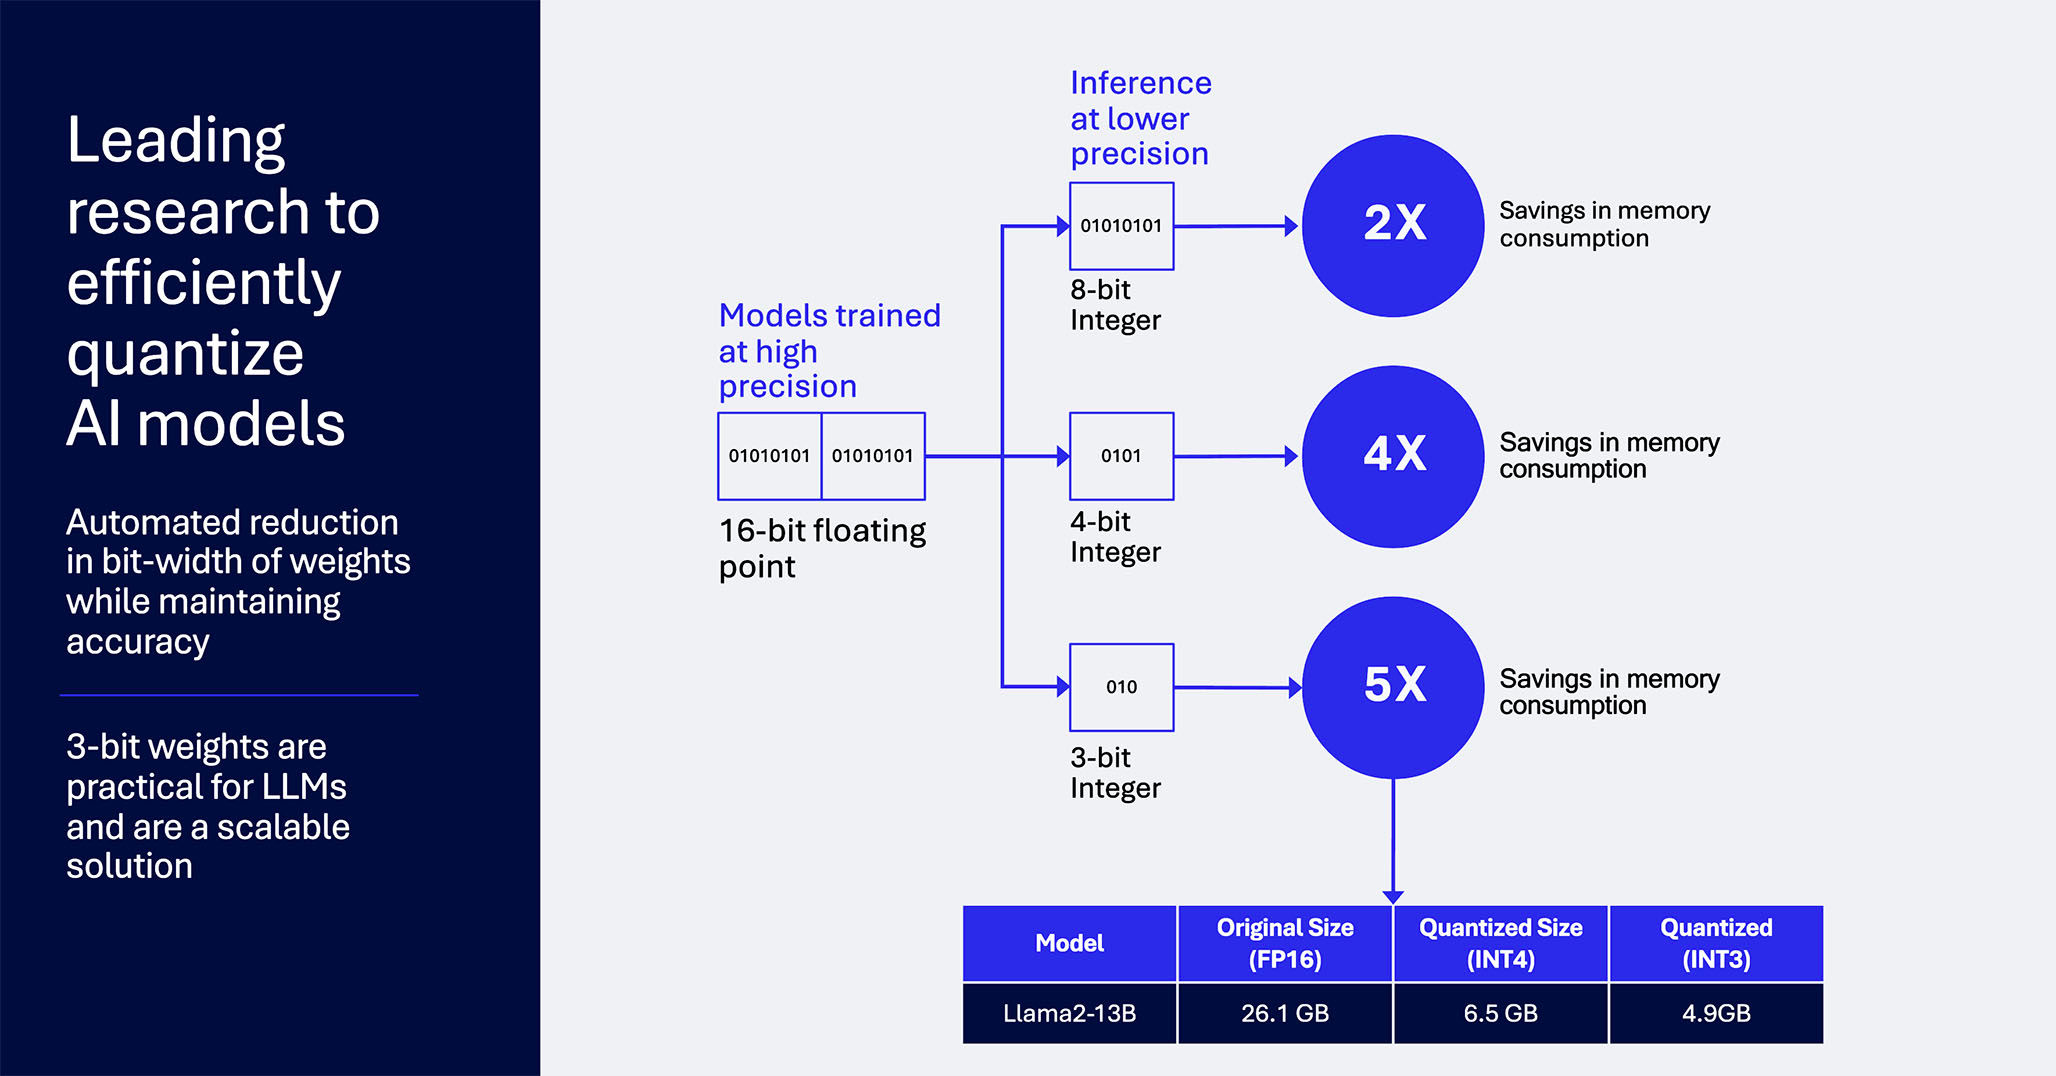
Quantization: Unlocking Scalability for Large Language Models - Edge AI ...

NanoQuant: Efficient Sub-1-Bit Quantization of Large Language Models ...

Low-bit Quantization of Recurrent Neural Network Language Models Using ...

[PDF] Post Training Mixed Precision Quantization of Neural Networks ...
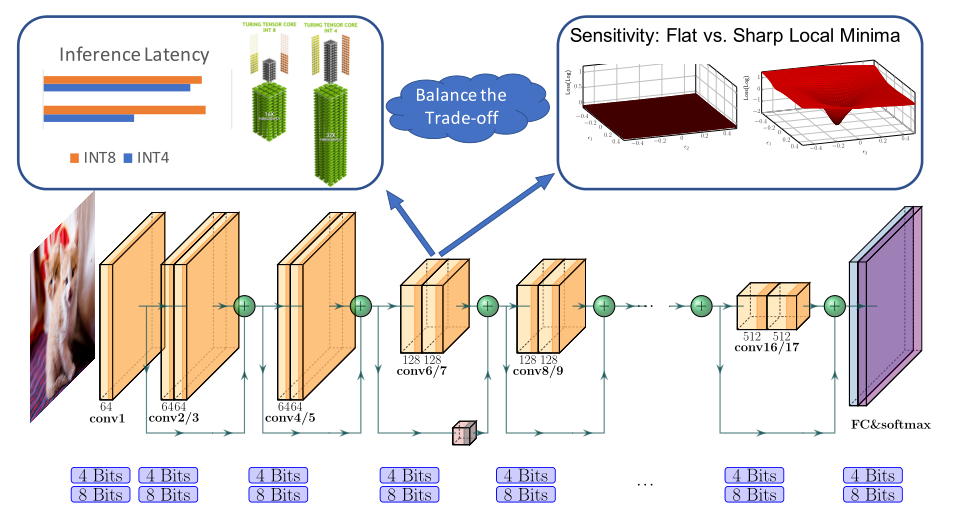
【读点论文】A Survey of Quantization Methods for Efficient Neural Network ...
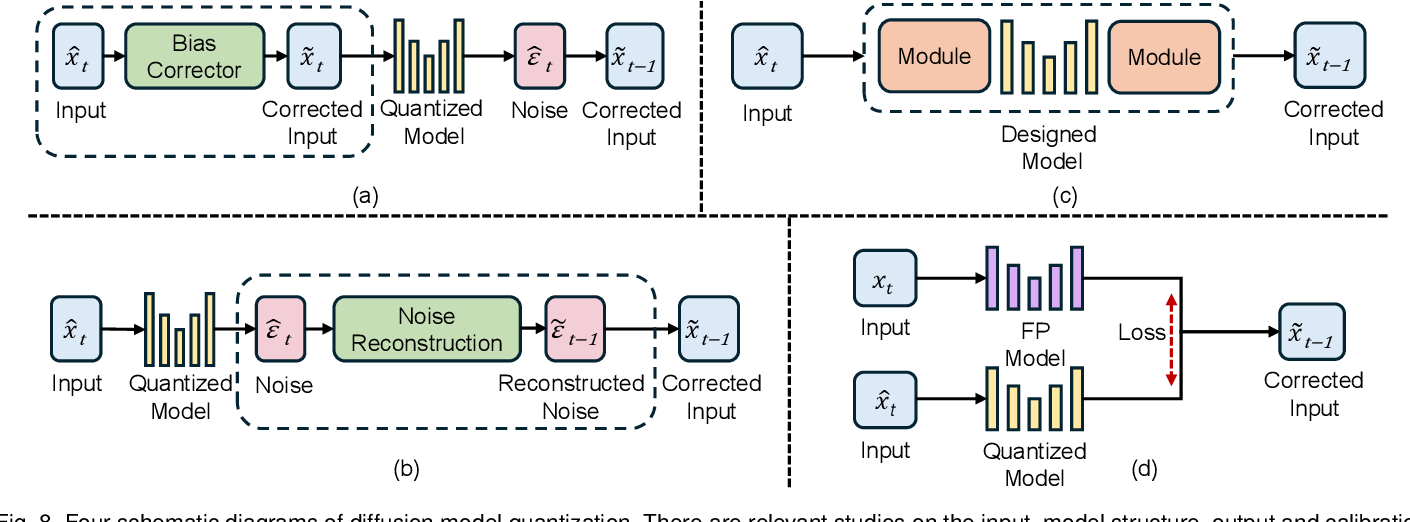
Figure 8 from Low-bit Model Quantization for Deep Neural Networks: A ...
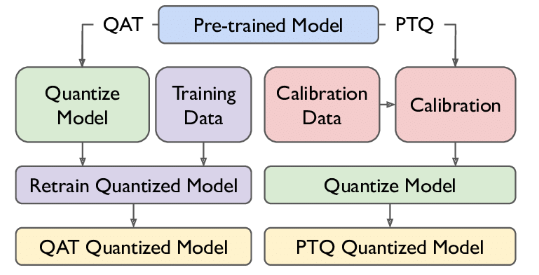
How to Deploy Large Language Models (LLMs): Techniques and Best ...
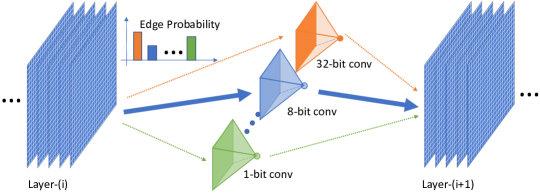
[1812.00090] Mixed Precision Quantization of ConvNets via ...
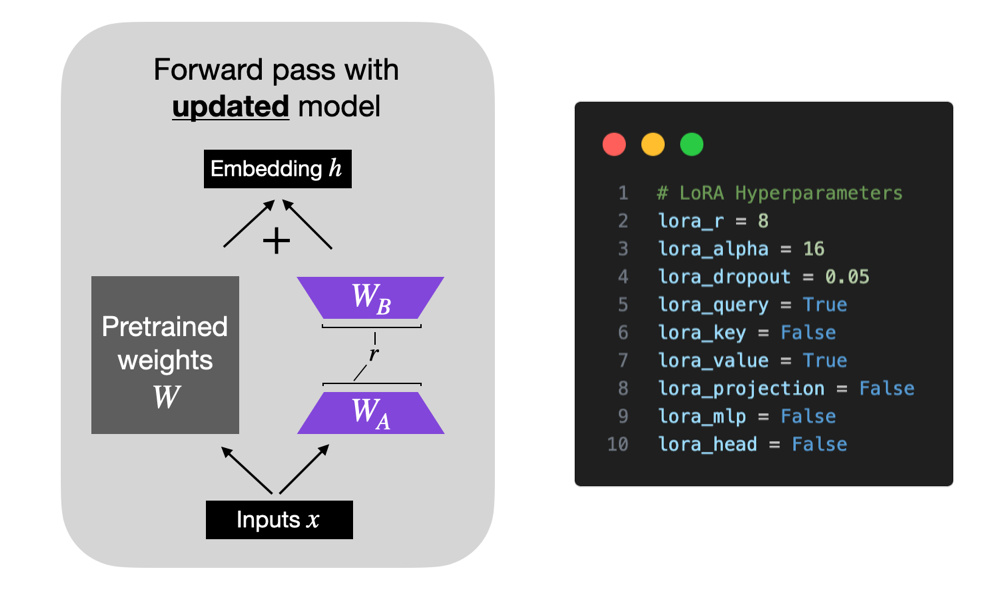
Accelerating Large Language Models with Mixed-Precision Techniques ...

Mixed-Precision Quantization for Language Models: Techniques and ...
Advertisement Space (336x280)

[2103.13630] A Survey of Quantization Methods for Efficient Neural ...
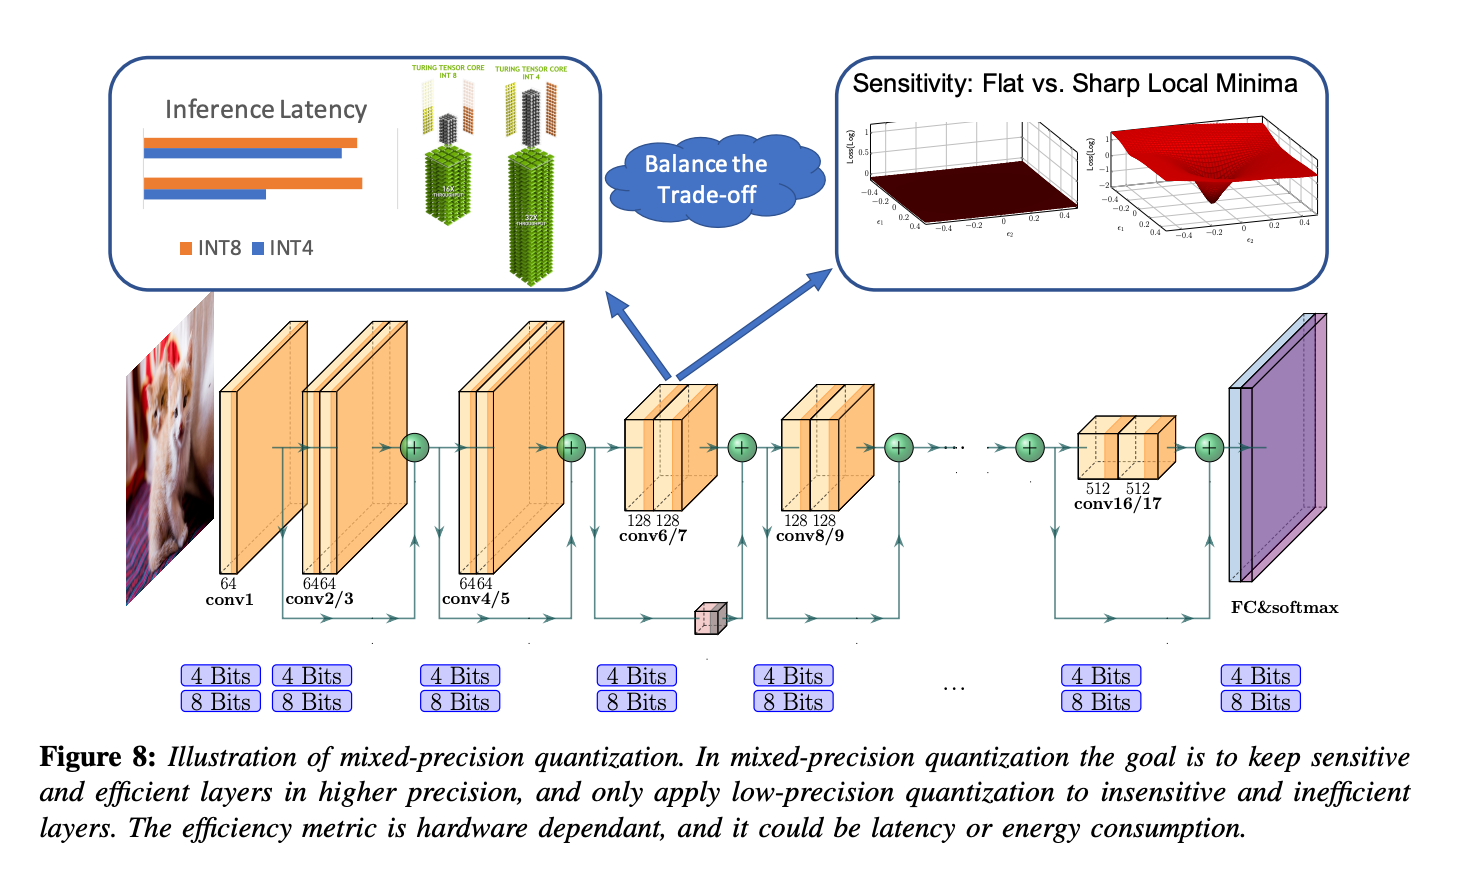
[21.03] A Survey of Quantization Methods for Efficient Neural Network ...

Low-bit Model Quantization for Deep Neural Networks: A Survey | AI ...

Figure 1 from Network Compression via Mixed Precision Quantization ...
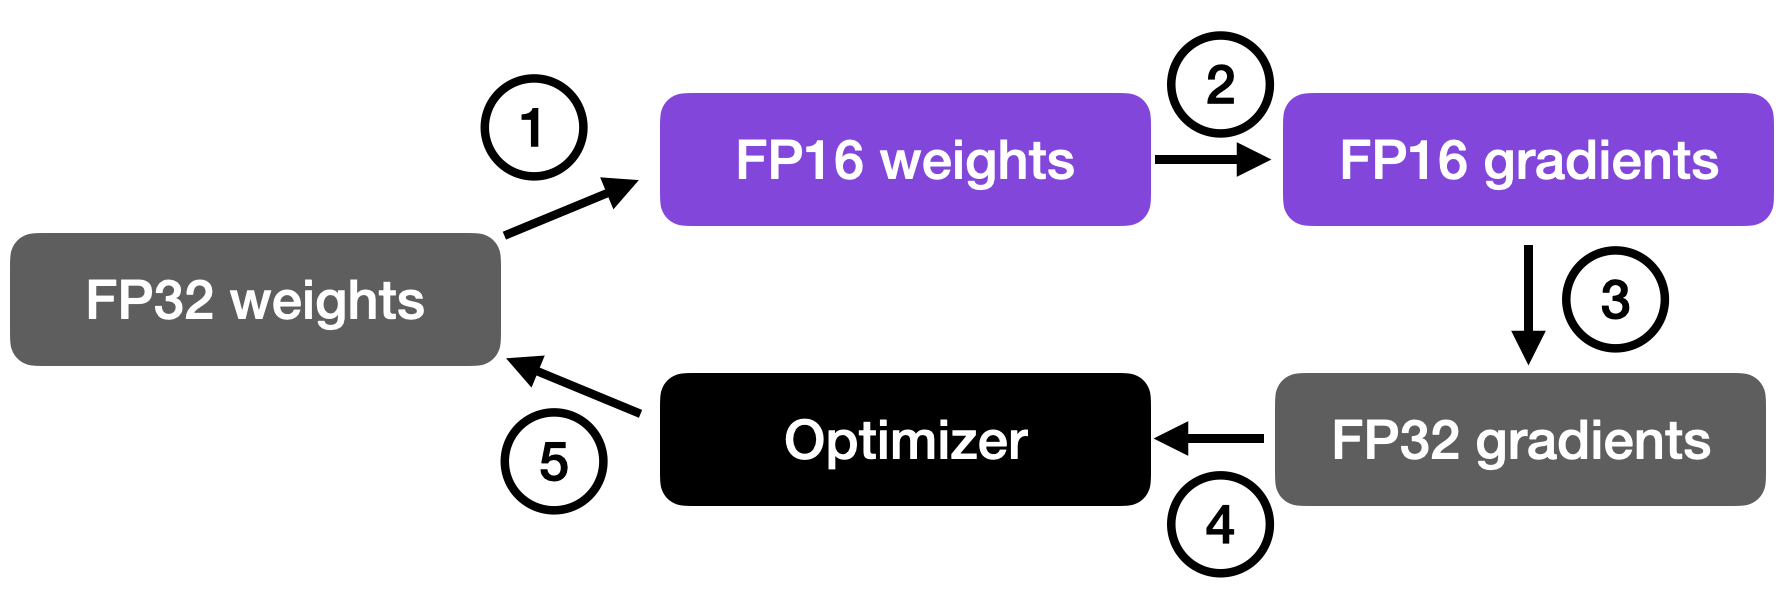
Accelerating Large Language Models with Mixed-Precision Techniques ...

LeanQuant: Accurate Large Language Model Quantization with Loss-Error ...