
Model Parallelism Vllm Project Vllm Discussion 243 Github
model parallelism · vllm-project vllm · Discussion #243 · GitHub
[GRPO] How to train model using vLLM and model parallelism on one node ...
GPU-parallel inference · vllm-project vllm · Discussion #12188 · GitHub
Expert Parallelism and Mixed Parallelism Strategies in vLLM | Jarvis ...
[Usage]: How to release GPU of vLLM model in python code · Issue #6544 ...
Can vllm serving clients by using multiple model instances? · vllm ...
[Usage]: How to pass the model path to the vllm serve command · Issue ...
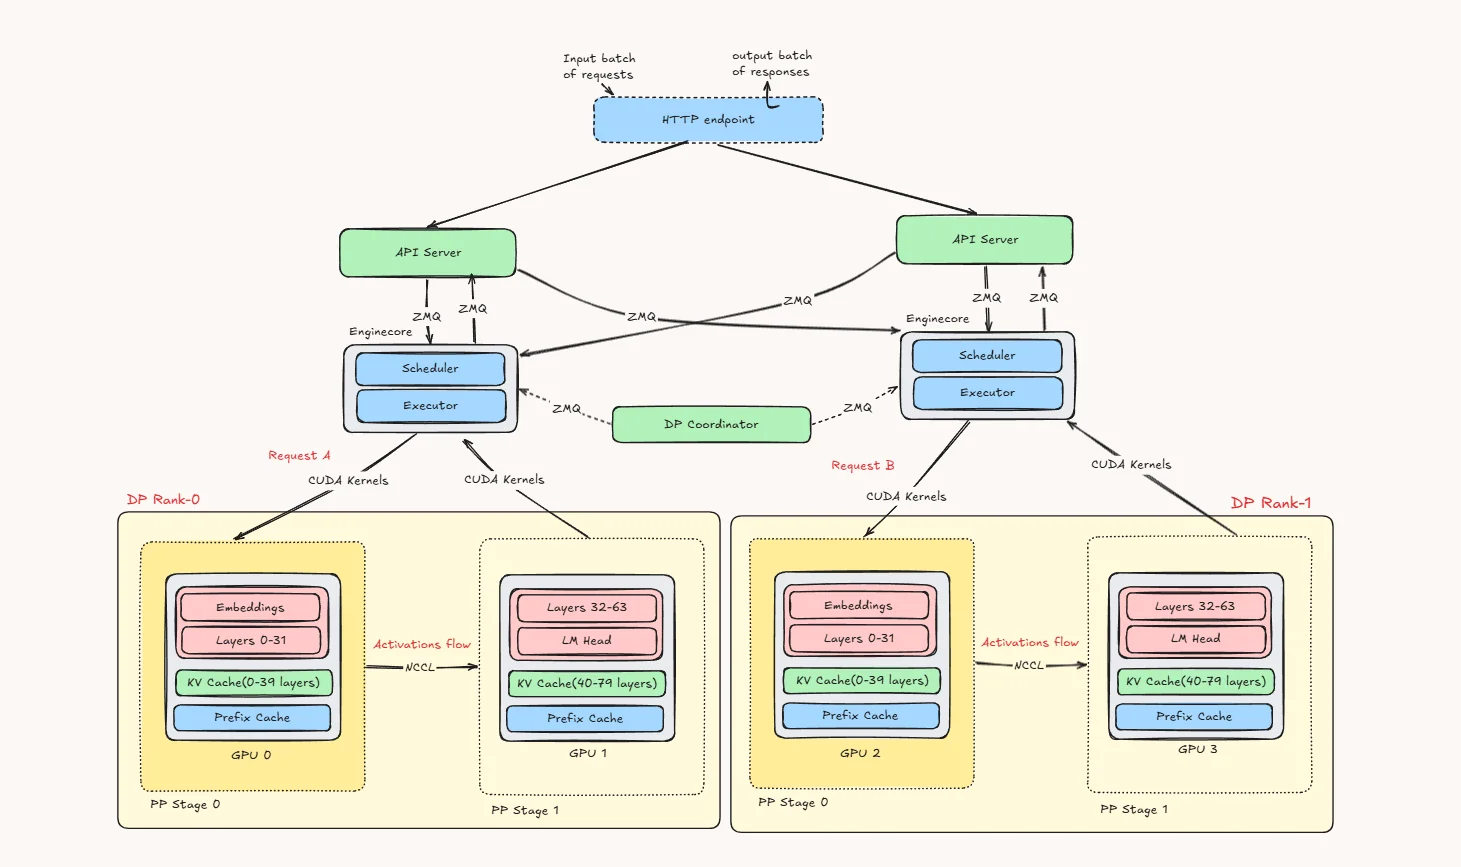
Expert Parallelism and Mixed Parallelism Strategies in vLLM | Jarvis ...
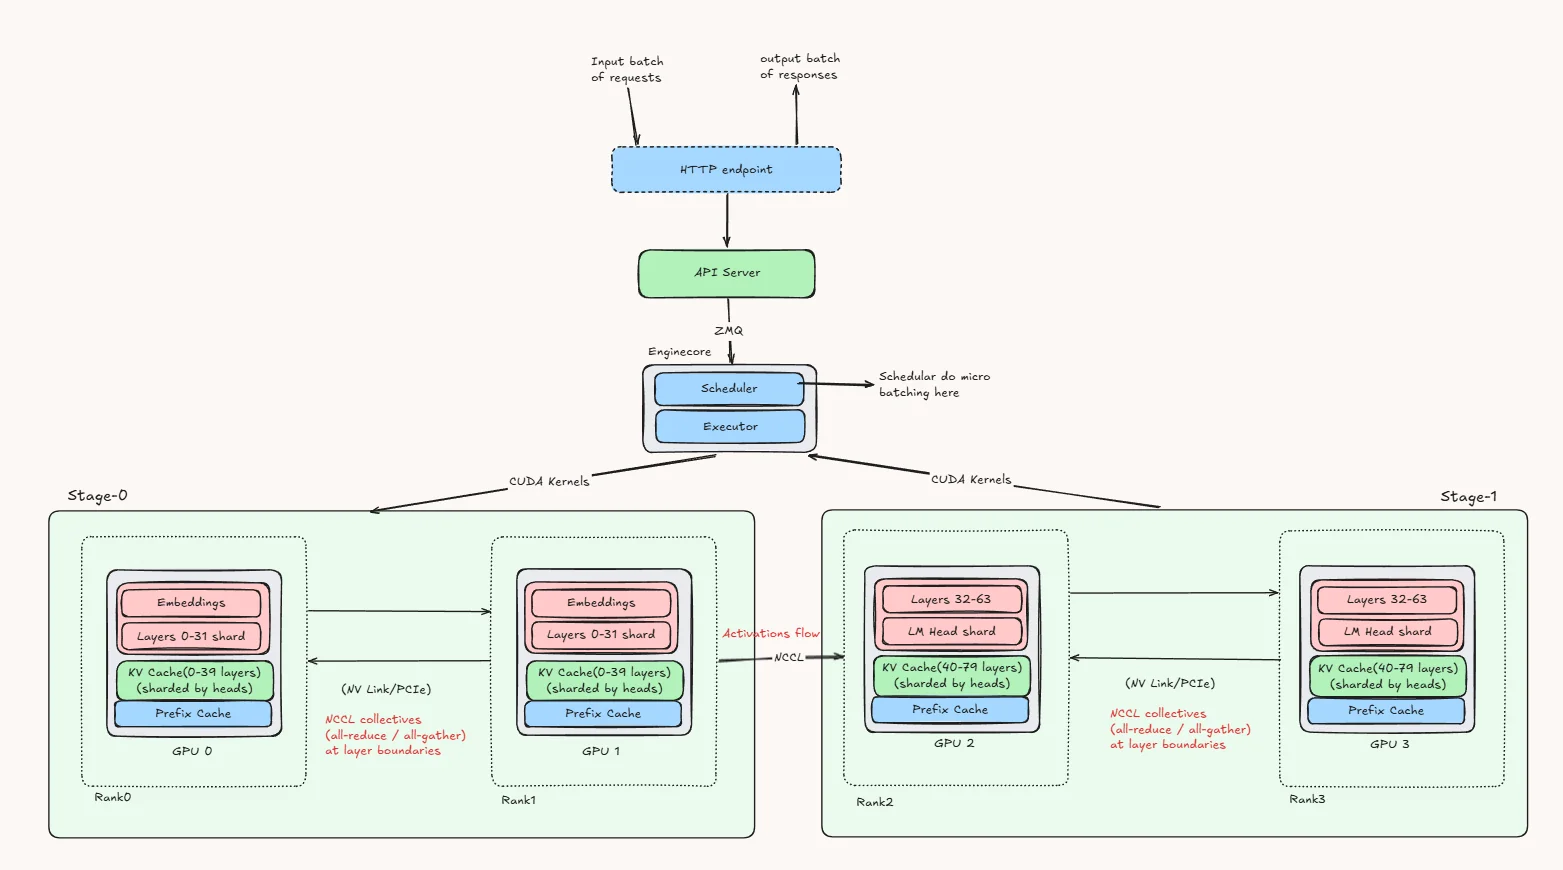
Expert Parallelism and Mixed Parallelism Strategies in vLLM | Jarvis ...
How to connect VLLM to Open WebUI? · vllm-project vllm · Discussion ...
Advertisement Space (300x250)
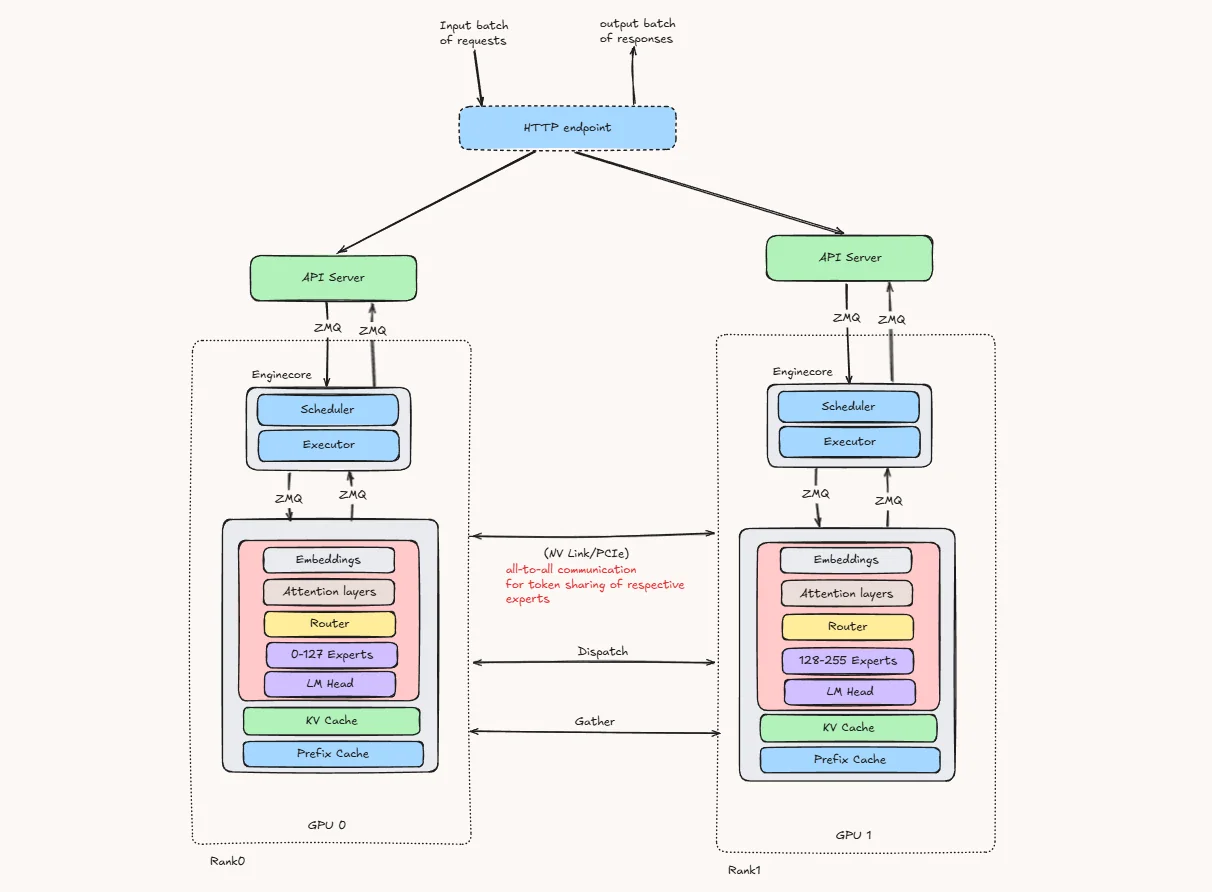
Expert Parallelism and Mixed Parallelism Strategies in vLLM | Jarvis ...
[RFC]: Expert parallelism in VLLM - do you do local dropping on sub ...
What happens after model_running.py loading model weights? · vllm ...
deploying embedding model in same way as LLM · Issue #6498 · vllm ...
How to a model forward and obtain logits? · vllm-project vllm ...
how can vllm support function_call · vllm-project vllm · Discussion ...
Dynamic Model Loading with Docker Deployment · vllm-project vllm ...
vLLM Development Roadmap · Issue #244 · vllm-project/vllm · GitHub
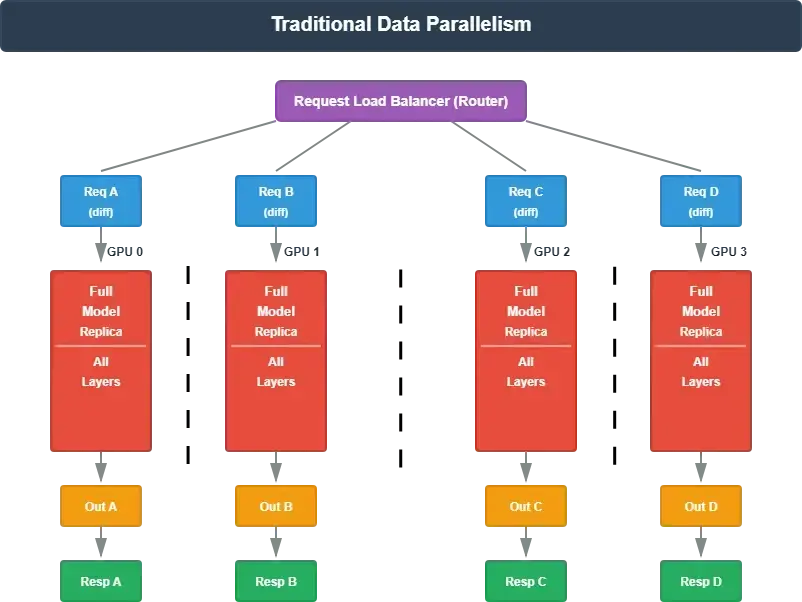
vLLM MoE 调优手册(上篇):TP、DP、PP 与 Expert Parallelism 实战指南 - 知乎
Pipeline parallelism + vLLM + Ray · Issue #2697 · verl-project/verl ...
Advertisement Space (336x280)
Best practice to check if a model architecture is supported by VLLM ...
Does vLLM support flash attention? · vllm-project vllm · Discussion ...
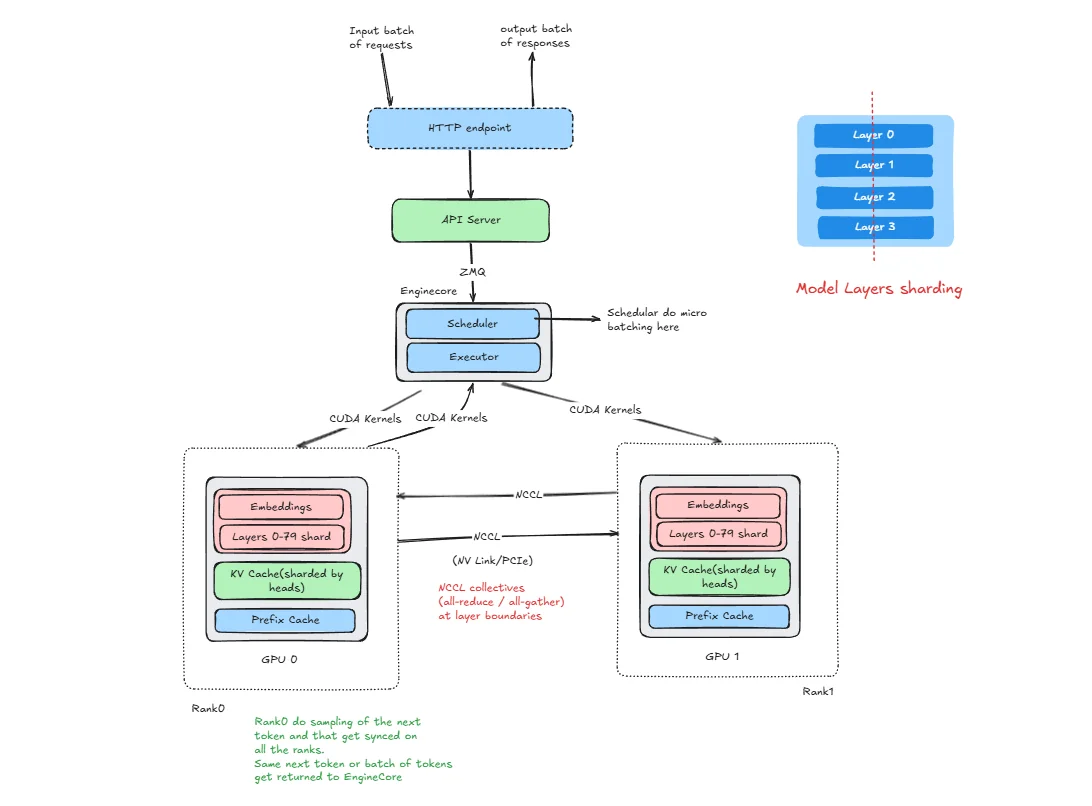
Scaling LLM Inference: Data, Pipeline & Tensor Parallelism in vLLM ...
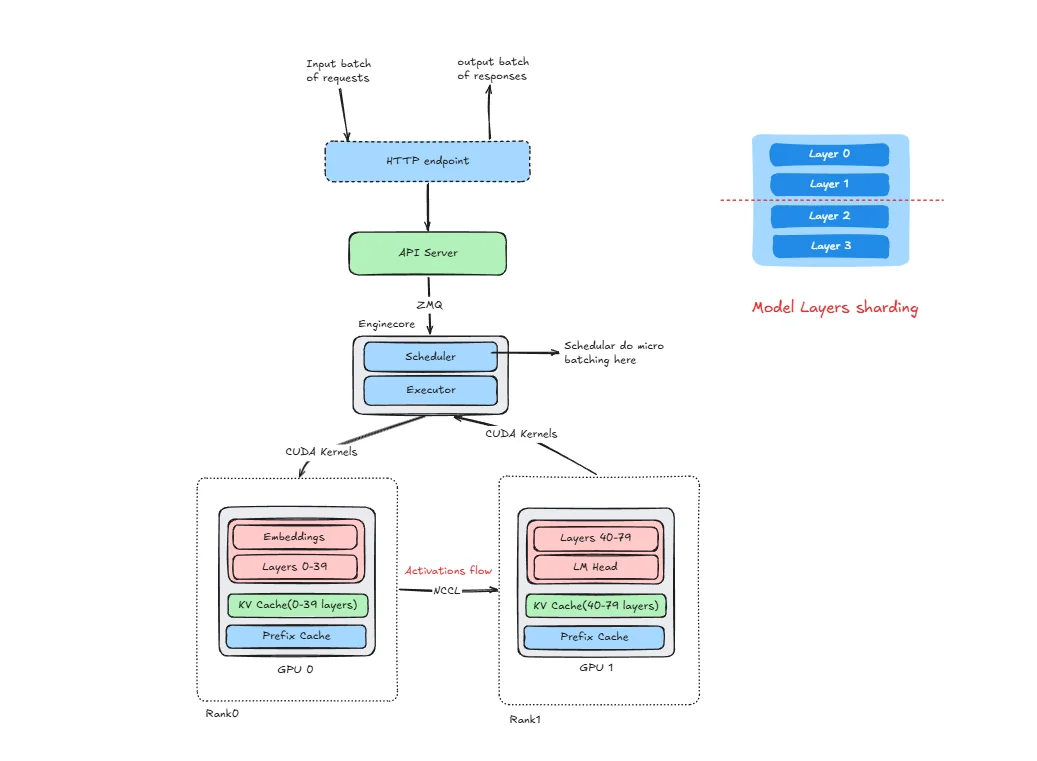
Scaling LLM Inference: Data, Pipeline & Tensor Parallelism in vLLM ...
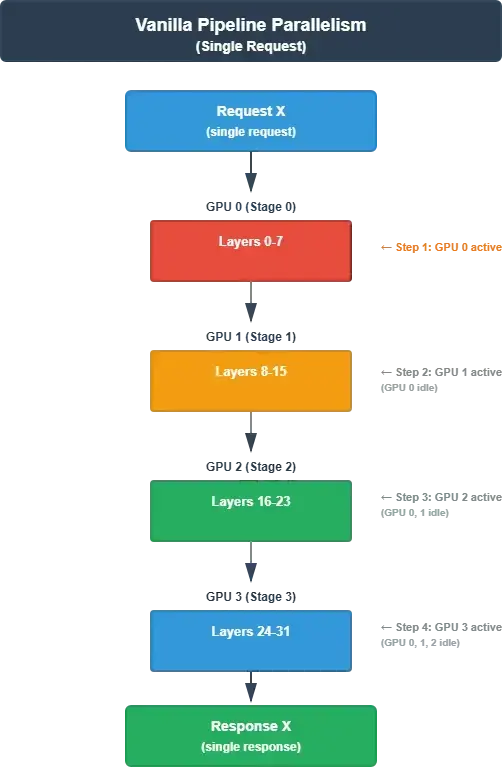
vLLM MoE 调优手册(上篇):TP、DP、PP 与 Expert Parallelism 实战指南 - 知乎

Reproduce the given benchmark results · vllm-project vllm · Discussion ...
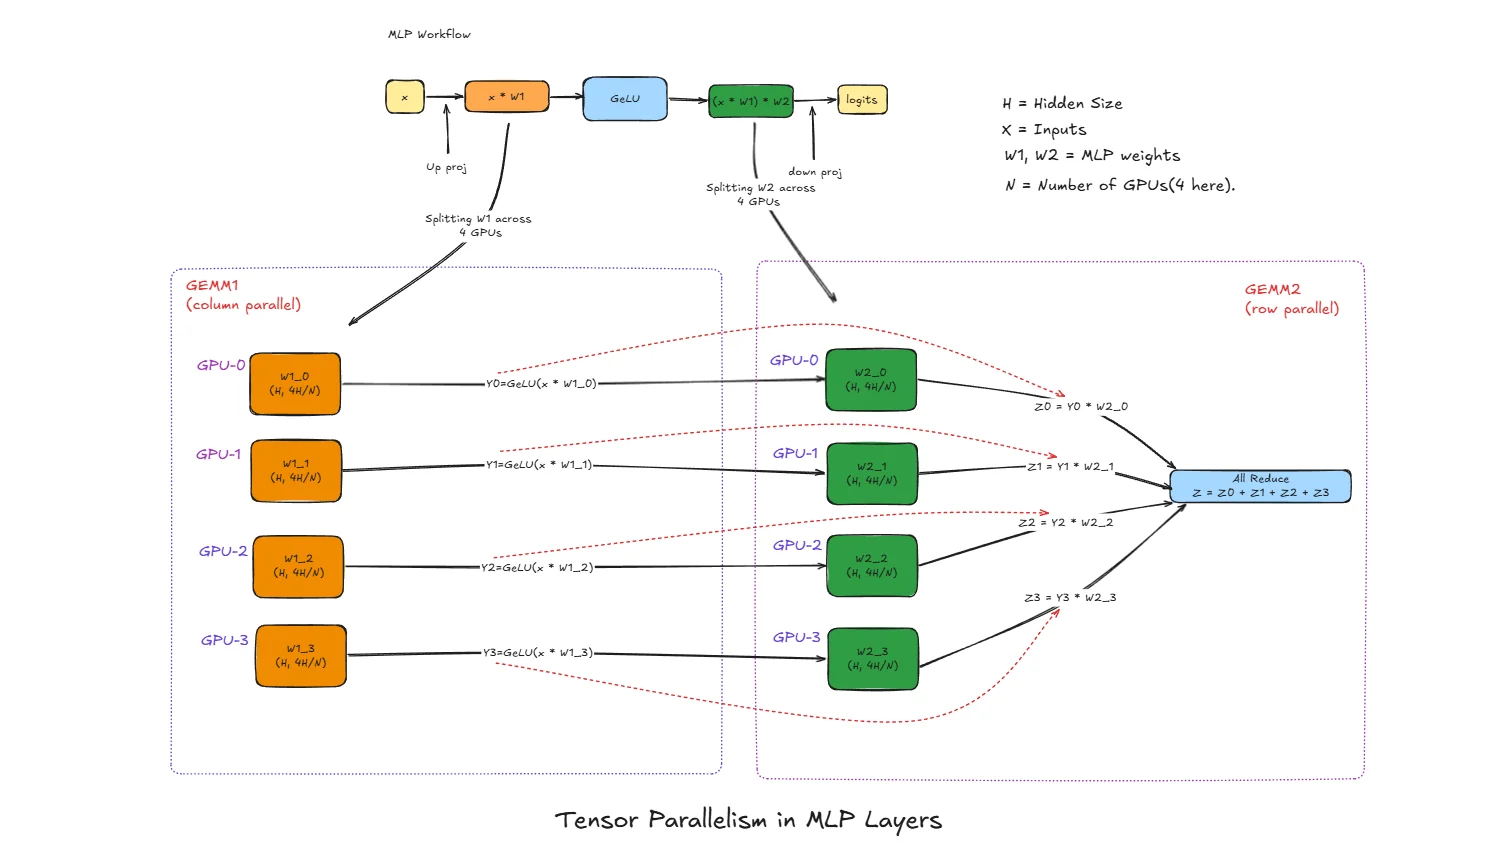
Scaling LLM Inference: Data, Pipeline & Tensor Parallelism in vLLM ...
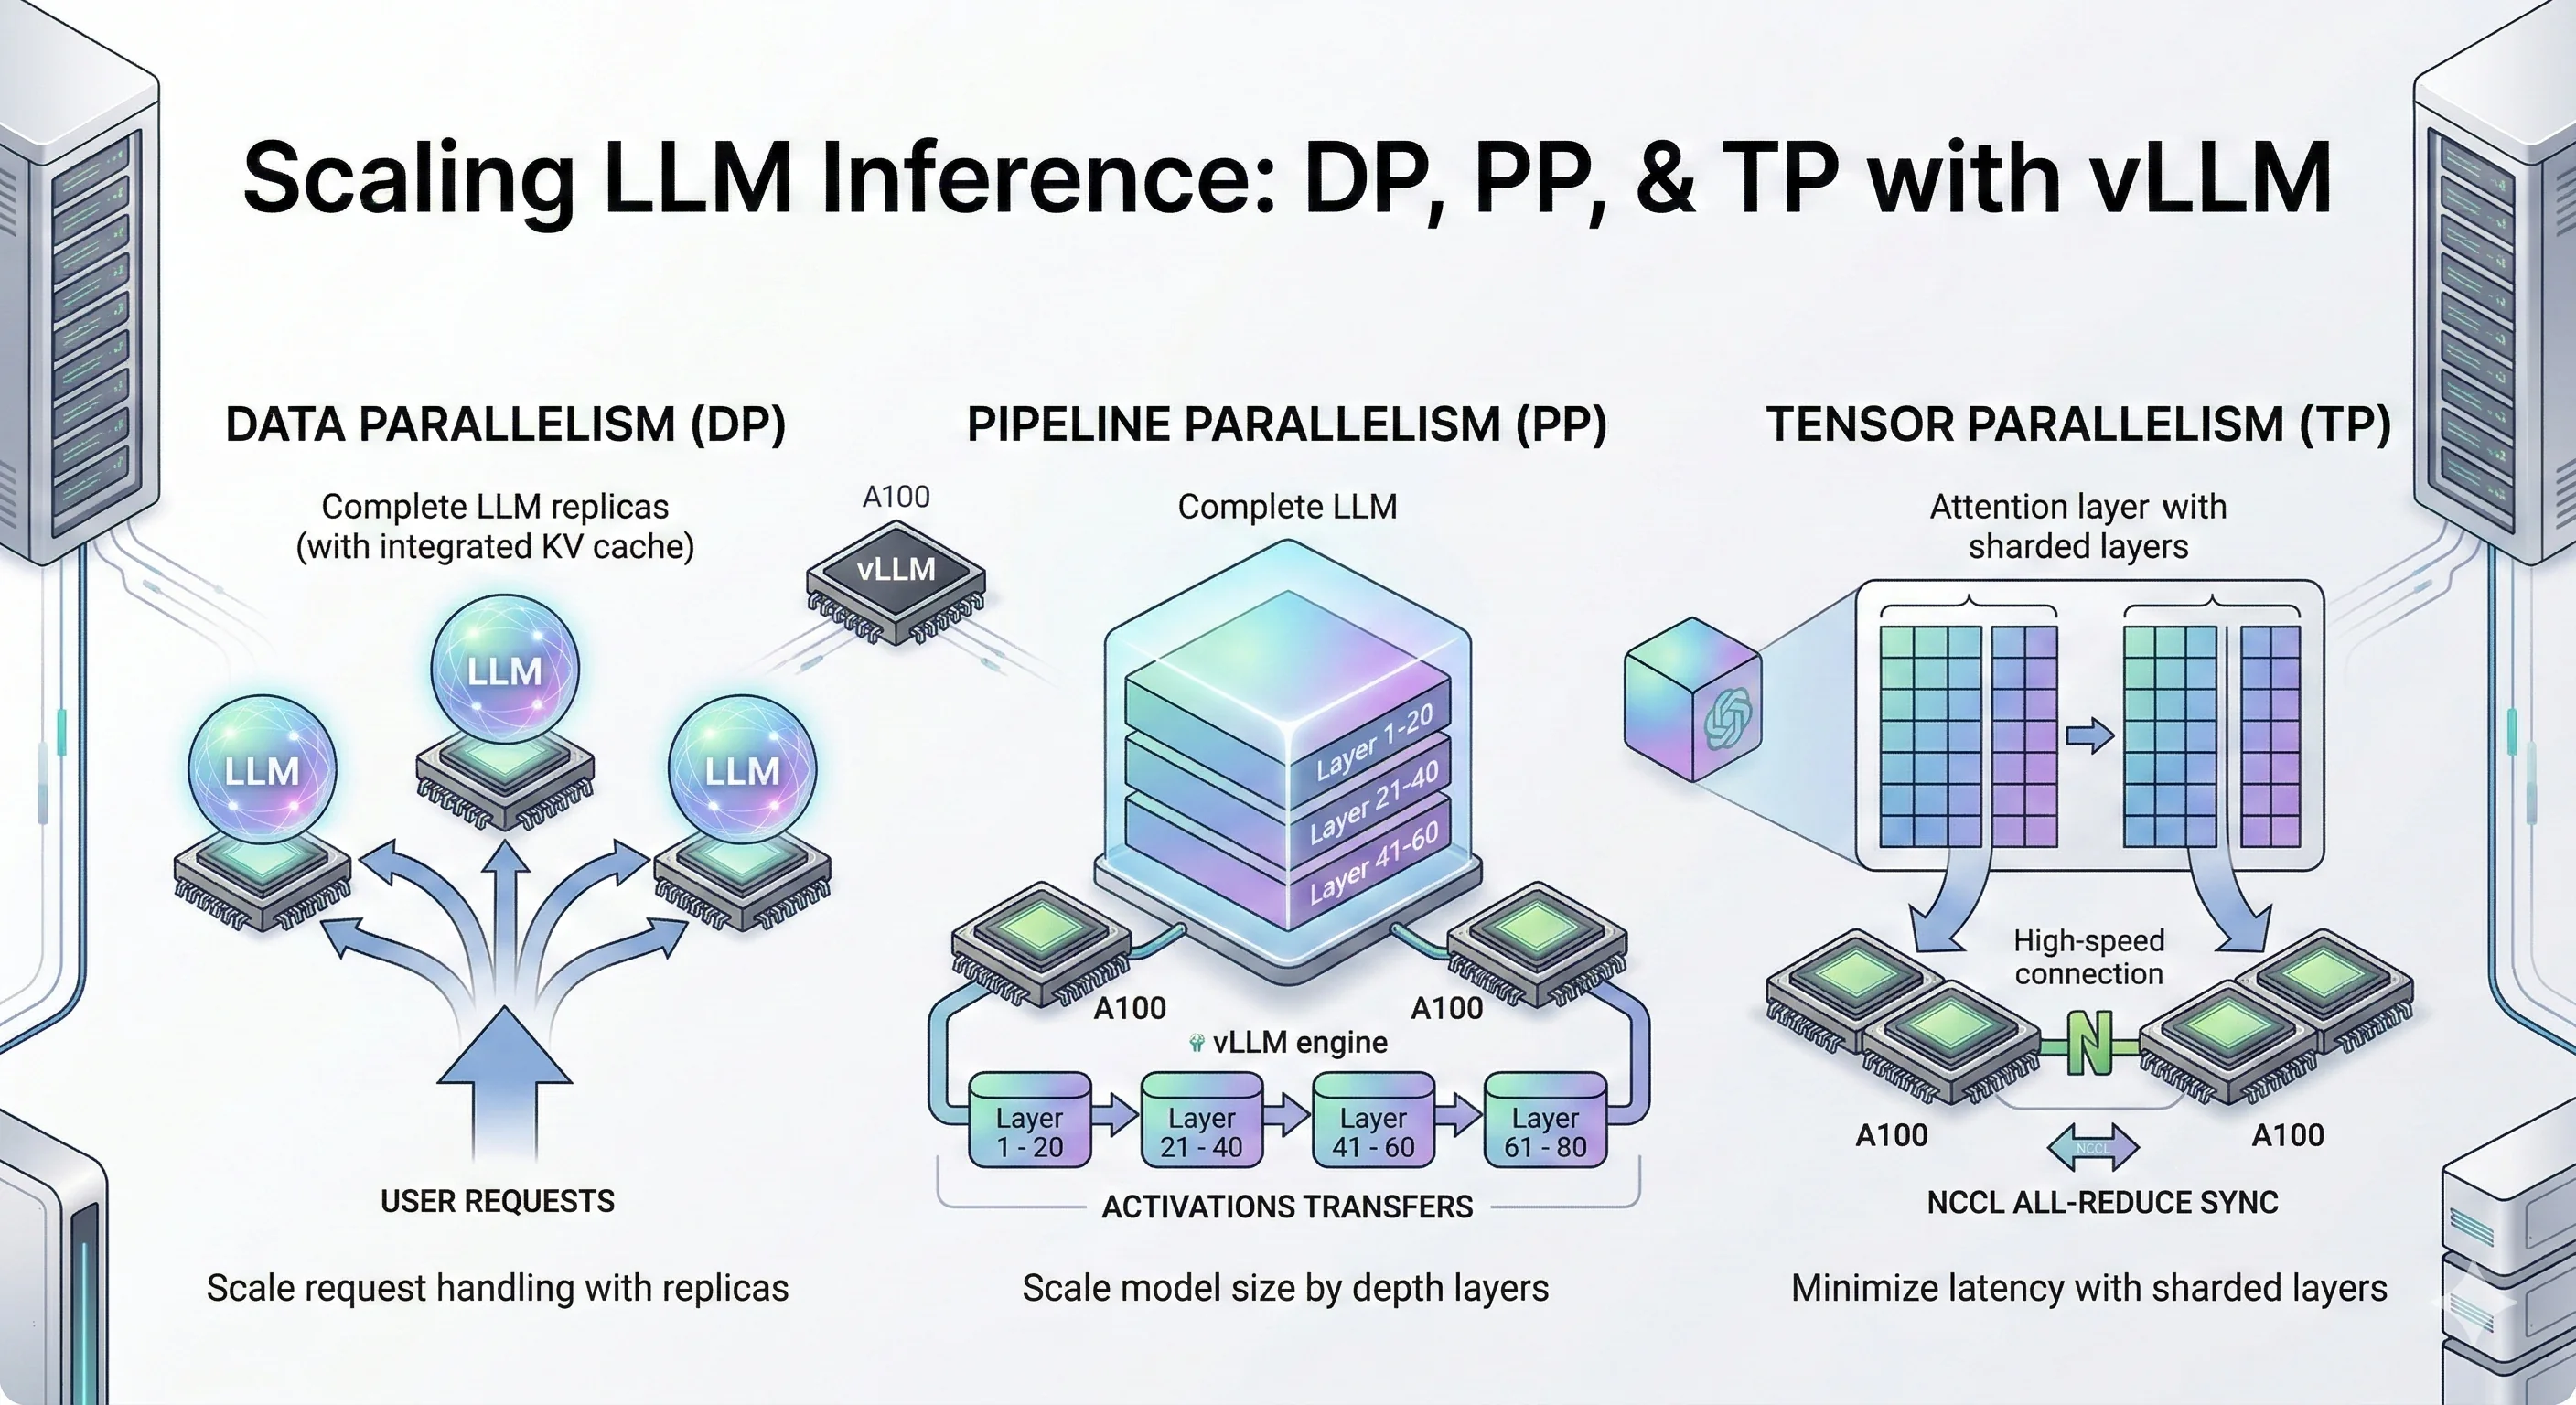
vLLM Optimization Techniques: 5 Practical Methods to Improve ...

vLLM Integration
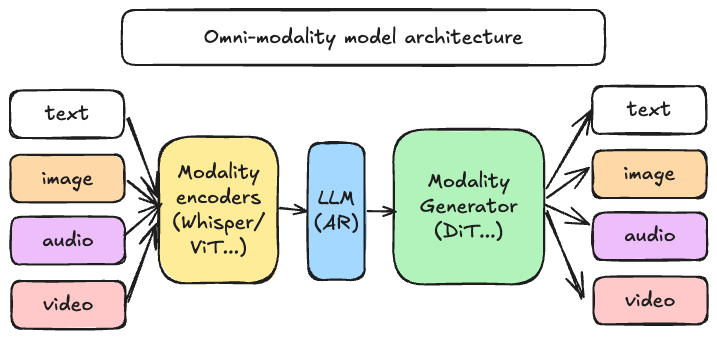
GitHub - vllm-project/vllm-omni: A framework for efficient model ...
Advertisement Space (336x280)

Distributed Inference with vLLM | vLLM Blog
GitHub - nbeeeel/LLM-Model-Level-Parallelism-For-HPC: 4-node model ...
[RFC]: Pipeline-Parallelism for vLLM V1 · Issue #11945 · vllm-project ...
[Feature]: Pipeline parallelism support for qwen model · Issue #6471 ...
Pipeline parallelism support · Issue #752 · vllm-project/vllm · GitHub
[Feature]: is vllm support sequence-parallel? · Issue #3940 · vllm ...