
Model Quantization And Optimization For Mcus Siliconwit
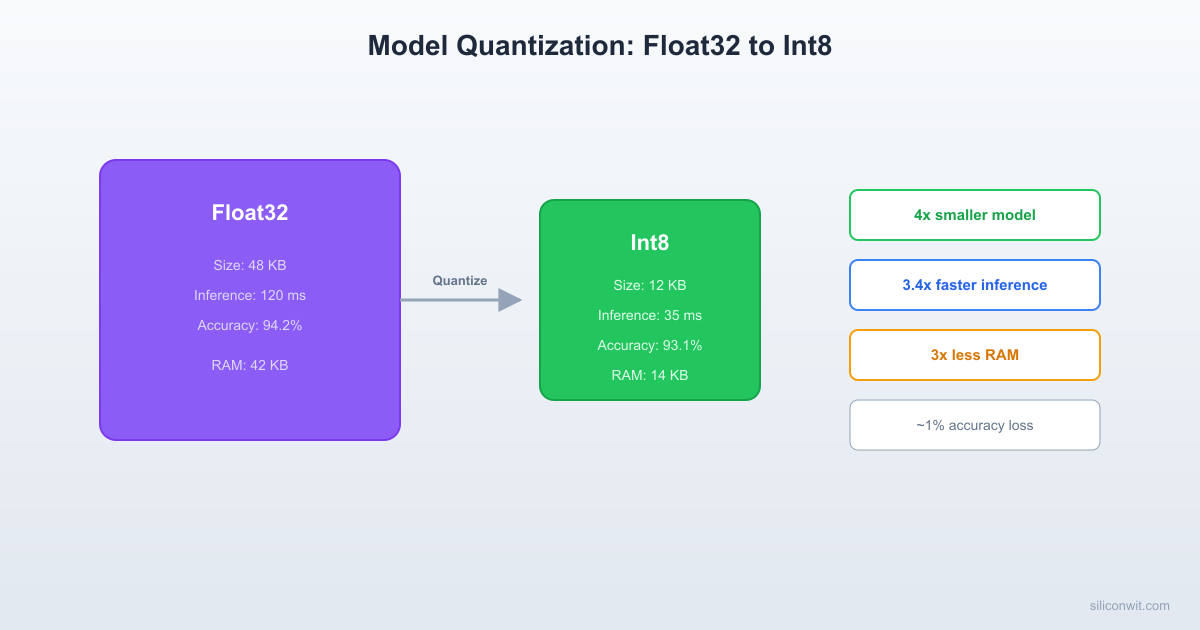
Model Quantization and Optimization for MCUs | SiliconWit
Model Quantization and Deployment | renesas/ruhmi-framework-mcu | DeepWiki
Graph Quantization Folding: AI Model Optimization Explained | Inference ...

Automated deep‐learning model optimization framework for ...

LLM inference optimization: Model Quantization and Distillation - YouTube
Quantization State: Definition & AI Model Optimization | Inference Systems
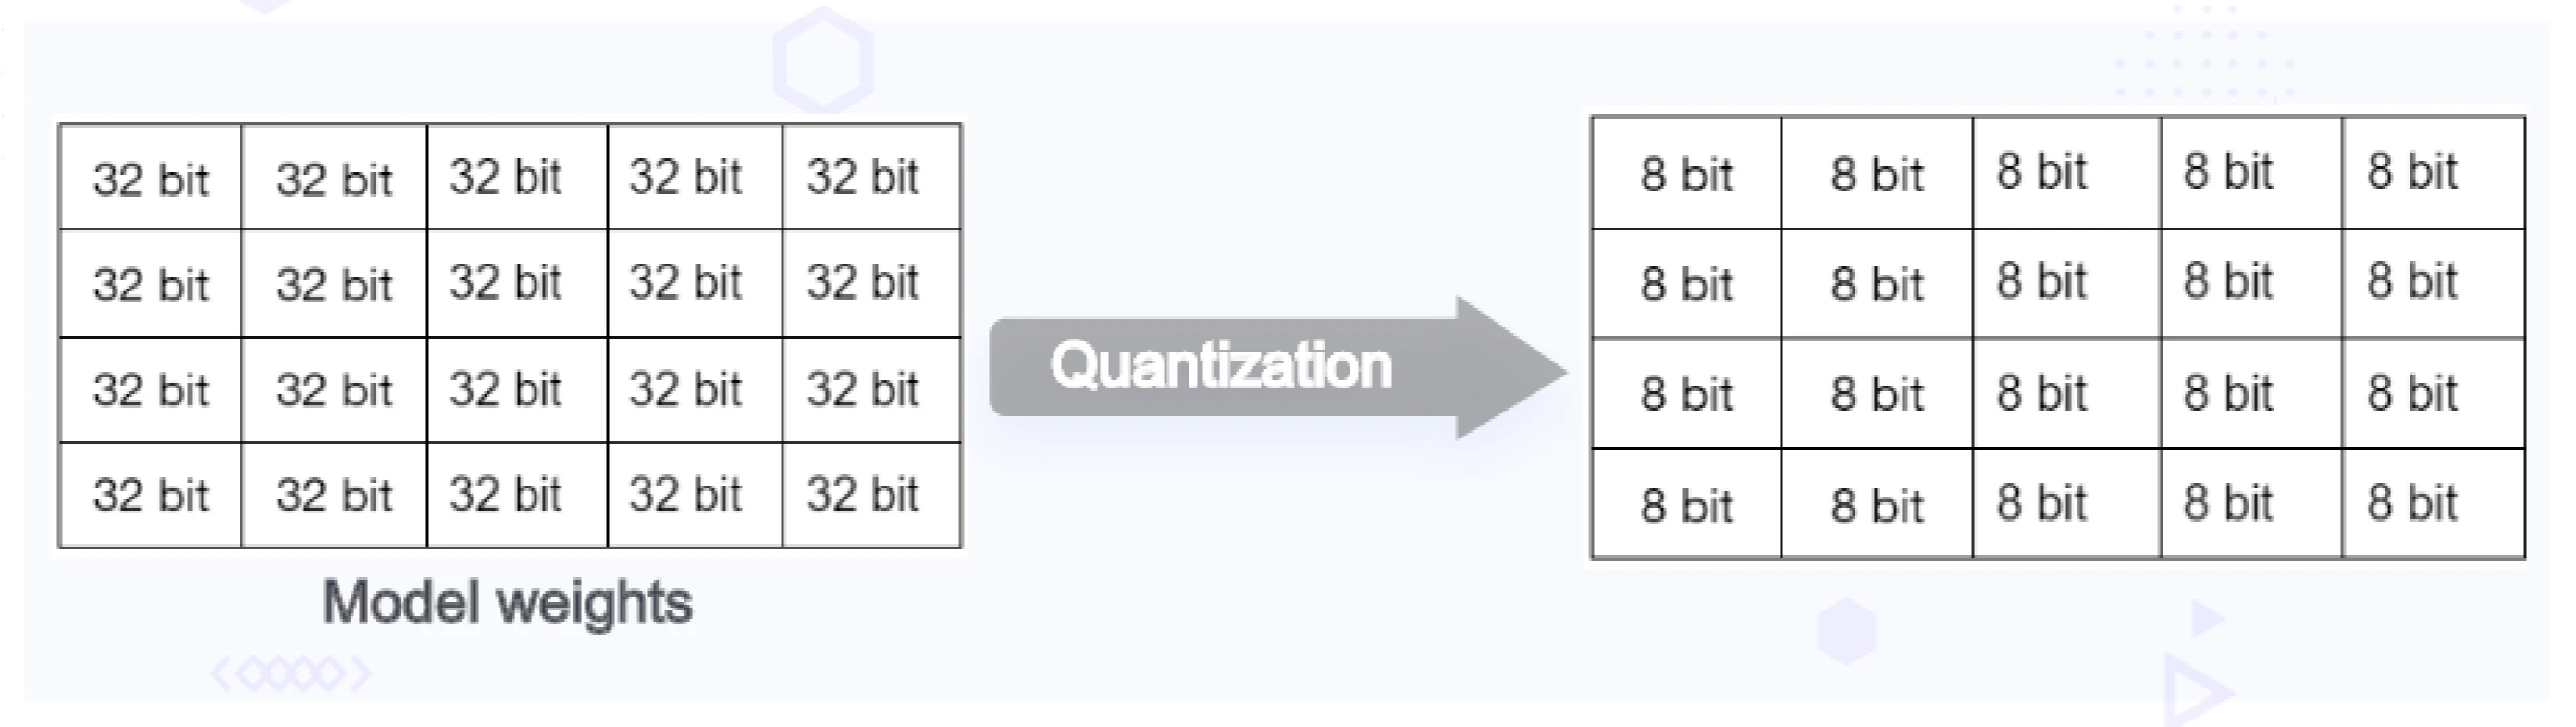
Exploring AI Model Inference: Servers, Frameworks, and Optimization ...

The Process of Model Training 4.4. Model optimization and deployment ...
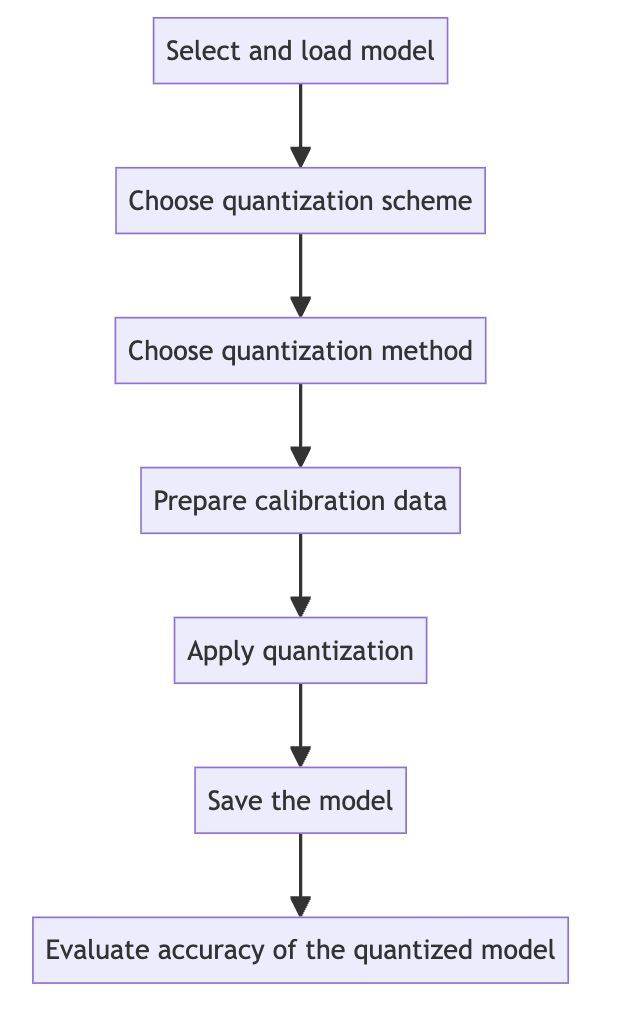
Model optimization :: LLM optimization and inference leveraging
How to Implement Quantization for Efficient Model Deployment ...
Advertisement Space (300x250)
Part 3 — Model Optimization Techniques: A Deep Dive into Quantization ...
Optimize Model Quantization for Large Language Models on Edge Devices ...
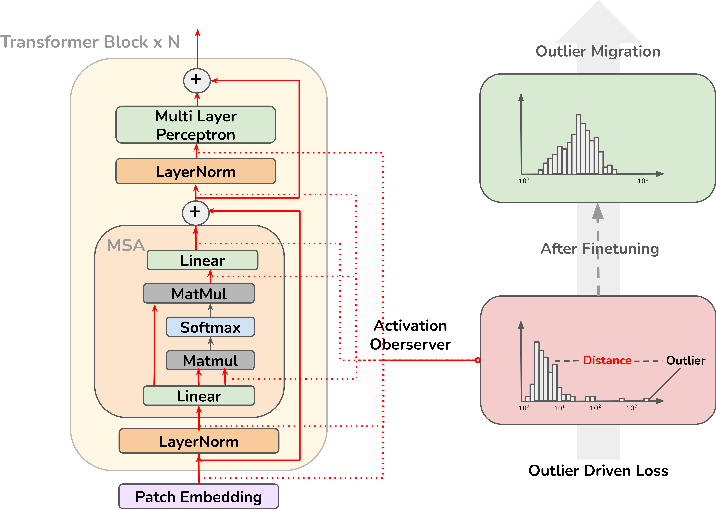
QuantTune: Optimizing Model Quantization with Adaptive Outlier-Driven ...
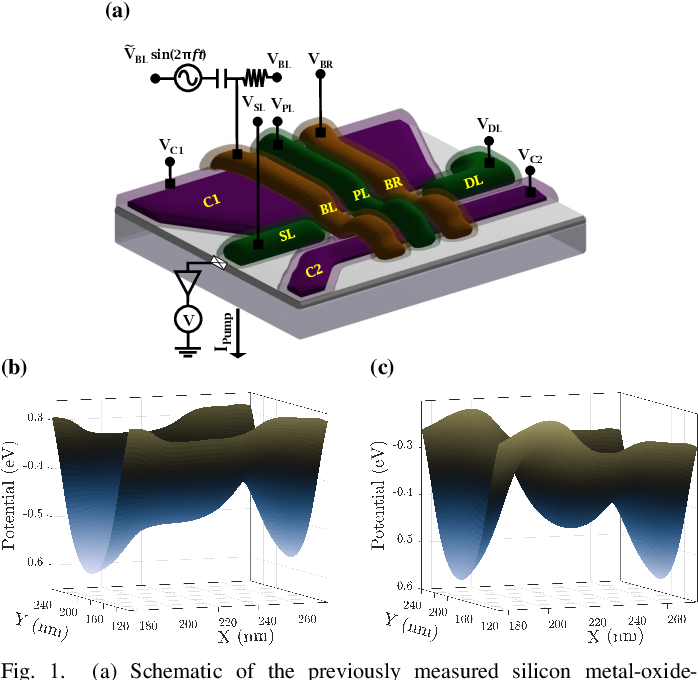
Figure 1 from Optimization of Silicon MOS Architecture for Self ...

On-board charger design’s call for purpose-built MCUs - EDN
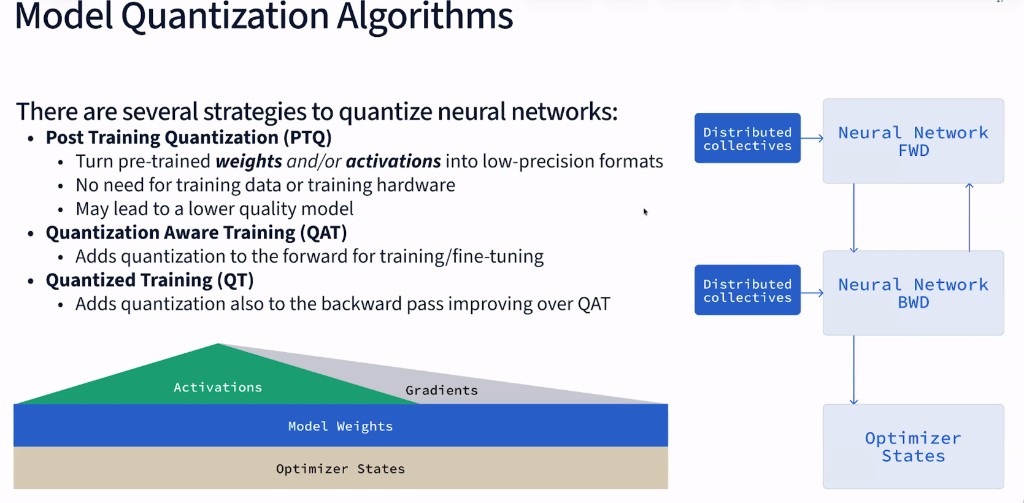
Model Optimization Techniques
Model Quantization - A Lazy Data Science Guide
Quantization: AI Model Compression for Microcontrollers | Inference Systems

Model Quantization
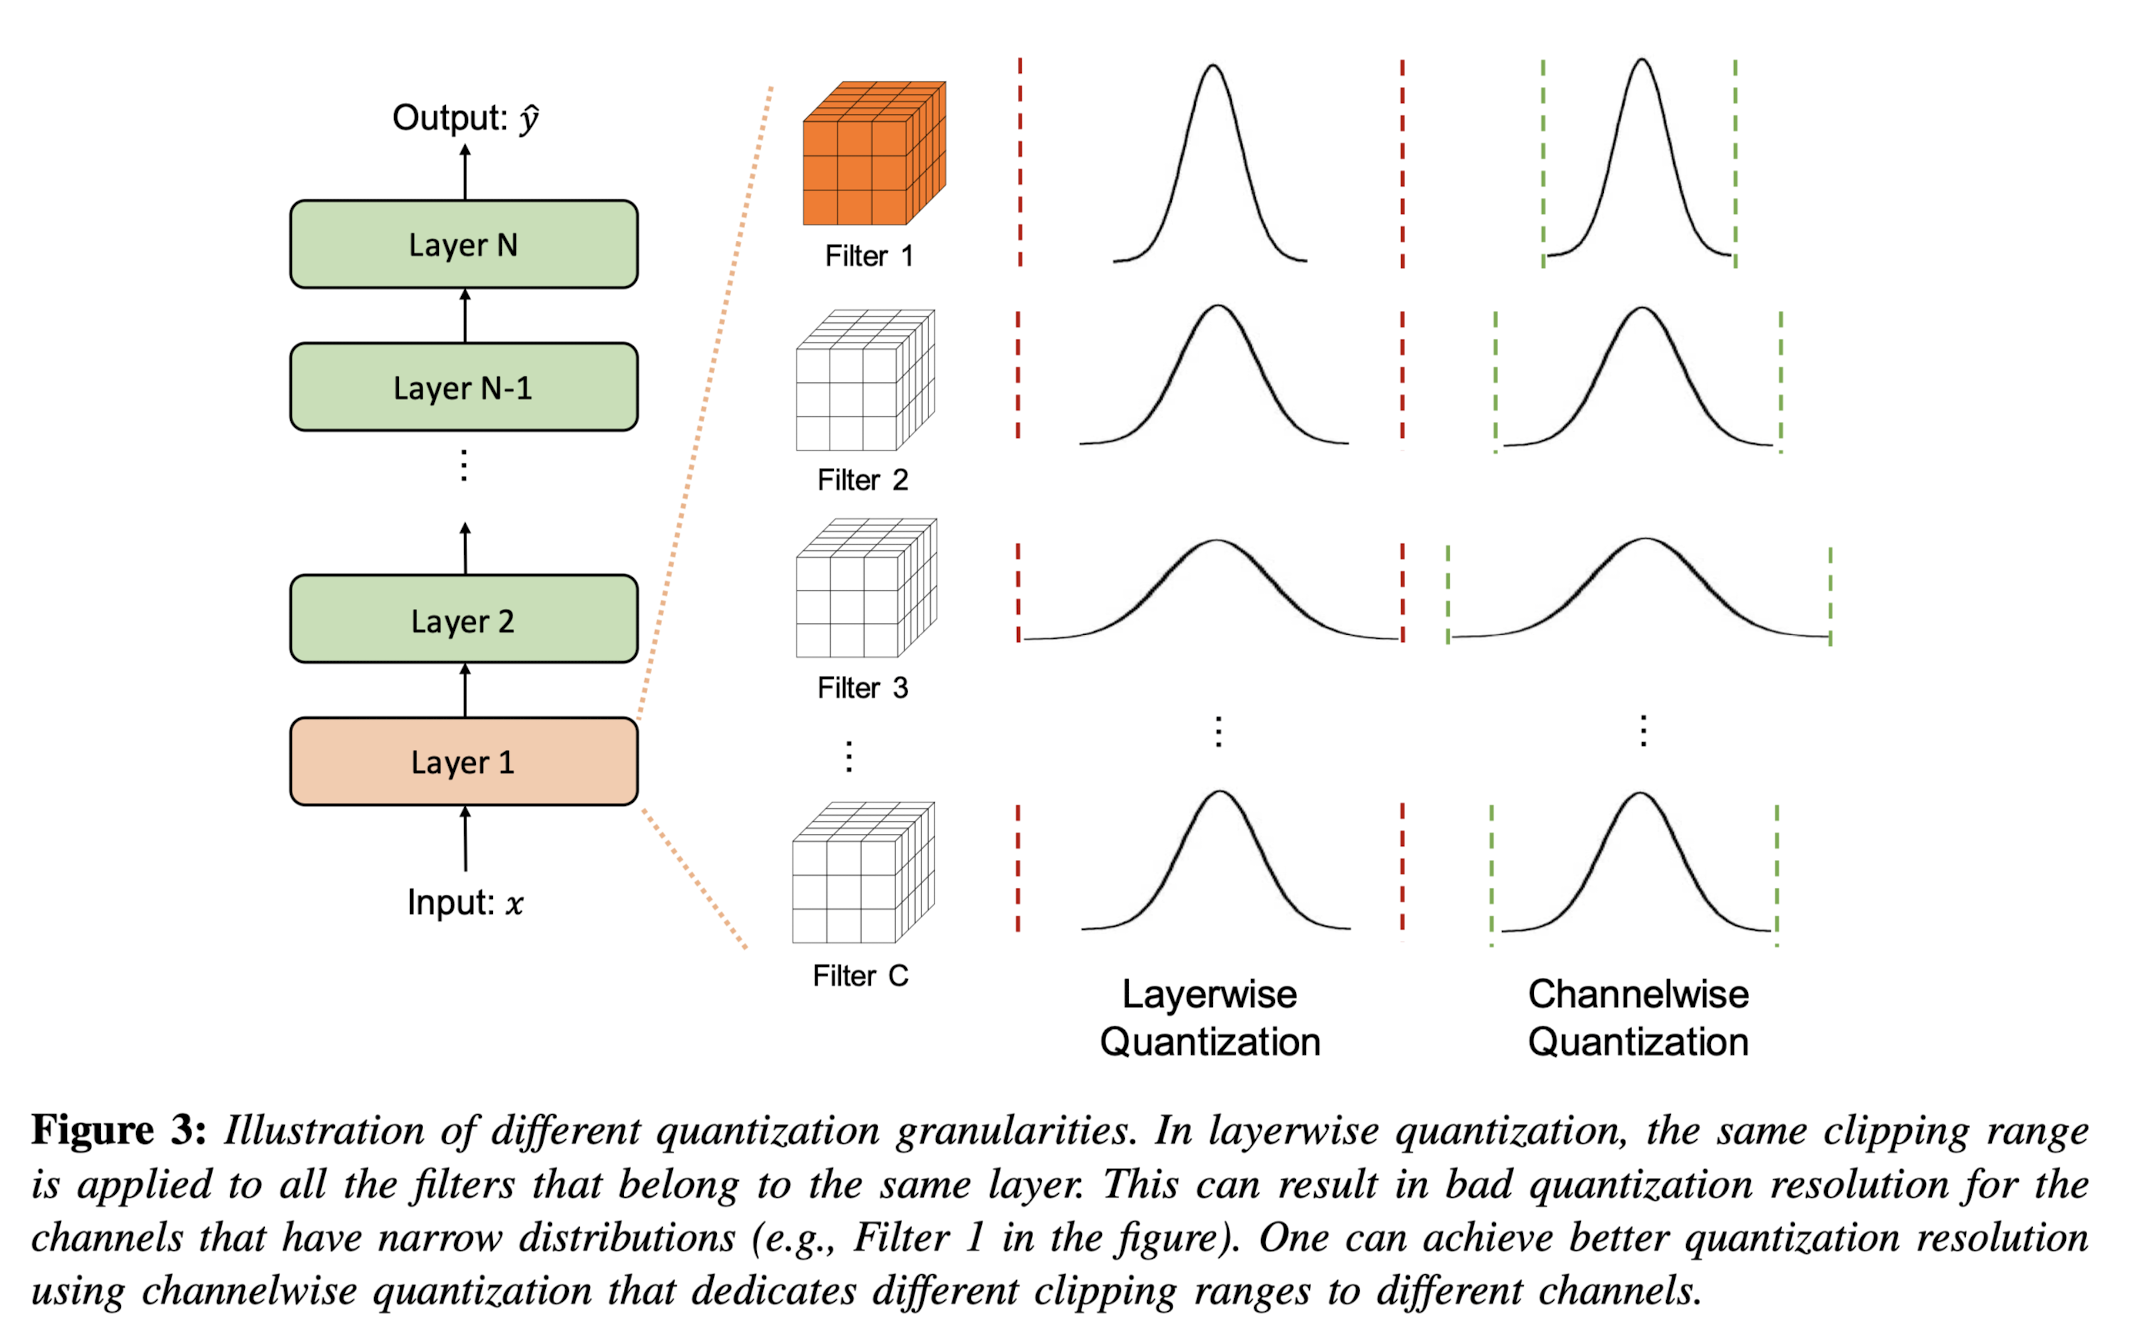
AI Model Optimization: Maximizing Performance and Efficiency | IT-Magic
Advertisement Space (336x280)

Model Quantization — FuriosaAI Warboy & SDK Documents 0.10.2 documentation
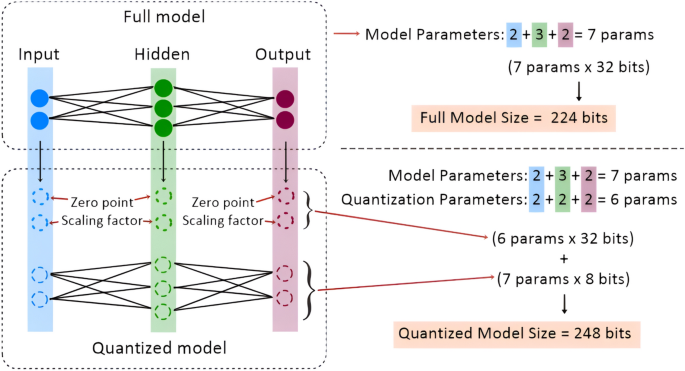
Optimising TinyML with quantization and distillation of transformer and ...
Model Quantization: Definition & AI Inference Optimization | Inference ...

DiffQuant: Reducing Compression Difference for Neural Network Quantization

Neural Network Quantization for High-Performance AI Systems: Advanced ...
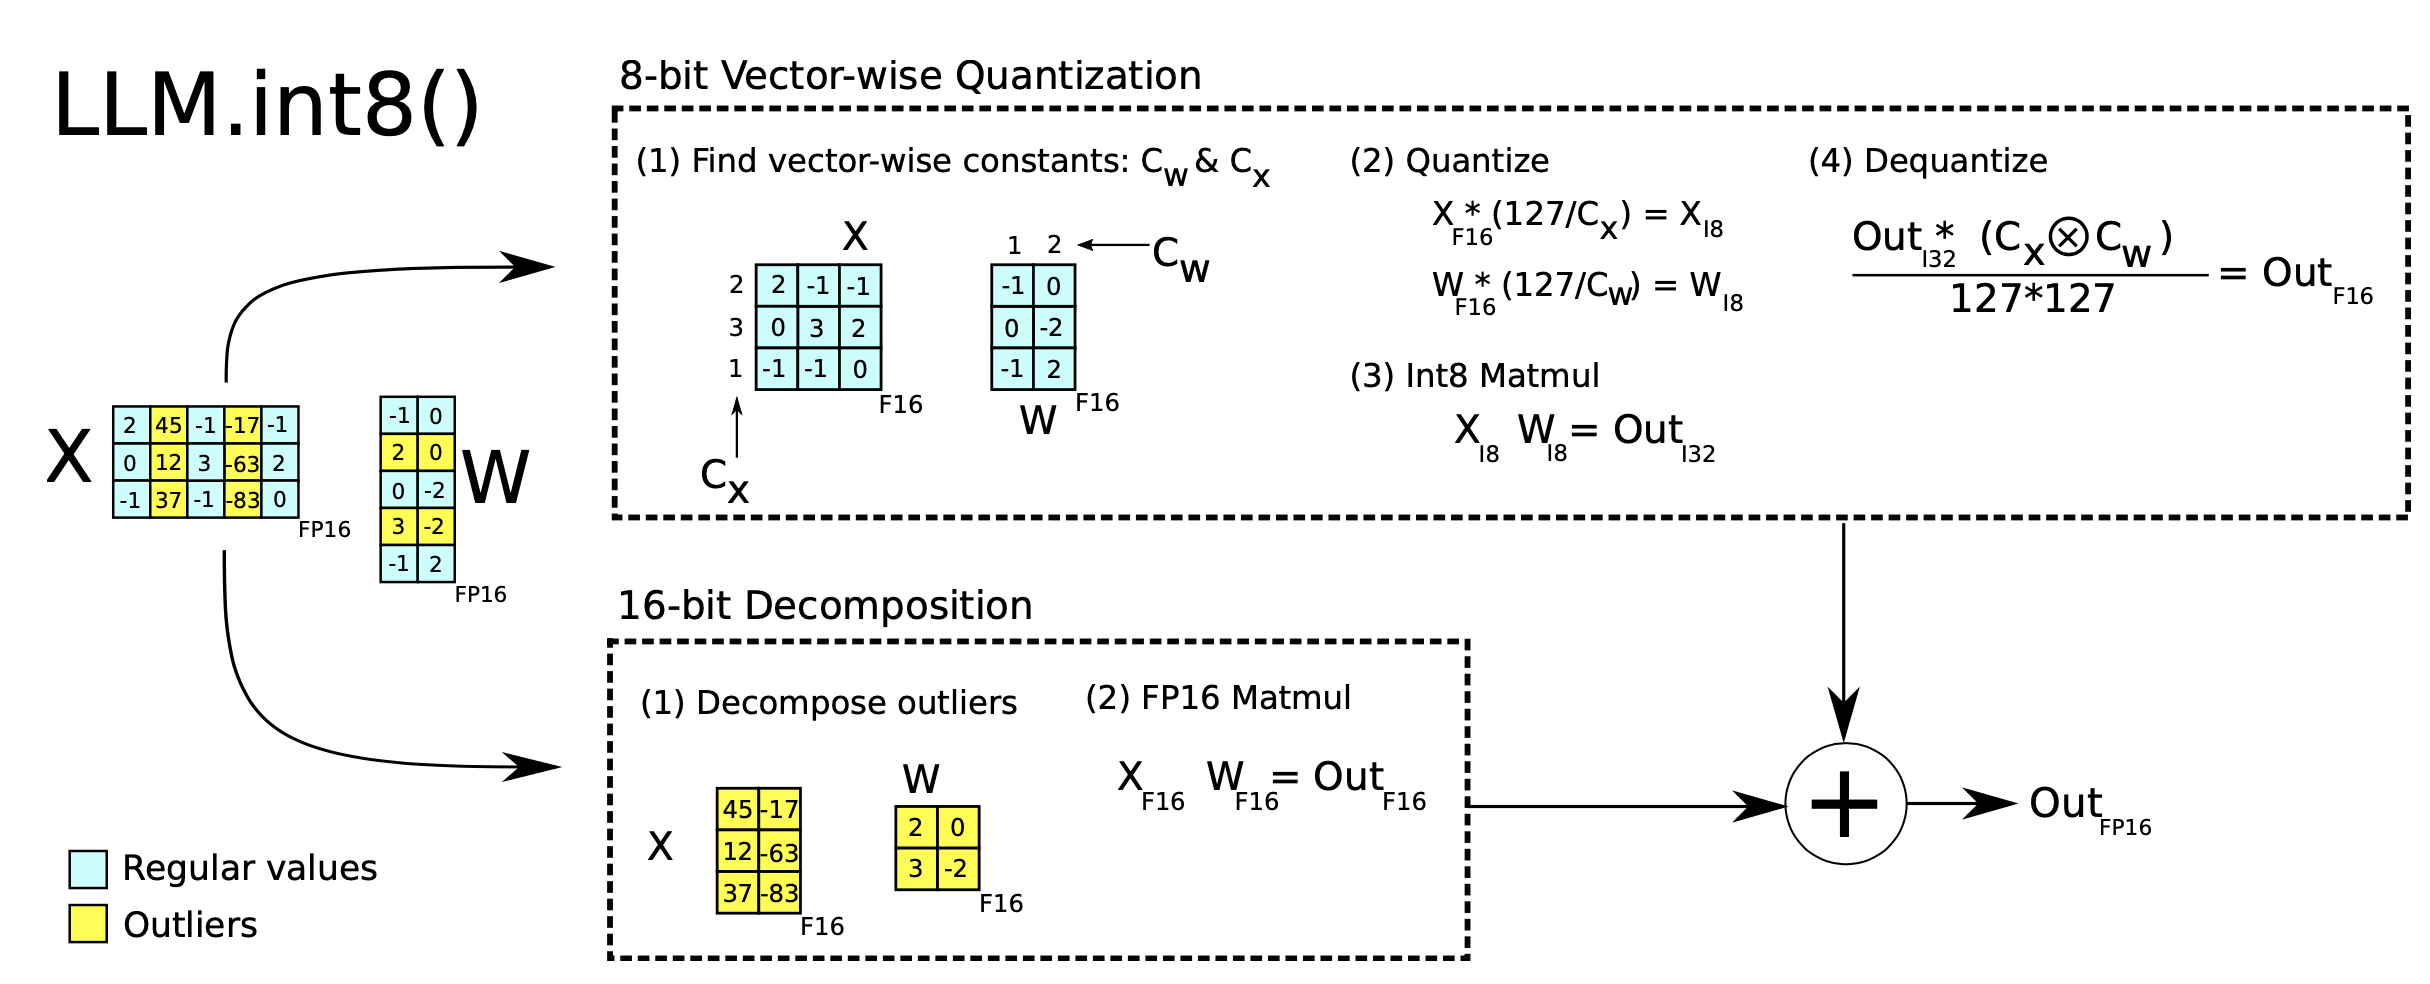
Large Transformer Model Inference Optimization | Lil'Log
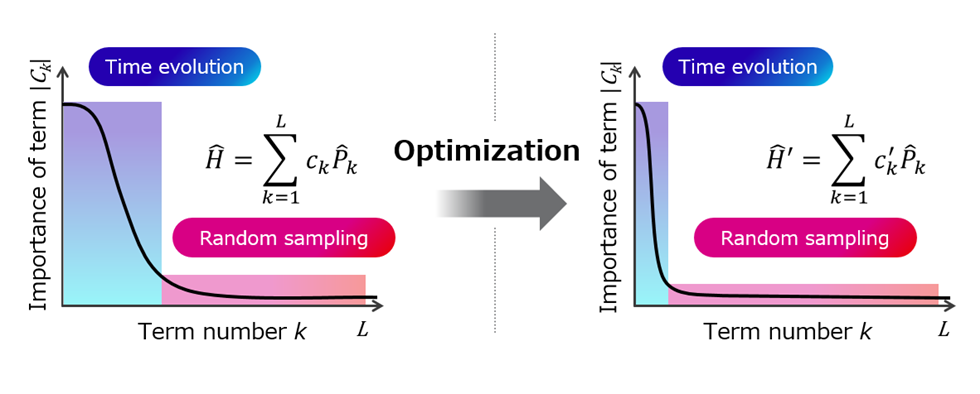
Figure 2: Principle of molecular model optimization
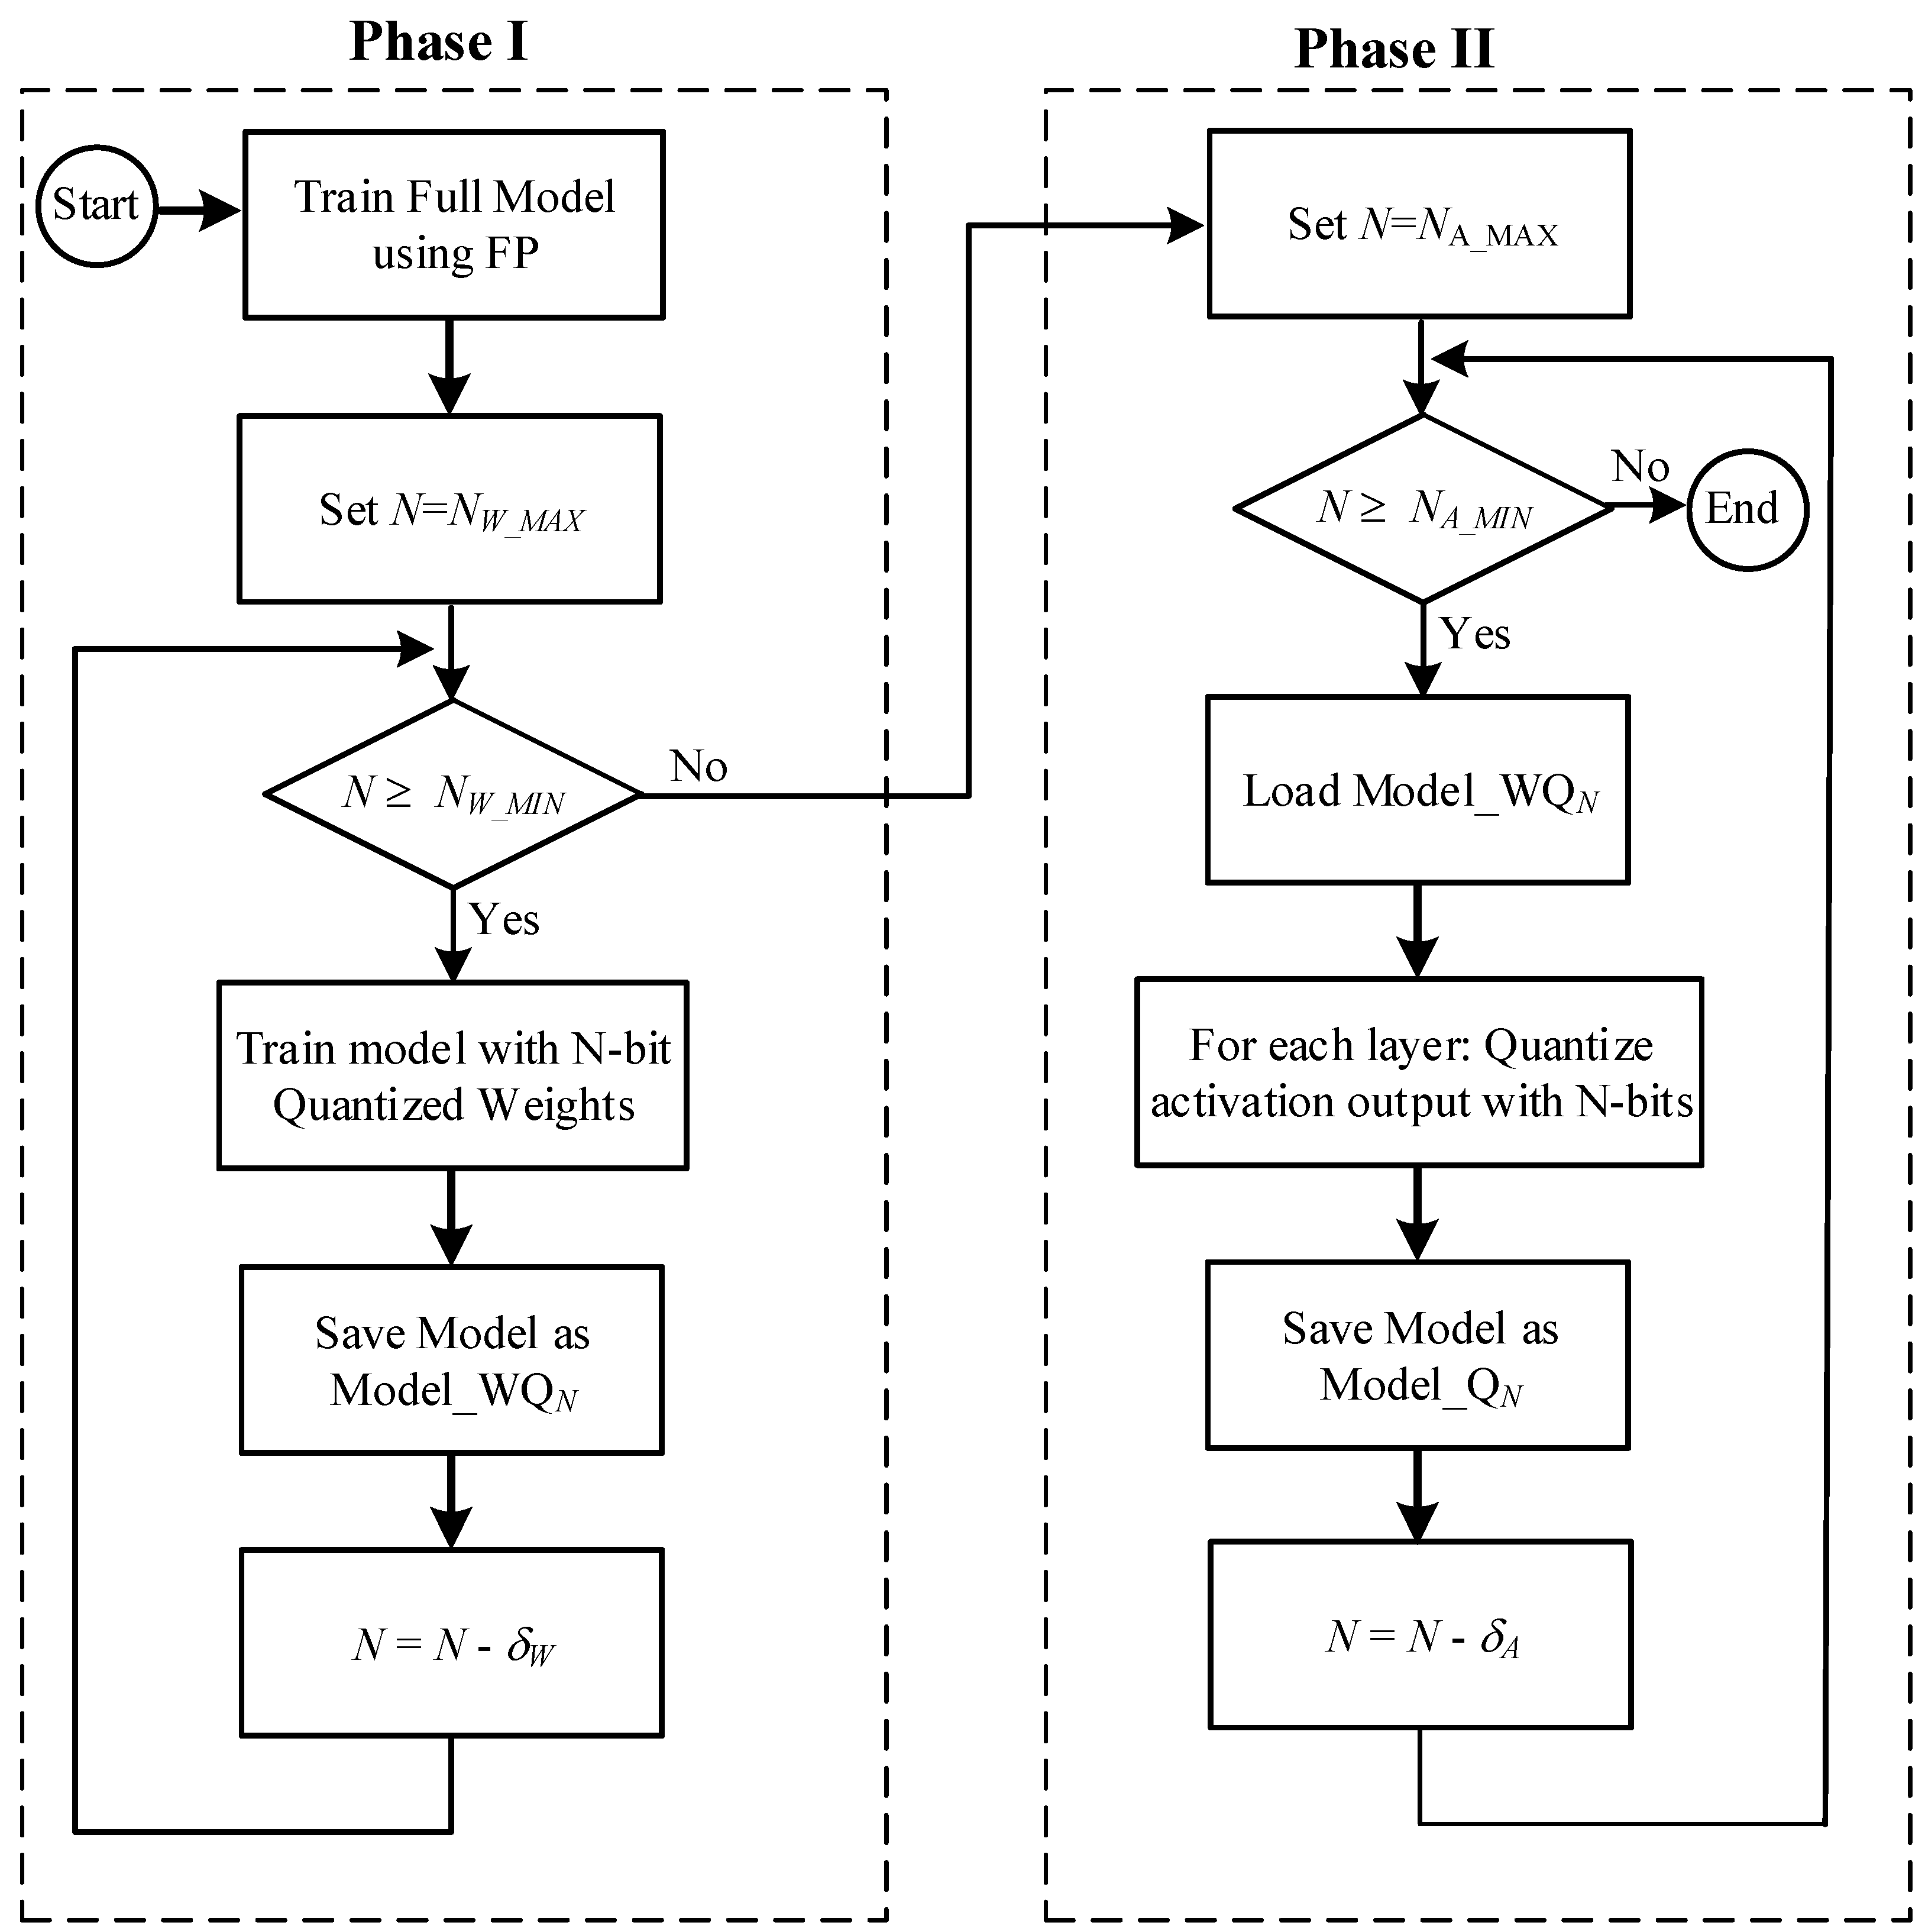
Quantization-Based Optimization Algorithm for Hardware Implementation ...
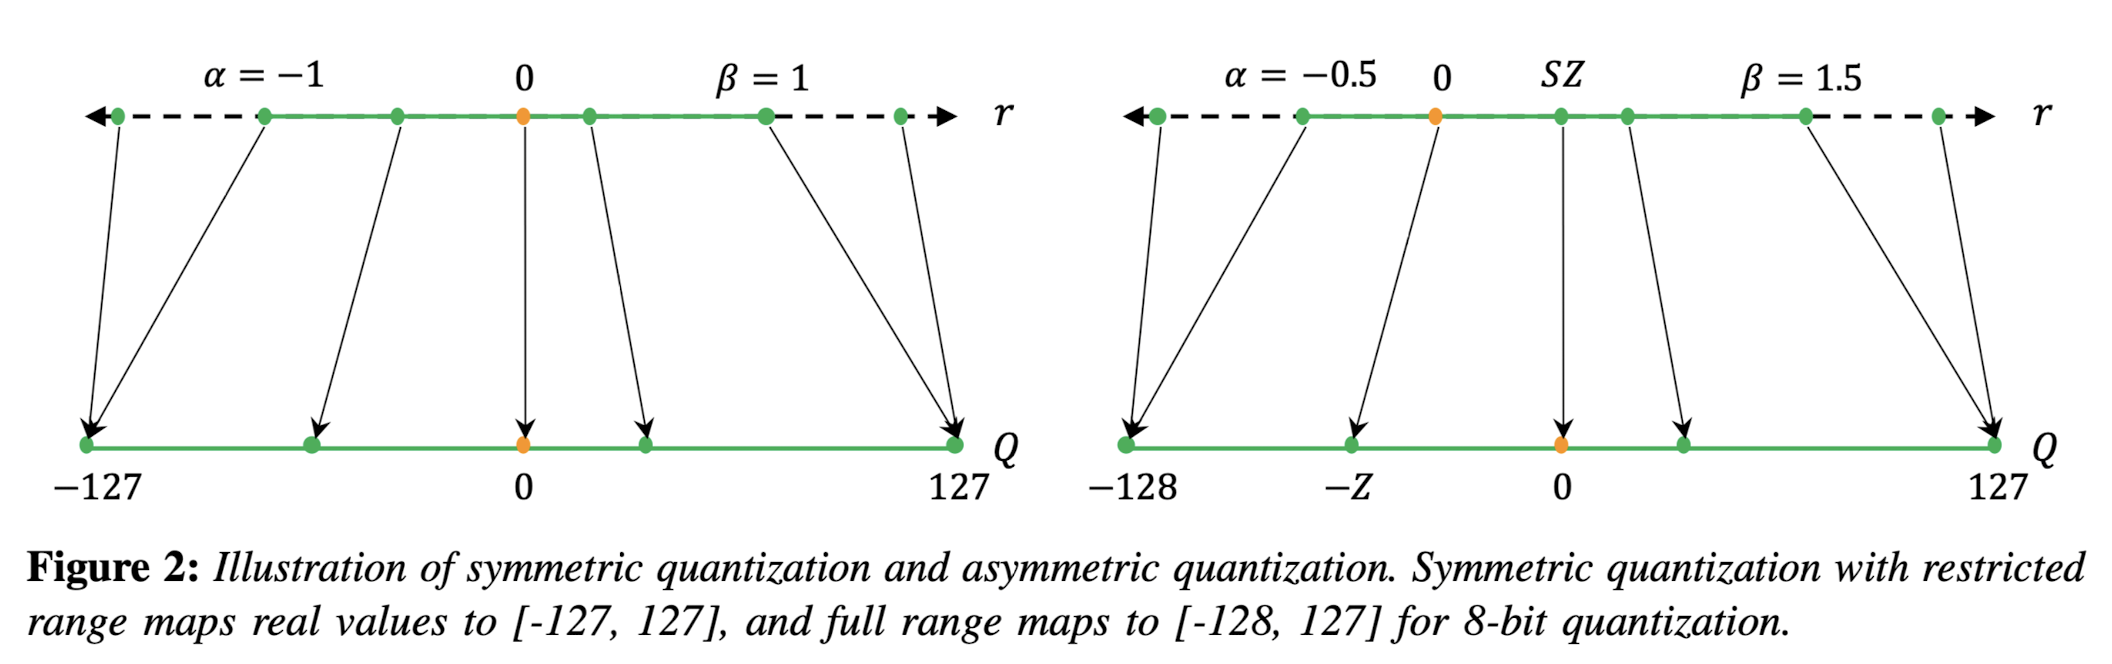
Model Quantization - A Lazy Data Science Guide
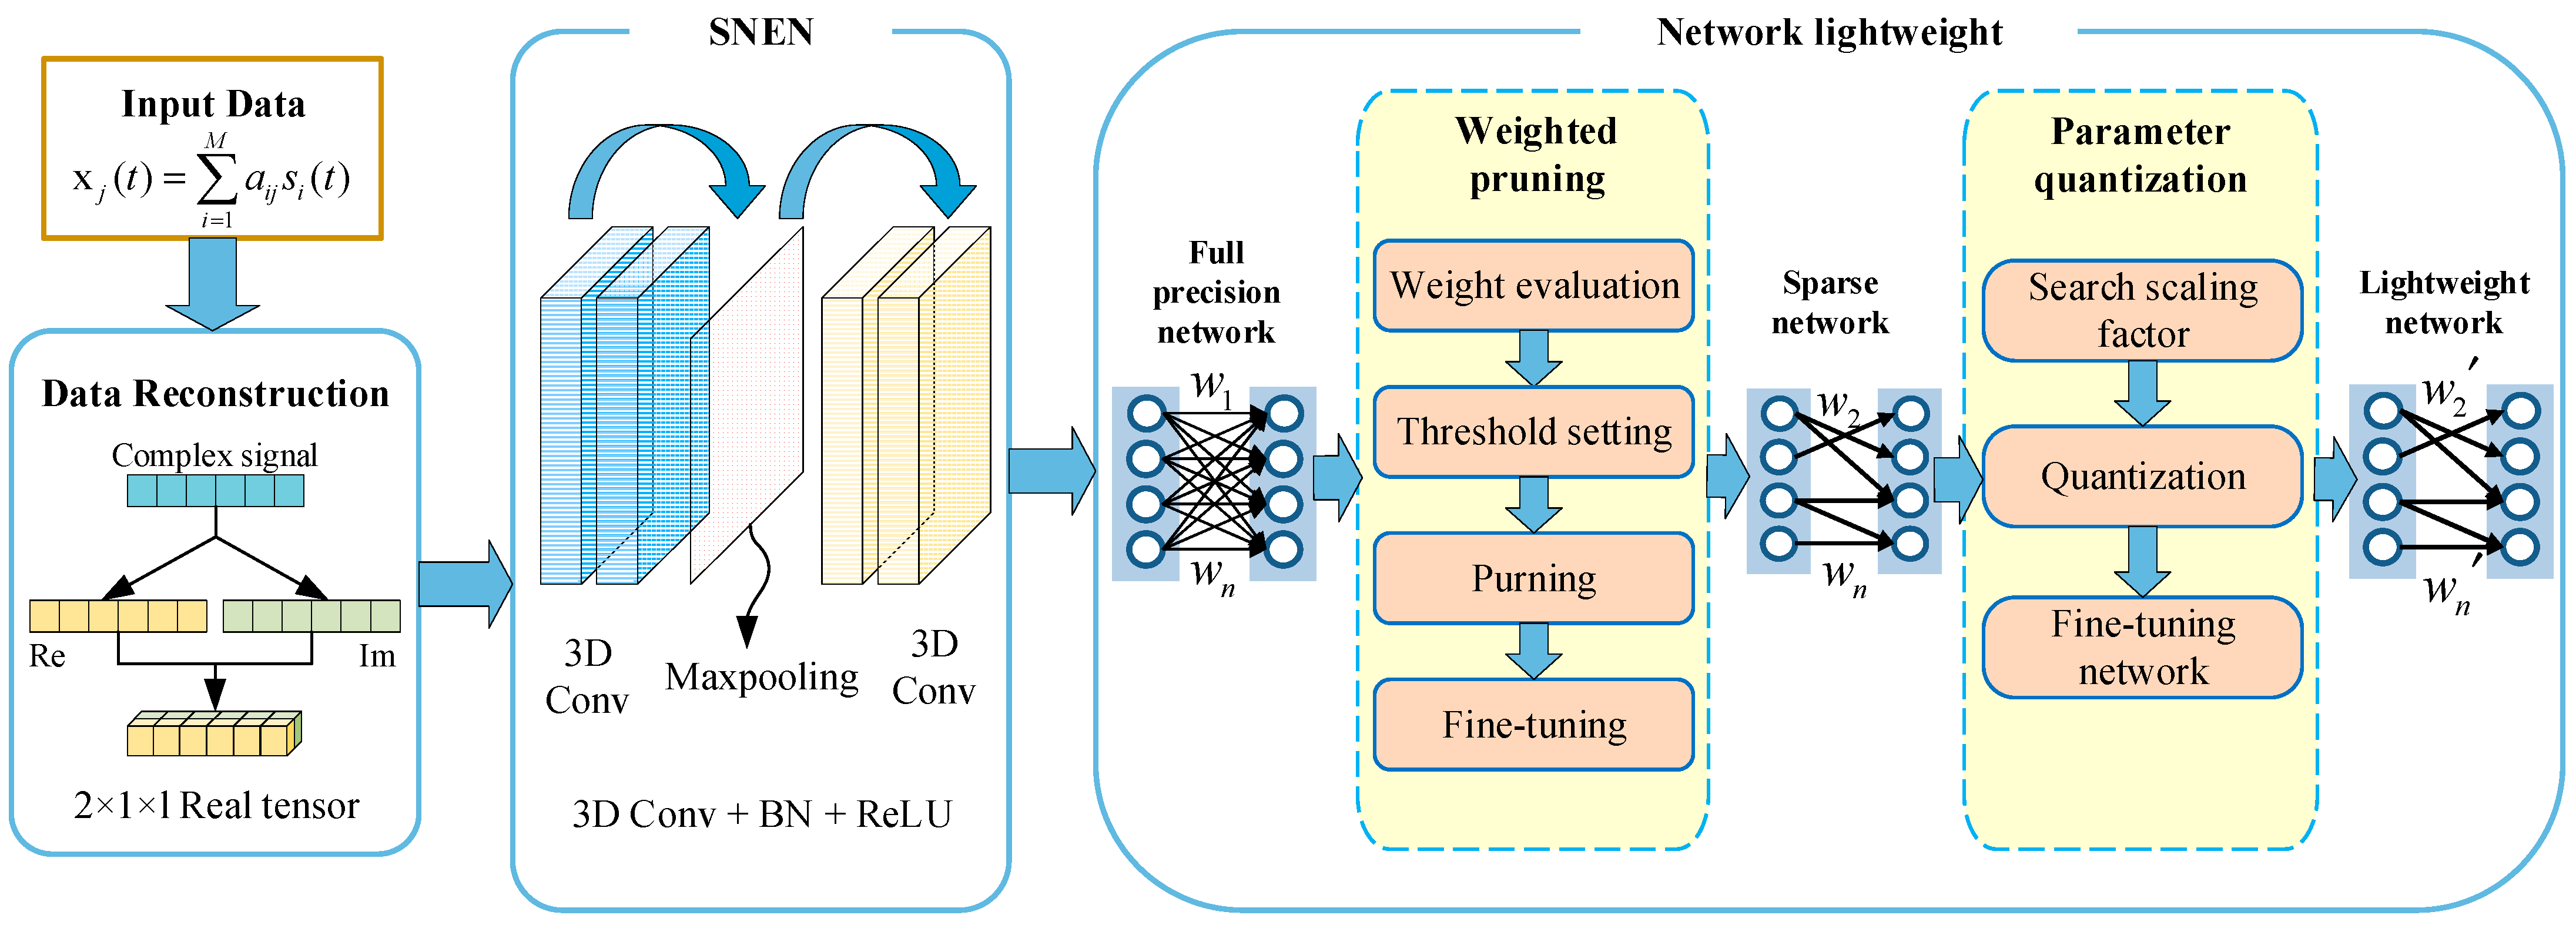
Pruning- and Quantization-Based Compression Algorithm for Number of ...
Advertisement Space (336x280)
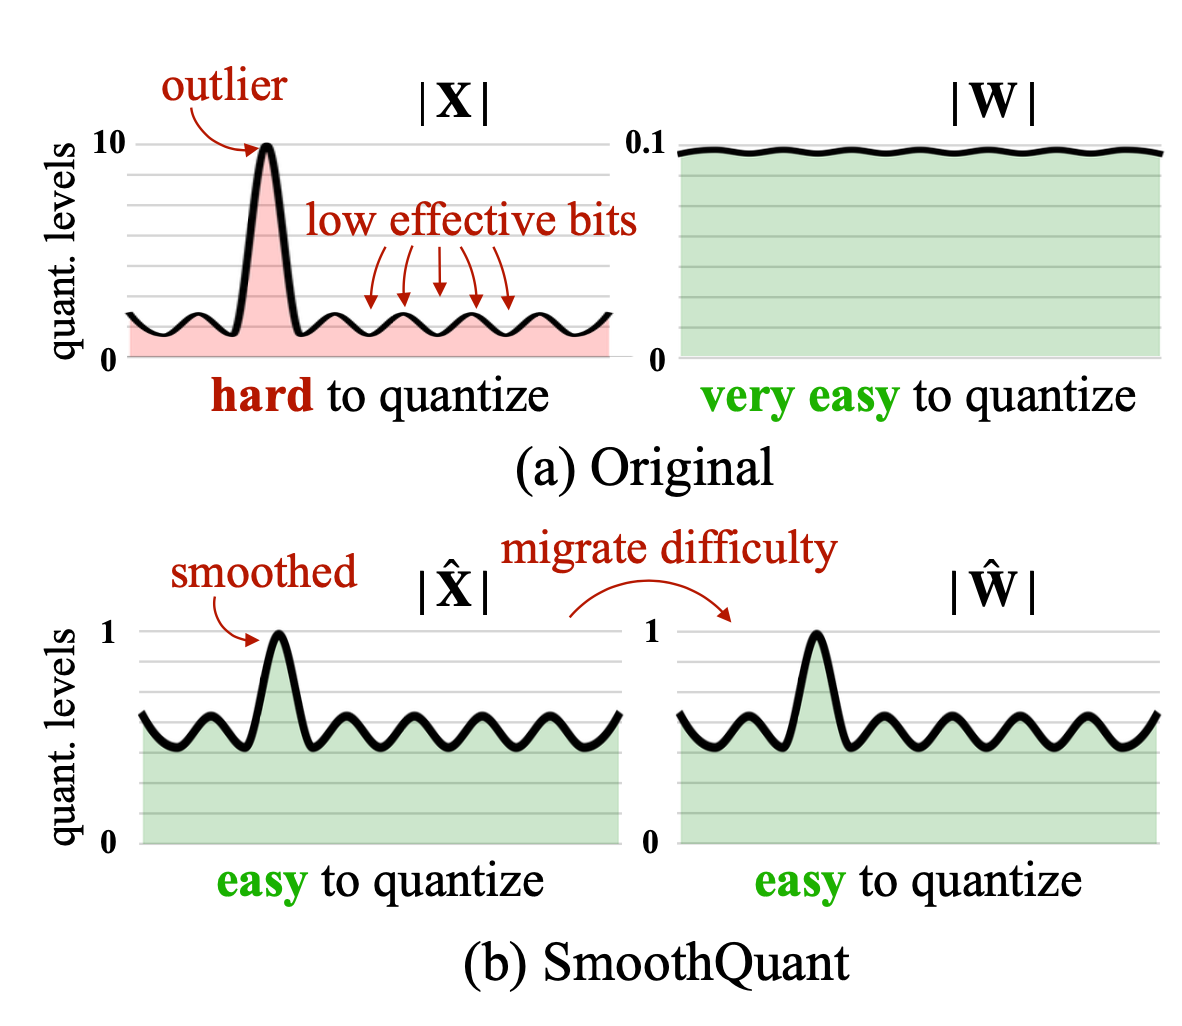
Large Transformer Model Inference Optimization | Lil'Log

Experiment design using the Tensorflow Lite and QKeras platform for ...

(PDF) Exploring Machine Learning for Semiconductor Process Optimization ...
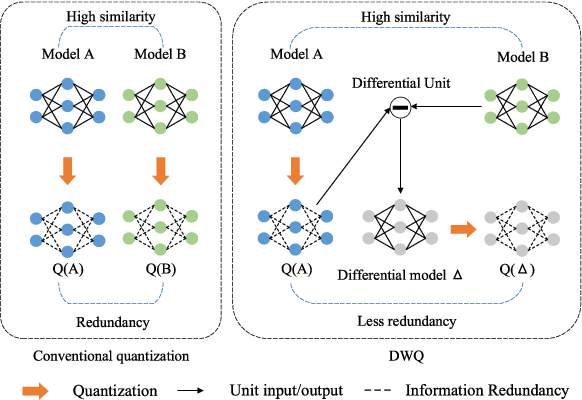
Figure 1 from Differential Weight Quantization for Multi-Model ...

Quantization-Based Optimization Algorithm for Hardware Implementation ...

[논문 리뷰] GuidedQuant: Large Language Model Quantization via Exploiting ...