
Modulesparsificationinfo Llm Compressor Docs
module_sparsification_info - LLM Compressor Docs

What is LLM Compressor? - LLM Compressor Docs
llmcompressor.transformers.sparsification.sparse_model - LLM Compressor ...
LLM Compressor v0.10: Faster compression with distributed GPTQ | Red ...
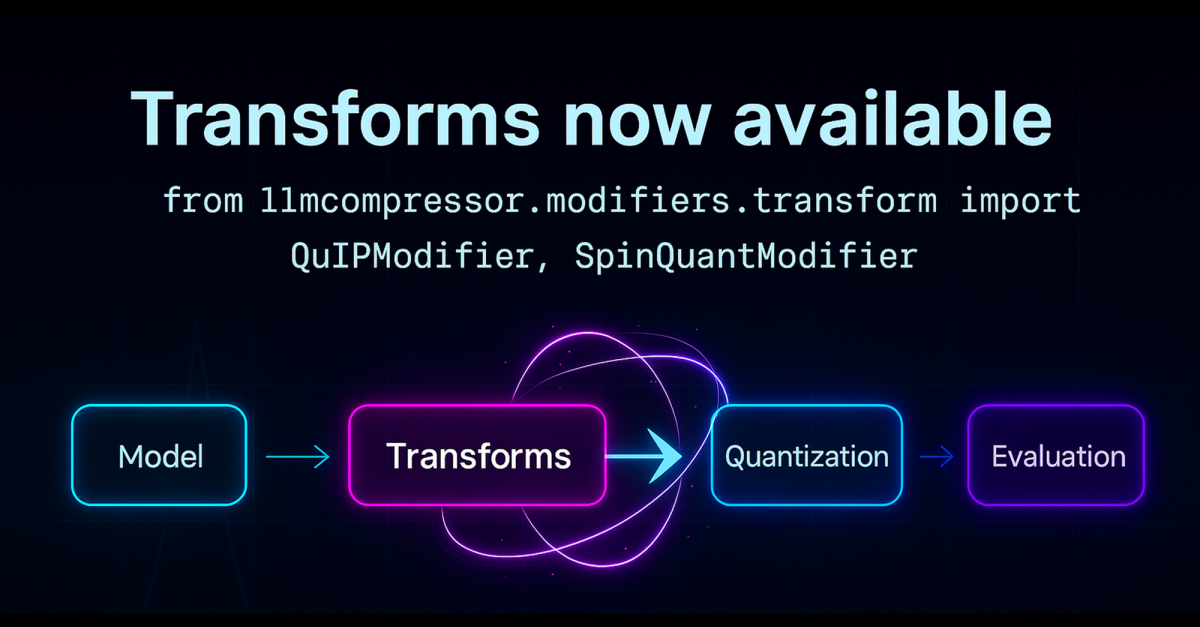
LLM Compressor 0.7.0 release recap | Red Hat Developer
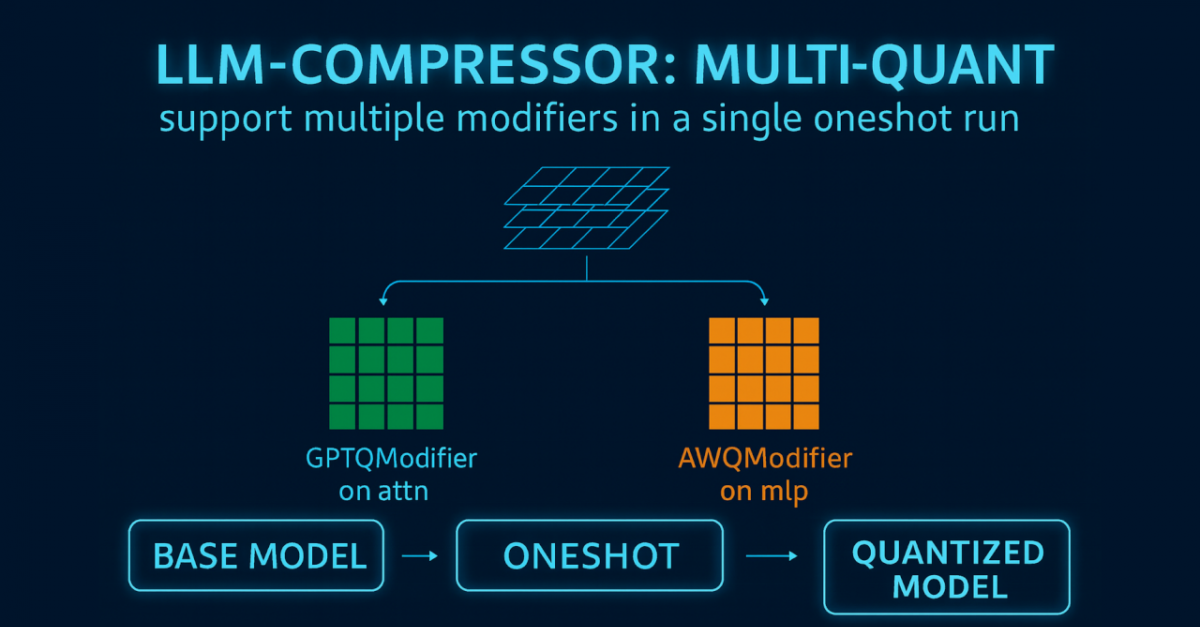
LLM Compressor 0.8.0: Extended support for Qwen3 and more | Red Hat ...

LLM Compressor 0.7.0 release recap | Red Hat Developer
Advancing Low‑Bit Quantization for LLMs: AutoRound x LLM Compressor ...

LLM Compressor deep dive + walkthrough - YouTube

LLM Compressor testing - a nm-testing Collection
Advertisement Space (300x250)

什麼是 LLM Compressor? - LLM Compressor 文件 - vLLM 文件
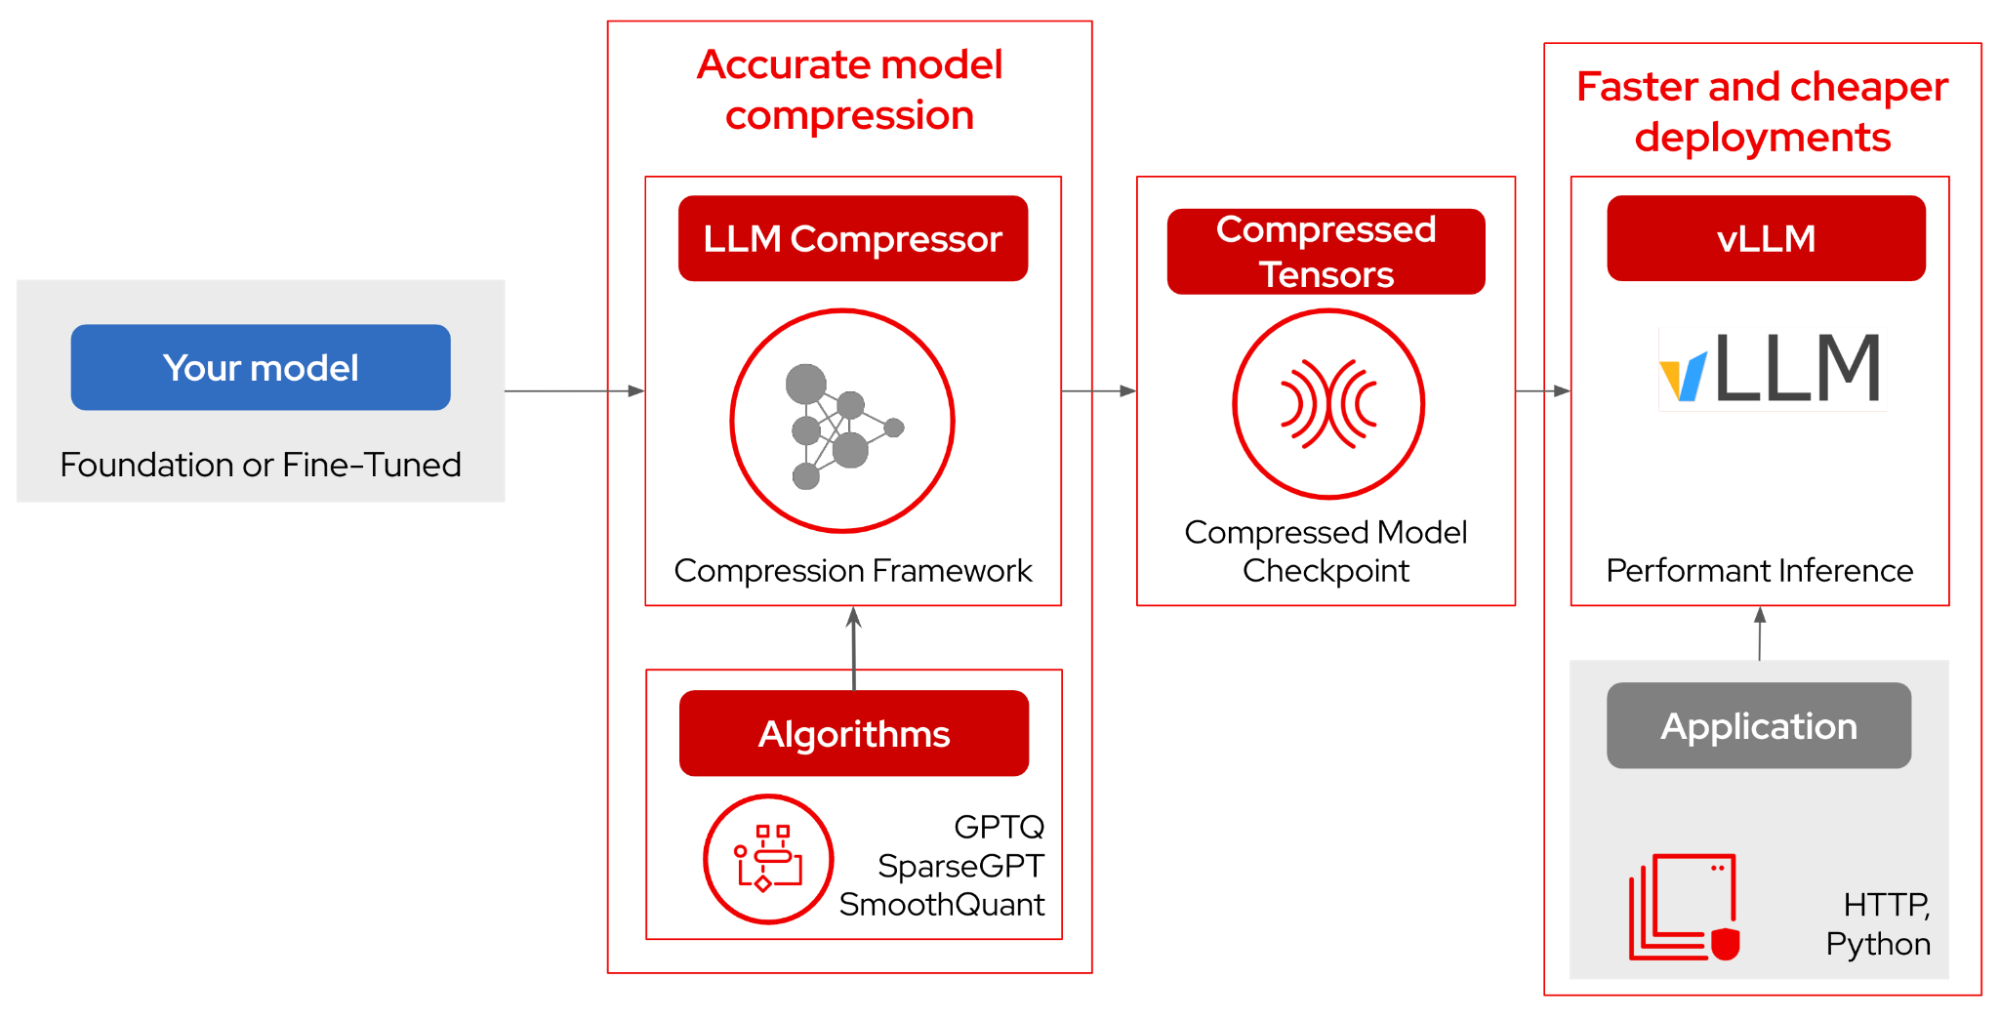
LLM compression and optimization: Cheaper inference with fewer hardware ...
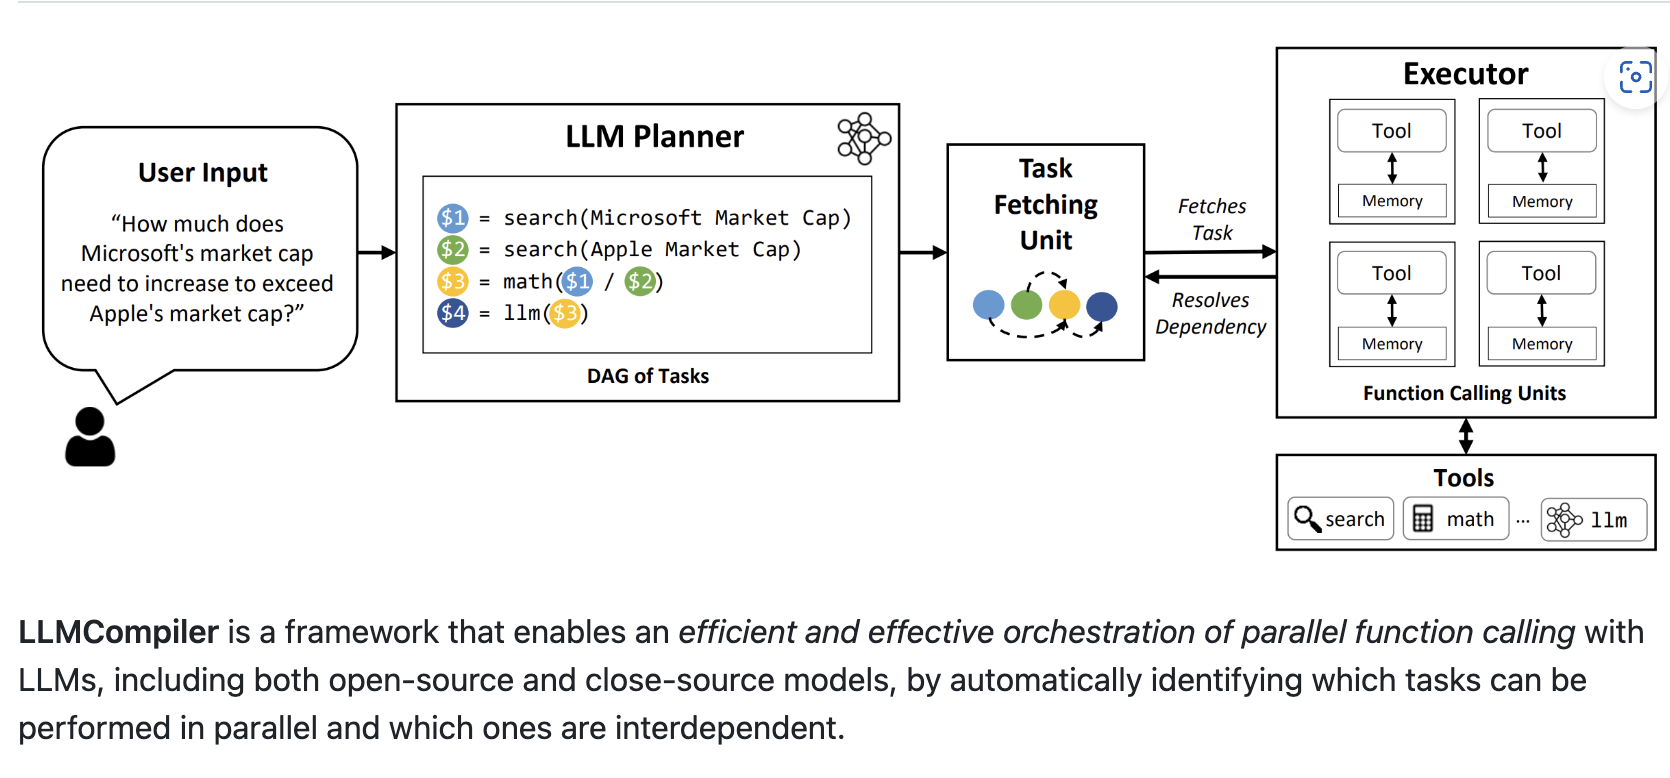
Exploring The Dynamics Of Llm Based Agent Frameworks – Monir ...
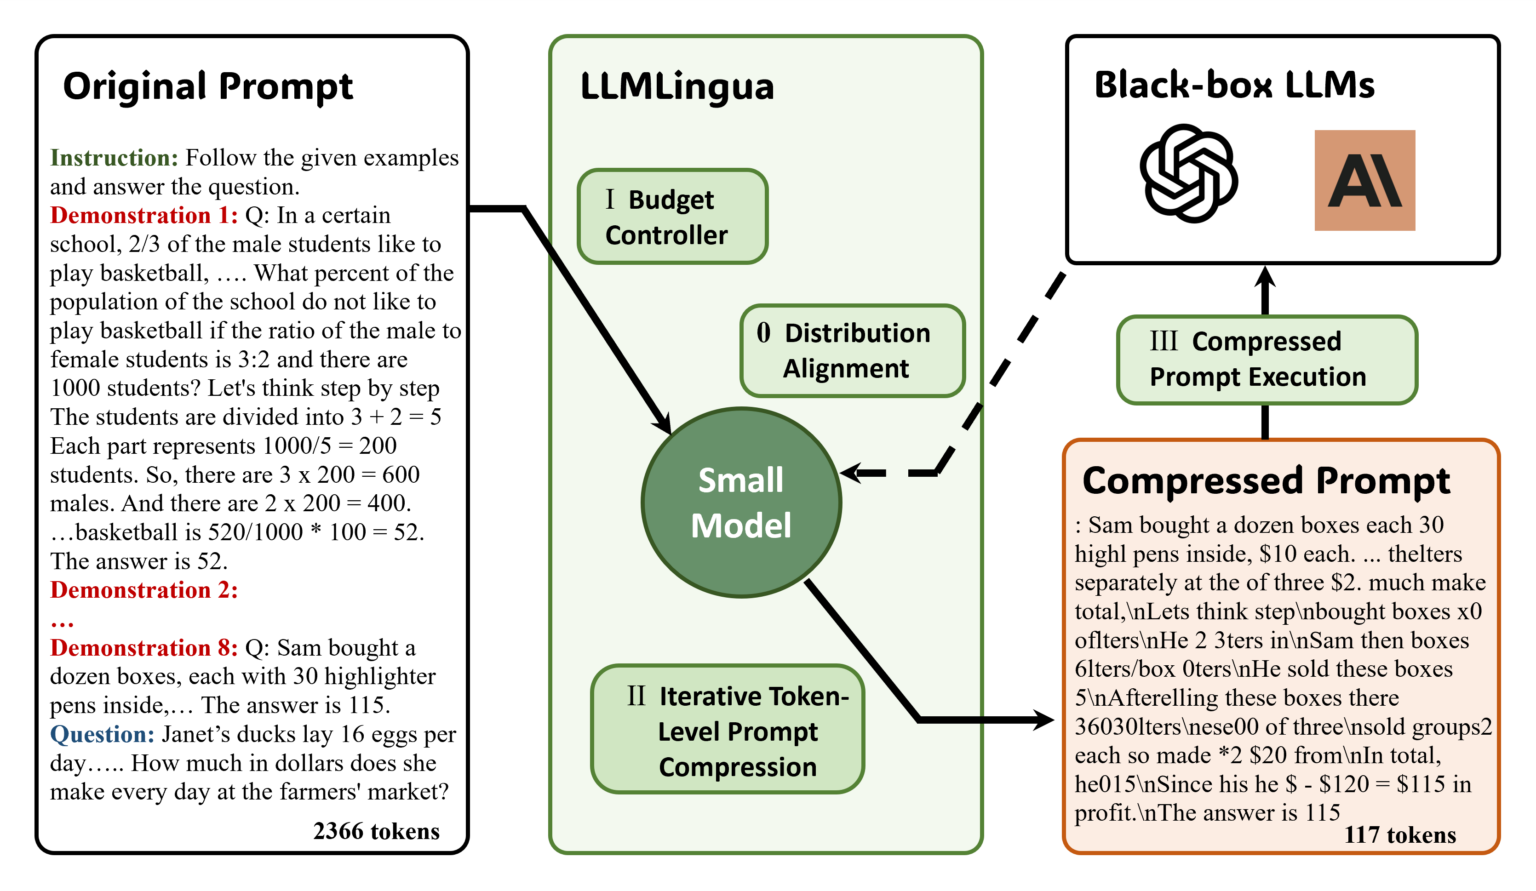
LLMLingua: Innovating LLM efficiency with prompt compression ...

LLM Compressor: Optimize LLMs for low-latency deployments | Red Hat ...

Evaluating LLM Compression: Balancing Efficiency, Trustworthiness, and ...

LLM Model Compression Techniques - Best Generative AI & Machine ...

LLM Compressor: Optimize LLMs for low-latency deployments | Red Hat ...
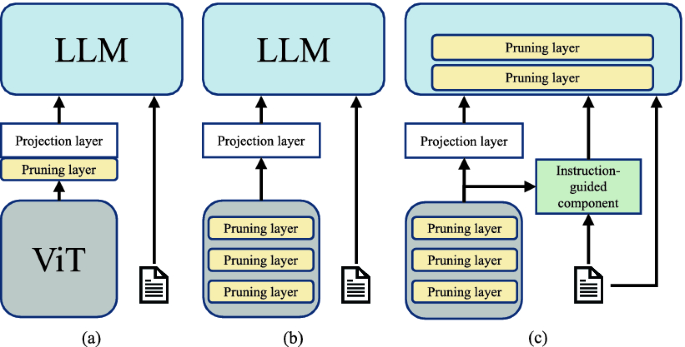
4 LLM Compression Techniques That You Can't Miss
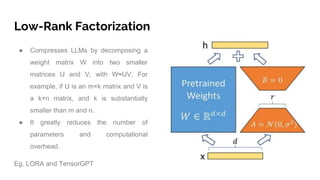
Paper presentation on LLM compression | PPTX
Advertisement Space (336x280)
LLM Compression | nunchaku-ai/deepcompressor | DeepWiki

(PDF) Understanding LLM Behaviors via Compression: Data Generation ...
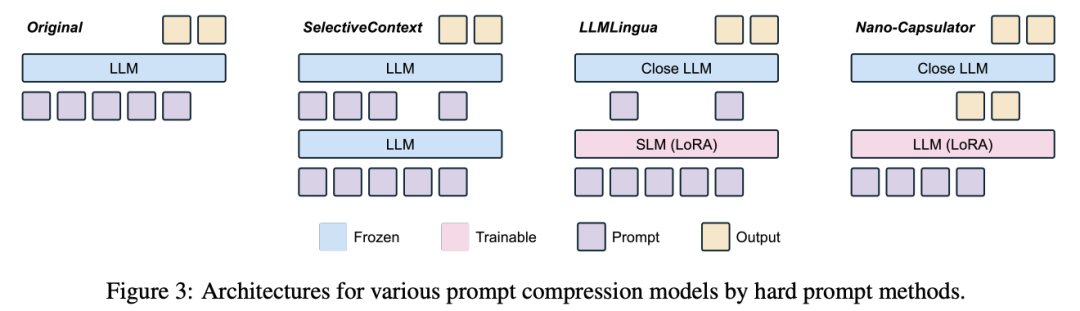
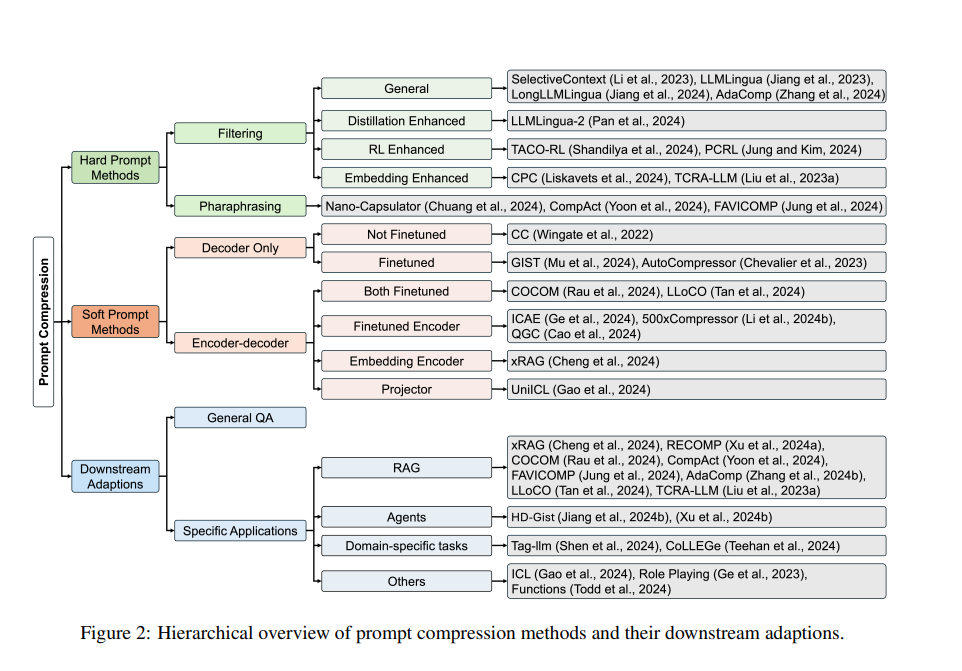
LLM 之 prompt压缩技术综述:技术进展、挑战与未来展望 - 知乎
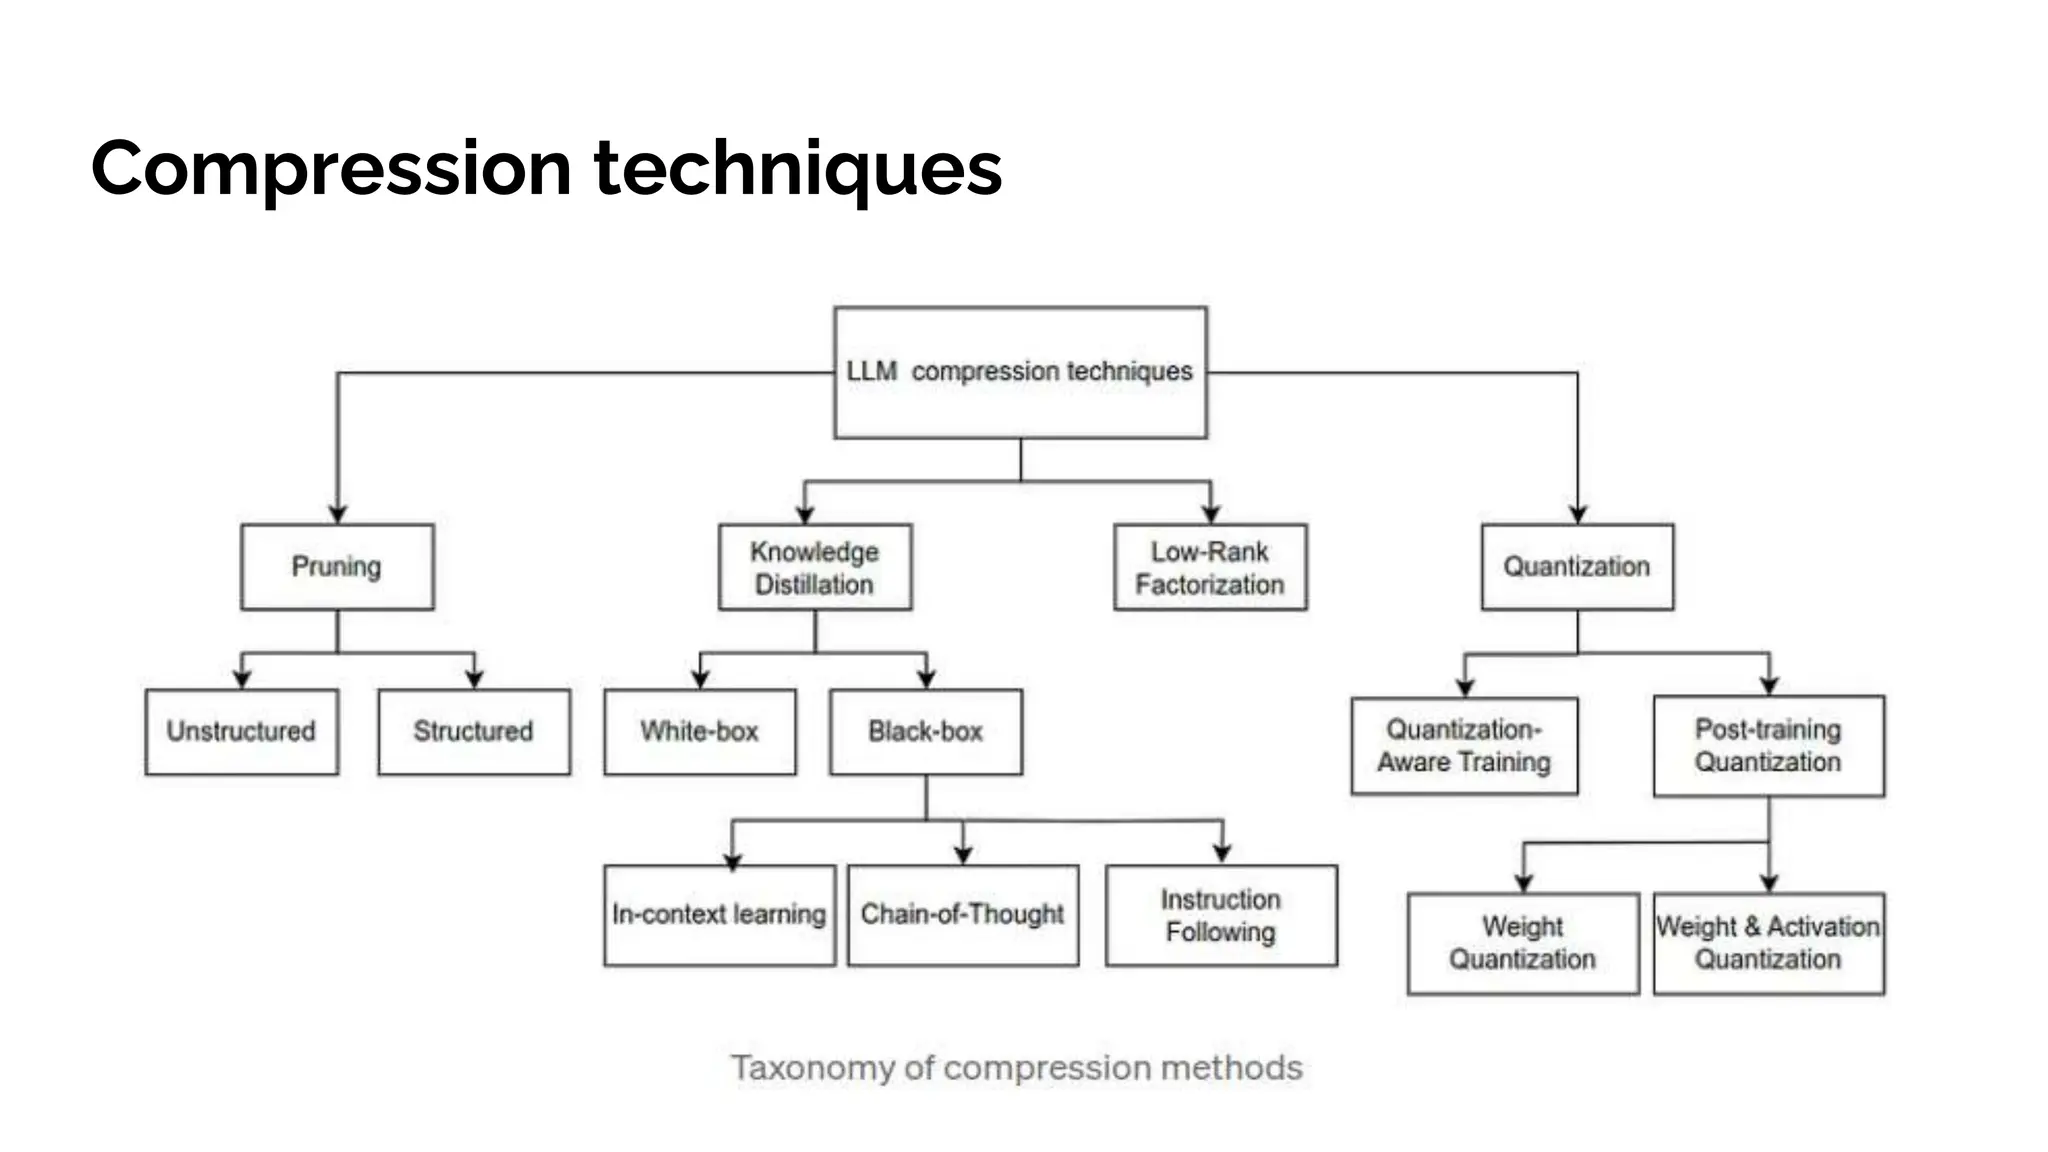
Paper presentation on LLM compression | PPTX

LLM Compression Techniques Deep Dive — Quantization, Pruning, and ...
LLM Compression Techniques to Build Faster and Cheaper LLMs
LLM Compression Techniques to Build Faster and Cheaper LLMs
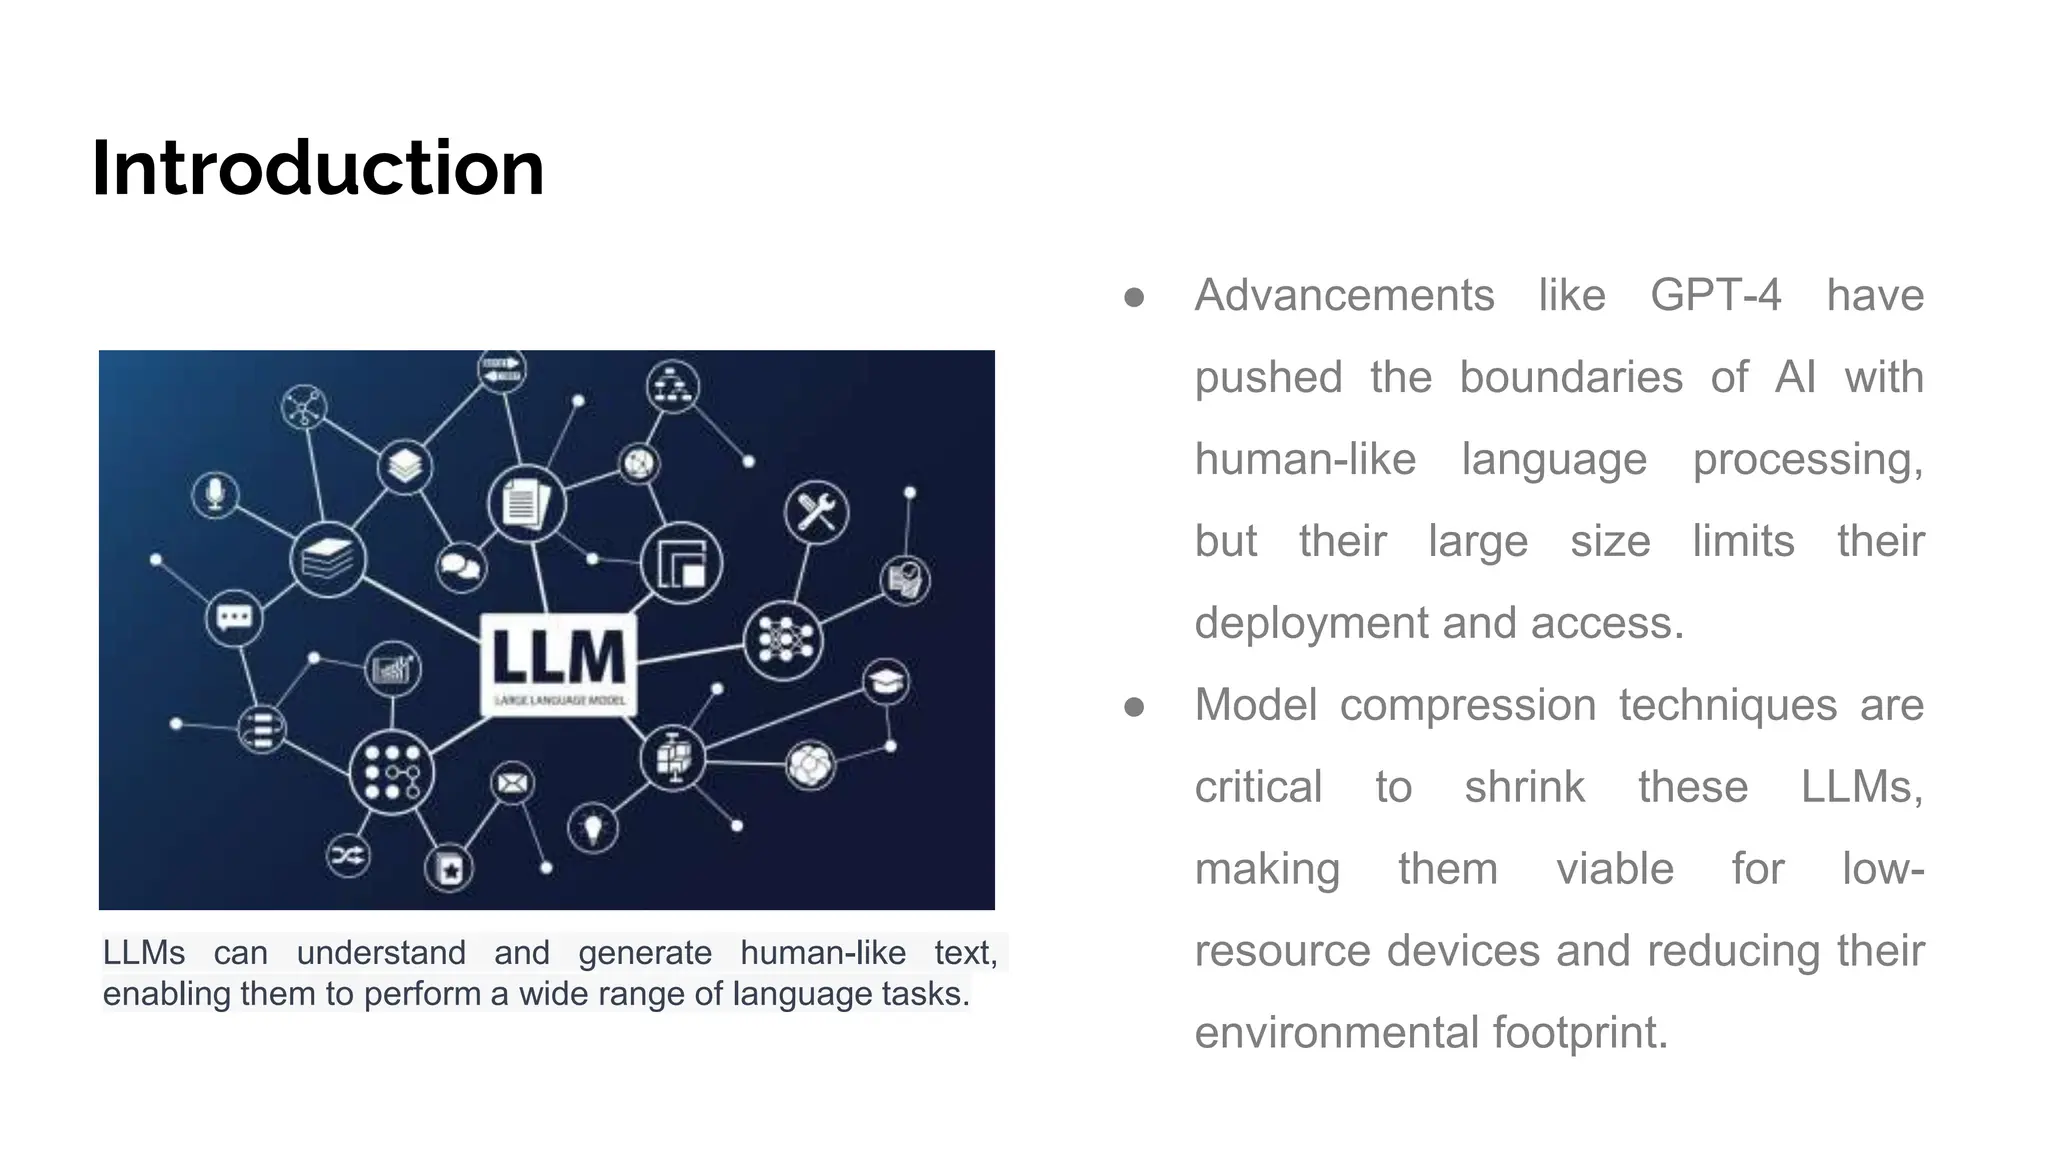
Paper presentation on LLM compression | PPTX
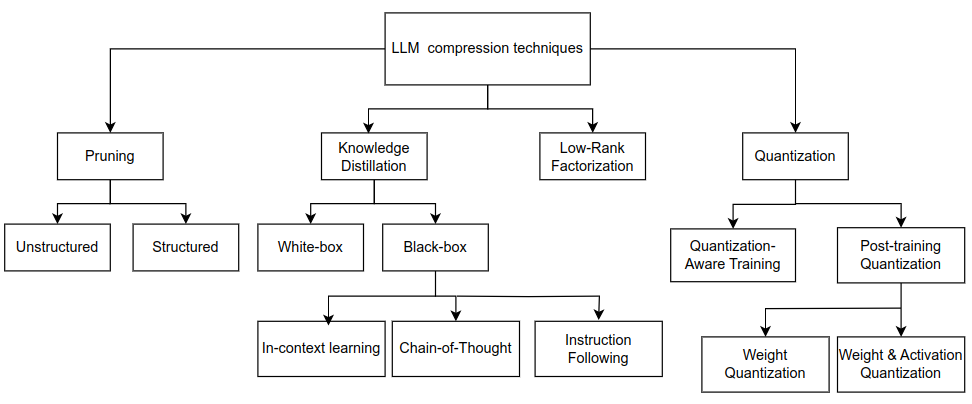
LLM Compression Techniques to Build Faster and Cheaper LLMs

FLAT-LLM: Efficient LLM Compression | PDF
Advertisement Space (336x280)
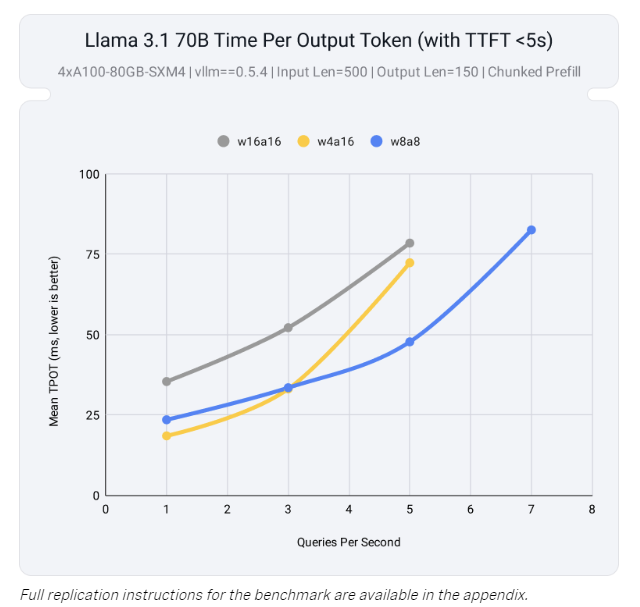
Neural Magic Releases LLM Compressor: A Novel Library to Compress LLMs ...
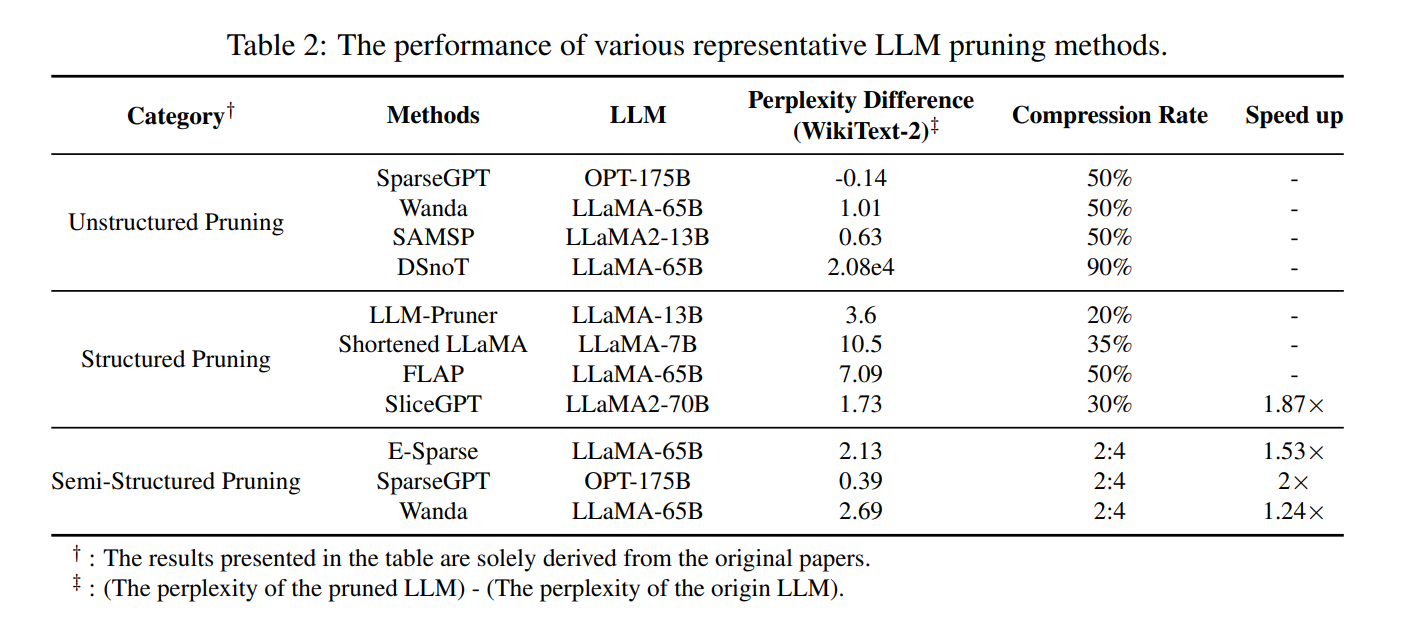
LLM Compression Techniques to Build Faster and Cheaper LLMs
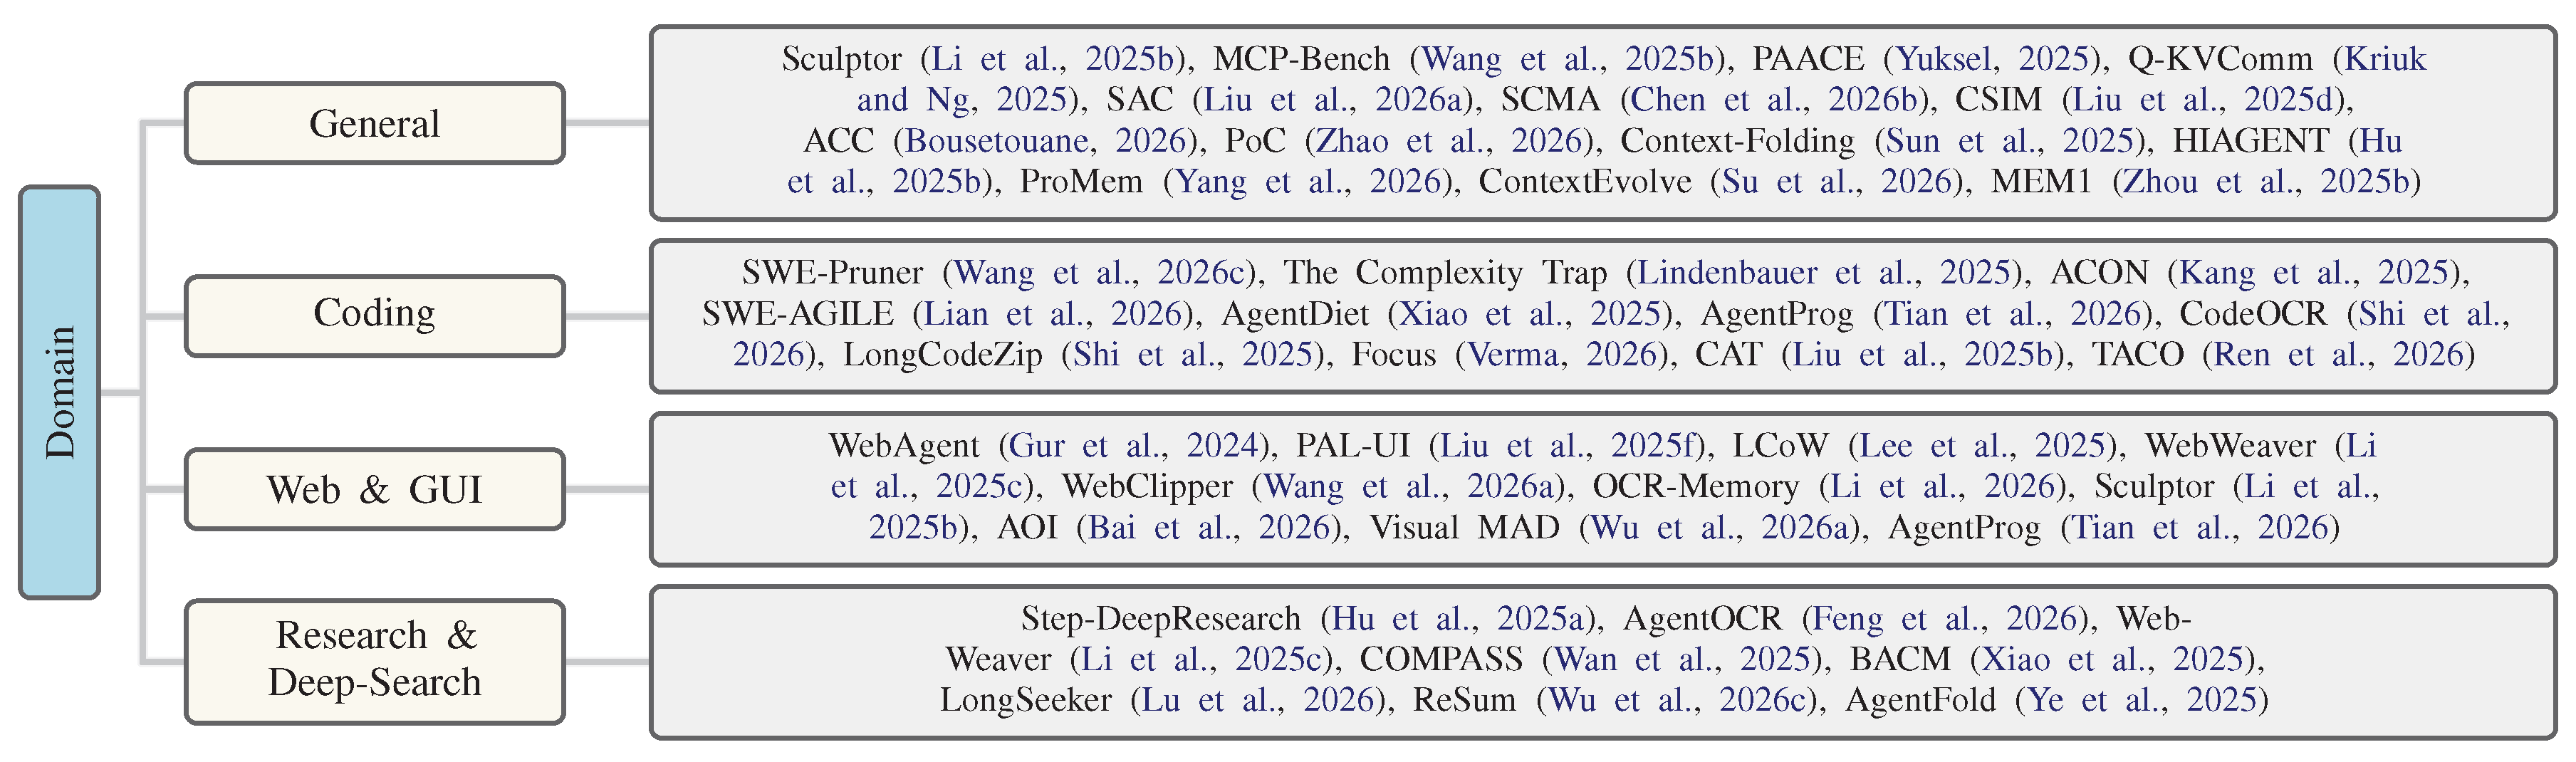
Context Compression for LLM Agents: A Survey of Methods, Failure Modes ...

ZipServ: Fast and Memory-Efficient LLM Inference with Hardware-Aware ...
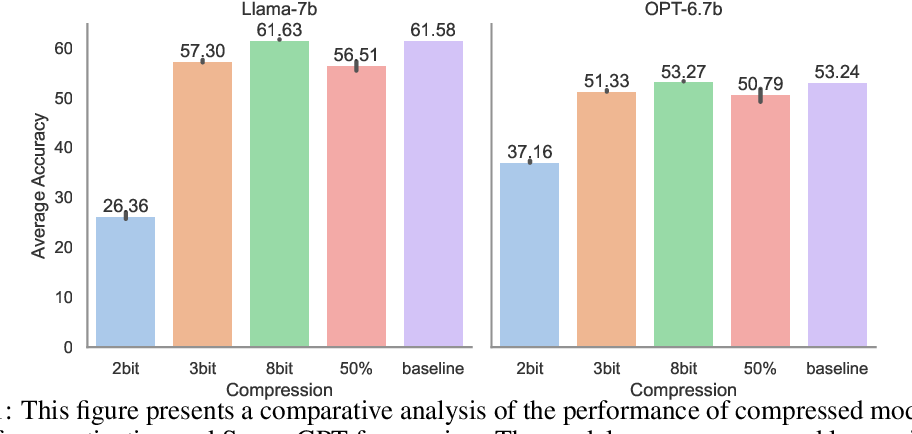
Figure 1 from Simple LLM Compression Recovery Using Dynamic Prompting ...

Multimodal Quantization with LLM Compressor! Compression isn't just for ...