
Multi Task Domain Adaptation For Language Grounding With 3d Objects

Multi-Task Domain Adaptation for Language Grounding with 3D Objects ...
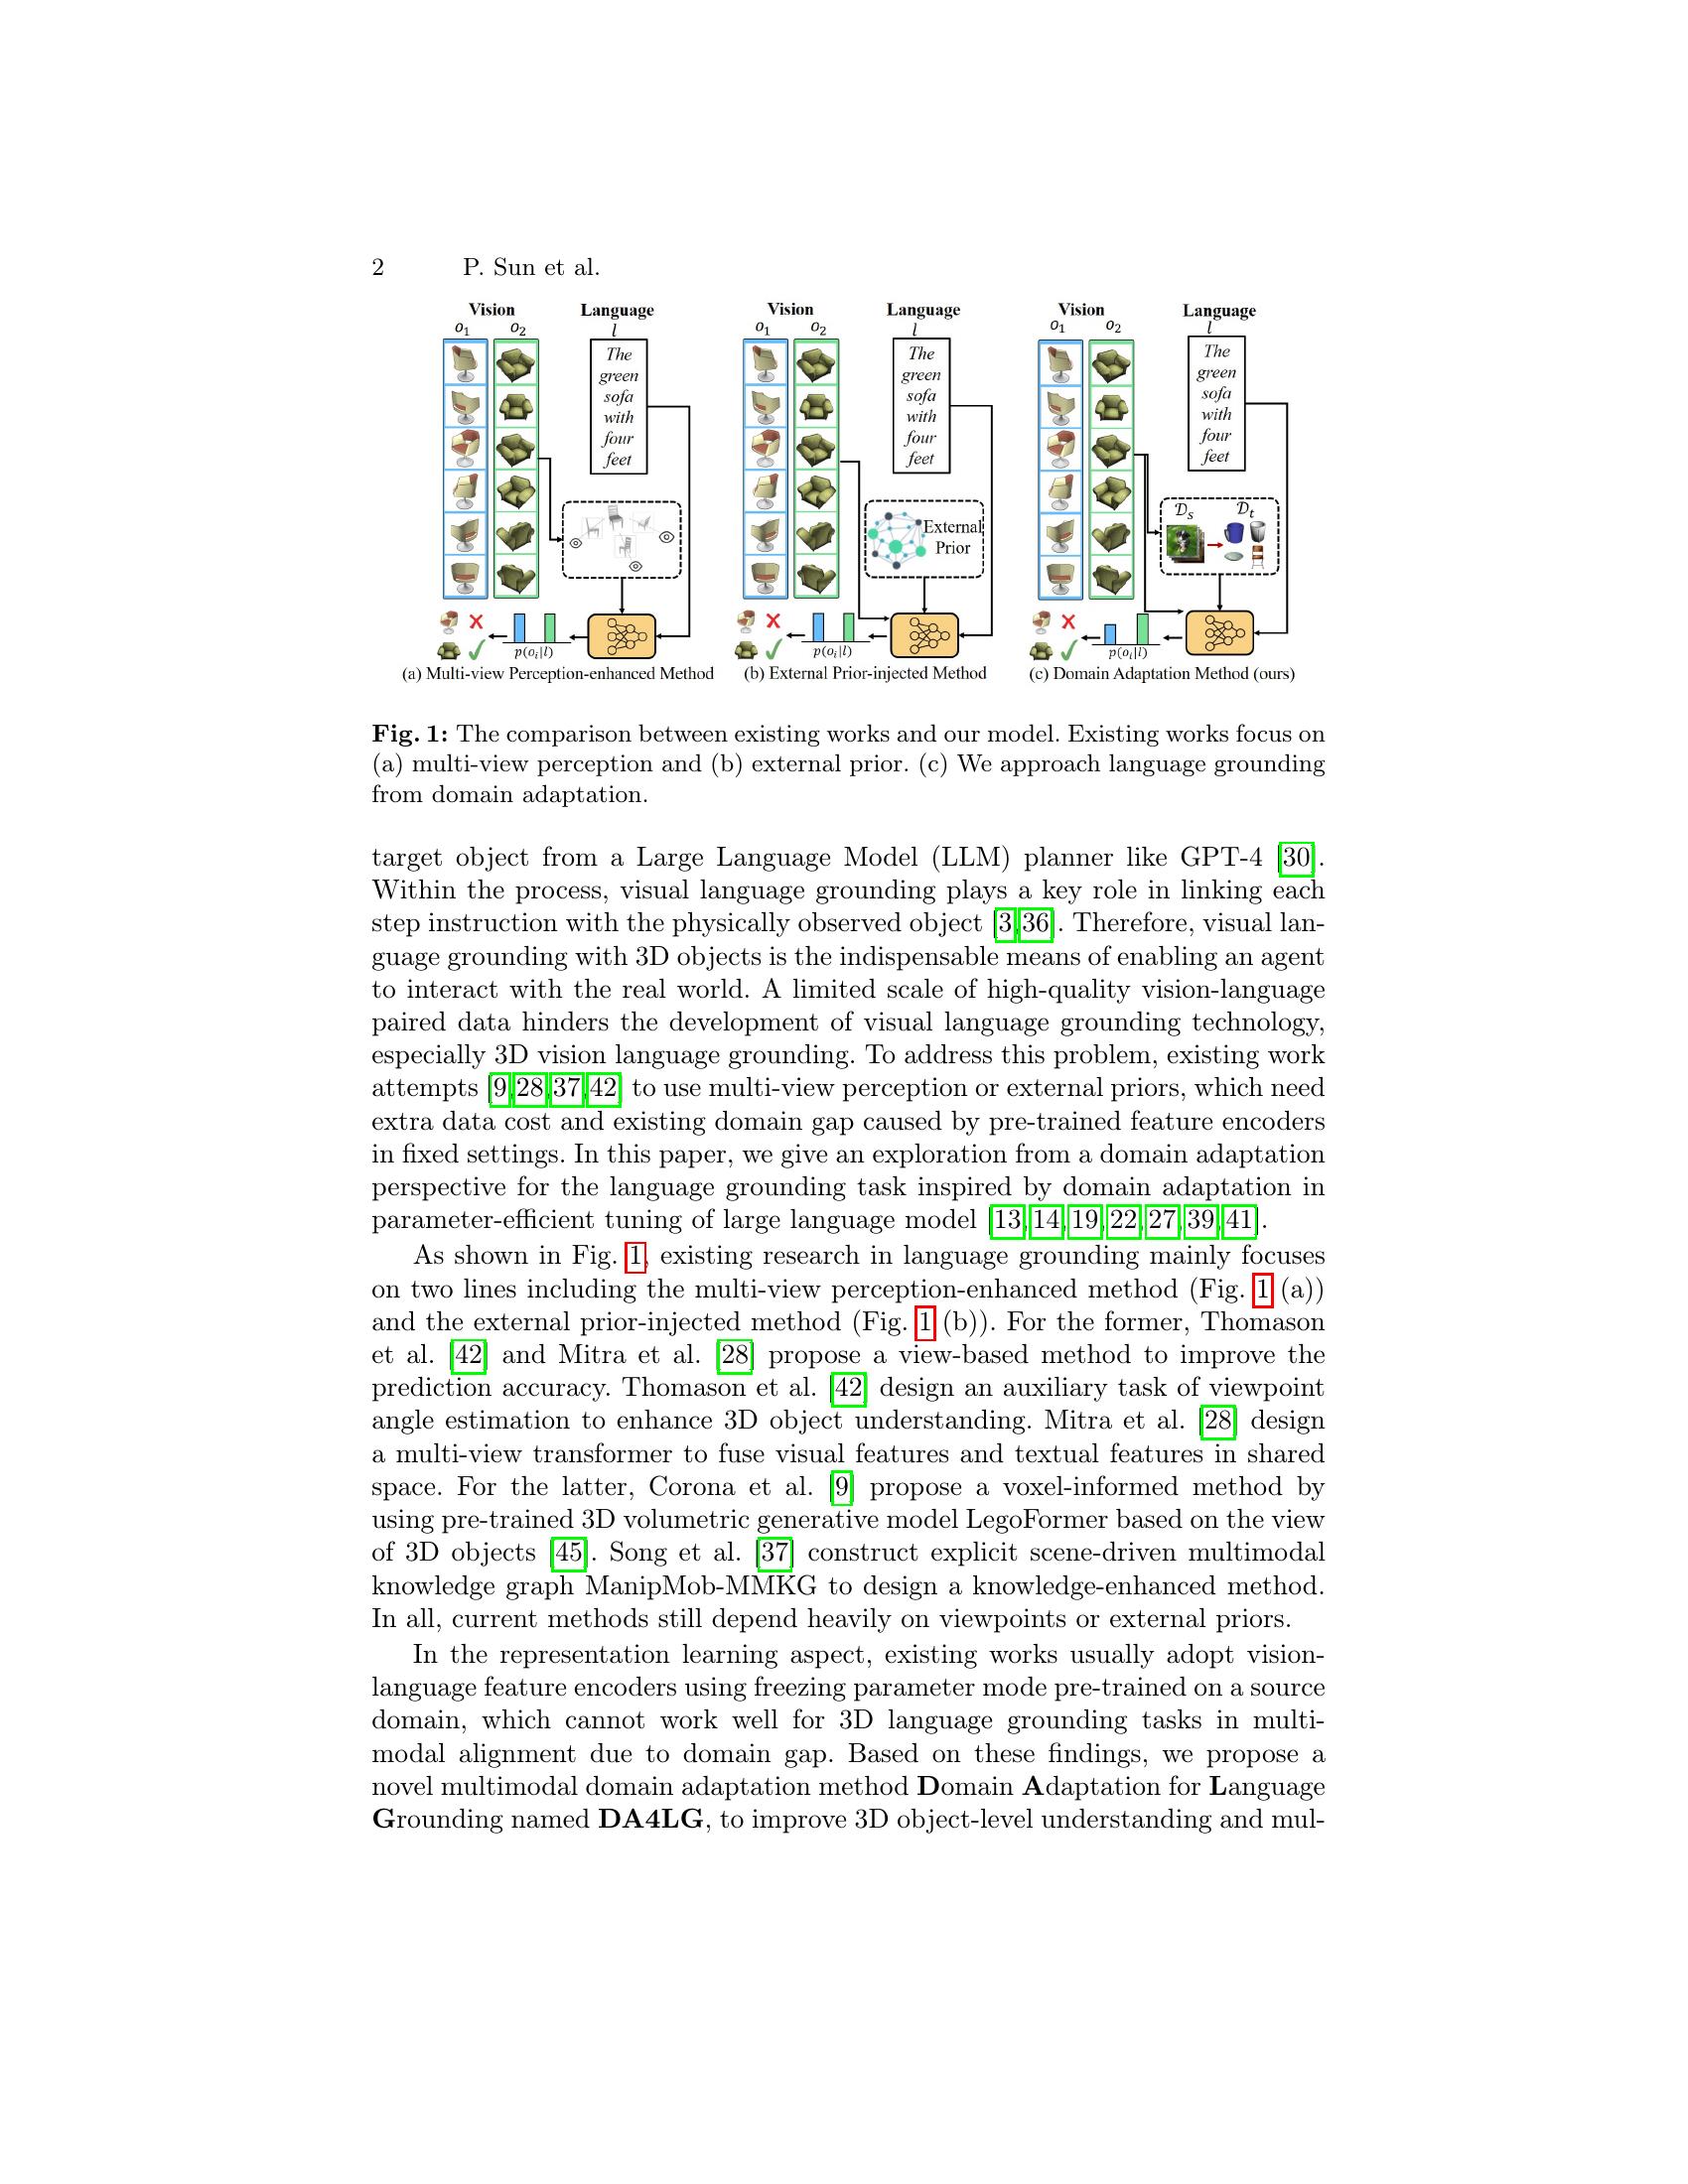
Multi-Task Domain Adaptation for Language Grounding with 3D Objects - 智 ...

[2407.02846] Multi-Task Domain Adaptation for Language Grounding with ...

[2407.02846] Multi-Task Domain Adaptation for Language Grounding with ...
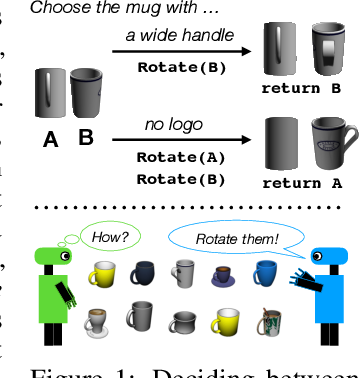
Figure 1 from Language Grounding with 3D Objects | Semantic Scholar
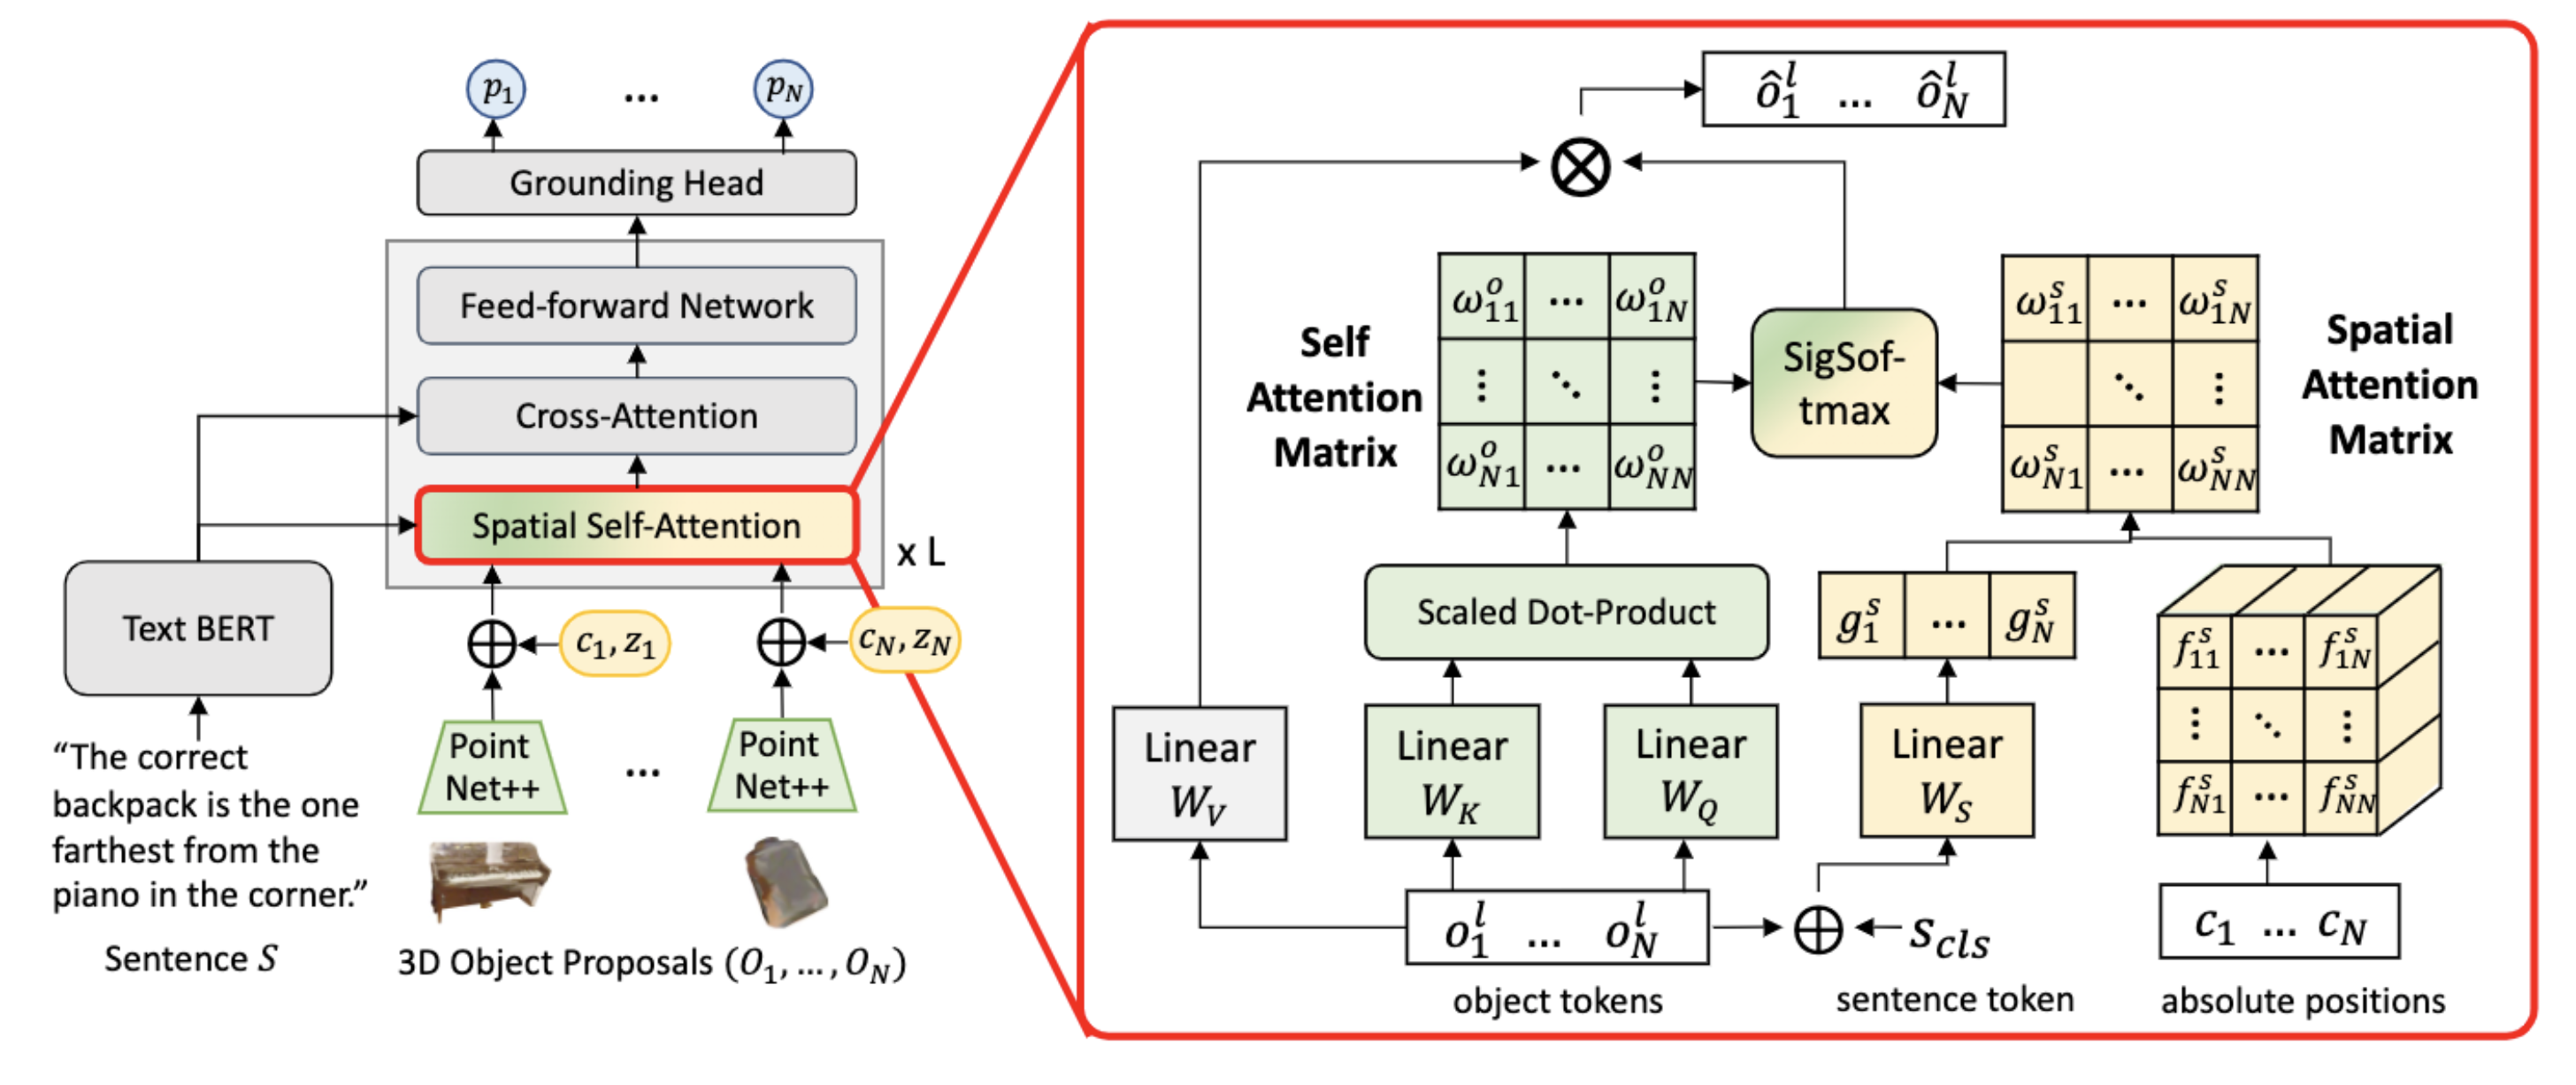
Language Conditioned Spatial Relation Reasoning for 3D Object Grounding
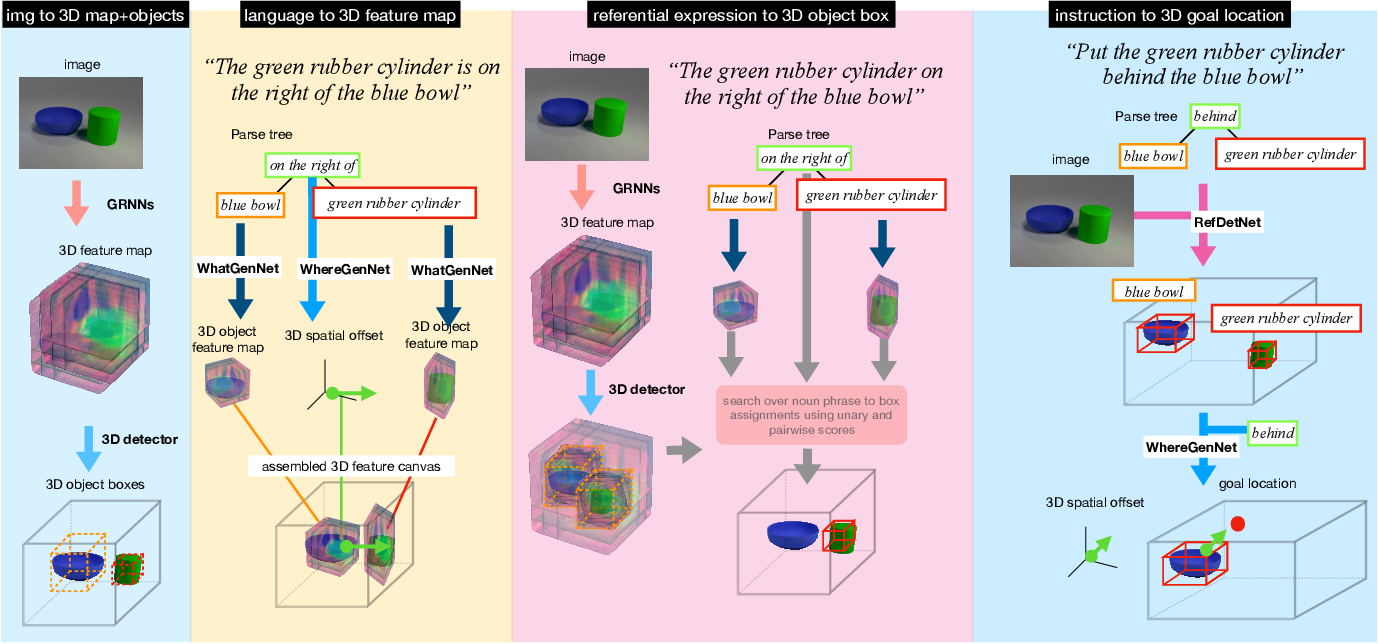
Figure 1 from Embodied Language Grounding With 3D Visual Feature ...

Figure 6 from Naturally Supervised 3D Visual Grounding with Language ...

Language Conditioned Spatial Relation Reasoning for 3D Object Grounding ...

CVPR2021:ST3D——Self-training for Unsupervised Domain Adaptation on 3D ...
Advertisement Space (300x250)

Grounding 3D Object Affordance with Language Instructions, Visual ...

LLM-Grounder: Open-Vocabulary 3D Visual Grounding with Large Language ...

Figure 1 from Unsupervised Domain Adaptation for Video Object Grounding ...
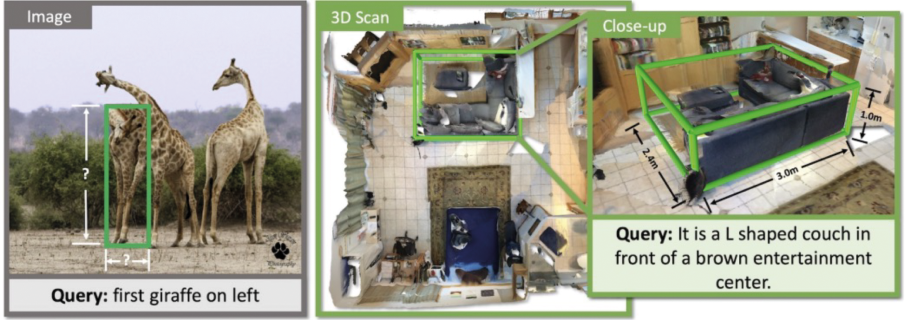
Grounding natural language to 3D scenes - Institute for Advanced Study ...

Figure 1 from Domain and Task Adaptive Pretraining for Language Models ...
UADA3D: Unsupervised Adversarial Domain Adaptation for 3D Object ...

[2406.19362] STAL3D: Unsupervised Domain Adaptation for 3D Object ...

[2107.03438] LanguageRefer: Spatial-Language Model for 3D Visual Grounding

Paper page - LLM-Grounder: Open-Vocabulary 3D Visual Grounding with ...

[2309.12311] LLM-Grounder: Open-Vocabulary 3D Visual Grounding with ...
Advertisement Space (336x280)

Figure 5 from Language Conditioned Spatial Relation Reasoning for 3D ...

Figure 2 from Language Conditioned Spatial Relation Reasoning for 3D ...

(PDF) LanguageRefer: Spatial-Language Model for 3D Visual Grounding

Language Adaptive Weight Generation for Multi-task Visual Grounding 论文 ...

[论文评述] Visual Grounding with Multi-modal Conditional Adaptation
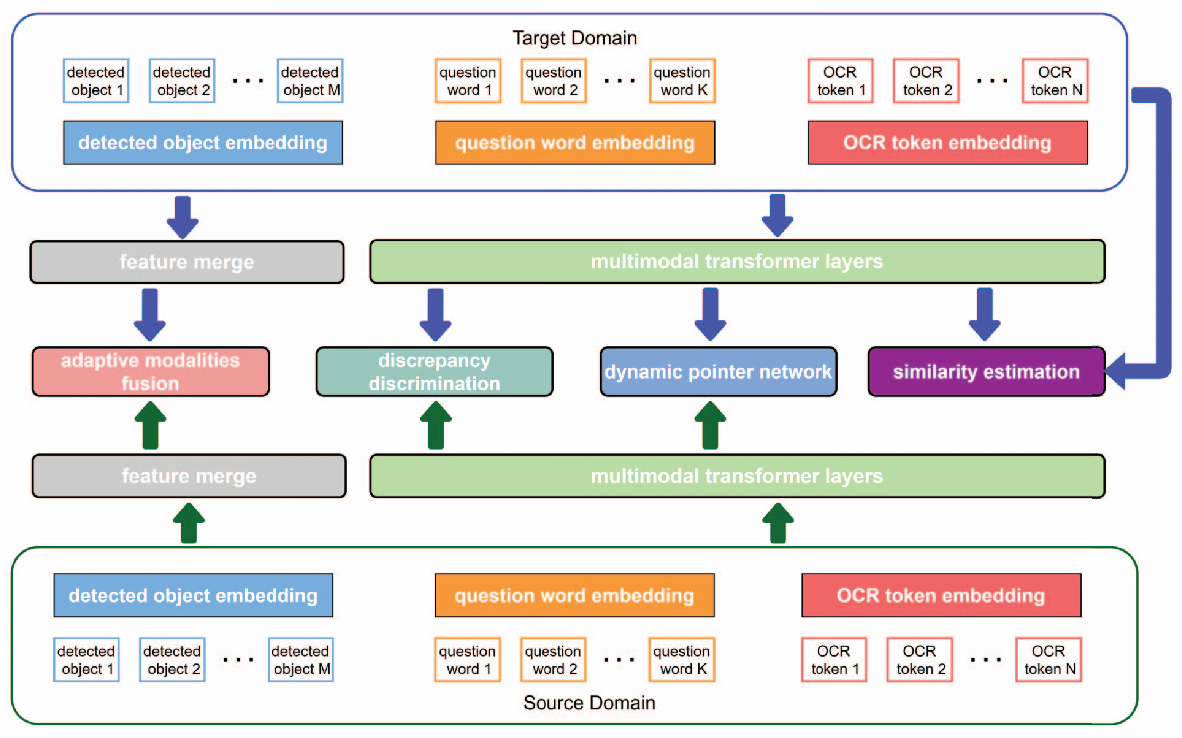
Figure 2 from Multi-modal Domain Adaptation for Text Visual Question ...

An Accuracy Enhanced Vision Language Grounding Method Fused with Gaze ...

《Multi-task Domain Adaptation for Sequence Tagging》阅读笔记 - 知乎

Figure 1 from Multi-task Domain Adaptation for Sequence Tagging ...

OnlineSI: Taming Large Language Model for Online 3D Understanding and ...
Advertisement Space (336x280)

Open-Vocabulary Indoor Object Grounding with 3D Hierarchical Scene ...

Paper page - Visual Grounding with Multi-modal Conditional Adaptation

An Accuracy Enhanced Vision Language Grounding Method Fused with Gaze ...

A Multi-Source Consistency Domain Adaptation Neural Network MCDANN for ...

(PDF) Multi-level distribution alignment-based domain adaptation for ...

[논문 리뷰] Multi-task Domain Adaptation for Computation Offloading in Edge ...