
Optimise Llm Inference Throughput From First Principles
Optimise LLM Inference Throughput from First Principles
Optimise LLM Inference Throughput from First Principles
Optimise LLM Inference Throughput from First Principles
Optimise LLM Inference Throughput from First Principles
Optimise LLM Inference Throughput from First Principles
Optimise LLM Inference Throughput from First Principles
Optimise LLM Inference Throughput from First Principles
Optimise LLM Inference Throughput from First Principles
Optimise LLM Inference Throughput from First Principles

Continuous Batching: Optimizing LLM Inference Throughput from First ...
Advertisement Space (300x250)
LLM Inference Economics from First Principles

LLM Inference Economics from First Principles
LLM Inference Economics from First Principles
LLM Inference Optimization Overview - From Data to System Architecture ...
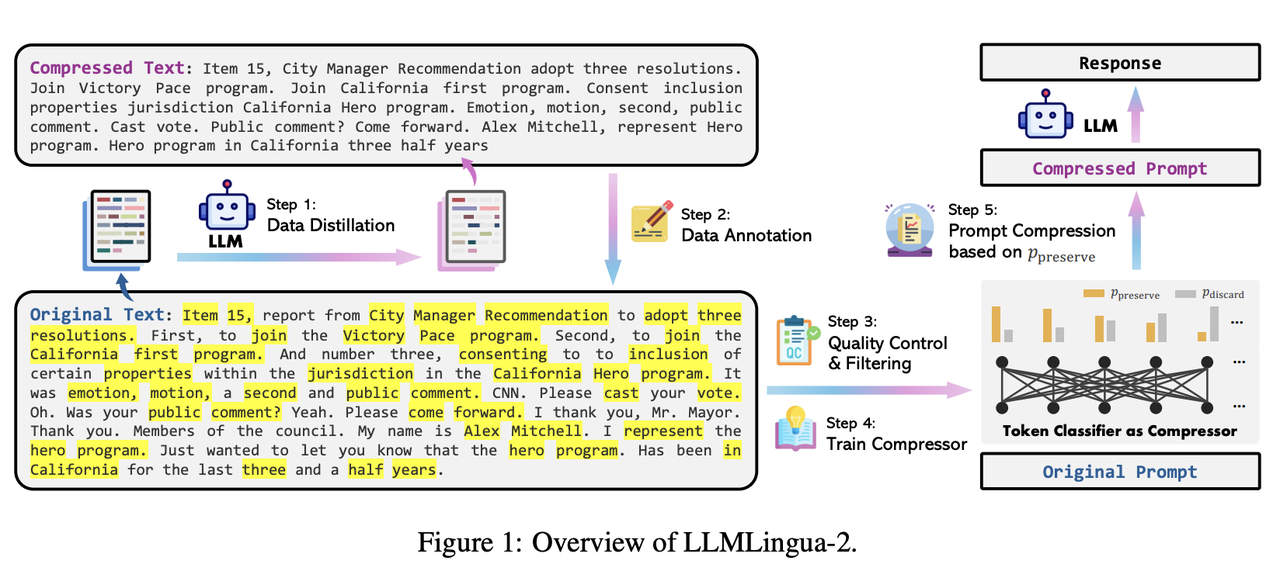
LLM Inference Optimization Overview - From Data to System Architecture ...
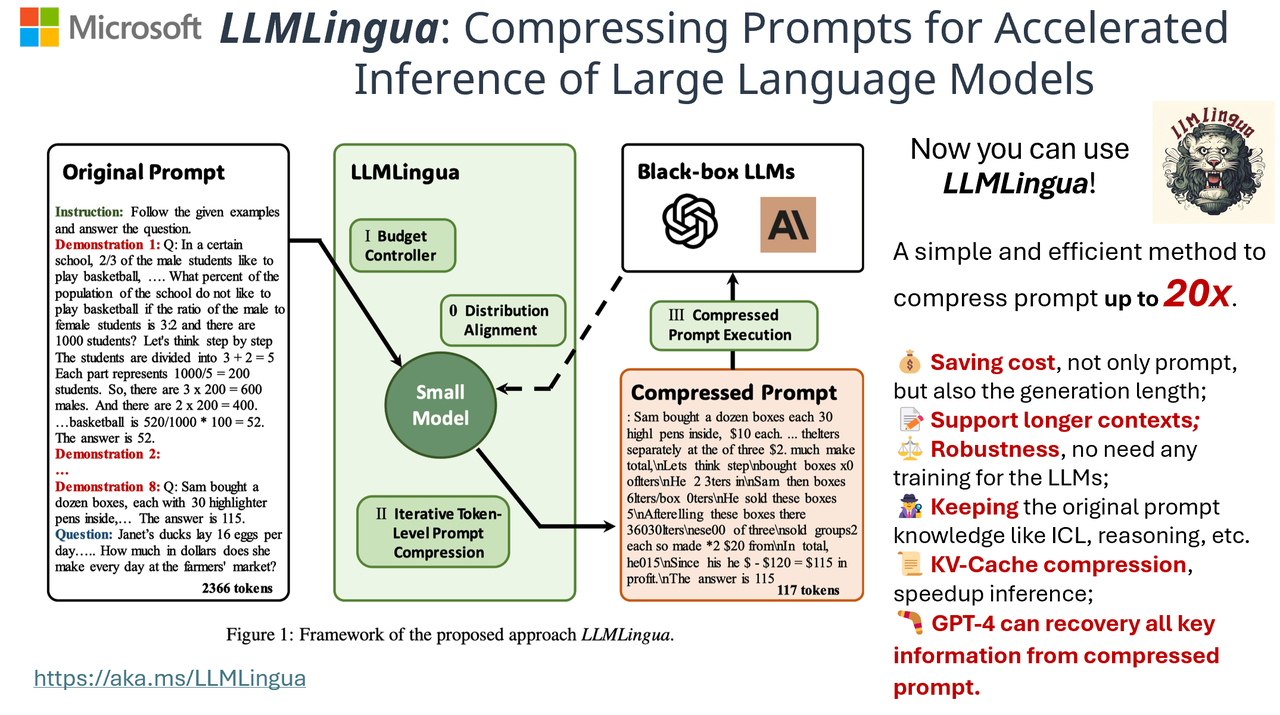
LLM Inference Optimization Overview - From Data to System Architecture ...
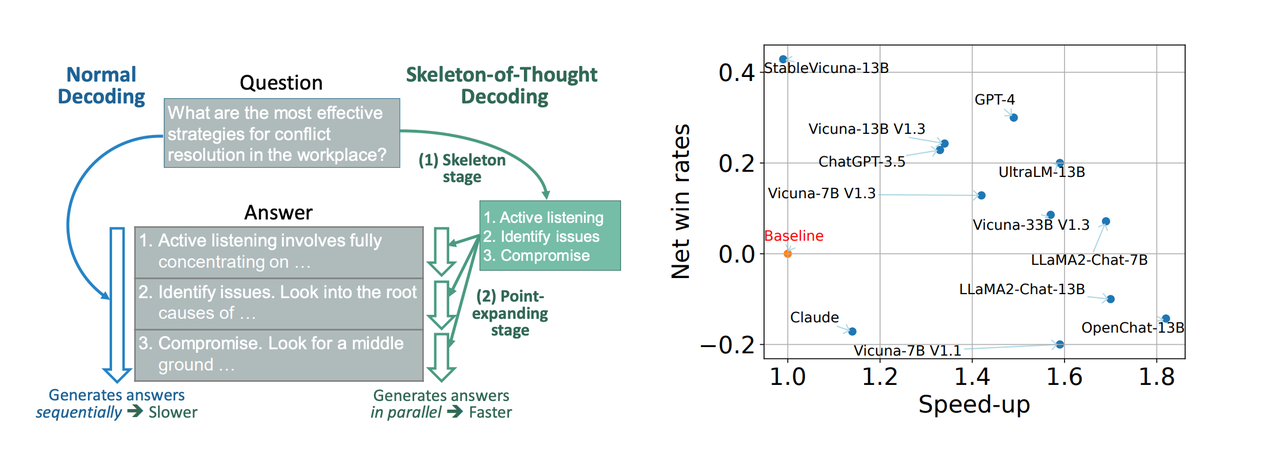
LLM Inference Optimization Overview - From Data to System Architecture ...
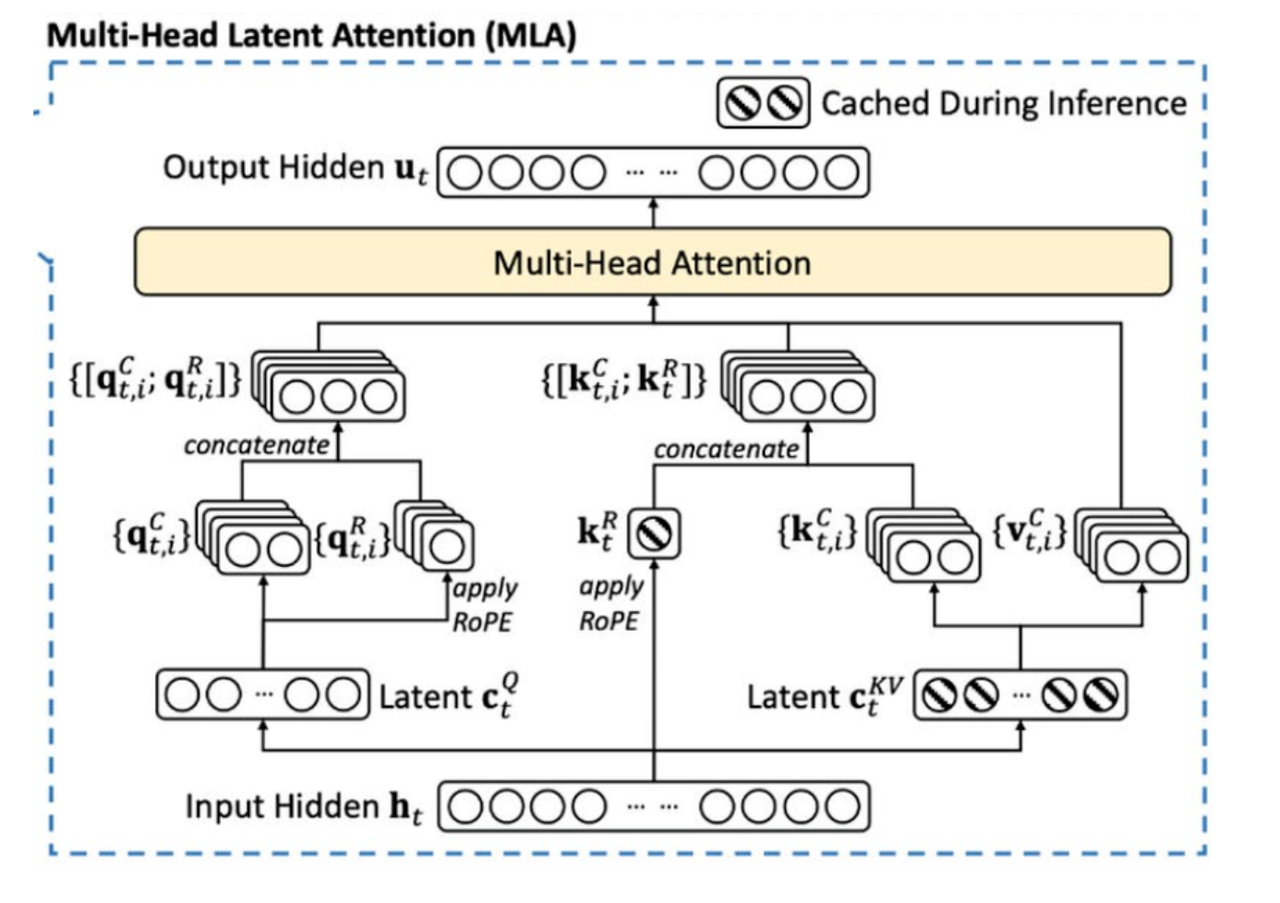
LLM Inference Optimization Overview - From Data to System Architecture ...
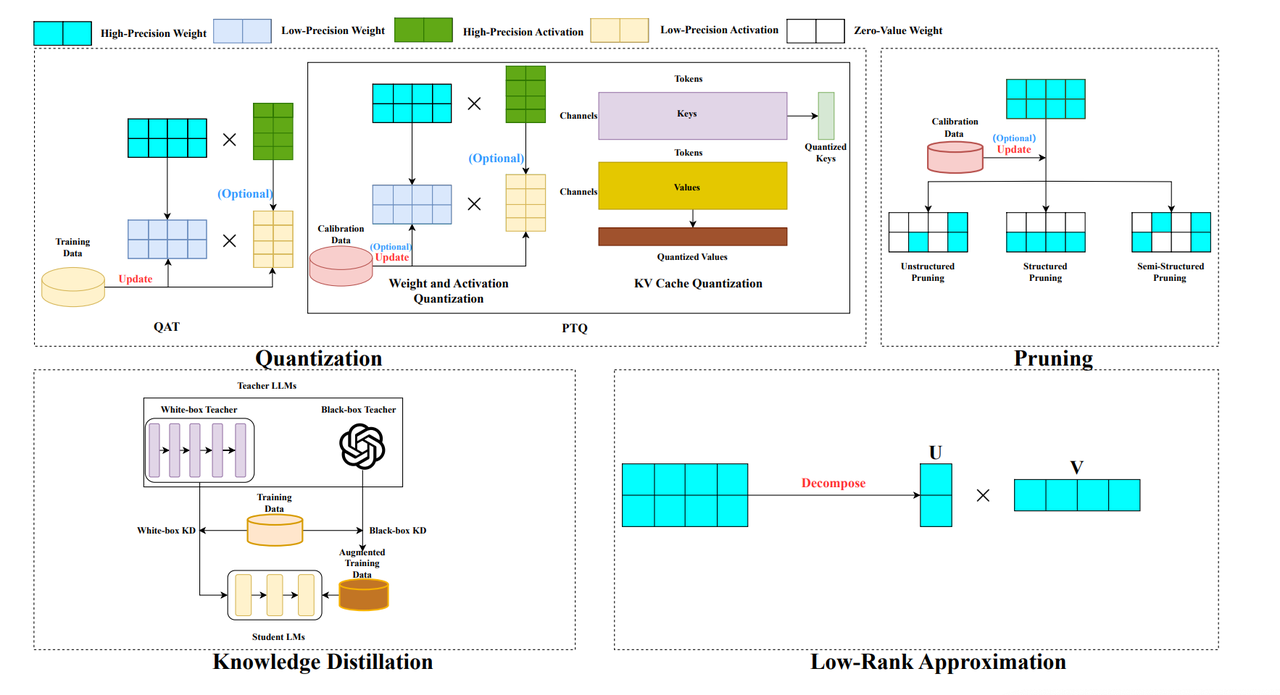
LLM Inference Optimization Overview - From Data to System Architecture ...
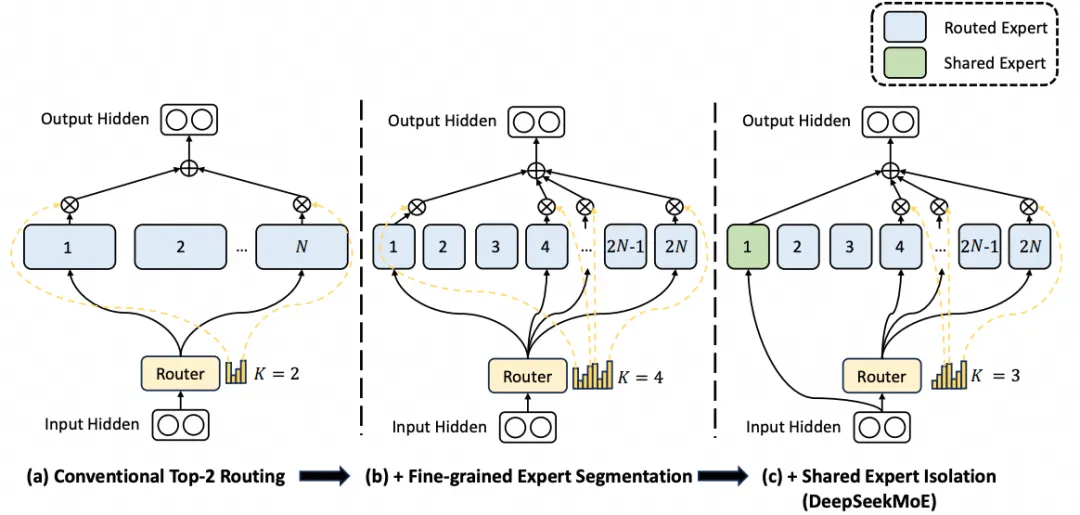
LLM Inference Optimization Overview - From Data to System Architecture ...
Advertisement Space (336x280)
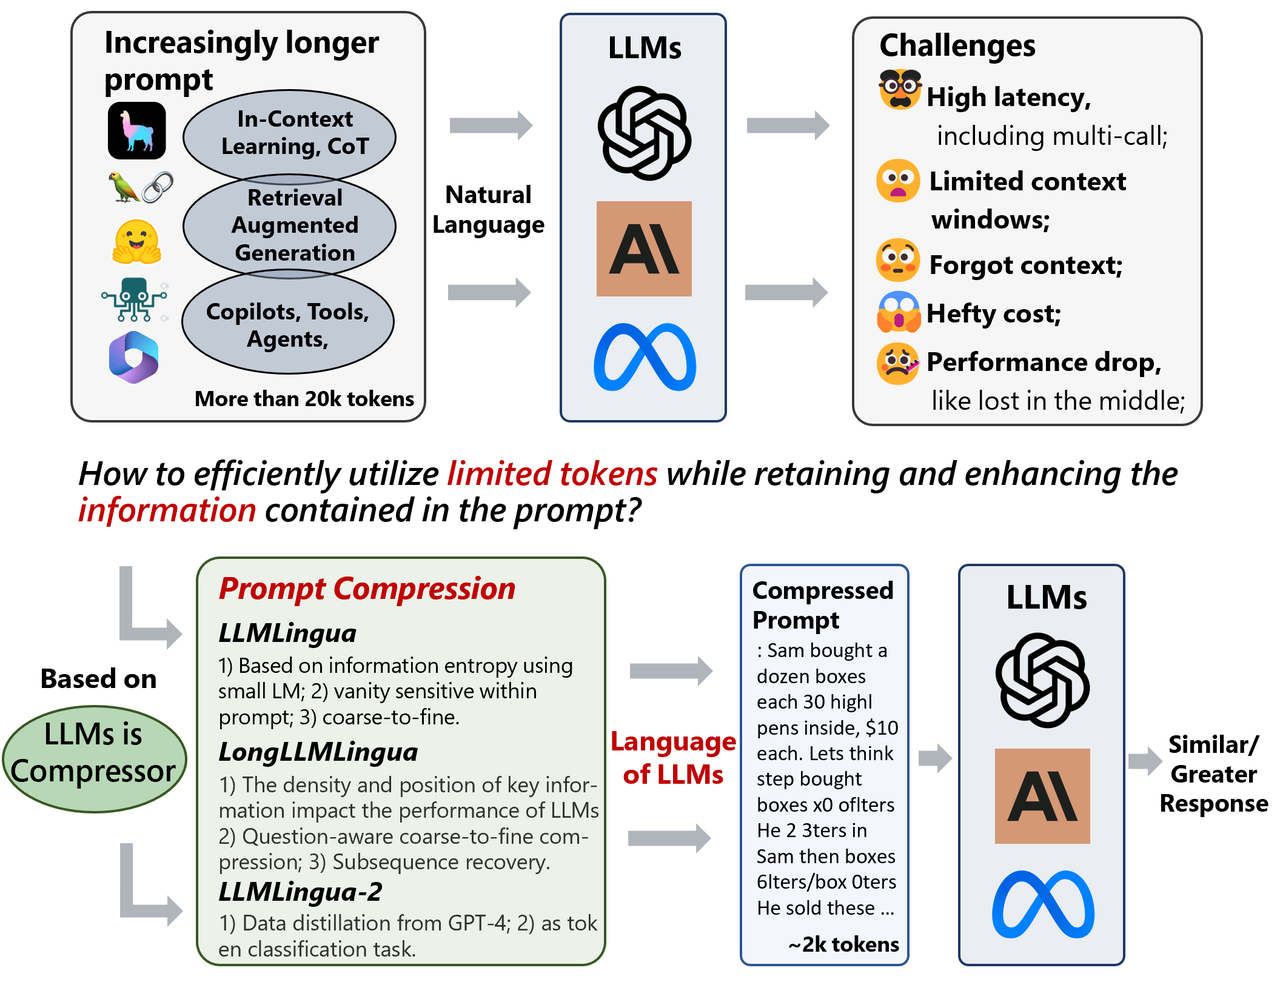
LLM Inference Optimization Overview - From Data to System Architecture ...

LLM Inference Optimization Overview - From Data to System Architecture
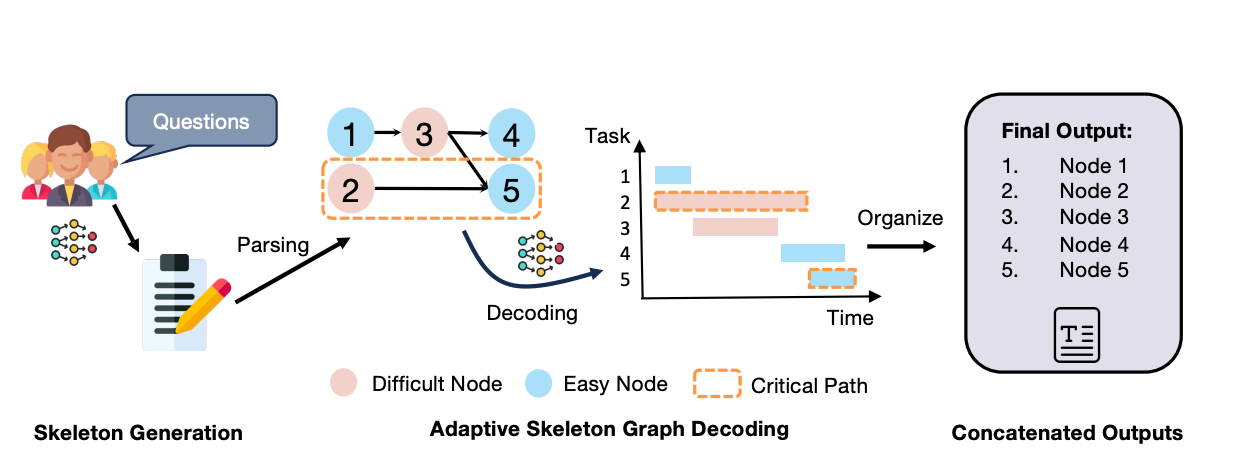
LLM Inference Optimization Overview - From Data to System Architecture ...

LLM Inference Optimization Overview - From Data to System Architecture ...

How continuous batching enables 23x throughput in LLM inference ...
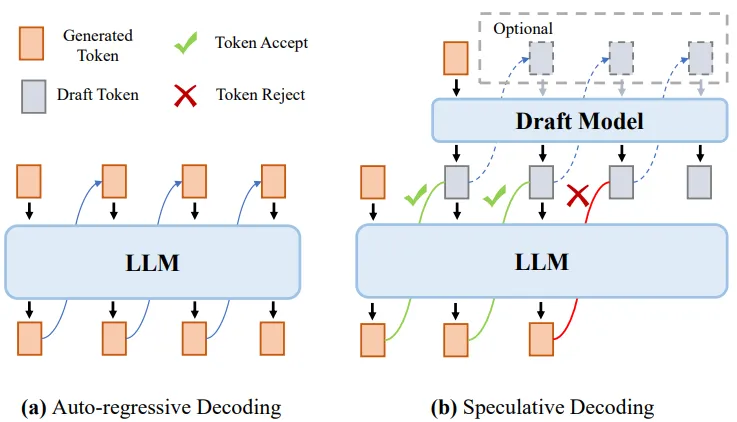
LLM Inference Optimization Overview - From Data to System Architecture ...

[2503.05248] Optimizing LLM Inference Throughput via Memory-aware and ...

LLM Inference Optimization Overview - From Data to System Architecture ...
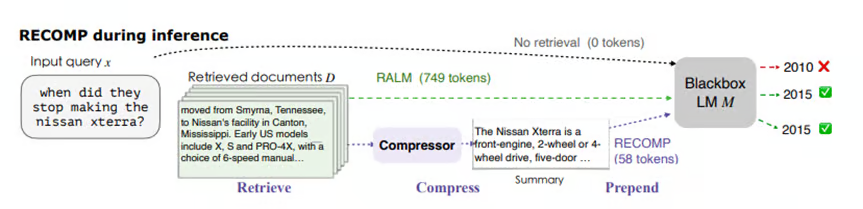
LLM Inference Optimization Overview - From Data to System Architecture ...
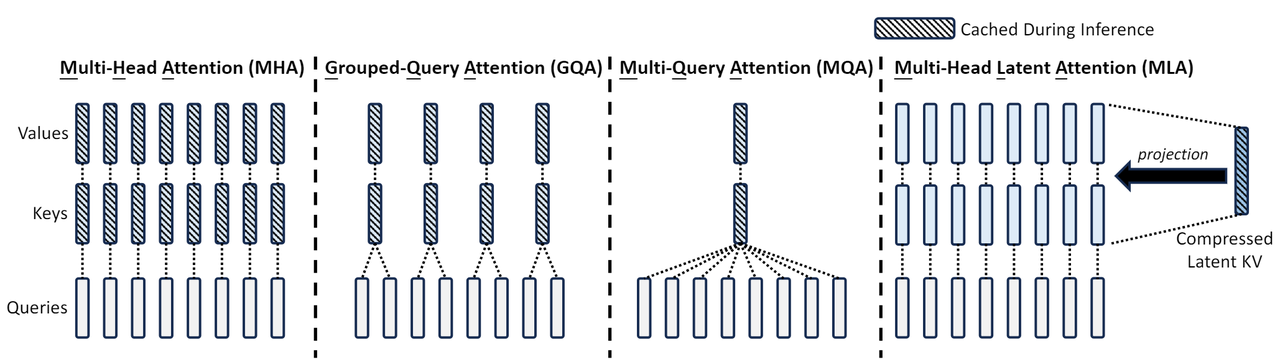
LLM Inference Optimization Overview - From Data to System Architecture ...
Advertisement Space (336x280)

The LLM Inference Pipeline: From Text to Embeddings and the Power of RAG
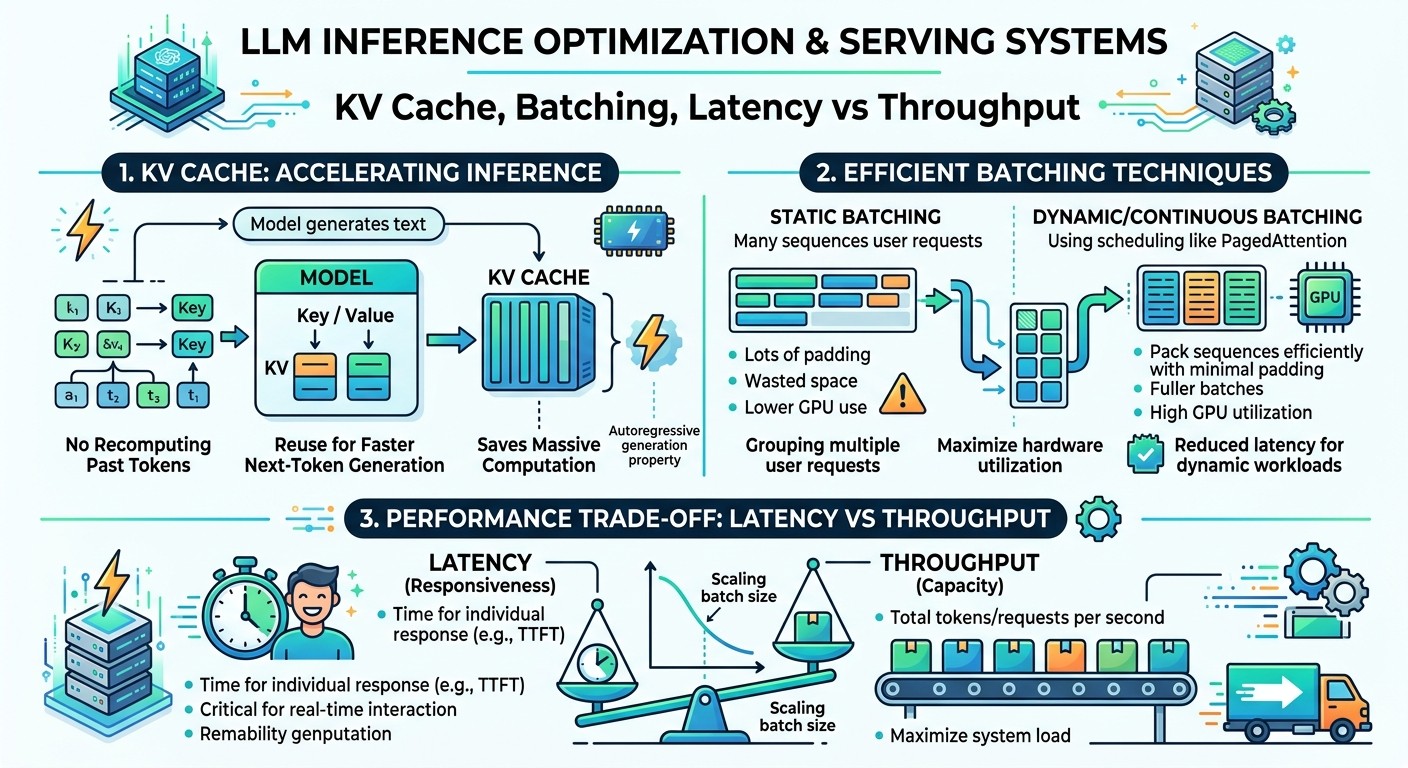
LLM Inference Optimization & Serving Systems – Billion Hopes

LLM Inference Optimization Production Guide 2026 | Iterathon
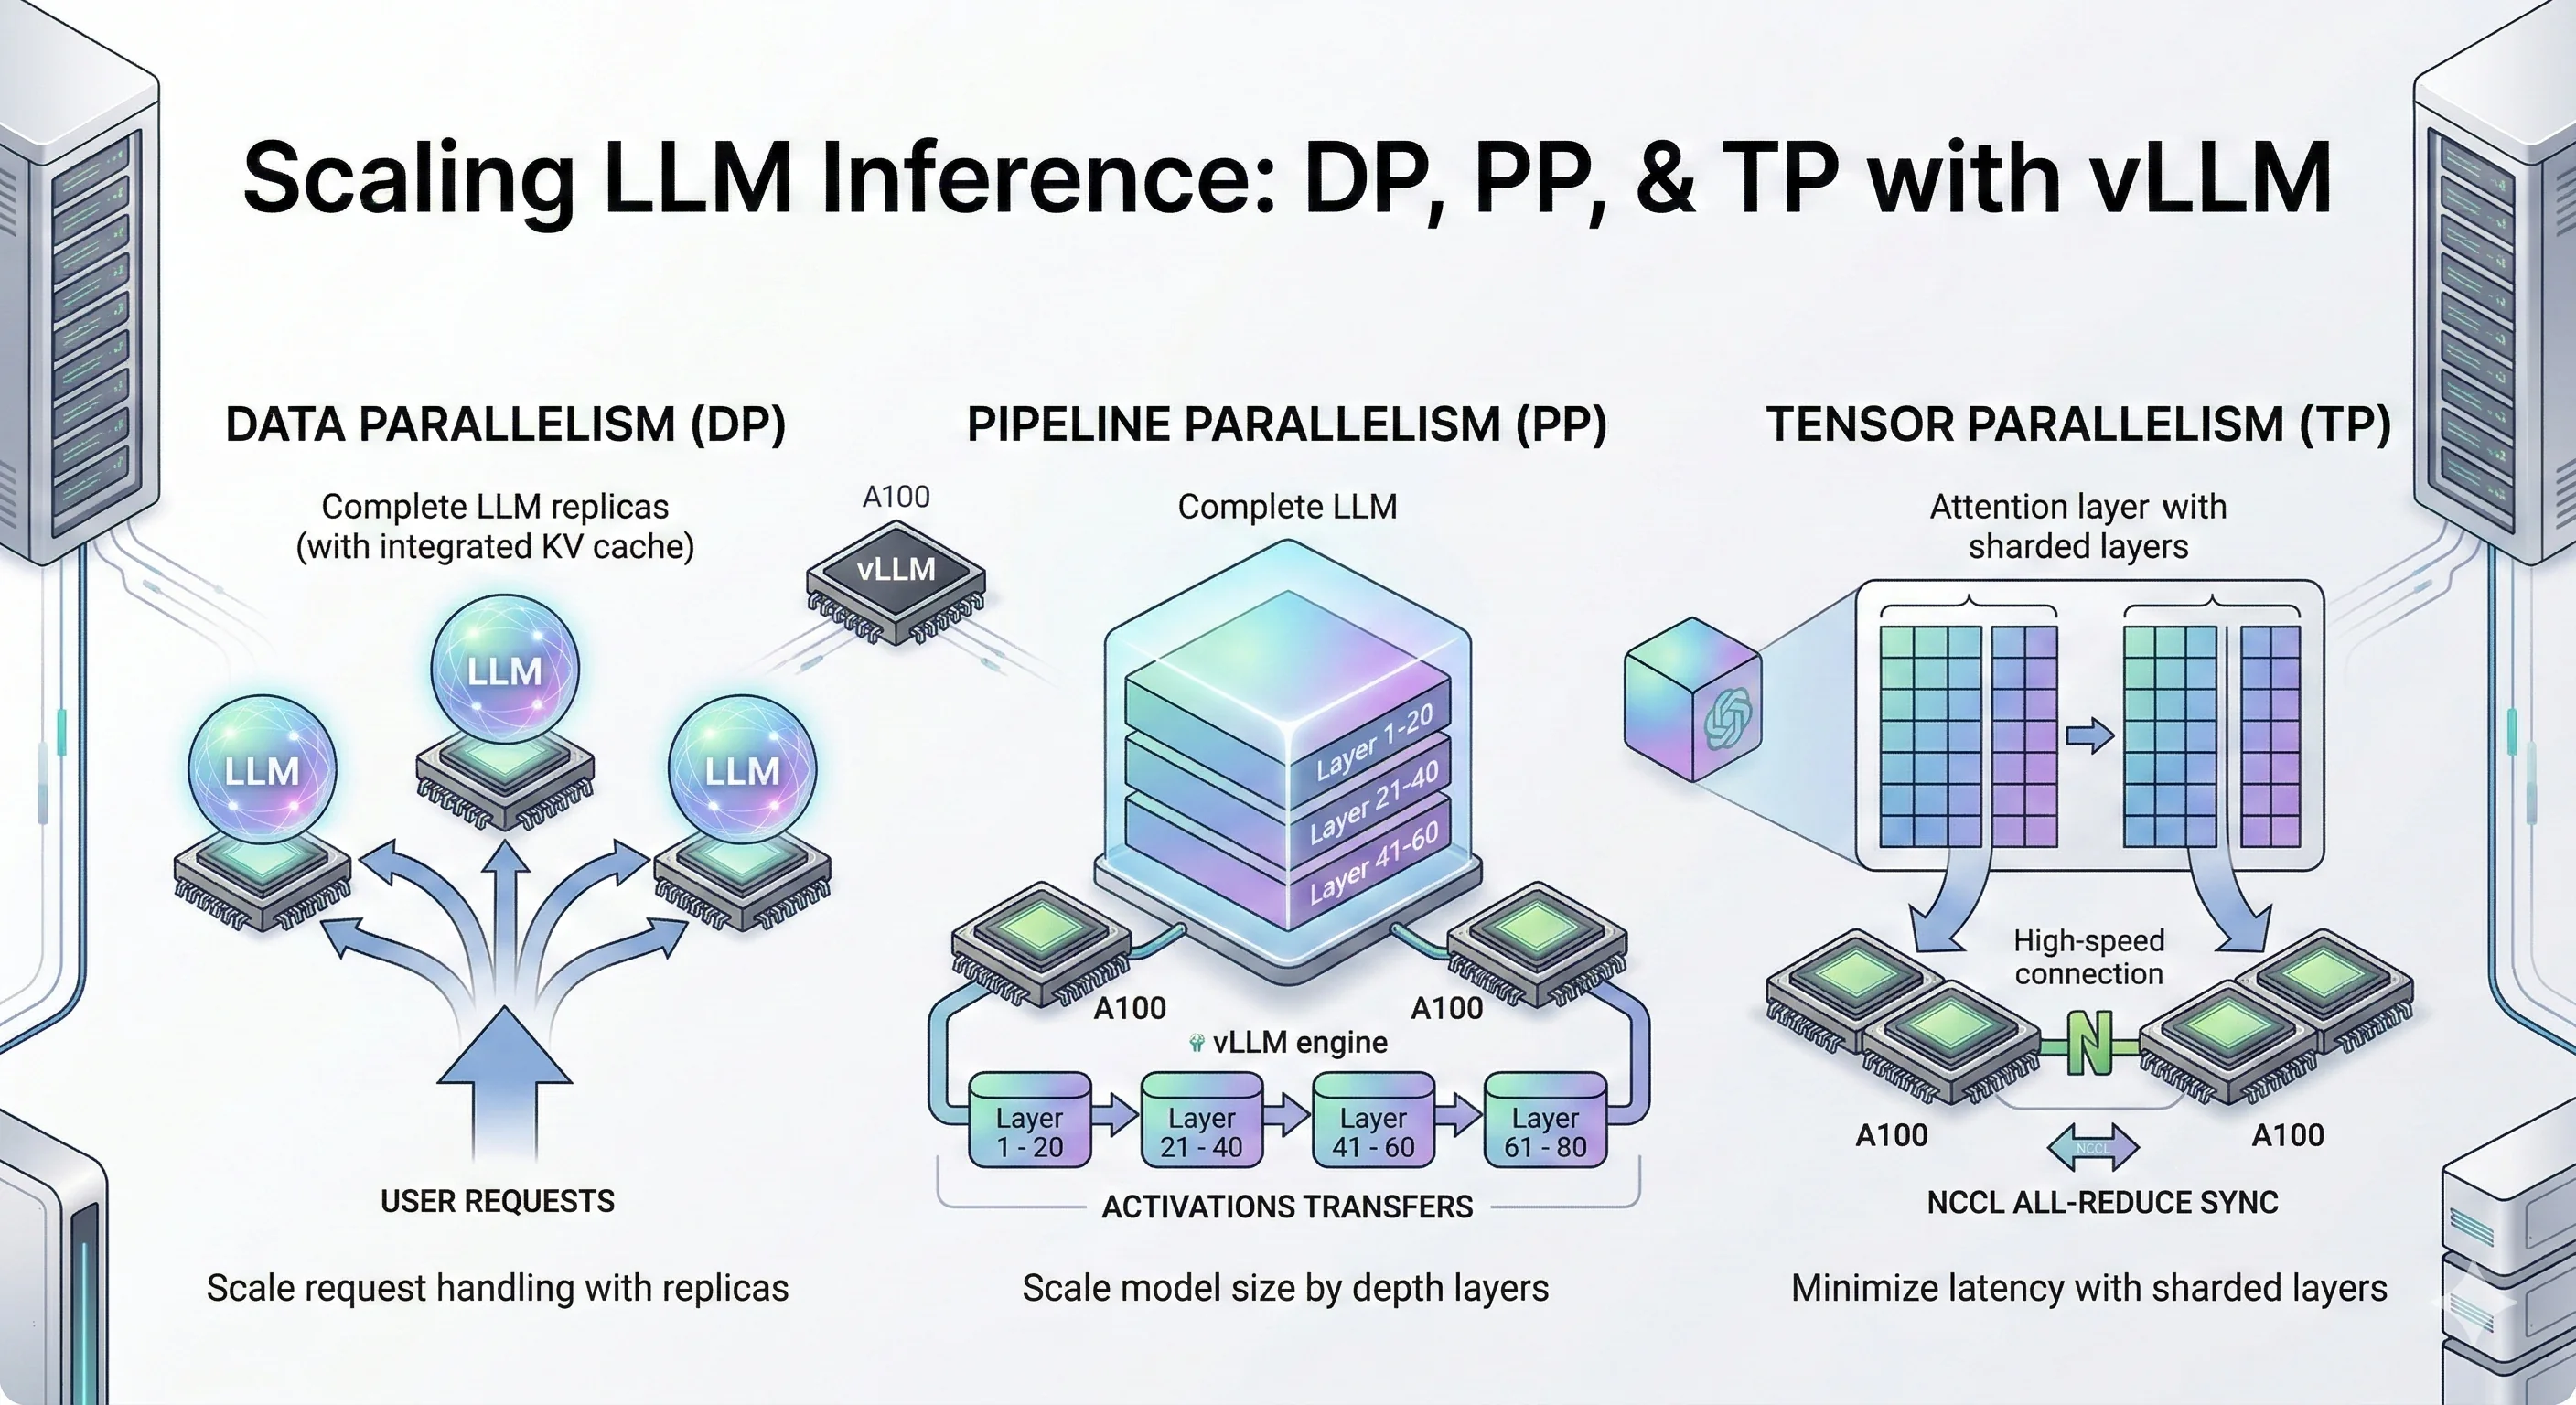
Speculative Decoding in vLLM: Complete Guide to Faster LLM Inference ...
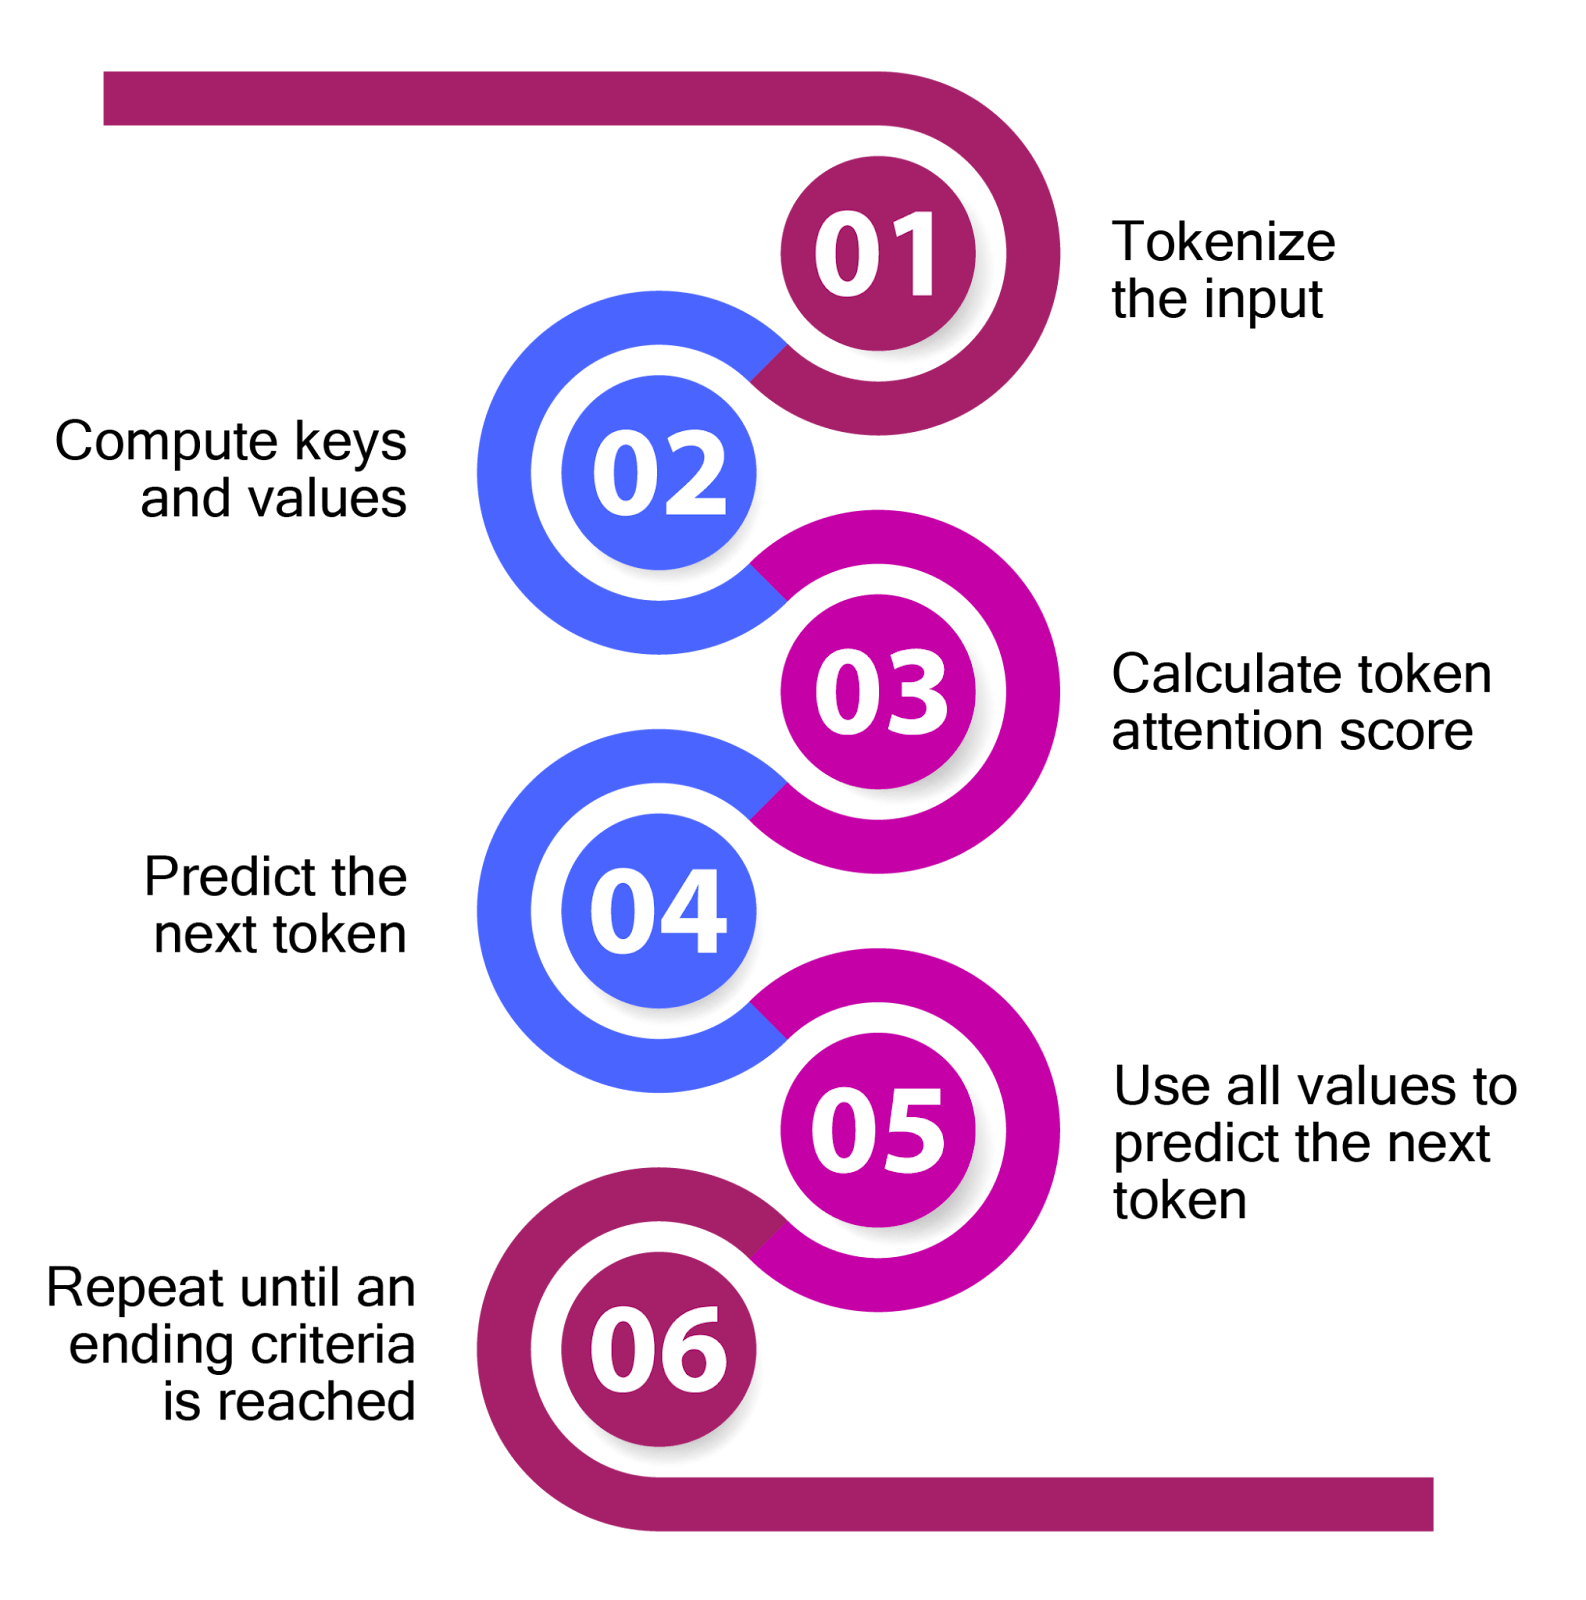
LLM inference optimization: Tutorial & Best Practices | LaunchDarkly
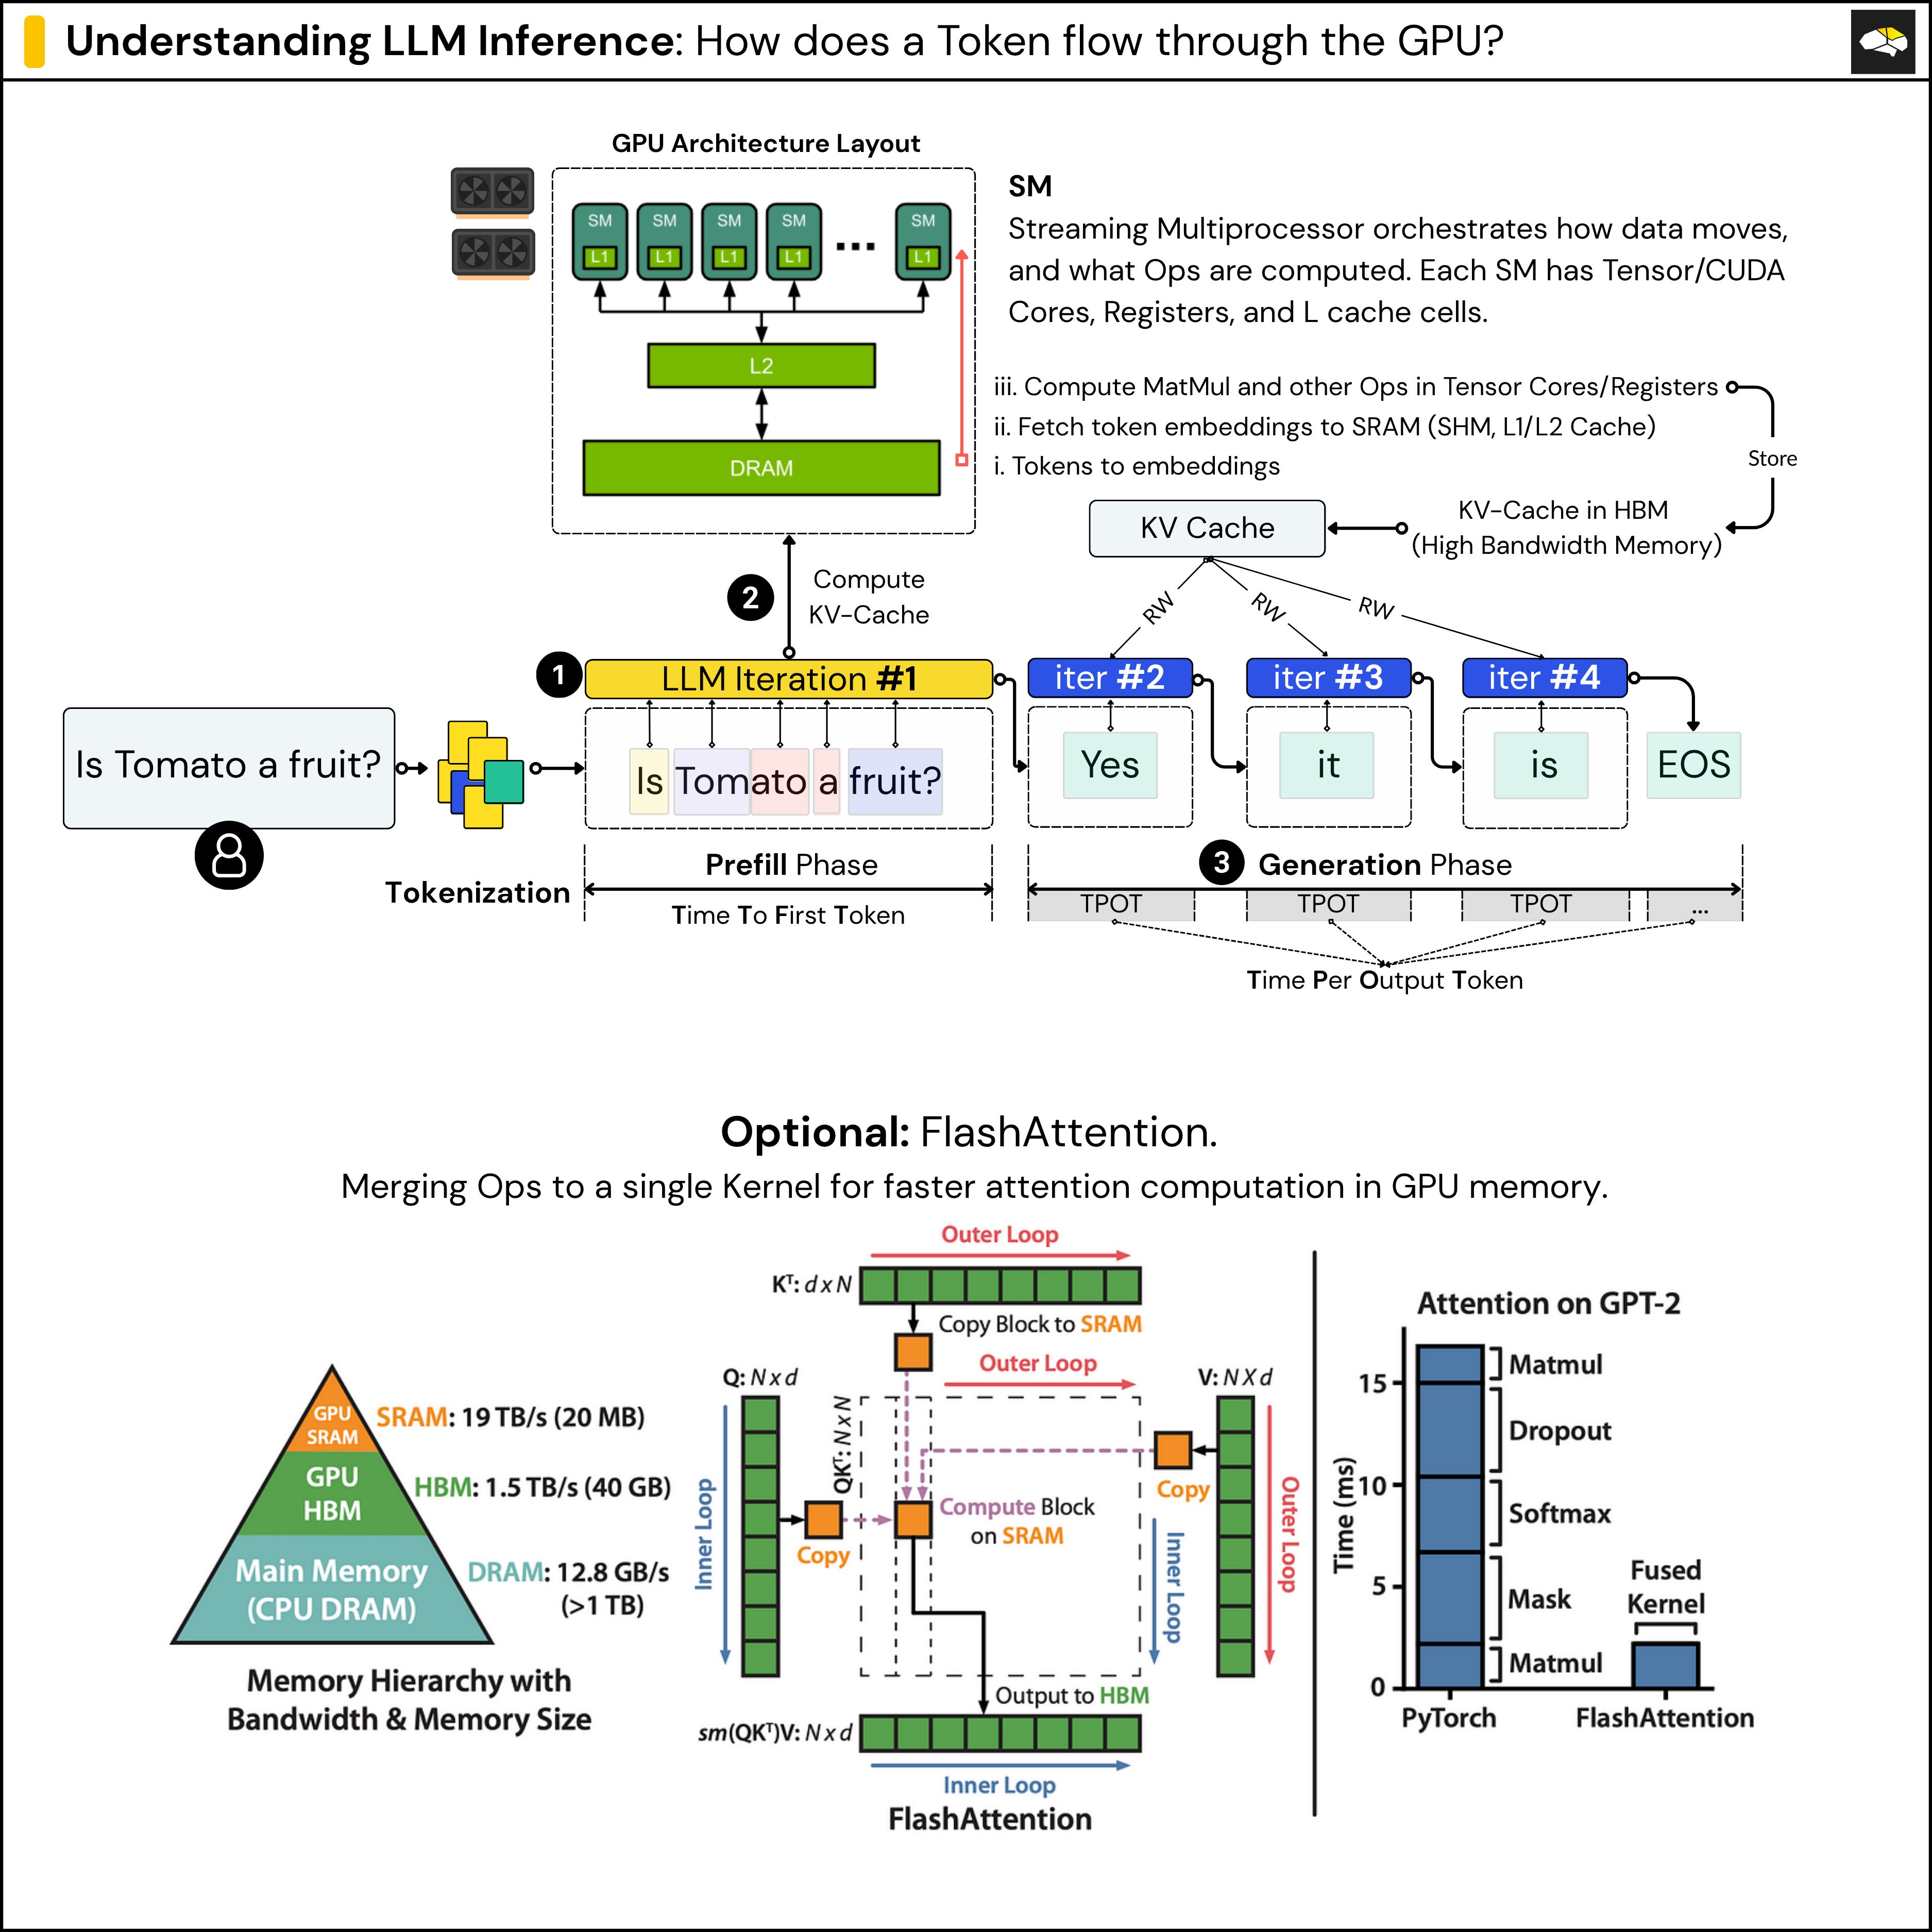
Understanding LLM Inference - by Alex Razvant