
Outliertune Efficient Channel Wise Quantization For Large Language
OutlierTune: Efficient Channel-Wise Quantization for Large Language ...

OutlierTune: Efficient Channel-Wise Quantization for Large Language ...

Free Video: Quantization Techniques for Efficient Large Language Model ...
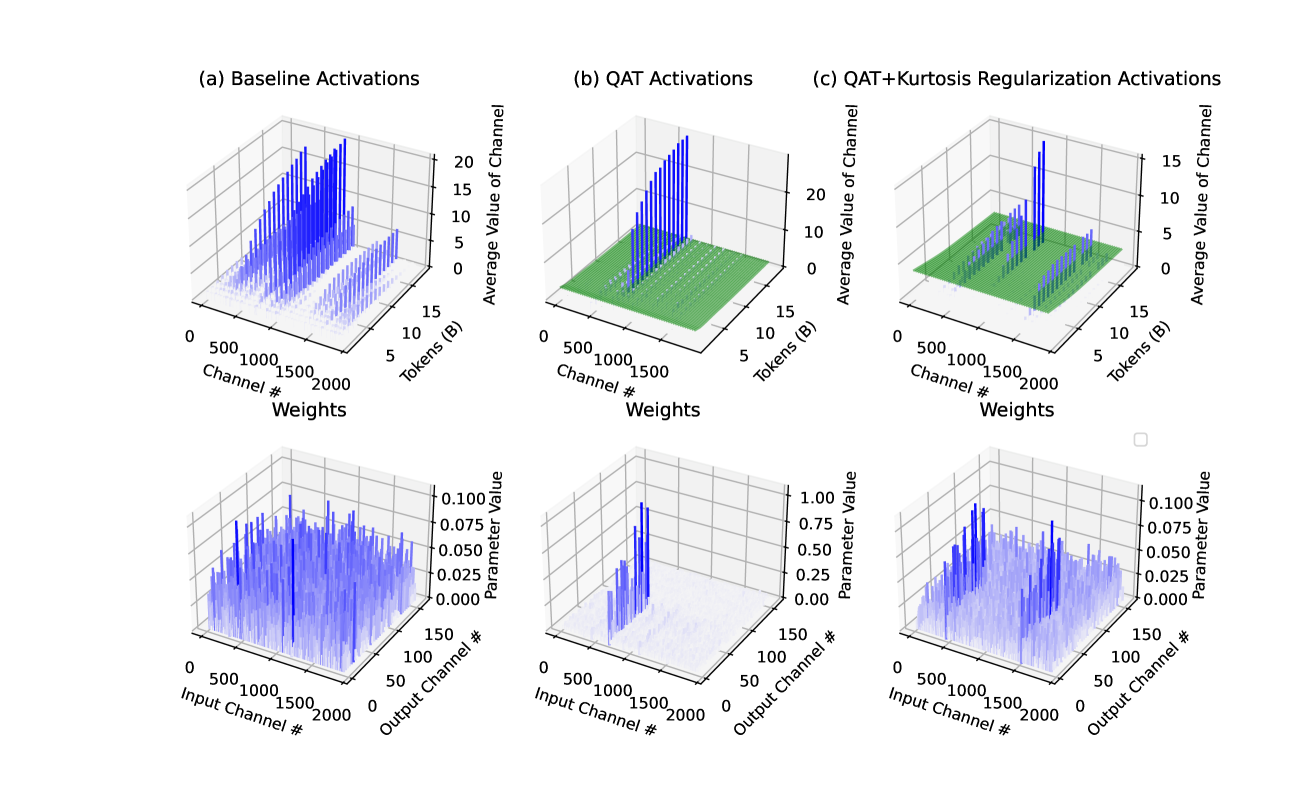
Figure 1 from OOQ: Outlier-Oriented Quantization for Efficient Large ...

[论文评述] Channel-Wise Mixed-Precision Quantization for Large Language Models
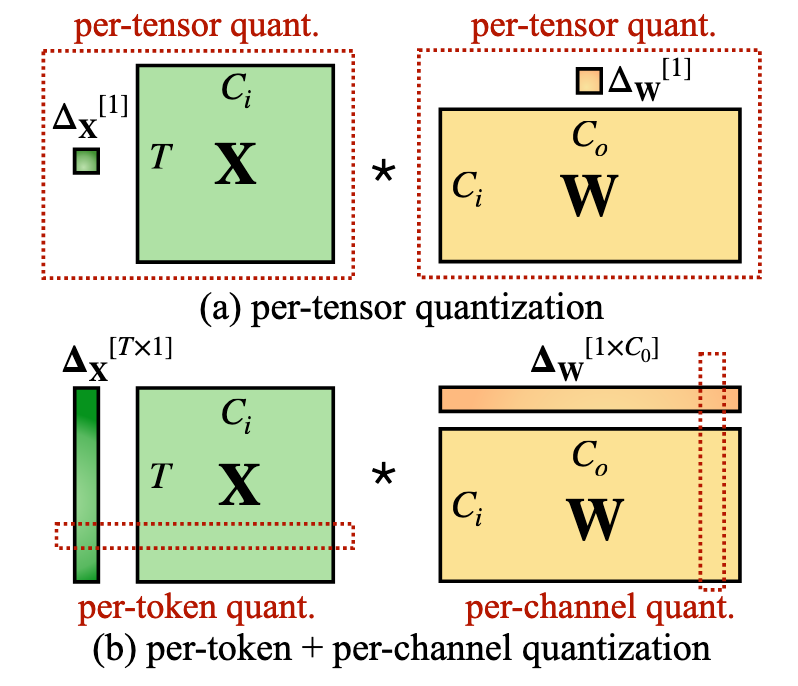
SmoothQuant Accurate and Efficient Post-Training Quantization for Large ...

OmniQuant: Omnidirectionally Calibrated Quantization for Large Language ...
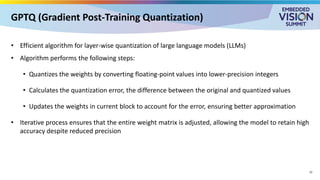
“Quantization Techniques for Efficient Deployment of Large Language ...
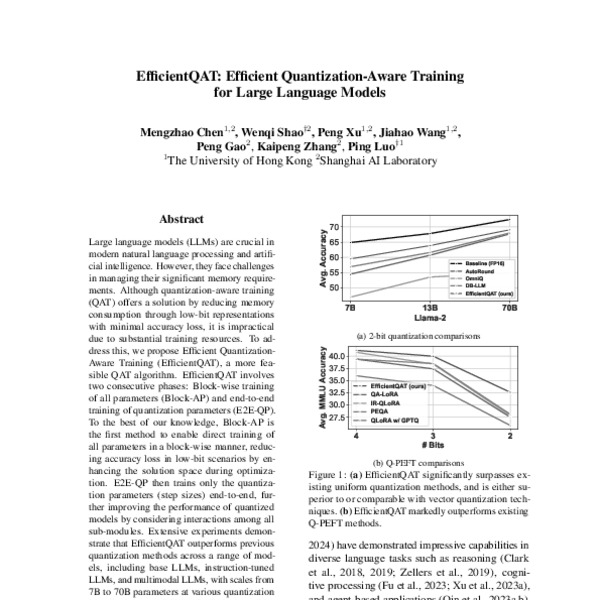
EfficientQAT: Efficient Quantization-Aware Training for Large Language ...
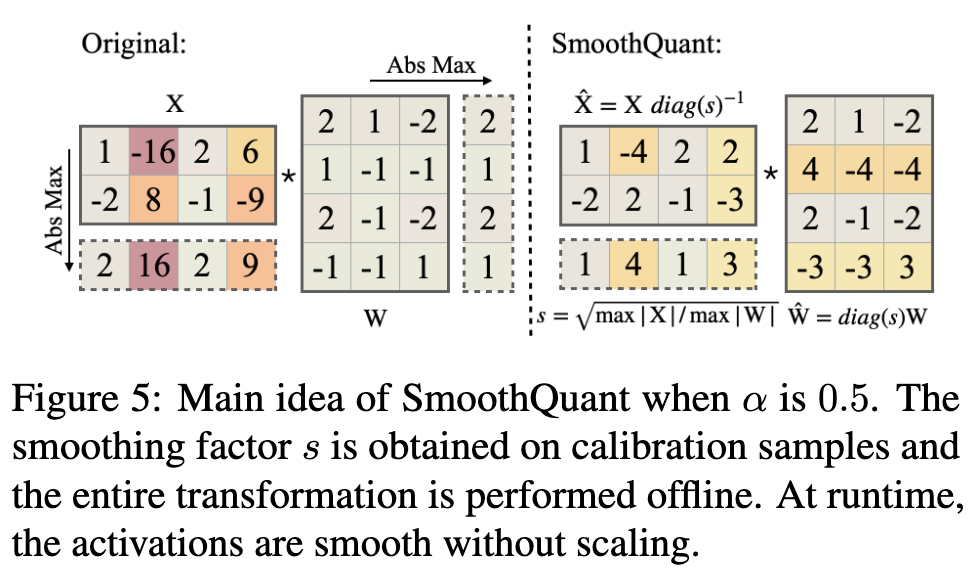
SmoothQuant Accurate and Efficient Post-Training Quantization for Large ...
Advertisement Space (300x250)
“Quantization Techniques for Efficient Deployment of Large Language ...
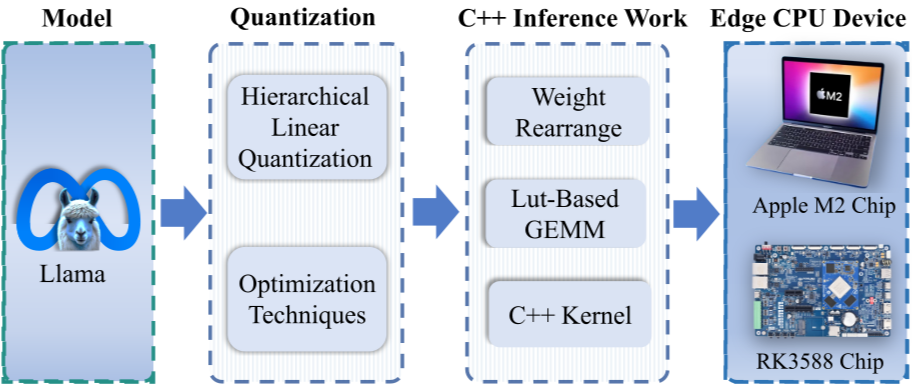
[논문 리뷰] ELUTQ: Efficient LUT-Aware Quantization for Deploying Large ...
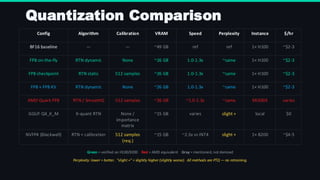
Advanced Quantization Techniques for Large Language Models in 2026 | PDF

Paper page - BAQ: Efficient Bit Allocation Quantization for Large ...

Fine-Grained Post-Training Quantization for Large Vision Language ...
Microscaling Quantization for Large Language Models — AI Post Transformers
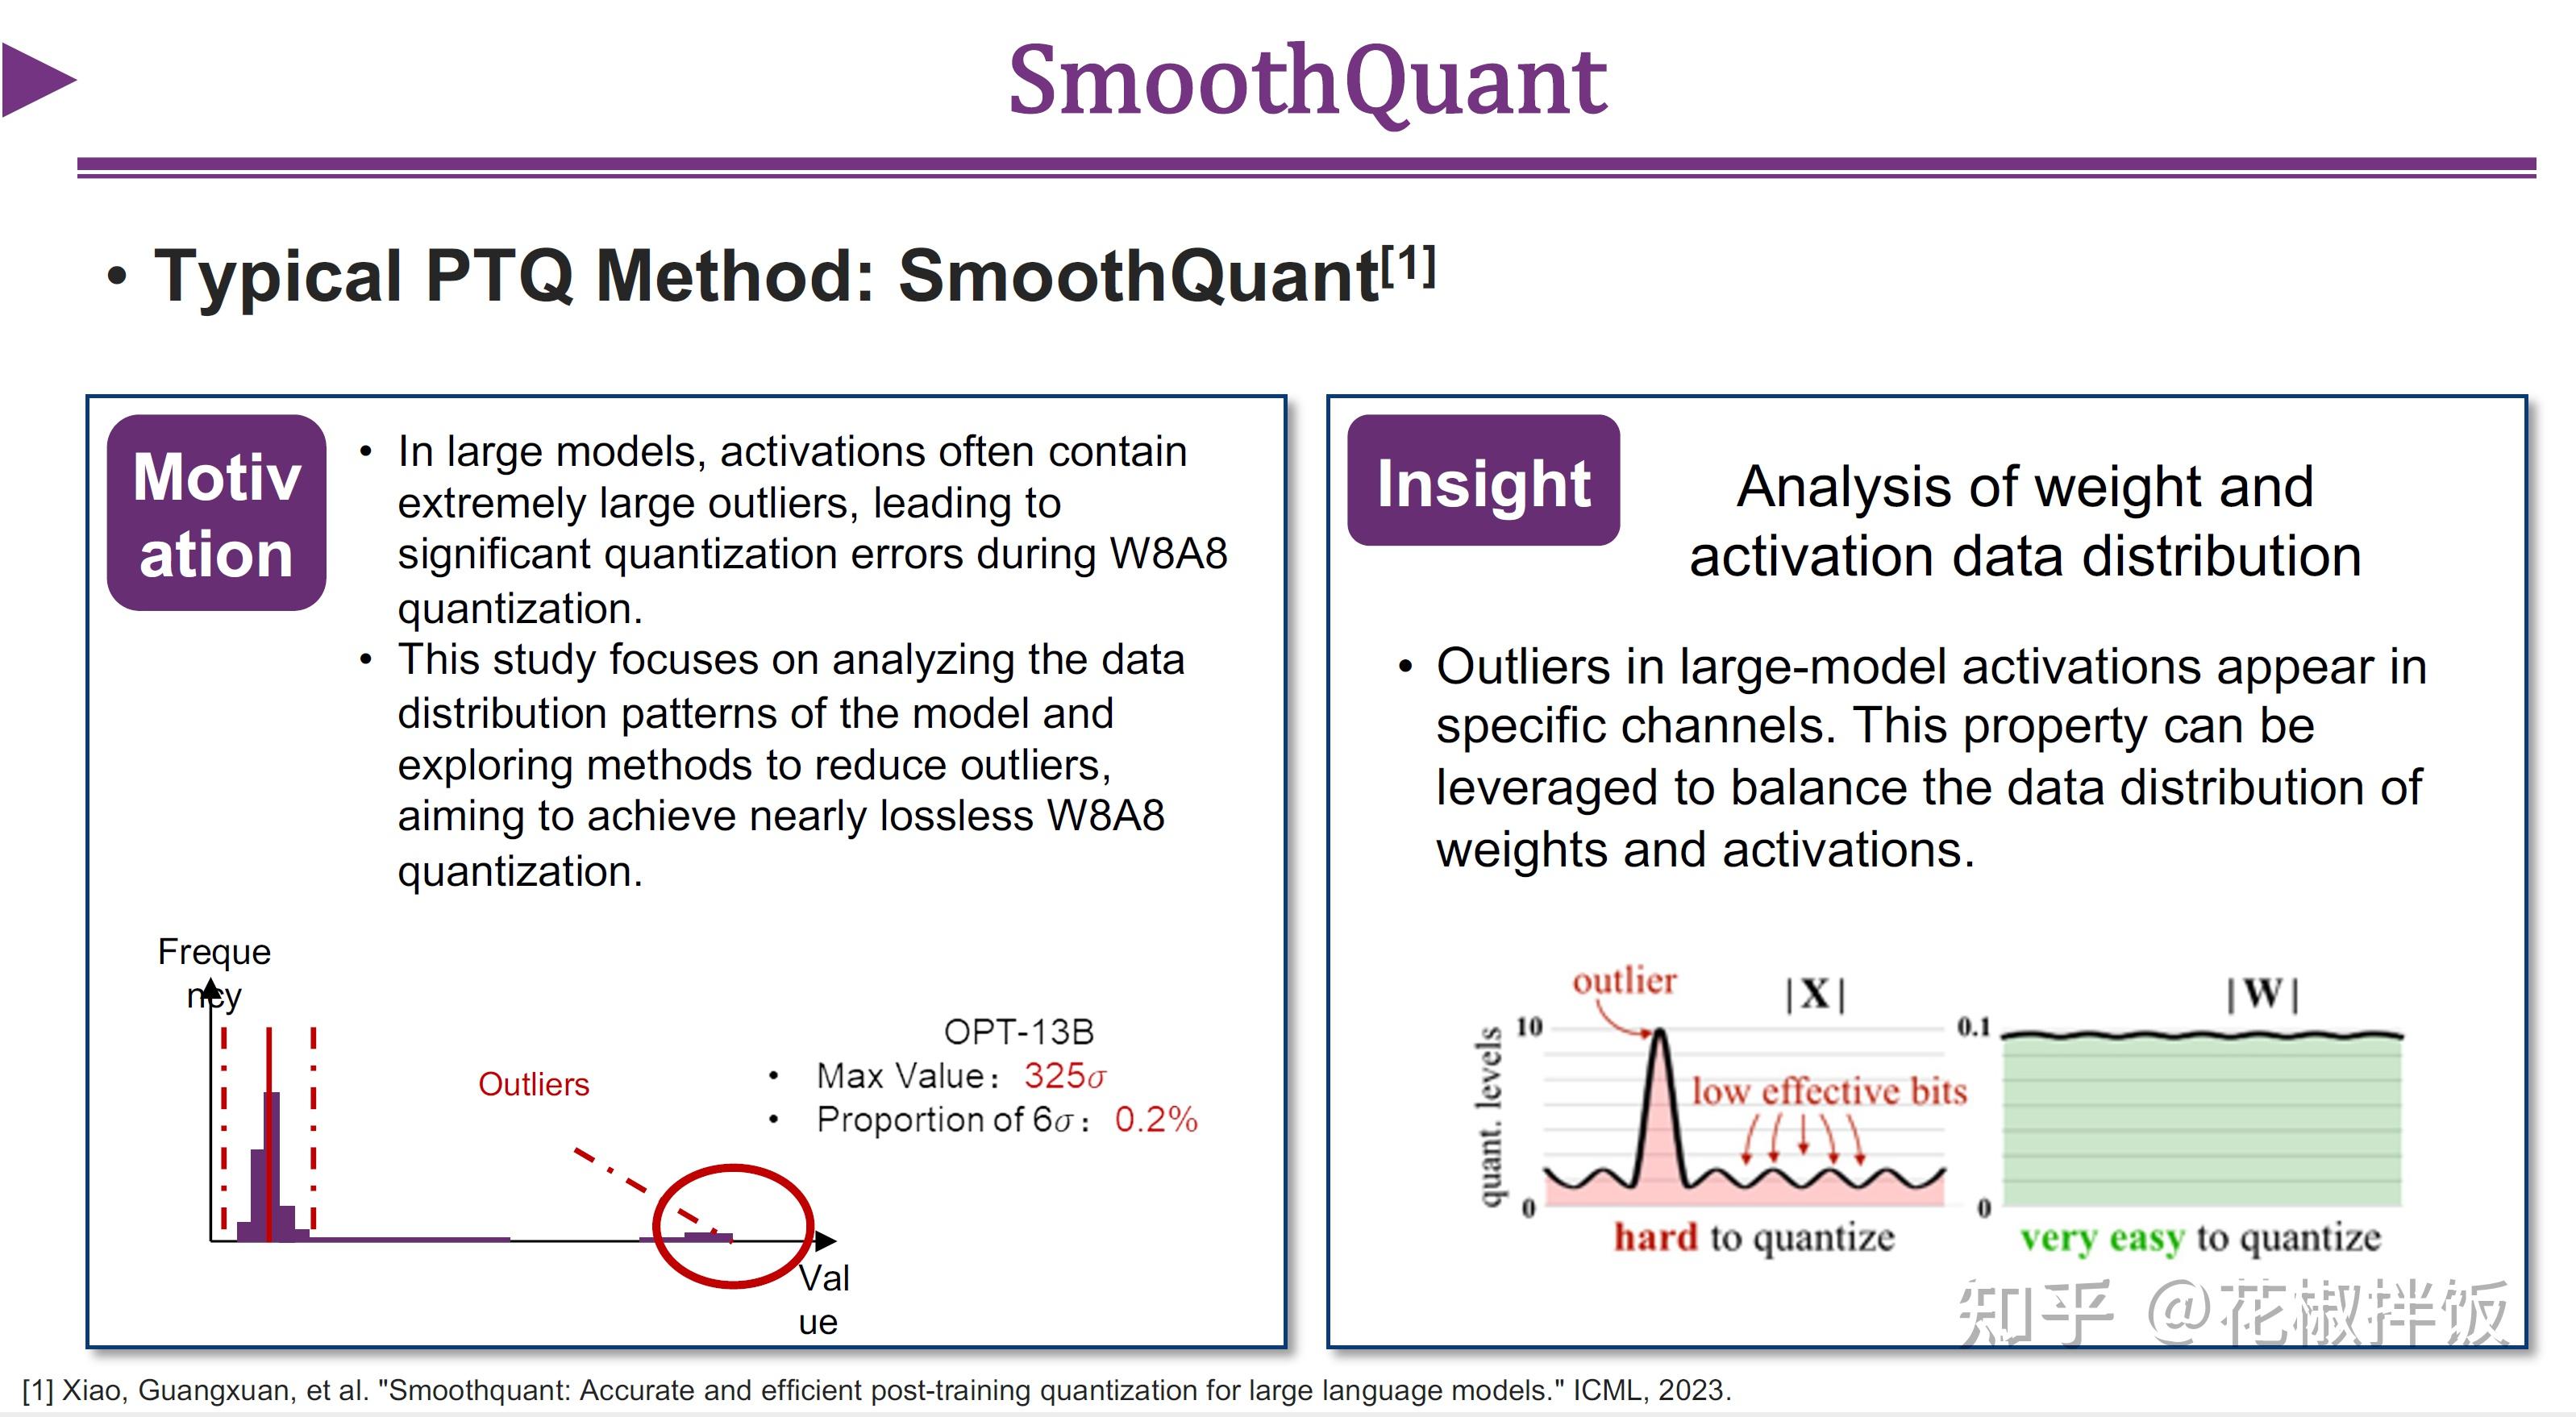
Efficient Inference for Large Language Models – Algorithm, Model, and ...
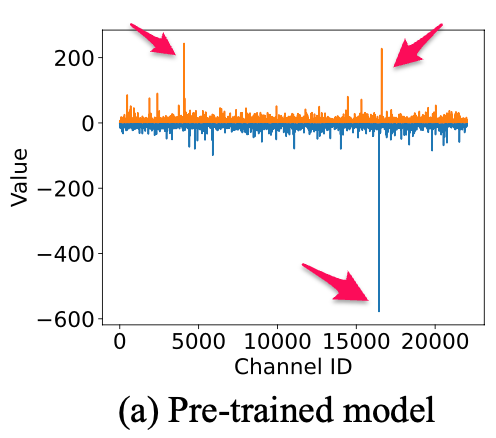
QLLM: ACCURATE AND EFFICIENT LOW-BITWIDTH QUANTIZATION FOR LARGE ...
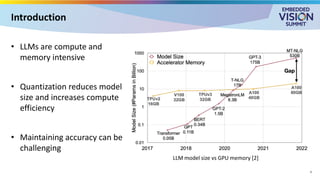
“Quantization Techniques for Efficient Deployment of Large Language ...

Table 1 from OWQ: Outlier-Aware Weight Quantization for Efficient Fine ...
Advertisement Space (336x280)
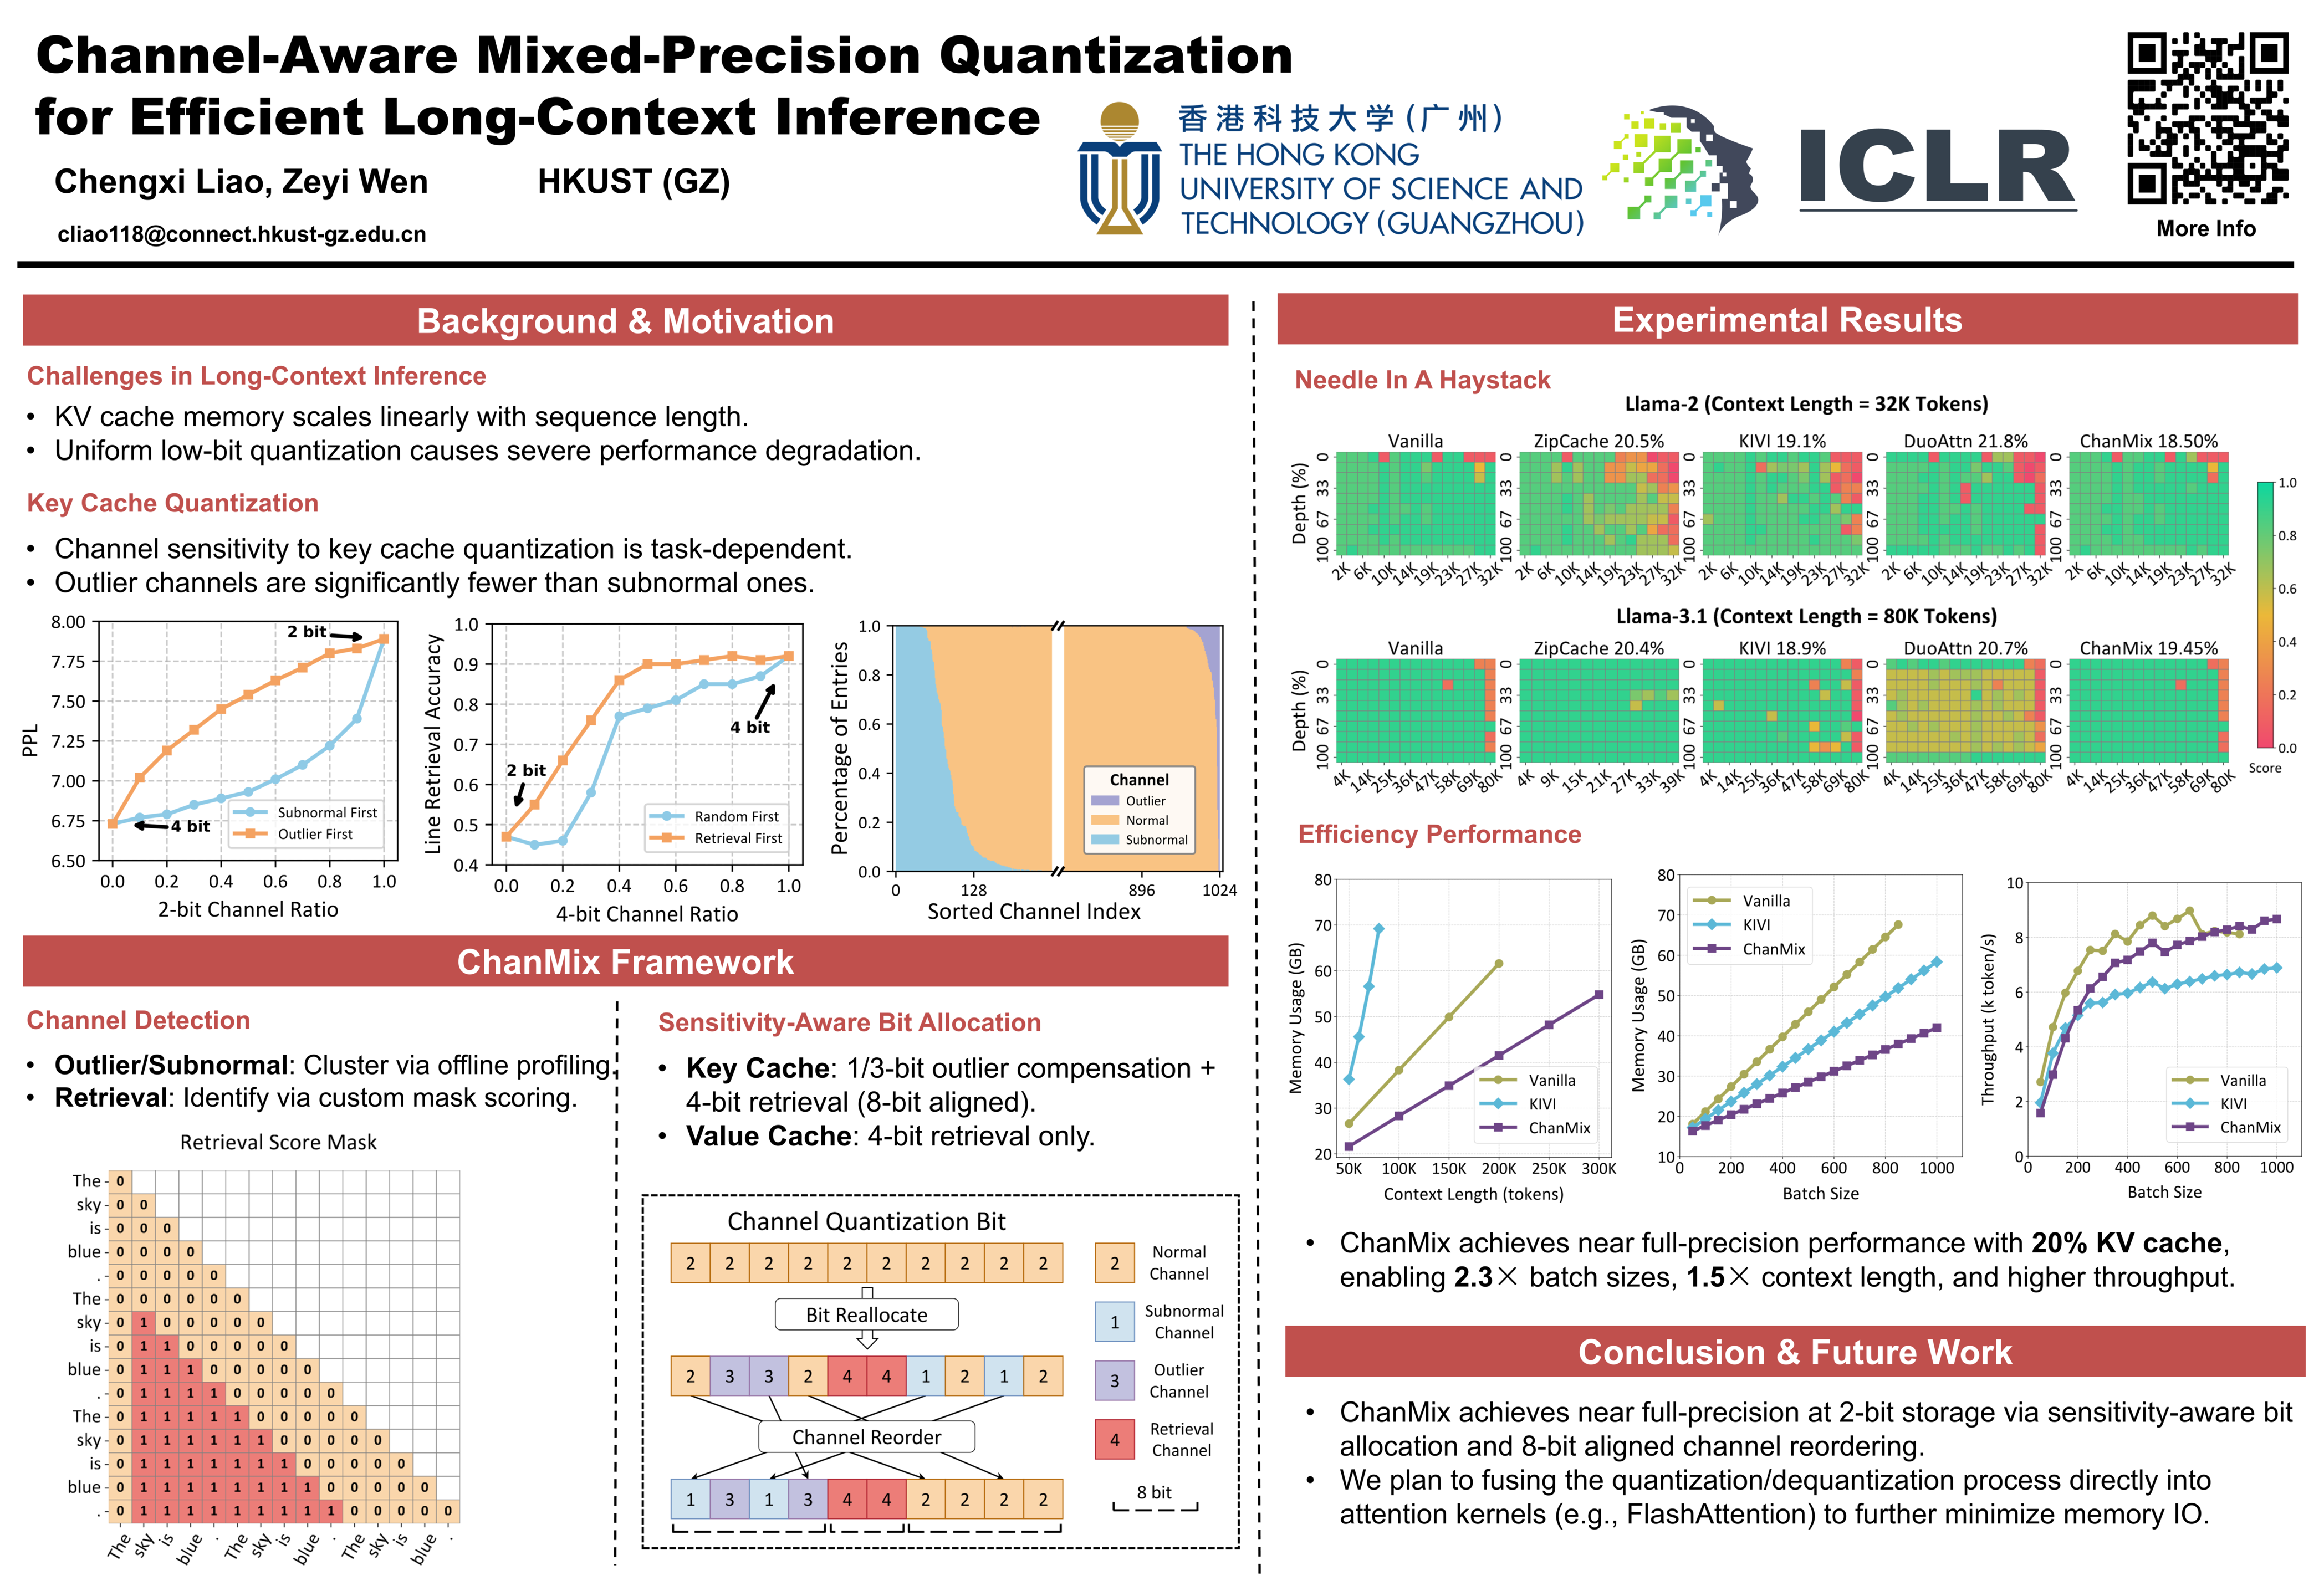
ICLR Poster Channel-Aware Mixed-Precision Quantization for Efficient ...

SmoothQuant: Accurate and Efficient Post-Training Quantization for ...

Dual Grained Quantization: Efficient Fine-Grained Quantization for LLM

(PDF) KV Cache is 1 Bit Per Channel: Efficient Large Language Model ...

[2103.13630] A Survey of Quantization Methods for Efficient Neural ...

MergeQuant: Accurate 4-bit Static Quantization of Large Language Models ...

Paper page - OWQ: Outlier-Aware Weight Quantization for Efficient Fine ...

KV Cache is 1 Bit Per Channel: Efficient Large Language Model Inference ...
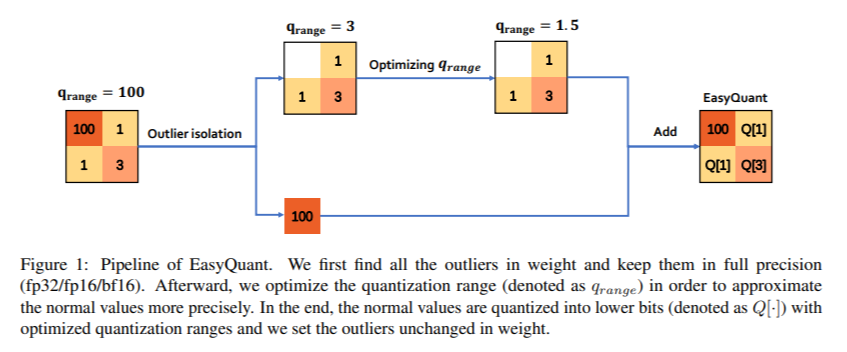
EasyQuant: Revolutionizing Large Language Model Quantization with ...
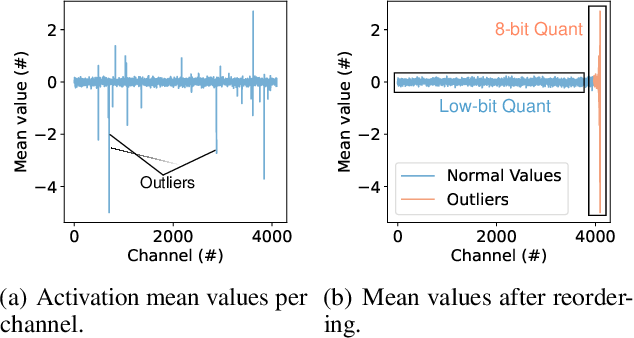
Figure 1 from Atom: Low-bit Quantization for Efficient and Accurate LLM ...
Advertisement Space (336x280)

(PDF) QuantEase: Optimization-based Quantization for Language Models ...
OWQ: Outlier-Aware Weight Quantization for Efficient Fine-Tuning and ...

SmoothQuant: Accurate and Efficient Post-Training Quantization for ...

Paper page - QuIP: 2-Bit Quantization of Large Language Models With ...

(PDF) Advancing Multimodal Large Language Models with Quantization ...

Dual Grained Quantization: Efficient Fine-Grained Quantization for LLM