
Paper Page A Function Interpretation Benchmark For Evaluating

Paper page - A Function Interpretation Benchmark for Evaluating ...
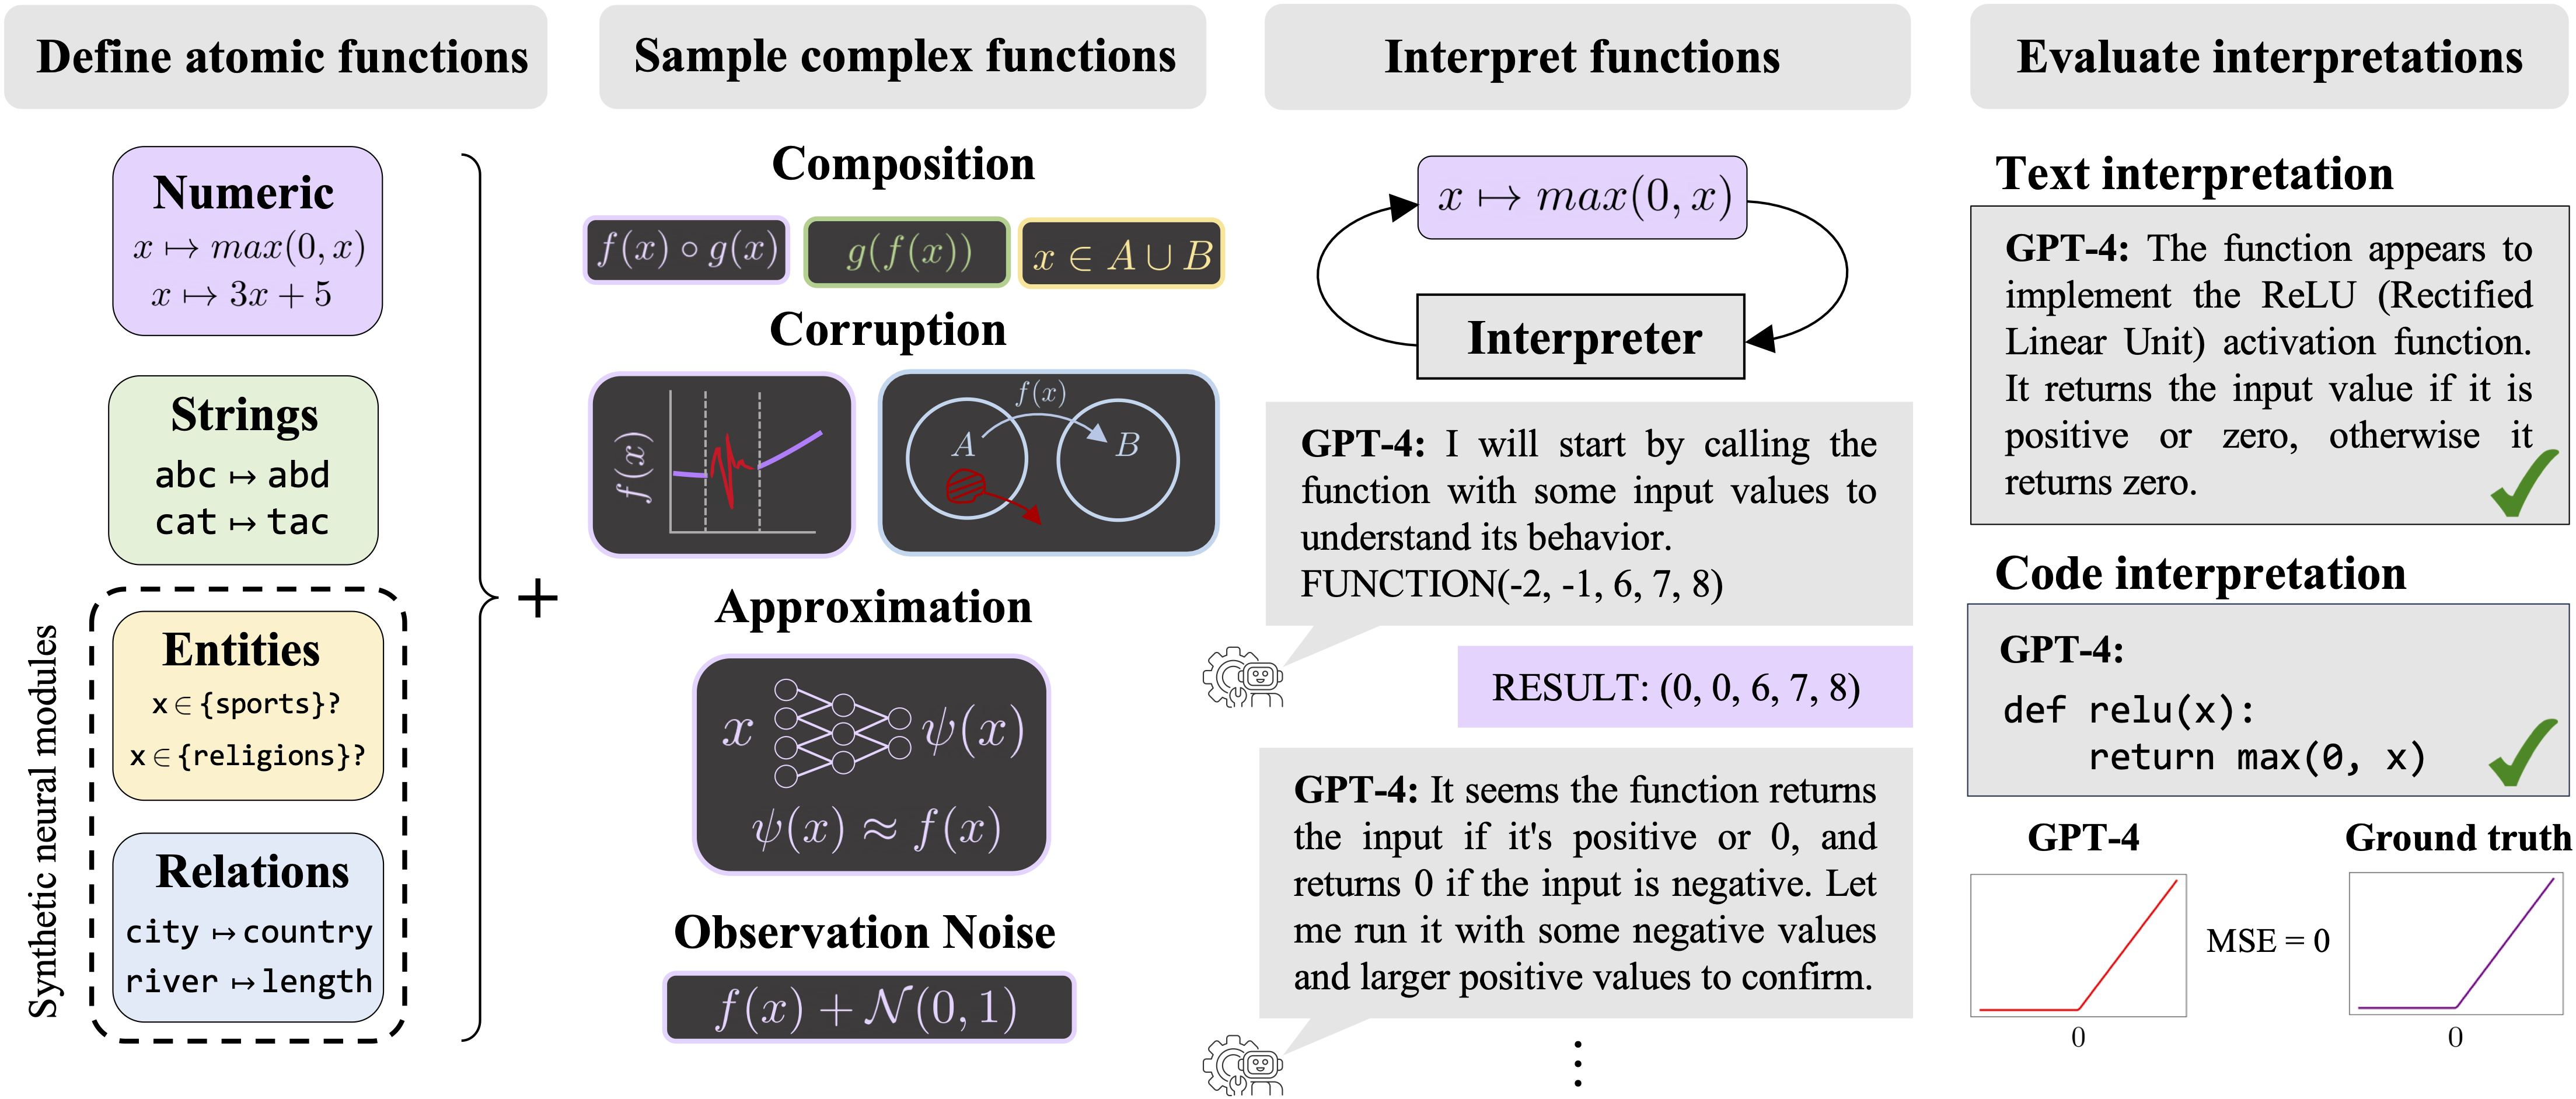
A Function Interpretation Benchmark for Evaluating Interpretability Methods

A Function Interpretation Benchmark for Evaluating Interpretability Methods
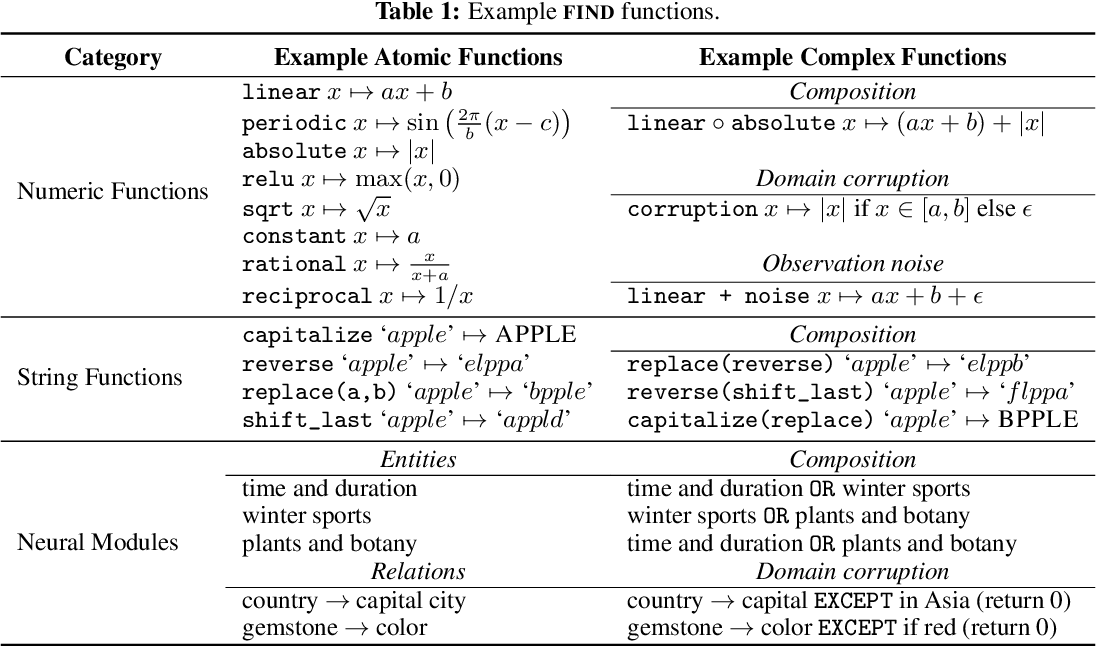
Table 1 from A Function Interpretation Benchmark for Evaluating ...

Paper page - FEA-Bench: A Benchmark for Evaluating Repository-Level ...

Paper page - CEval: A Benchmark for Evaluating Counterfactual Text ...

Paper page - IFIR: A Comprehensive Benchmark for Evaluating Instruction ...

Paper page - DesignQA: A Multimodal Benchmark for Evaluating Large ...

Paper page - TReB: A Comprehensive Benchmark for Evaluating Table ...

Paper page - CMI-Bench: A Comprehensive Benchmark for Evaluating Music ...
Advertisement Space (300x250)

Paper page - JudgeBench: A Benchmark for Evaluating LLM-based Judges

Paper page - UrBench: A Comprehensive Benchmark for Evaluating Large ...

Paper page - DOCBENCH: A Benchmark for Evaluating LLM-based Document ...

Paper page - FrontierMath: A Benchmark for Evaluating Advanced ...

Paper page - Paloma: A Benchmark for Evaluating Language Model Fit

Paper page - JMedBench: A Benchmark for Evaluating Japanese Biomedical ...

Paper page - CPsyExam: A Chinese Benchmark for Evaluating Psychology ...

Paper page - U-MATH: A University-Level Benchmark for Evaluating ...

A Function Interpretation Benchmark for Evaluating Interpretability Methods

Paper page - ViBe: A Text-to-Video Benchmark for Evaluating ...
Advertisement Space (336x280)

Paper page - AGIEval: A Human-Centric Benchmark for Evaluating ...

Paper page - TeXpert: A Multi-Level Benchmark for Evaluating LaTeX Code ...

Paper page - Soohak: A Mathematician-Curated Benchmark for Evaluating ...

Paper page - MLB: A Scenario-Driven Benchmark for Evaluating Large ...

Paper page - GBQA: A Game Benchmark for Evaluating LLMs as Quality ...

Paper page - PATCHEVAL: A New Benchmark for Evaluating LLMs on Patching ...

Paper page - Benchmark Agreement Testing Done Right: A Guide for LLM ...

Paper page - fev-bench: A Realistic Benchmark for Time Series Forecasting

Paper page - HellaSwag-Pro: A Large-Scale Bilingual Benchmark for ...

Paper page - BenchHub: A Unified Benchmark Suite for Holistic and ...
Advertisement Space (336x280)

Paper page - SWE-PolyBench: A multi-language benchmark for repository ...

Paper page - WorldScore: A Unified Evaluation Benchmark for World ...

Paper page - JointAVBench: A Benchmark for Joint Audio-Visual Reasoning ...

Paper page - DocBank: A Benchmark Dataset for Document Layout Analysis

Paper page - LitBench: A Benchmark and Dataset for Reliable Evaluation ...

Paper page - VisScience: An Extensive Benchmark for Evaluating K12 ...