
Paper Page Agent Rlvr Training Software Engineering Agents Via

Paper page - Agent-RLVR: Training Software Engineering Agents via ...

Paper page - Training Software Engineering Agents and Verifiers with ...

Paper page - Efficient RLVR Training via Weighted Mutual Information ...

Paper page - Detecting RLVR Training Data via Structural Convergence of ...

Paper page - Training Long-Context, Multi-Turn Software Engineering ...

Paper page - Training Long-Context, Multi-Turn Software Engineering ...

Paper page - Efficient RLVR Training via Weighted Mutual Information ...

Paper page - WebAgent-R1: Training Web Agents via End-to-End Multi-Turn ...

Paper page - Agentless: Demystifying LLM-based Software Engineering Agents

Paper page - Agent-Omit: Training Efficient LLM Agents for Adaptive ...
Advertisement Space (300x250)

Paper page - Agent Learning via Early Experience

Paper page - Beyond Variance: Prompt-Efficient RLVR via Rare-Event ...

Paper page - Data-Efficient RLVR via Off-Policy Influence Guidance

Paper page - Agent-R1: Training Powerful LLM Agents with End-to-End ...

Paper page - Agent Lightning: Train ANY AI Agents with Reinforcement ...
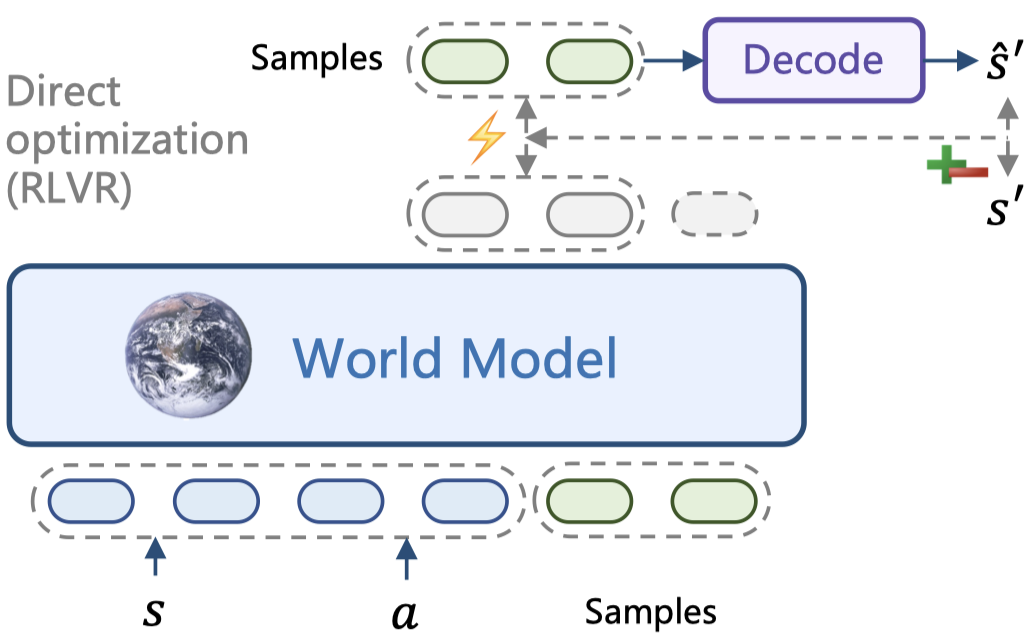
Paper page - RLVR-World: Training World Models with Reinforcement Learning

Paper page - RLPR: Extrapolating RLVR to General Domains without Verifiers

Detecting RLVR Training Data via Structural Convergence of Reasoning ...

WebAgent-R1: Training Web Agents via End-to-End Multi-Turn ...

SWE-Fuse: Empowering Software Agents via Issue-free Trajectory Learning ...
Advertisement Space (336x280)

Detecting RLVR Training Data via Structural Convergence of Reasoning ...

Efficient RLVR Training via Weighted Mutual Information Data Selection ...
Detecting RLVR Training Data via Structural Convergence of Reasoning ...

Paper page - ProRL Agent: Rollout-as-a-Service for RL Training of Multi ...

Paper page - How Far Can Unsupervised RLVR Scale LLM Training?

Paper page - On the Direction of RLVR Updates for LLM Reasoning ...

Paper page - RLVR-World: Training World Models with Reinforcement Learning

Paper page - Self-Distilled RLVR

Paper page - Implicit Actor Critic Coupling via a Supervised Learning ...

Agent-R: Training Language Model Agents to Reflect via Iterative Self ...
Advertisement Space (336x280)

Paper page - RLPR: Extrapolating RLVR to General Domains without Verifiers

Paper page - CEPO: RLVR Self-Distillation using Contrastive Evidence ...

Paper page - Evaluating Parameter Efficient Methods for RLVR

[논문 리뷰] SWE-Fuse: Empowering Software Agents via Issue-free Trajectory ...

Paper page - Low-rank Optimization Trajectories Modeling for LLM RLVR ...

Paper page - OpenClaw-RL: Train Any Agent Simply by Talking