
Paper Page Sliminfer Accelerating Long Context Llm Inference Via

Paper page - SlimInfer: Accelerating Long-Context LLM Inference via ...

Paper page - AccLLM: Accelerating Long-Context LLM Inference Via ...

Paper page - Squeezed Attention: Accelerating Long Context Length LLM ...

Paper page - DASH-KV: Accelerating Long-Context LLM Inference via ...

Paper page - LycheeDecode: Accelerating Long-Context LLM Inference via ...

Paper page - Accelerating LLM Inference with Staged Speculative Decoding

Squeezed Attention: Accelerating Long Context Length LLM Inference ...
Squeezed Attention: Accelerating Long Context Length LLM Inference - AI ...

Paper page - Recursive Speculative Decoding: Accelerating LLM Inference ...

Paper page — Infinite-LLM: Efficient LLM Service for Long Context with ...
Advertisement Space (300x250)
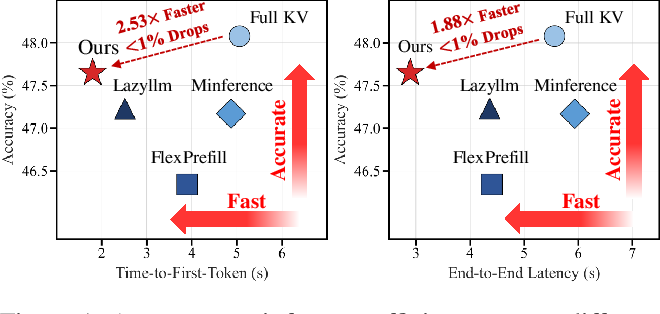
Figure 1 from SlimInfer: Accelerating Long-Context LLM Inference via ...

AccLLM: Accelerating Long-Context LLM Inference Via Algorithm-Hardware ...

RetrievalAttention: Accelerating Long-Context LLM Inference via Vector ...
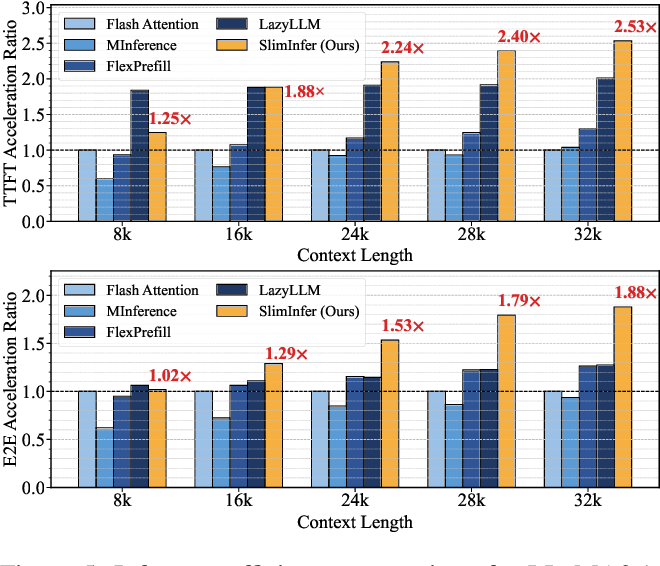
Figure 5 from SlimInfer: Accelerating Long-Context LLM Inference via ...

RetrievalAttention: Accelerating Long-Context LLM Inference via Vector ...

RetrievalAttention: Accelerating Long-Context LLM Inference via Vector ...
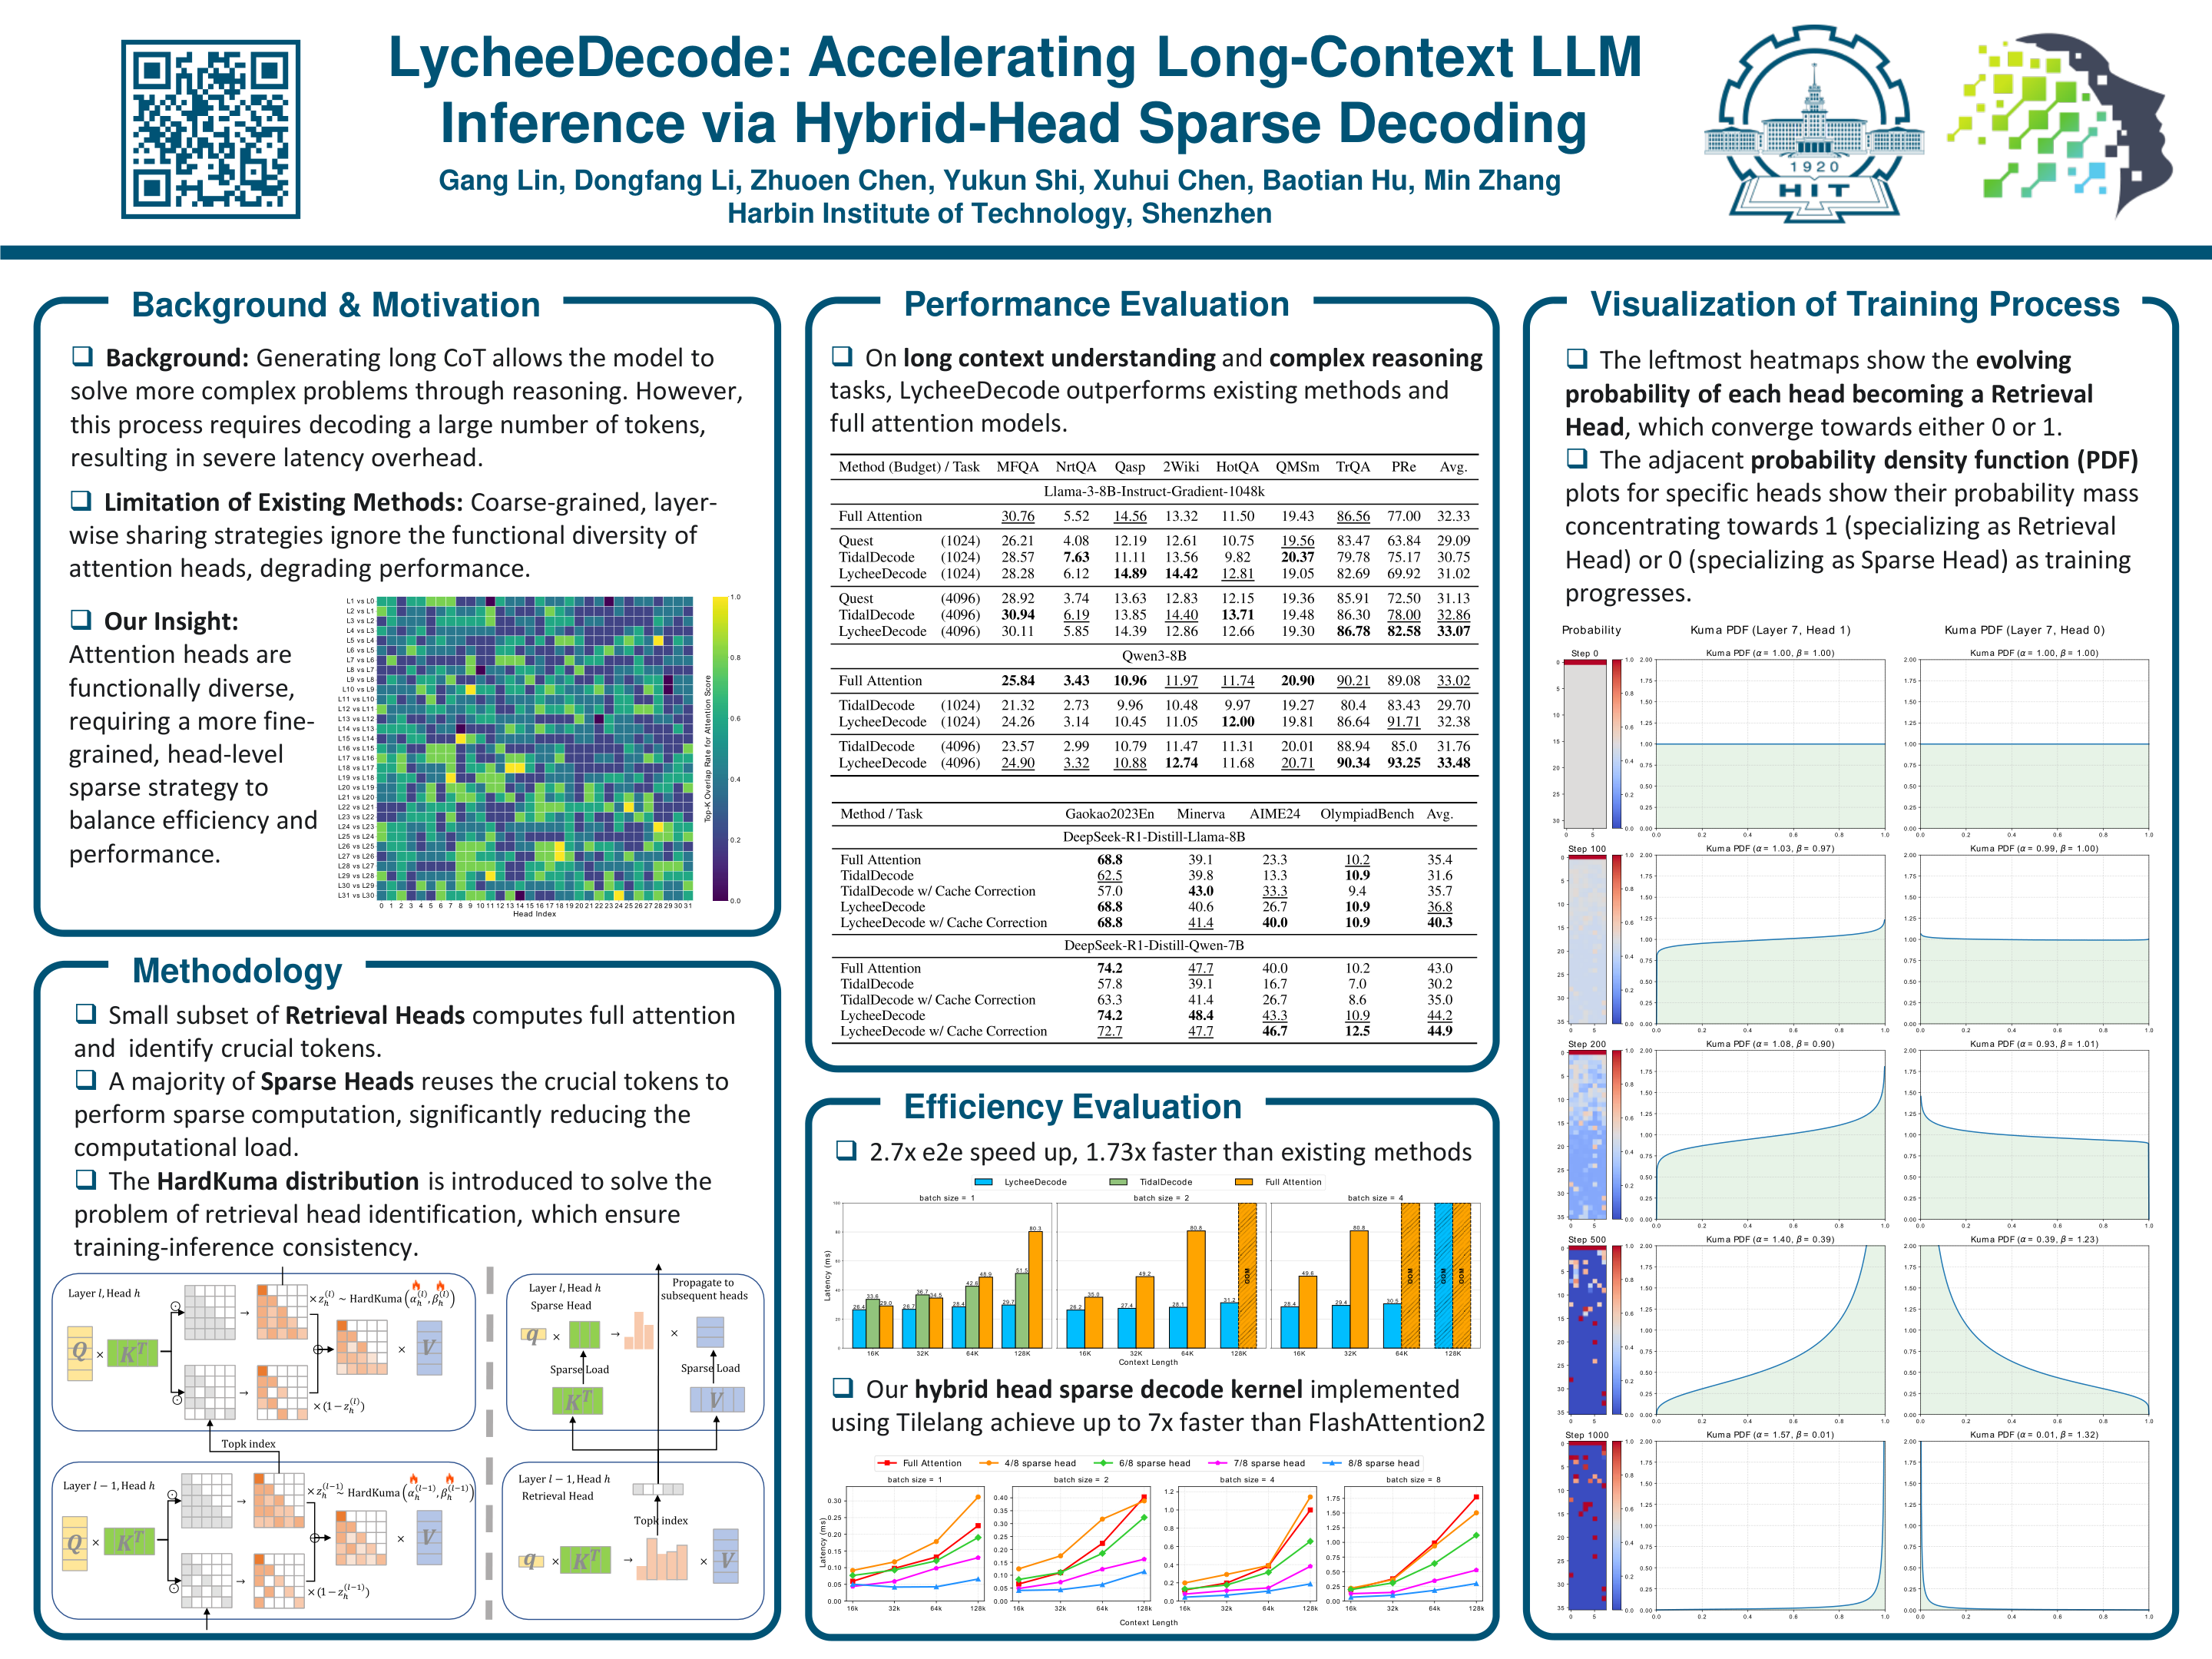
ICLR Poster LycheeDecode: Accelerating Long-Context LLM Inference via ...

Paper page - RetrievalAttention: Accelerating Long-Context LLM ...

Focus-dLLM: Accelerating Long-Context Diffusion LLM Inference via ...

Paper page - Focus-dLLM: Accelerating Long-Context Diffusion LLM ...
Advertisement Space (336x280)

LycheeDecode: Accelerating Long-Context LLM Inference via Hybrid-Head ...

Paper page - LazyLLM: Dynamic Token Pruning for Efficient Long Context ...

(PDF) RetrievalAttention: Accelerating Long-Context LLM Inference via ...

Paper page - LazyLLM: Dynamic Token Pruning for Efficient Long Context ...

Figure 1 from SlimInfer: Accelerating Long-Context LLM Inference via ...

(PDF) RocketKV: Accelerating Long-Context LLM Inference via Two-Stage ...

RetrievalAttention: Accelerating Long-Context LLM Inference via Vector ...

Paper page - DuoAttention: Efficient Long-Context LLM Inference with ...

Paper page - Discovering the Gems in Early Layers: Accelerating Long ...

[논문 리뷰] DASH-KV: Accelerating Long-Context LLM Inference via Asymmetric ...
Advertisement Space (336x280)

Paper page - LongLLMLingua: Accelerating and Enhancing LLMs in Long ...
LycheeDecode: Accelerating Long-Context LLM Inference via Hybrid-Head ...
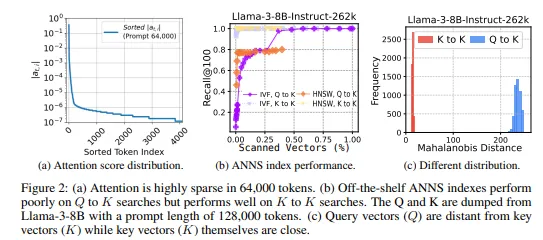
RetrievalAttention: Accelerating Long-Context LLM Inference via Vector ...

Paper page - Scaling Long-Horizon LLM Agent via Context-Folding
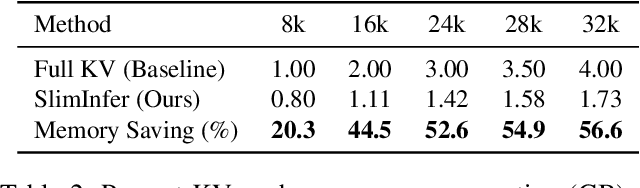
Table 2 from SlimInfer: Accelerating Long-Context LLM Inference via ...
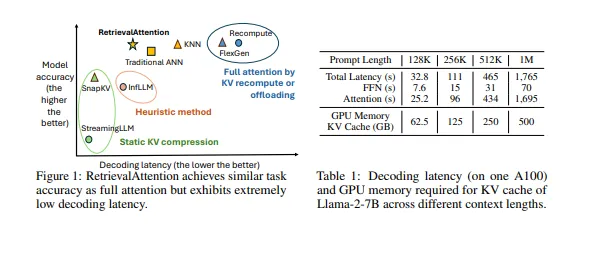
RetrievalAttention: Accelerating Long-Context LLM Inference via Vector ...