
Parallelism Techniques For Llm Inference Aws Neuron Documentation

Parallelism Techniques for LLM Inference — AWS Neuron Documentation

Parallelism Techniques for LLM Inference — AWS Neuron Documentation

Parallelism Techniques for LLM Inference — AWS Neuron Documentation
Parallelism Techniques for LLM Inference — AWS Neuron Documentation

Generative LLM inference with Neuron — AWS Neuron Documentation
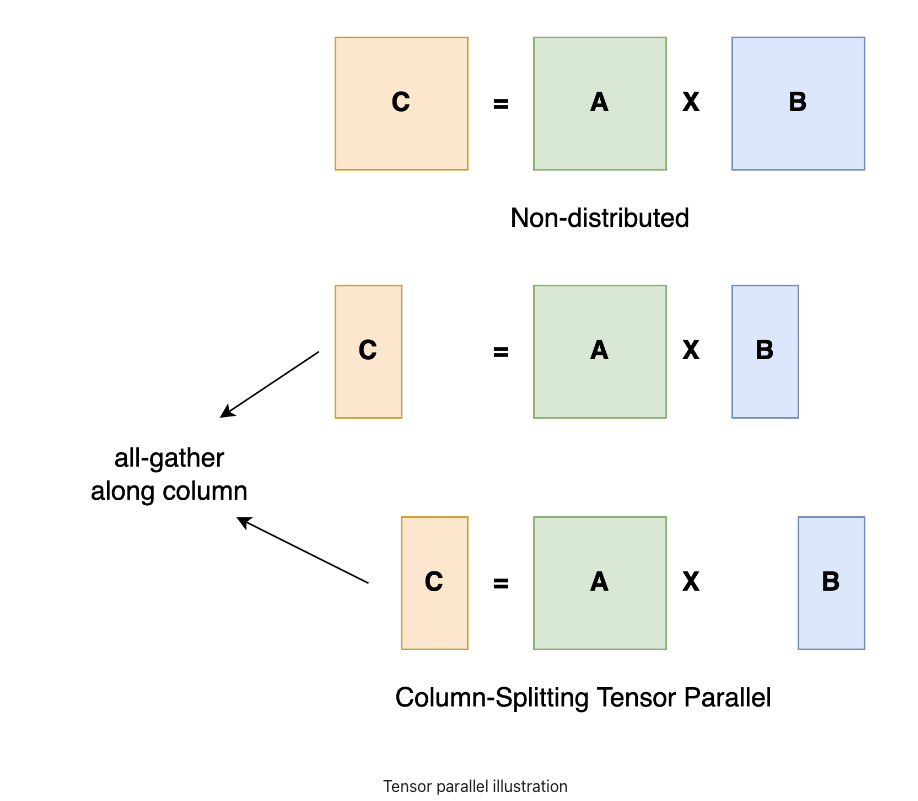
Tensor Parallelism Overview — AWS Neuron Documentation
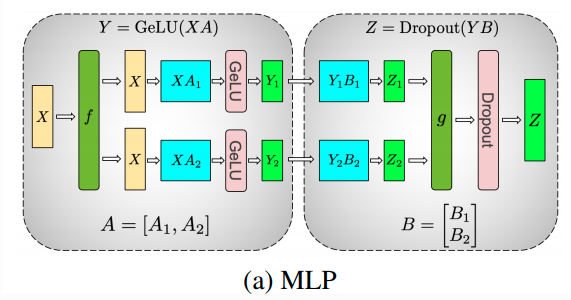
Tensor Parallelism Overview — AWS Neuron Documentation

Model Parallelism for LLM Inference | LeetLLM
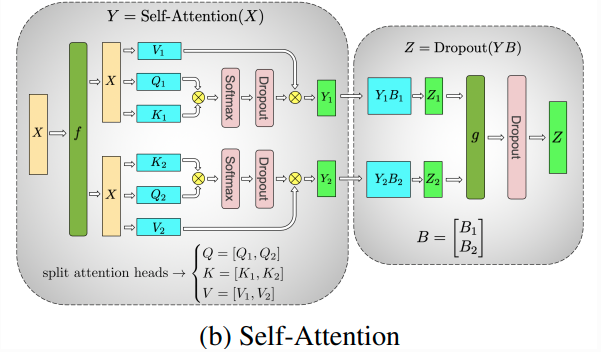
Tensor Parallelism Overview — AWS Neuron Documentation

Model Parallelism for LLM Inference | LeetLLM
Advertisement Space (300x250)

Context Parallelism Overview — AWS Neuron Documentation

Analysis of LLM Architectures and AWS for Training and Inference Pipelines
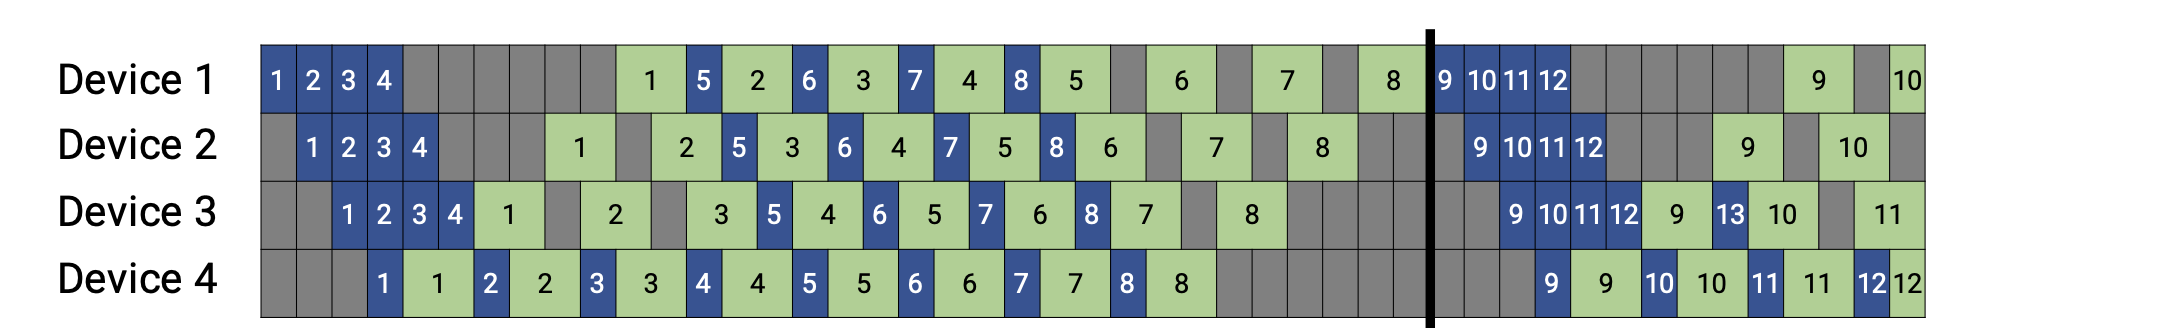
Pipeline Parallelism Overview — AWS Neuron Documentation

Analysis of LLM Architectures and AWS for Training and Inference Pipelines

Comprehensive Analysis of LLM Inference Parallelism Strategies: TP / DP ...
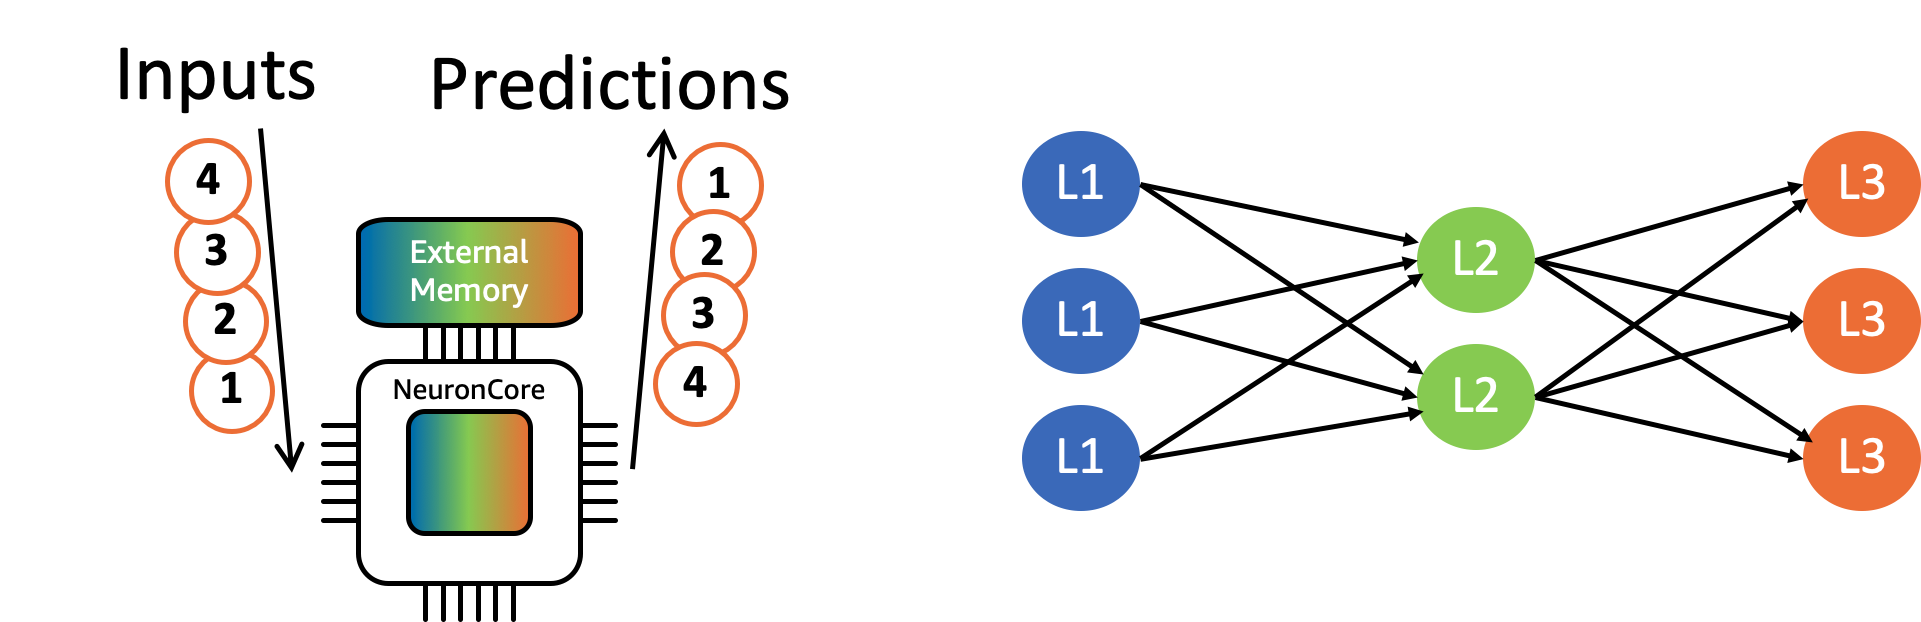
Neuron Batching — AWS Neuron Documentation

Shift Parallelism: Low-Latency, High-Throughput LLM Inference for ...
Tensor Parallelism: Model Parallelism for Large LLMs | Inference Systems
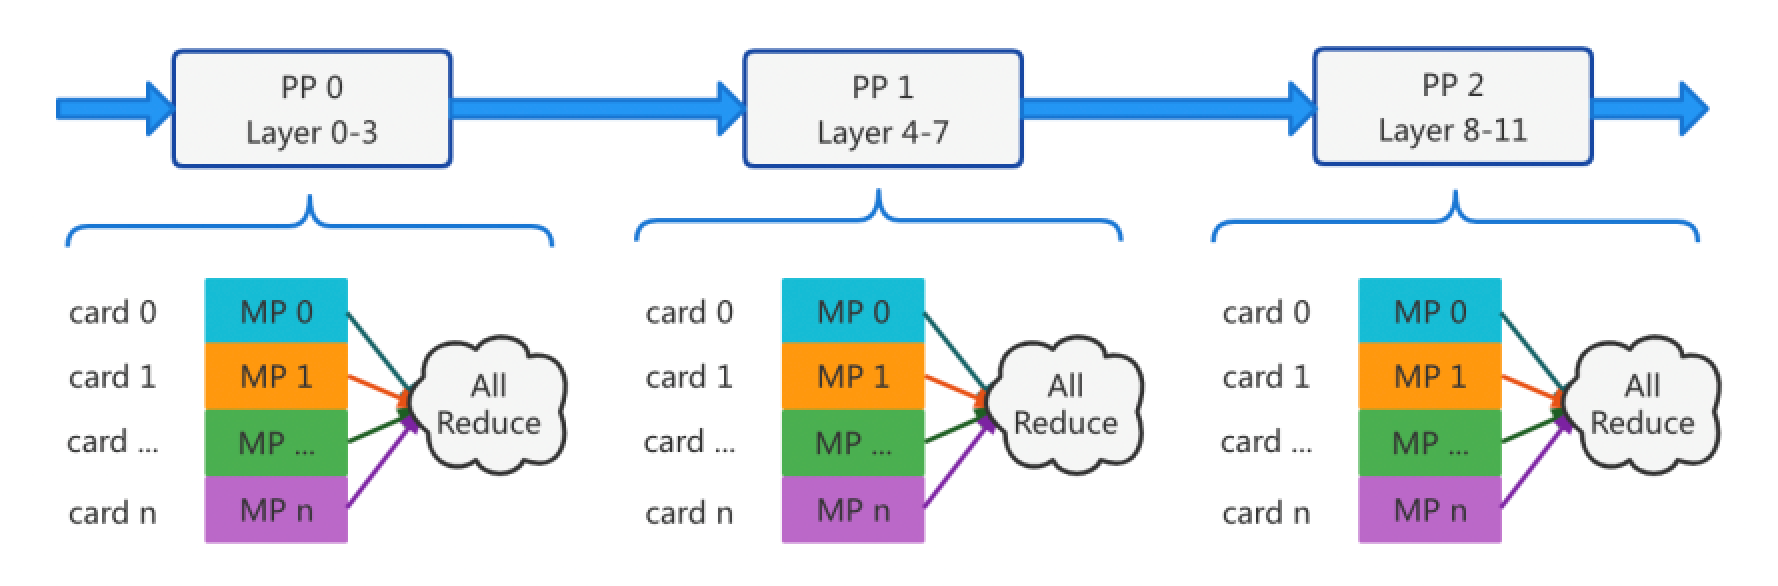
Comprehensive Analysis of LLM Inference Parallelism Strategies: TP / DP ...

Parallelism Techniques for Large Language Model Training | Vinoth Kumar ...
Advertisement Space (336x280)

gLLM: Global Balanced Pipeline Parallelism System for Distributed LLM ...
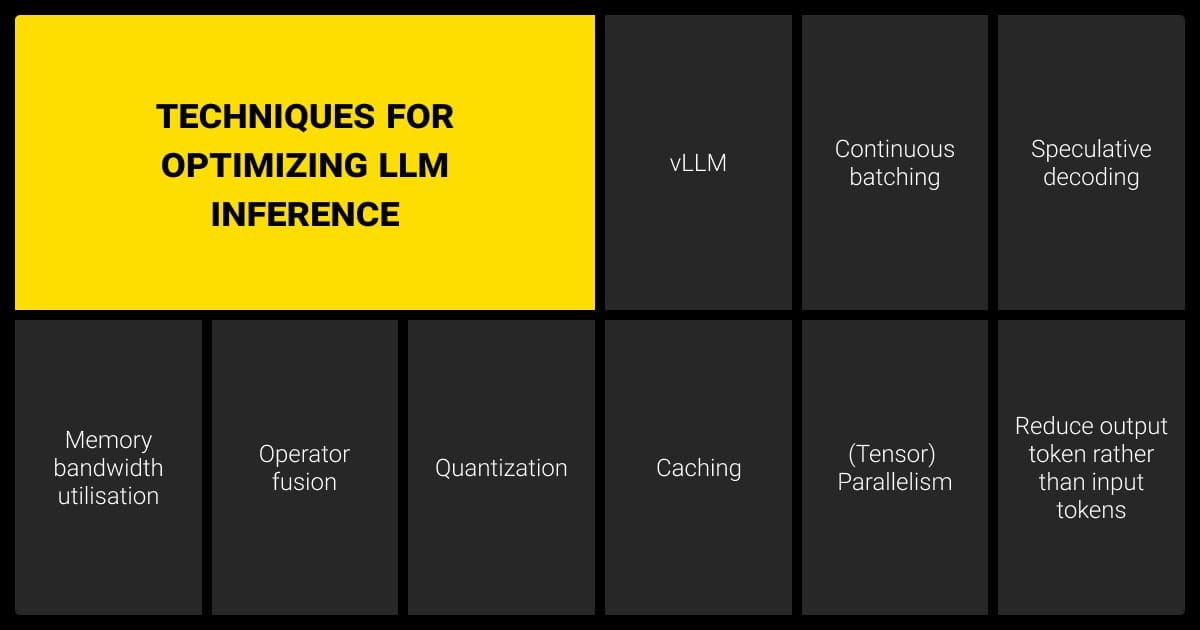
LLM Inference: Techniques for Optimized Deployment in 2026 | Label Your ...

Mini-SGLang-Neuron: Bringing Lightweight LLM Inference to AWS Trainium ...

Scaling LLM Inference on EKS with AWS Inferentia and Trainium | by ...

A Switch-Centric In-Network Architecture for Accelerating LLM Inference ...
ThreadWeaver: Adaptive Parallel Reasoning for Efficient LLM Inference ...

LLM Parallel Processing in Practice: Key Techniques for Performance ...
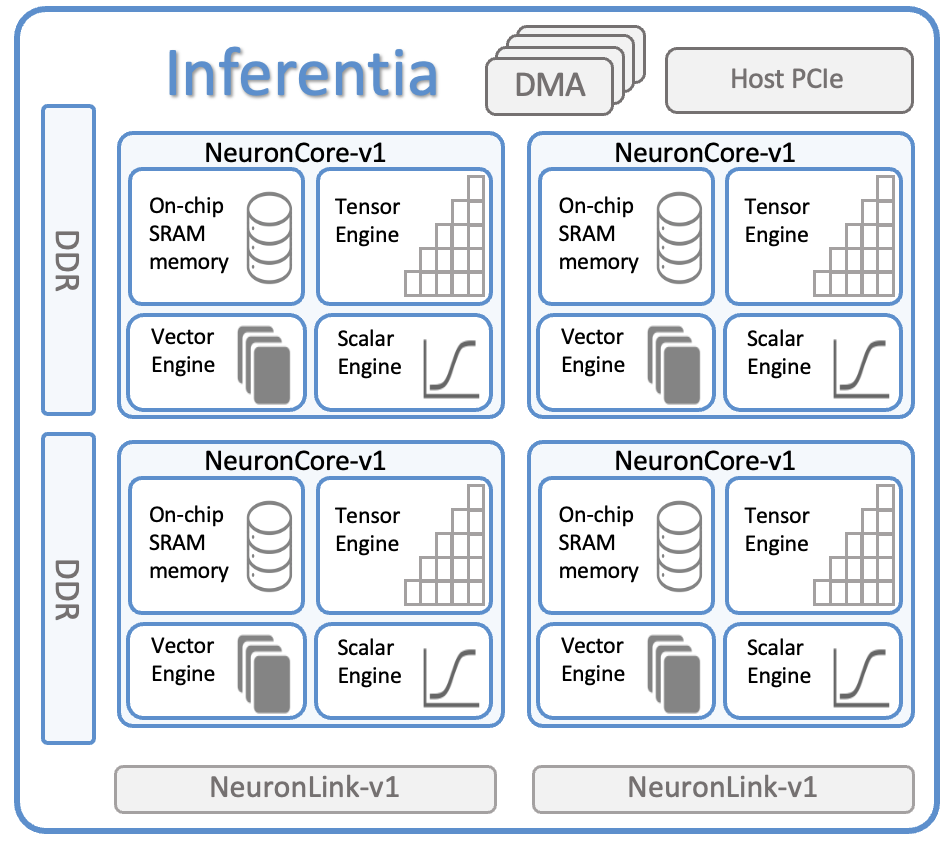
Inferentia Architecture — AWS Neuron Documentation

Mini-SGLang-Neuron: Bringing Lightweight LLM Inference to AWS Trainium ...
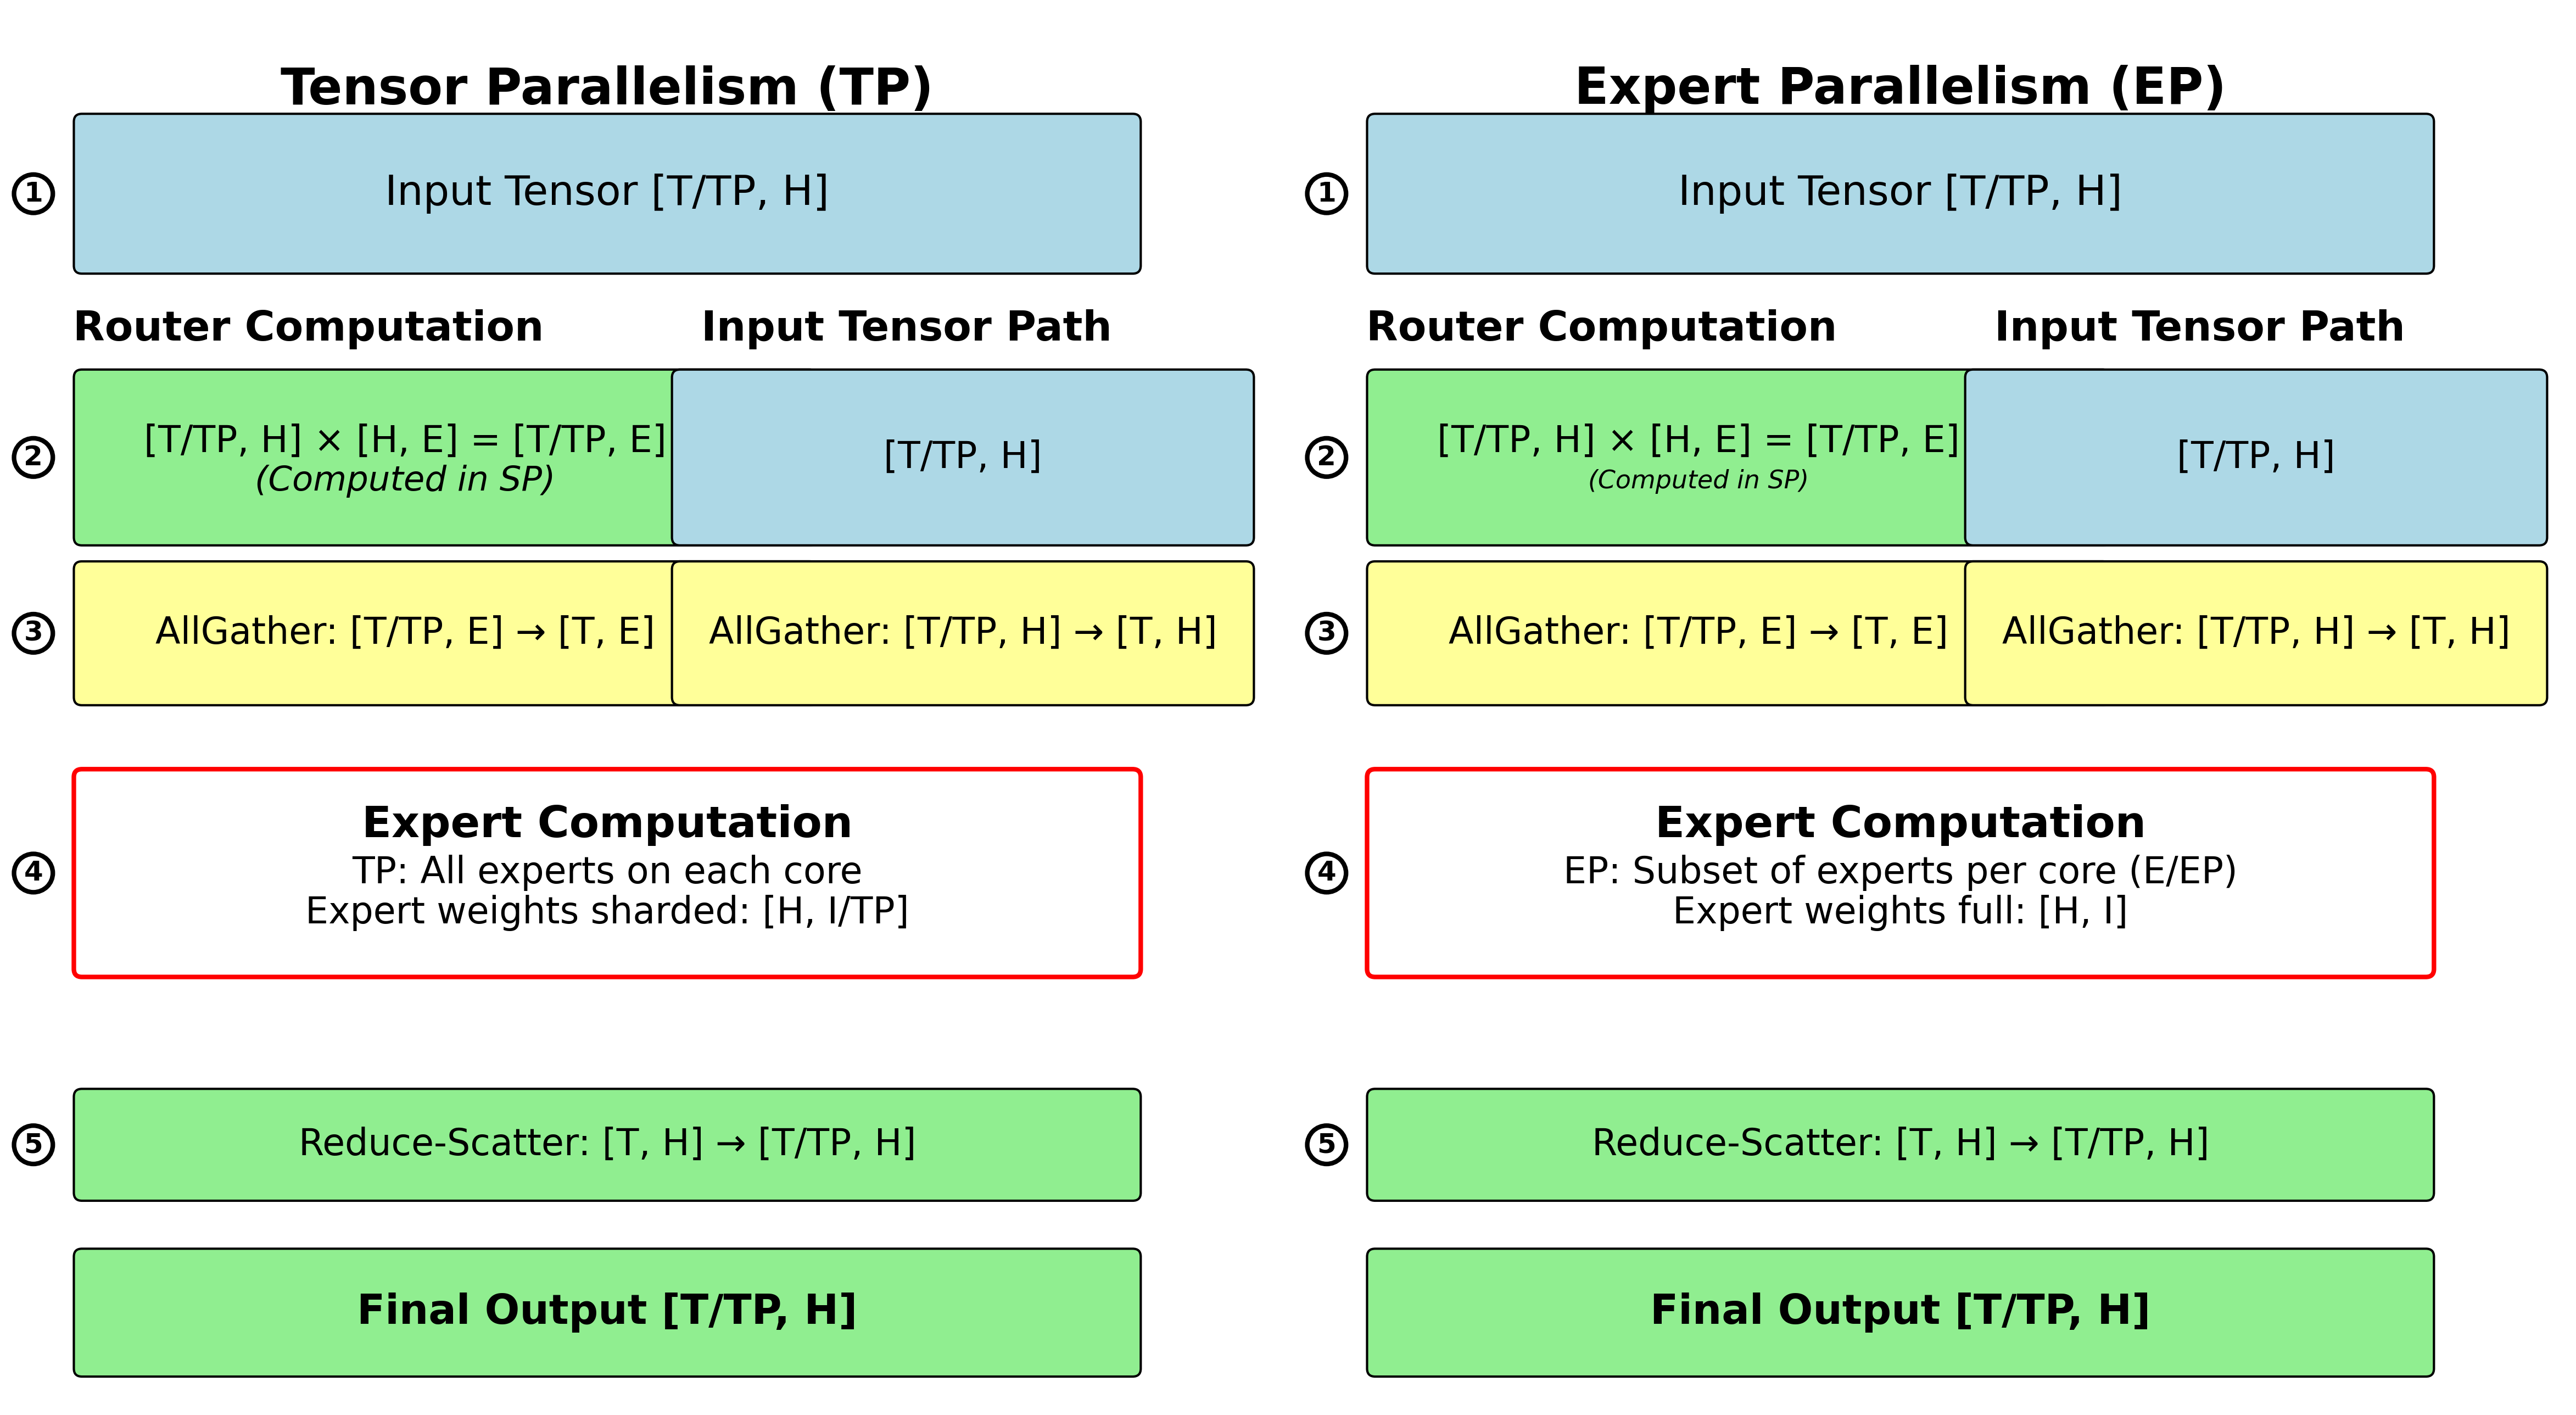
Deep dive: Explore Mixture of Experts (MoE) inference support for ...
Advertisement Space (336x280)
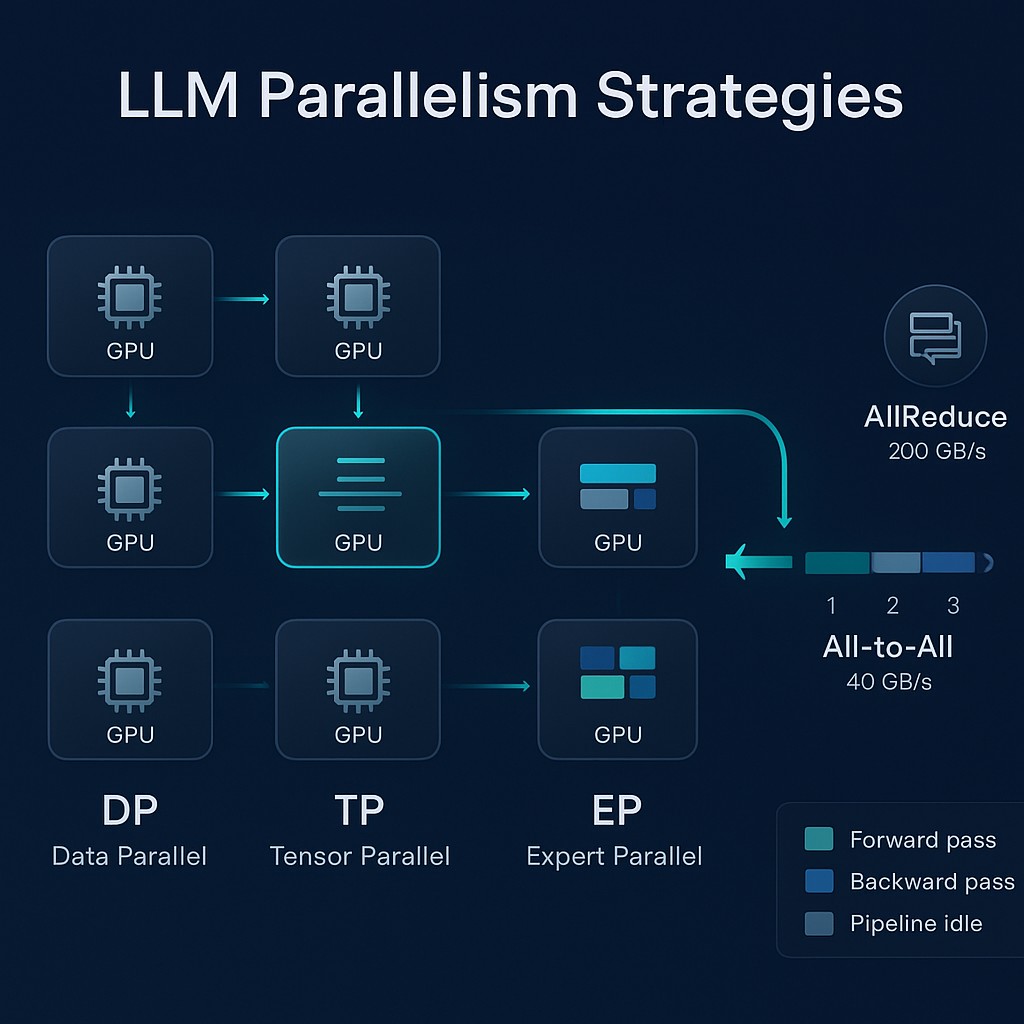
LLM Parallelism Strategies Explained | Simulations4All
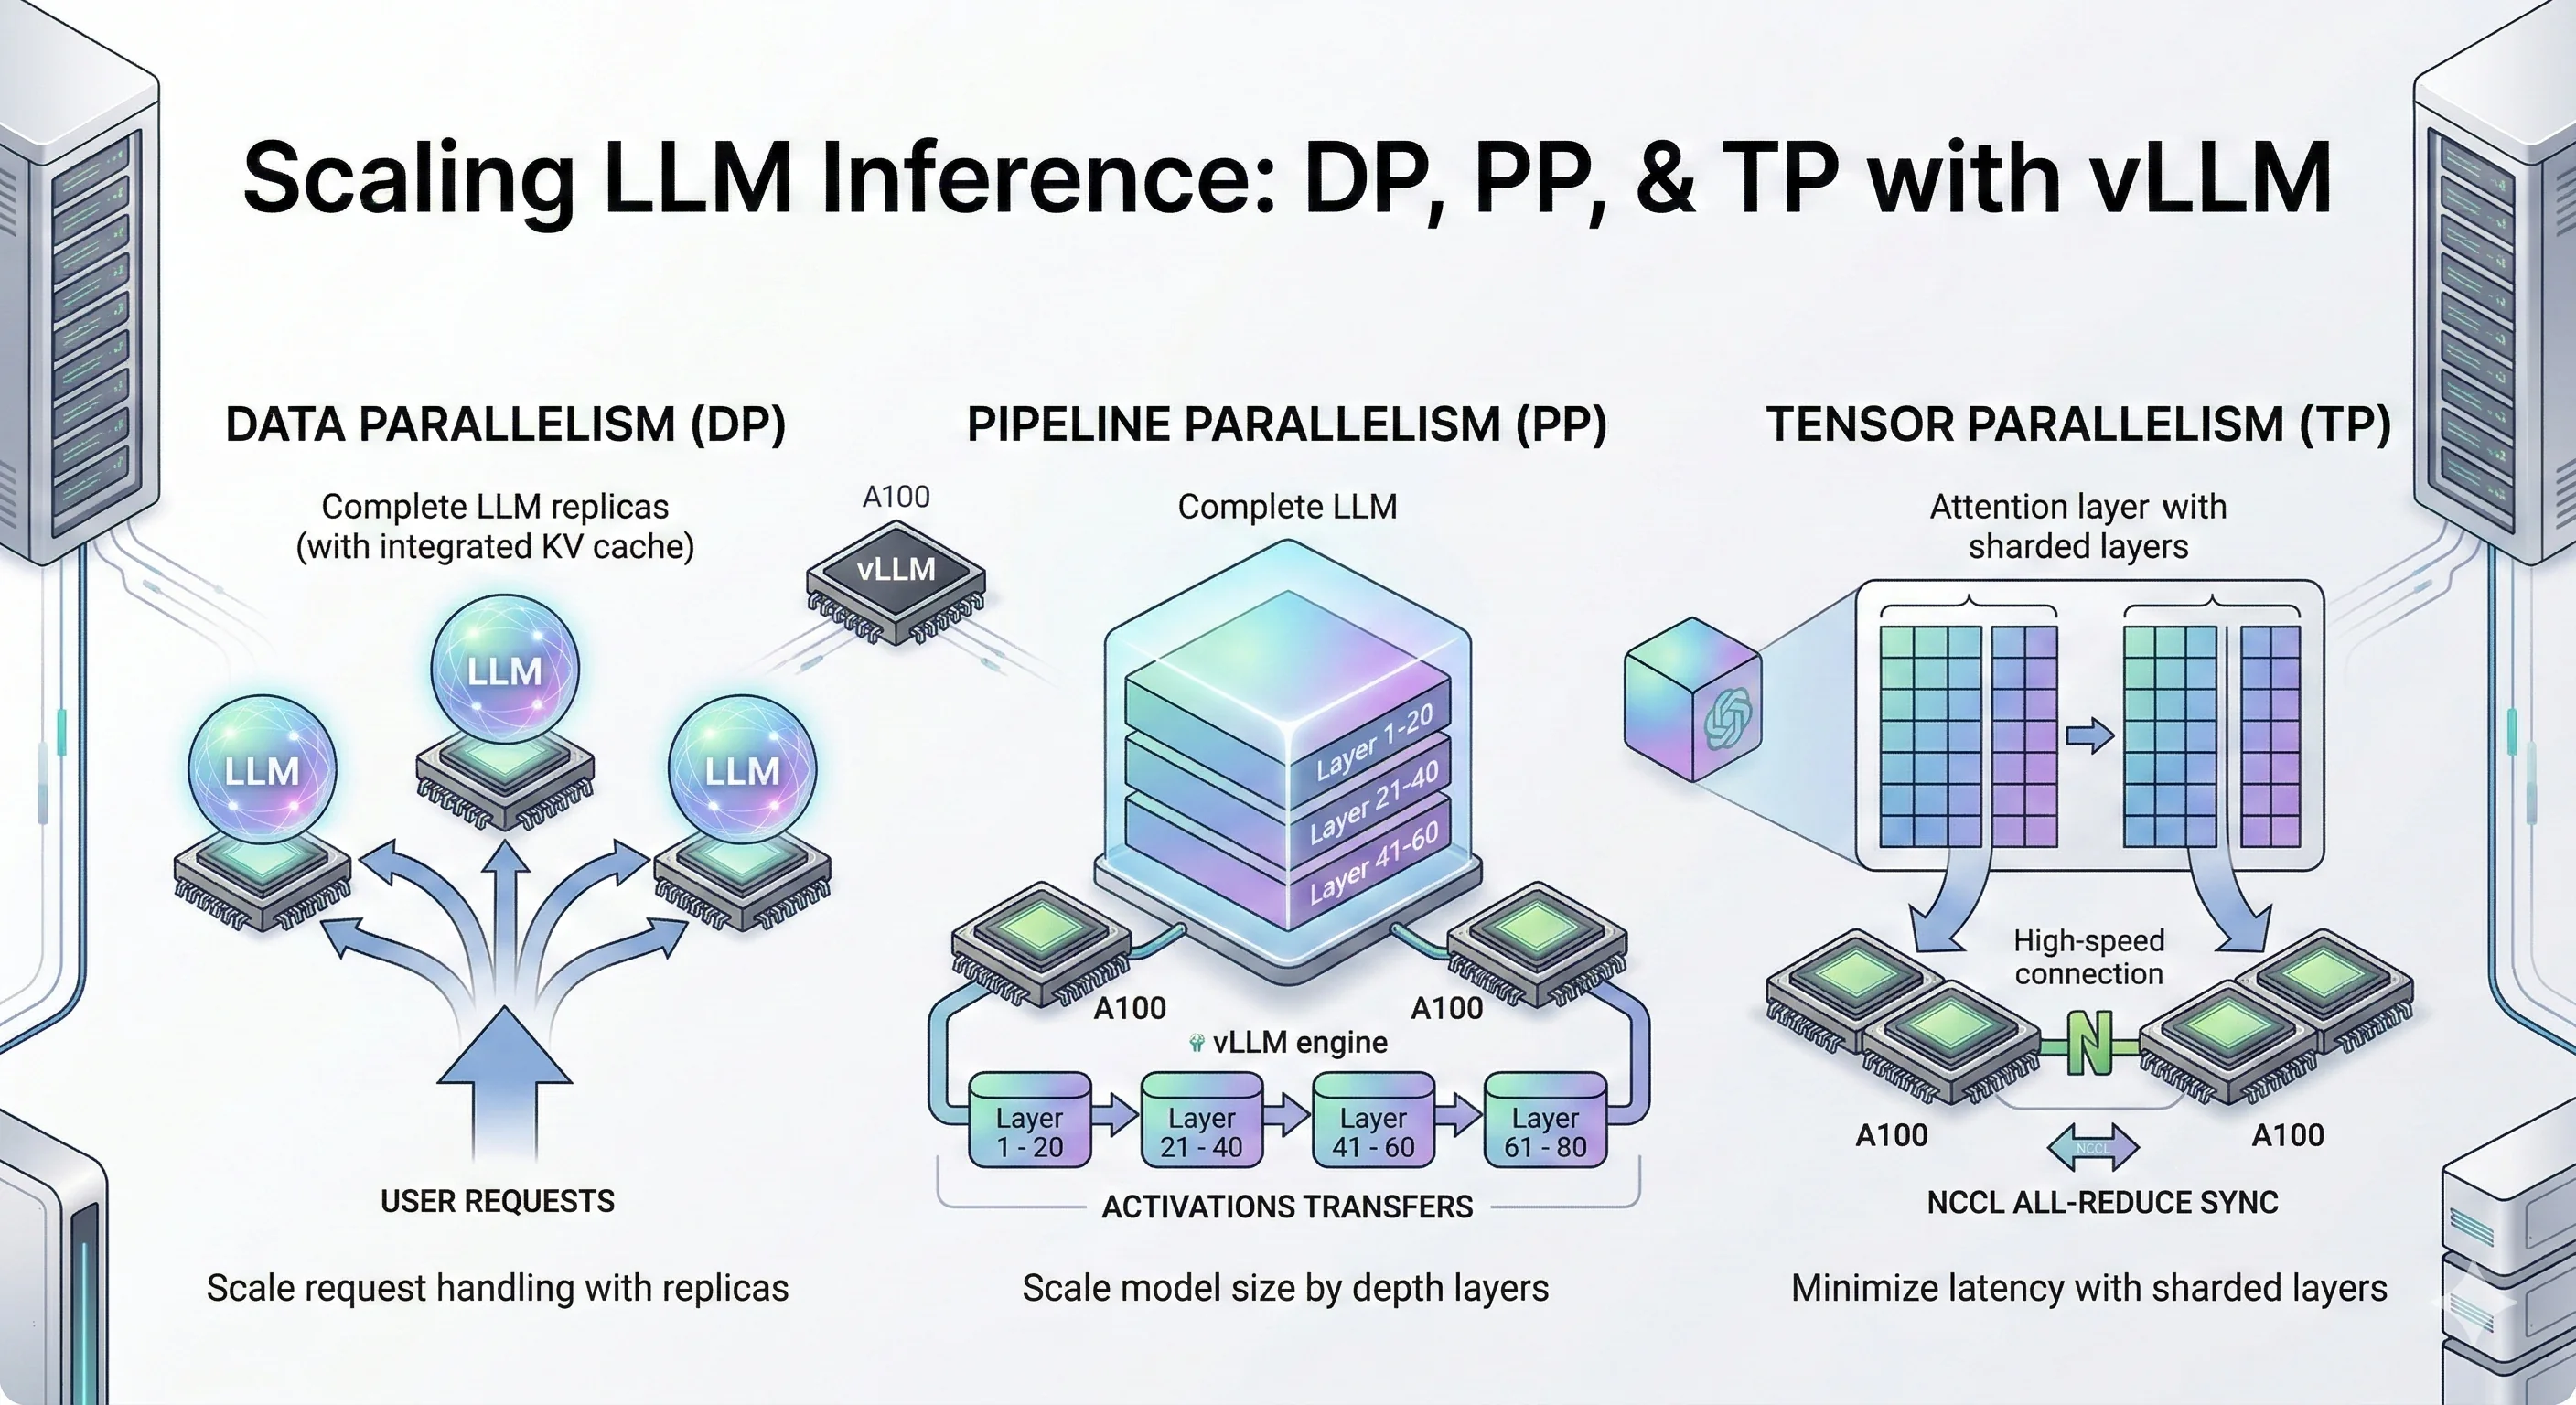
Speculative Decoding in vLLM: Complete Guide to Faster LLM Inference ...
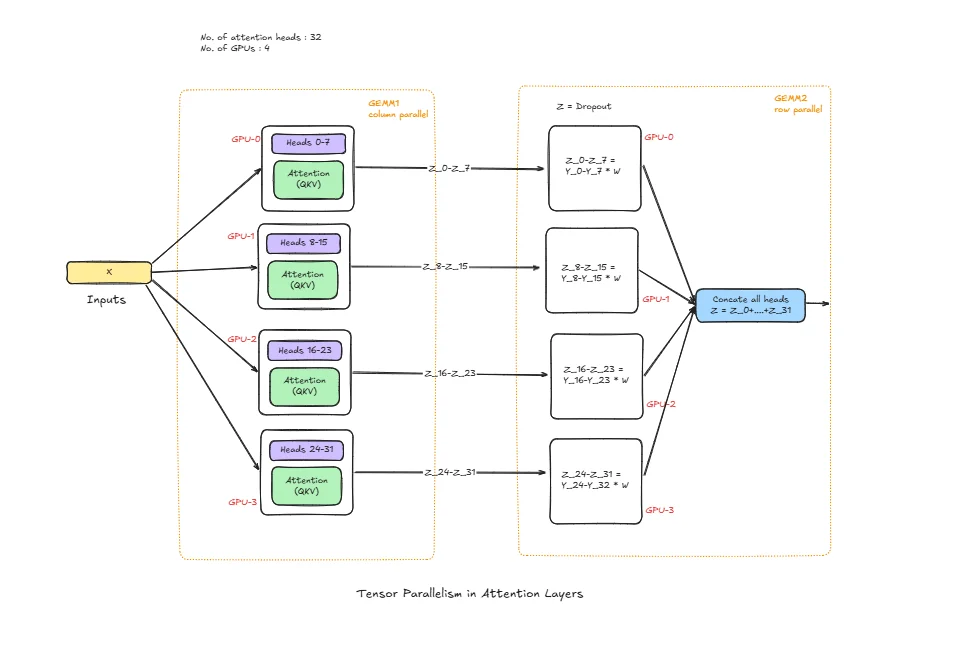
Scaling LLM Inference: Data, Pipeline & Tensor Parallelism in vLLM ...
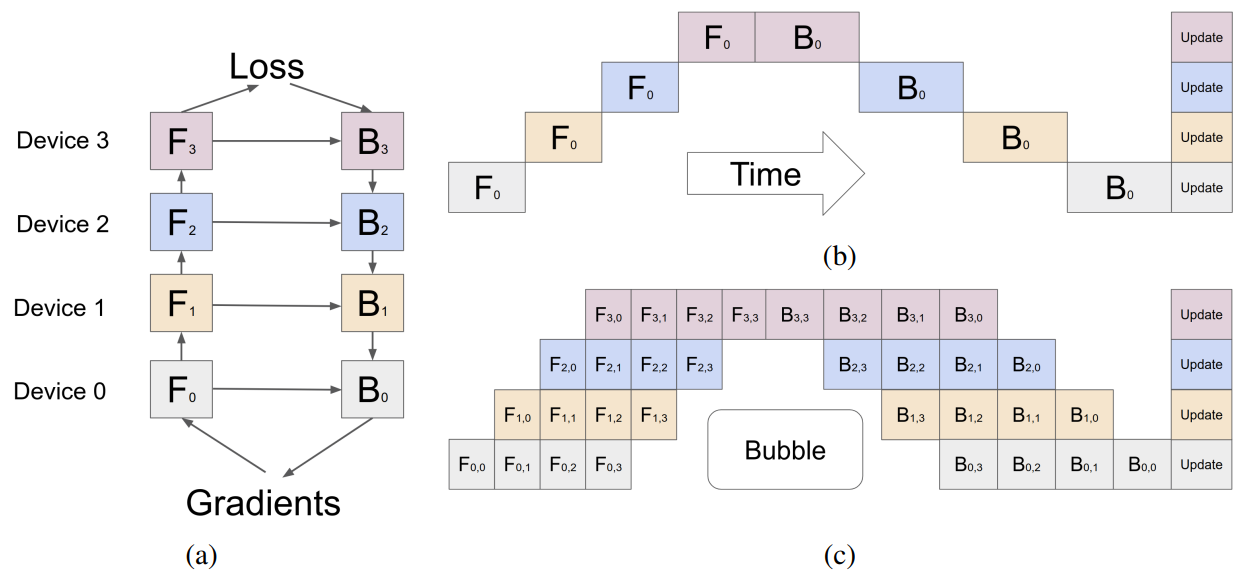
Mastering LLM Techniques: Inference Optimization – GIXtools
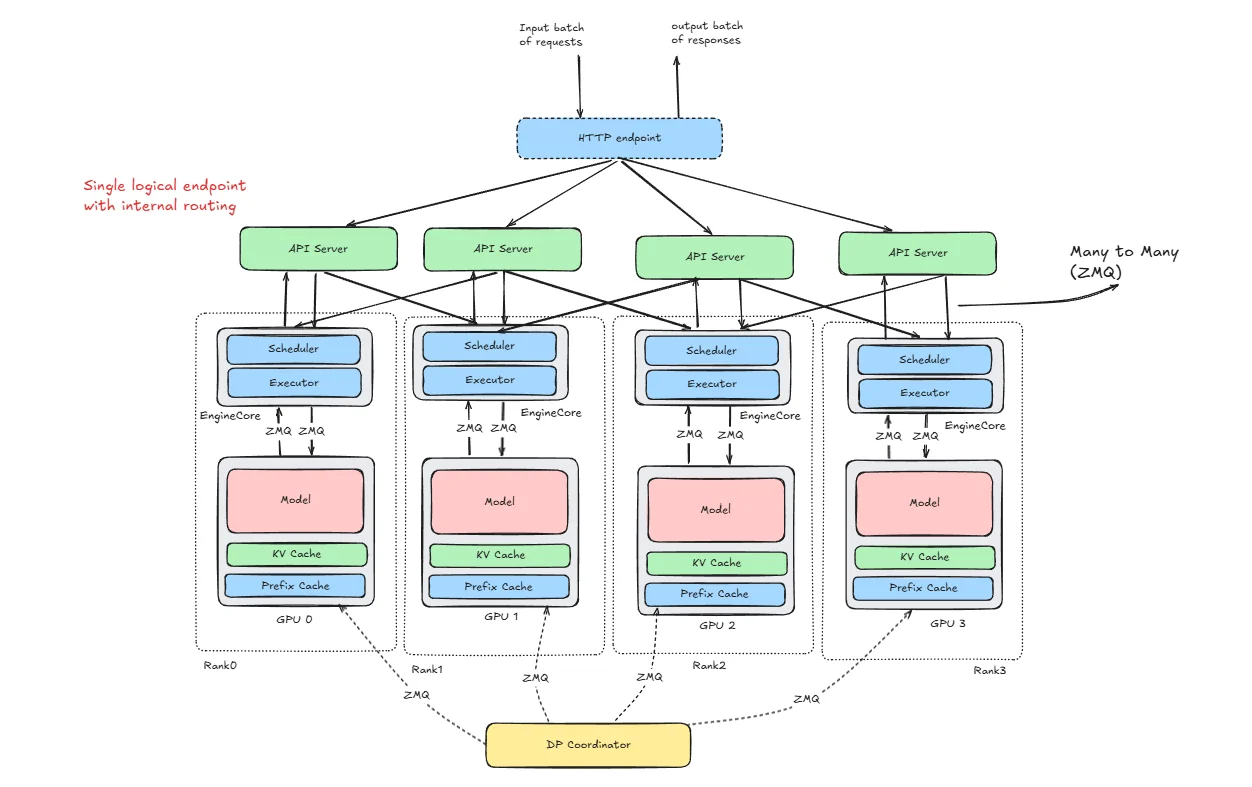
Scaling LLM Inference: Data, Pipeline & Tensor Parallelism in vLLM ...
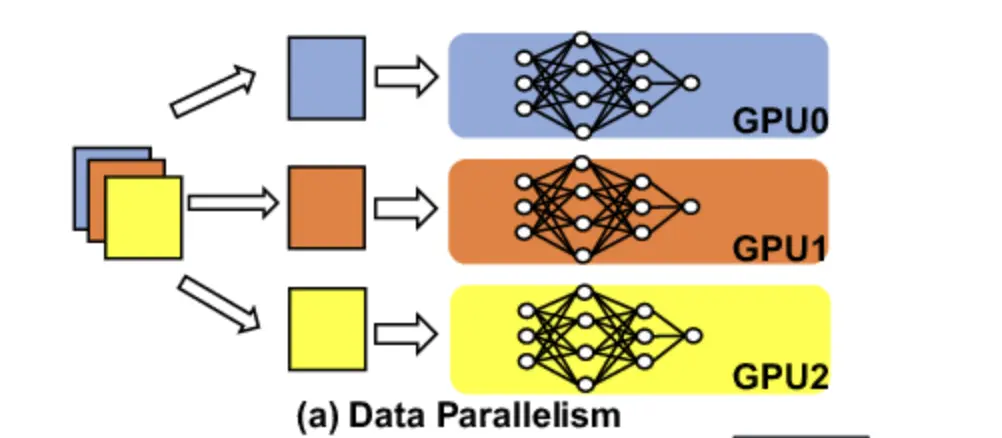
What is Inference Parallelism and How it Works