
Pdf Og Vla 3d Aware Vision Language Action Model Via Orthographic

(PDF) OG-VLA: 3D-Aware Vision Language Action Model via Orthographic ...
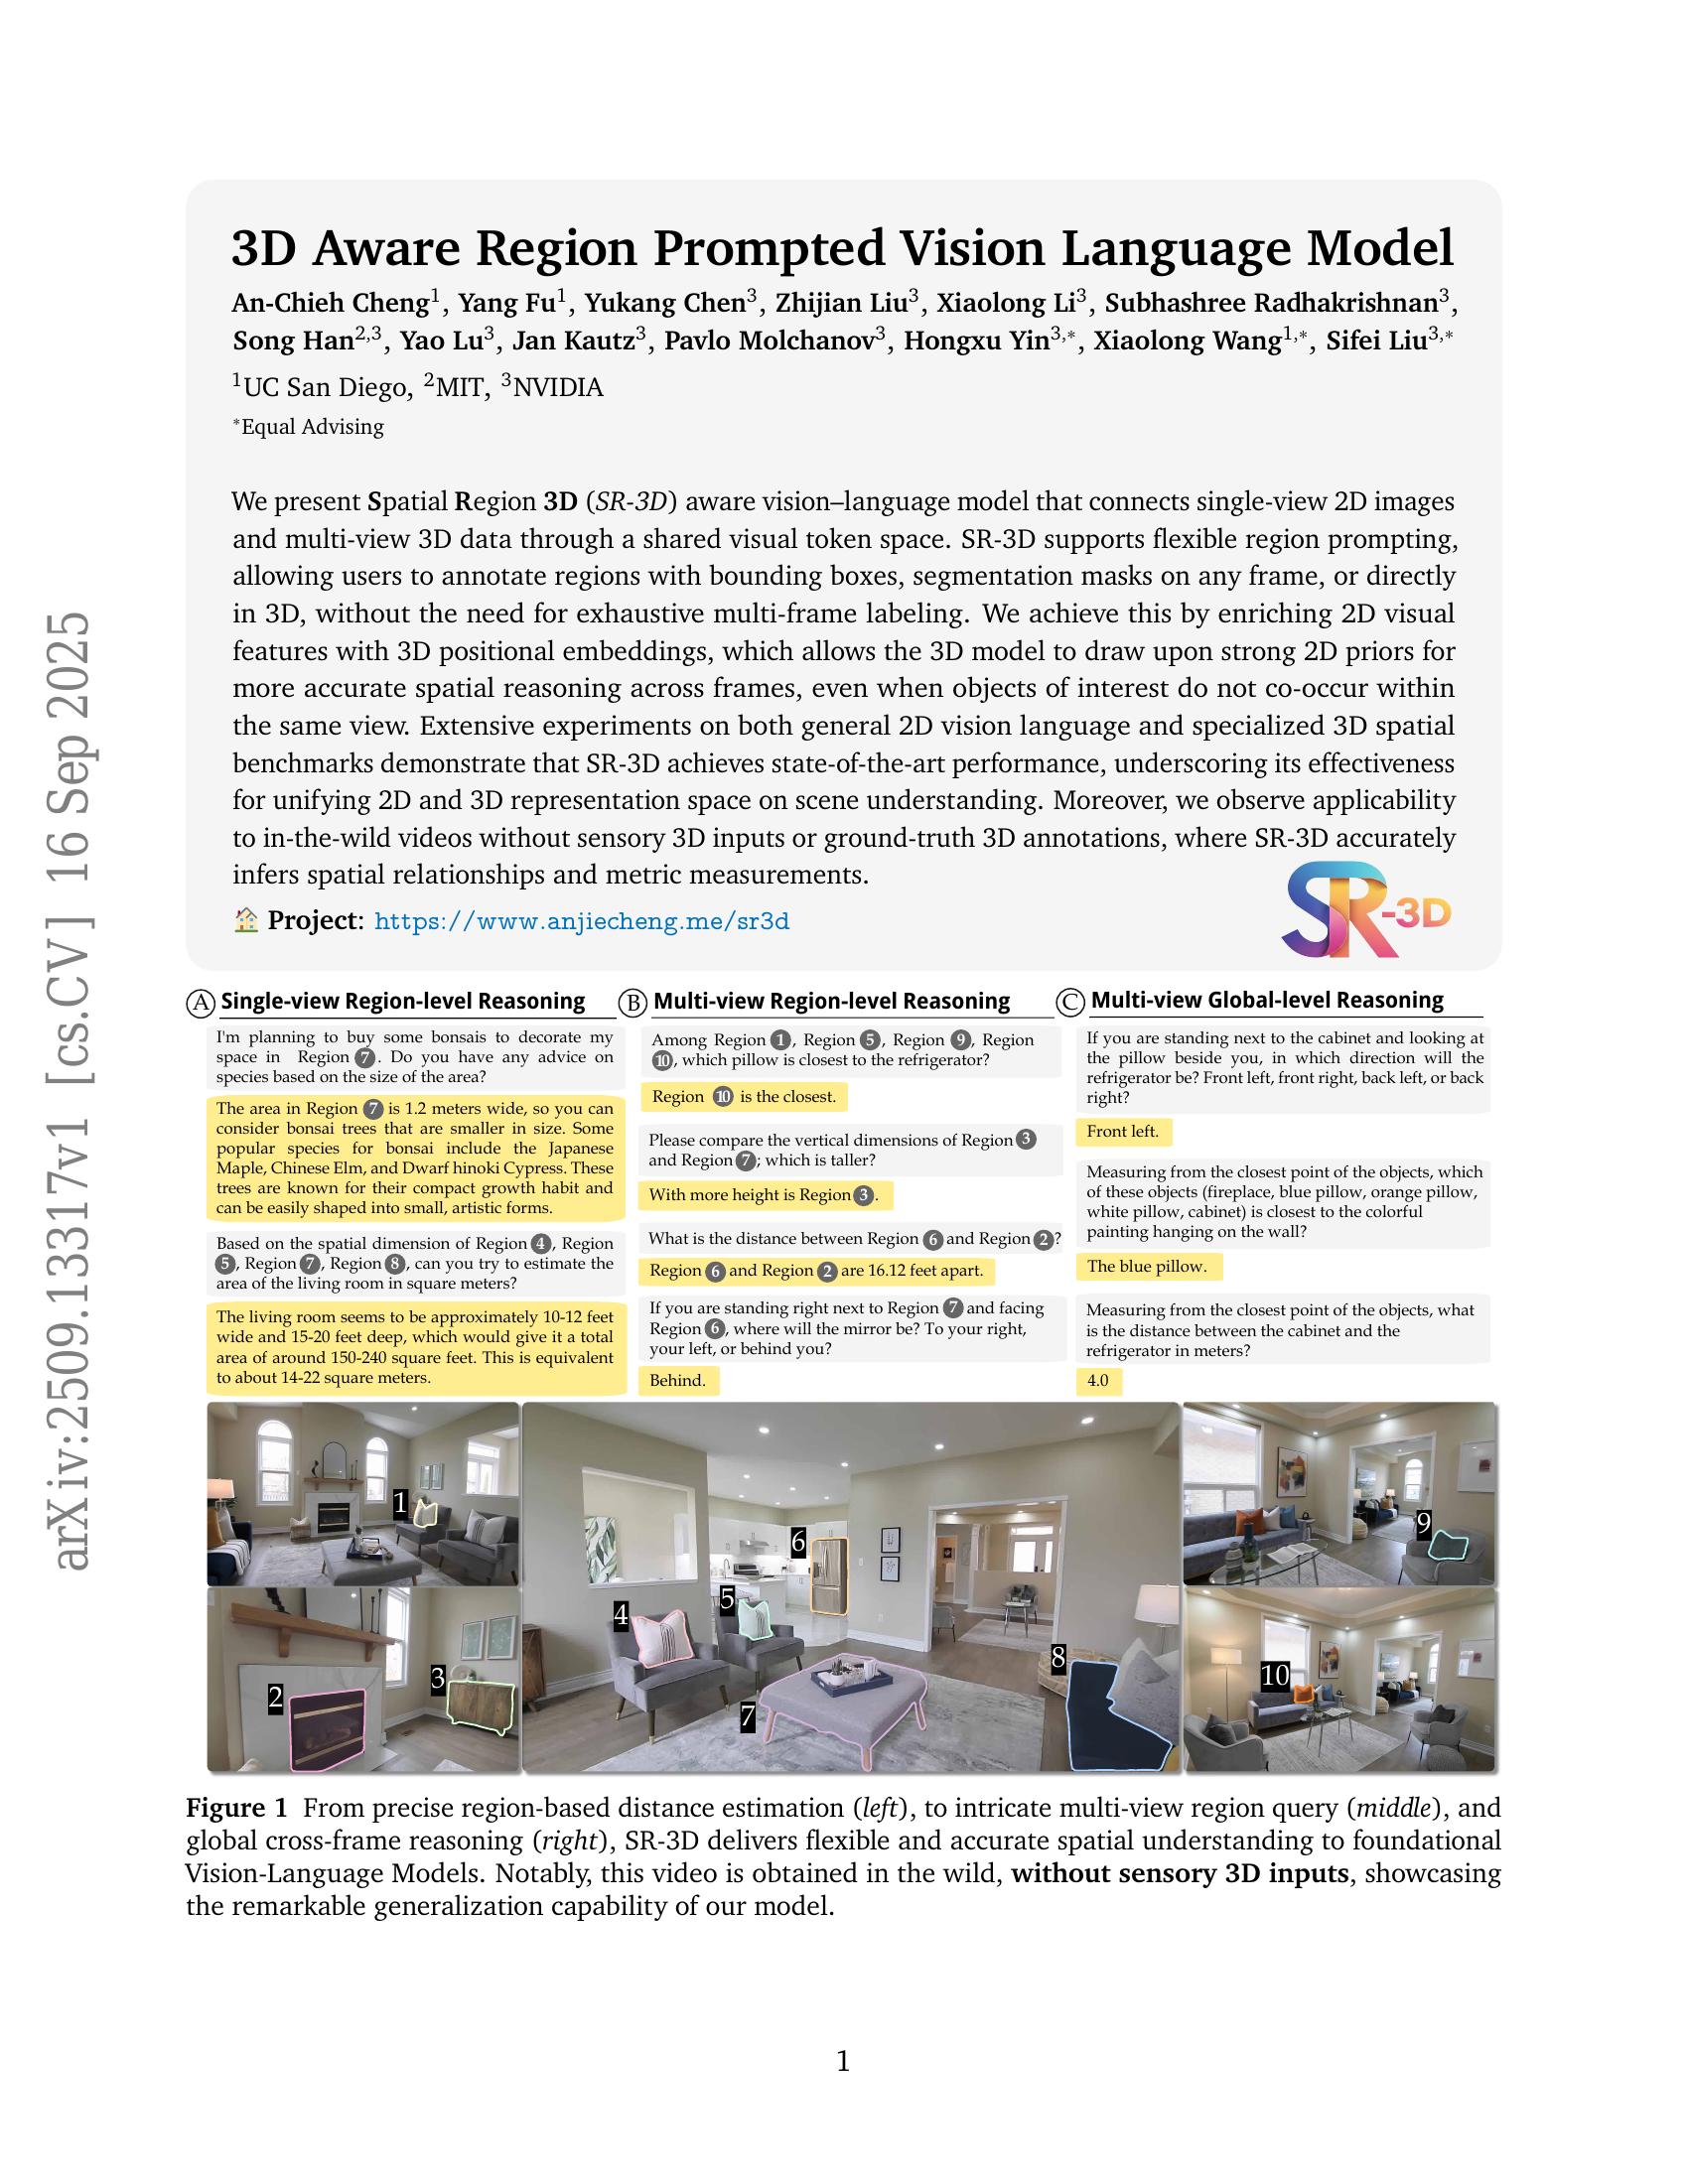
3D Aware Region Prompted Vision Language Model - 智源社区论文

Vision Language Action Models | PDF | Cognitive Science
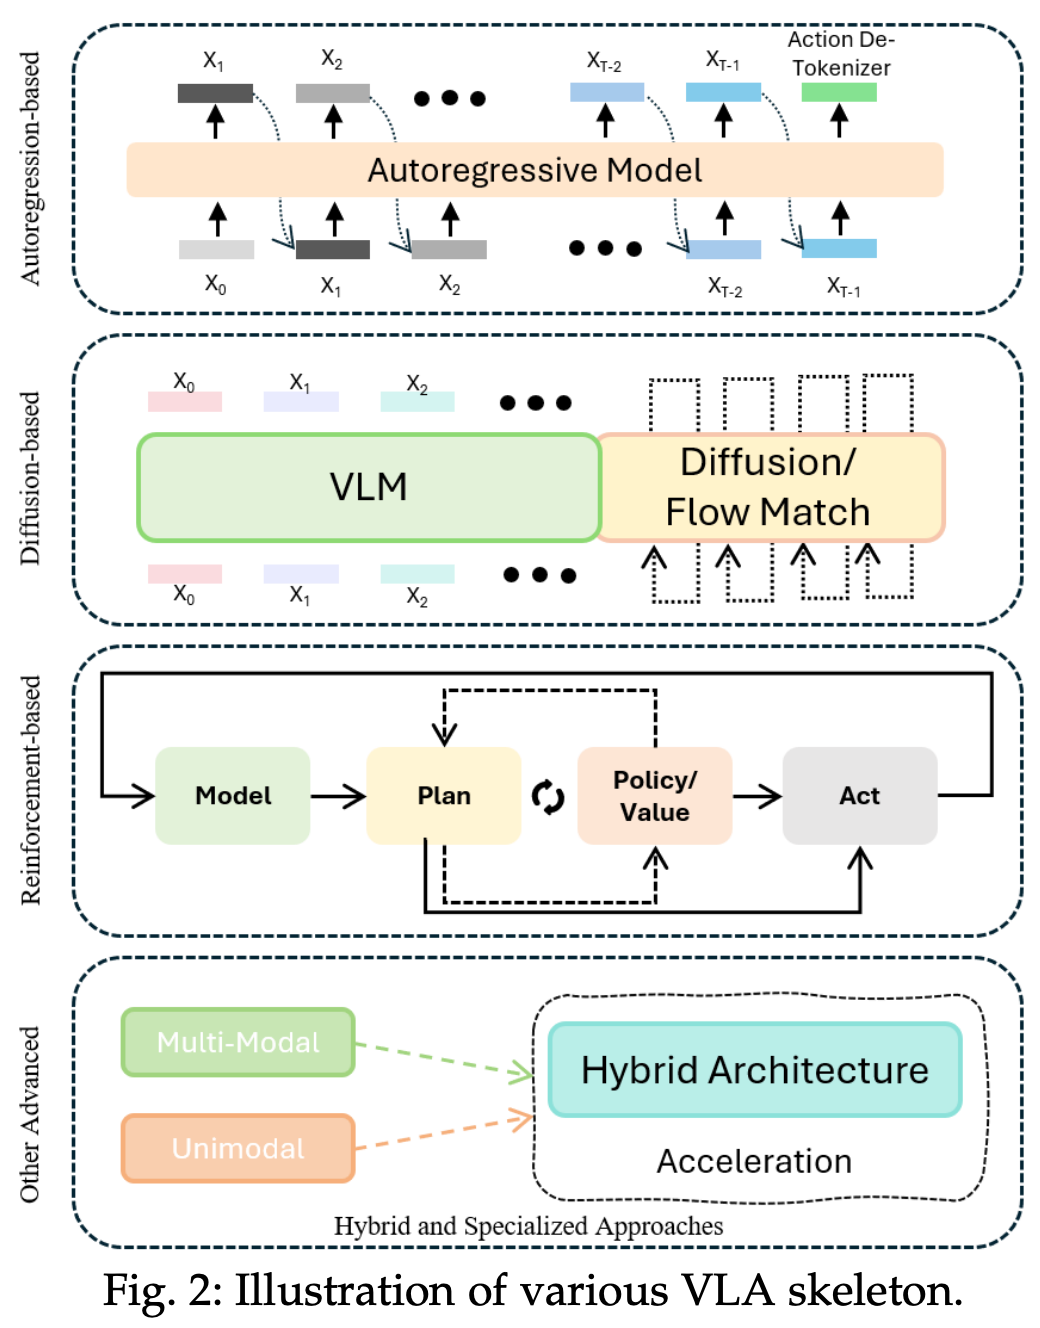
VLA 论文精读(三十四)Pure Vision Language Action (VLA) Models: A Comprehensive ...

Vision Language Action Models - OpenVLA, π0, RT-2, Gemini Robotics ...
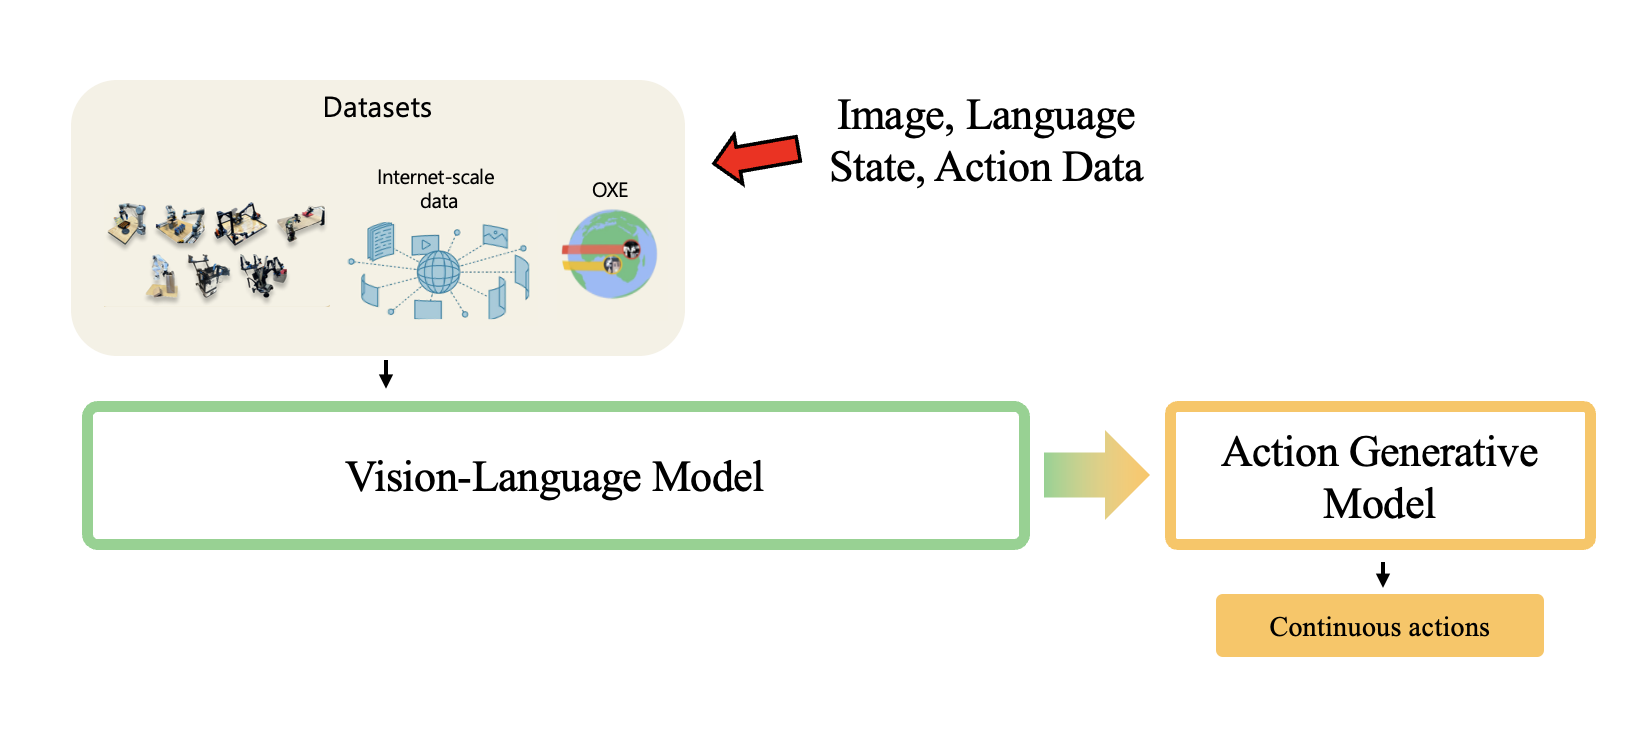
VLA (Vision Language Action model)란?

(PDF) Vision Language Action Models in Robotic Manipulation: A ...

3D-VLA - A 3D Vision-Language-Action Generative World Model | PDF

(PDF) Object-and-Action Aware Model for Visual Language Navigation
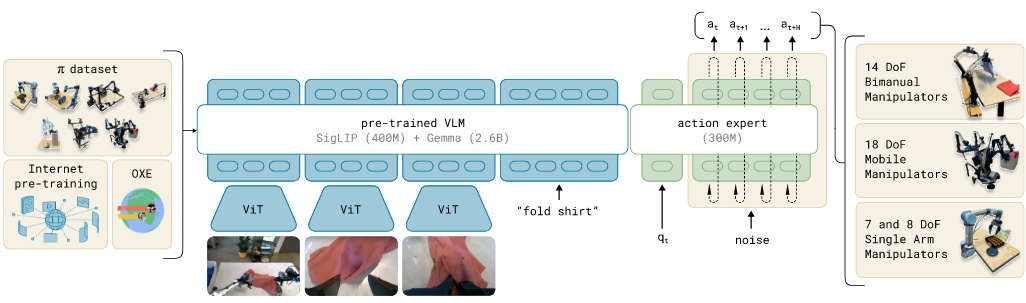
VLA (Vision Language Action model)란?
Advertisement Space (300x250)
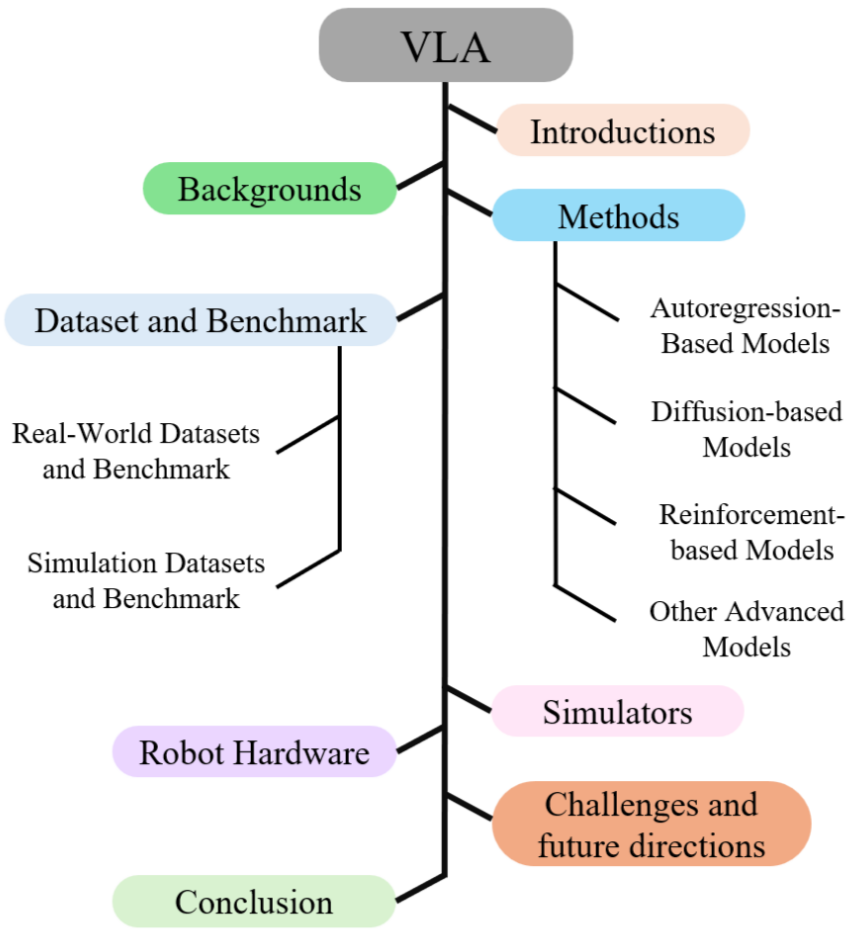
[논문 리뷰] Pure Vision Language Action (VLA) Models: A Comprehensive Survey
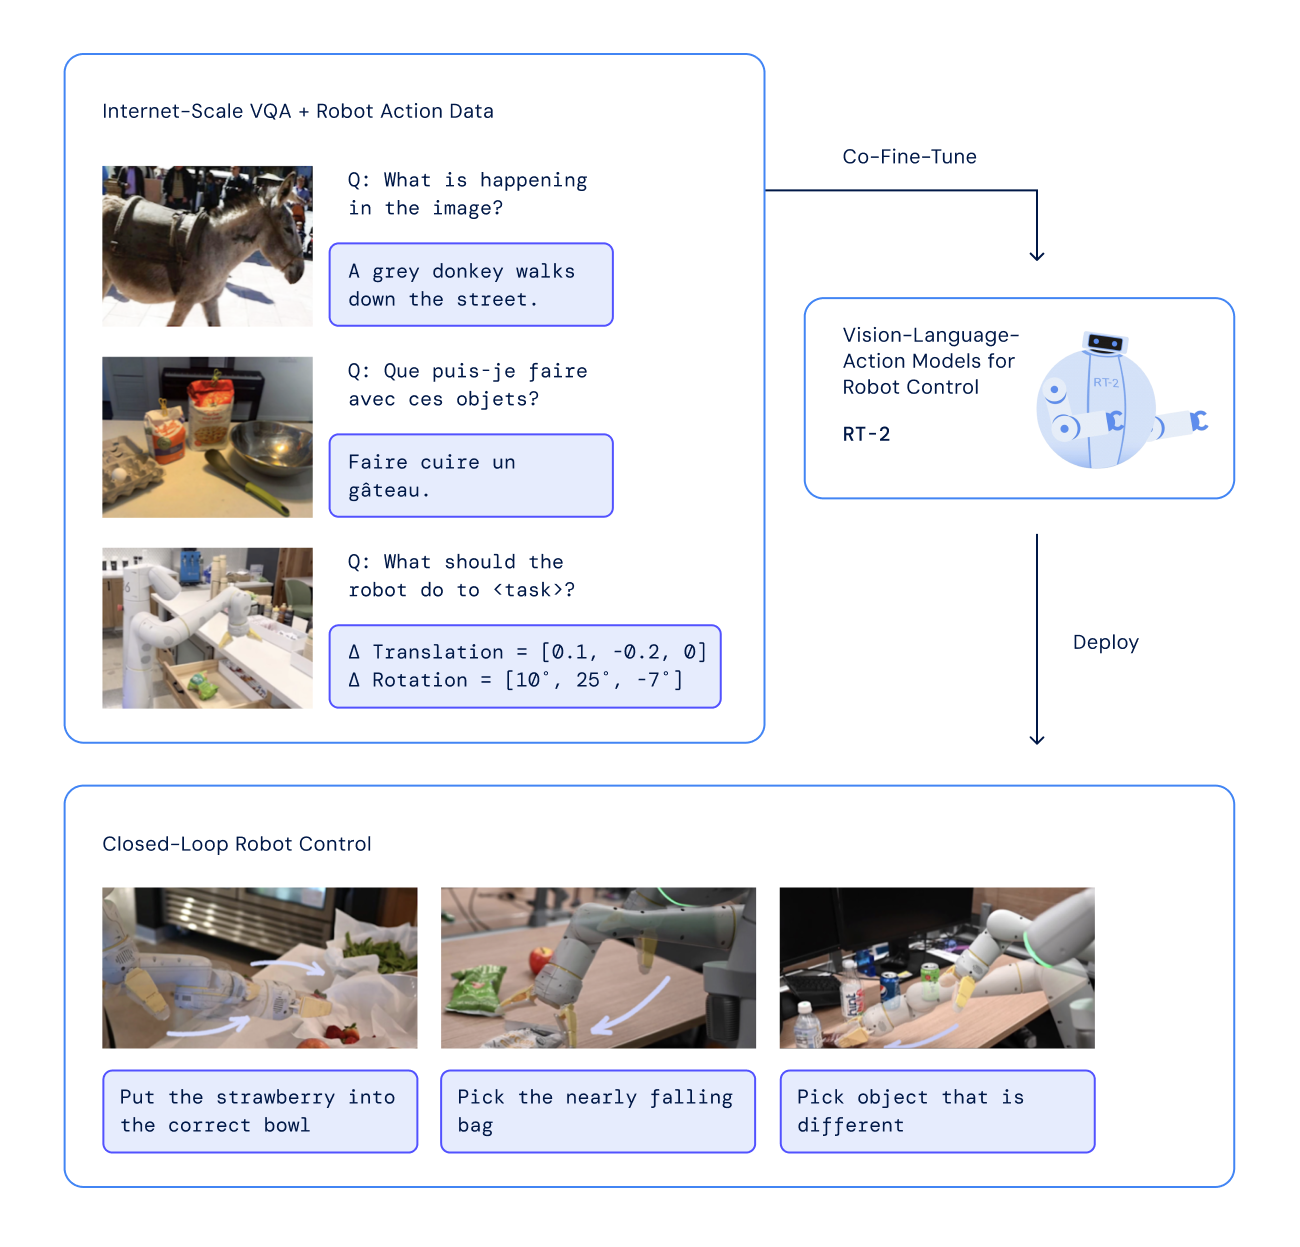
Vision Language Action Models (VLA) & Policies for Robots

Paper page - LLaDA-VLA: Vision Language Diffusion Action Models

LLaDA-VLA: Vision Language Diffusion Action Models | AI Research Paper ...
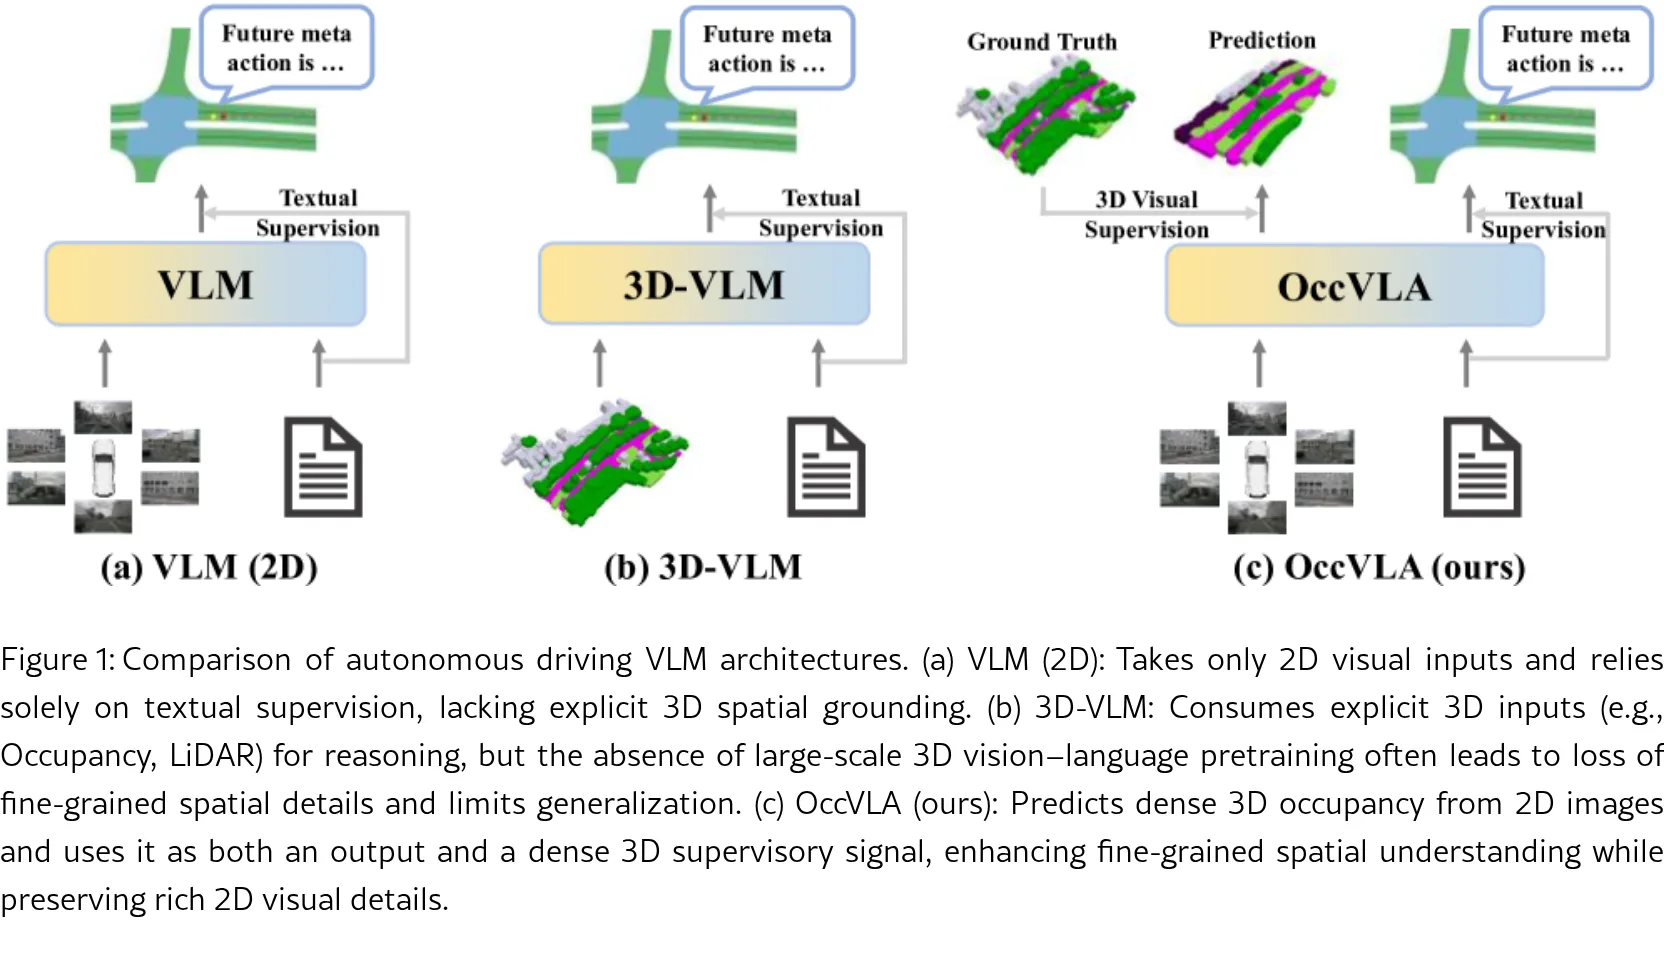
OccVLA: Vision-Language-Action Model with Implicit 3D Occupancy ...

3D-VLA: A 3D Vision-Language-Action Generative World Model [Quick Review]
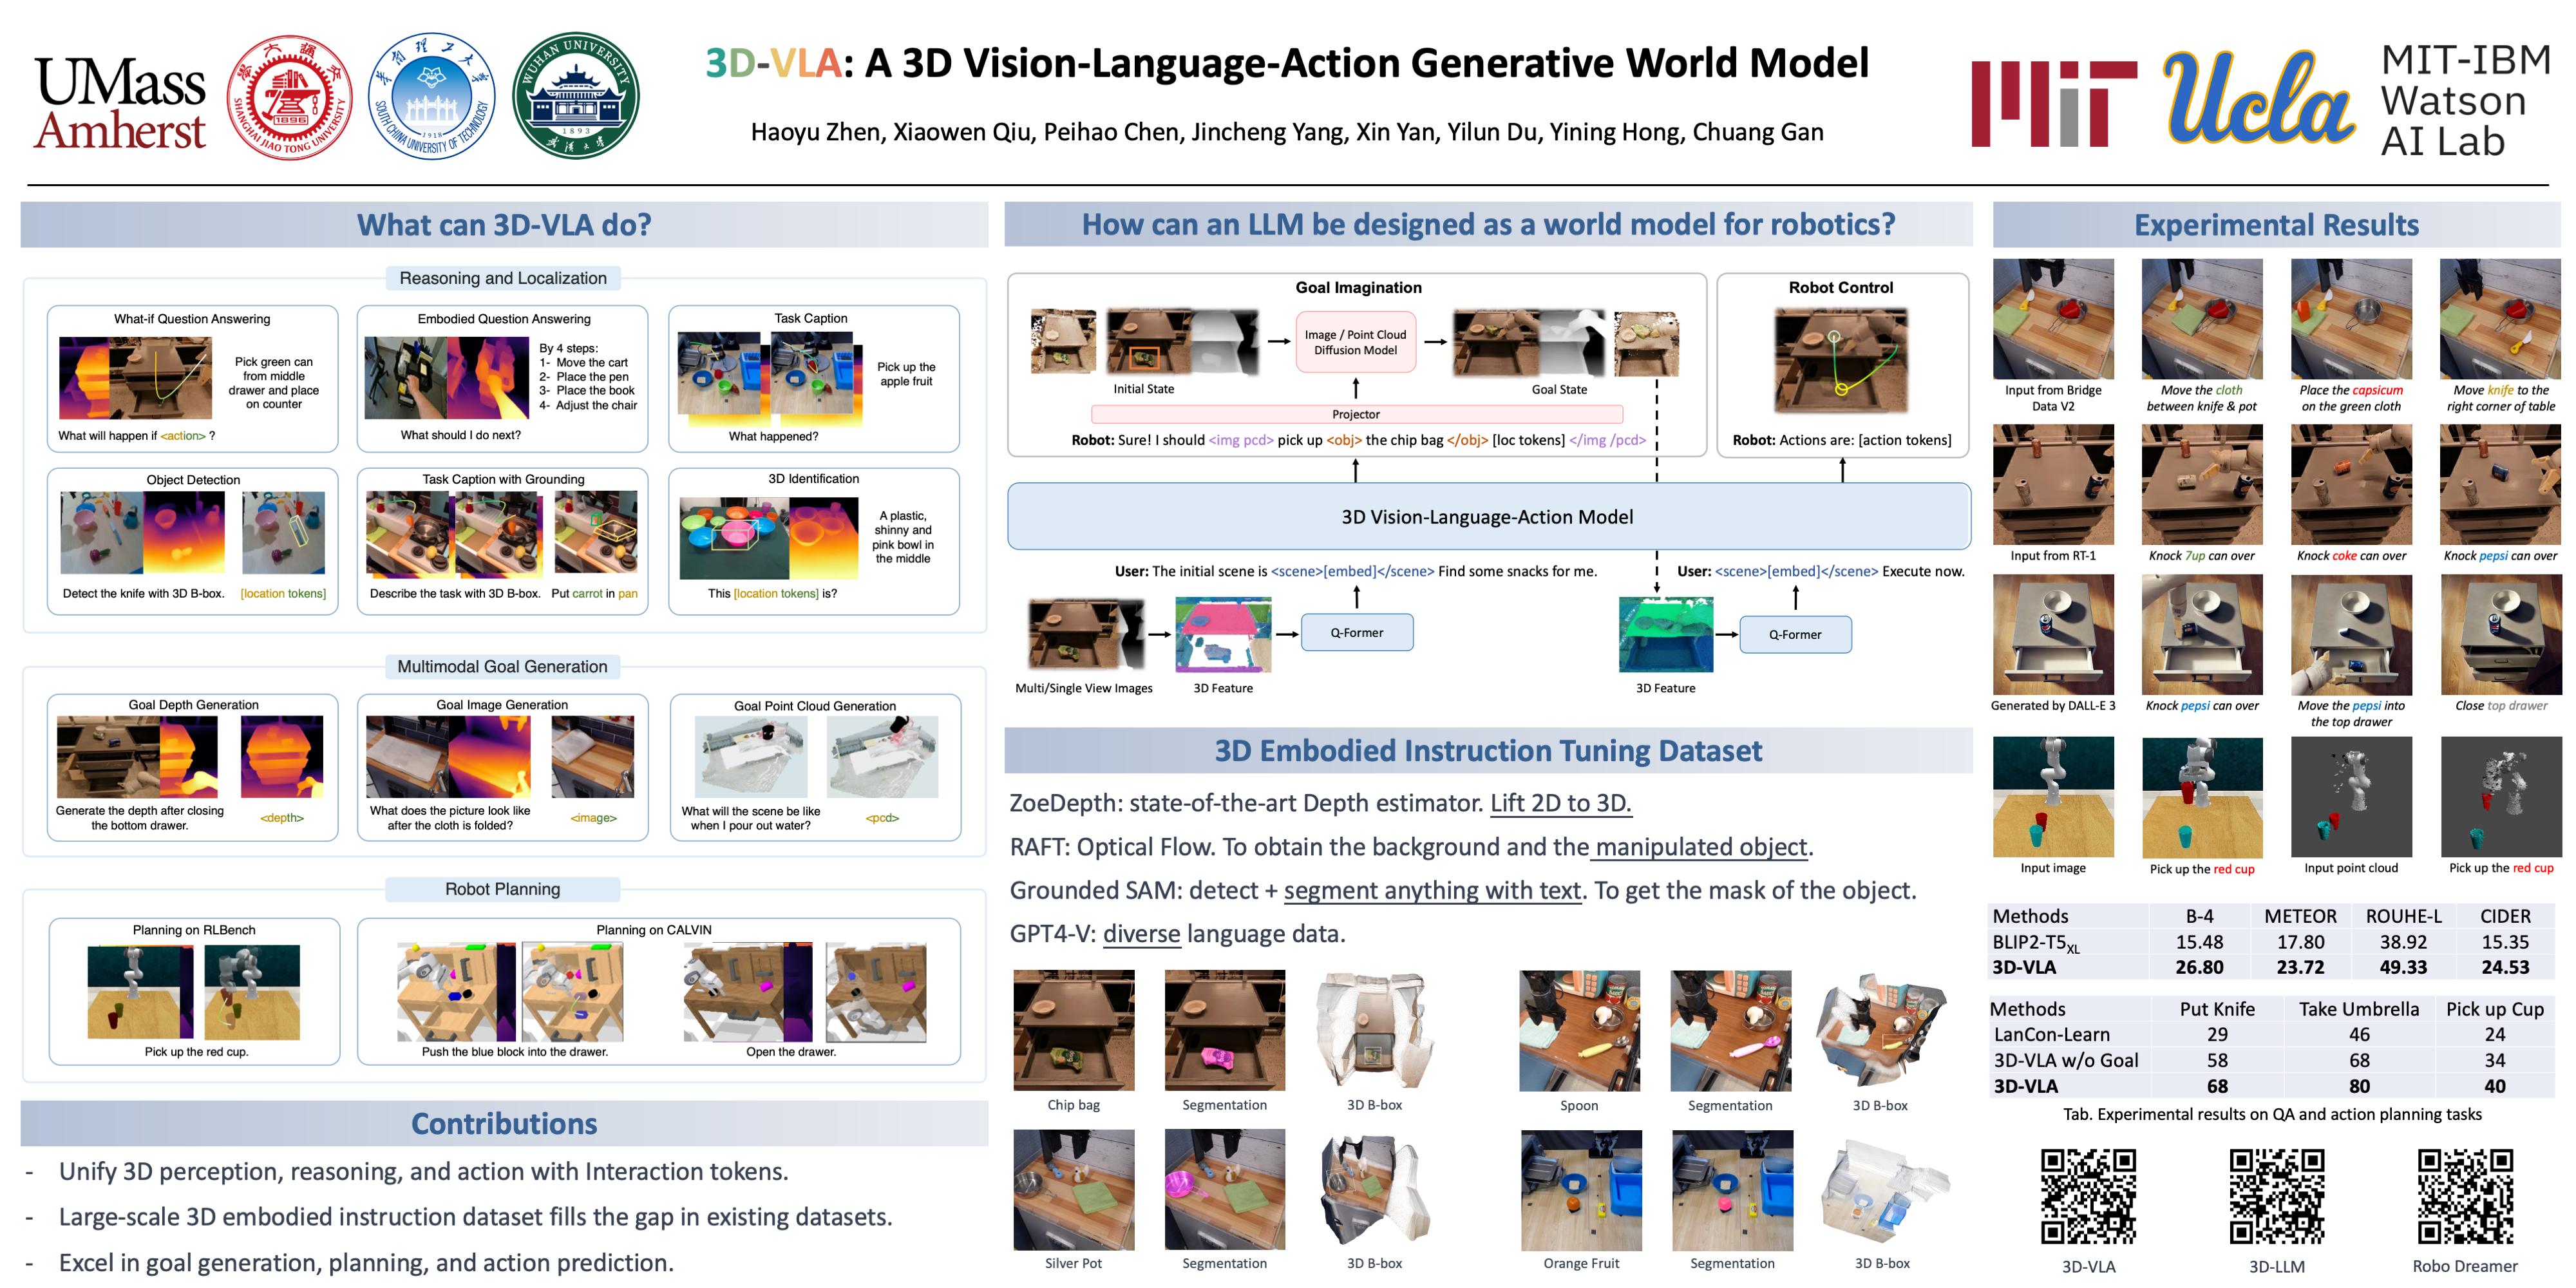
ICML Poster 3D-VLA: A 3D Vision-Language-Action Generative World Model

Paper page - 3D-VLA: A 3D Vision-Language-Action Generative World Model
3D-VLA: A 3D Vision-Language-Action Generative World Model [Quick Review]

The Ultimate Guide to Visual Language Action Models (VLAM)
Advertisement Space (336x280)

Paper page - OccVLA: Vision-Language-Action Model with Implicit 3D ...

GST-VLA: Structured Gaussian Spatial Tokens for 3D Depth-Aware Vision ...
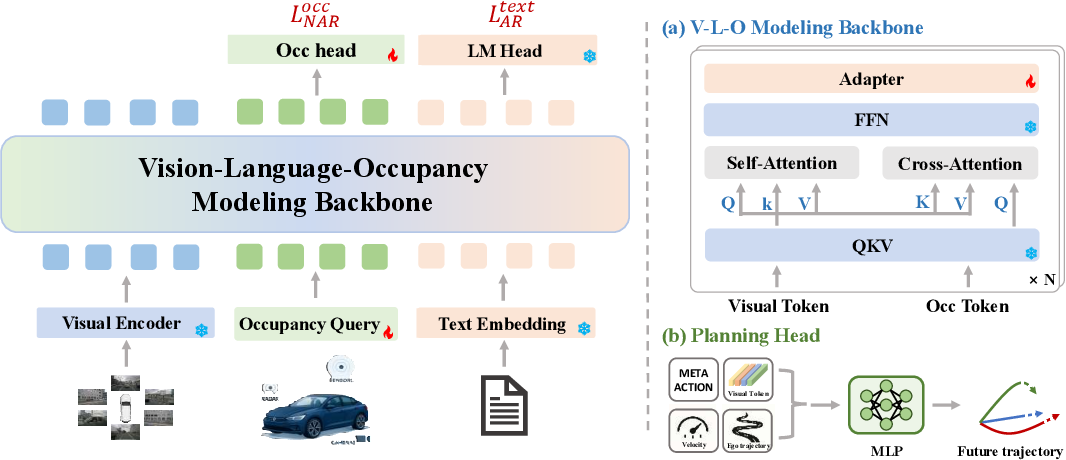
Figure 2 from OccVLA: Vision-Language-Action Model with Implicit 3D ...

GraphCoT-VLA: A 3D Spatial-Aware Reasoning Vision-Language-Action Model ...

GeoAware-VLA: Implicit Geometry Aware Vision-Language-Action Model | AI ...

3D-VLA: A 3D Vision-Language-Action Generative World Model

GST-VLA: Structured Gaussian Spatial Tokens for 3D Depth-Aware Vision ...

Paper page - Unified Diffusion VLA: Vision-Language-Action Model via ...

Vision Language Modelと完全自動運転AIの最新動向 - Speaker Deck
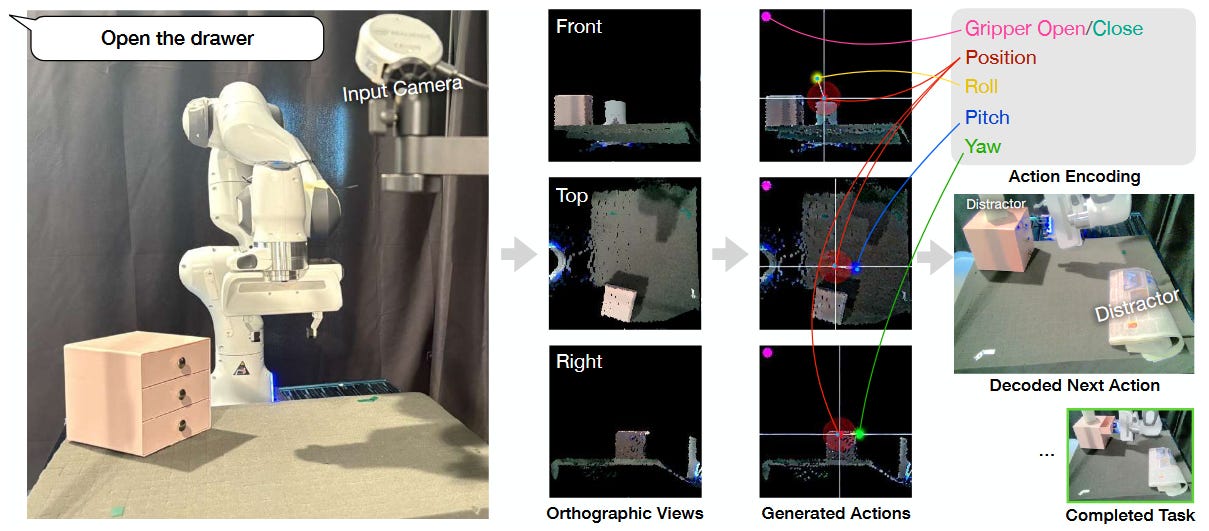
Interesting Directions in Vision-Language-Action Model Research
Advertisement Space (336x280)
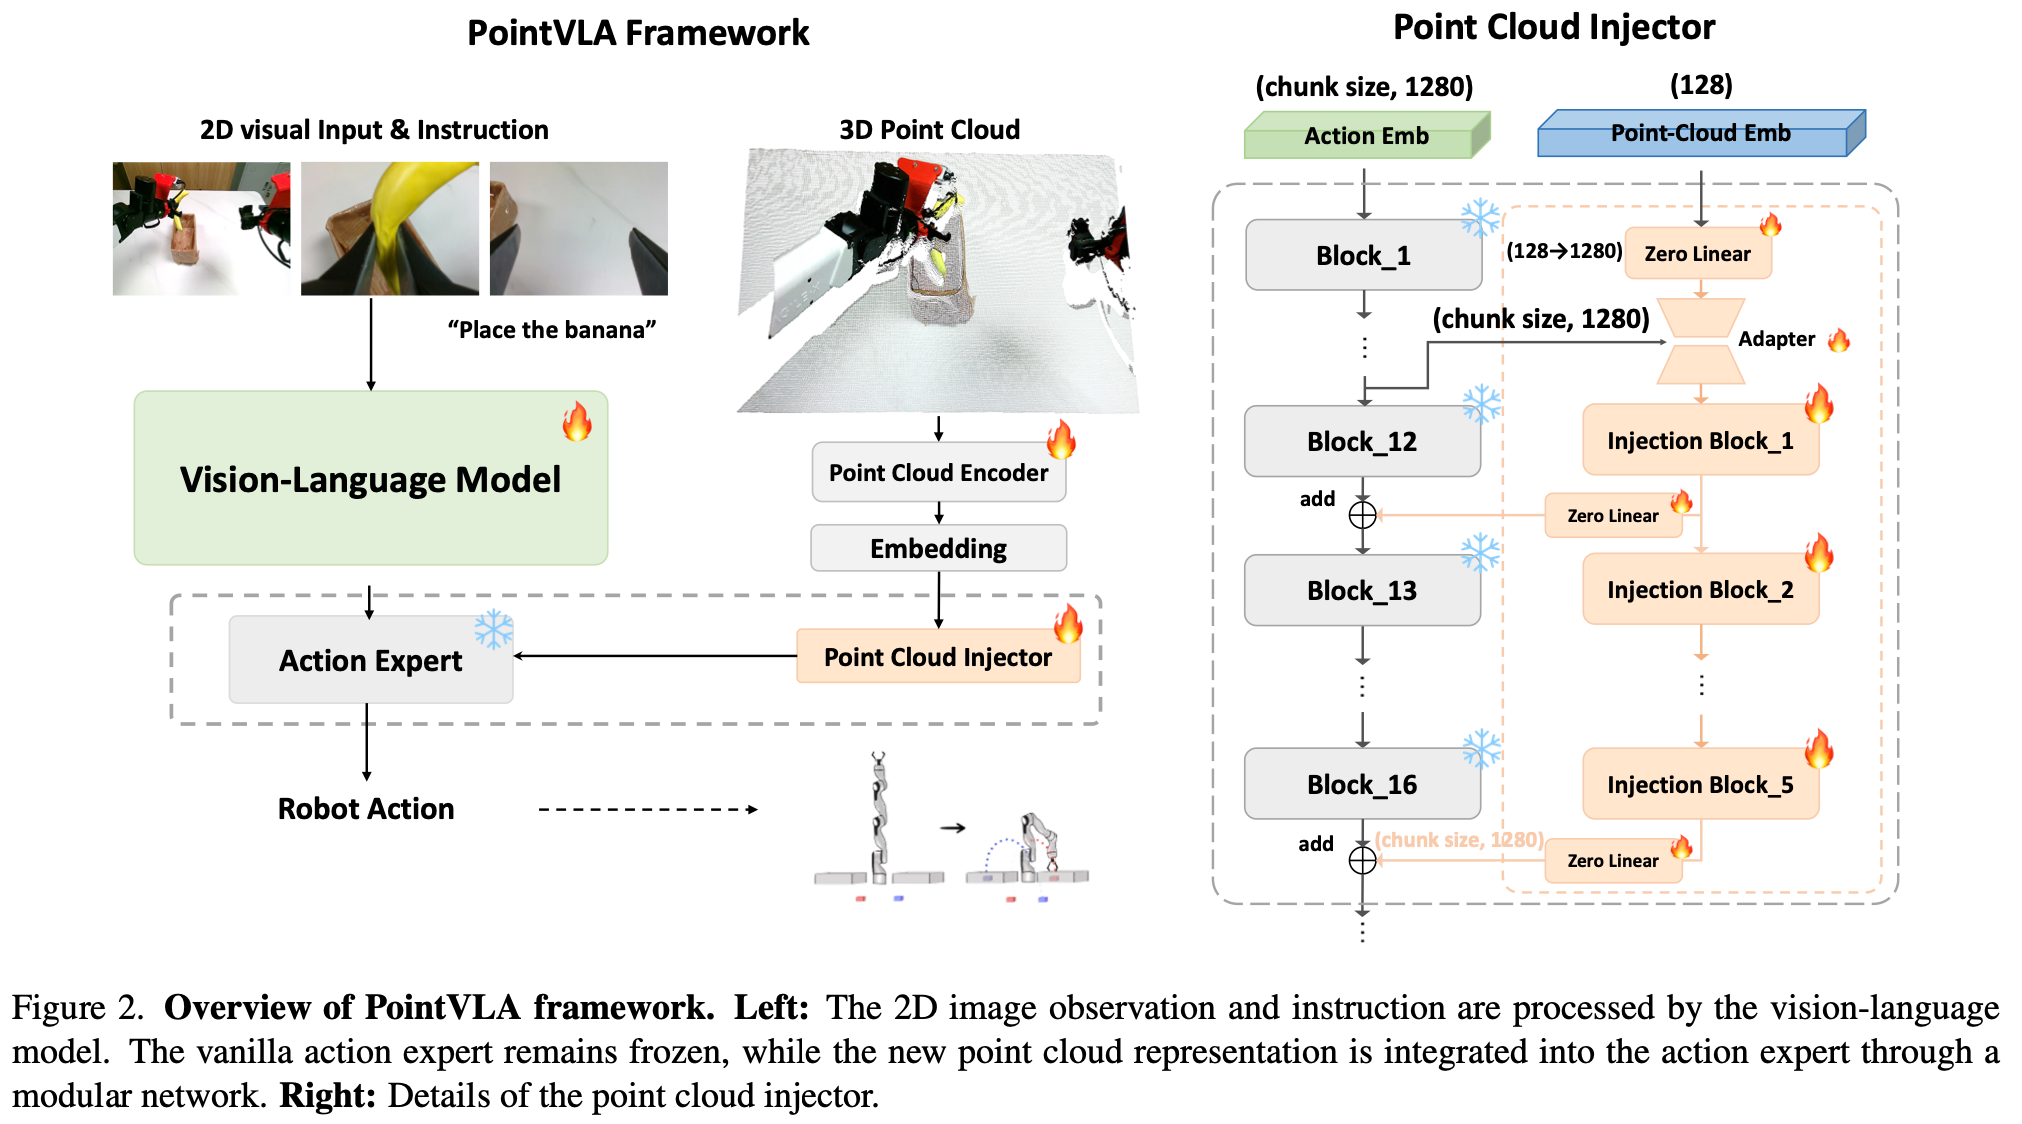
VLA论文精读(十四)PointVLA: Injecting the 3D World into Vision-Language-Action ...

Vizuara VLA Bootcamp | Vision-Language-Action for Autonomous Driving

[Revisión de artículo] SafeVLA: Towards Safety Alignment of Vision ...

[논문 리뷰] Unified Vision-Language-Action Model

(PDF) VLA-Arena: An Open-Source Framework for Benchmarking Vision ...

Bridging the Gap: How 3DS-VLA Brings 3D Awareness to 2D Robot Brains ...