
Pdf Optimizing Transformer Models For Low Latency Inference

(PDF) Optimizing Transformer Models for Low-Latency Inference ...

Low Latency Transformer Inference on FPGAs for Physics Applications ...

[论文评述] Low Latency Transformer Inference on FPGAs for Physics ...
Optimizing Inference Latency for Deep Learning Models in Cloud ...
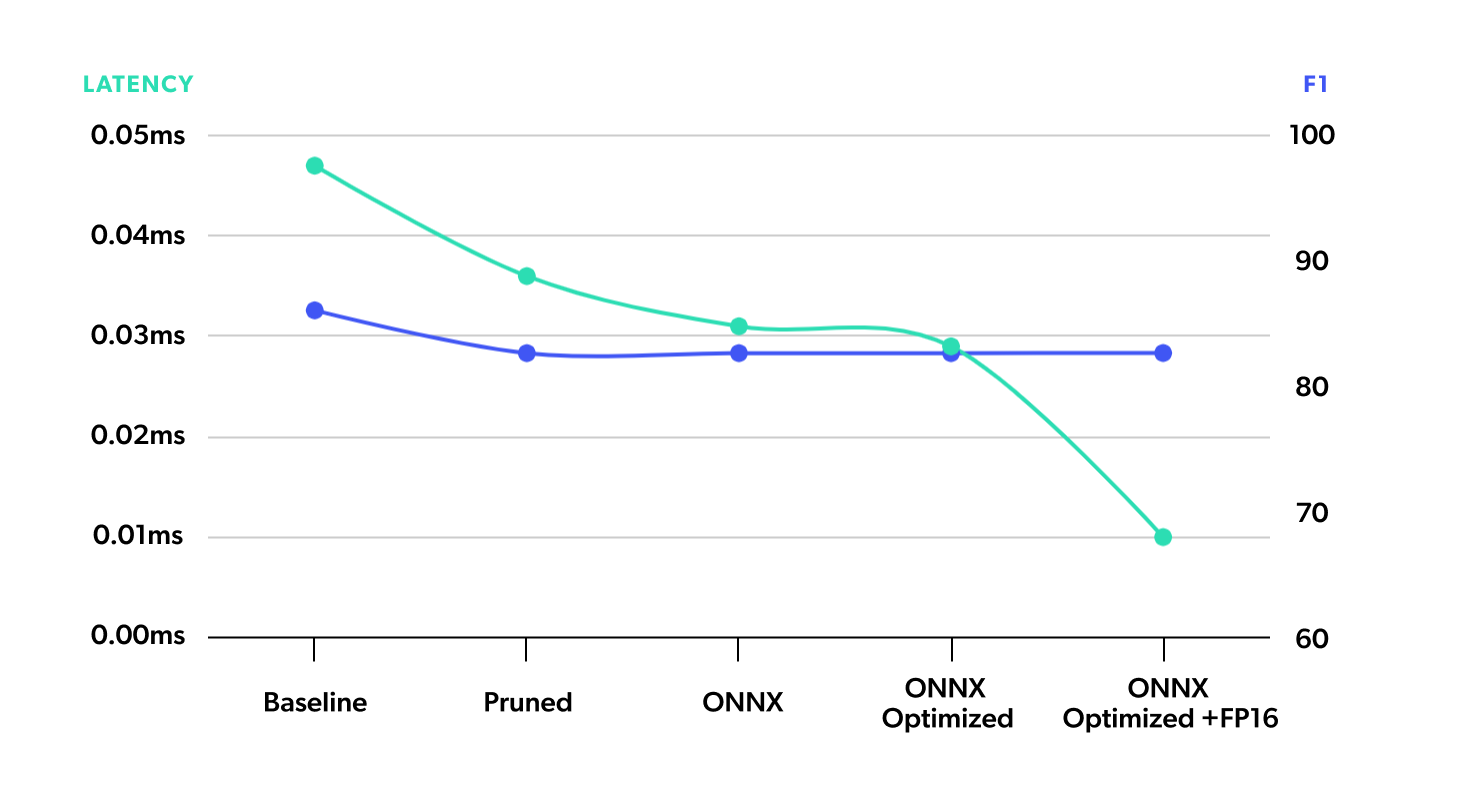
A guide to optimizing Transformer-based models for faster inference ...
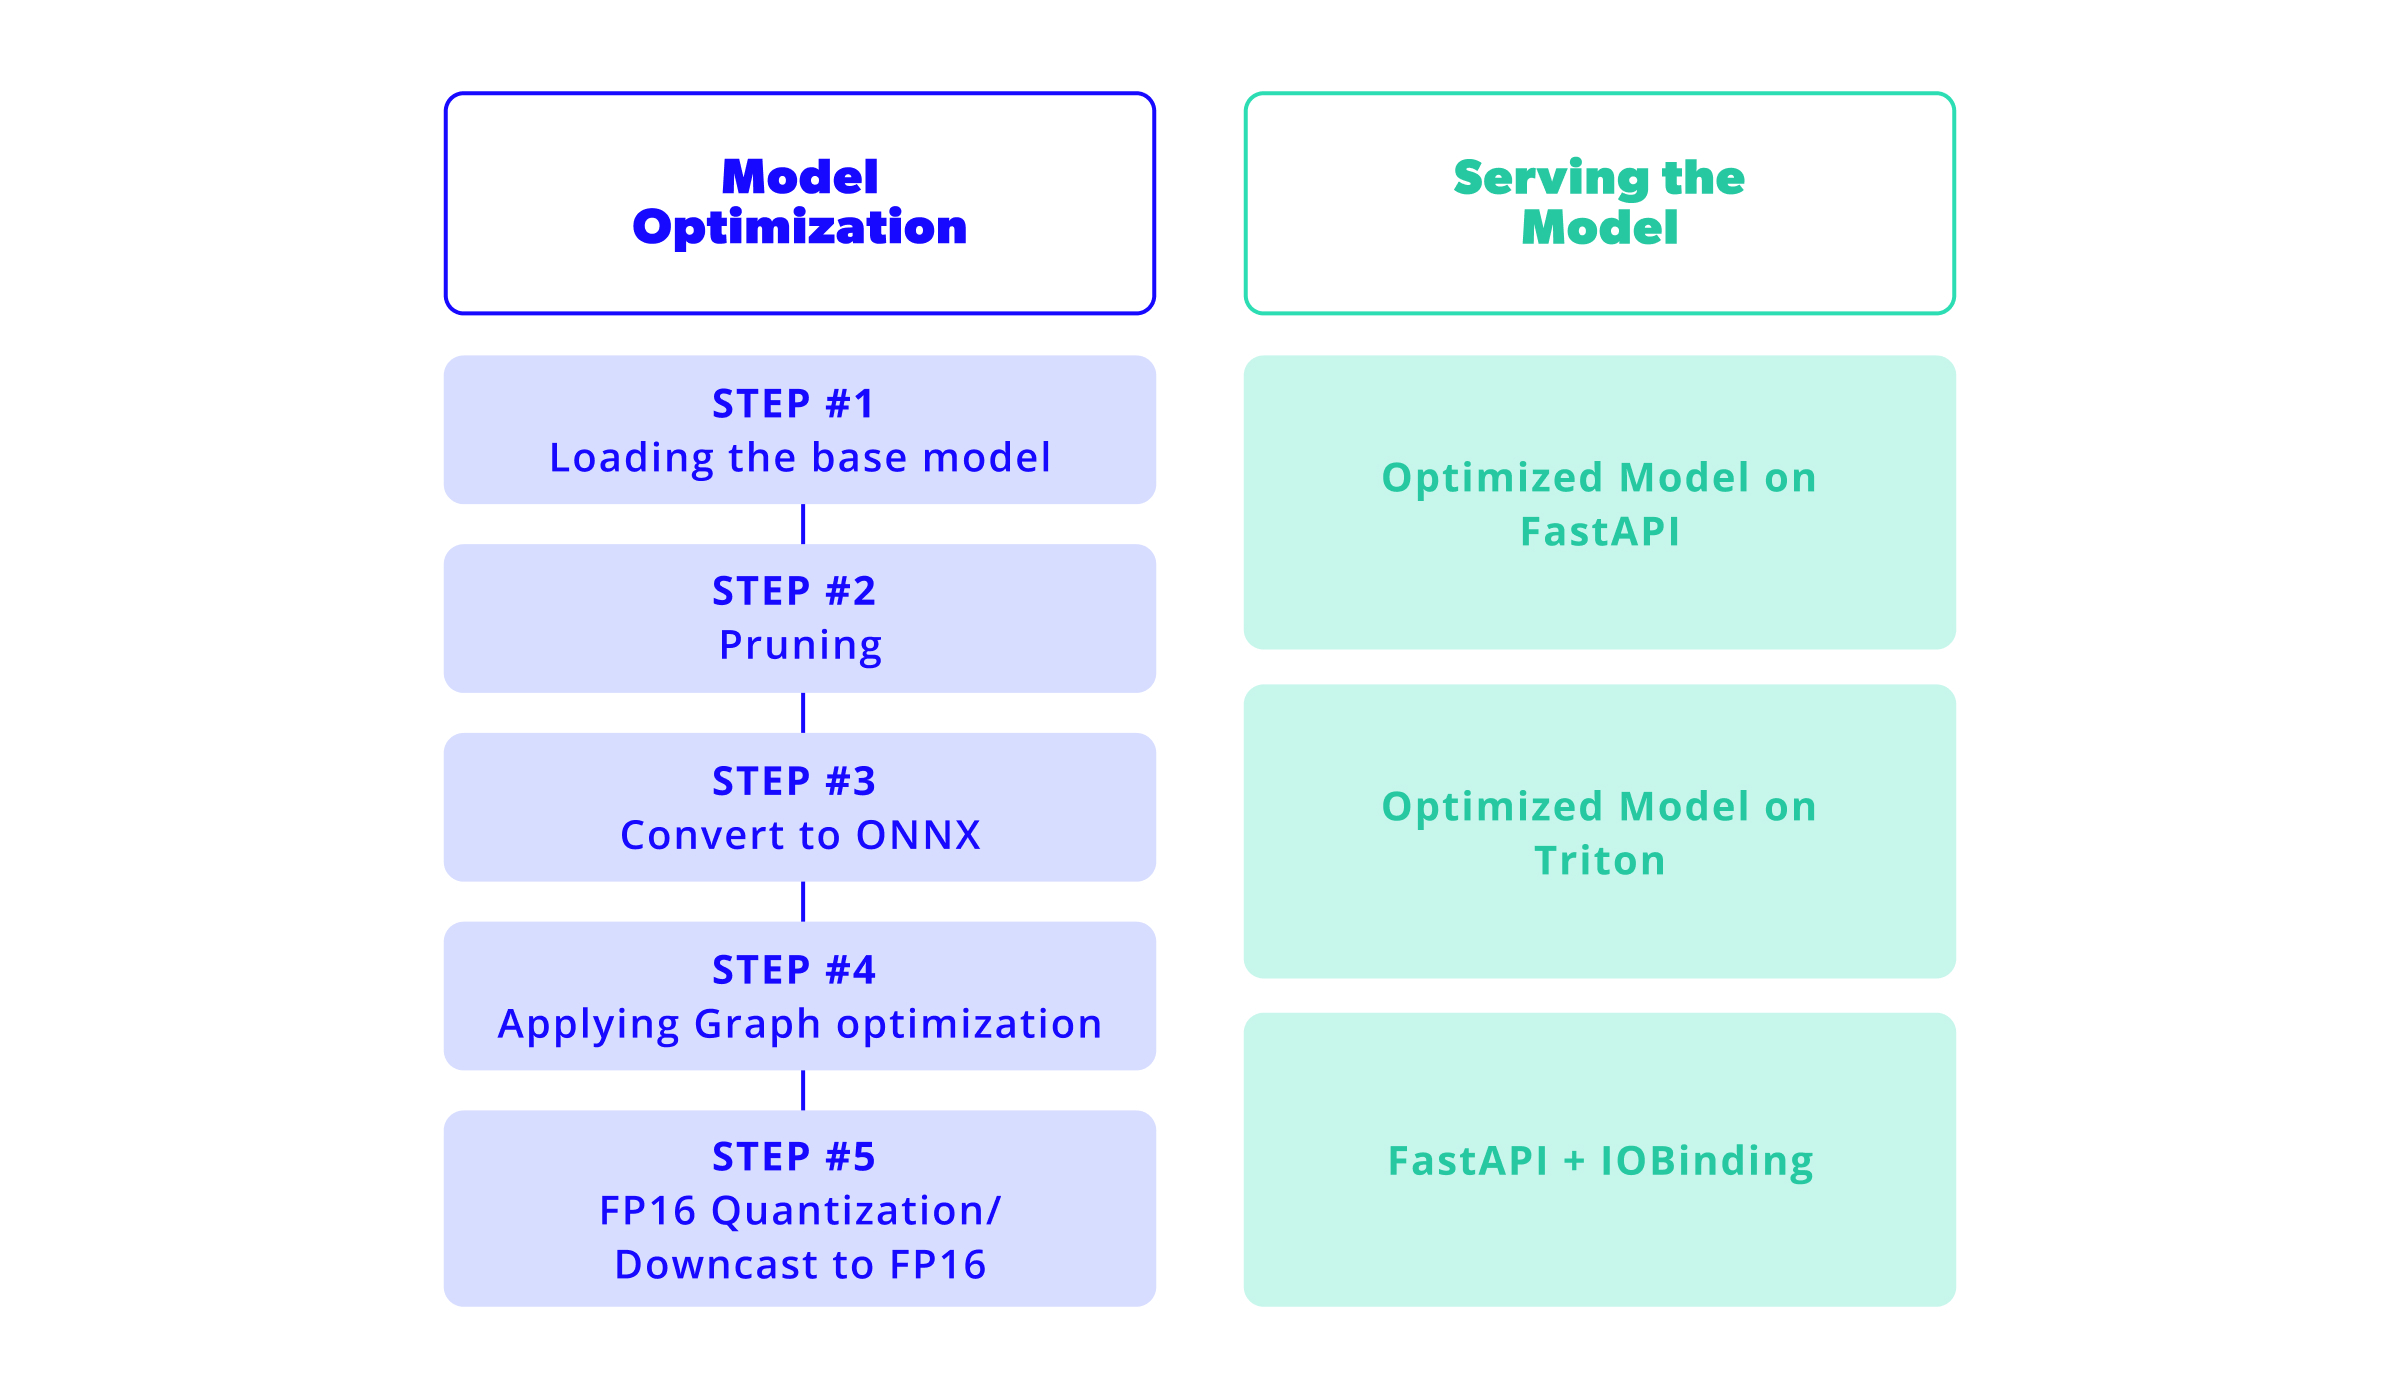
A Guide to Optimizing Transformer-based Models for Faster Inference ...

(PDF) Low Latency Deep Learning Inference Model for Distributed ...

Figure 2 from LOW LATENCY DEEP LEARNING INFERENCE MODEL FOR DISTRIBUTED ...
A Guide to Optimizing Transformer-based Models for Faster Inference ...

Figure 3 from LOW LATENCY DEEP LEARNING INFERENCE MODEL FOR DISTRIBUTED ...
Advertisement Space (300x250)

Integrated Robust Optimization for Lightweight Transformer Models in ...
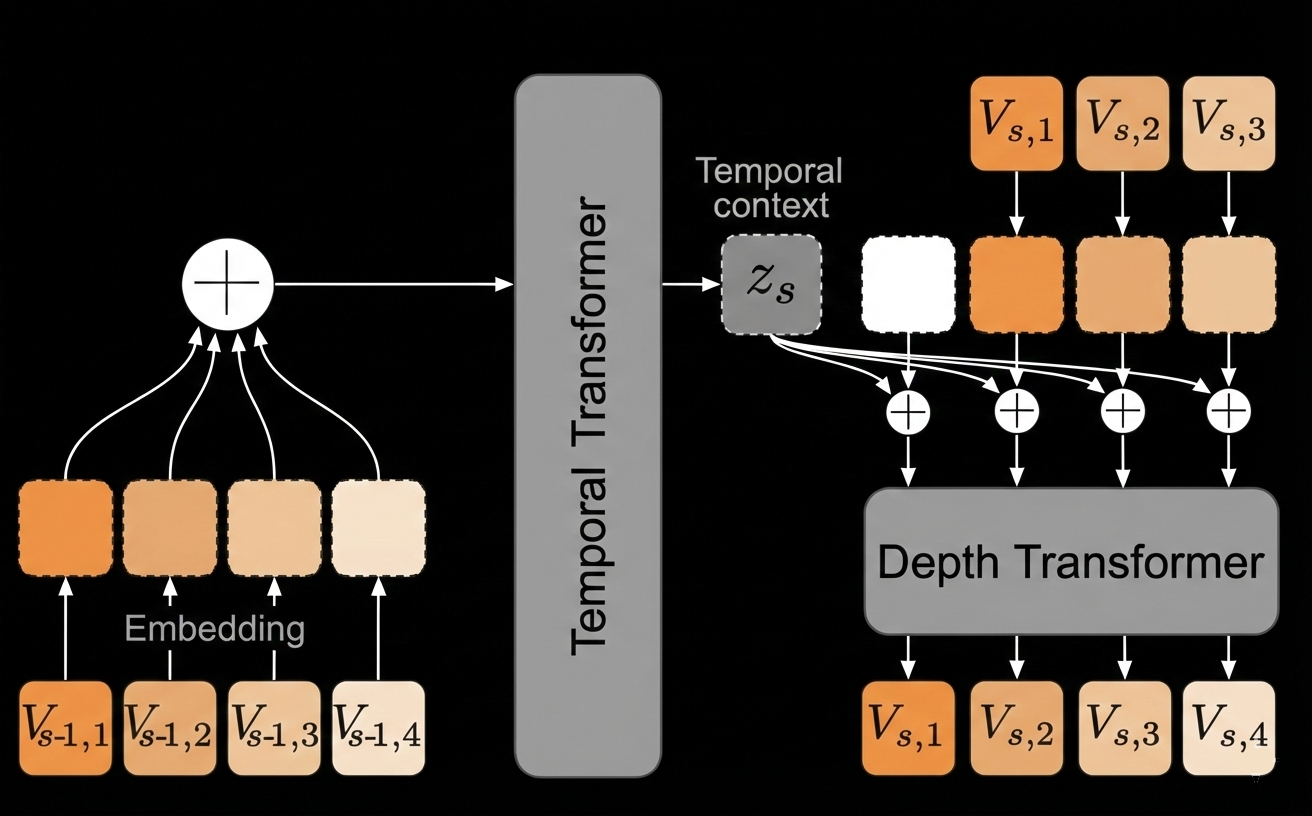
Optimizing Quality vs. Latency in Real-Time Text-to-Speech AI Models ...

Integrated Robust Optimization for Lightweight Transformer Models in ...

(PDF) Understanding INT4 Quantization for Transformer Models: Latency ...

(PDF) Optimizing Transformer for Low-Resource Neural Machine Translation

(PDF) A Study on Inference Latency for Vision Transformers on Mobile ...

(PDF) TrIMS: Transparent and Isolated Model Sharing for Low Latency ...

Transformer Models in NLP | PDF | Artificial Intelligence ...

Integrated Robust Optimization for Lightweight Transformer Models in ...

Transformer Modeling for Low-Frequency Transients | PDF | Transformer ...
Advertisement Space (336x280)

Overview of Transformer Models in NLP | PDF | Artificial Intelligence ...

(PDF) Optimizing On-Device Model Adaptation with Minimal Latency for ...
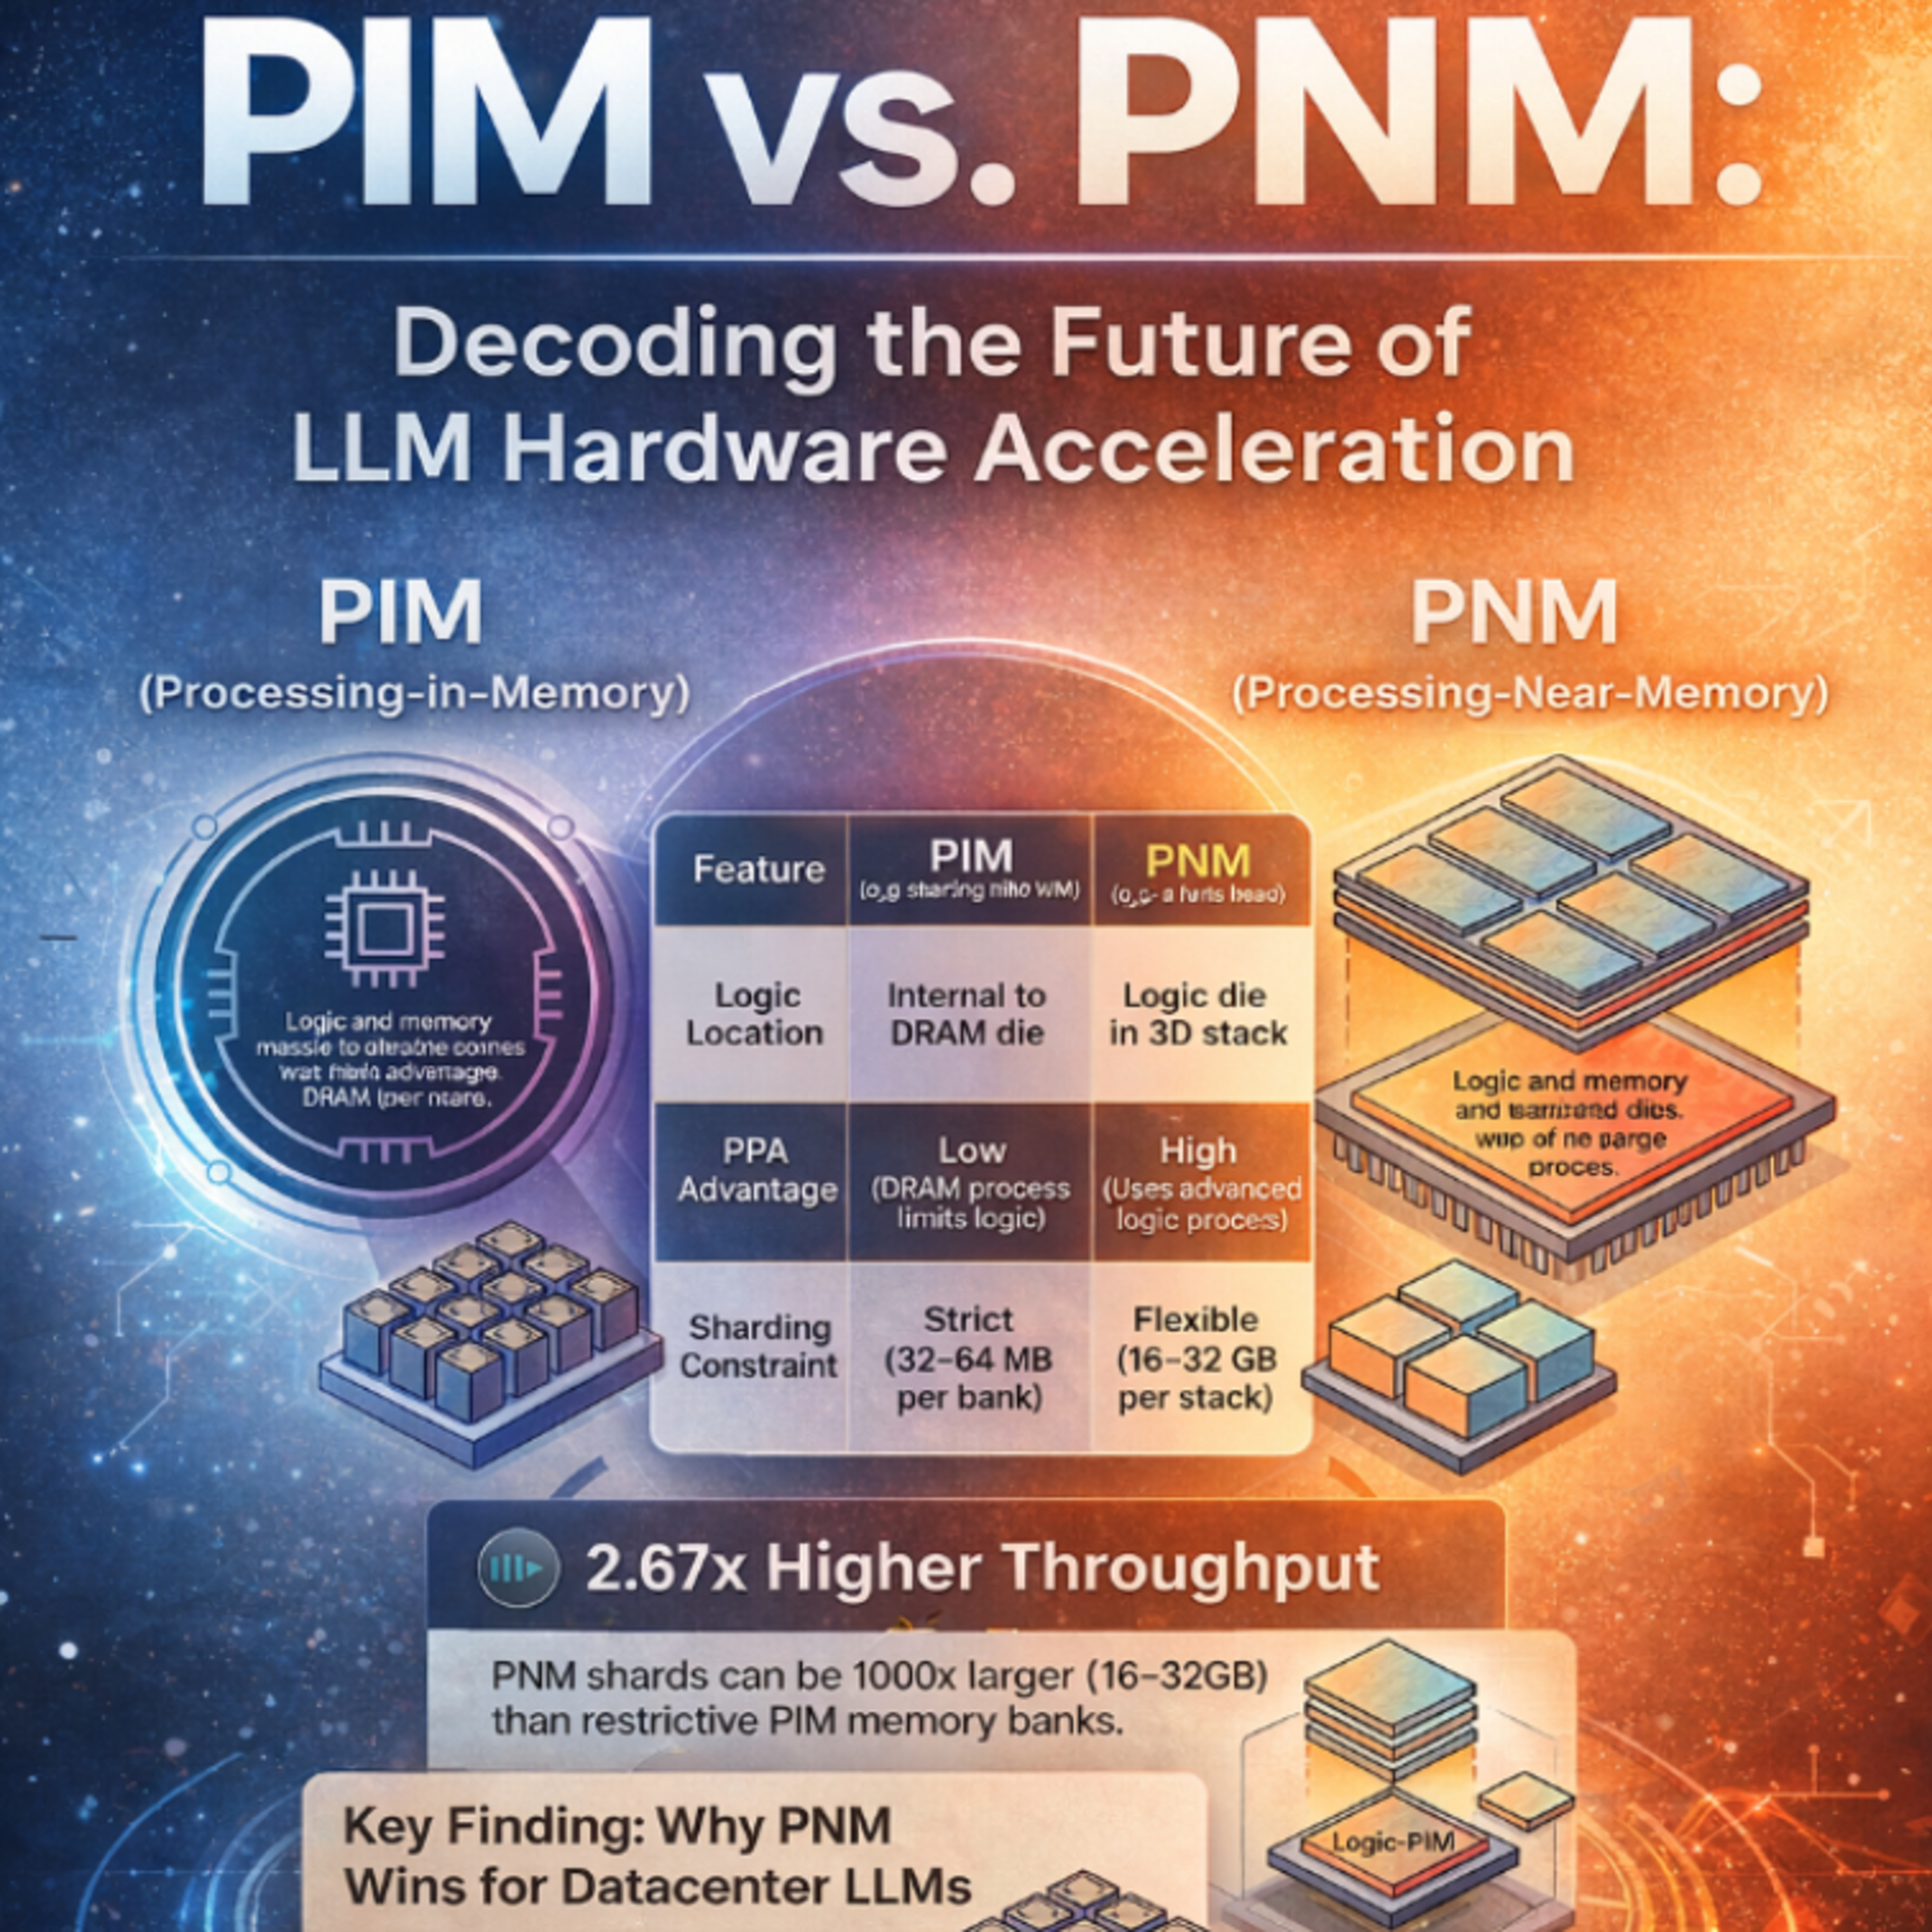
Google: R&D inference value on HBF + PNM + low latency interconnect ...

Understanding Transformer Models | PDF | Applied Linguistics | Computing
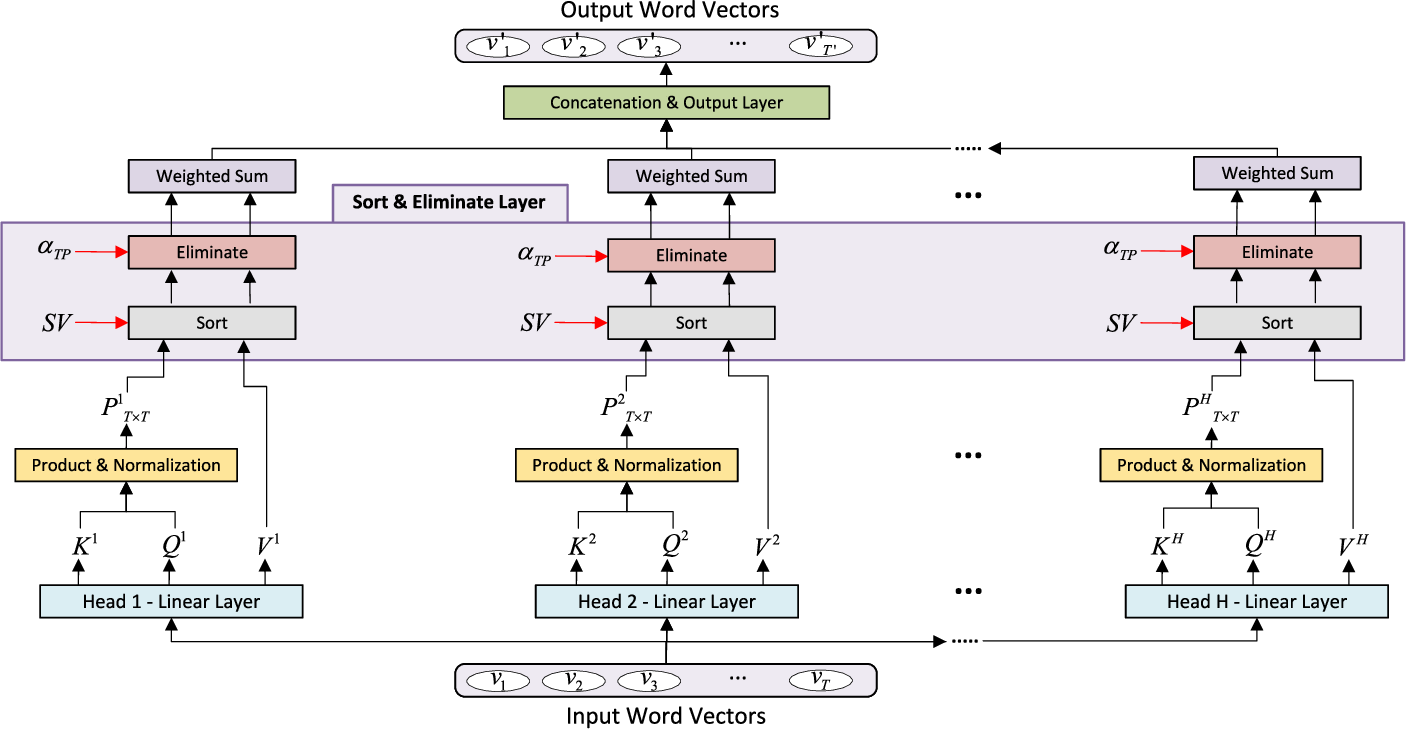
Figure 5 from Latency Adjustable Transformer Encoder for Language ...

Ferroelectric Vertical Low energy Low latency low volume Modules fOr ...

Paper page - Latency Adjustable Transformer Encoder for Language ...

(PDF) Optimizing LLM Latency and Throughput for Interactive Web Interfaces
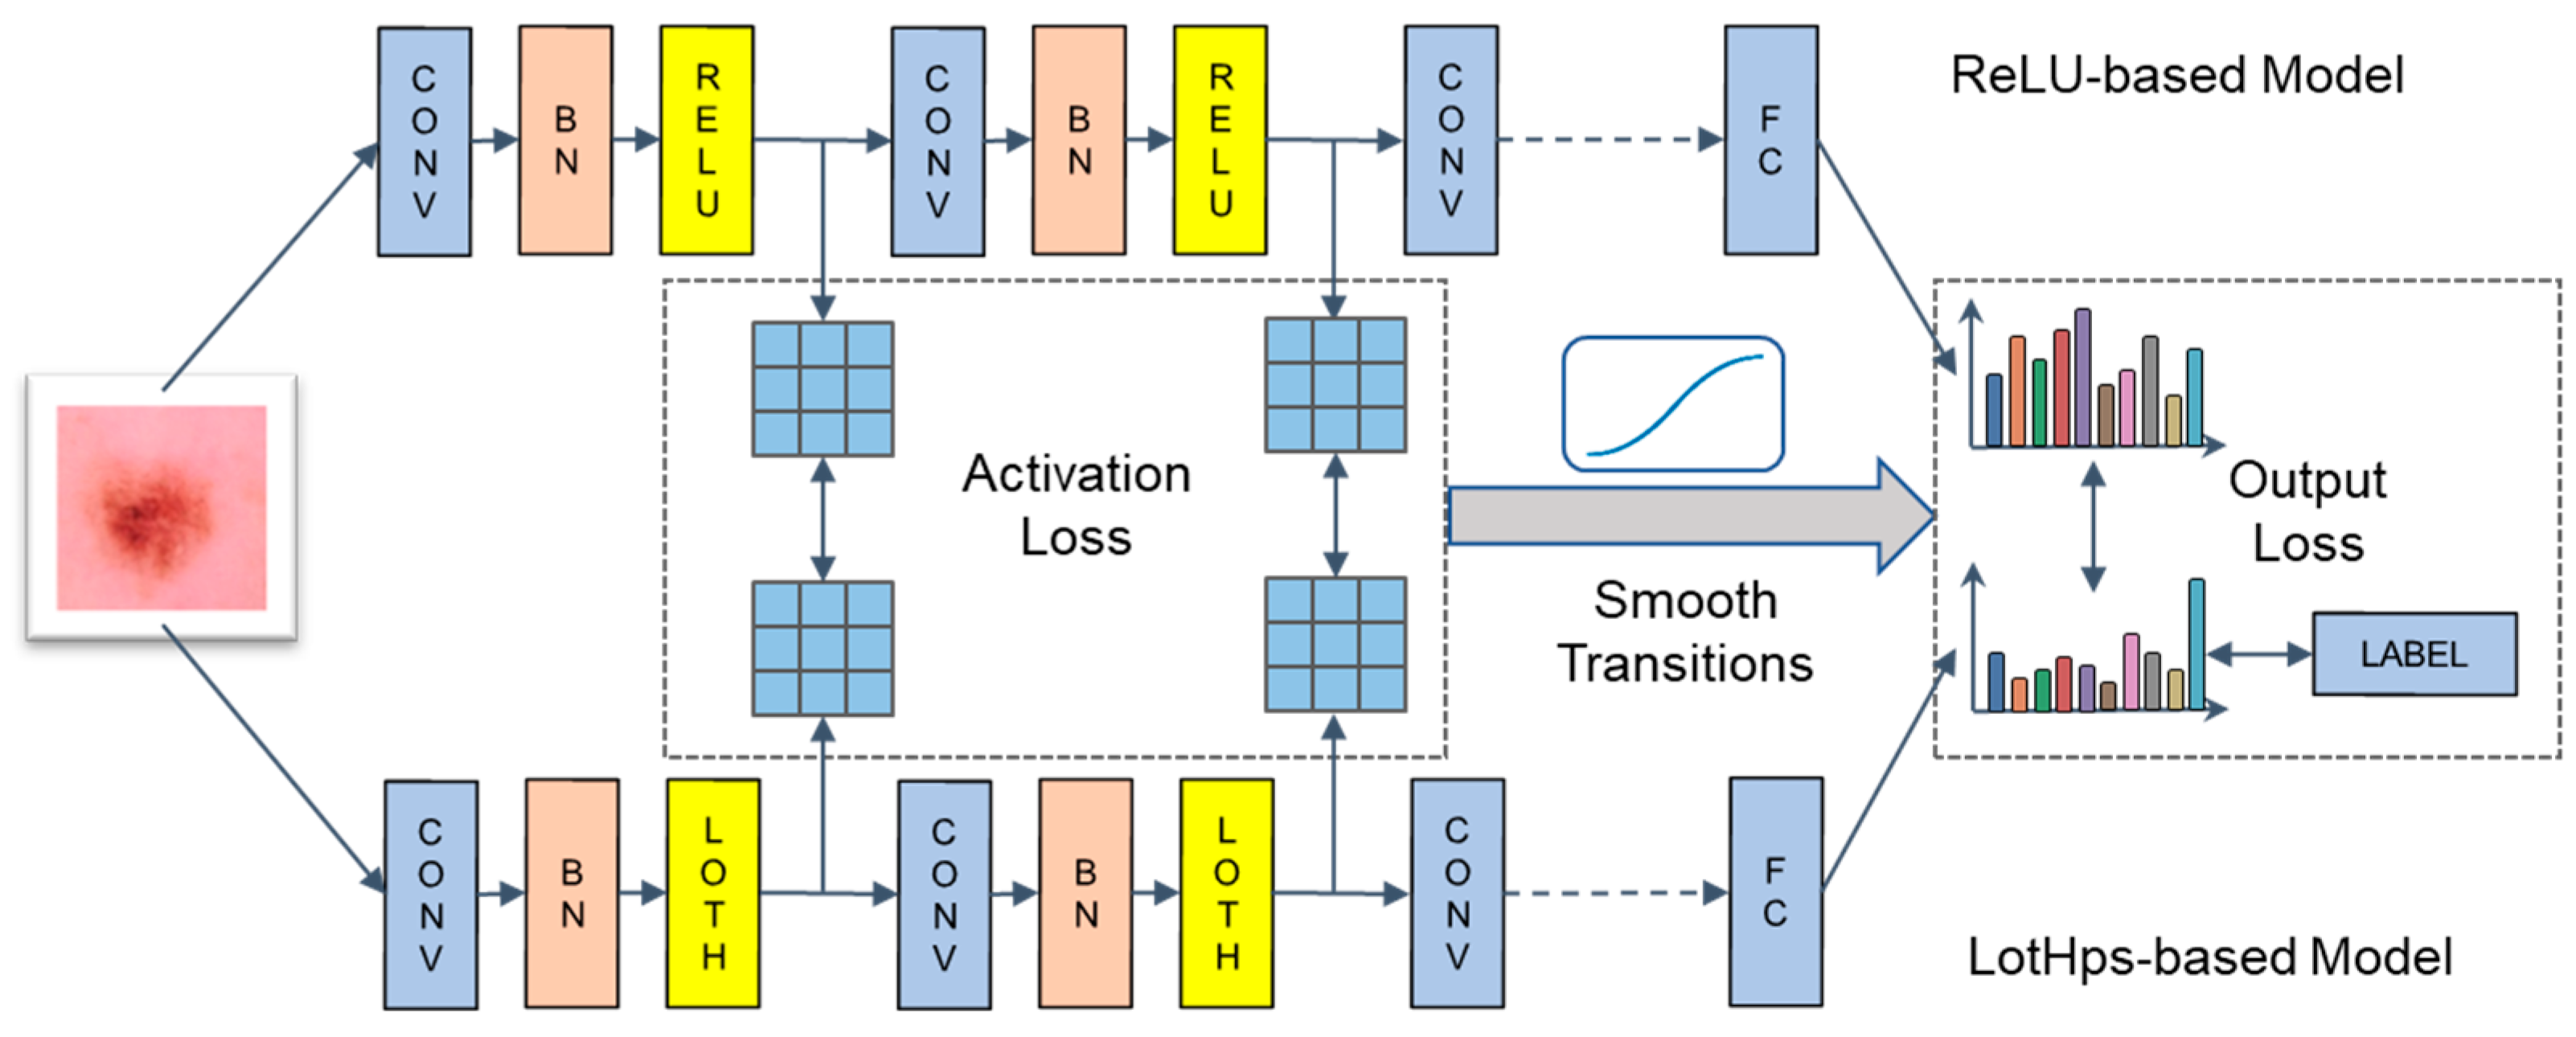
LHDNN: Maintaining High Precision and Low Latency Inference of Deep ...
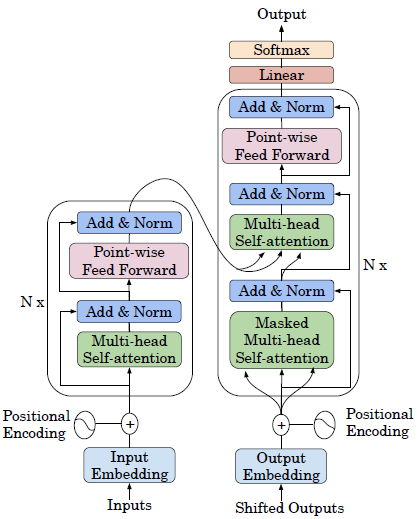
Transformer推理技术优化综述-A Survey of Techniques for Optimizing Transformer ...
Advertisement Space (336x280)

Efficient Deployment of Large-Scale Transformer Models: Strategies for ...

Survey of transformer inference optimization techniques

[R] Retentive Network: A Successor to Transformer for Large Language ...
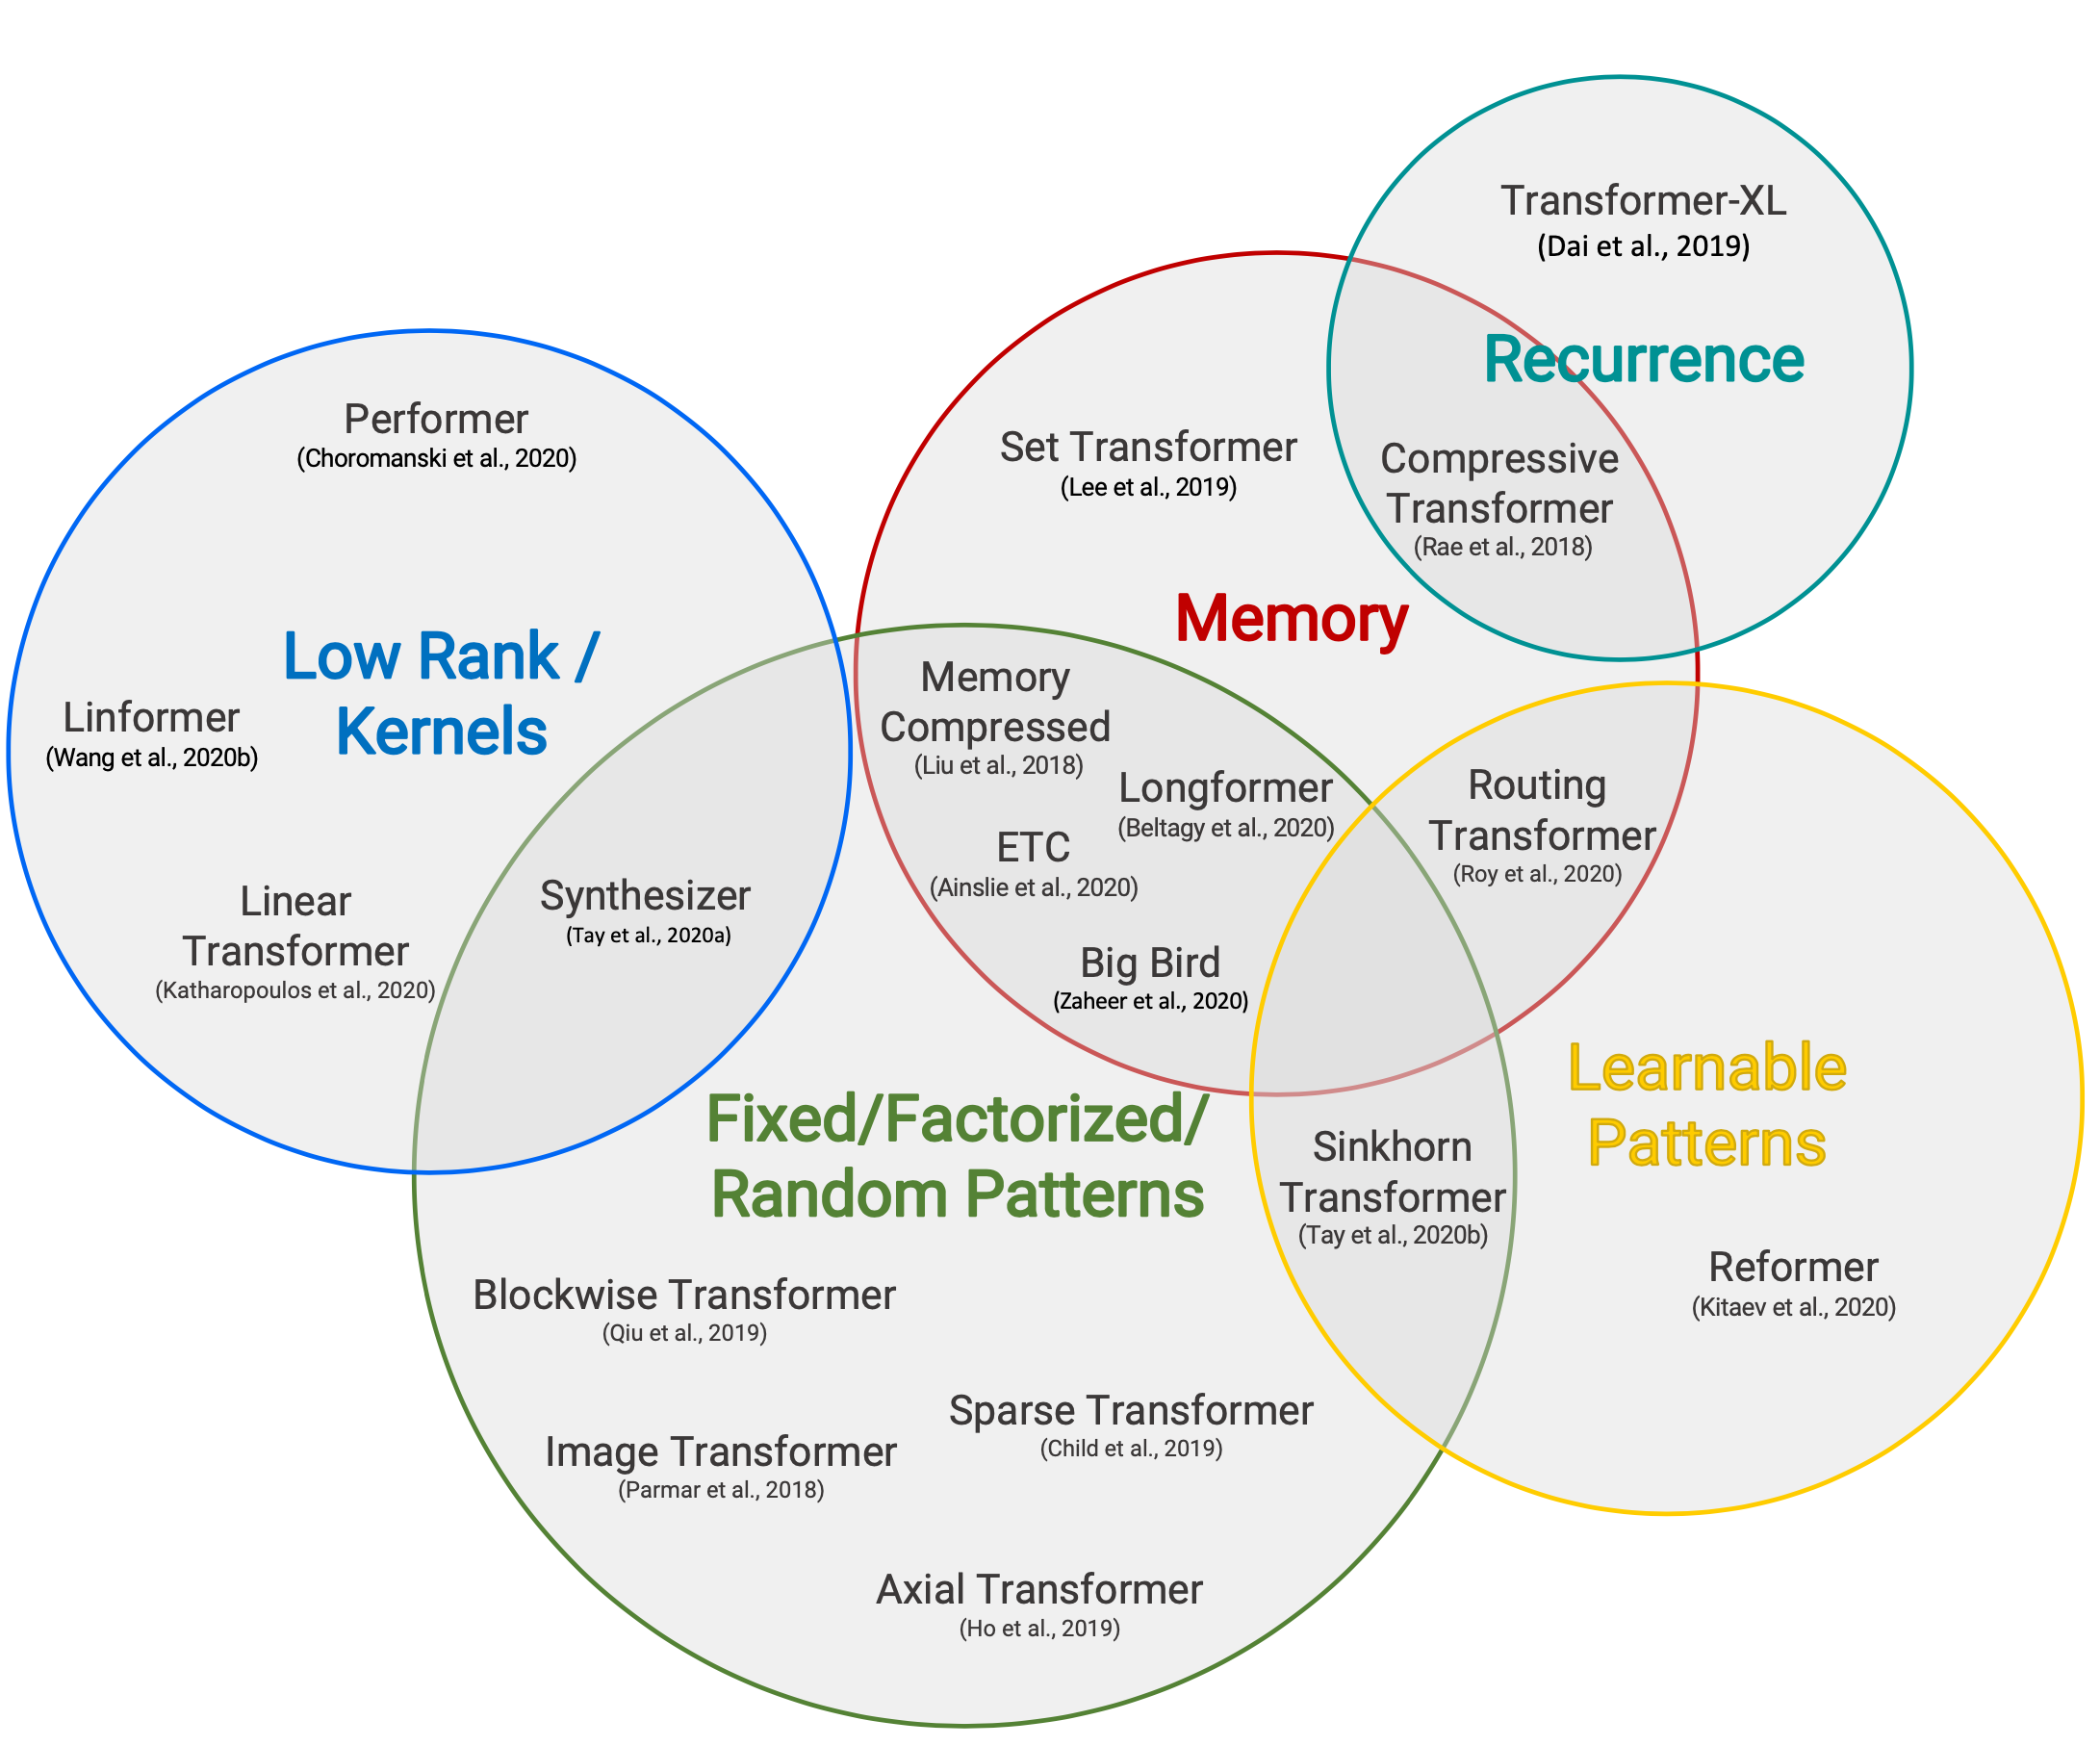
Large Transformer Model Inference Optimization | Lil'Log
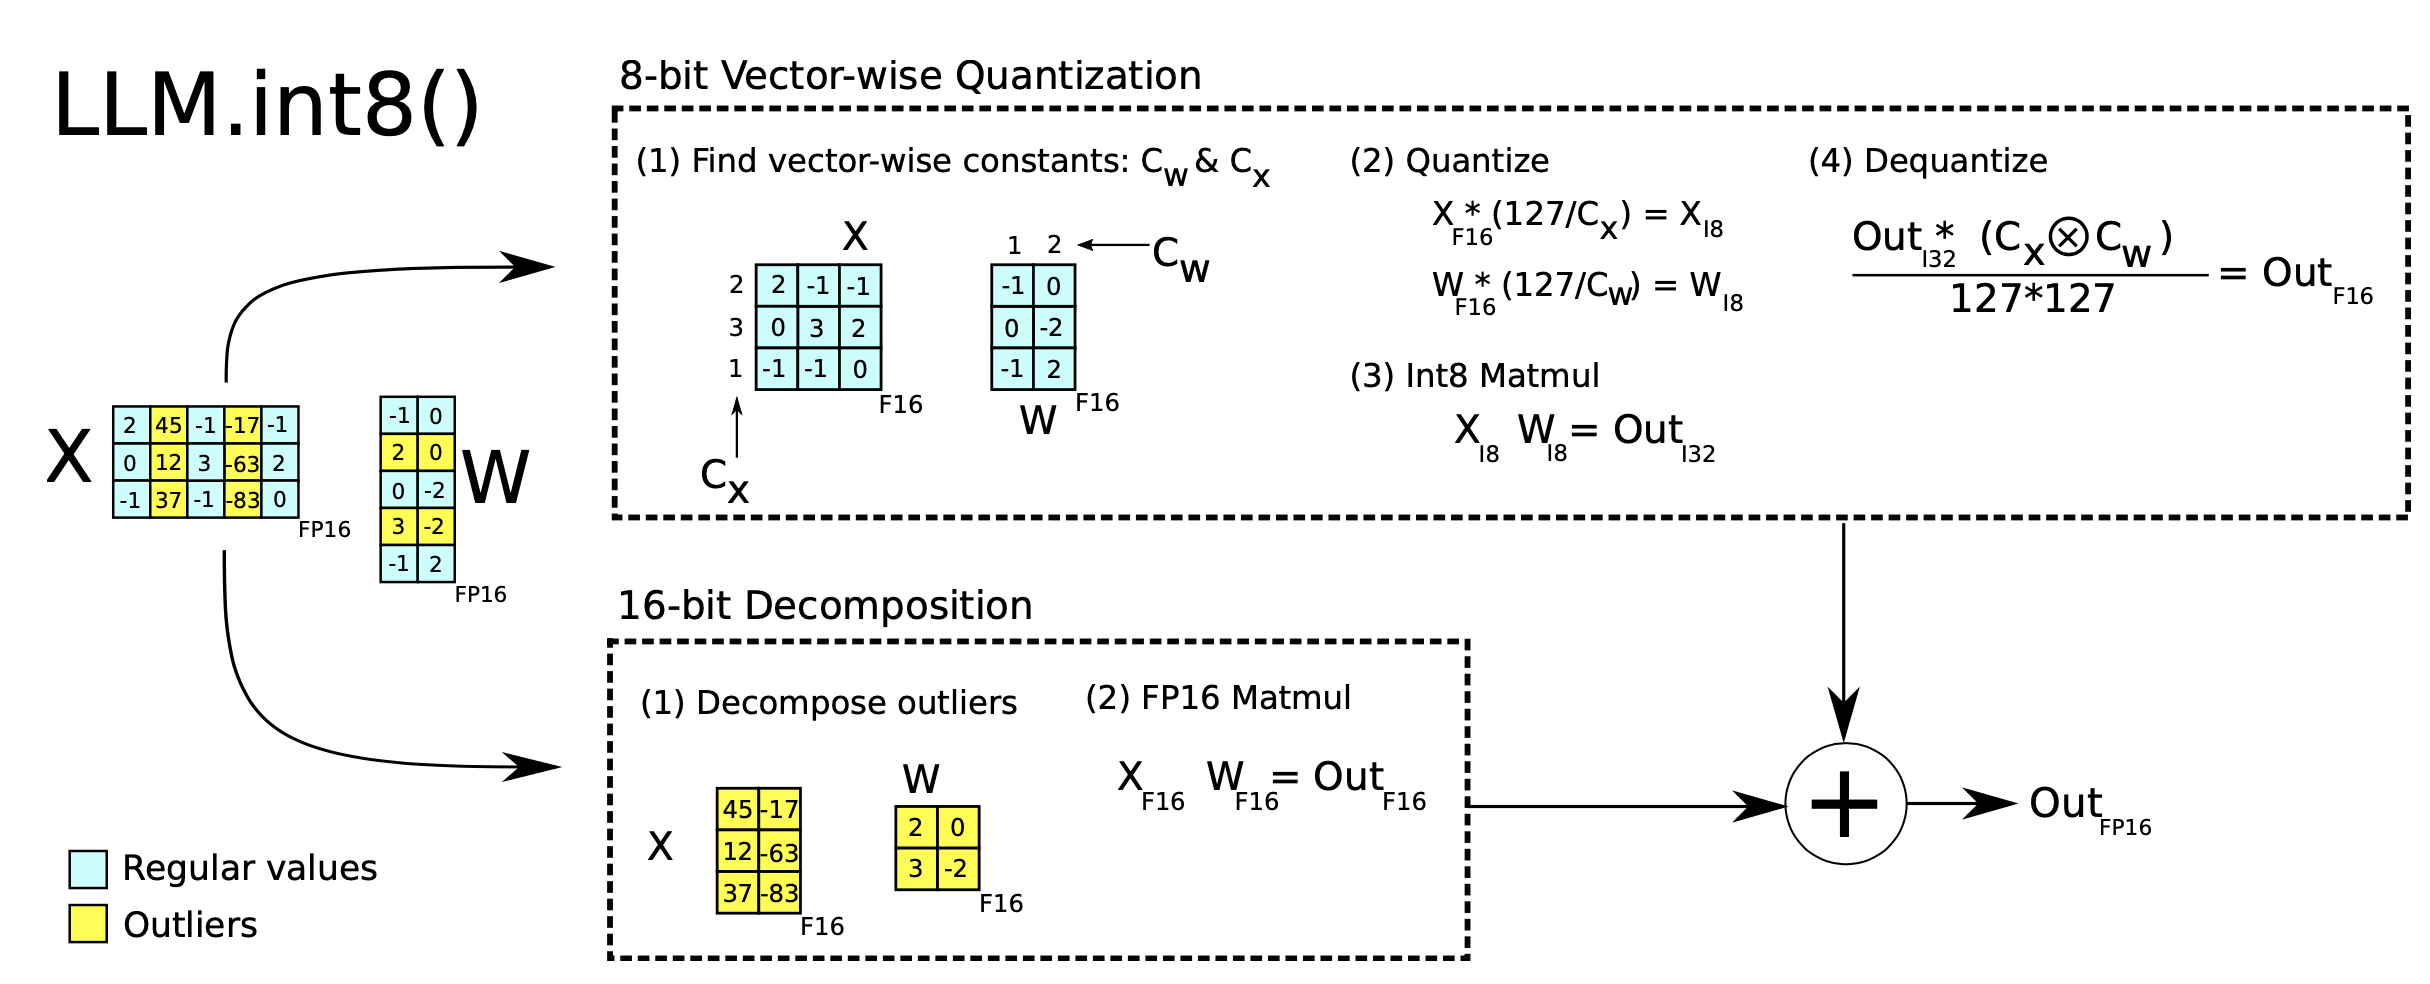
Large Transformer Model Inference Optimization | Lil'Log
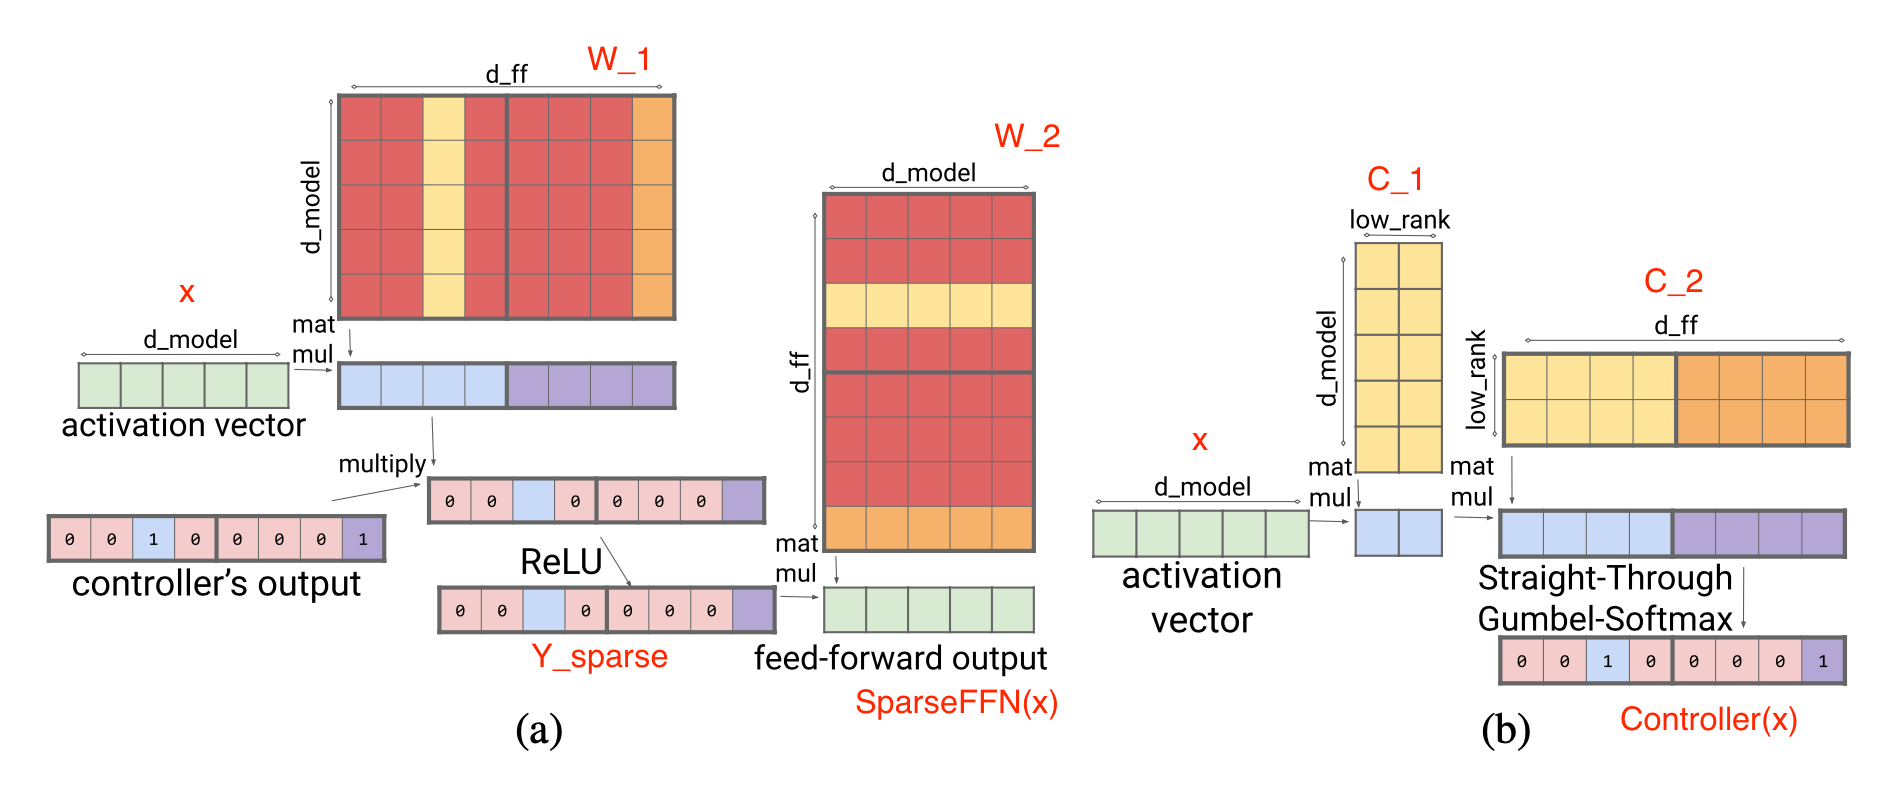
Large Transformer Model Inference Optimization | Lil'Log