
Pdf Vit Ae Improving Vision Transformer Autoencoder For Self

(PDF) ViT-AE++: Improving Vision Transformer Autoencoder for Self ...

ViT-AE++: Improving Vision Transformer Autoencoder for Self-supervised ...

Figure 1 from ViT-AE++: Improving Vision Transformer Autoencoder for ...
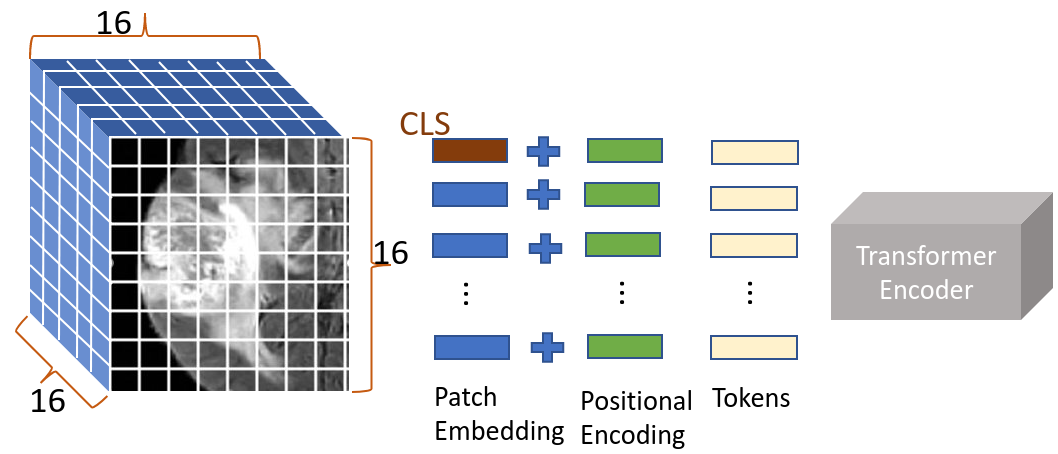
[2301.07382] ViT-AE++: Improving Vision Transformer Autoencoder for ...
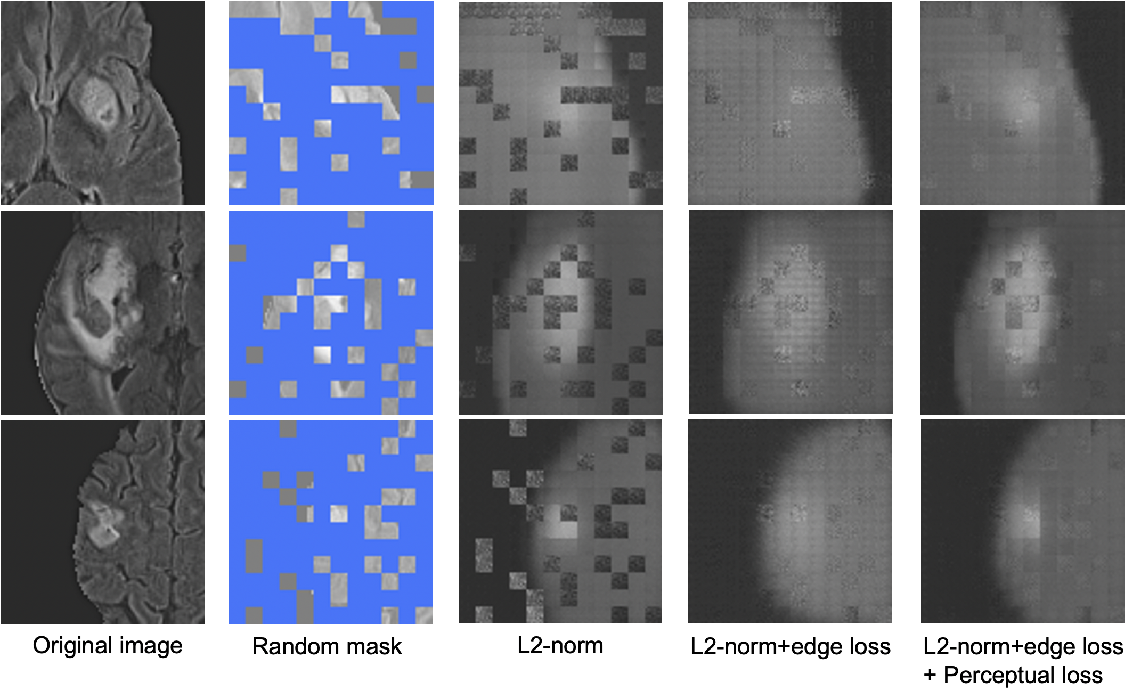
Figure 3 from ViT-AE++: Improving Vision Transformer Autoencoder for ...
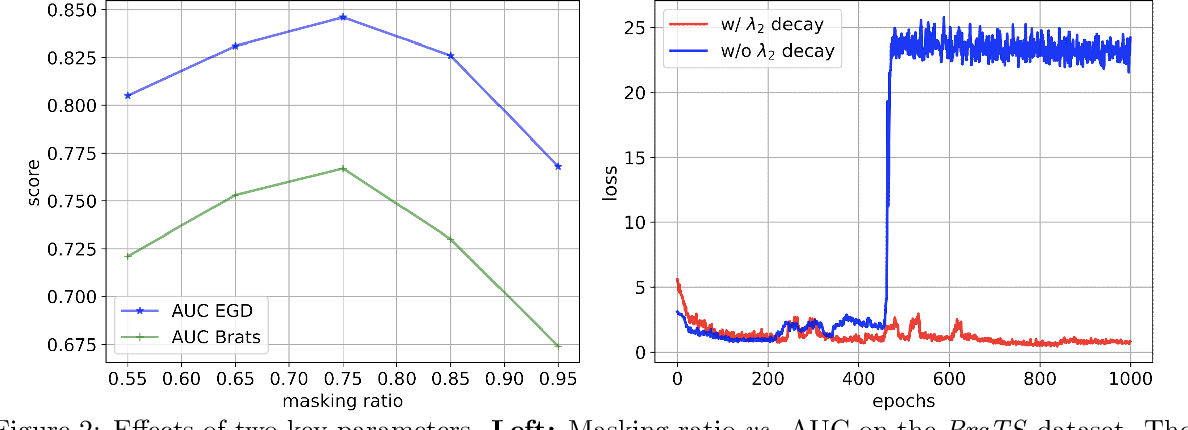
Figure 2 from ViT-AE++: Improving Vision Transformer Autoencoder for ...
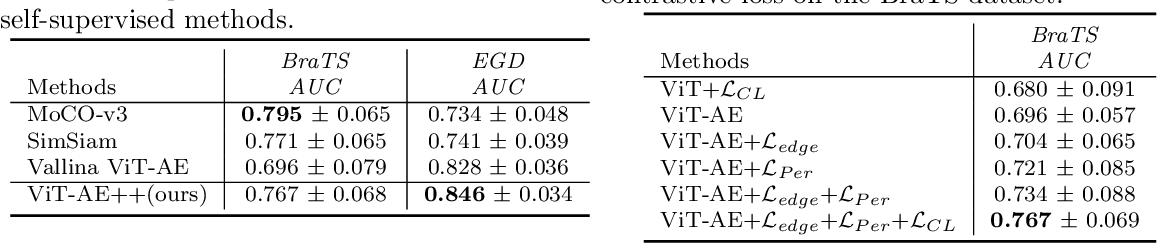
Table 2 from ViT-AE++: Improving Vision Transformer Autoencoder for ...
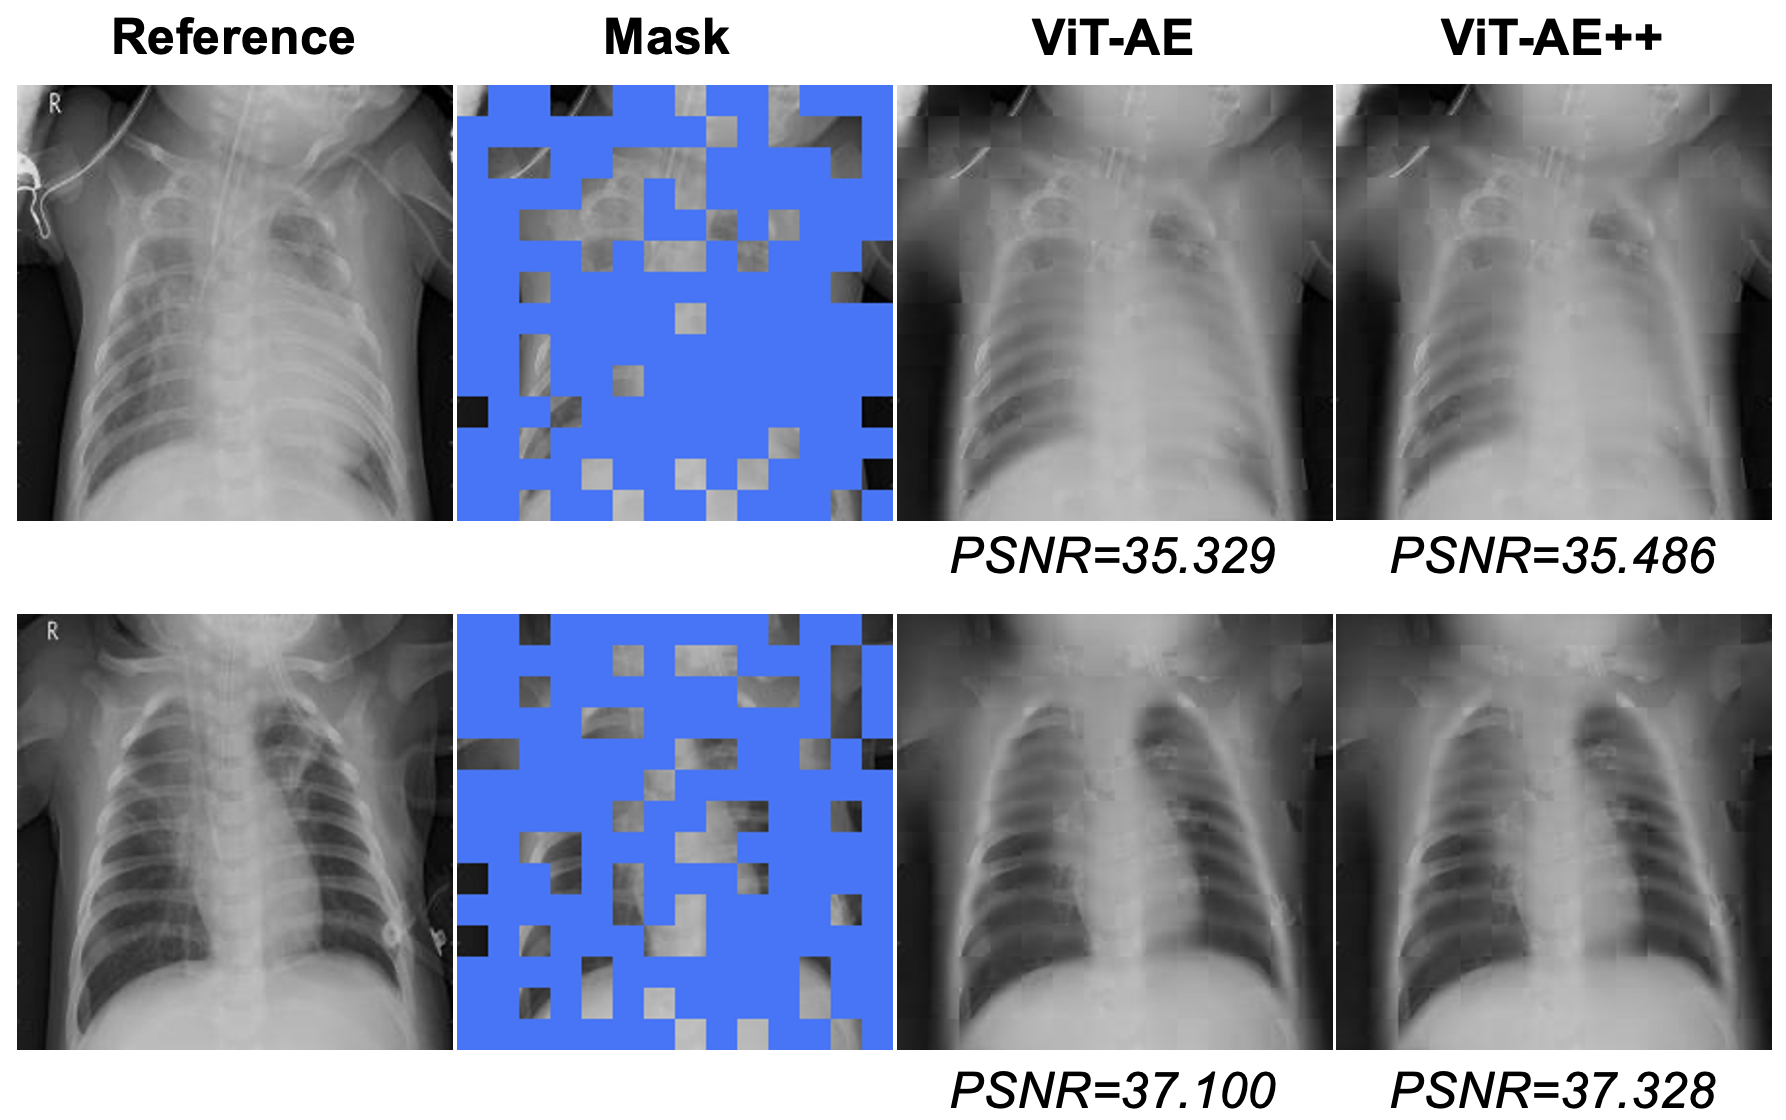
[2301.07382] ViT-AE++: Improving Vision Transformer Autoencoder for ...

(PDF) Denoising Vision Transformer Autoencoder with Spectral Self ...

[논문 리뷰] Denoising Vision Transformer Autoencoder with Spectral Self ...
Advertisement Space (300x250)

How is a Vision Transformer (ViT) model built and implemented? | PDF ...

Improving Visual Prompt Tuning for Self-supervised Vision Transformers ...

How is a Vision Transformer (ViT) model built and implemented? | PDF ...

(PDF) Rethinking Vision Transformer and Masked Autoencoder in ...

(PDF) Effectiveness of masked autoencoder in vision transformer models ...
How is a Vision Transformer (ViT) model built and implemented? | PDF

(PDF) Vision Transformer With Enhanced Self-Attention for Few-Shot Ship ...

Vit Transformer | PDF

DLゼミ: ViTPose: Simple Vision Transformer Baselines for Human Pose ...

An autoencoder and vision transformer based interpretability analysis ...
Advertisement Space (336x280)

(PDF) Improving Visual Prompt Tuning for Self-supervised Vision ...

Vision Transformers : ViT et Swin | PDF | Informatique | Intelligence ...

(PDF) PF-ViT: Parallel and Fast Vision Transformer for Offline ...

Rethinking Vision Transformer and Masked Autoencoder in Multimodal Face ...

论文笔记(六) Vision Transformer & Masked Autoencoder - 知乎

论文笔记(六) Vision Transformer & Masked Autoencoder - 知乎

ViT | Vision Transformer | Vision Transformer (ViT) Architecture ...

Vision Transformer (Vit) - Based Applications in Image Classification | PDF

(PDF) FV-ViT: Vision Transformer for Finger Vein Recognition
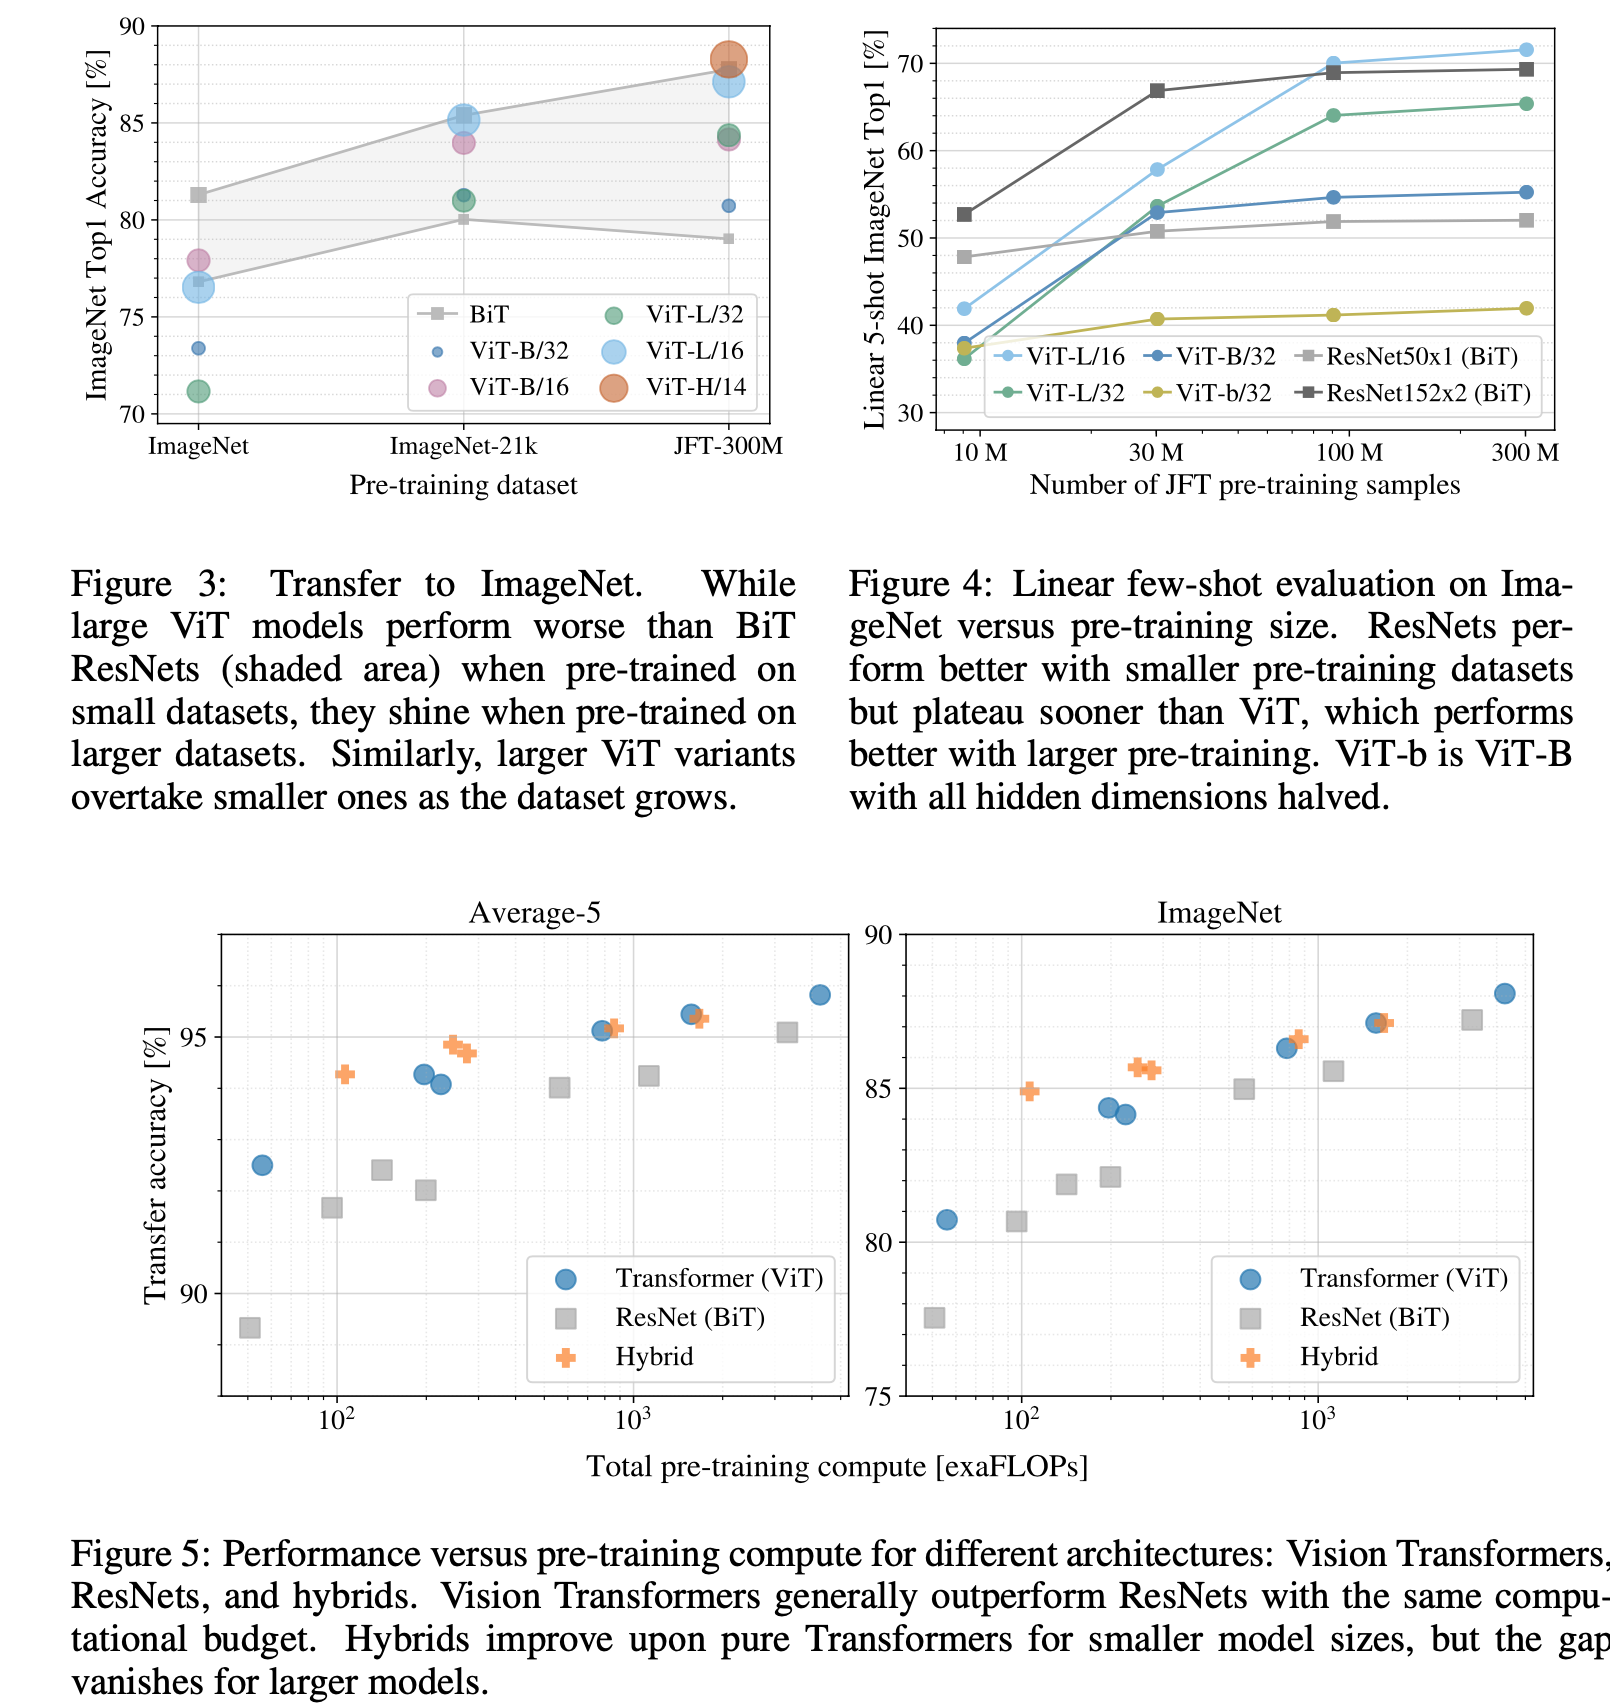
[Vision Paper Review] - ViT : Vision Transformer
Advertisement Space (336x280)

How is a Vision Transformer (ViT) model built and implemented? | PDF

(PDF) PLG-ViT: Vision Transformer with Parallel Local and Global Self ...

AE-ViT: Token Enhancement for Vision Transformers via CNN-based ...

Vision Transformer (ViT) Notes | Wenwen Kong

ViT (Vision Transformer) Review [CDM] | PDF
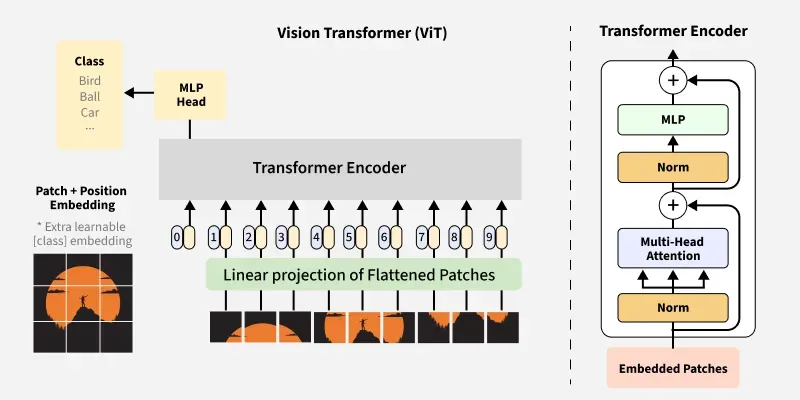
Vision Transformer (ViT) Architecture | GeeksforGeeks