
Pretraining Hyperparameter Conflict Between Code And Paper Issue 79
Pretraining hyperparameter conflict between code and paper · Issue #79 ...
Hyperparameter discrepancy between paper(s) and code · Issue #8 ...
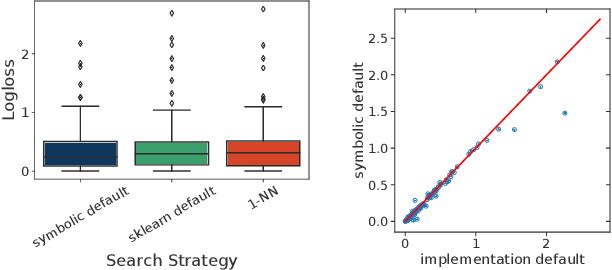
Meta-Learning for Symbolic Hyperparameter Defaults: Paper and Code ...
Pre-training code and detailed hyperparameters · Issue #1 · aim-uofa/BA ...
On Pretraining for Project-Level Code Completion - Paper Details

Paper page - Front-Loading Reasoning: The Synergy between Pretraining ...

Difference between Model Parameter and Hyperparameter | Free Data ...

Paper page - Predictable Scale: Part I -- Optimal Hyperparameter ...

Paper page - Testing the Efficacy of Hyperparameter Optimization ...

Paper page - Tune As You Scale: Hyperparameter Optimization For Compute ...
Advertisement Space (300x250)

Paper page - SFT-GRPO Data Overlap as a Post-Training Hyperparameter ...

Paper page - To Code, or Not To Code? Exploring Impact of Code in Pre ...
μP Hyperparameter Transfer Has an Embedding Layer Hole, New arXiv Paper ...

Paper page - Hyperparameter Optimization for Multi-Objective ...
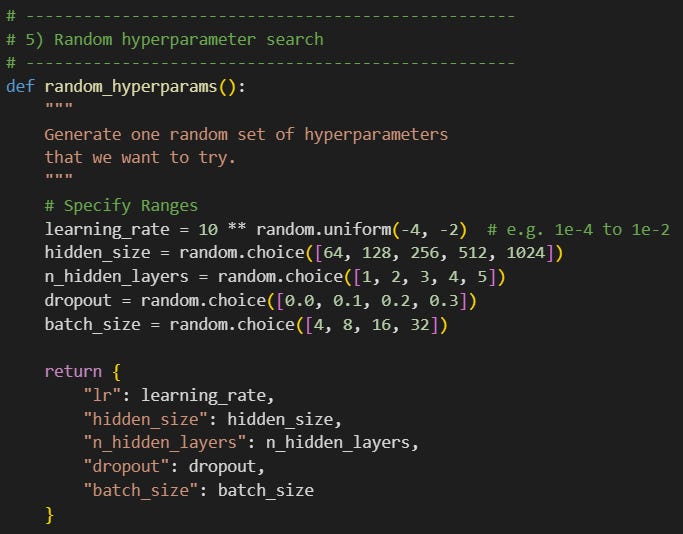
Hyperparameter Tuning Basics: Hands-On Code & Key Frameworks
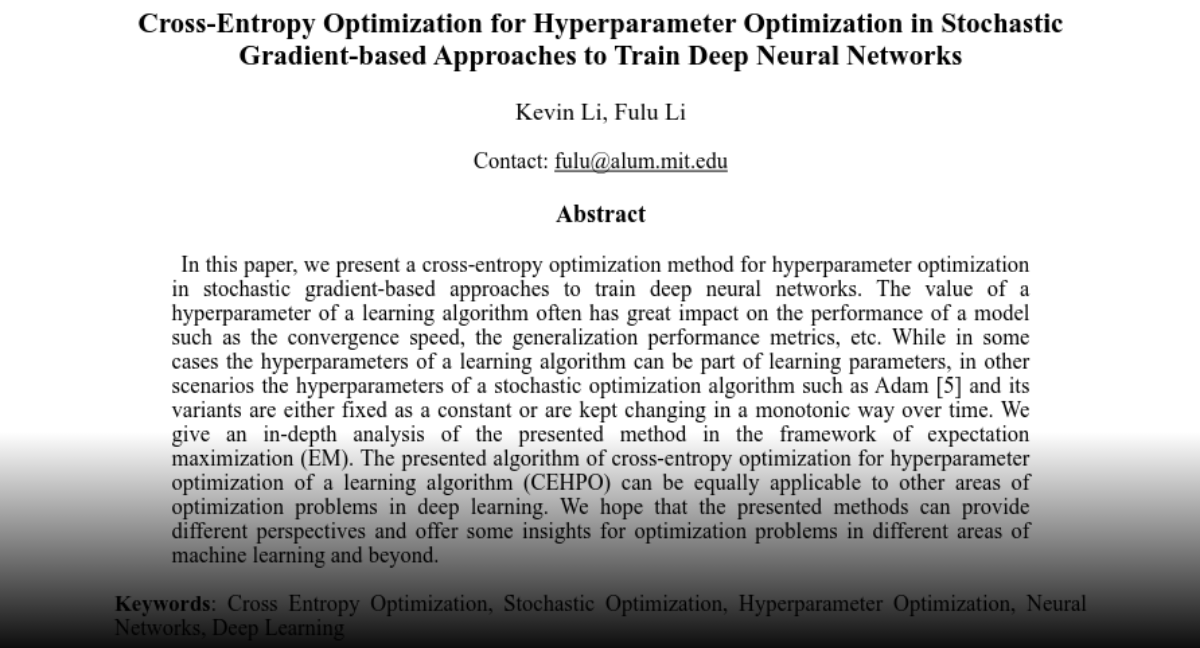
Paper page - Cross-Entropy Optimization for Hyperparameter Optimization ...

Paper page - GraphCodeBERT: Pre-training Code Representations with Data ...
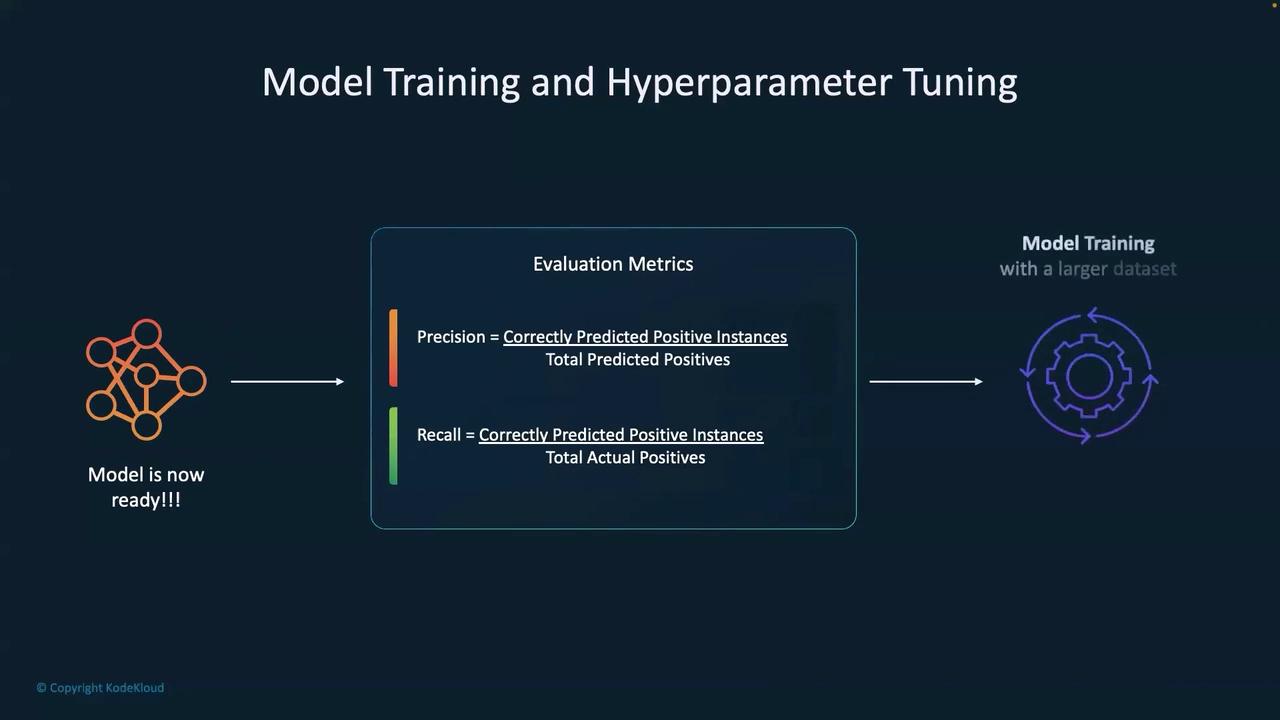
Model Training and Hyperparameter tuning - KodeKloud

Paper page - Guiding Pretraining in Reinforcement Learning with Large ...

This AI Paper from Cornell and Brown University Introduces Epistemic ...
Advertisement Space (336x280)

How Does Code Pretraining Affect Language Model Task Performance? - 智源社区论文

(PDF) Hyperparameter Optimization and Reproducibility in Deep Learning ...
Final model training and validation performance, after hyperparameter ...

Top arXiv Papers: Generative Language Models, Code LLM, Hyperparameter ...
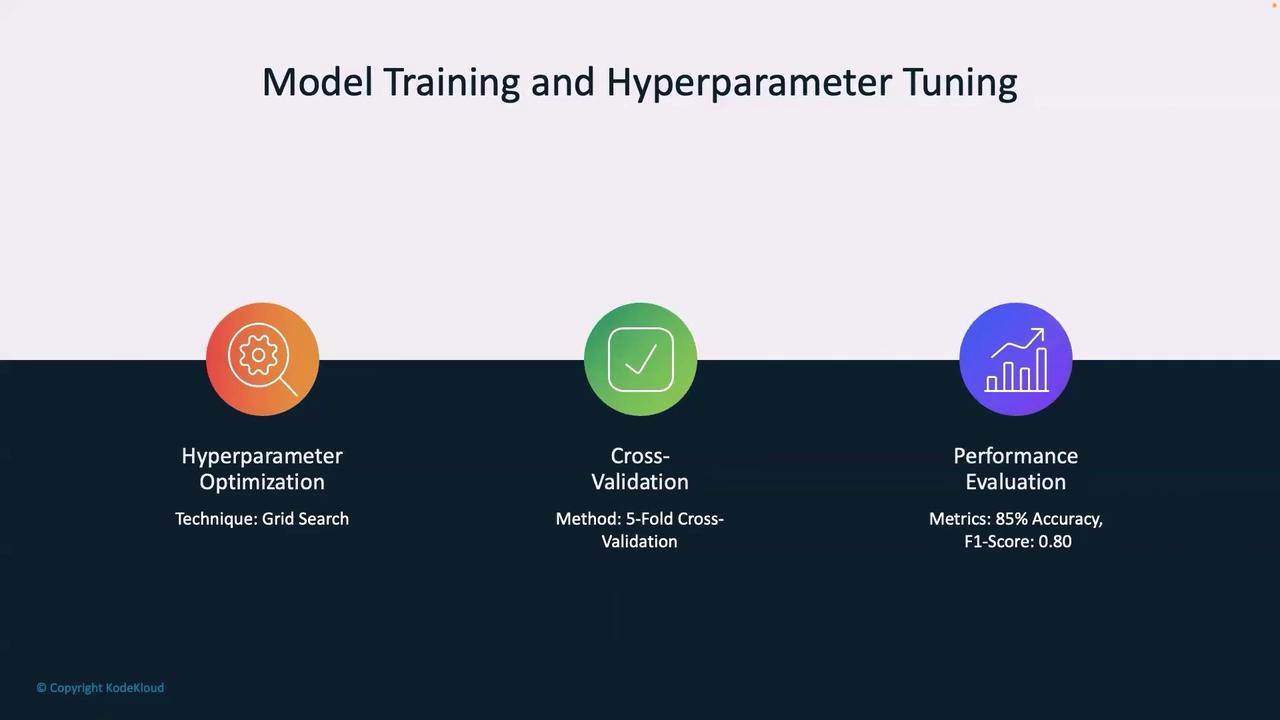
Model Training and Hyperparameter tuning - KodeKloud

Paper page - On the Interplay of Pre-Training, Mid-Training, and RL on ...
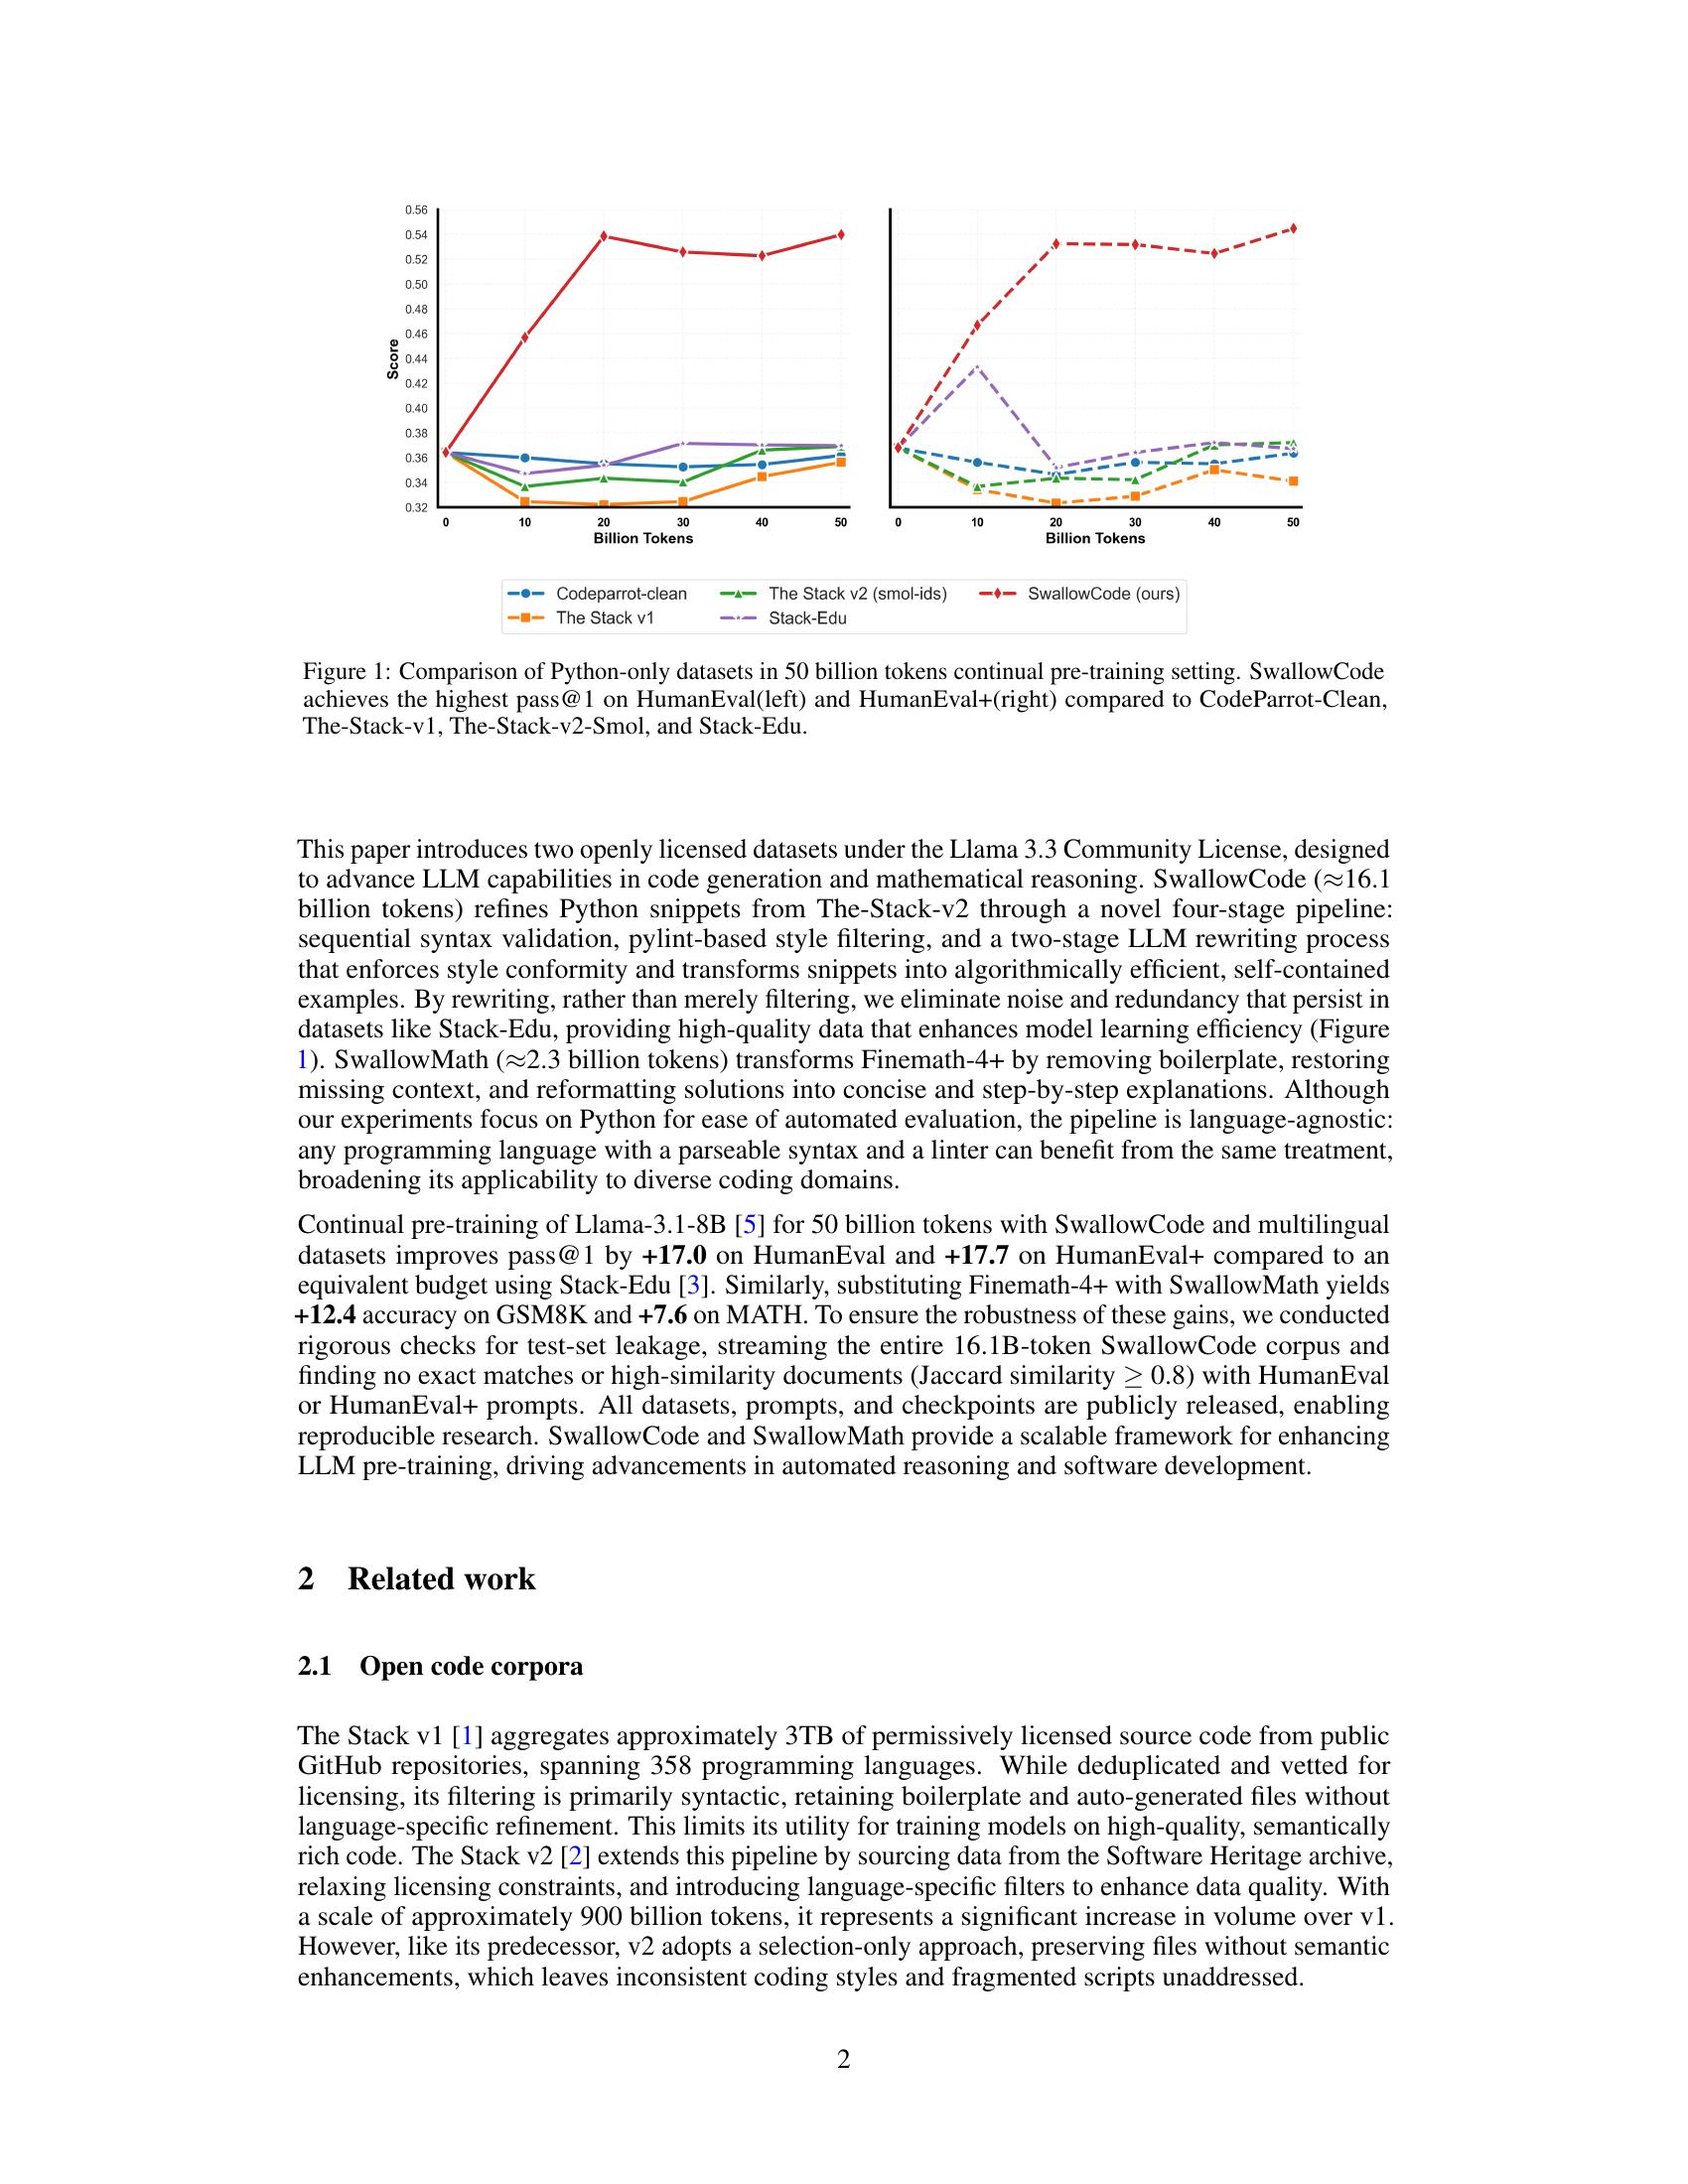
Rewriting Pre-Training Data Boosts LLM Performance in Math and Code - 智 ...

(PDF) Ensuring Reliability via Hyperparameter Selection: Review and ...

Paper page - Instruction Pre-Training: Language Models are Supervised ...
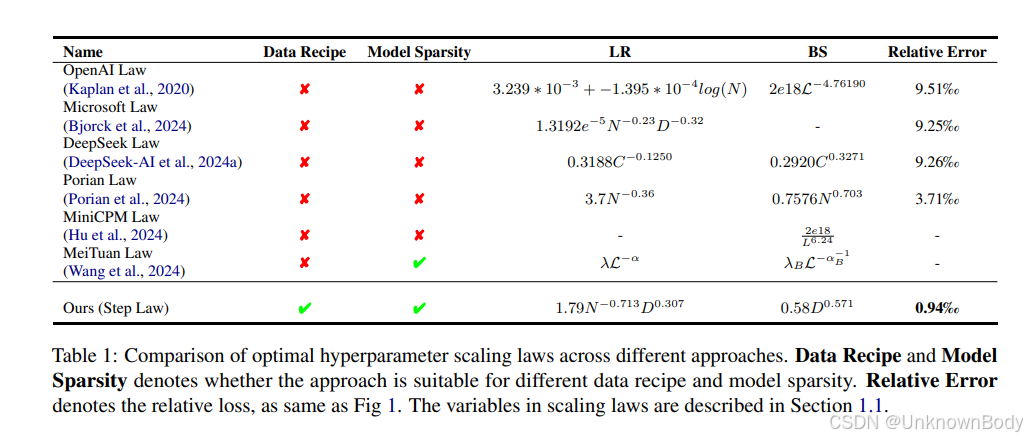
Predictable Scale: Part I — Optimal Hyperparameter Scaling Law in Large ...
Advertisement Space (336x280)
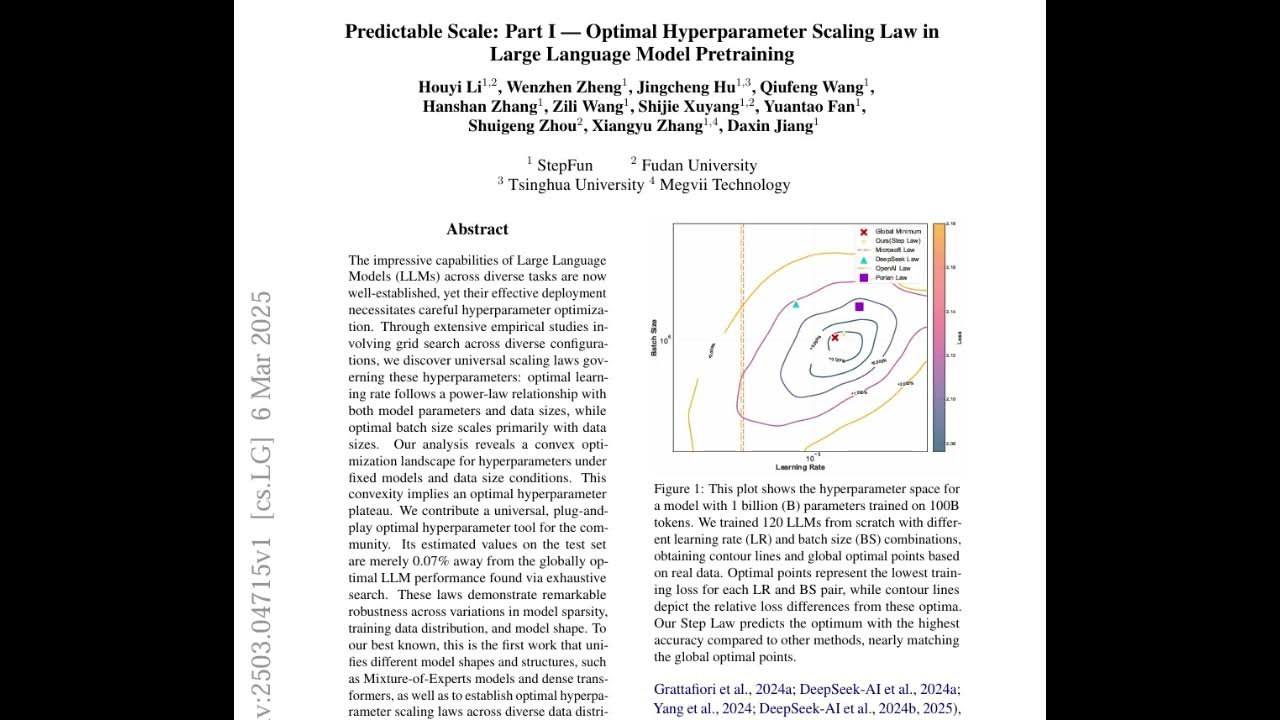
Predictable Scale: Part I -- Optimal Hyperparameter Scaling Law in ...

Hyperparameter Tuning - Eine Frage der Einstellung

RBM pre-training hyperparameter configuration. | Download Scientific ...

Two-step hyperparameter optimization method: Accelerating ...

Hyperparameter Transfer Laws for Non-Recurrent Multi-Path Neural ...

Completed Hyperparameter Transfer across Modules, Width, Depth, Batch ...