
Prof An Llm Based Reward Code Preference Optimization Framework For

PROF: An LLM-based Reward Code Preference Optimization Framework for ...

PROF: An LLM-based Reward Code Preference Optimization Framework for ...

PROF: An LLM-based Reward Code Preference Optimization Framework for ...

PROF: An LLM-based Reward Code Preference Optimization Framework for ...

Differentiable Reward Optimization for LLM based TTS system - Papers ...
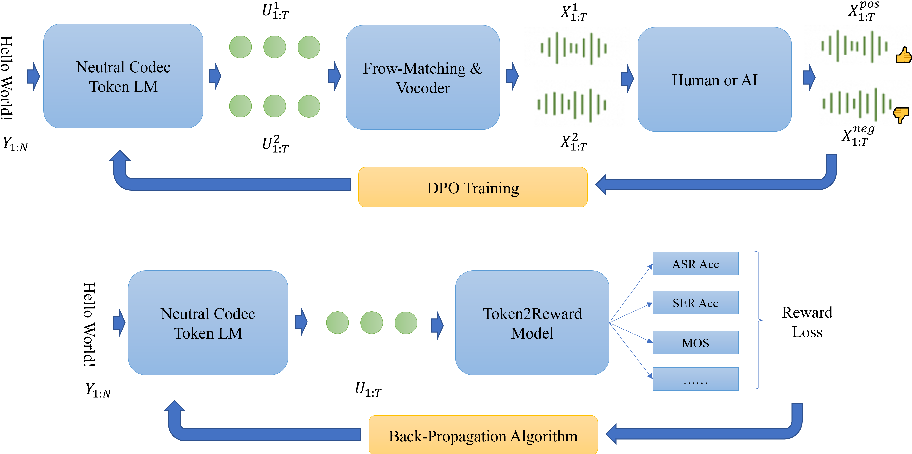
Figure 1 from Differentiable Reward Optimization for LLM based TTS ...
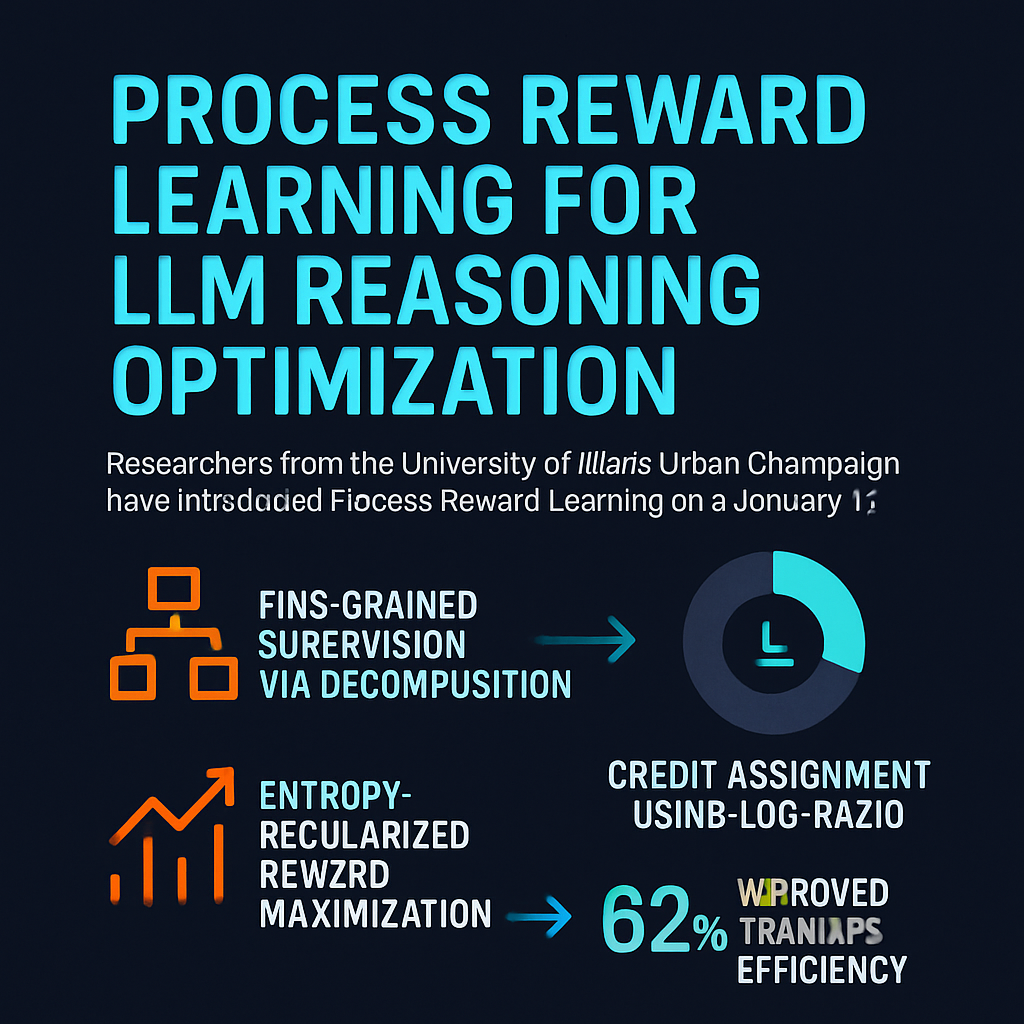
Process Reward Learning for LLM Reasoning Optimization — AI Post ...

[论文评述] Probability-Consistent Preference Optimization for Enhanced LLM ...

Weighted-Reward Preference Optimization for LLM Fusion | PDF | Applied ...

[论文评述] Process Reward Models for LLM Agents: Practical Framework and ...
Advertisement Space (300x250)

RRO: LLM Agent Optimization Through Rising Reward Trajectories

Weighted-Reward Preference Optimization for Implicit Model Fusion · HF ...
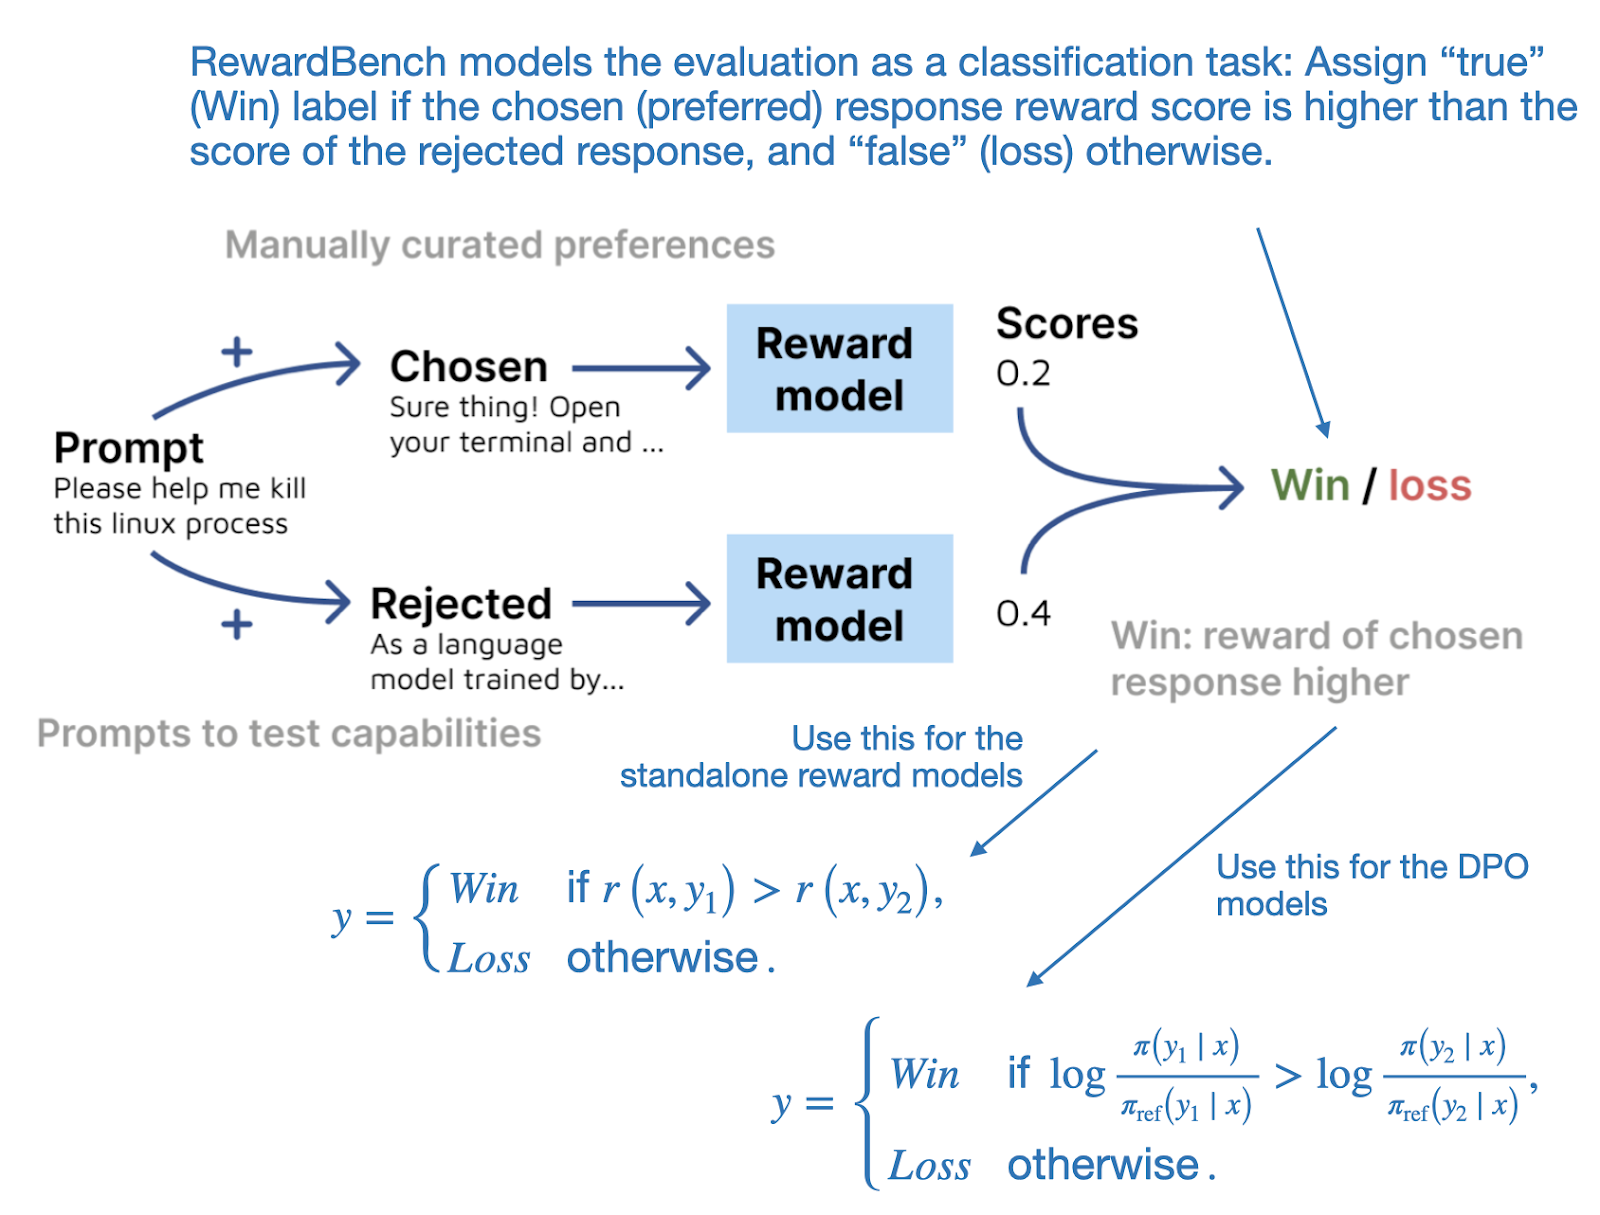
Tips for LLM Pretraining and Evaluating Reward Models
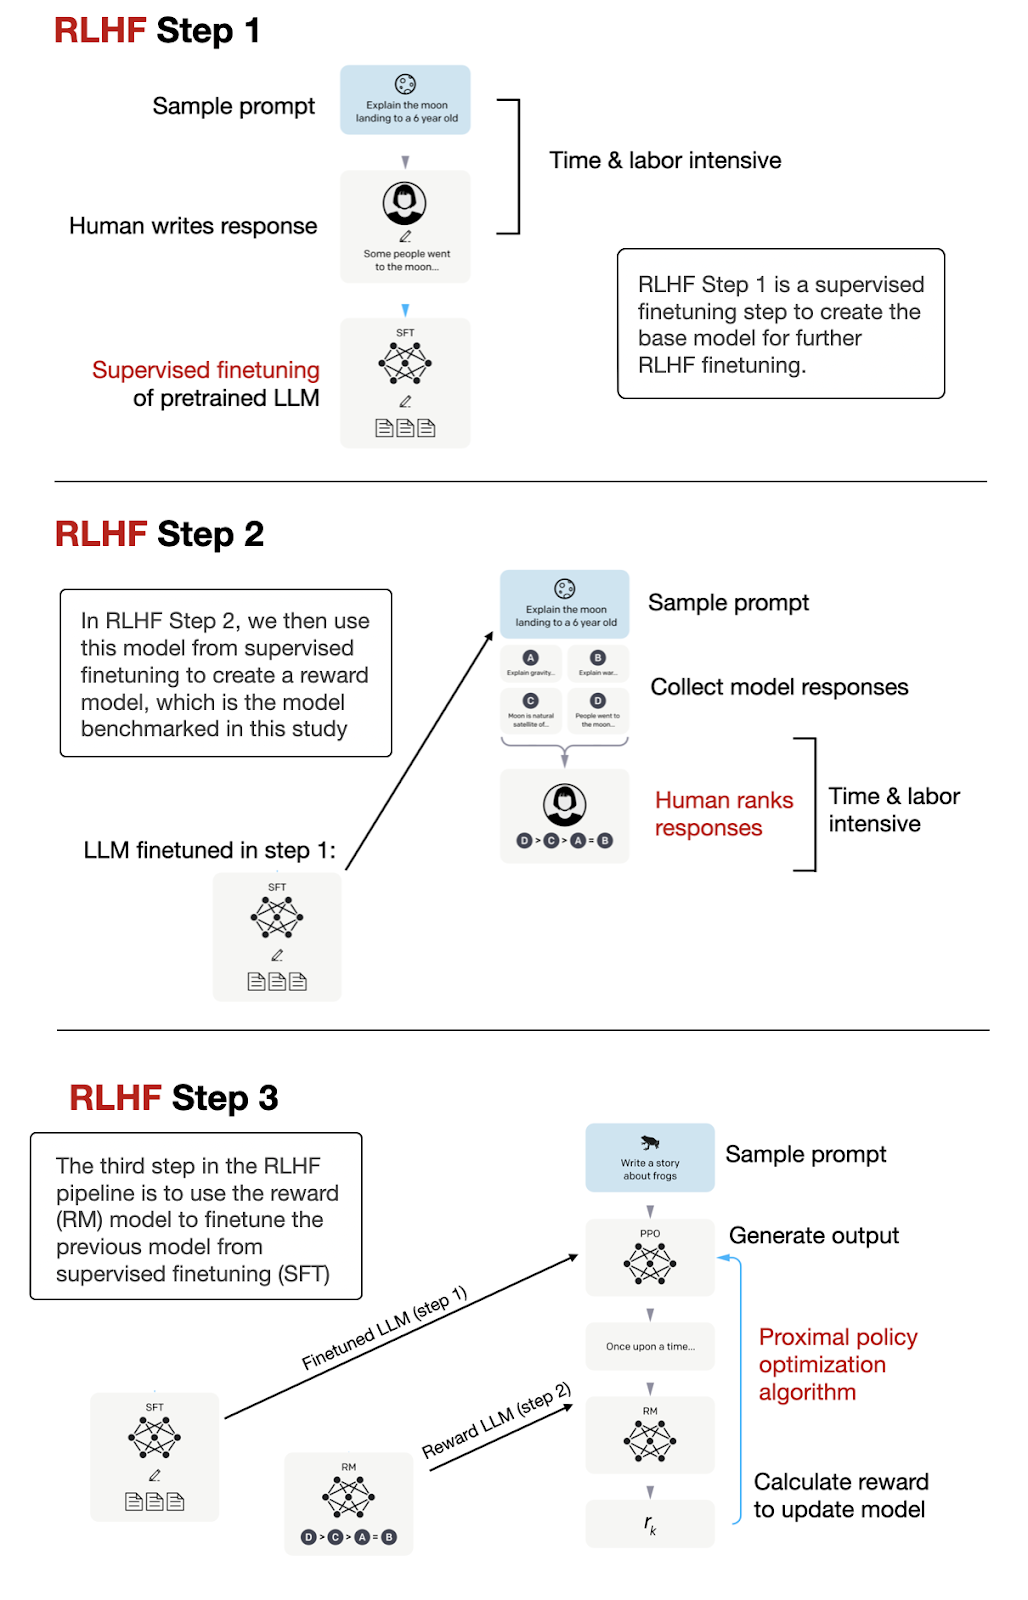
Tips for LLM Pretraining and Evaluating Reward Models

Critic-RM: A Self-Critiquing AI Framework for Enhanced Reward Modeling ...
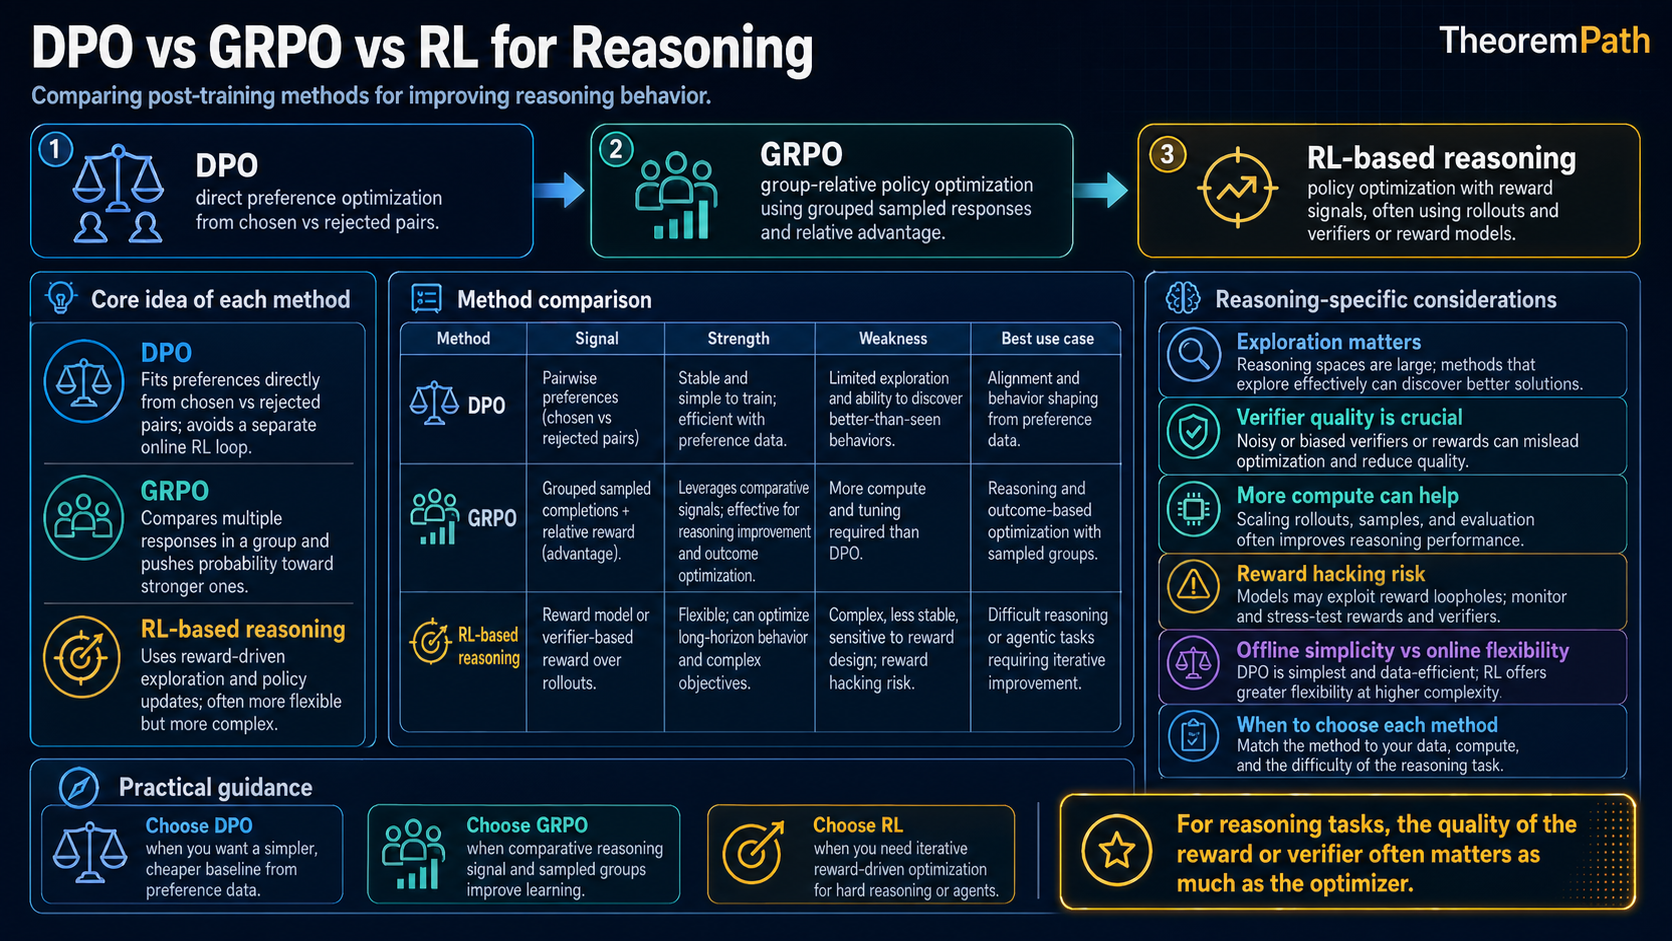
DPO vs GRPO vs RL: LLM Preference Optimization Compared | TheoremPath

User Preference Modeling for Conversational LLM Agents: Weak Rewards ...

Tips for LLM Pretraining and Evaluating Reward Models
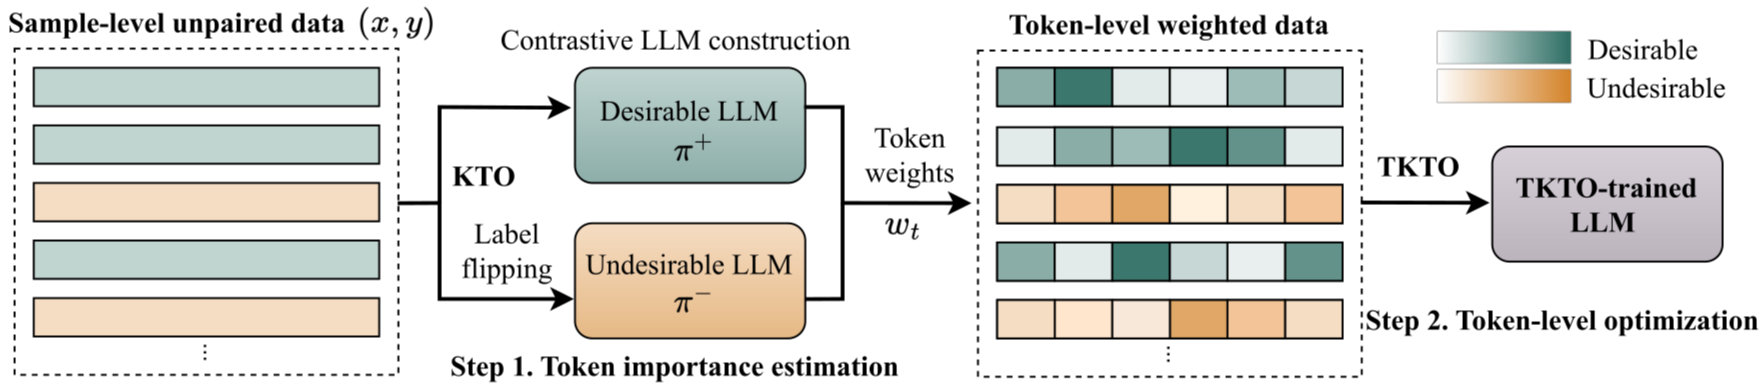
[논문 리뷰] Data-efficient Targeted Token-level Preference Optimization for ...

User Simulator-Guided Multi-Turn Preference Optimization for Reasoning ...
Advertisement Space (336x280)

One Adapts to Any: Meta Reward Modeling for Personalized LLM Alignment

User Simulator-Guided Multi-Turn Preference Optimization for Reasoning ...

Weighted-Reward Preference Optimization for Implicit Model Fusion | AI ...
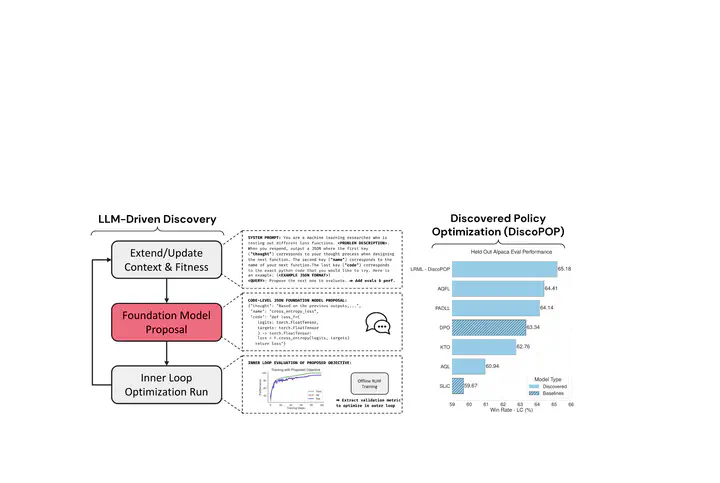
Discovering Preference Optimization Algorithms with and for Large ...
User Preference Modeling for Conversational LLM Agents: Weak Rewards ...

Compiler Optimization via LLM Reasoning for Efficient Model Serving ...

Using LLM to Design Reward Function for Bipedal Walker-v3 | Proceedings ...
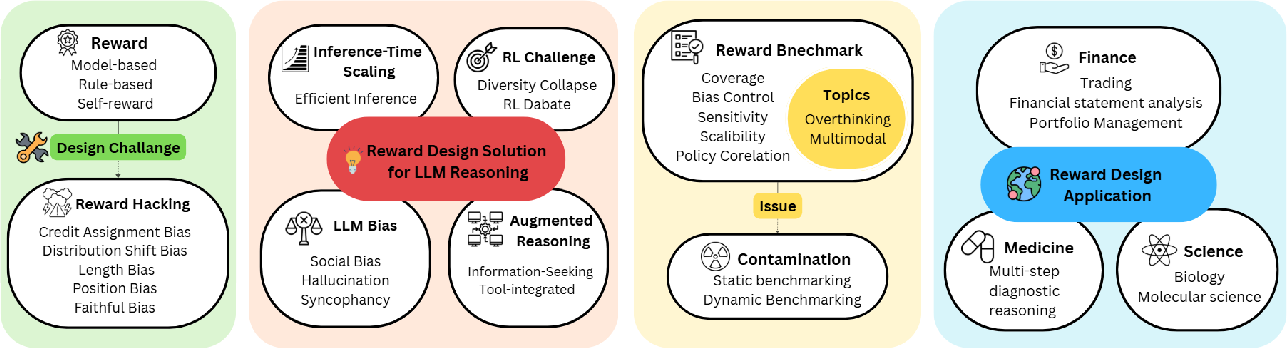
Figure 1 from Reward Modeling for Reinforcement Learning-Based LLM ...

Reward models have transformed LLM research by incorporating human ...
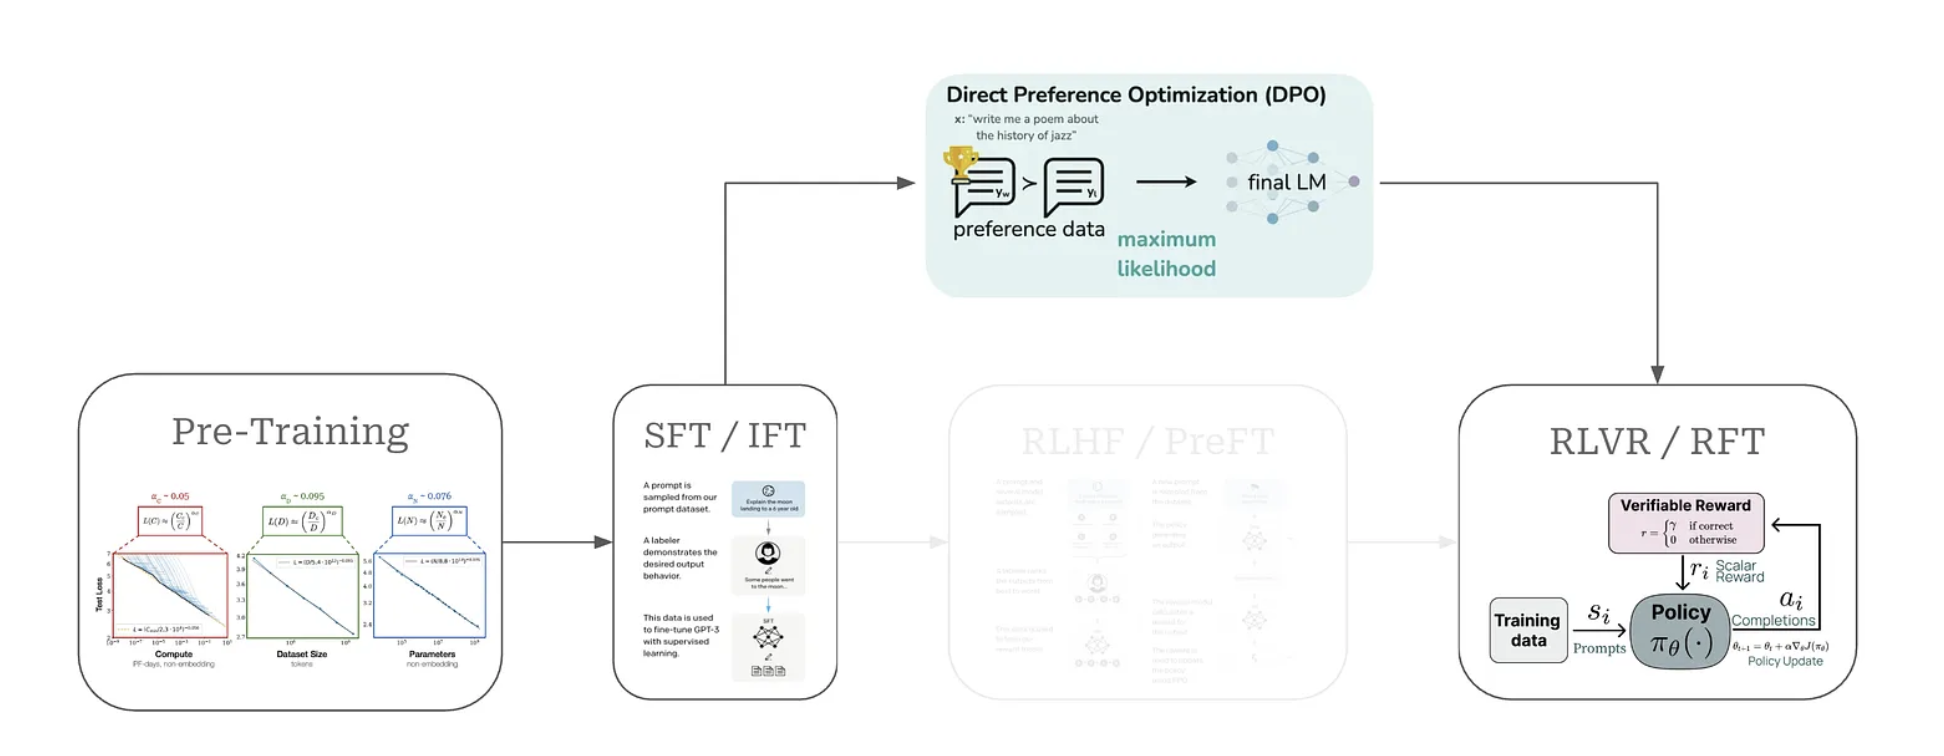
DPO - Direct Preference Optimization - Kyle’s Tech Blog
Advertisement Space (336x280)
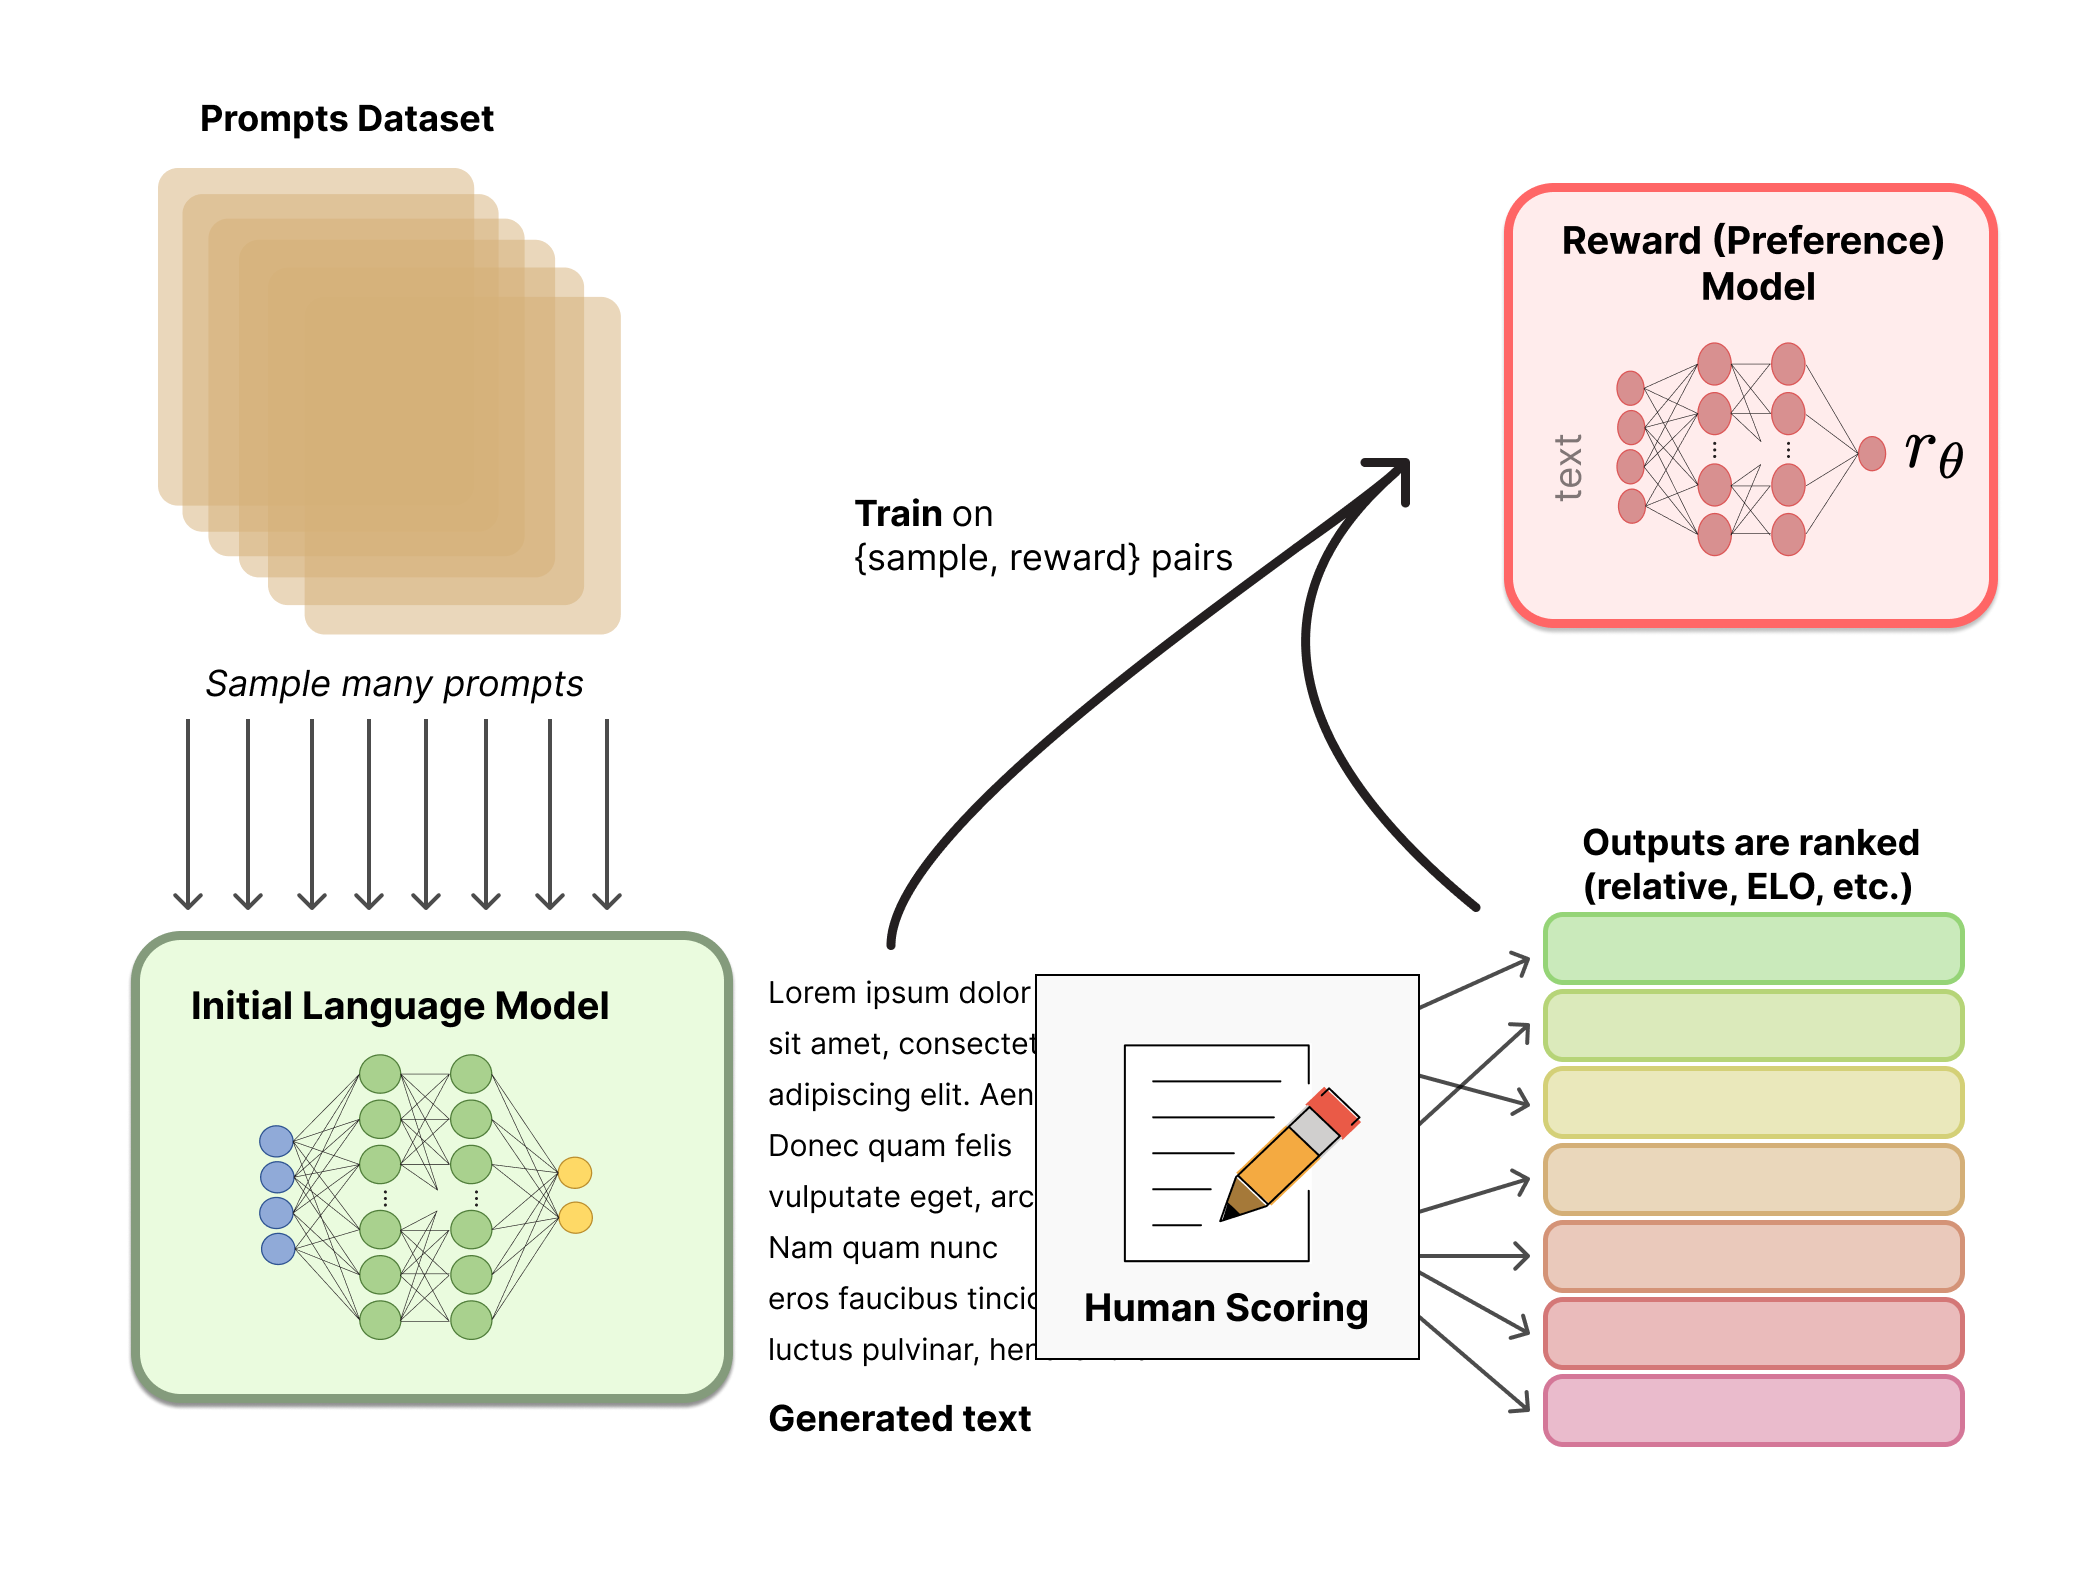
LLM Preference Alignment

Direct Preference Optimization of Video Large Multimodal Models from ...
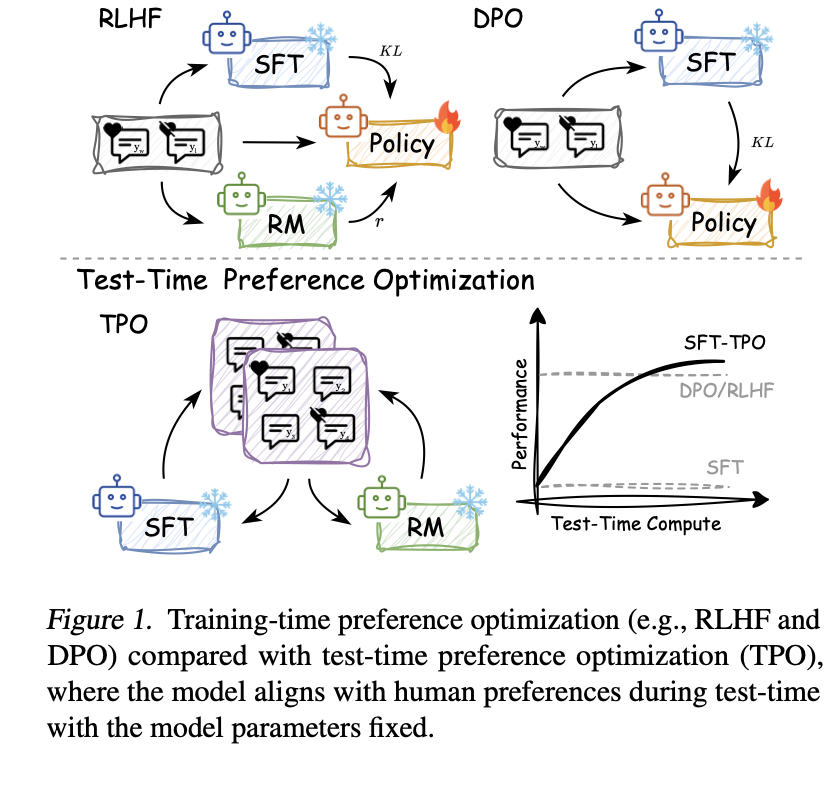
Test-Time Preference Optimization: A Novel AI Framework that Optimizes ...

Large Language Model Guided Incentive Aware Reward Design for ...

Test-Time Preference Optimization: A Novel AI Framework that Optimizes ...
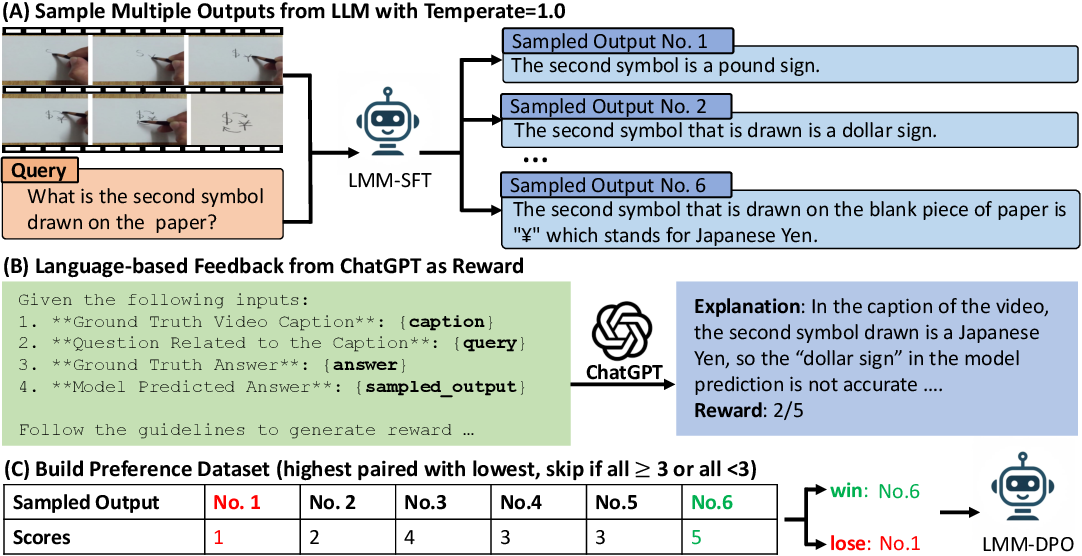
Figure 2 from Direct Preference Optimization of Video Large Multimodal ...