
Qmamba Post Training Quantization For Vision State Space Models Ai

QMamba: Post-Training Quantization for Vision State Space Models | AI ...

[논문 리뷰] QMamba: Post-Training Quantization for Vision State Space Models

QMamba: Post-Training Quantization for Vision State Space Models

QMamba: Post-Training Quantization for Vision State Space Models

QMamba: Post-Training Quantization for Vision State Space Models

SF-Mamba: Rethinking State Space Model for Vision | AI Research Paper ...

EAMamba: Efficient All-Around Vision State Space Model for Image ...

Paper page - SF-Mamba: Rethinking State Space Model for Vision

(PDF) OuroMamba: A Data-Free Quantization Framework for Vision Mamba Models

Paper page - A2Mamba: Attention-augmented State Space Models for Visual ...
Advertisement Space (300x250)
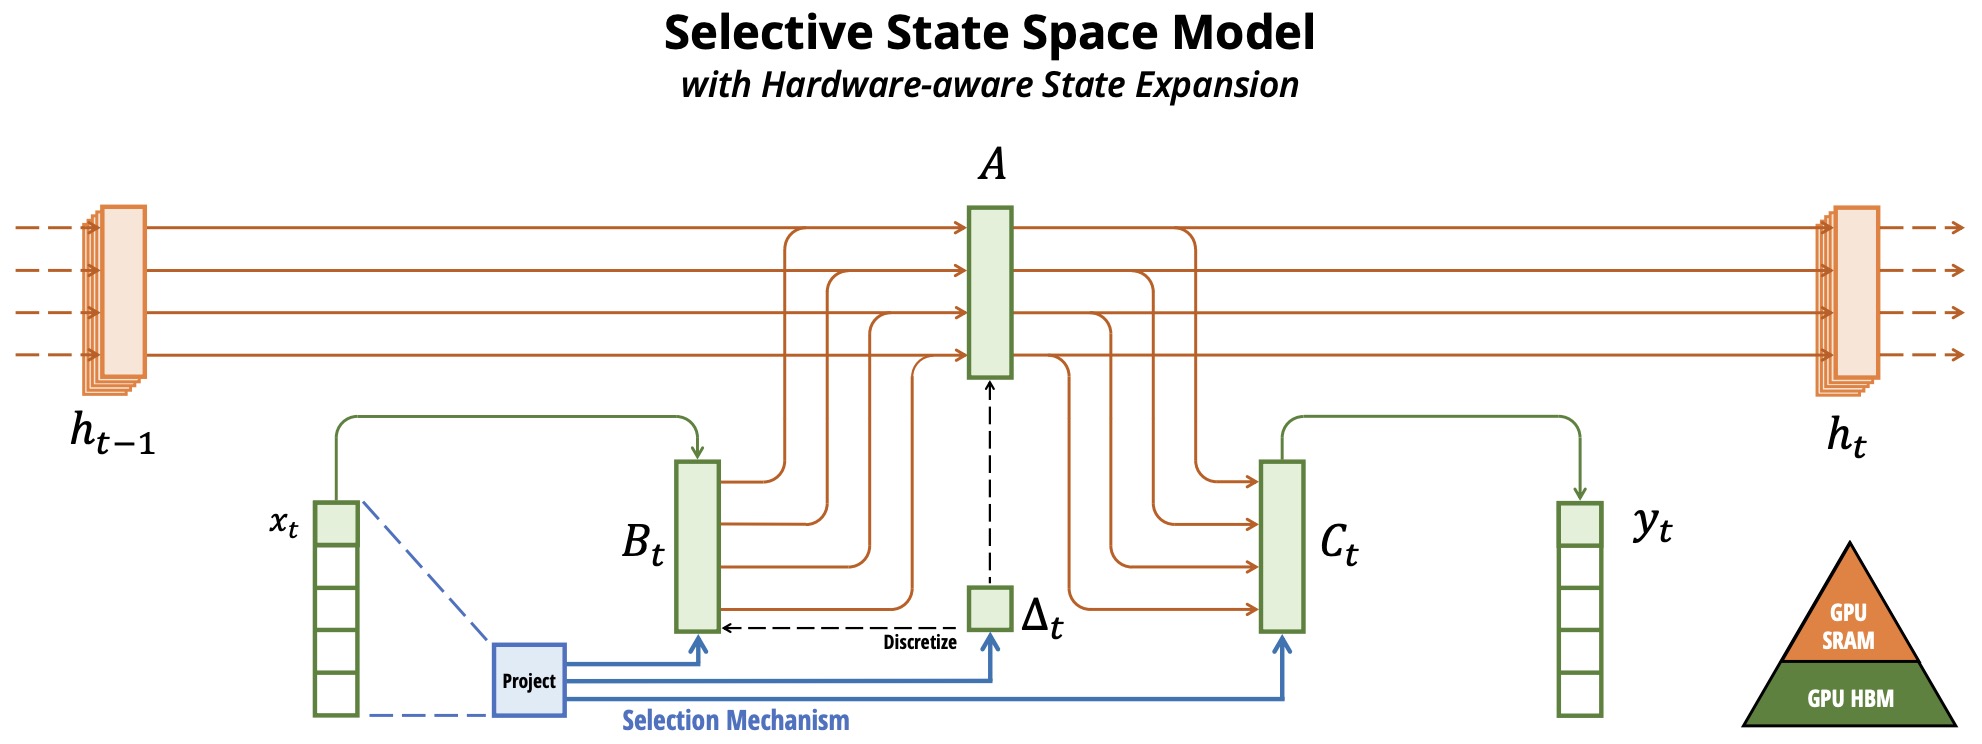
Aman's AI Journal • Primers • State Space Models

Towards Mamba State Space Models for Images, Videos and Time Series ...
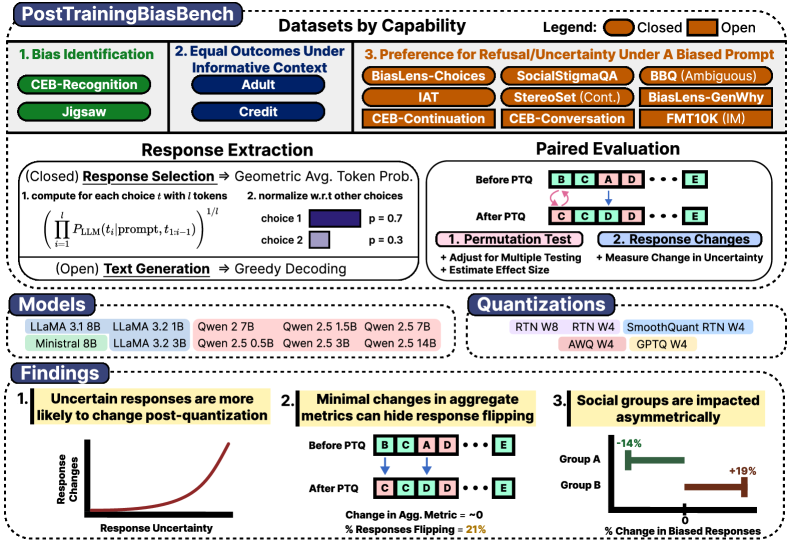
Post Training quantization | AI Research Papers

VSSD: Vision Mamba with Non-Casual State Space Duality | AI Research ...

Towards Mamba State Space Models for Images, Videos and Time Series ...

EAMamba: Efficient All-Around Vision State Space Model for Image ...

EAMamba: Efficient All-Around Vision State Space Model for Image ...

EAMamba: Efficient All-Around Vision State Space Model for Image ...

A Visual Guide to Mamba and State Space Models
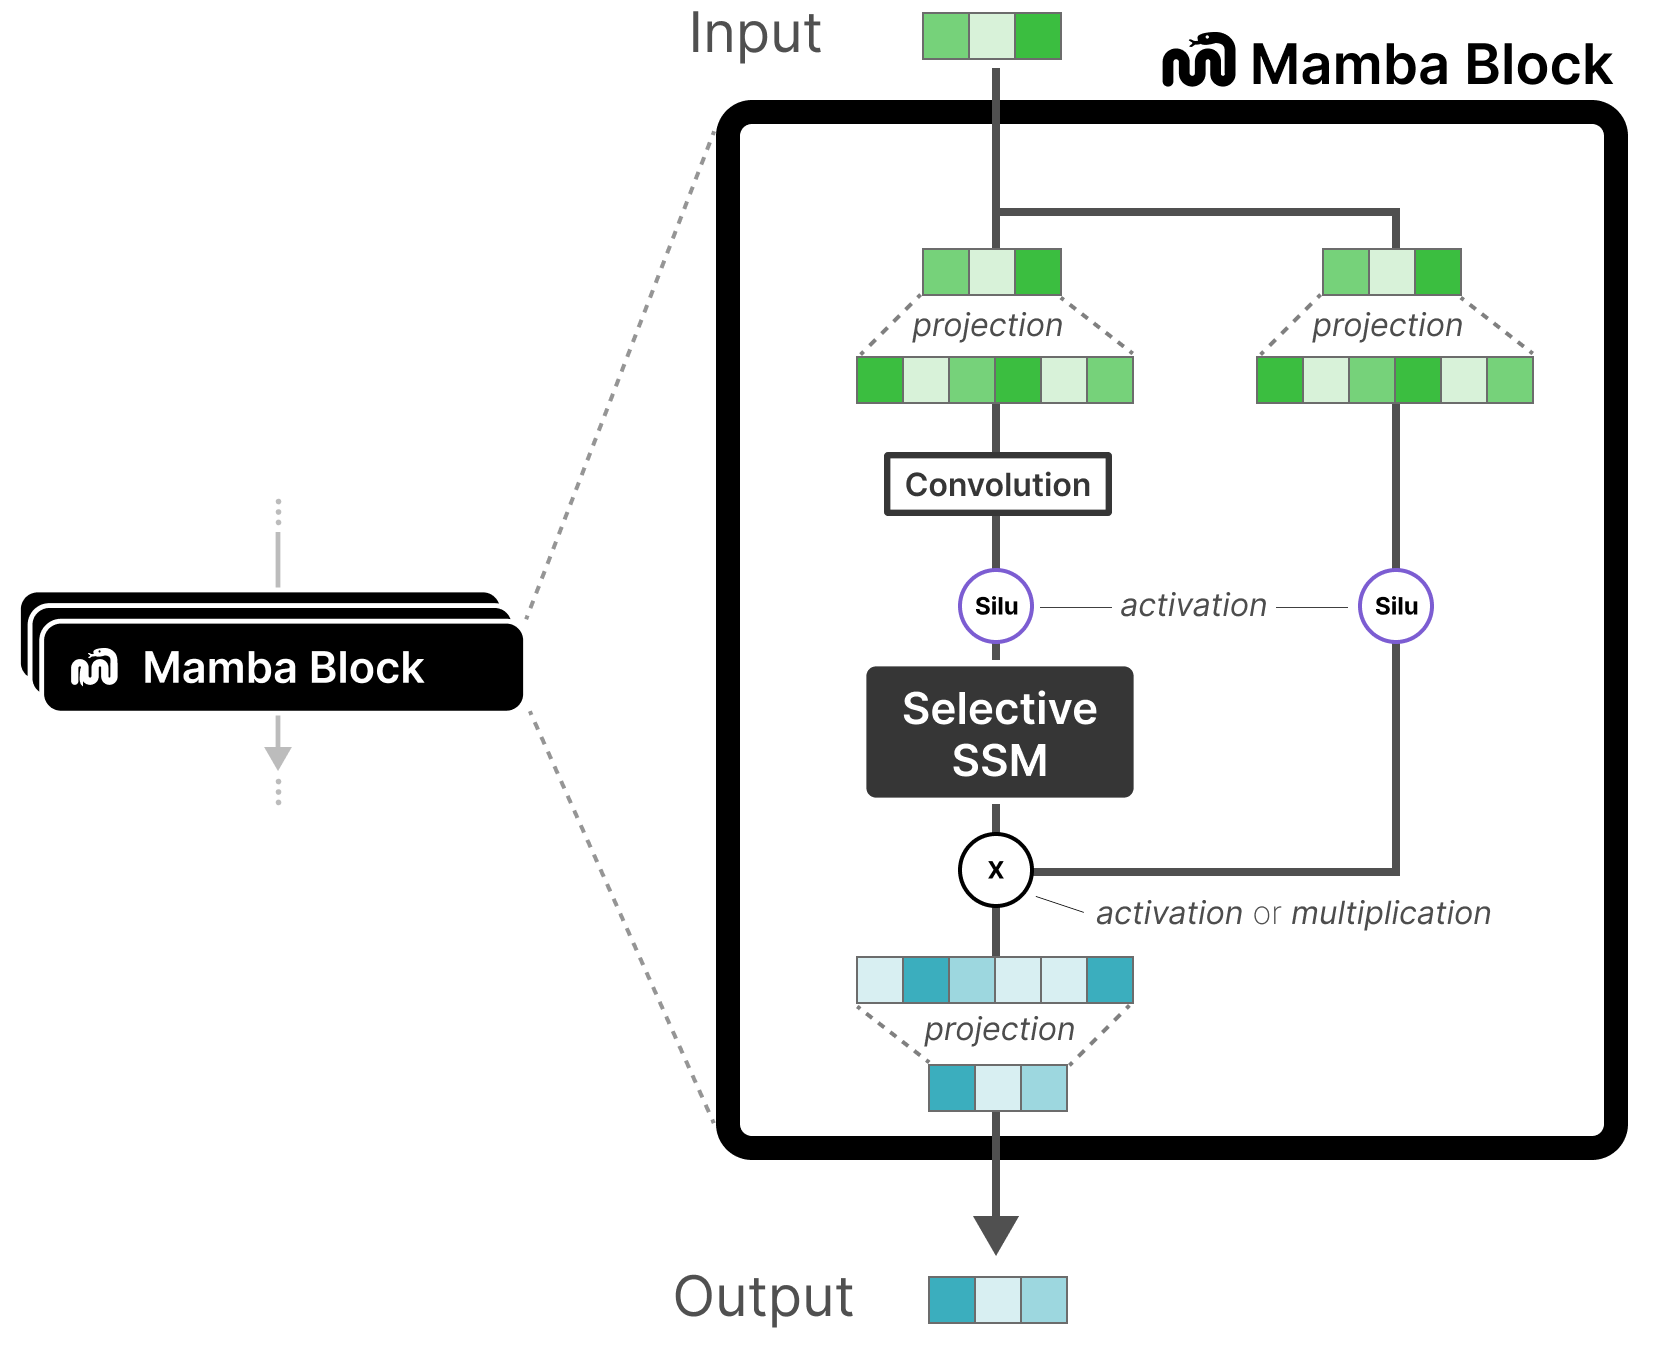
A Visual Guide to Mamba and State Space Models
Advertisement Space (336x280)

A Visual Guide to Mamba and State Space Models

WaterMamba: Visual State Space Model for Underwater Image Enhancement ...

A Visual Guide to Mamba and State Space Models

QuantVLA: Scale-Calibrated Post-Training Quantization for Vision ...

MGRQ: Post-Training Quantization For Vision Transformer With Mixed ...

VMamba: Visual State Space Model | AI Research Paper Details

A Visual Guide to Mamba and State Space Models

Free Video: State Space Models and Mamba - Revolutionizing Large ...

(PDF) Quamba: A Post-Training Quantization Recipe for Selective State ...

ICCV Poster OuroMamba: A Data-Free Quantization Framework for Vision Mamba
Advertisement Space (336x280)
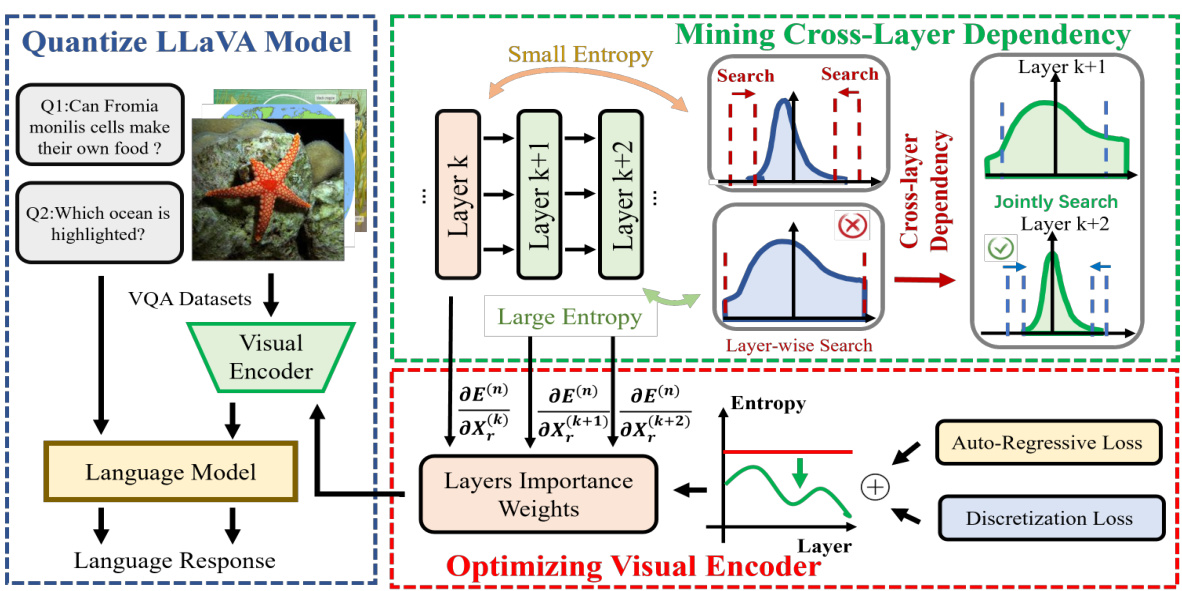
Q-VLM: Post-training Quantization for Large Vision-Language Models ...

[论文评述] DAMamba: Vision State Space Model with Dynamic Adaptive Scan
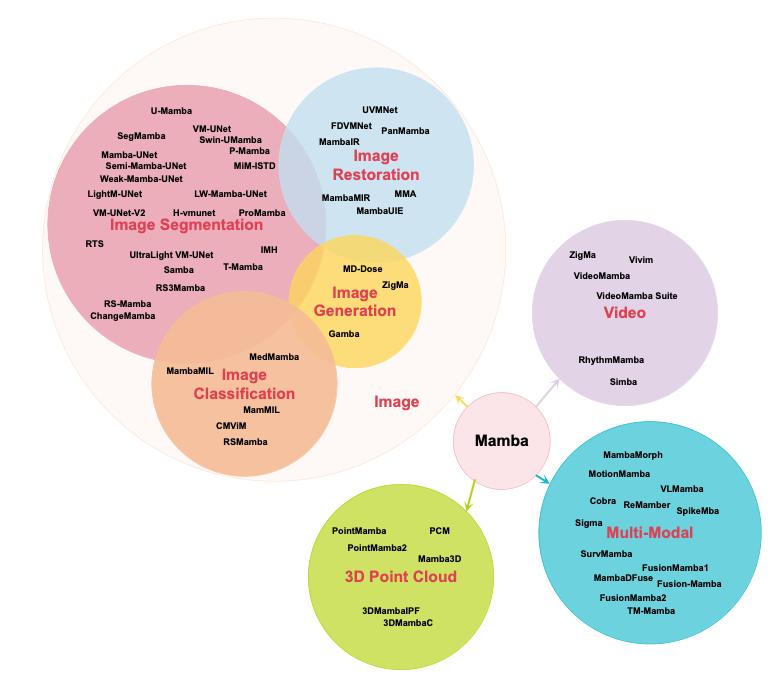
Structured State Space Sequence Models (S4) and Mamba Explained: A ...

[论文评述] CMamba: Learned Image Compression with State Space Models

[论文评述] ZeroMamba: Exploring Visual State Space Model for Zero-Shot Learning

AdaLog: Post-Training Quantization for Vision Transformers with ...