
Quantization Ai Model Compression For Efficient Deployment Inference
Quantization: AI Model Compression for Efficient Deployment | Inference ...
How to Implement Quantization for Efficient Model Deployment ...
Quantization in AI: Model Compression for Edge Inference | Inference ...
Edge AI Model Compression & Quantization | Inference Systems
Model Quantization: AI Compression for Edge Devices | Inference Systems
Quantization: AI Model Compression for Edge Devices | Inference Systems
Quantization: AI Model Compression for Faster Inference | Inference Systems
Quantization: AI Model Compression for Microcontrollers | Inference Systems
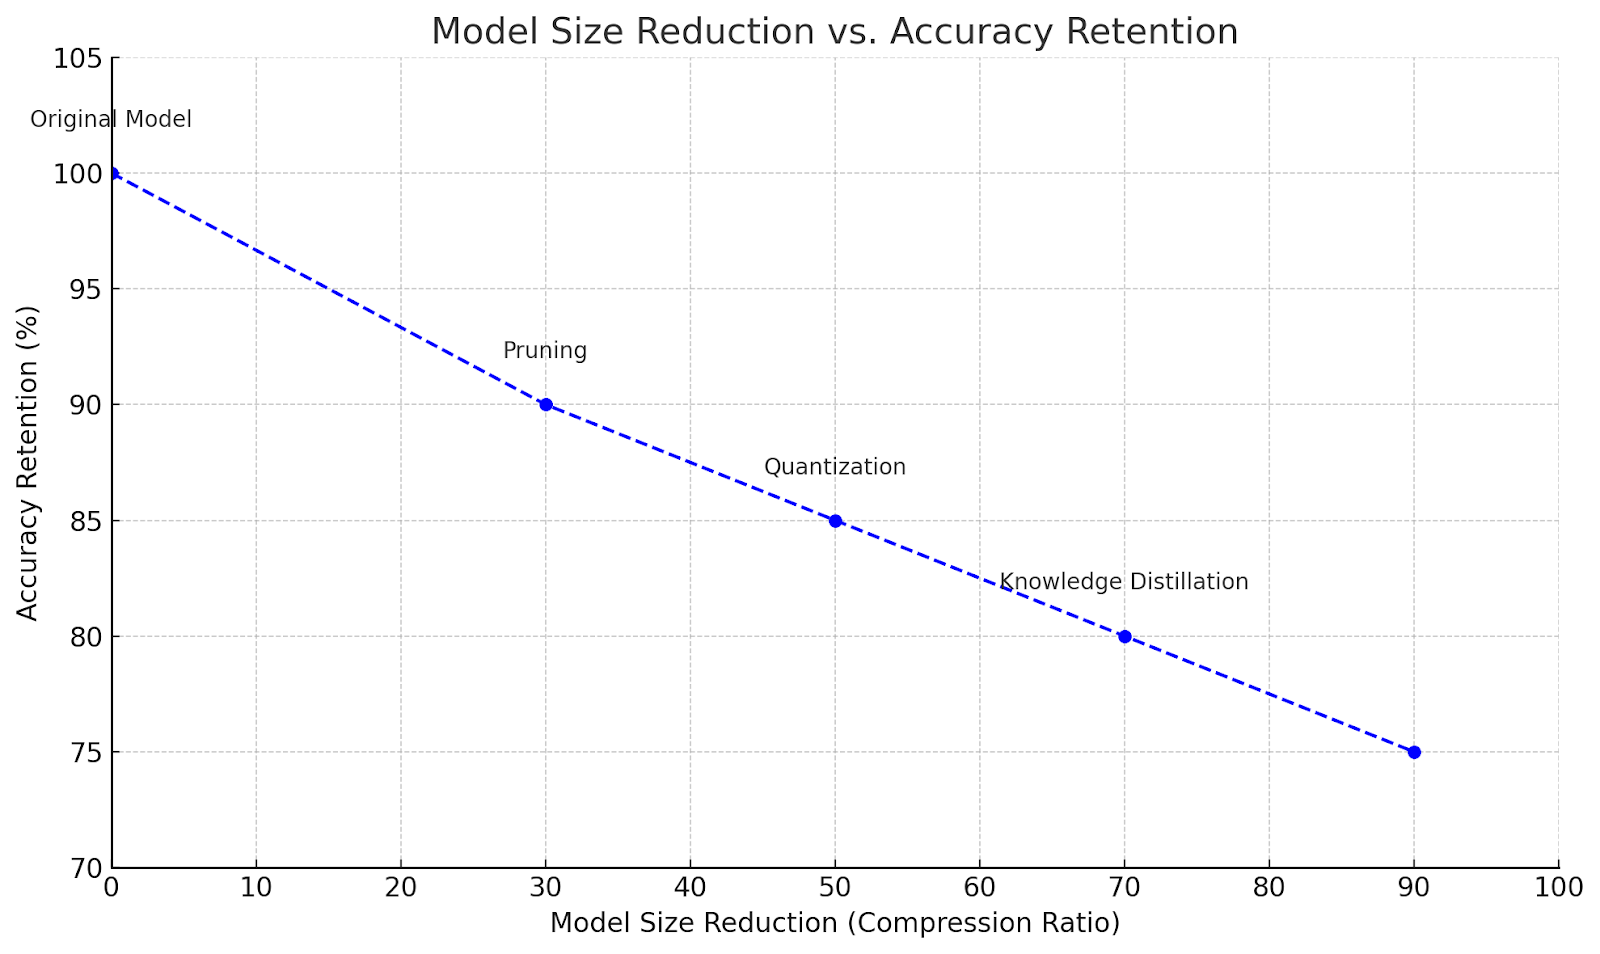
AI Model Compression Techniques for Cost-Efficient Cloud Deployment

AI Model Compression Techniques for Cost-Efficient Cloud Deployment
Advertisement Space (300x250)
Shrink to Win: Mastering AI Model Compression for Edge Deployment ...
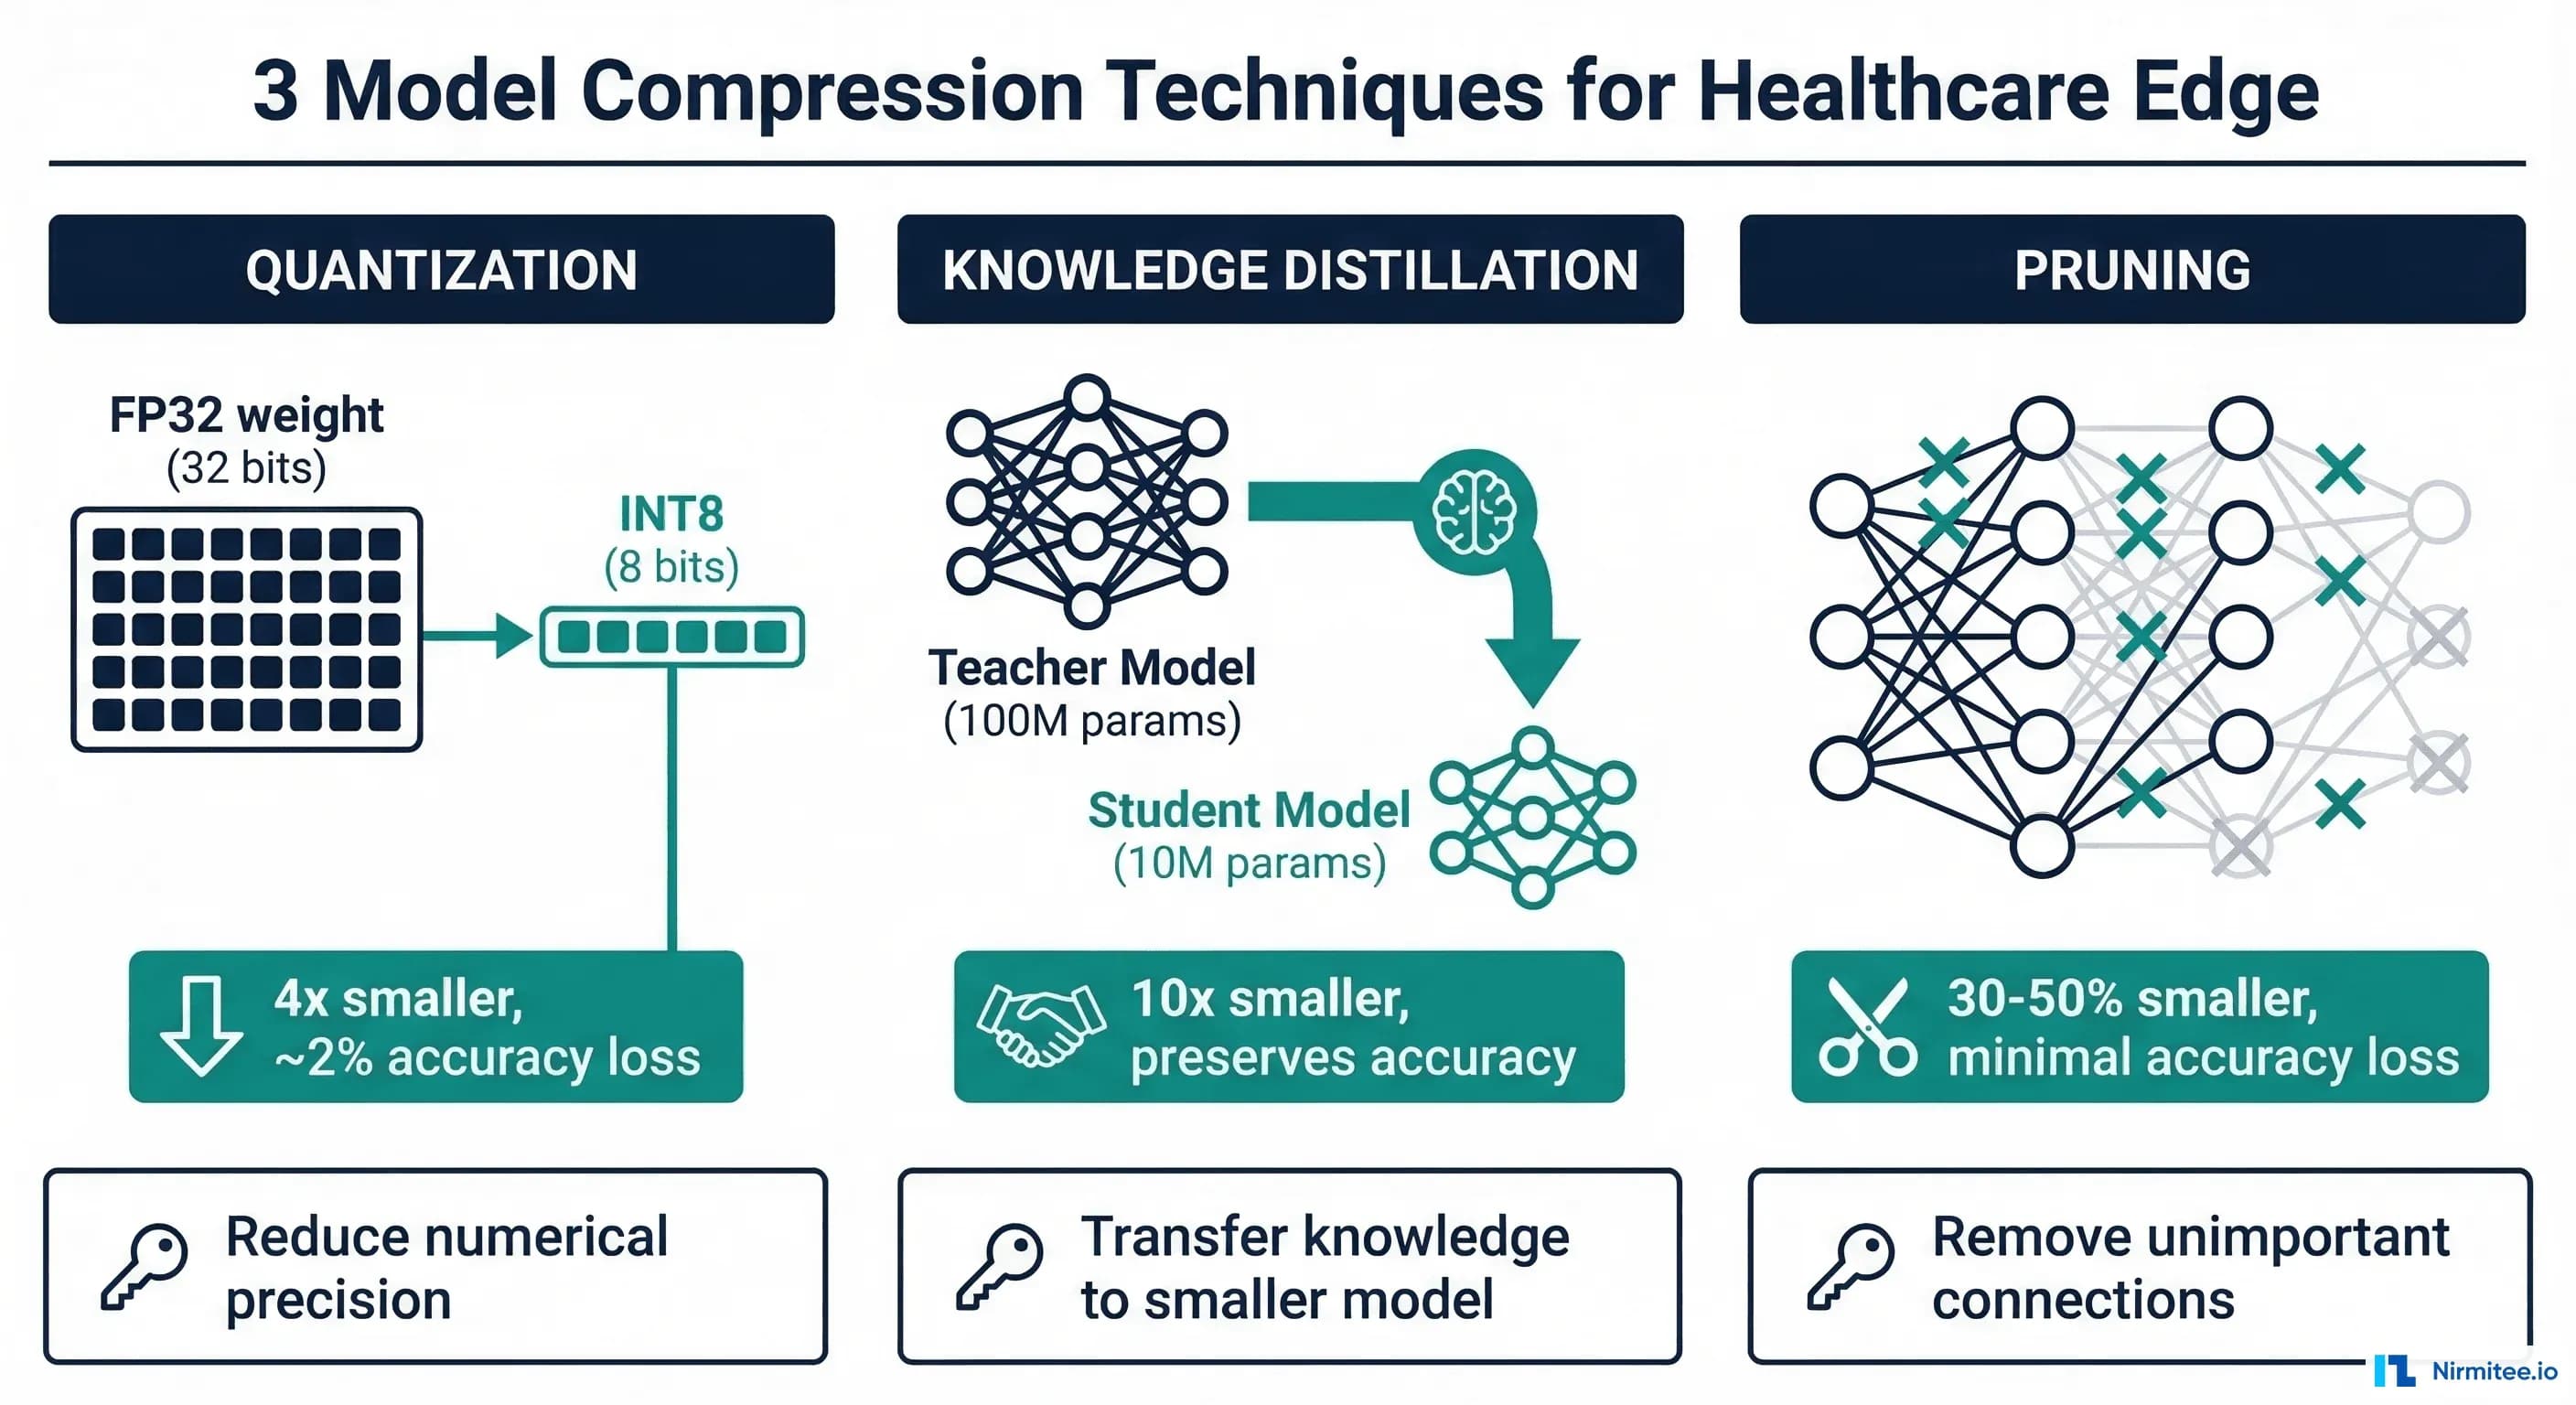
Model Compression Techniques for Healthcare AI
Quantization-Aware Distillation | AI Model Compression | Inference Systems
Quantization-Aware Training (QAT) | AI Model Compression | Inference ...
Symmetric Quantization: AI Model Compression Explained | Inference Systems
Binary Quantization: AI Model Compression to 1-Bit | Inference Systems
Sparse Quantization: Definition & AI Model Compression | Inference Systems
Quantization: AI Model Compression Technique | Inference Systems
Symmetric Quantization: AI Model Compression Explained | Inference Systems

Free Video: Quantization Techniques for Efficient Large Language Model ...
Advertisement Space (336x280)

Model Quantization in Edge AI for Enhanced Performance
Latest Trends in Efficient Compression and Quantization of Large AI ...
Quantization for Large Language Models (LLMs): Reduce AI Model Sizes ...
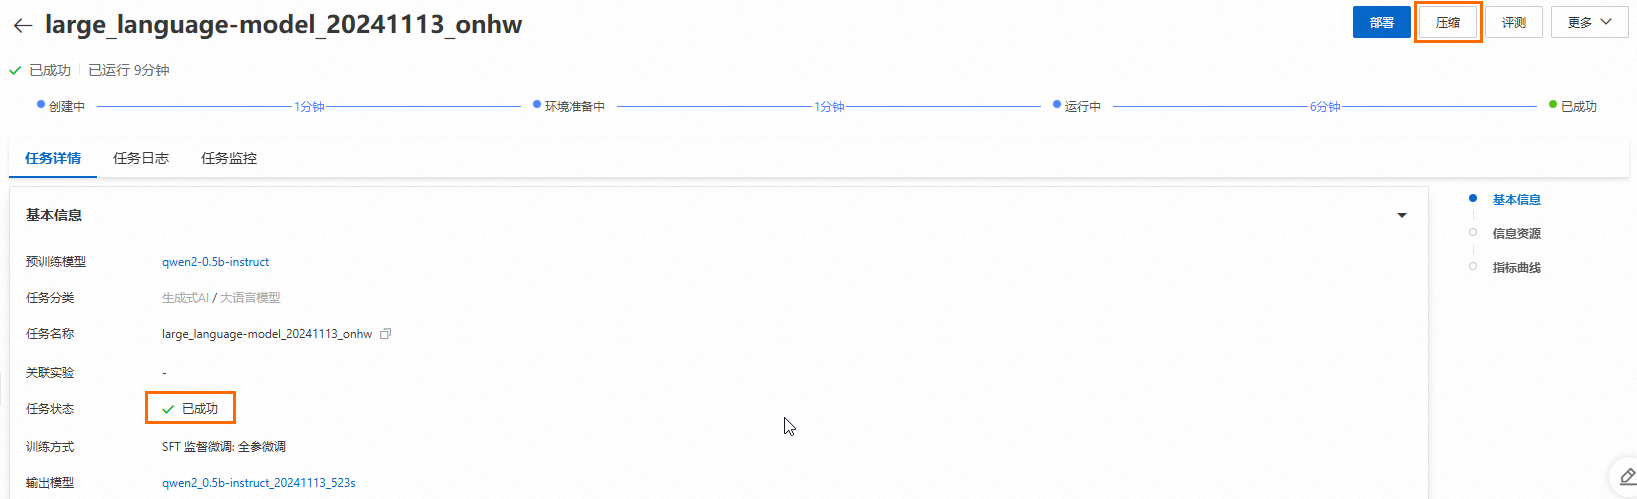
Quantize LLMs with Weight-only Quantization for Efficient Inference ...

A Deep Dive into Model Quantization for Large-Scale Deployment ...
AI Model Compression: Pruning and Quantization Strategies for Real-Time ...

Top 5 AI Model Optimization Techniques for Faster, Smarter Inference ...
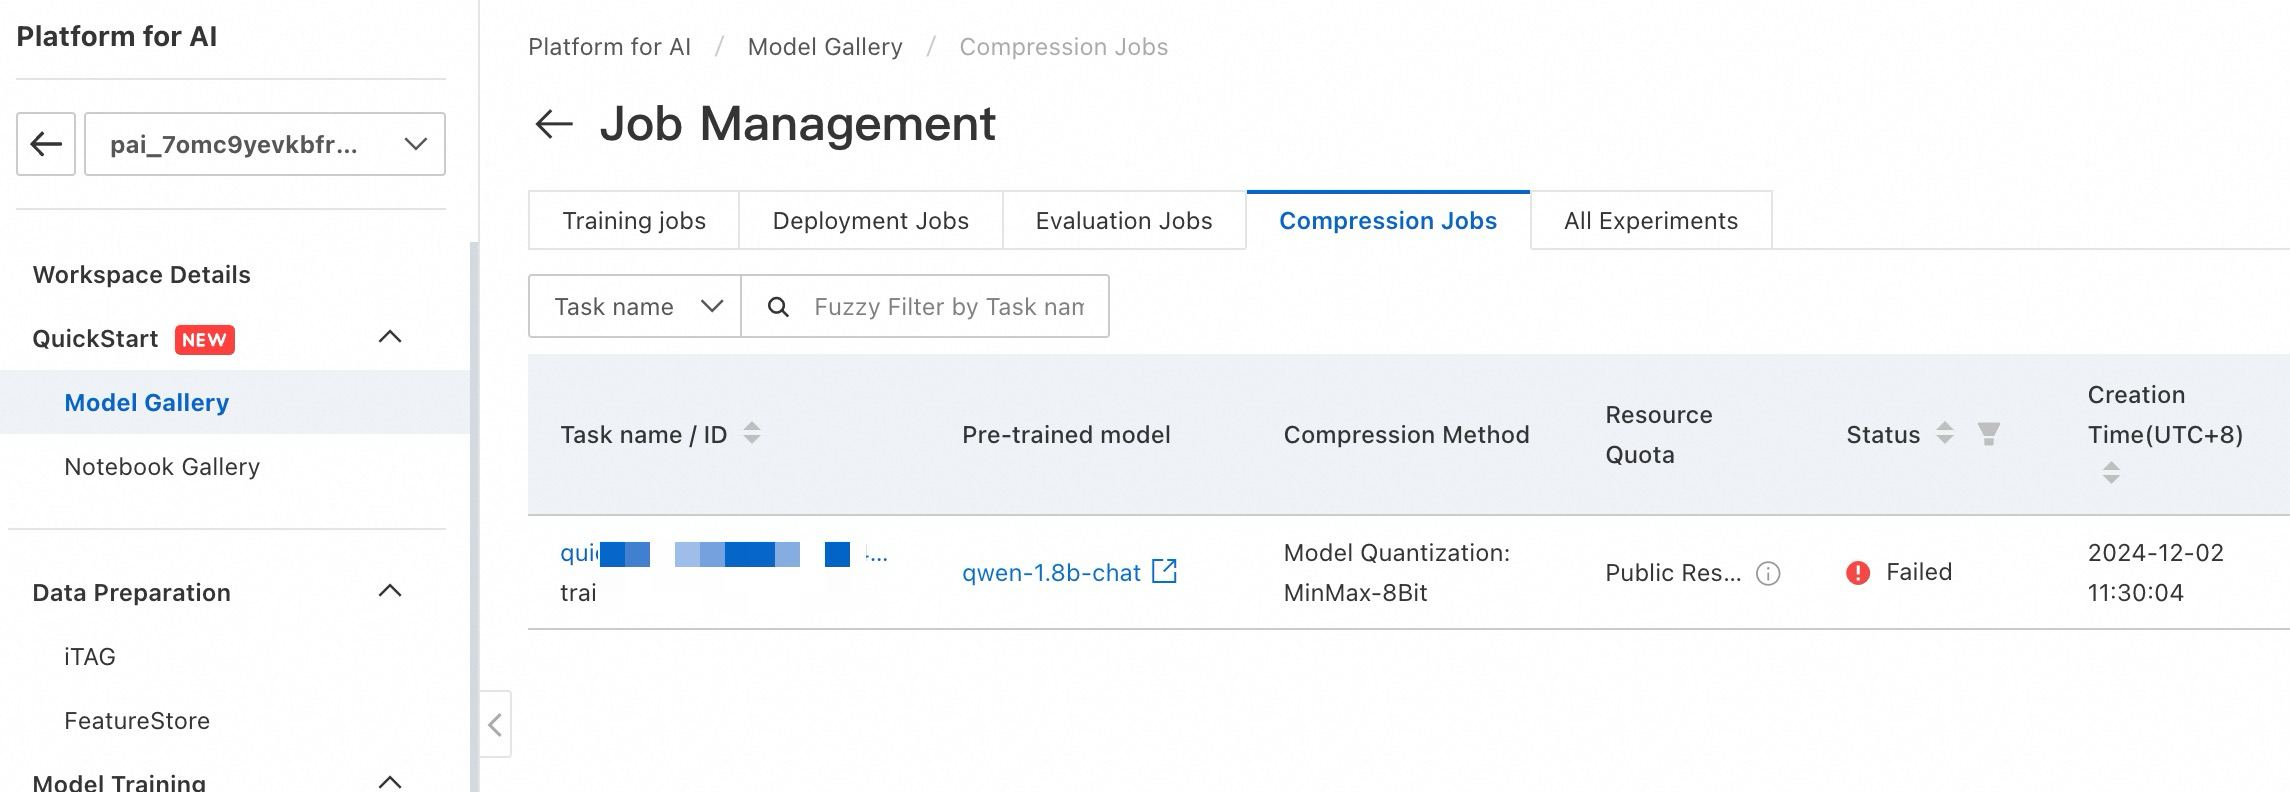
Quantize LLMs with Weight-only Quantization for Efficient Inference ...

Top 5 AI Model Optimization Techniques for Faster, Smarter Inference ...
AI Model Compression: Pruning and Quantization Strategies for Real-Time ...
Advertisement Space (336x280)
AI Model Compression Techniques That Cut Inference Costs...

Neural Network Quantization for High-Performance AI Systems: Advanced ...

Figure 1.1 from Neural Network Quantization with AI Model Efficiency ...
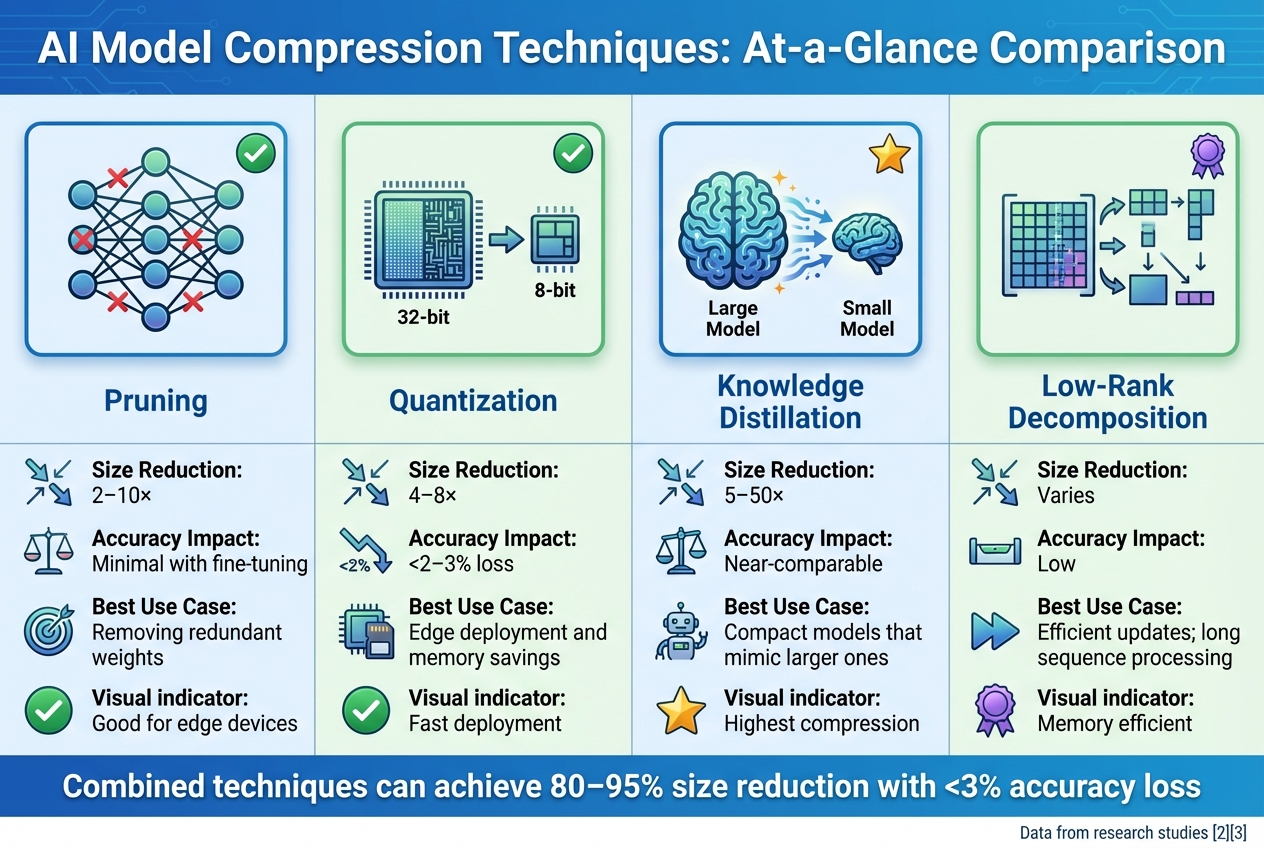
Impact of Compression on AI Model Scalability | NanoGPT

Figure 4.1 from Neural Network Quantization with AI Model Efficiency ...

Figure 3.3 from Neural Network Quantization with AI Model Efficiency ...