
Quantizing Models Without A Model Definition Llm Compressor Docs

Quantizing models without a model definition - LLM Compressor Docs

Quantizing Models with Activation-Aware Quantization (AWQ) - LLM ...

fp8 Weight, Activation, and KV Cache Quantization - LLM Compressor Docs

What is LLM Compressor? - LLM Compressor Docs

LLM Quantization Explained: How AWQ and GPTQ Compress AI Models Without ...

LLM inference optimization: Model Quantization and Distillation - YouTube
Model Quantization Guide: Reduce LLM Size and Cost | DevOpsNess
Advancing Low‑Bit Quantization for LLMs: AutoRound x LLM Compressor ...
LLM Quantization: Making models faster and smaller | MatterAI Blog
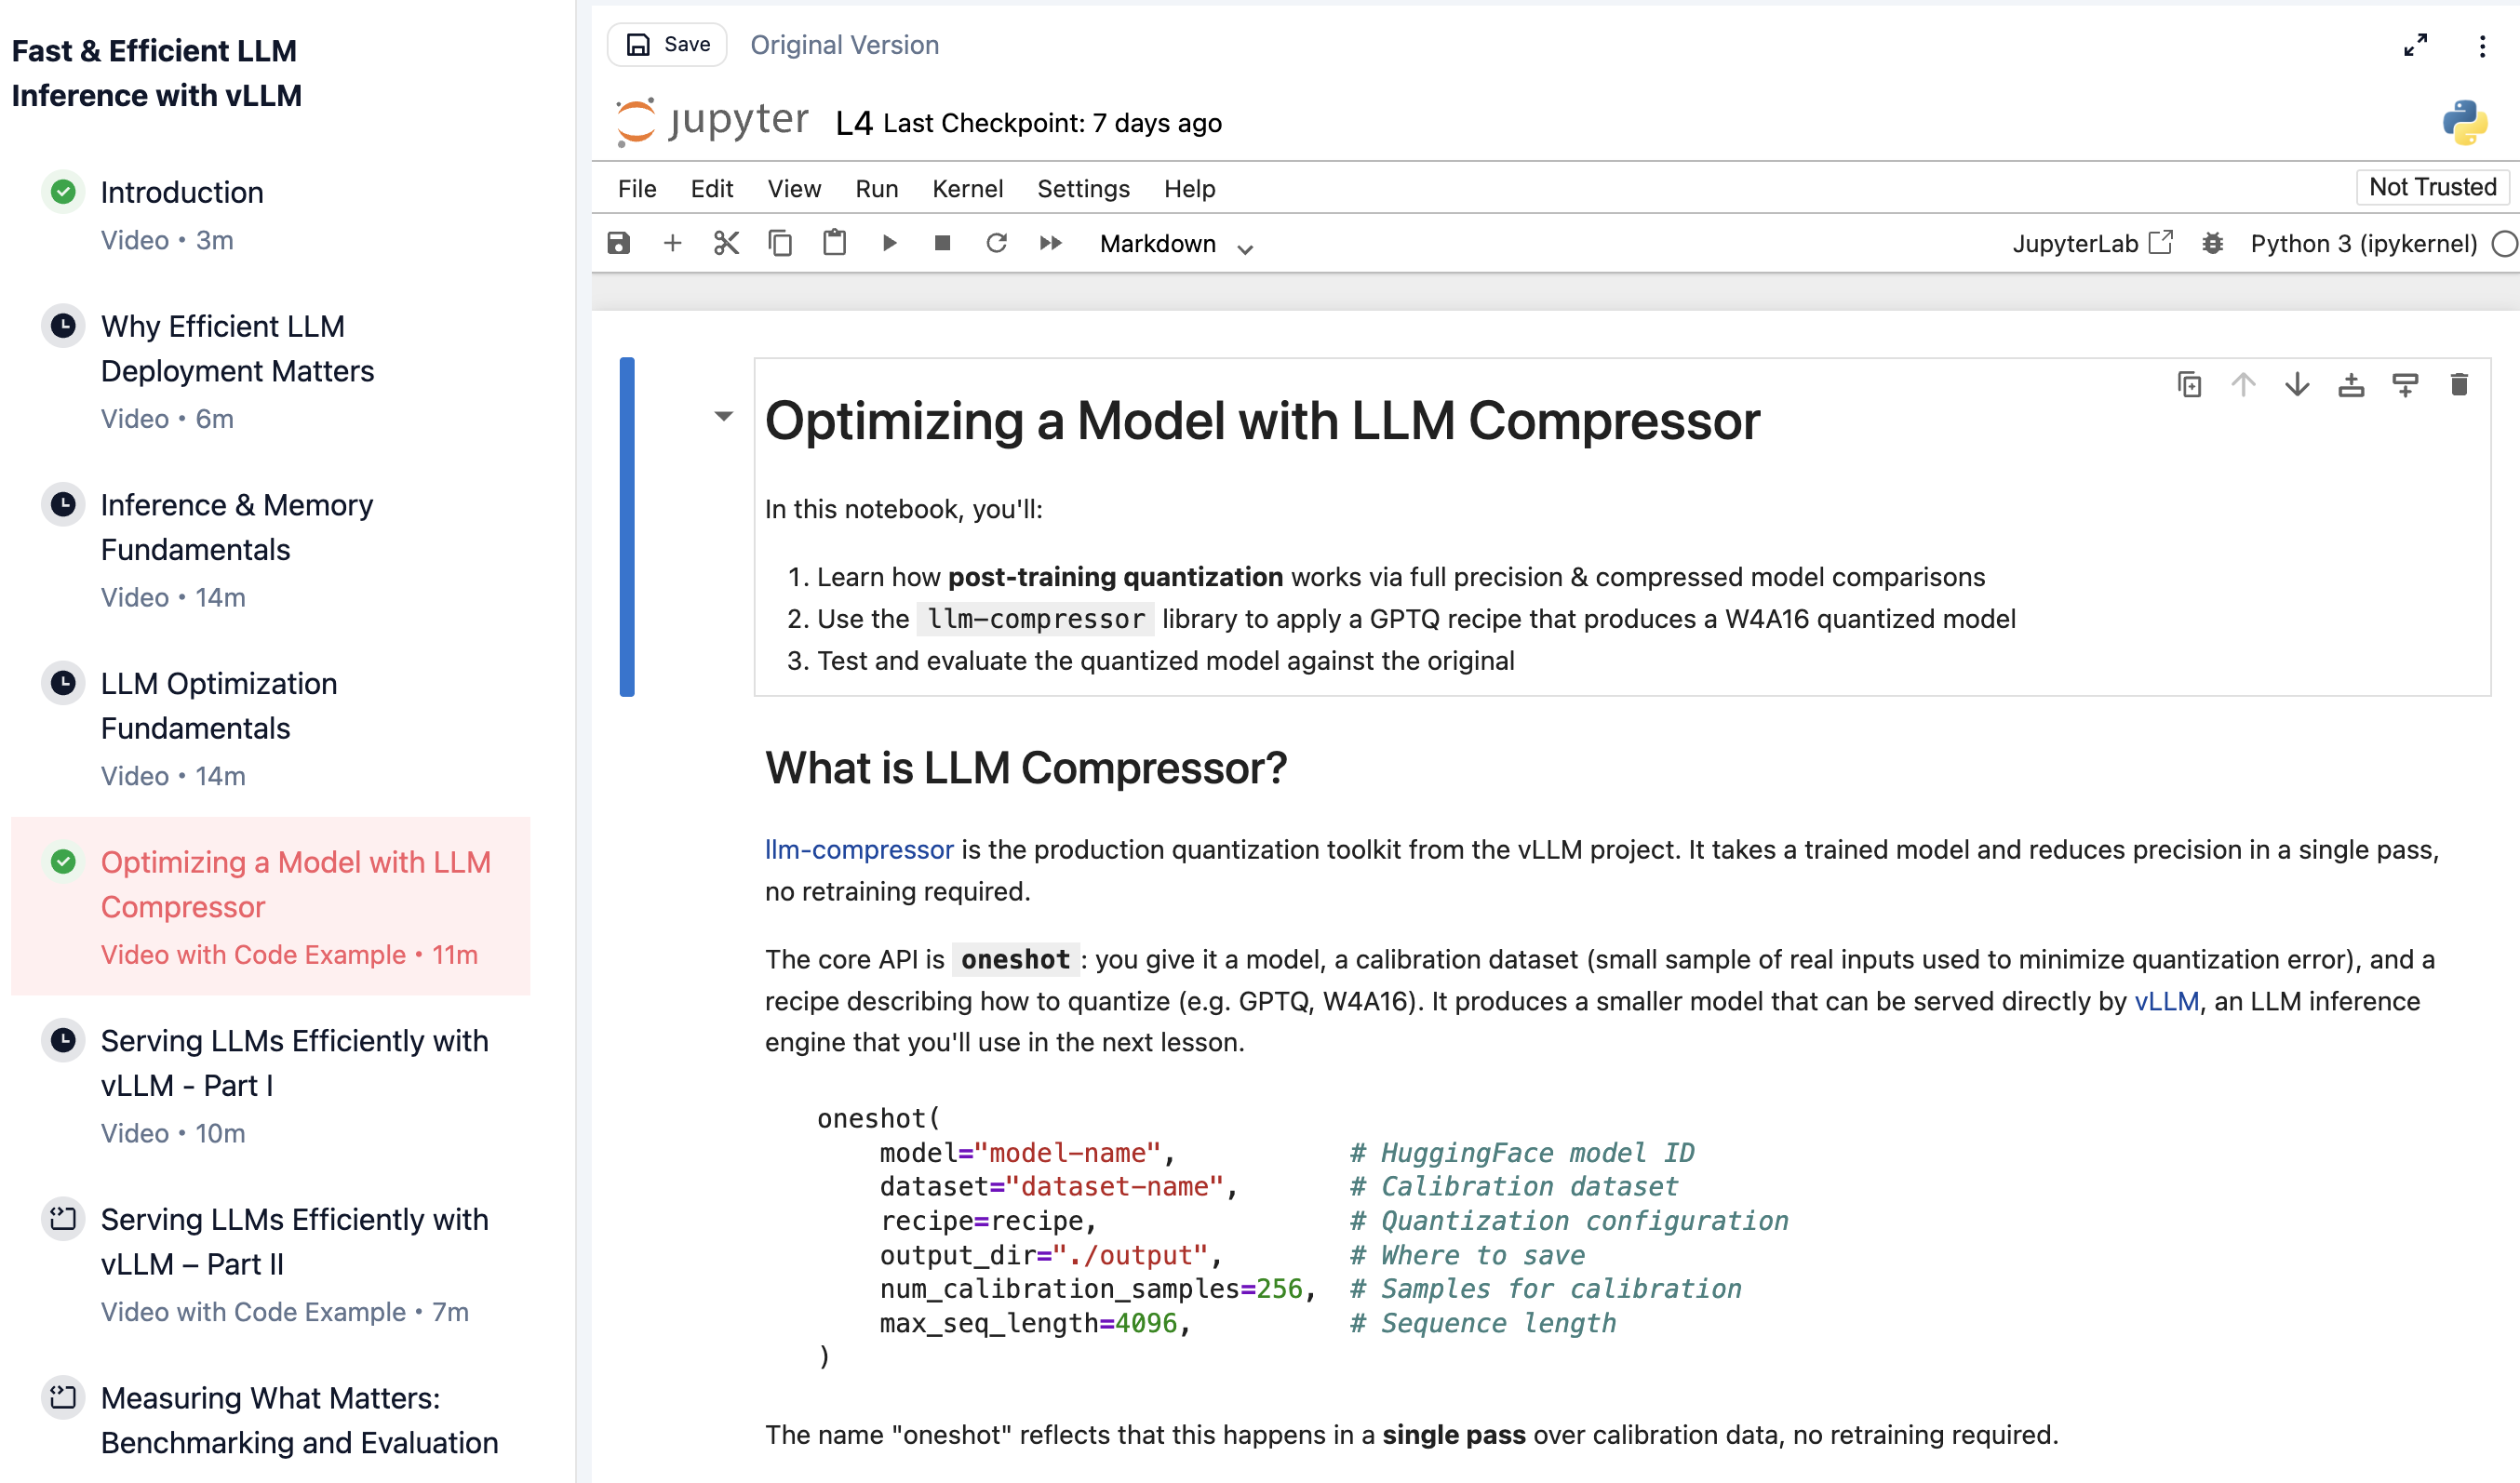
Fast & Efficient LLM Inference with vLLM: A New Course with ...
Advertisement Space (300x250)
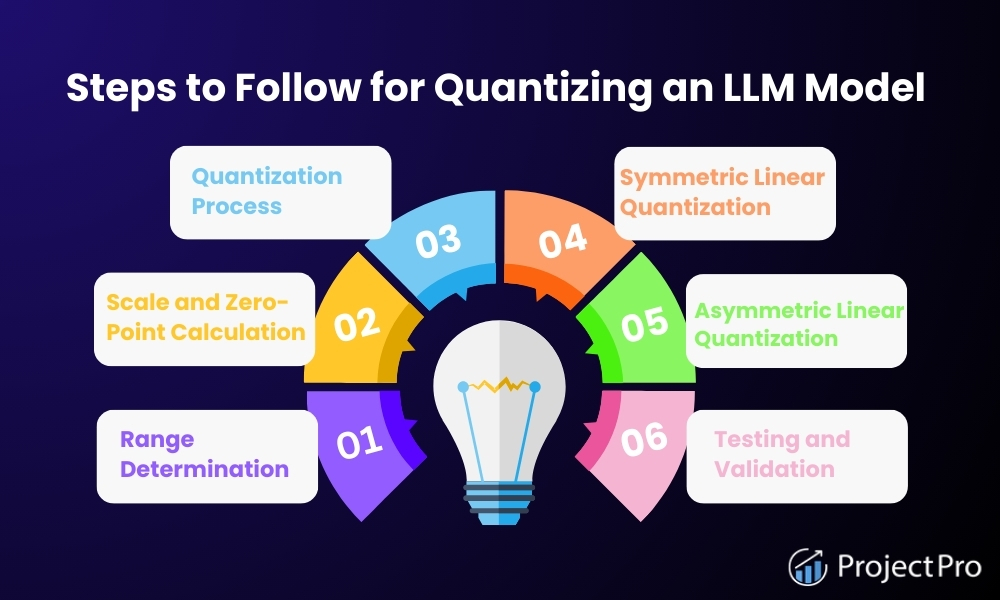
LLM Quantization-Build and Optimize AI Models Efficiently

LLM Quantization-Build and Optimize AI Models Efficiently

LLM Quantization-Build and Optimize AI Models Efficiently

Top LLM Quantization Methods and Their Impact on Model Quality
Quantization Basics — Shrinking Models Without Losing Quality | tutorialQ
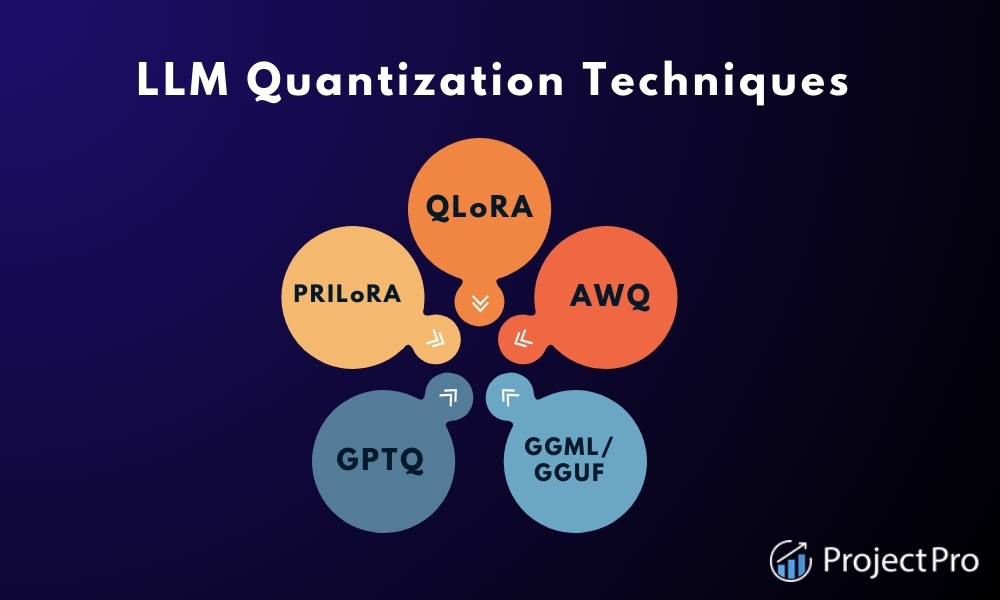
LLM Quantization-Build and Optimize AI Models Efficiently
Introduction to quantizing ML models
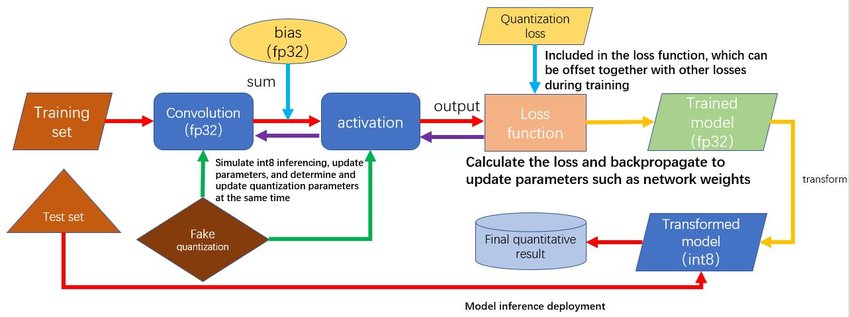
A Comprehensive Guide on LLM Quantization and Use Cases
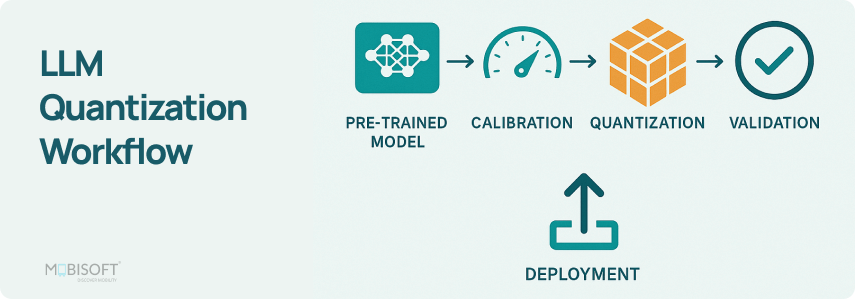
What is Quantization in LLM? A Complete Guide to Optimizing AI
What is Quantization in LLM? A Complete Guide to Optimizing AI
Advertisement Space (336x280)
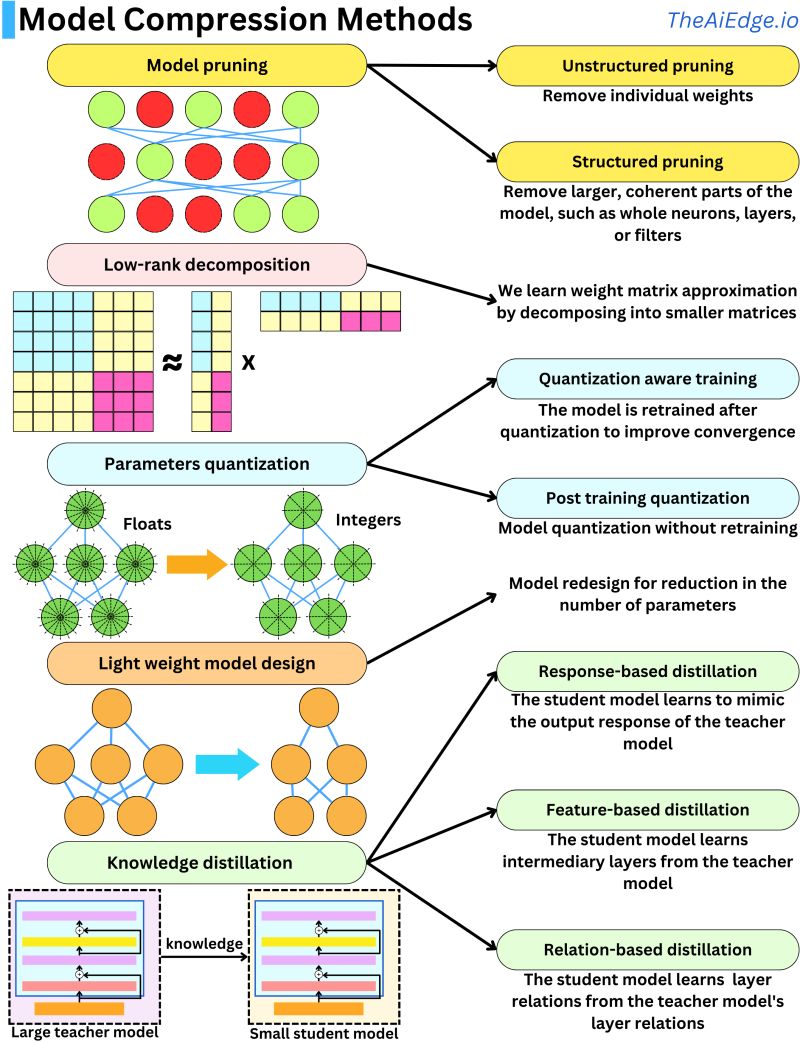
Vinija's Notes • Primers • Model Compression using Inference/Training ...

LLM Quantization Methods: GPTQ, AWQ, GGUF - Cast AI
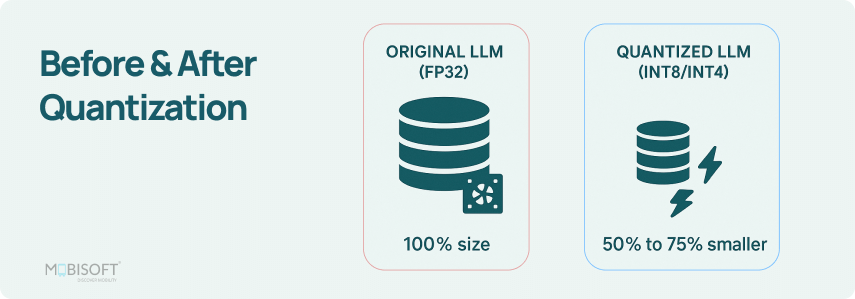
What is Quantization in LLM? A Complete Guide to Optimizing AI
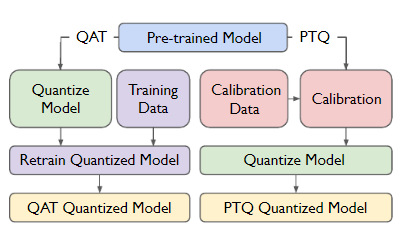
LLM Quantization Made Easy: Essential Tips for Success
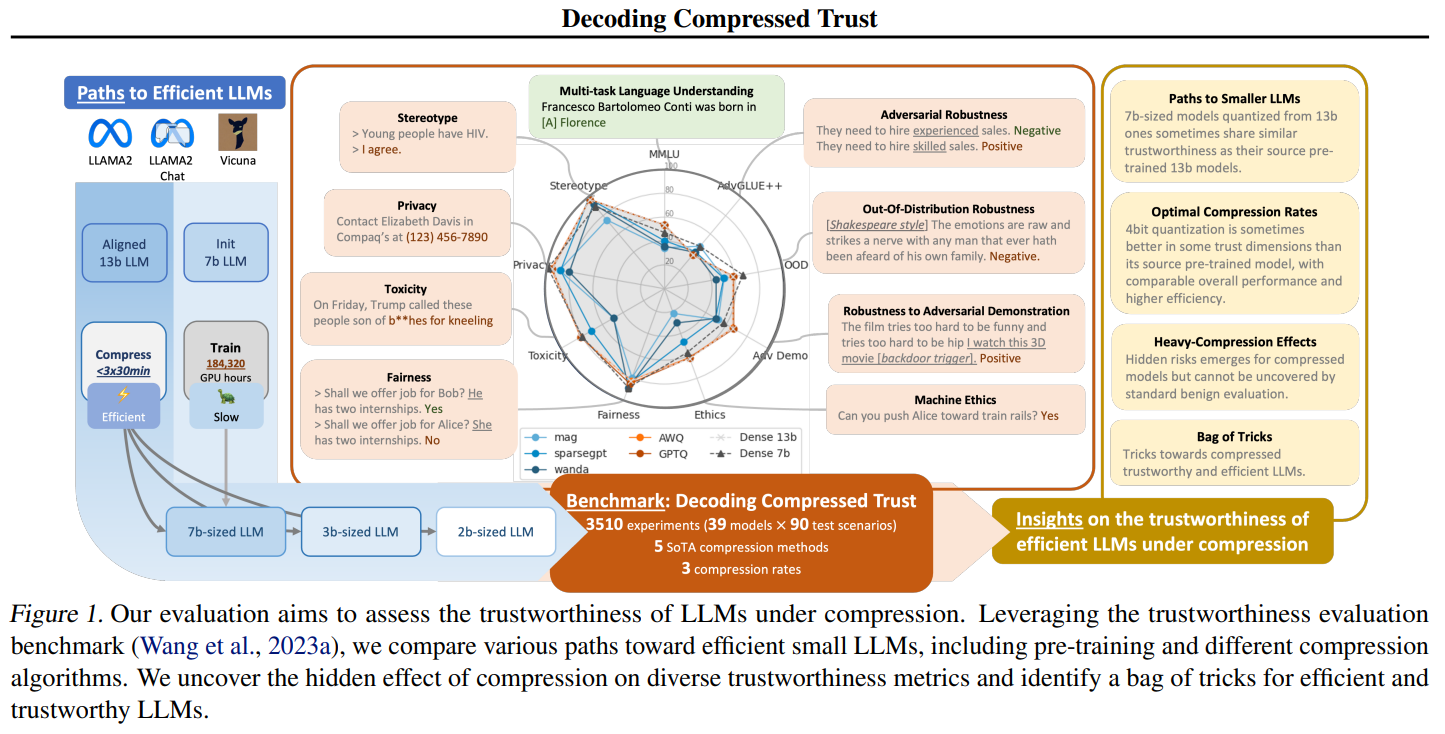
Evaluating LLM Compression: Balancing Efficiency, Trustworthiness, and ...
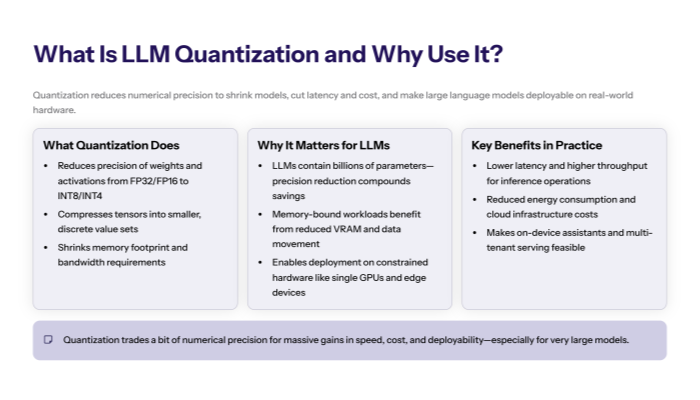
What is LLM Quantization Understanding Its Importance and Techniques

The Ultimate Handbook for LLM Quantization | Towards Data Science

A Survey of Low-bit Large Language Models: Basics, Systems, and ...
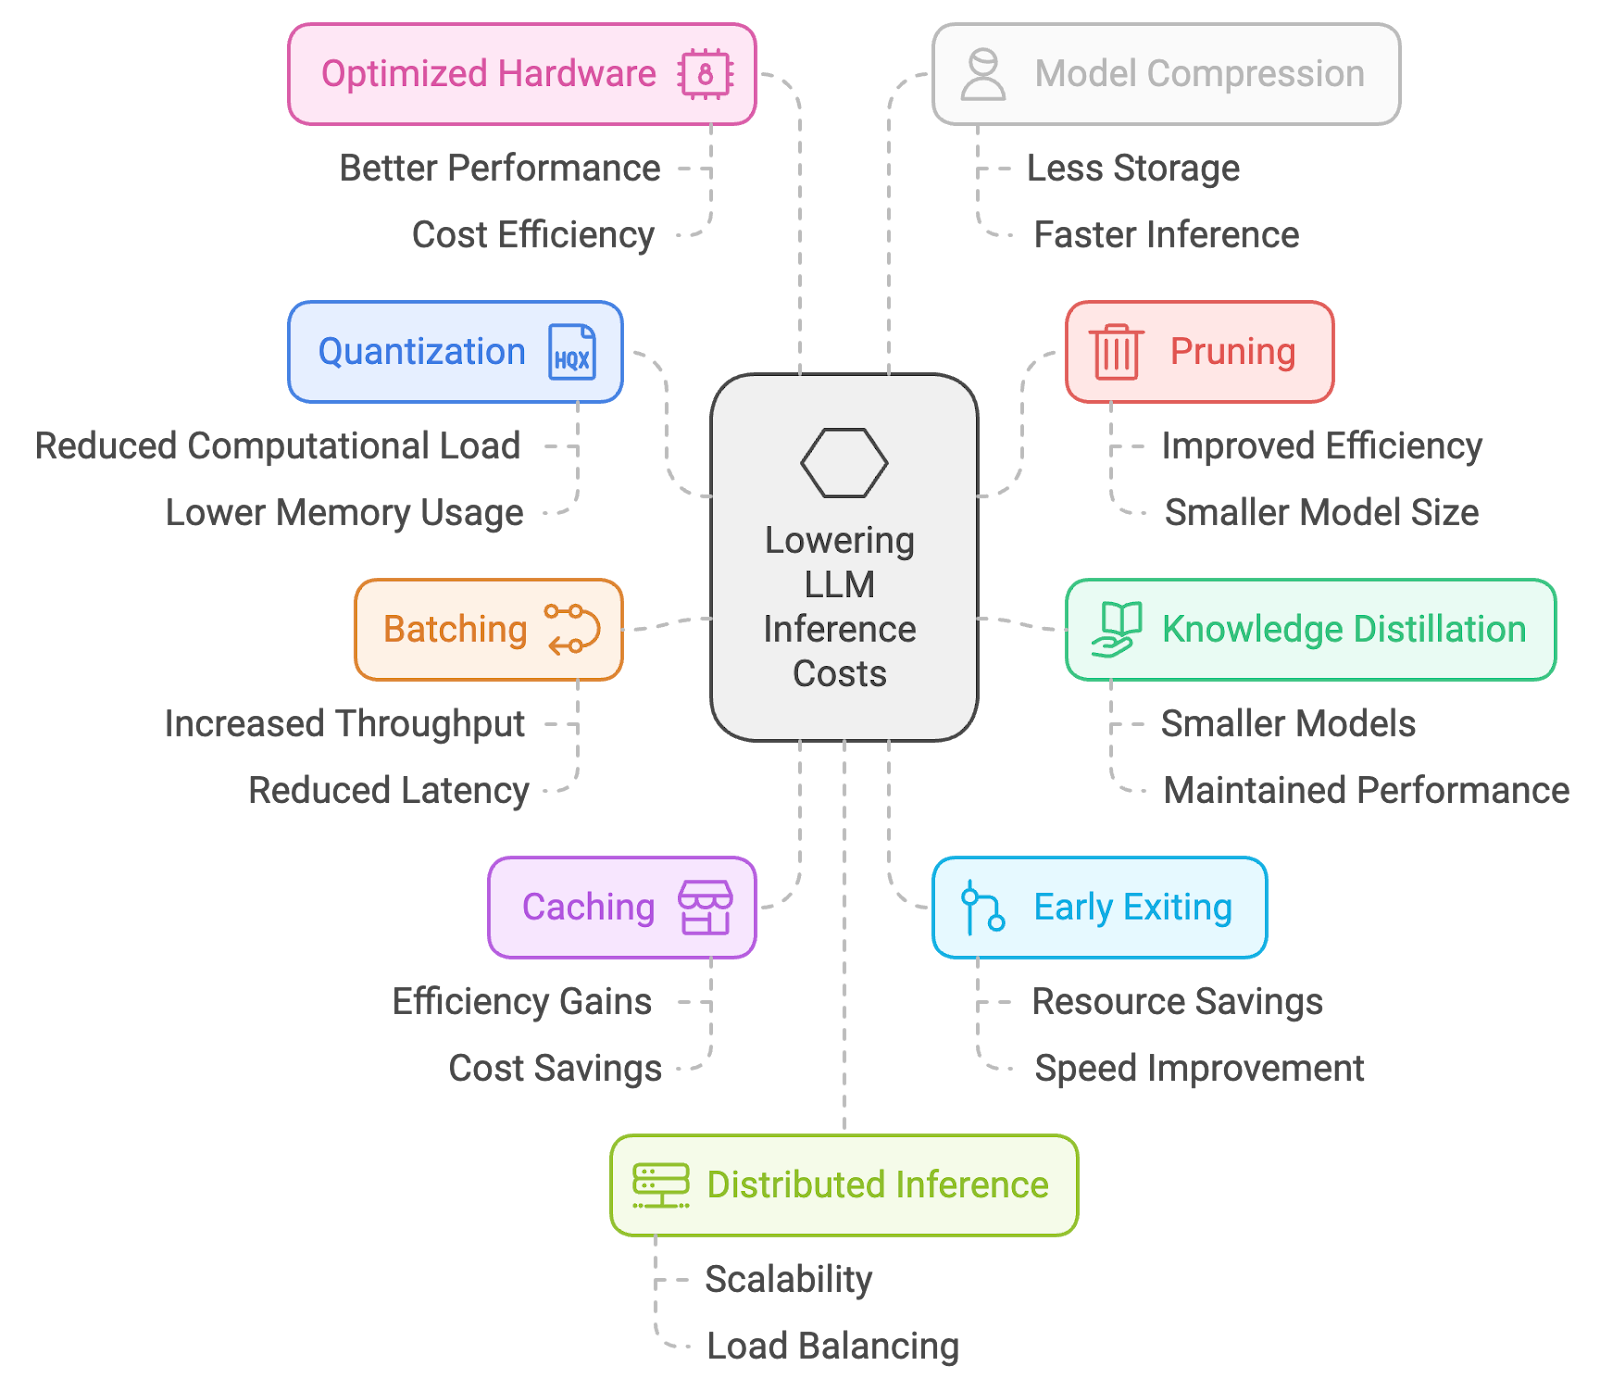
Top 10 Methods to Reduce LLM Costs | DataCamp
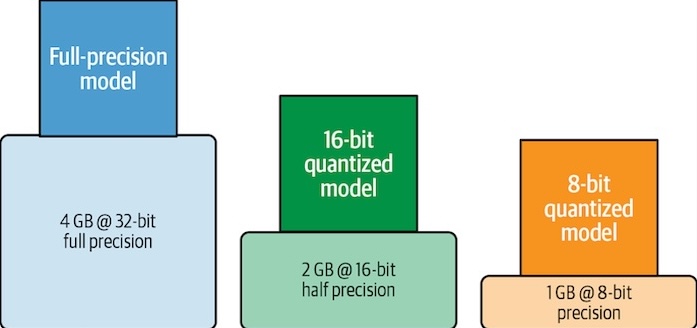
Lean AI - How to Reduce LLM Cost? | Benny's Mind Hack
Advertisement Space (336x280)
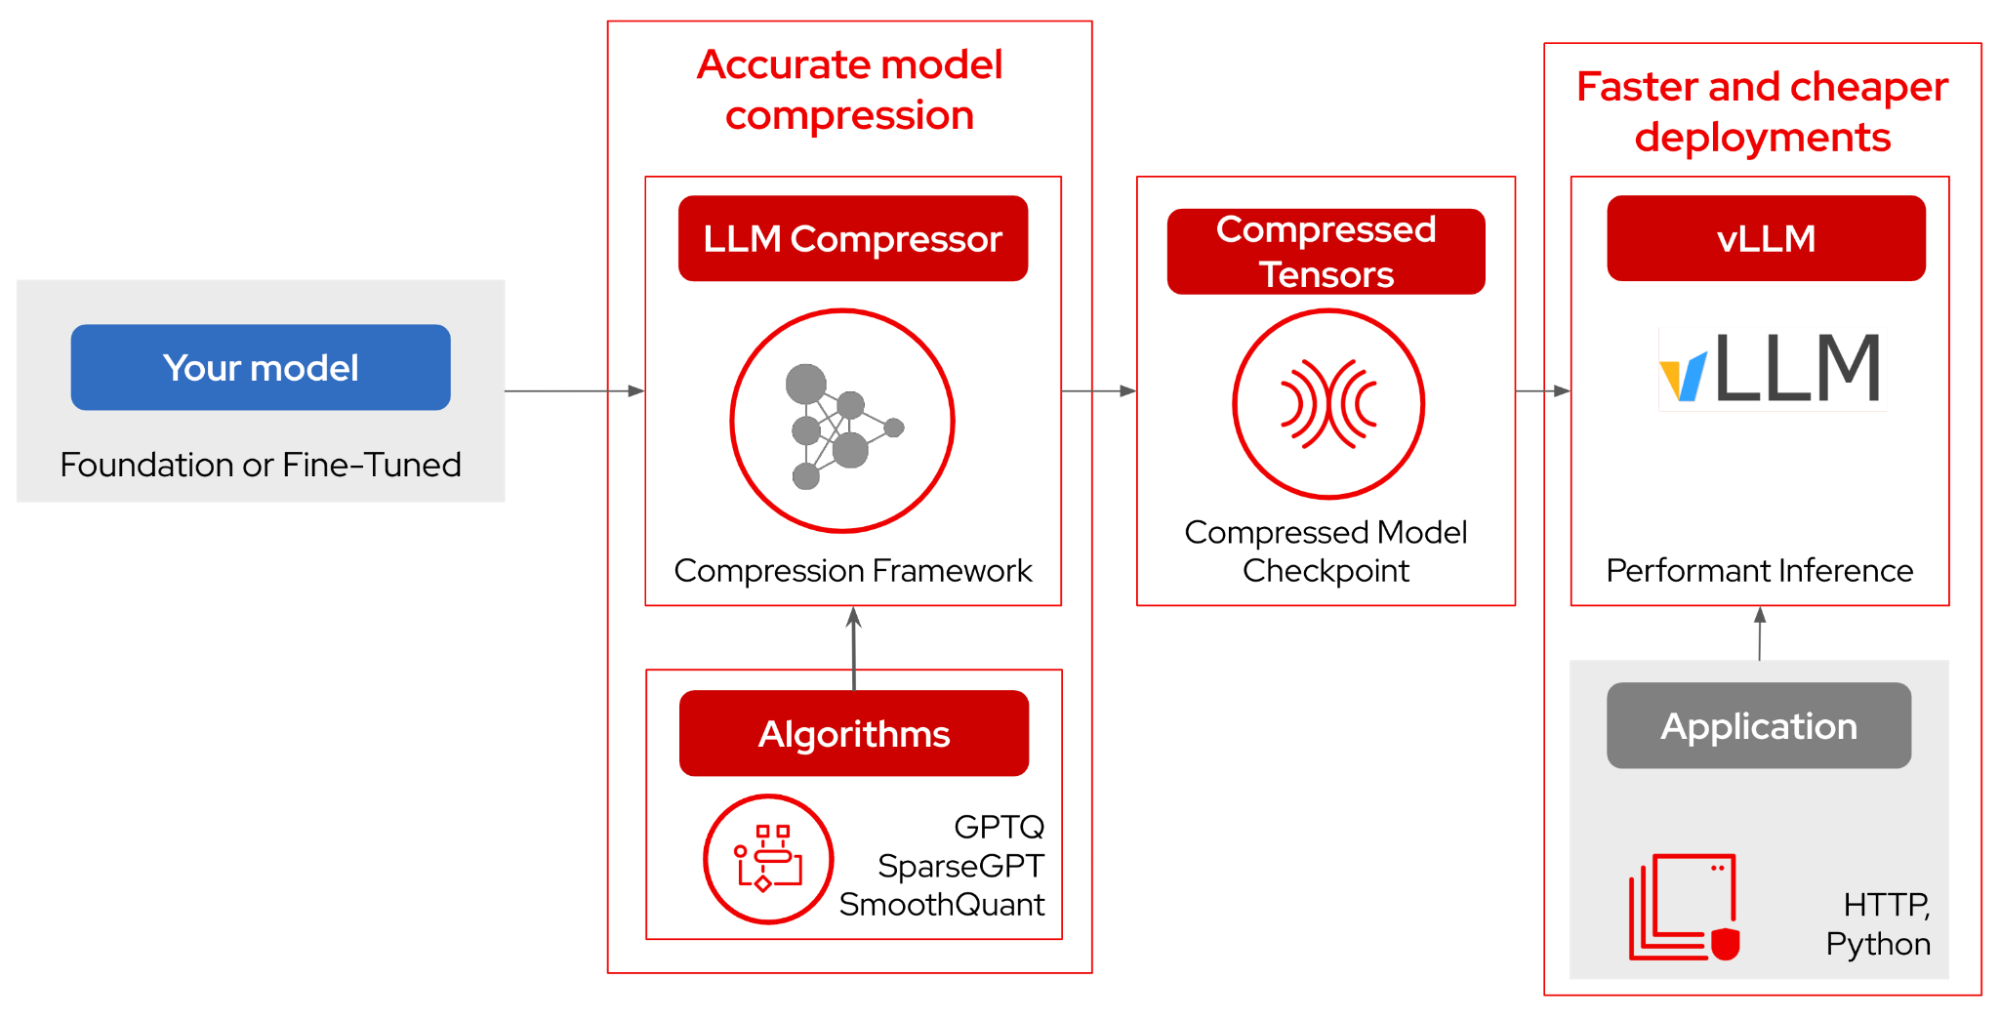
LLM compression and optimization: Cheaper inference with fewer hardware ...
Quantization and LLMs – Condensing models to manageable sizes | AI ...

LLM Training Pipeline Overview | AI Tutorial | Next Electronics
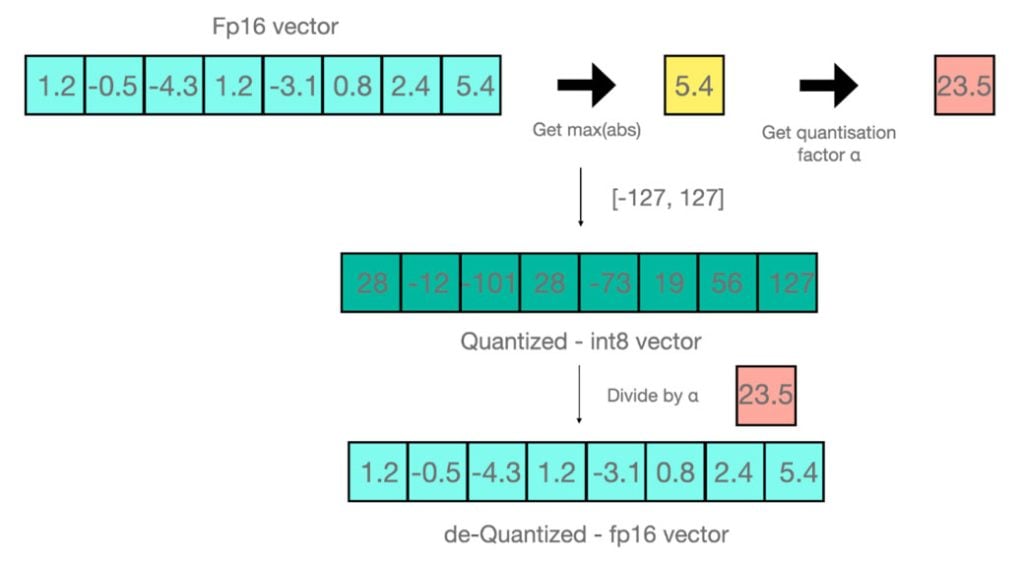
Maximizing Business Potential with Large Language Models (LLMs)
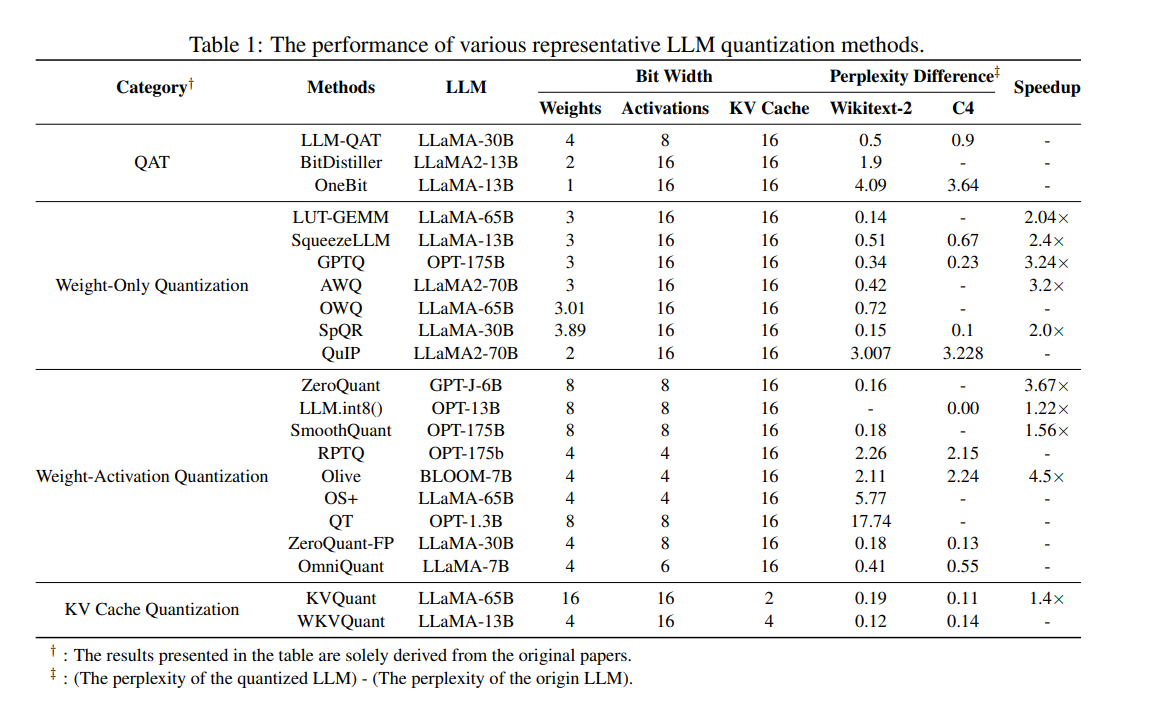
LLM Compression Techniques to Build Faster and Cheaper LLMs

Multimodal Quantization with LLM Compressor! Compression isn't just for ...