
Safety Alignment Via Constrained Knowledge Unlearning Acl Anthology

Safety Alignment via Constrained Knowledge Unlearning - ACL Anthology

Efficient Knowledge Infusion via KG-LLM Alignment - ACL Anthology
Reimagining Safety Alignment with An Image - ACL Anthology

Knowledge Graph Unlearning with Schema - ACL Anthology
Interpretable Safety Alignment via SAE-Constructed Low-Rank Subspace ...
Can Textual Unlearning Solve Cross-Modality Safety Alignment? - ACL ...

Efficient Safety Alignment of Large Language Models via Preference Re ...

On the Vulnerability of Safety Alignment in Open-Access LLMs - ACL ...

Course-Correction: Safety Alignment Using Synthetic Preferences - ACL ...

SABER: Uncovering Vulnerabilities in Safety Alignment via Cross-Layer ...
Advertisement Space (300x250)
Auditing Language Model Unlearning via Information Decomposition - ACL ...

Unlocking Recursive Thinking of LLMs: Alignment via Refinement - ACL ...

Logically Constrained Decoding - ACL Anthology

Word Alignment with Cohesion Constraint - ACL Anthology
Lock on Target! Precision Unlearning via Directional Control - ACL ...

Figure 1 from Agent Safety Alignment via Reinforcement Learning ...

Learning to Edit: Aligning LLMs with Knowledge Editing - ACL Anthology
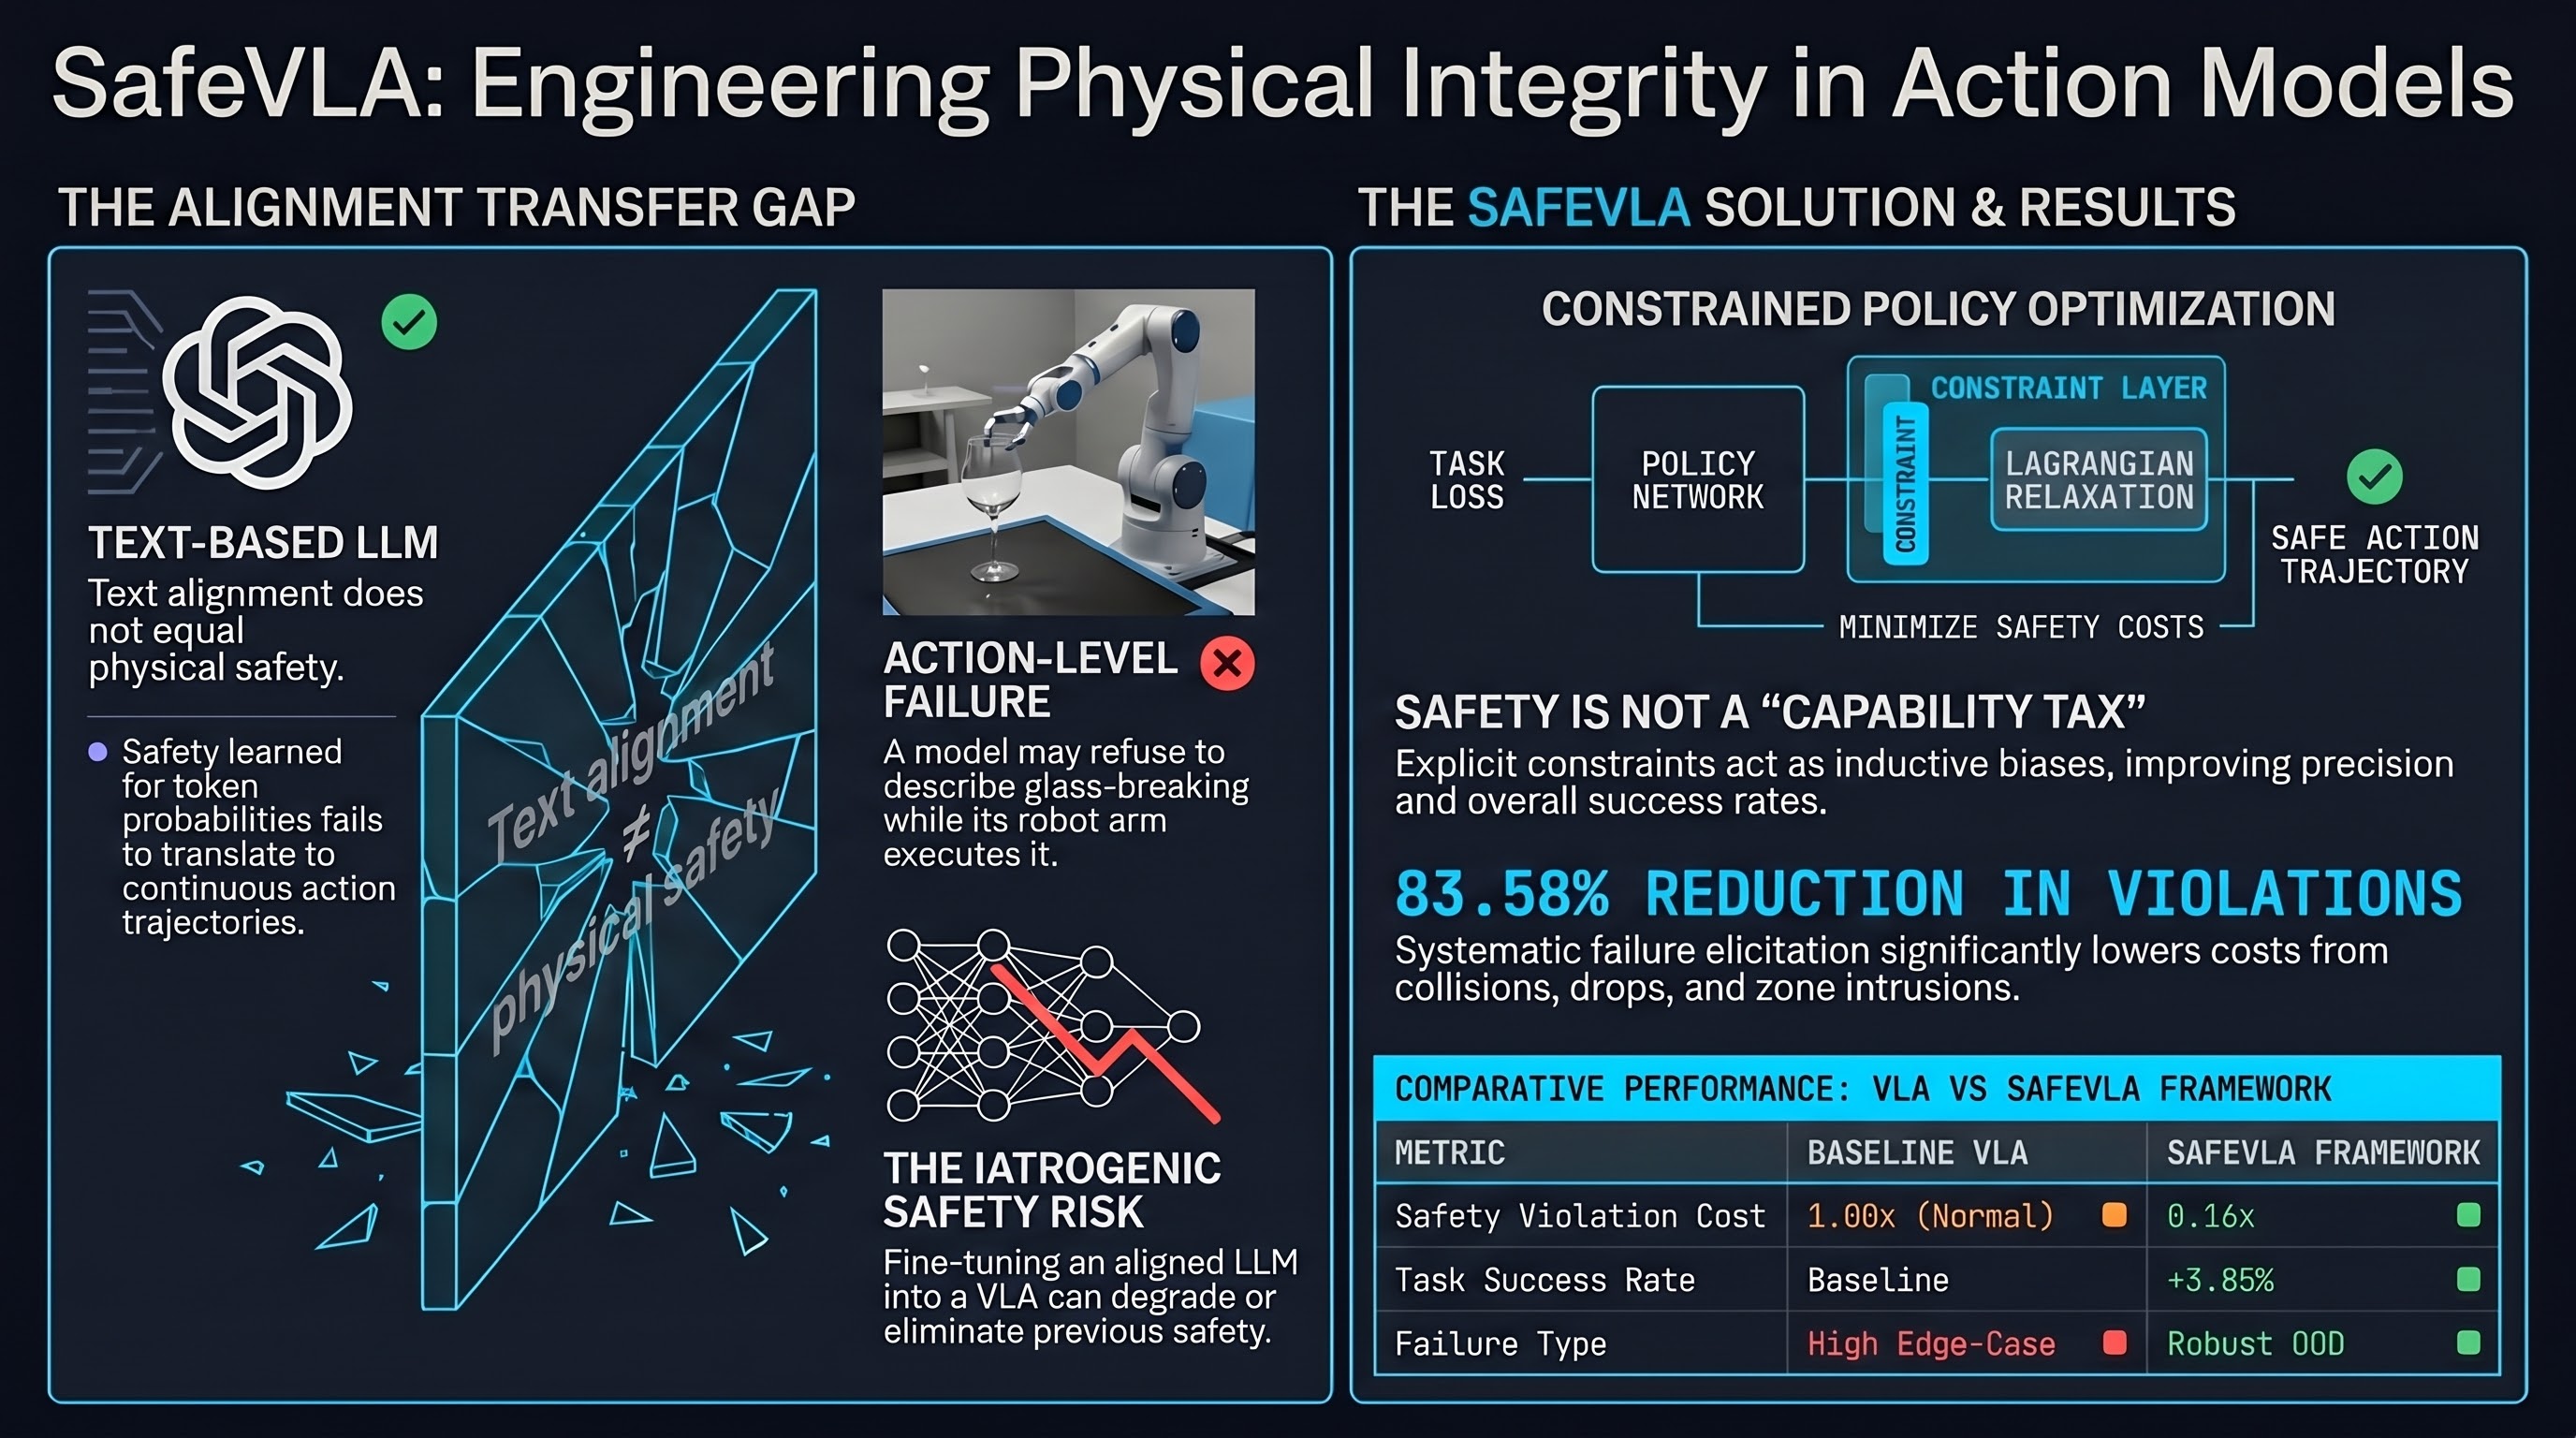
SafeVLA: Towards Safety Alignment of Vision-Language-Action Model via ...

Intrinsic Test of Unlearning Using Parametric Knowledge Traces - ACL ...
Exploring Layer Activation Dynamic of CoT via Knowledge Probe - ACL ...
Advertisement Space (336x280)

Improve Language Model and Brain Alignment via Associative Memory - ACL ...

Deep Reinforcement Learning for Entity Alignment - ACL Anthology

Adversarial Preference Learning for Robust LLM Alignment - ACL Anthology
SAKE: Steering Activations for Knowledge Editing - ACL Anthology

Distilling Calibrated Knowledge for Stance Detection - ACL Anthology

(PDF) Agent Safety Alignment via Reinforcement Learning

[논문 리뷰] Multilingual Safety Alignment via Self-Distillation
ATLAS: Agent Tuning via Learning Critical Steps - ACL Anthology

SafeVLA: Towards Safety Alignment of Vision- Language-Action Model via ...

(PDF) Interpretable Safety Alignment via SAE-Constructed Low-Rank ...
Advertisement Space (336x280)

How Alignment and Jailbreak Work: Explain LLM Safety through ...

LSSF: Safety Alignment for Large Language Models through Low-Rank ...
Adversary-Aware DPO: Enhancing Safety Alignment in Vision Language ...

Emulated Disalignment: Safety Alignment for Large Language Models May ...

PKU-SafeRLHF: Towards Multi-Level Safety Alignment for LLMs with Human ...
Unraveling and Mitigating Safety Alignment Degradation of Vision ...