
Self Play Preference Optimization For Language Model Alignment Ai
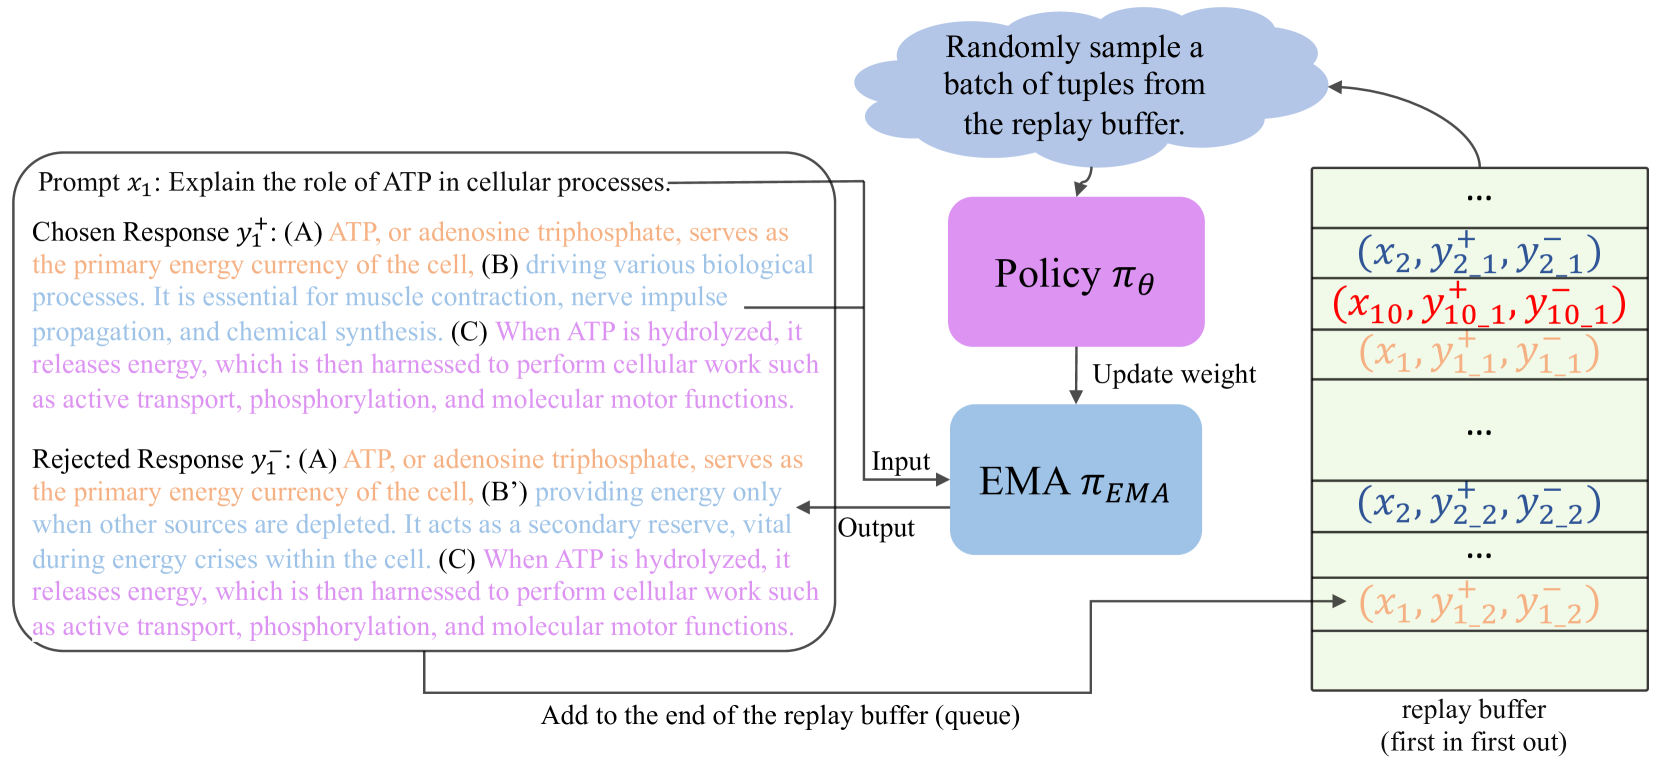
Self-Play Preference Optimization for Language Model Alignment | AI ...
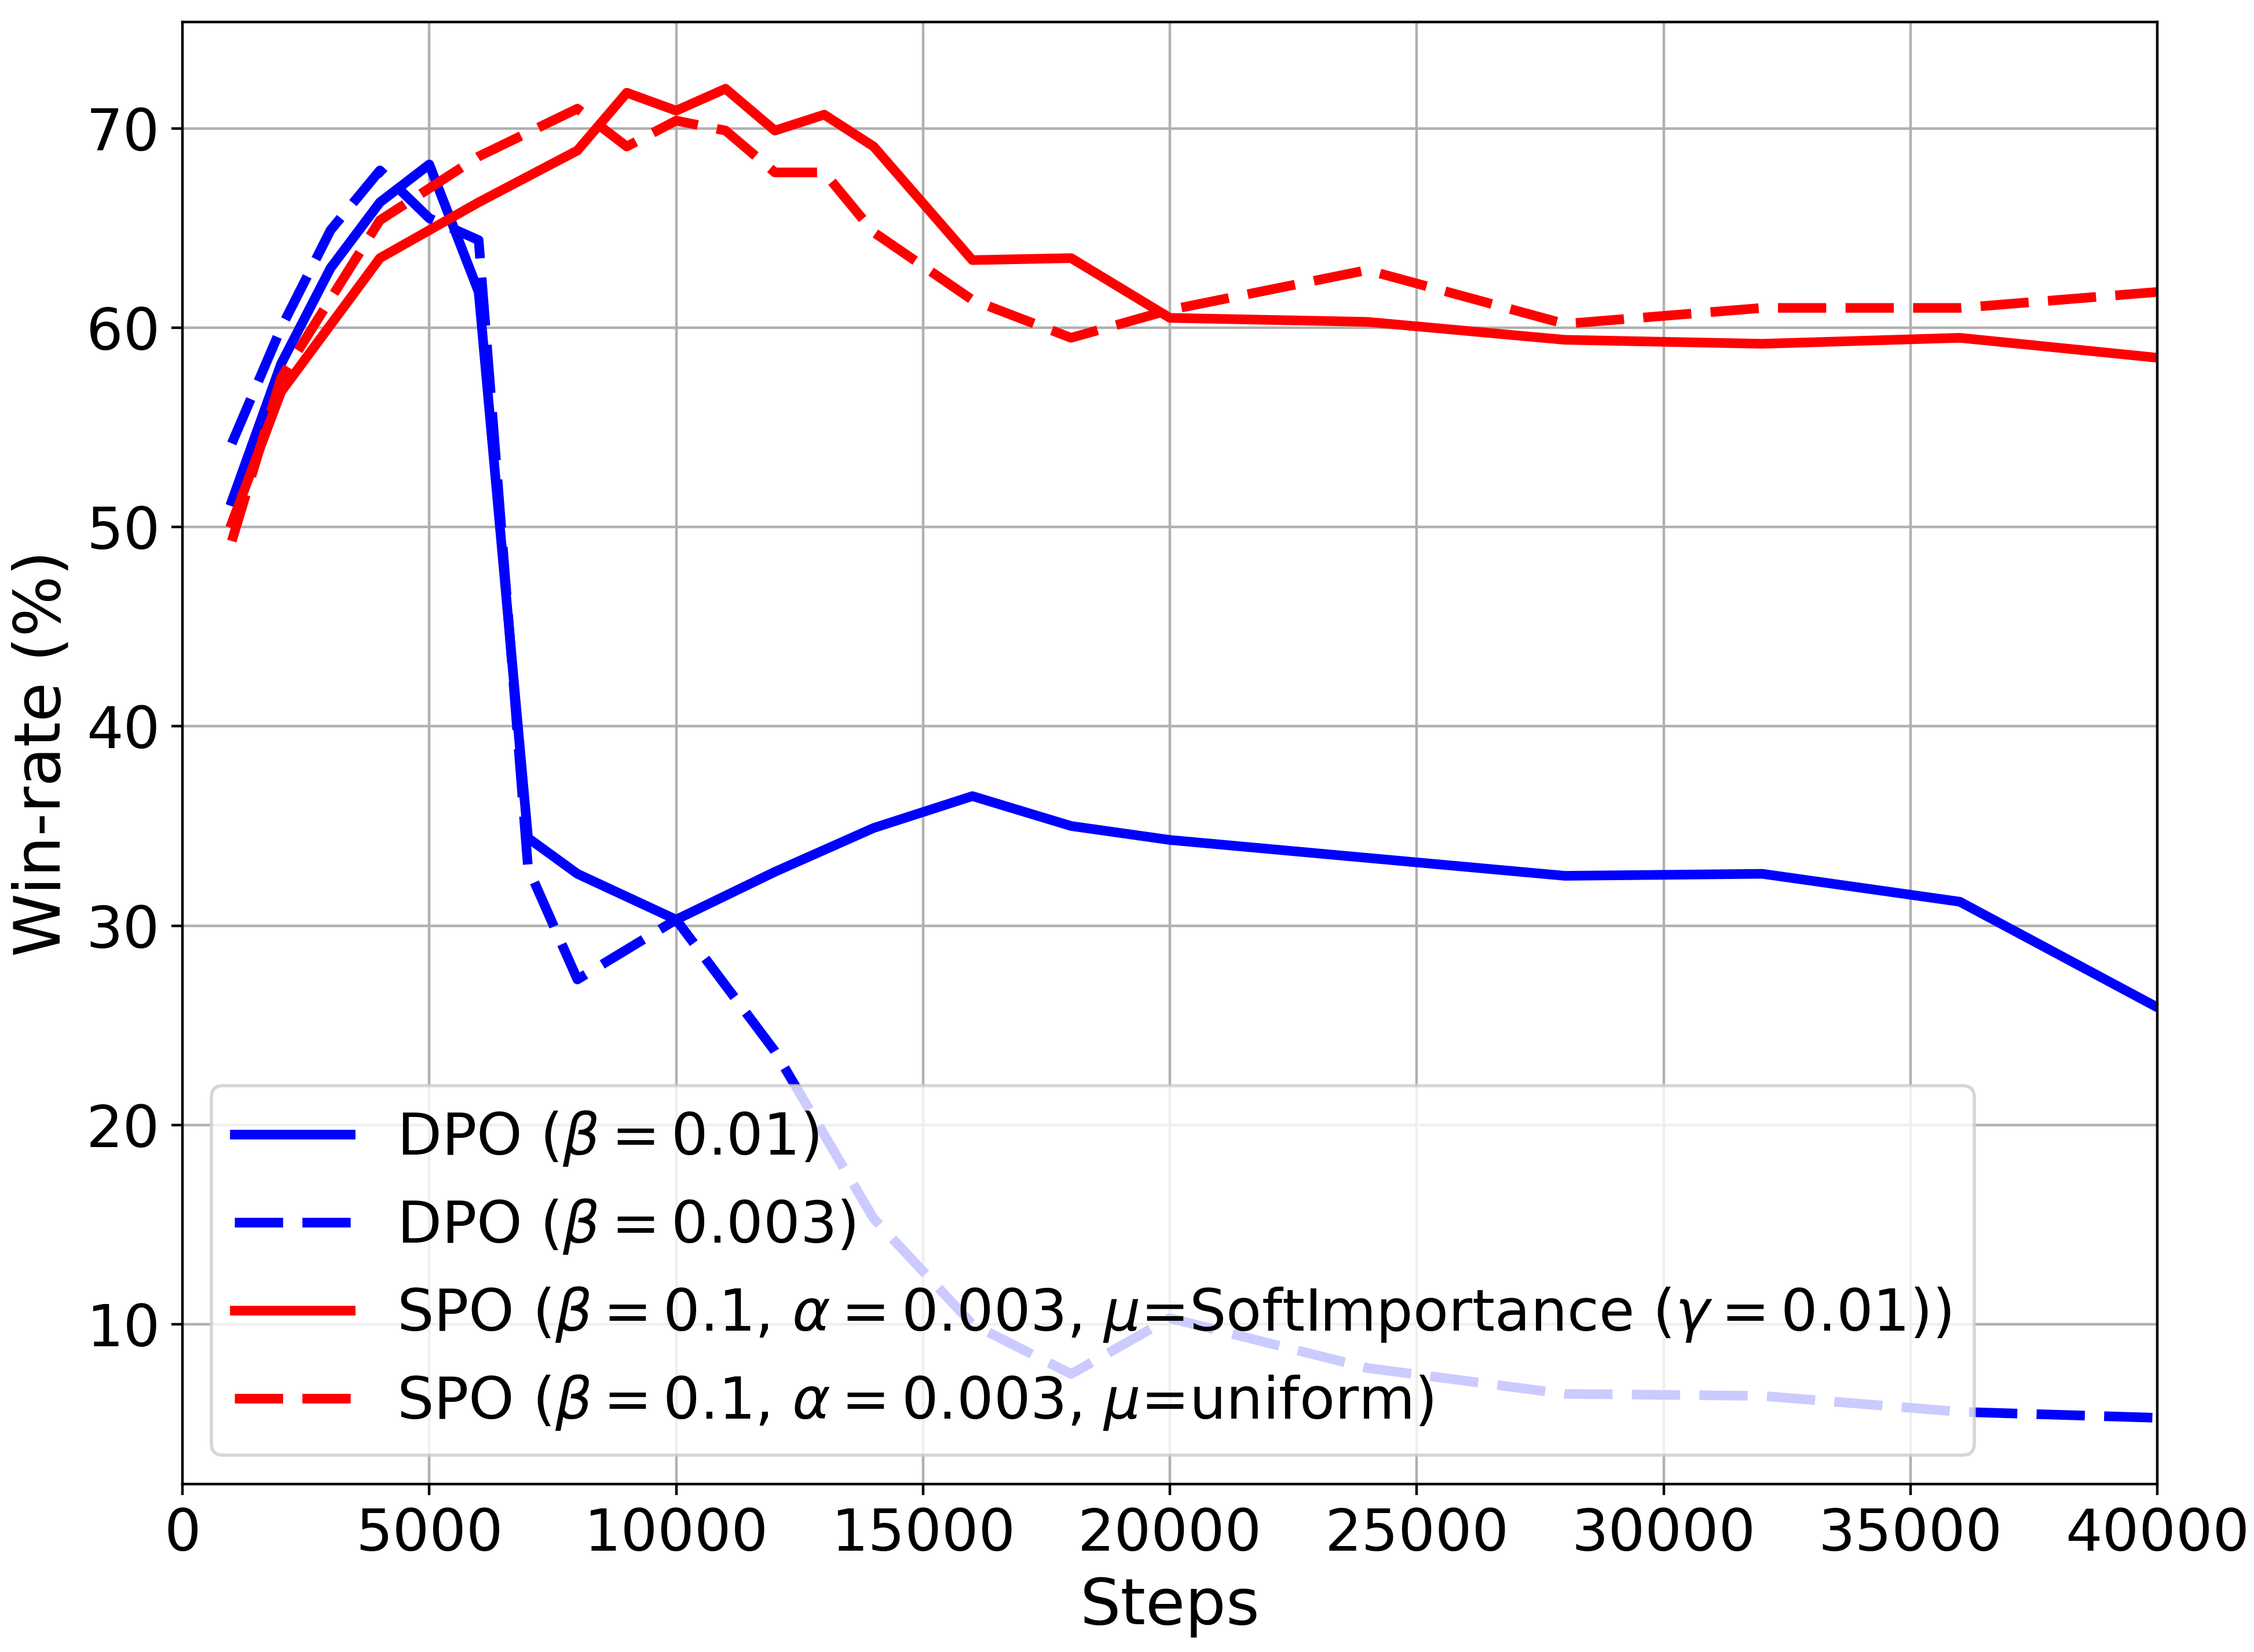
Self-Play Preference Optimization for Language Model Alignment | AI ...
Self-Play Preference Optimization for Language Model Alignment | AI ...
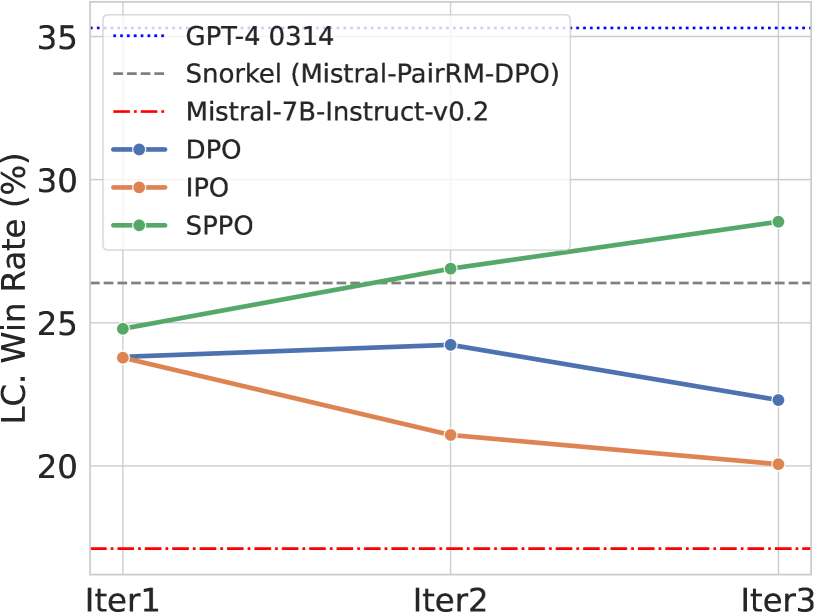
Self-Play Preference Optimization for Language Model Alignment | AI ...

Self-Play Preference Optimization For Language Model Alignment | PDF ...
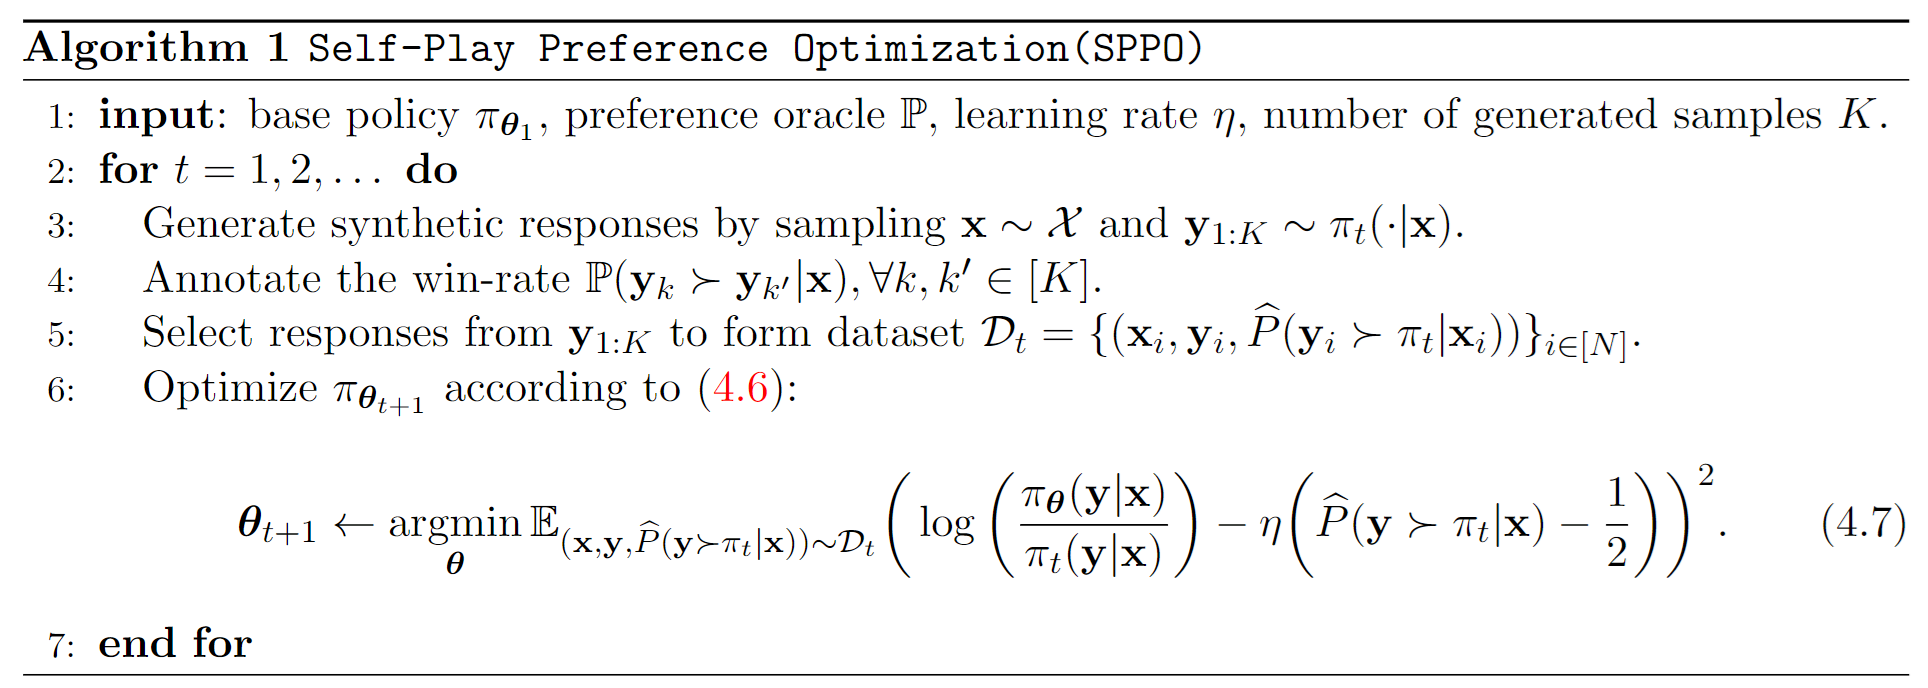
Self-Play Preference Optimization for Language Model Alignment

Self-Play Preference Optimization for Language Model Alignment - 智源社区论文

Self-Play Preference Optimization for Language Model Alignment

[QA] Self-Play Preference Optimization for Language Model Alignment ...

【大模型论文阅读】Self-Play Preference Optimization for Language Model Alignment ...
Advertisement Space (300x250)

Accelerated Preference Optimization for Large Language Model Alignment ...

Self-Play Preference Optimization for Language Model Alignment
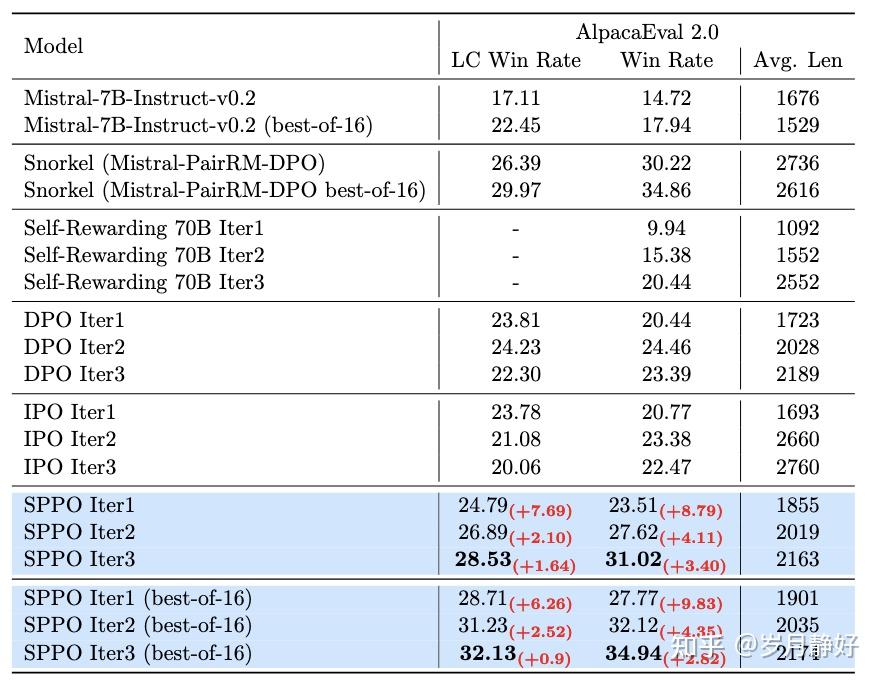
【RLHF系列】Self-Play Preference Optimization for Language Model Alignment - 知乎

【大模型论文阅读】Self-Play Preference Optimization for Language Model Alignment ...

Accelerated Preference Optimization for Large Language Model Alignment
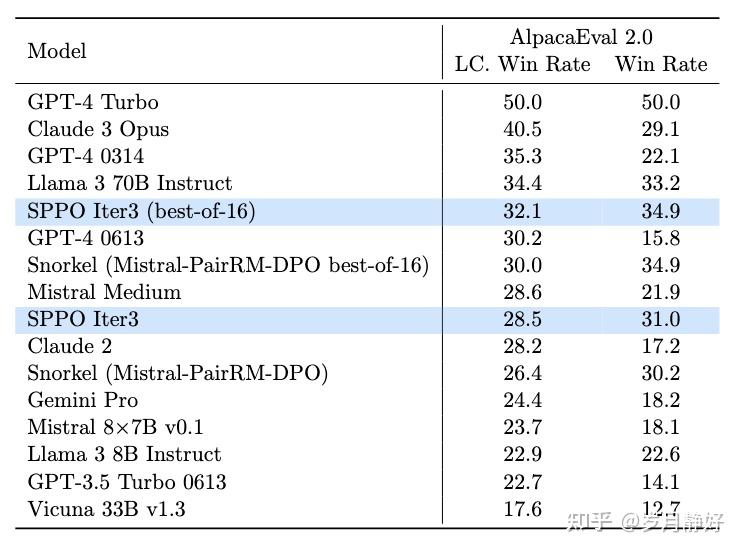
【RLHF系列】Self-Play Preference Optimization for Language Model Alignment - 知乎
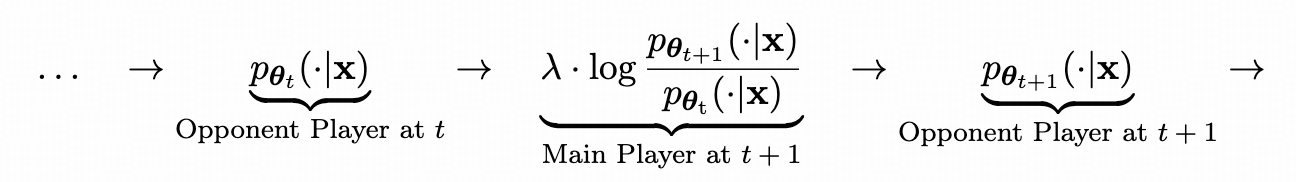
【大模型论文阅读】Self-Play Preference Optimization for Language Model Alignment ...

【大模型论文阅读】Self-Play Preference Optimization for Language Model Alignment ...

[2024 Best AI Paper] Self-Play Preference Optimization for Language ...

Direct Preference Optimization (DPO) in Language Model Alignment
Advertisement Space (336x280)

Self-Play v2 or Self-Play Preference Optimization for Language Model ...
SGDPO: Self-Guided Direct Preference Optimization for Language Model ...

Direct Preference Optimization (DPO) in Language Model alignment | UnfoldAI

Stackelberg Game Preference Optimization for Data-Efficient Alignment ...

Distortion of AI Alignment: Does Preference Optimization Optimize for ...

Divergence Minimization Preference Optimization for Diffusion Model ...

AMaPO: Adaptive Margin-attached Preference Optimization for Language ...
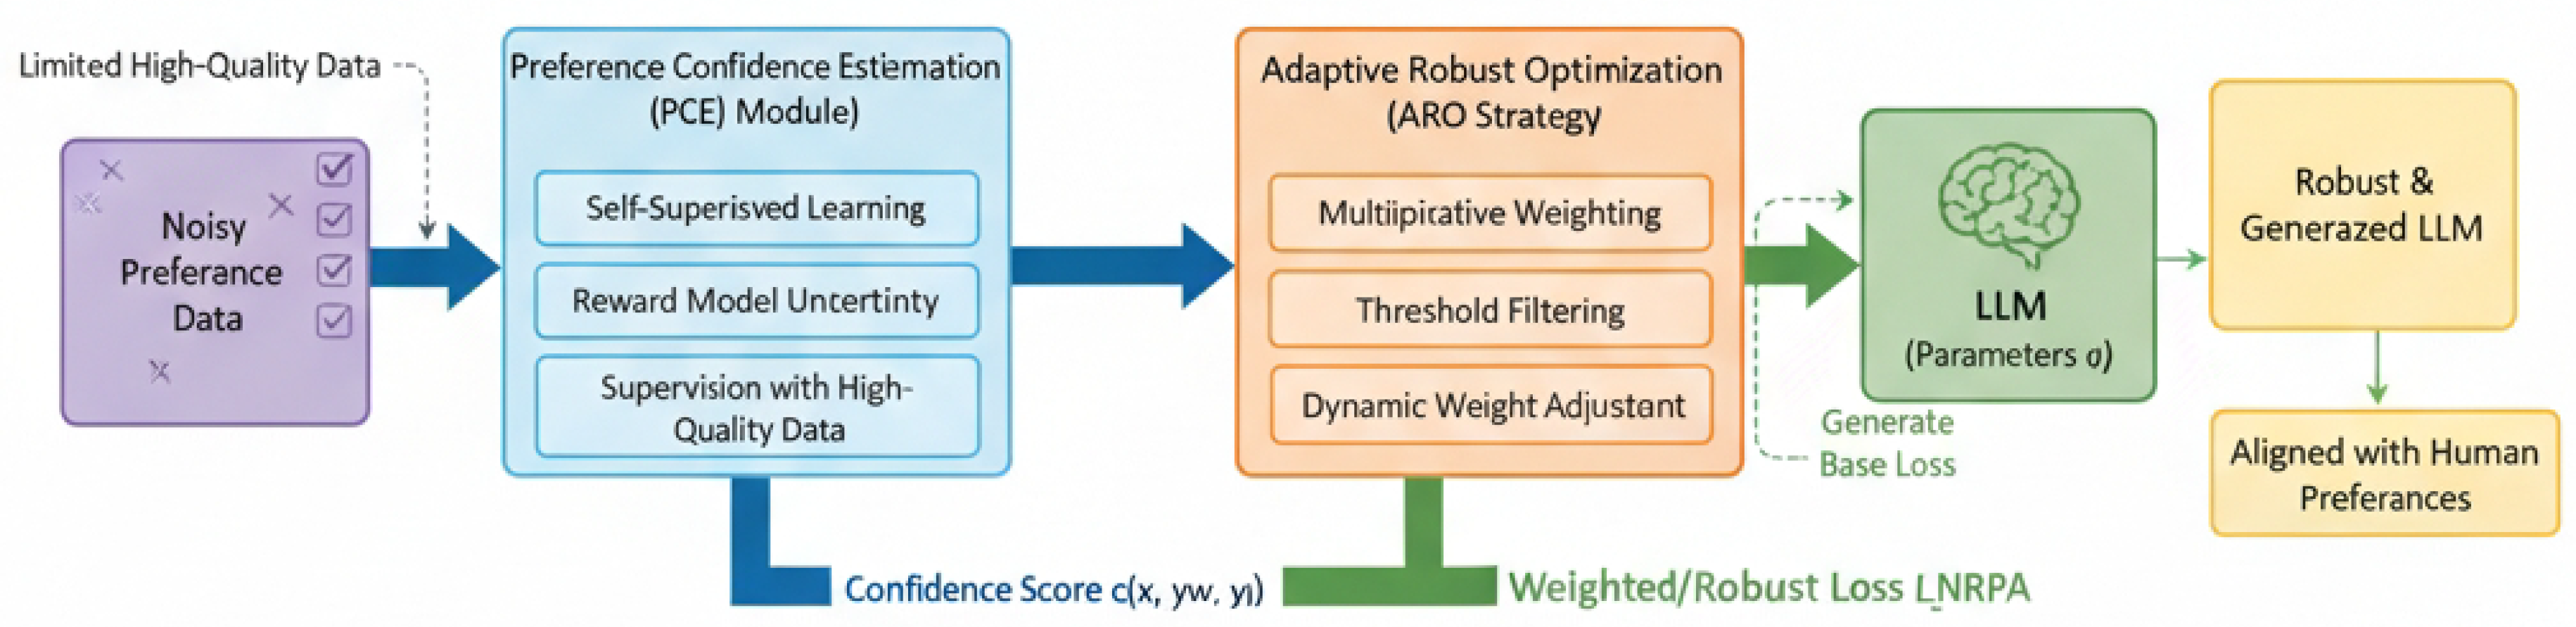
Noise-Robust Preference Alignment for Large Language Models via ...
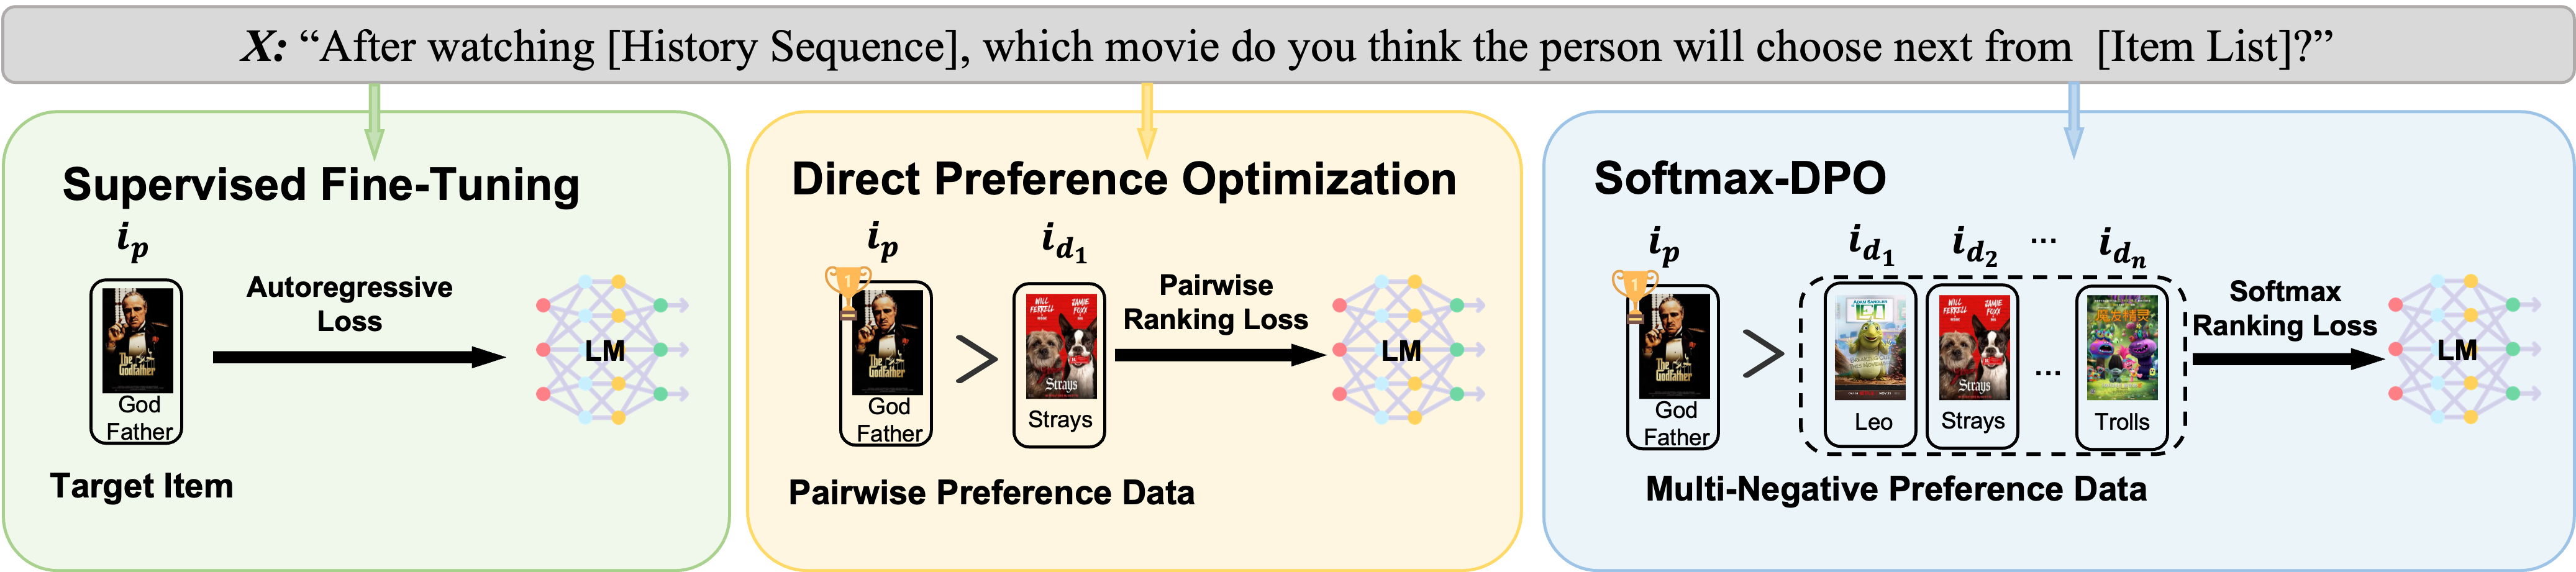
Finetuning Large Language Model for Personalized Ranking | AI Research ...

Towards Understanding Valuable Preference Data for Large Language Model ...
Advertisement Space (336x280)

Google Publishes Technique for AI Language Model Self-Improvement - InfoQ

Direct Preference Optimization (DPO): Your Language Model is Secretly a ...

Direct Language Model Alignment from Online AI Feedback

ICML Poster AMPO: Active Multi Preference Optimization for Self-play ...

[论文评述] LifeAlign: Lifelong Alignment for Large Language Models with ...

[Literature Review] Annotation-Efficient Preference Optimization for ...