
Sessionfunctions Llm Compressor Docs

session_functions - LLM Compressor Docs

session - LLM Compressor Docs

LLM Compressor Docs
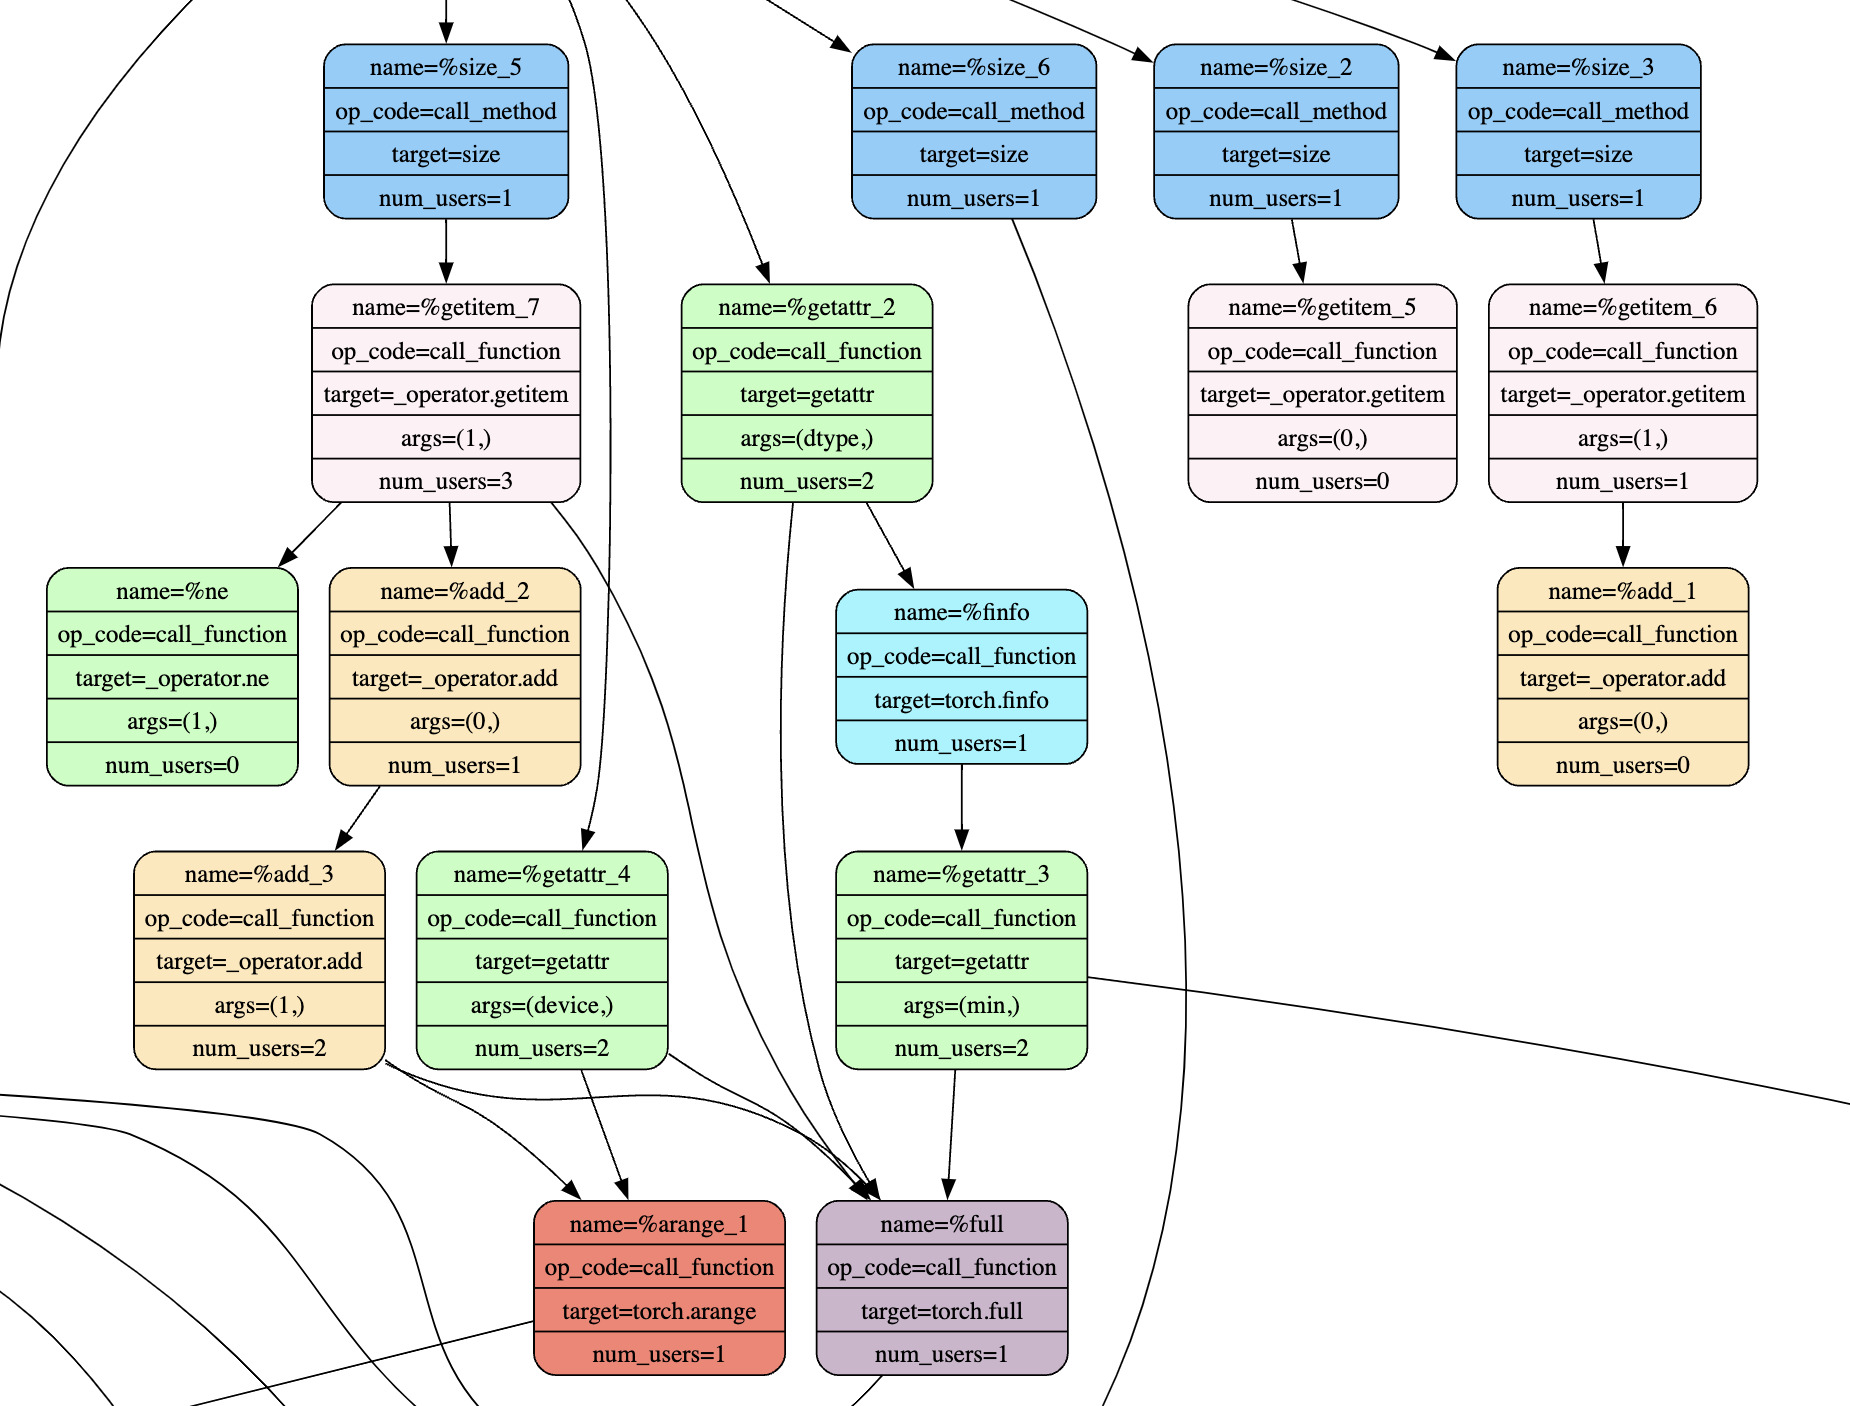
Sequential Onloading - LLM Compressor Docs

fp8 Weight, Activation, and KV Cache Quantization - LLM Compressor Docs
Choosing your model - LLM Compressor Docs

LLM Compressor 0.7.0 release recap | Red Hat Developer

分散式 oneshot - LLM Compressor 文件 - vLLM 文件

LLM Compressor testing - a nm-testing Collection
LLM Compressor 0.9.0: Attention quantization, MXFP4 support, and more ...
Advertisement Space (300x250)
Latest LLM Compressor version slowdown · Issue #1610 · vllm-project/llm ...
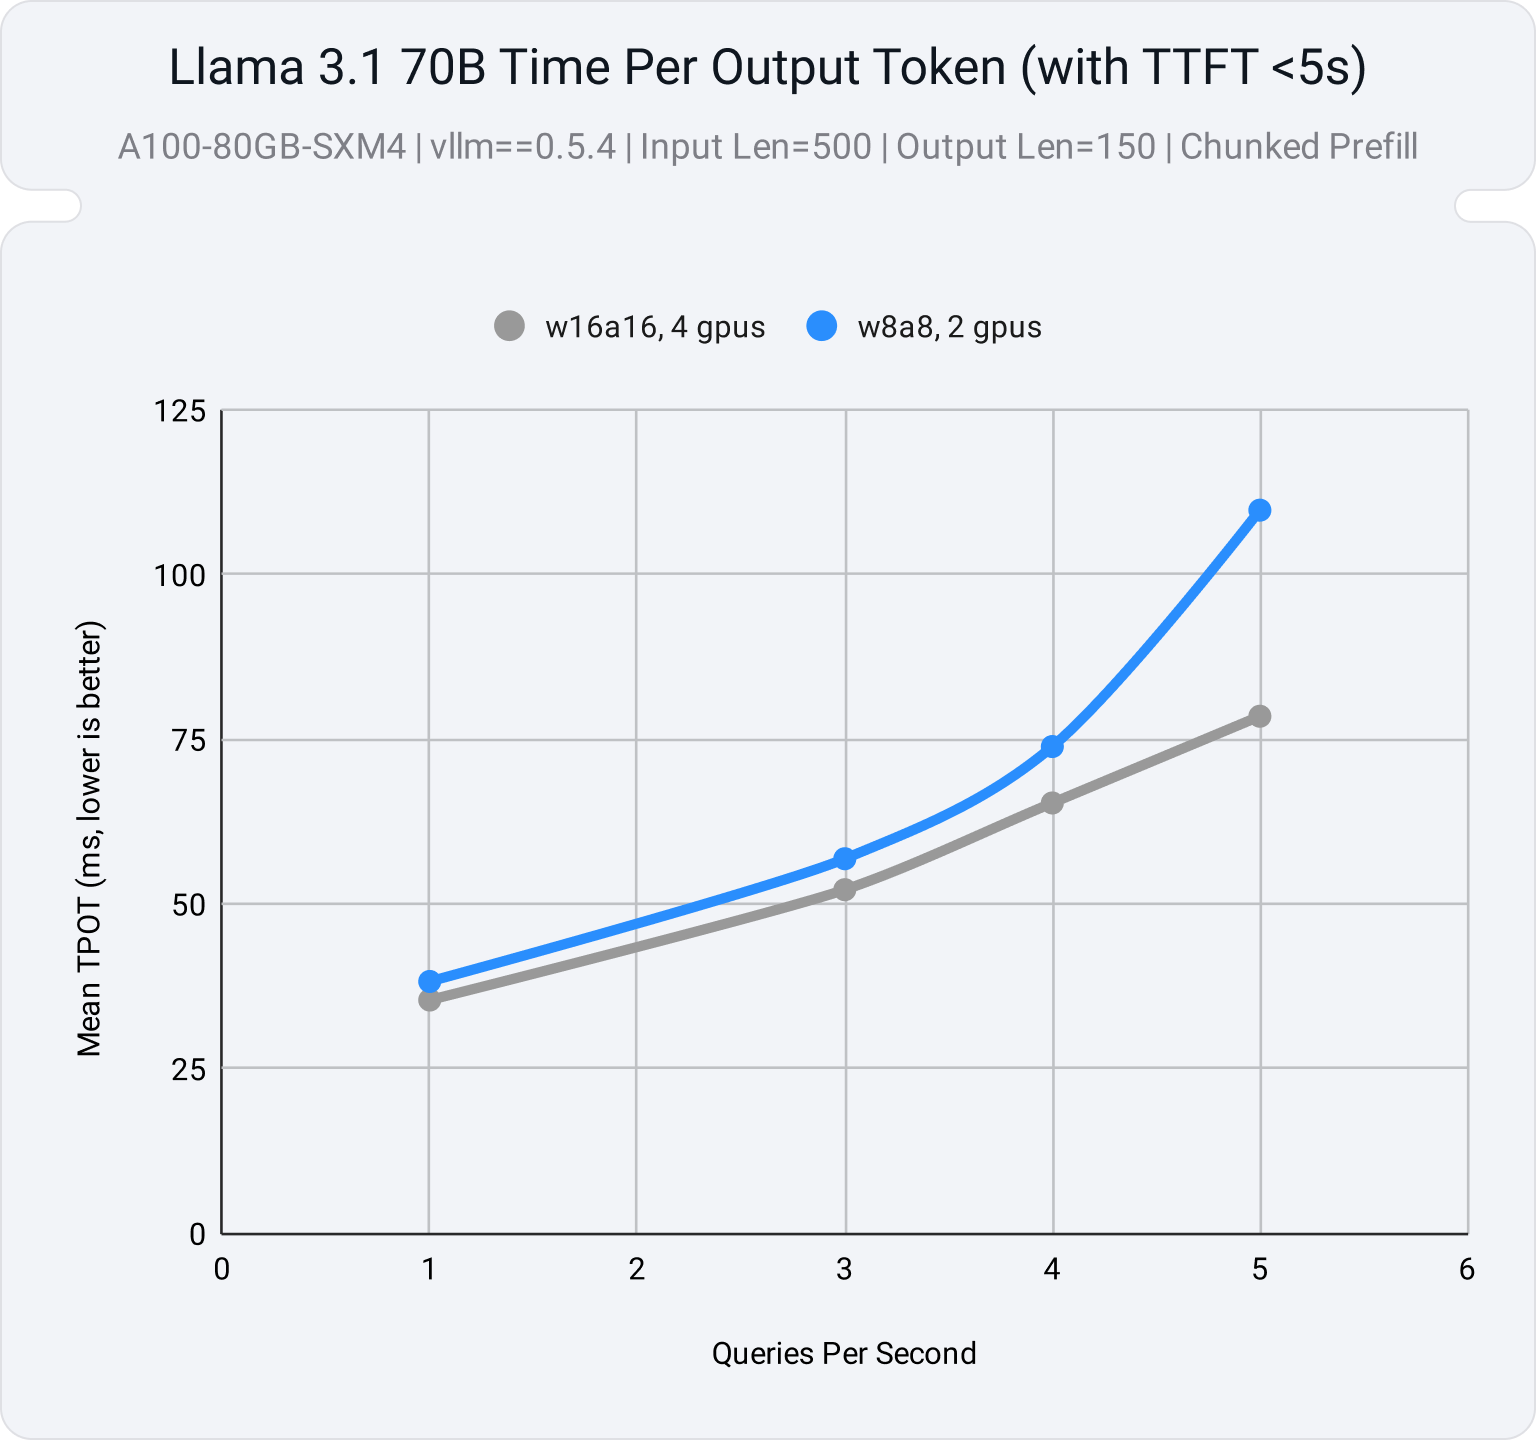
LLM Compressor is here: Faster inference with vLLM | Red Hat Developer
LLM Compressor 0.7.0 release recap | Red Hat Developer

Neural Magic Introduces the LLM Compressor Library | ml-news – Weights ...

I Built a Prompt Compressor That Saves 65% on LLM Costs — Here's the ...
Smarter compression: Tailoring AI with LLM Compressor in OpenShift AI ...

How I Built a Prompt Compressor That Reduces LLM Token Costs Without ...
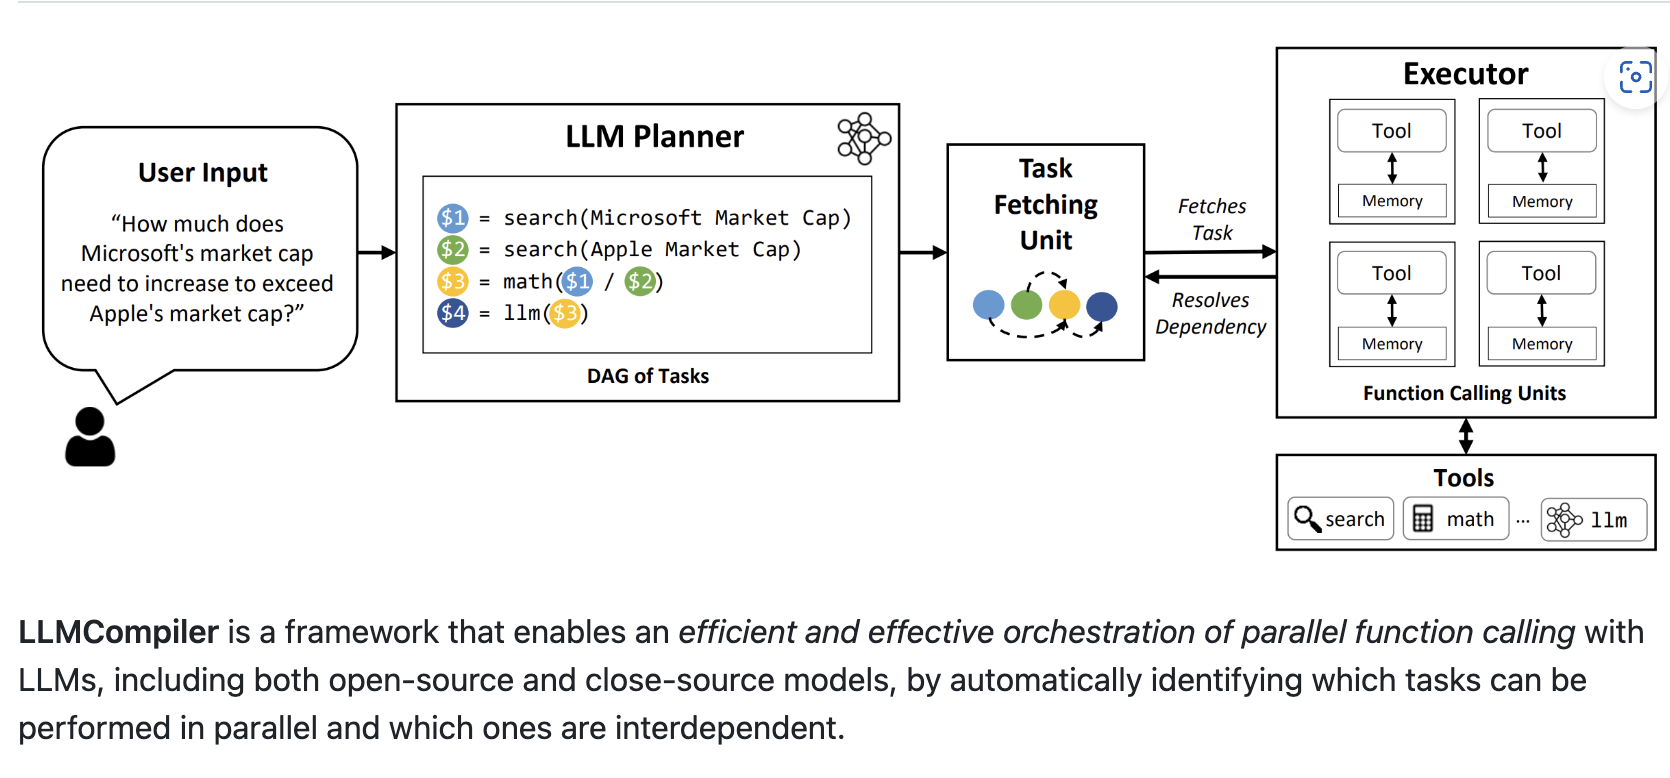
Exploring The Dynamics Of Llm Based Agent Frameworks – Monir ...

LLM Compressor: Optimize LLMs for low-latency deployments | Red Hat ...
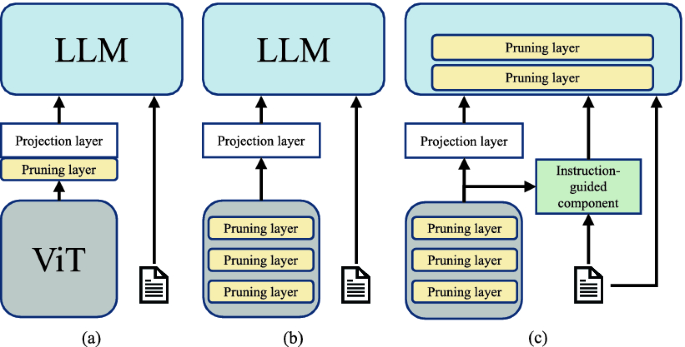
4 LLM Compression Techniques That You Can't Miss
Advertisement Space (336x280)
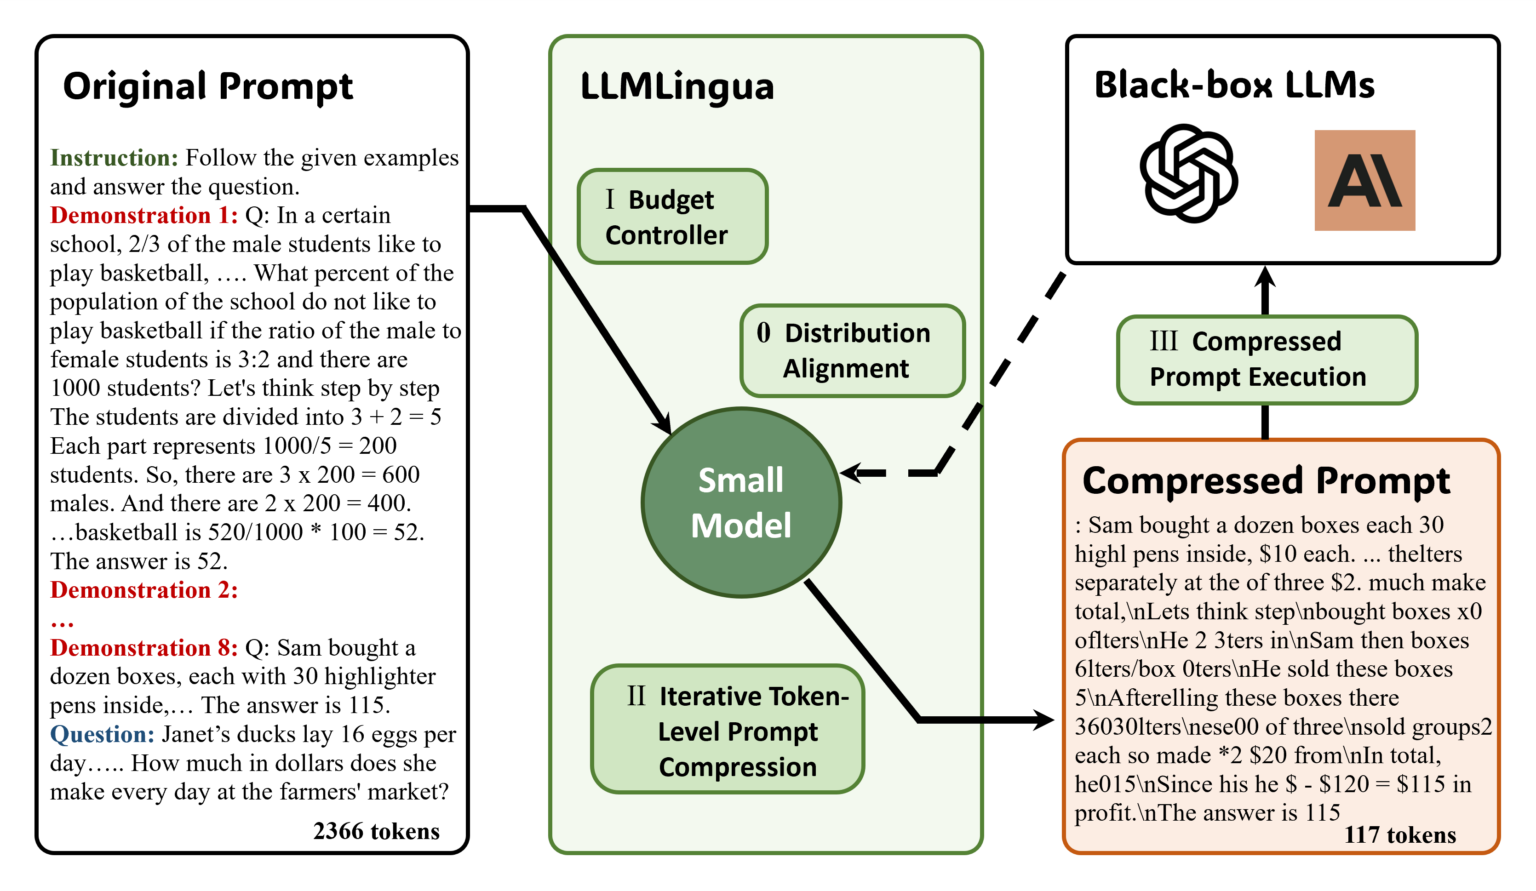
LLMLingua: Innovating LLM efficiency with prompt compression ...

LLM Compressor: Optimize LLMs for low-latency deployments | Red Hat ...
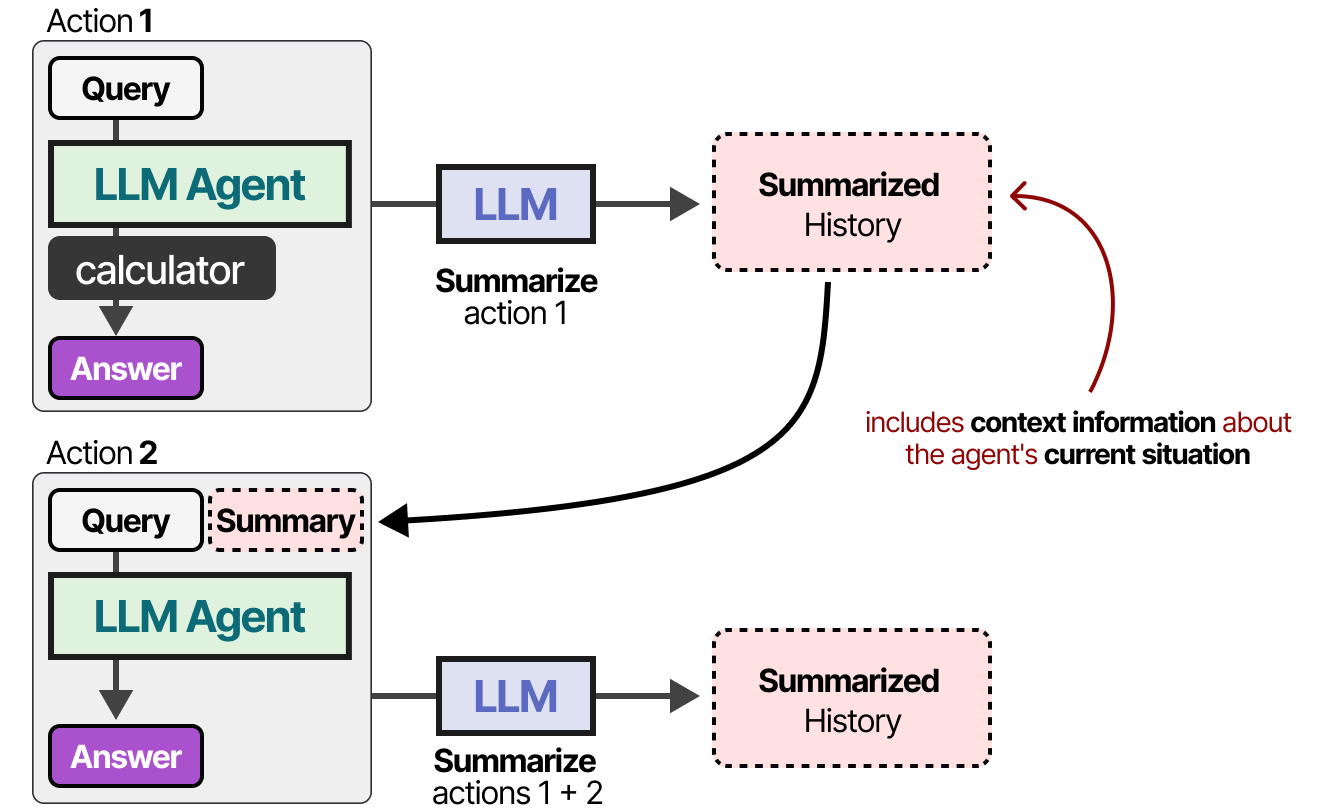
A Visual Guide to LLM Agents
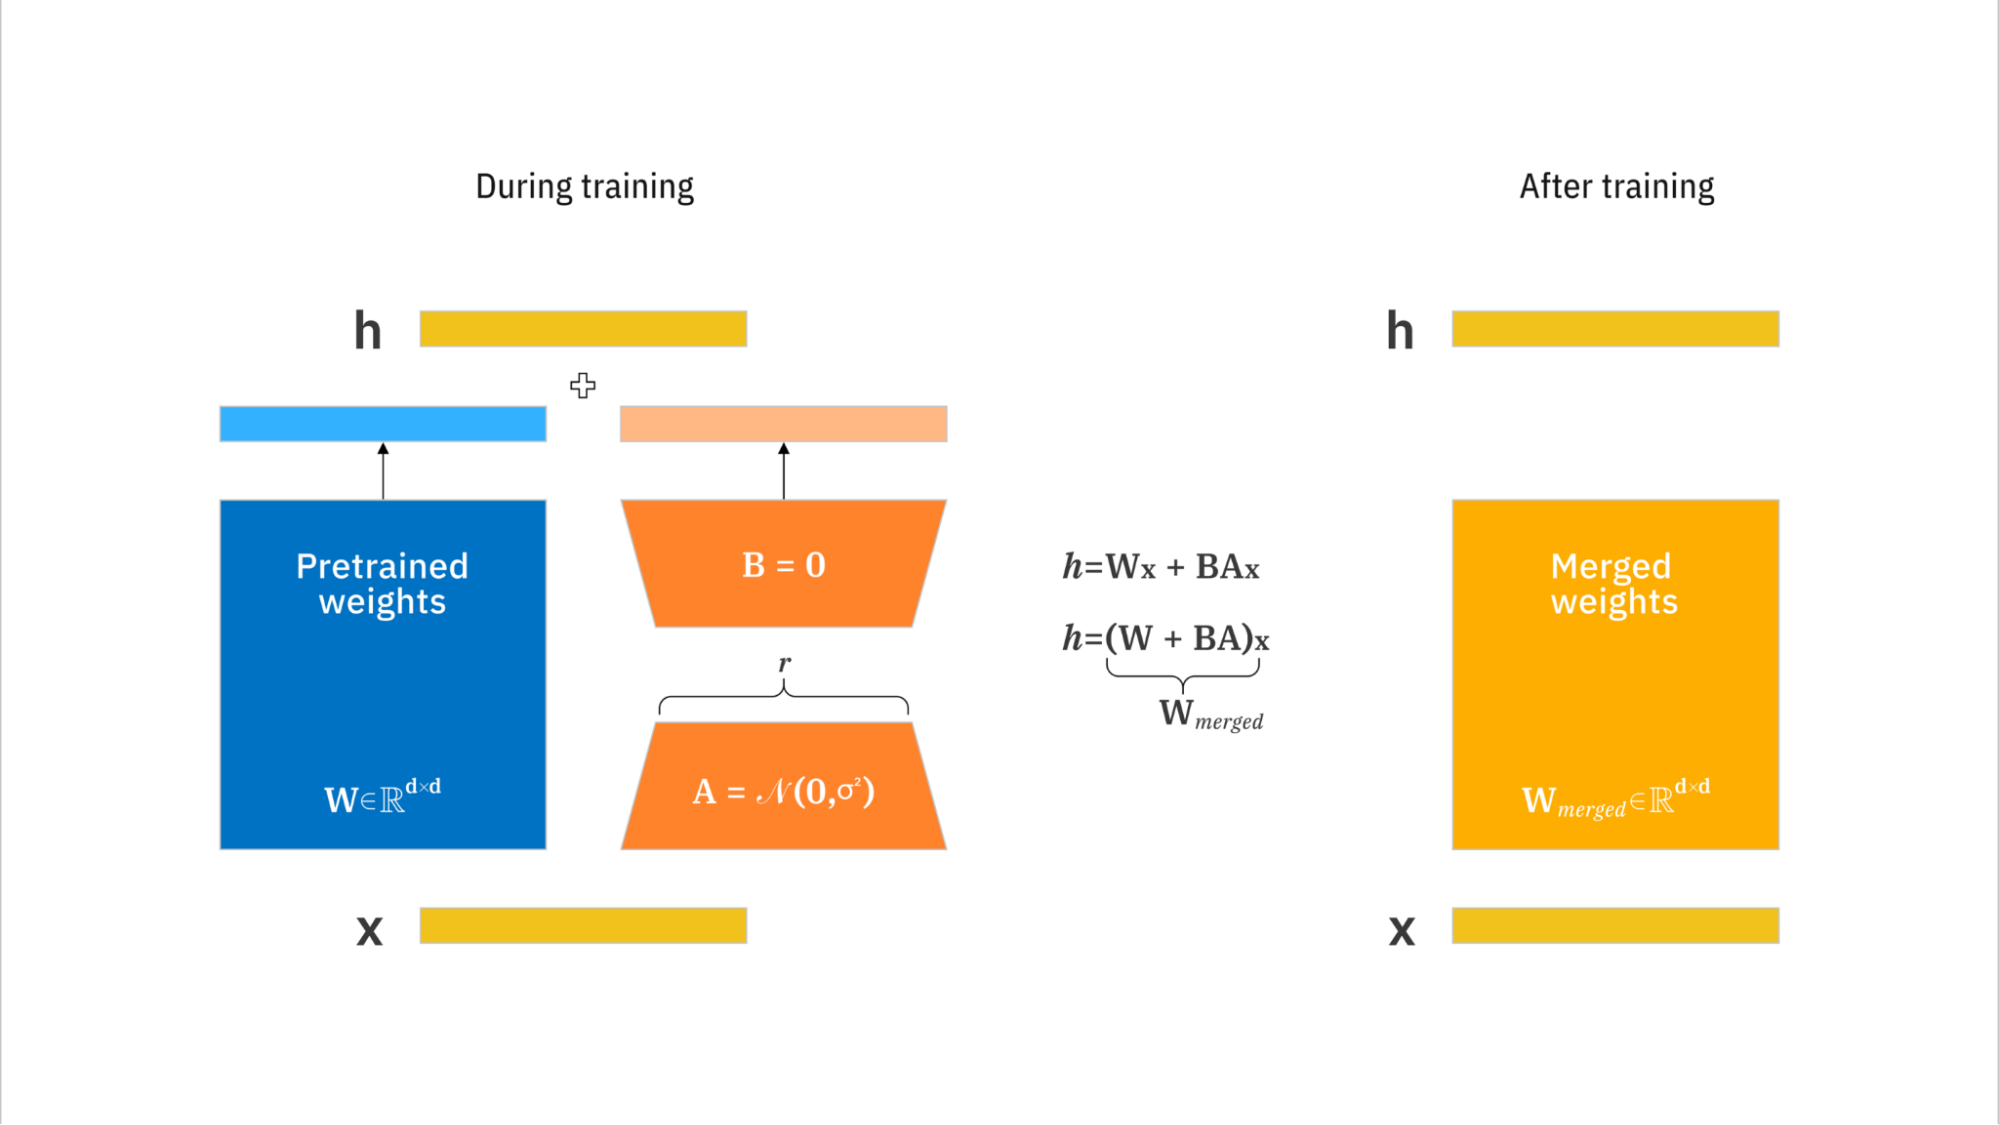
4 LLM Compression Techniques That You Can't Miss
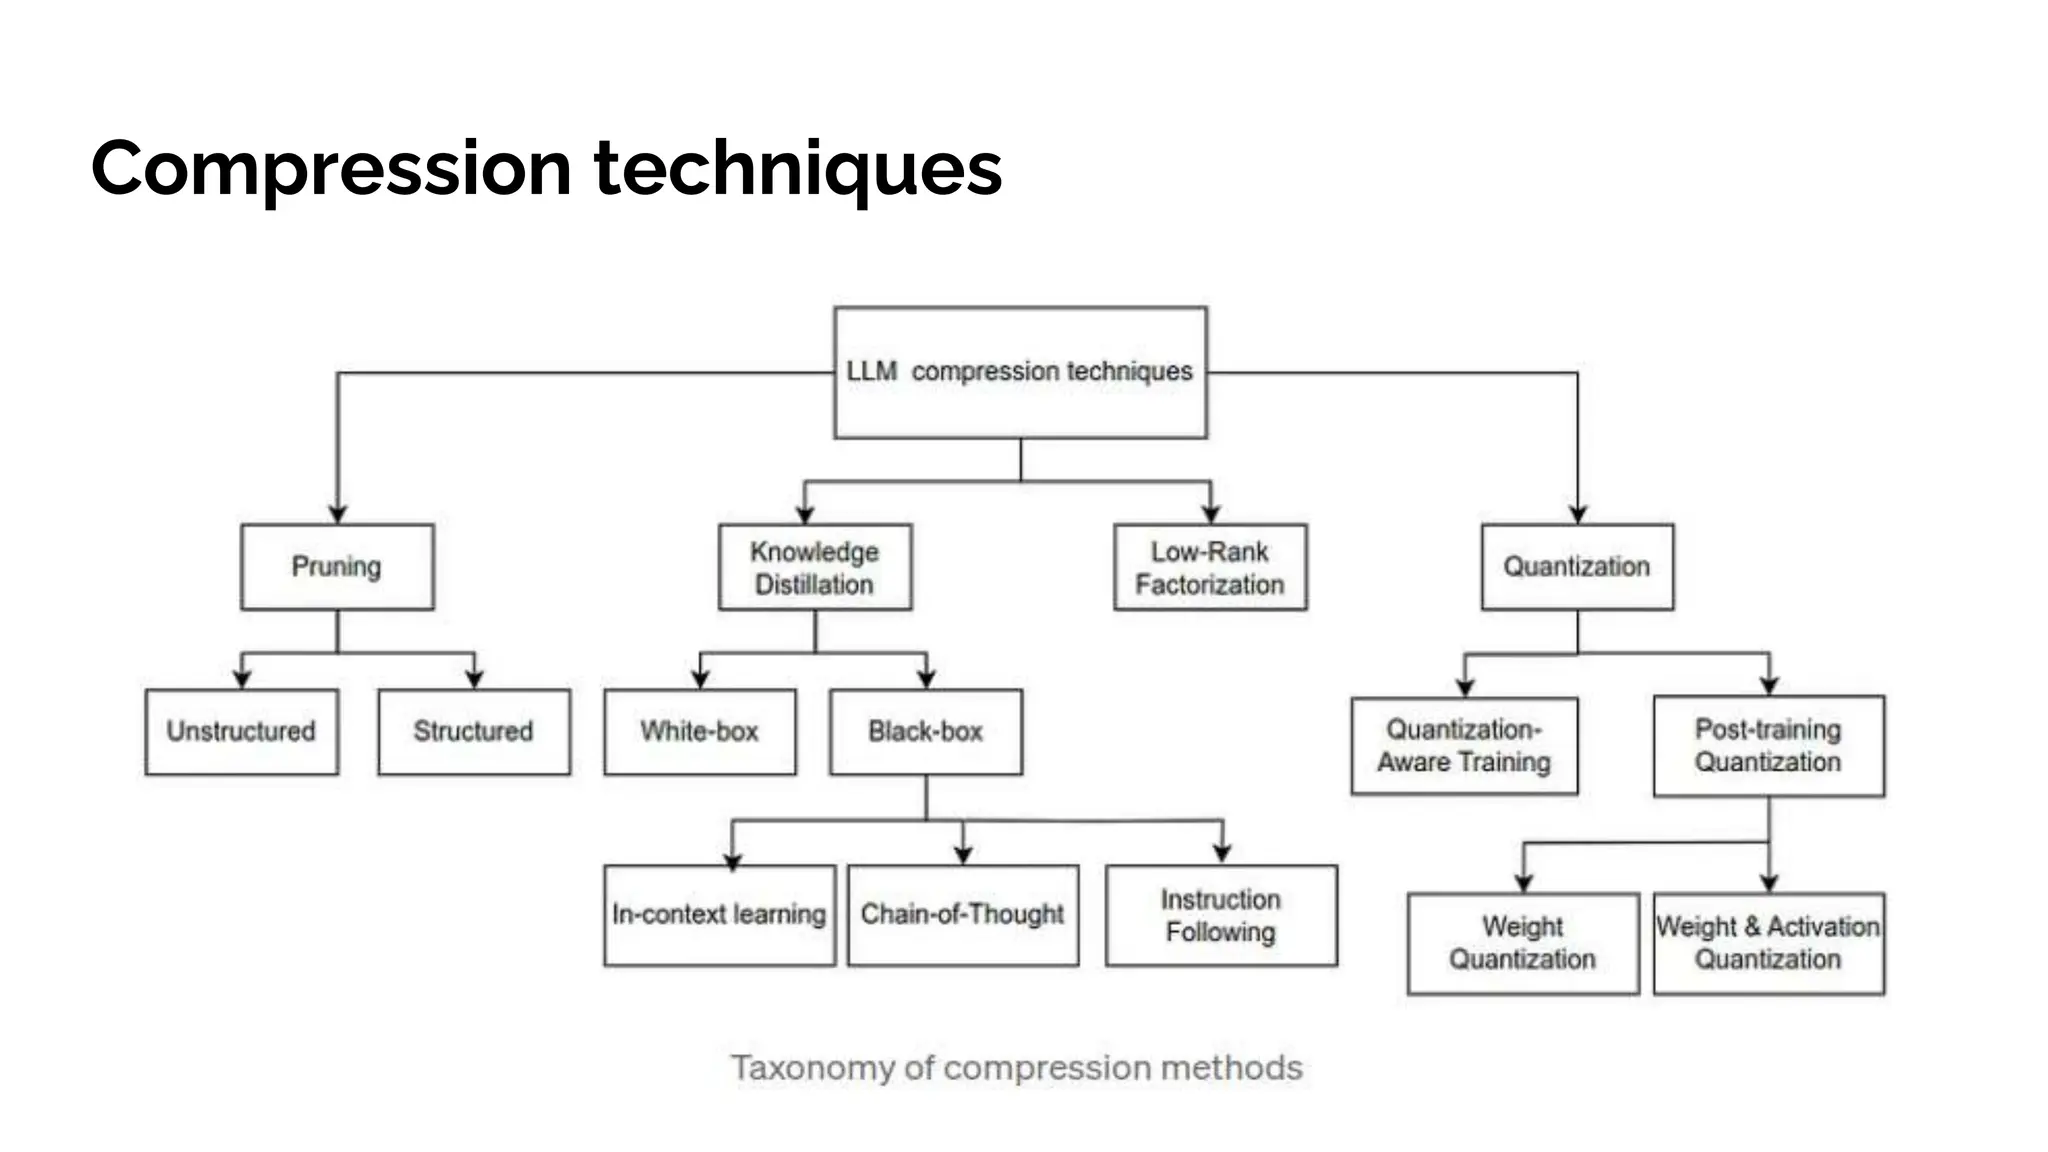
Paper presentation on LLM compression | PPTX
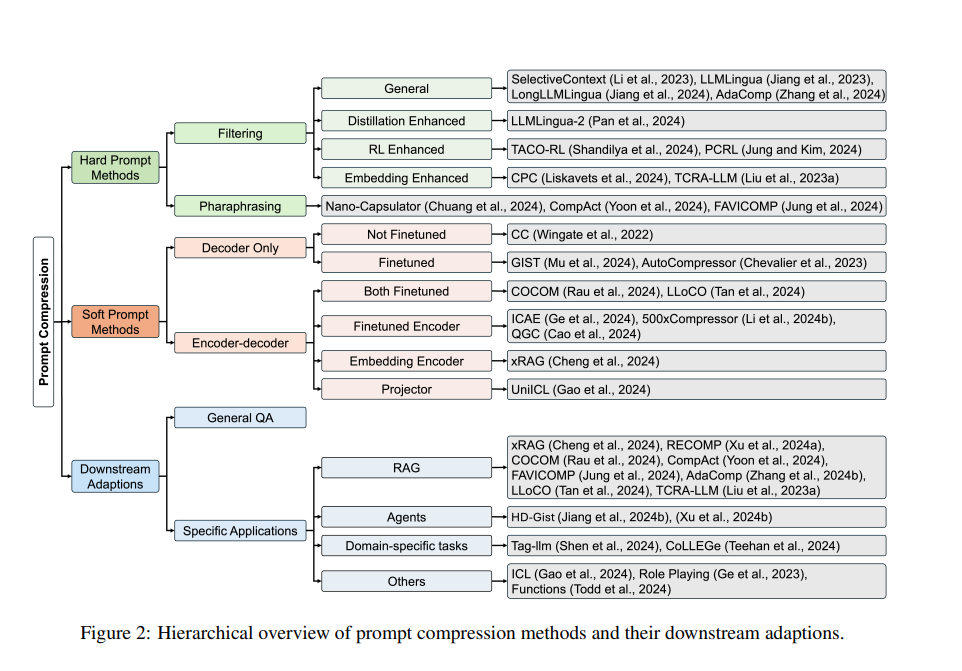
LLM Compression Techniques to Build Faster and Cheaper LLMs

[논문 리뷰] Lossless Compression for LLM Tensor Incremental Snapshots
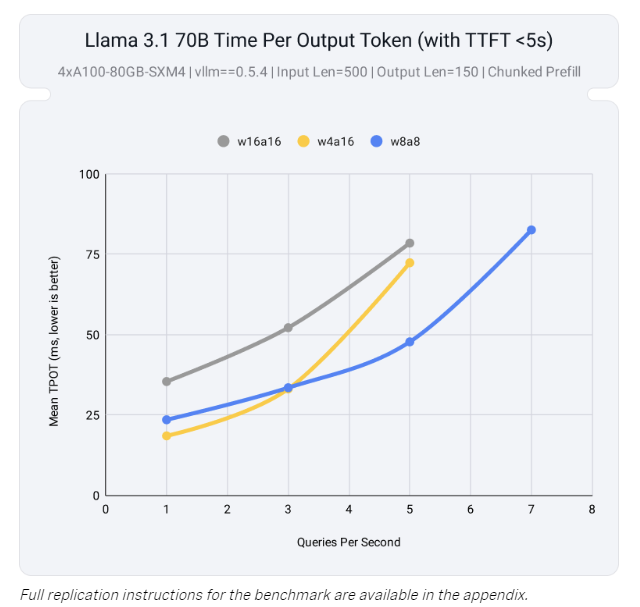
Neural Magic Releases LLM Compressor: A Novel Library to Compress LLMs ...
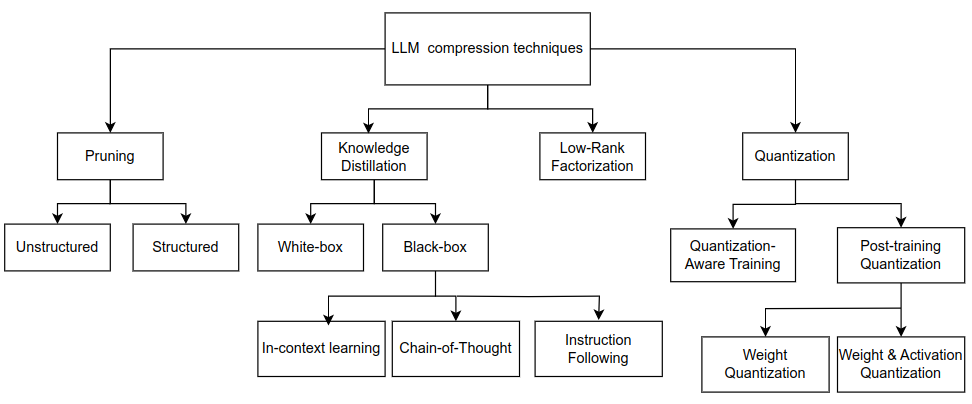
LLM Compression Techniques to Build Faster and Cheaper LLMs
Paper presentation on LLM compression | PPTX
Advertisement Space (336x280)
LLM Compression Techniques to Build Faster and Cheaper LLMs
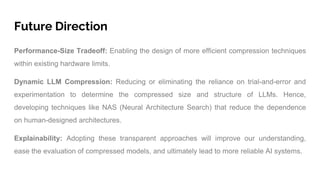
Paper presentation on LLM compression | PPTX
LLM Compressor,使vLLM 实现更快推理_llmcompressor-CSDN博客
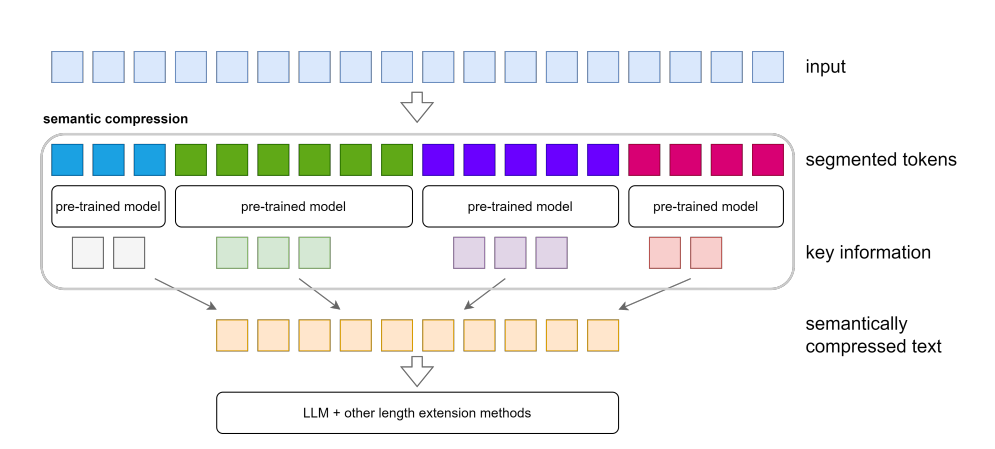
2 Ways to Extend LLM Context Windows — Supermemory

New Scalability Tips for LLM Platforms: Step-by-Step Guide

Learning is Forgetting: LLM Training As Lossy Compression