
Sparse Attention For Efficient Transformers
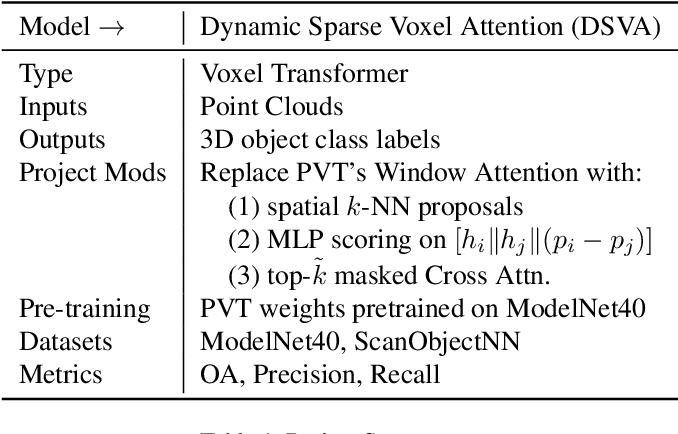
Table 1 from Dynamic Sparse Voxel Attention for Efficient Transformers ...

Trainable Log-linear Sparse Attention for Efficient Diffusion Transformers
Sparse Attention for Efficient Transformers
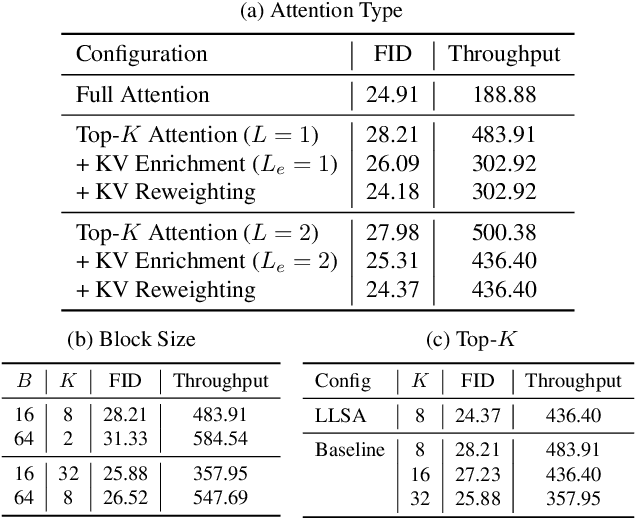
Trainable Log-linear Sparse Attention for Efficient Diffusion Transformers

Sparse Attention Transformers for Long-Form Math | AI Tutorial | Next ...

Smart Bird: Learnable Sparse Attention for Efficient and Effective ...

Sparse Attention Transformers for Long-Form Math | AI Tutorial | Next ...

Transformers with Sparse Attention for Granger Causality | AI Research ...

Sparser is Faster and Less is More: Efficient Sparse Attention for Long ...

Smart Bird: Learnable Sparse Attention for Efficient and Effective ...
Advertisement Space (300x250)

(PDF) Efficient Content-Based Sparse Attention with Routing Transformers

(PDF) Smart Bird: Learnable Sparse Attention for Efficient and ...

Sparse Attention Transformers for Long-Form Math | AI Tutorial | Next ...

Sparse Attention Transformers for Long-Form Math | AI Tutorial | Next ...

Constructing Transformers For Longer Sequences with Sparse Attention ...

Sparse Attention Transformers for Long-Form Math | AI Tutorial | Next ...

Transformers with Sparse Attention for Granger Causality

Efficient Content-Based Sparse Attention with Routing Transformers

Sparser is Faster and Less is More: Efficient Sparse Attention for Long ...

(PDF) Sparsifiner: Learning Sparse Instance-Dependent Attention for ...
Advertisement Space (336x280)

[논문 리뷰] Sparser is Faster and Less is More: Efficient Sparse Attention ...
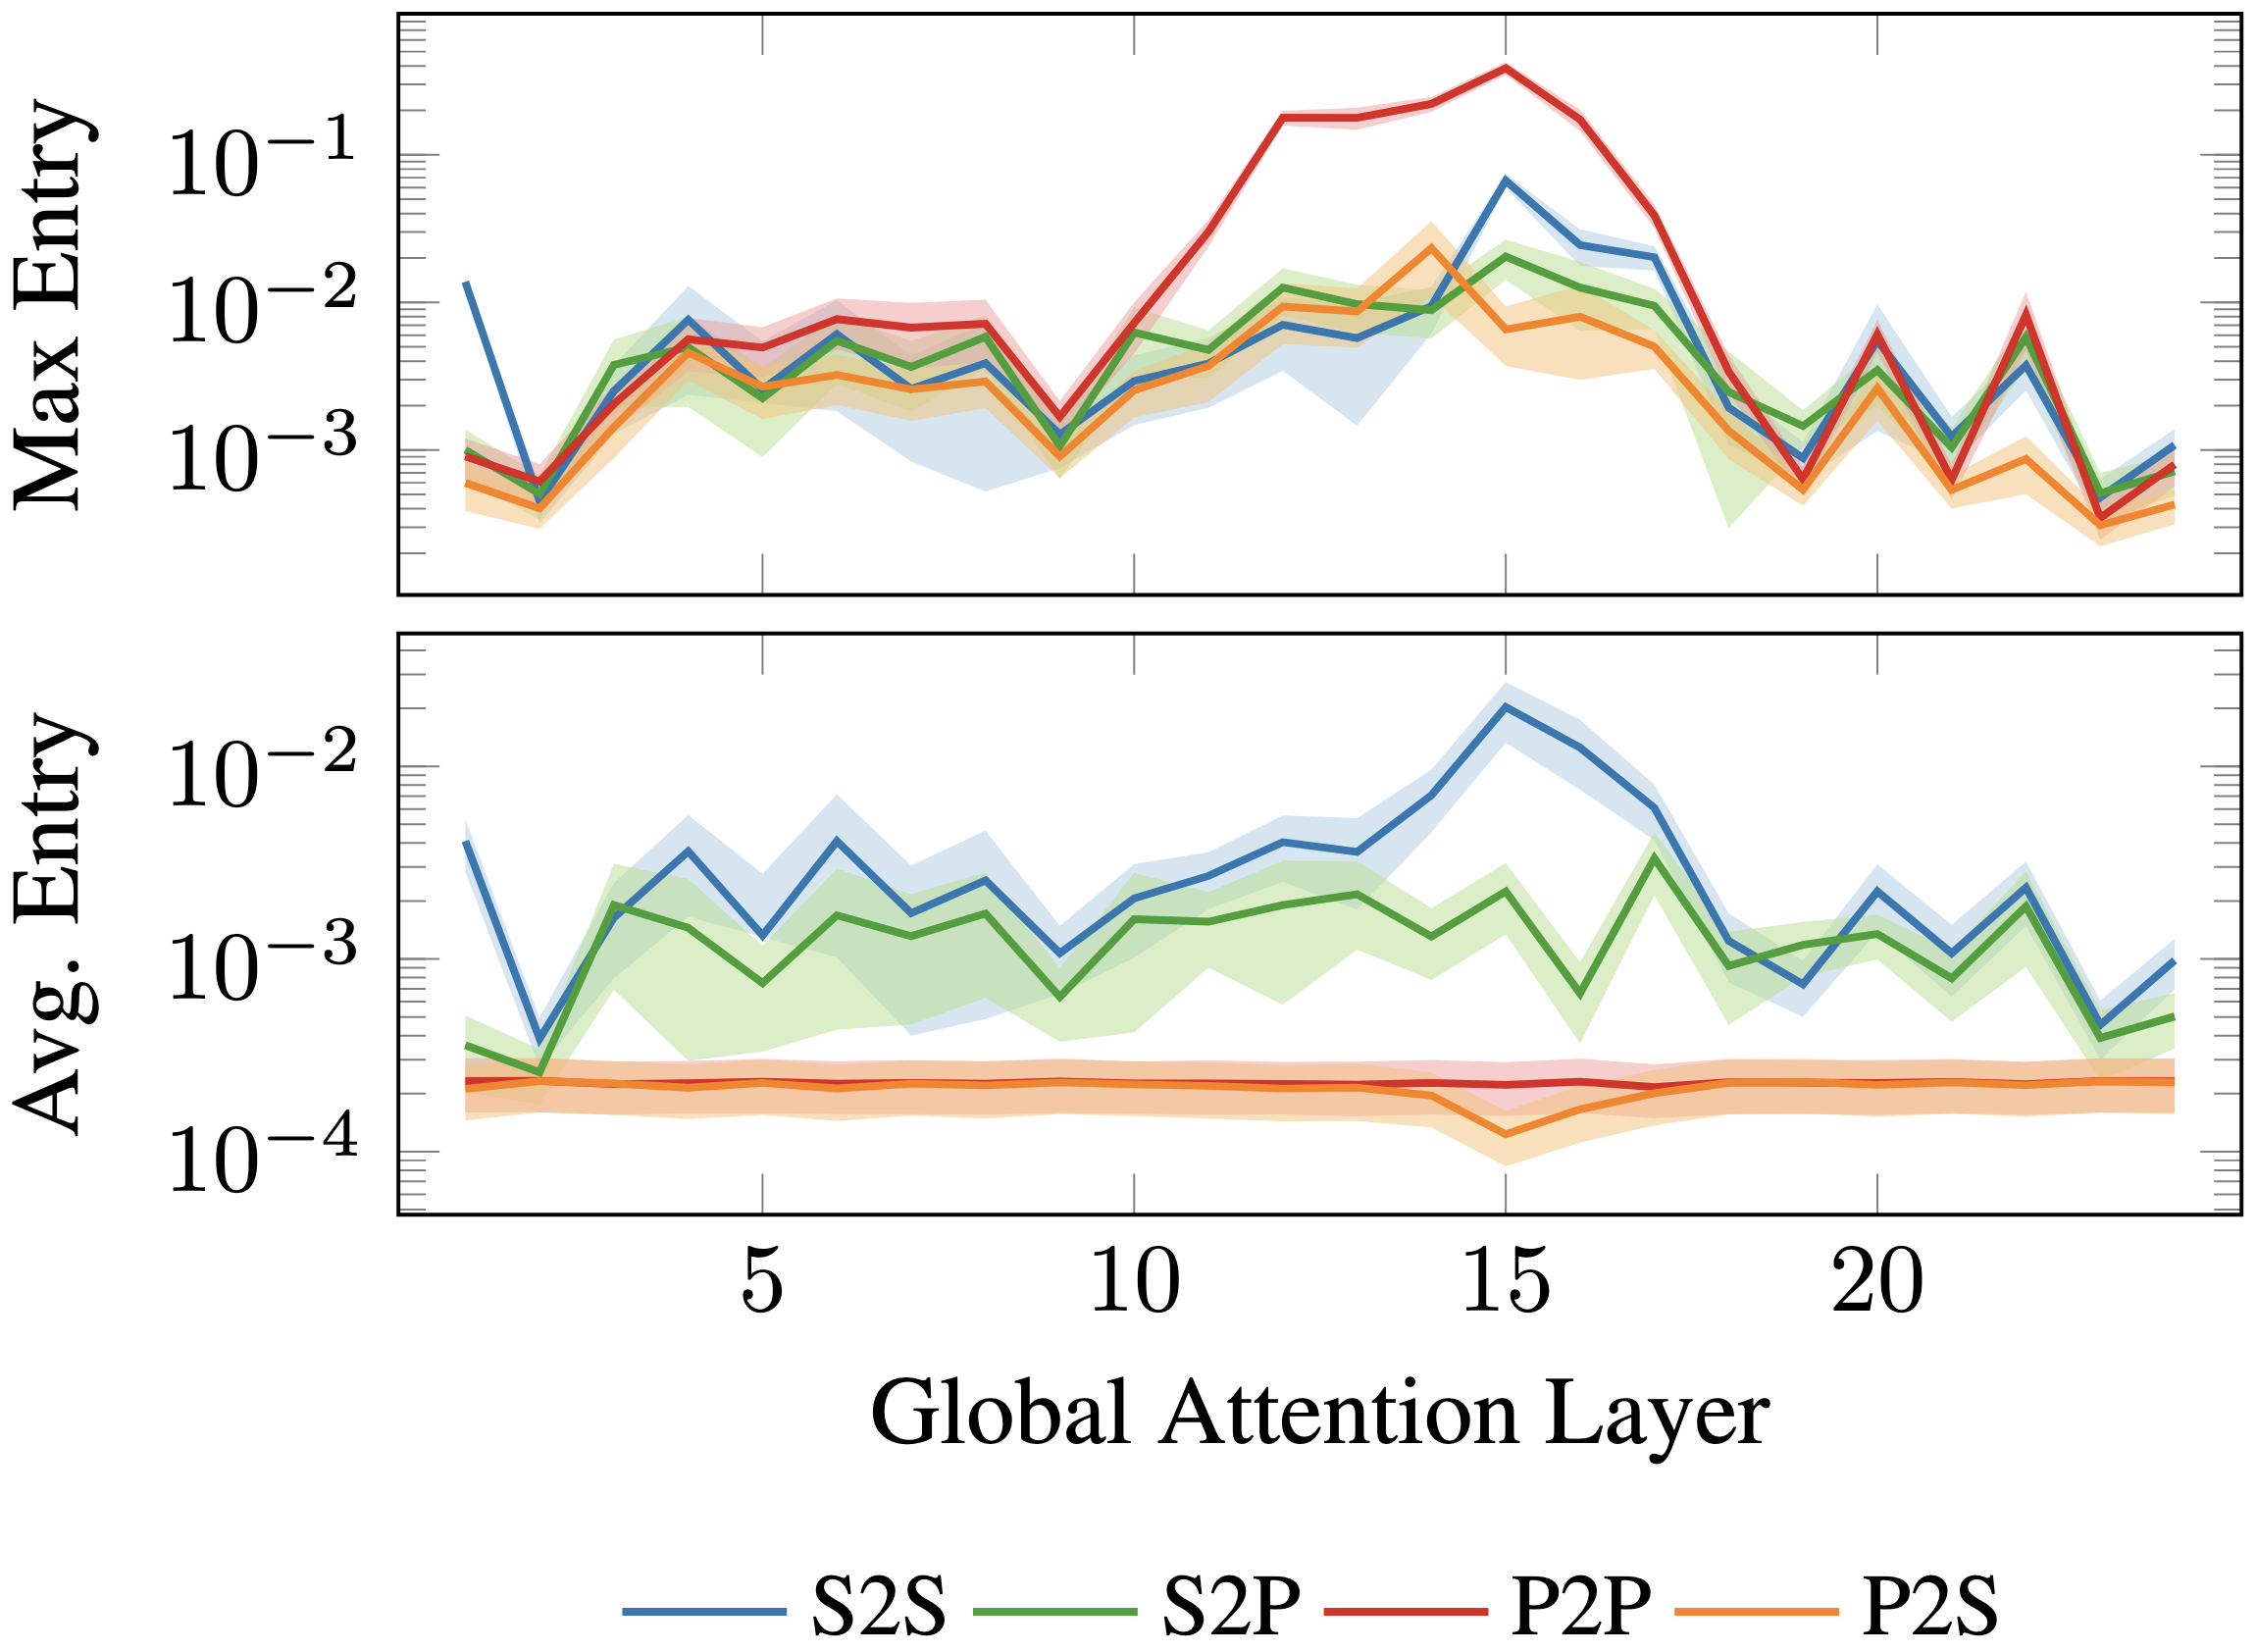
Block-Sparse Global Attention for Efficient Multi-View Geometry ...

Efficient Transformer-Based Piano Transcription With Sparse Attention ...

Underline | Efficient Content-Based Sparse Attention with Routing ...
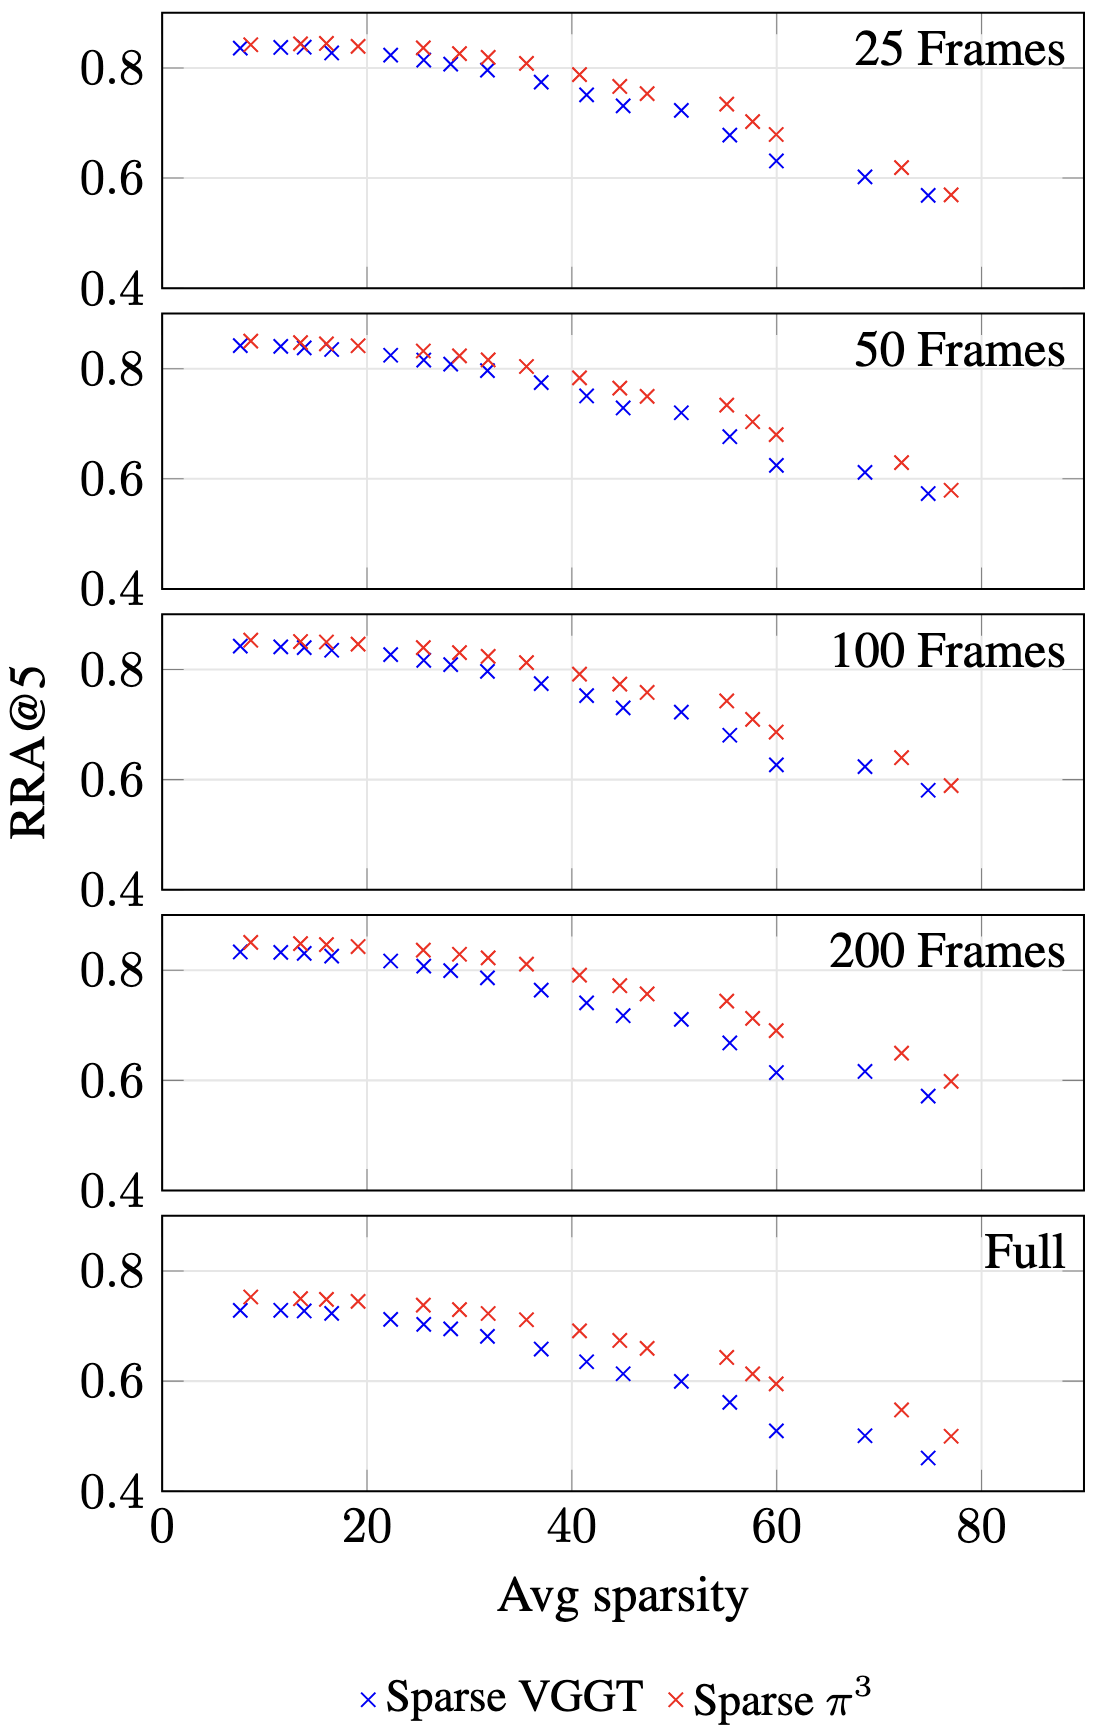
Block-Sparse Global Attention for Efficient Multi-View Geometry ...

Dynamic Sparse Attention For Scalable Transformer Acceleration | PDF ...

Figure 2 from An Exploration of Hierarchical Attention Transformers for ...

Fusion of regional and sparse attention in Vision Transformers | AI ...

(PDF) Sparser is Faster and Less is More: Efficient Sparse Attention ...
Sparse Attention and Performer Variants: Efficient Transformer Ideas ...
Advertisement Space (336x280)
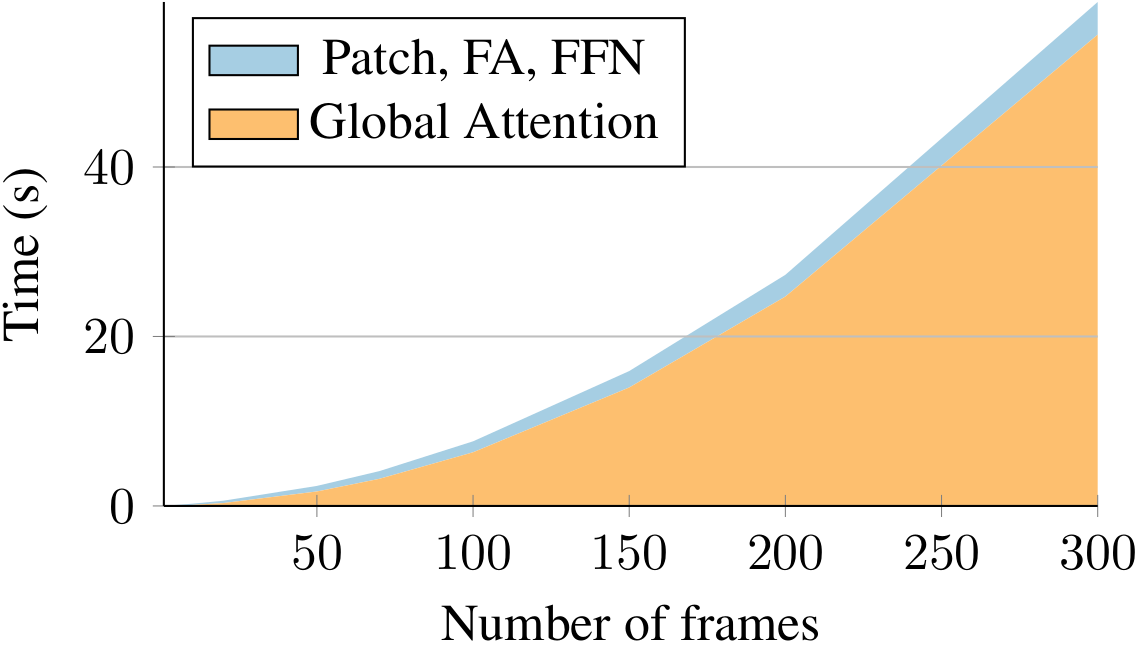
Block-Sparse Global Attention for Efficient Multi-View Geometry ...
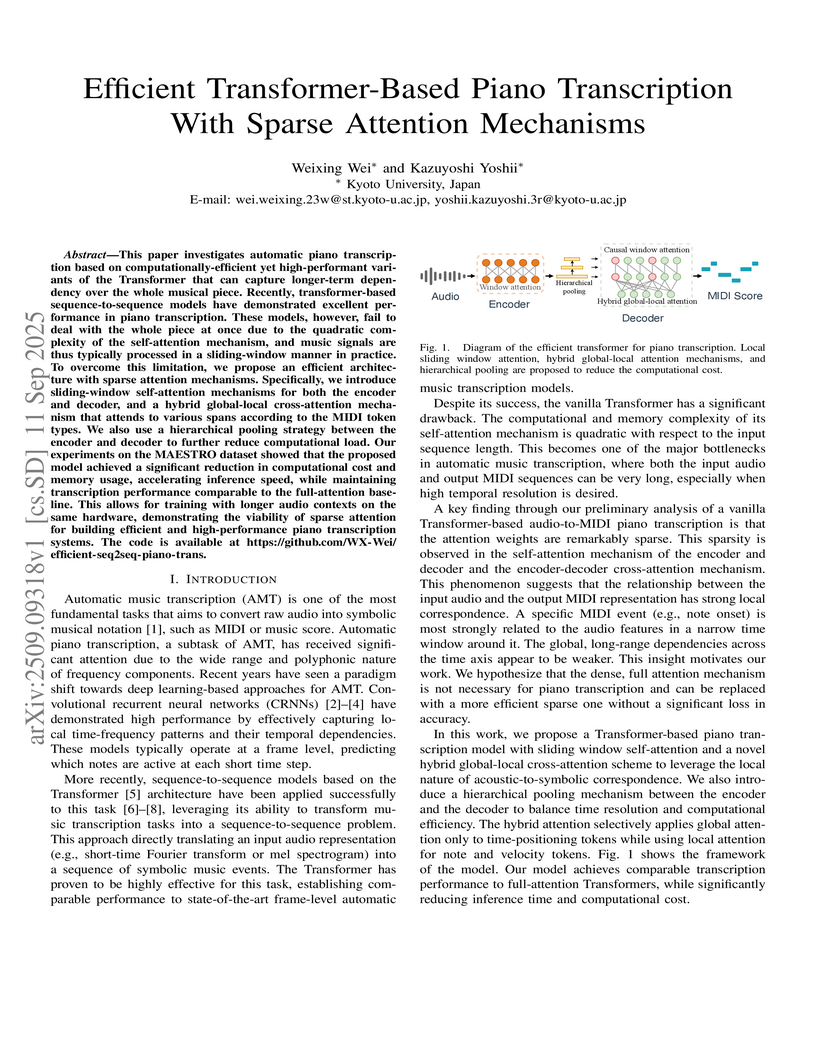
Efficient Transformer-Based Piano Transcription With Sparse Attention ...

GitHub - WallelWan/SP2T: [ICCV 2025] SP2T: Sparse Proxy Attention for ...
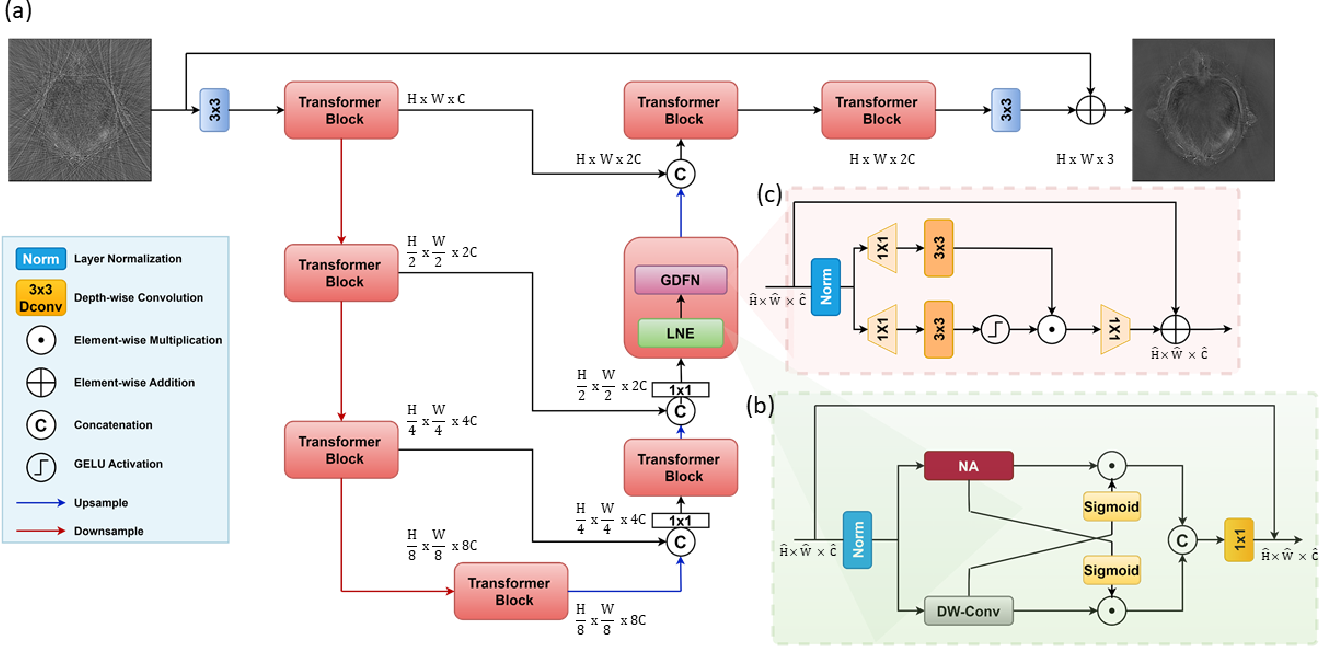
Figure 1 from Local Spatial Attention Transformer For Sparse ...
Sparse Attention and Performer Variants: Efficient Transformer Ideas ...

[2210.11794] Diffuser: Efficient Transformers with Multi-hop Attention ...