
Trainable Log Linear Sparse Attention For Efficient Diffusion Transformers

Trainable Log-linear Sparse Attention for Efficient Diffusion Transformers
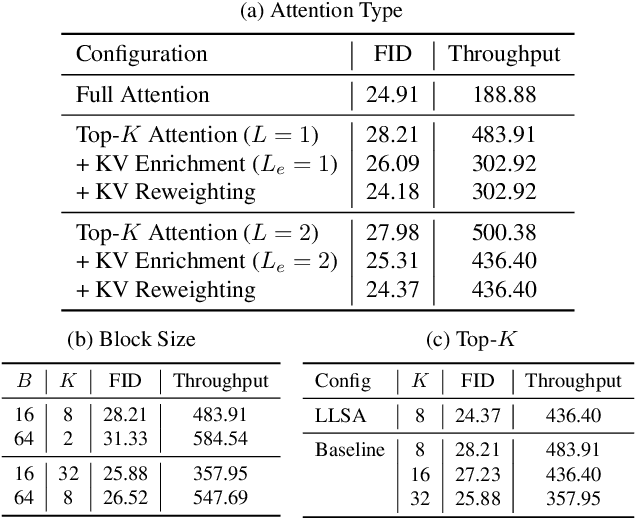
Trainable Log-linear Sparse Attention for Efficient Diffusion Transformers
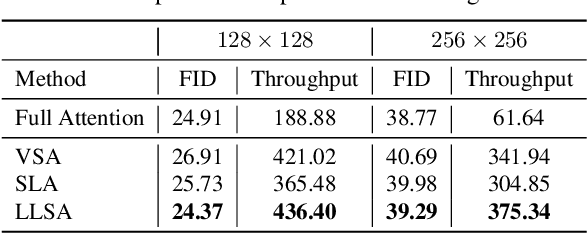
Trainable Log-linear Sparse Attention for Efficient Diffusion Transformers
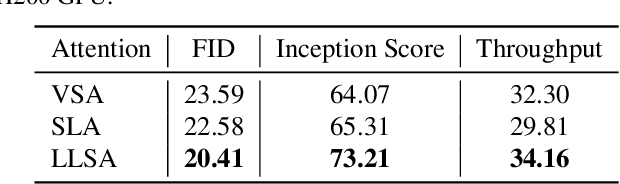
Trainable Log-linear Sparse Attention for Efficient Diffusion Transformers
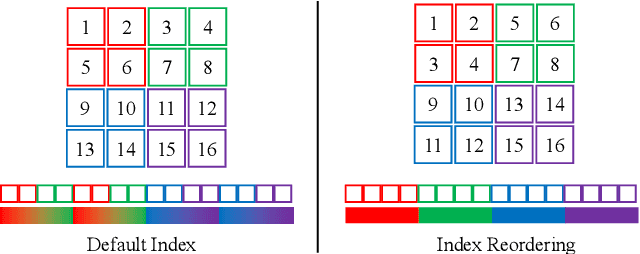
Trainable Log-linear Sparse Attention for Efficient Diffusion Transformers
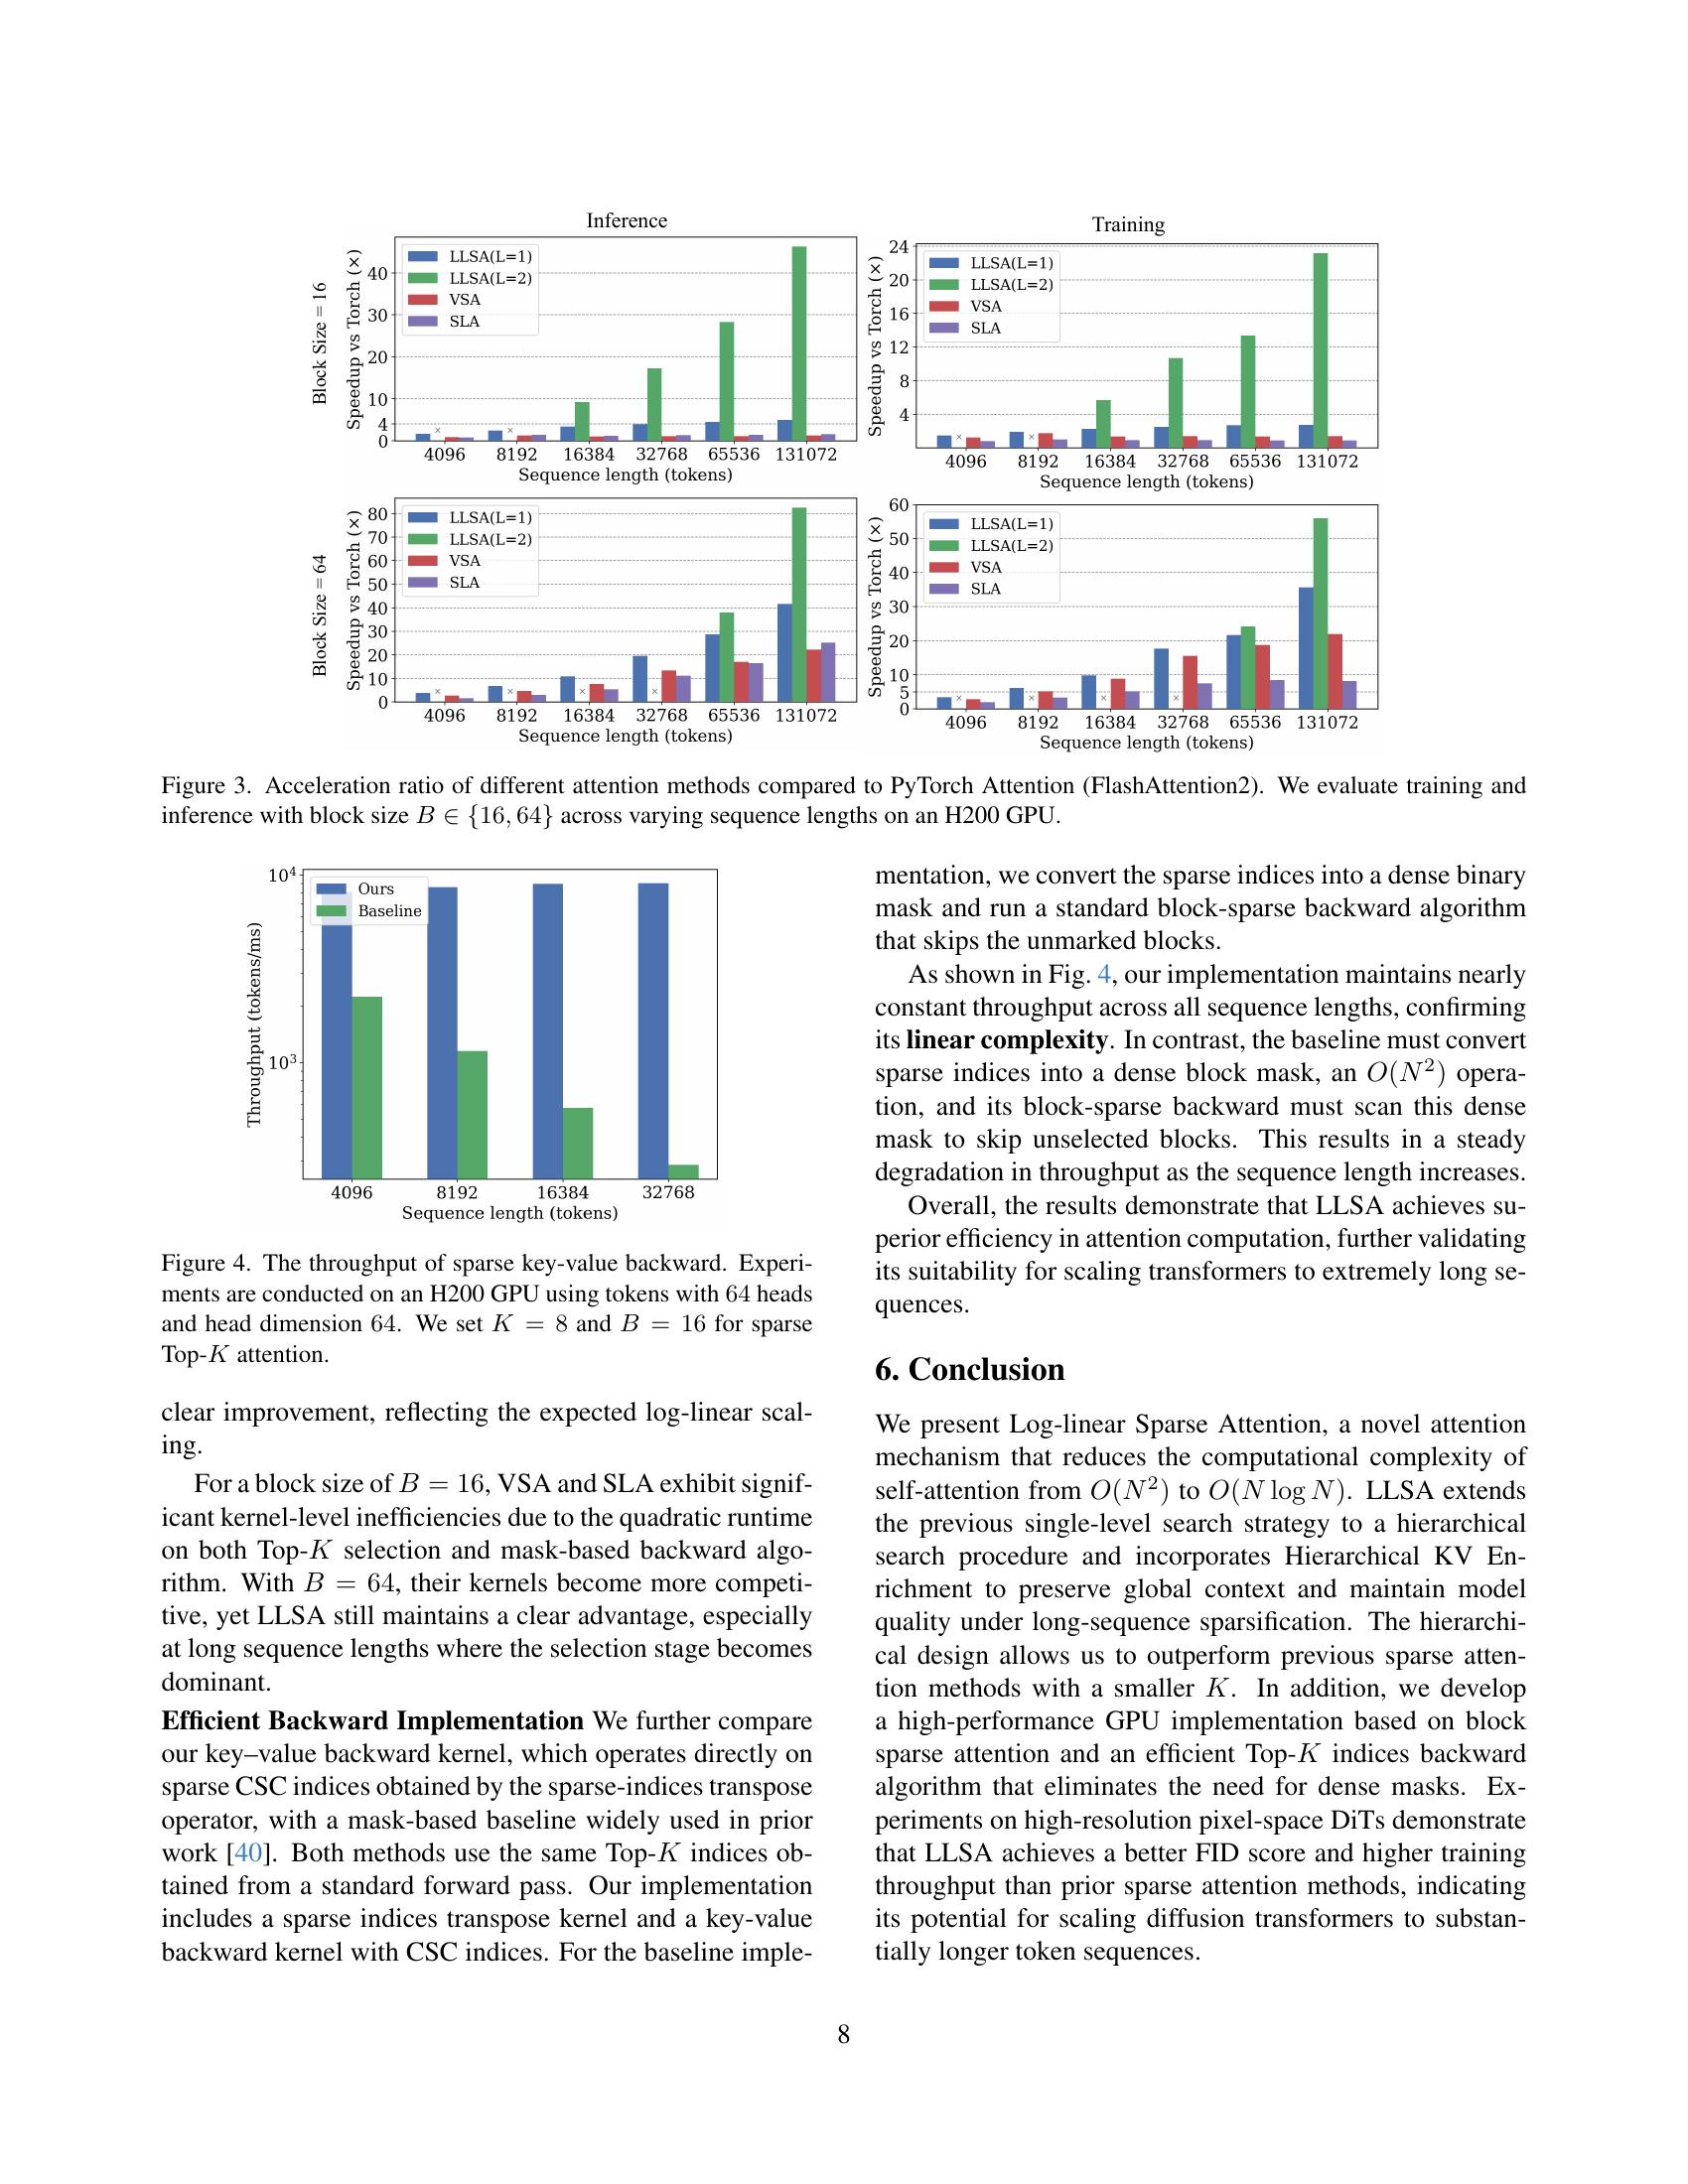
Trainable Log-linear Sparse Attention for Efficient Diffusion ...

EDiT: Efficient Diffusion Transformers with Linear Compressed Attention ...
Sparse Attention for Efficient Transformers

[论文评述] Faster Video Diffusion with Trainable Sparse Attention

[论文评述] EDiT: Efficient Diffusion Transformers with Linear Compressed ...
Advertisement Space (300x250)
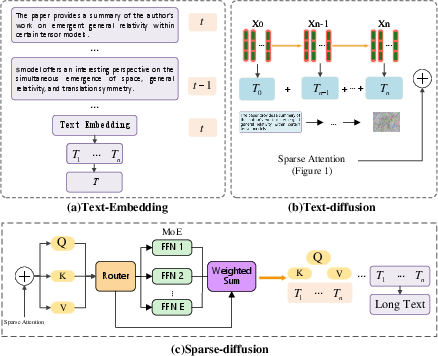
SA-DiffuSeq: Sparse Attention & Diffusion for Long Text

Sparse Attention Transformers for Long-Form Math | AI Tutorial | Next ...

Sparse Attention Transformers for Long-Form Math | AI Tutorial | Next ...

(PDF) EDiT: Efficient Diffusion Transformers with Linear Compressed ...

SparseD: Sparse Attention for Diffusion Language Models | AI Research ...

Sparser is Faster and Less is More: Efficient Sparse Attention for Long ...

Paper page - Faster Video Diffusion with Trainable Sparse Attention

Paper page - LiteAttention: A Temporal Sparse Attention for Diffusion ...
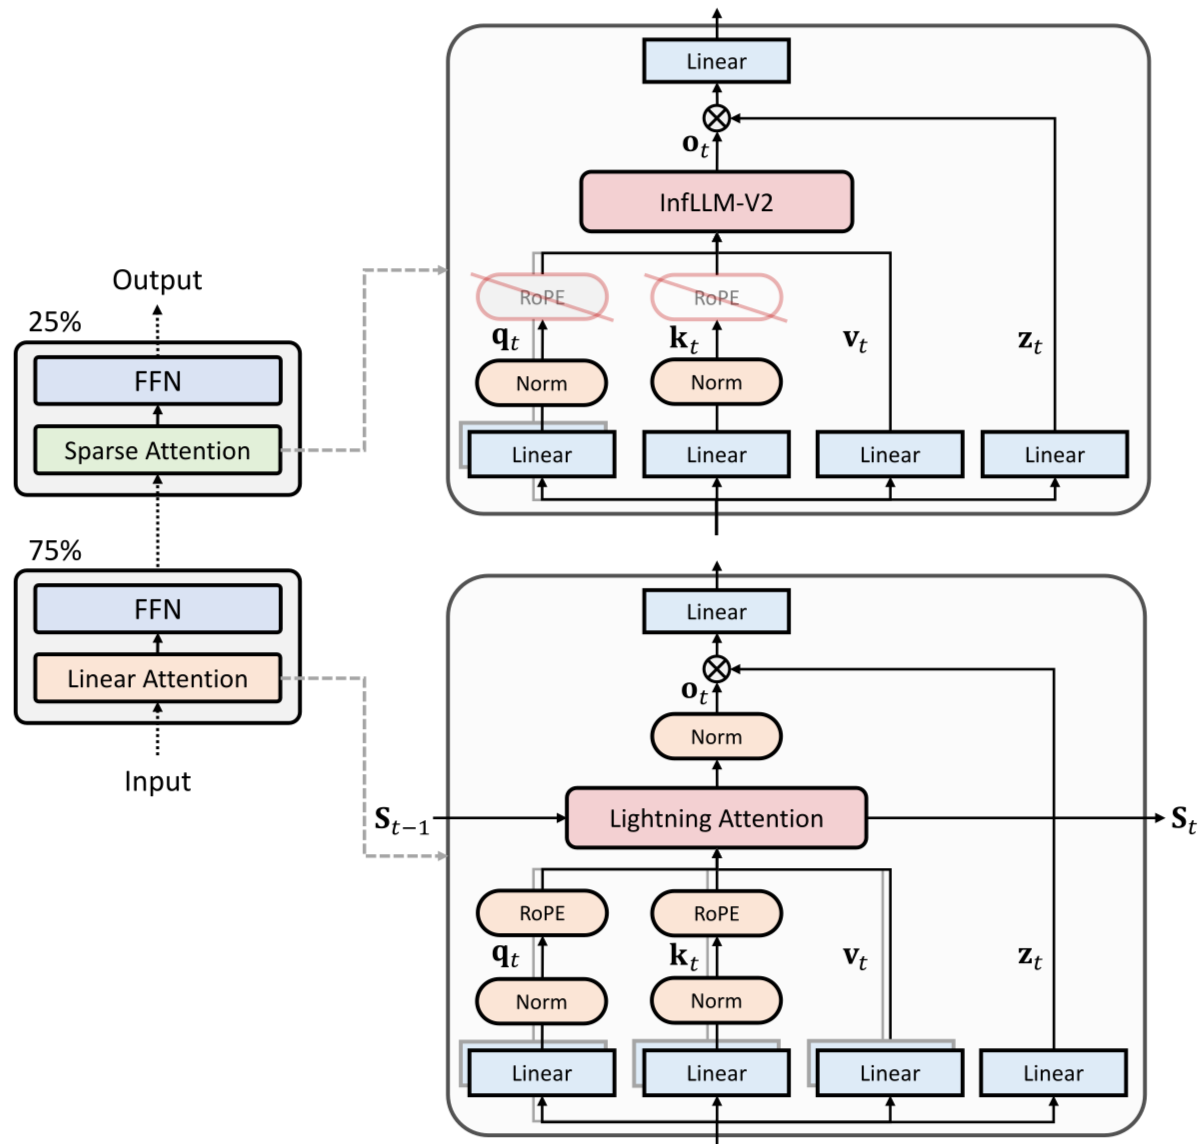
[論文レビュー] MiniCPM-SALA: Hybridizing Sparse and Linear Attention for ...

Sparse Attention Transformers for Long-Form Math | AI Tutorial | Next ...
Advertisement Space (336x280)

SLAB: Efficient Transformers with Simplified Linear Attention and ...
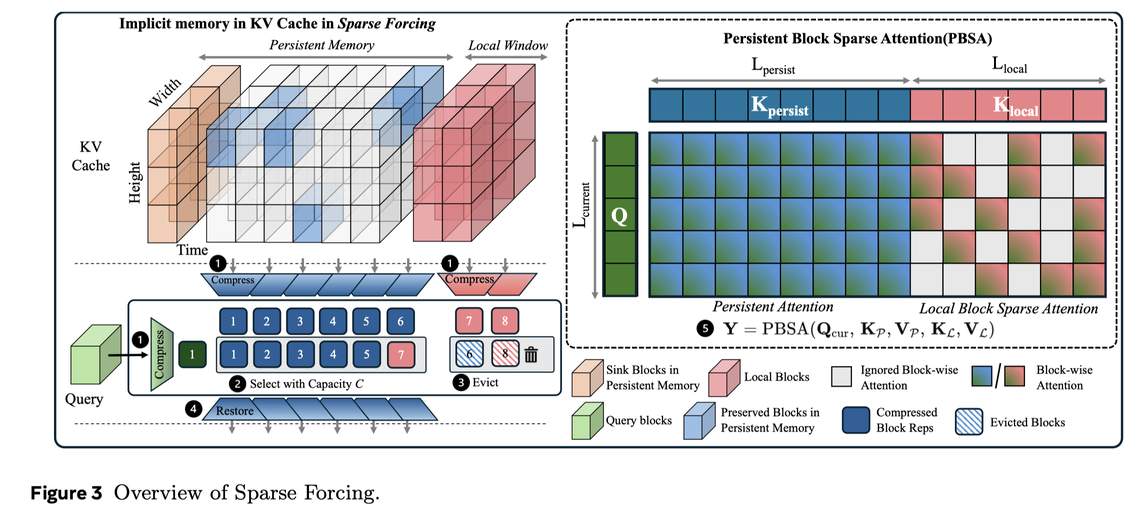
Sparse Forcing: Native Trainable Sparse Attention for Real-time ...
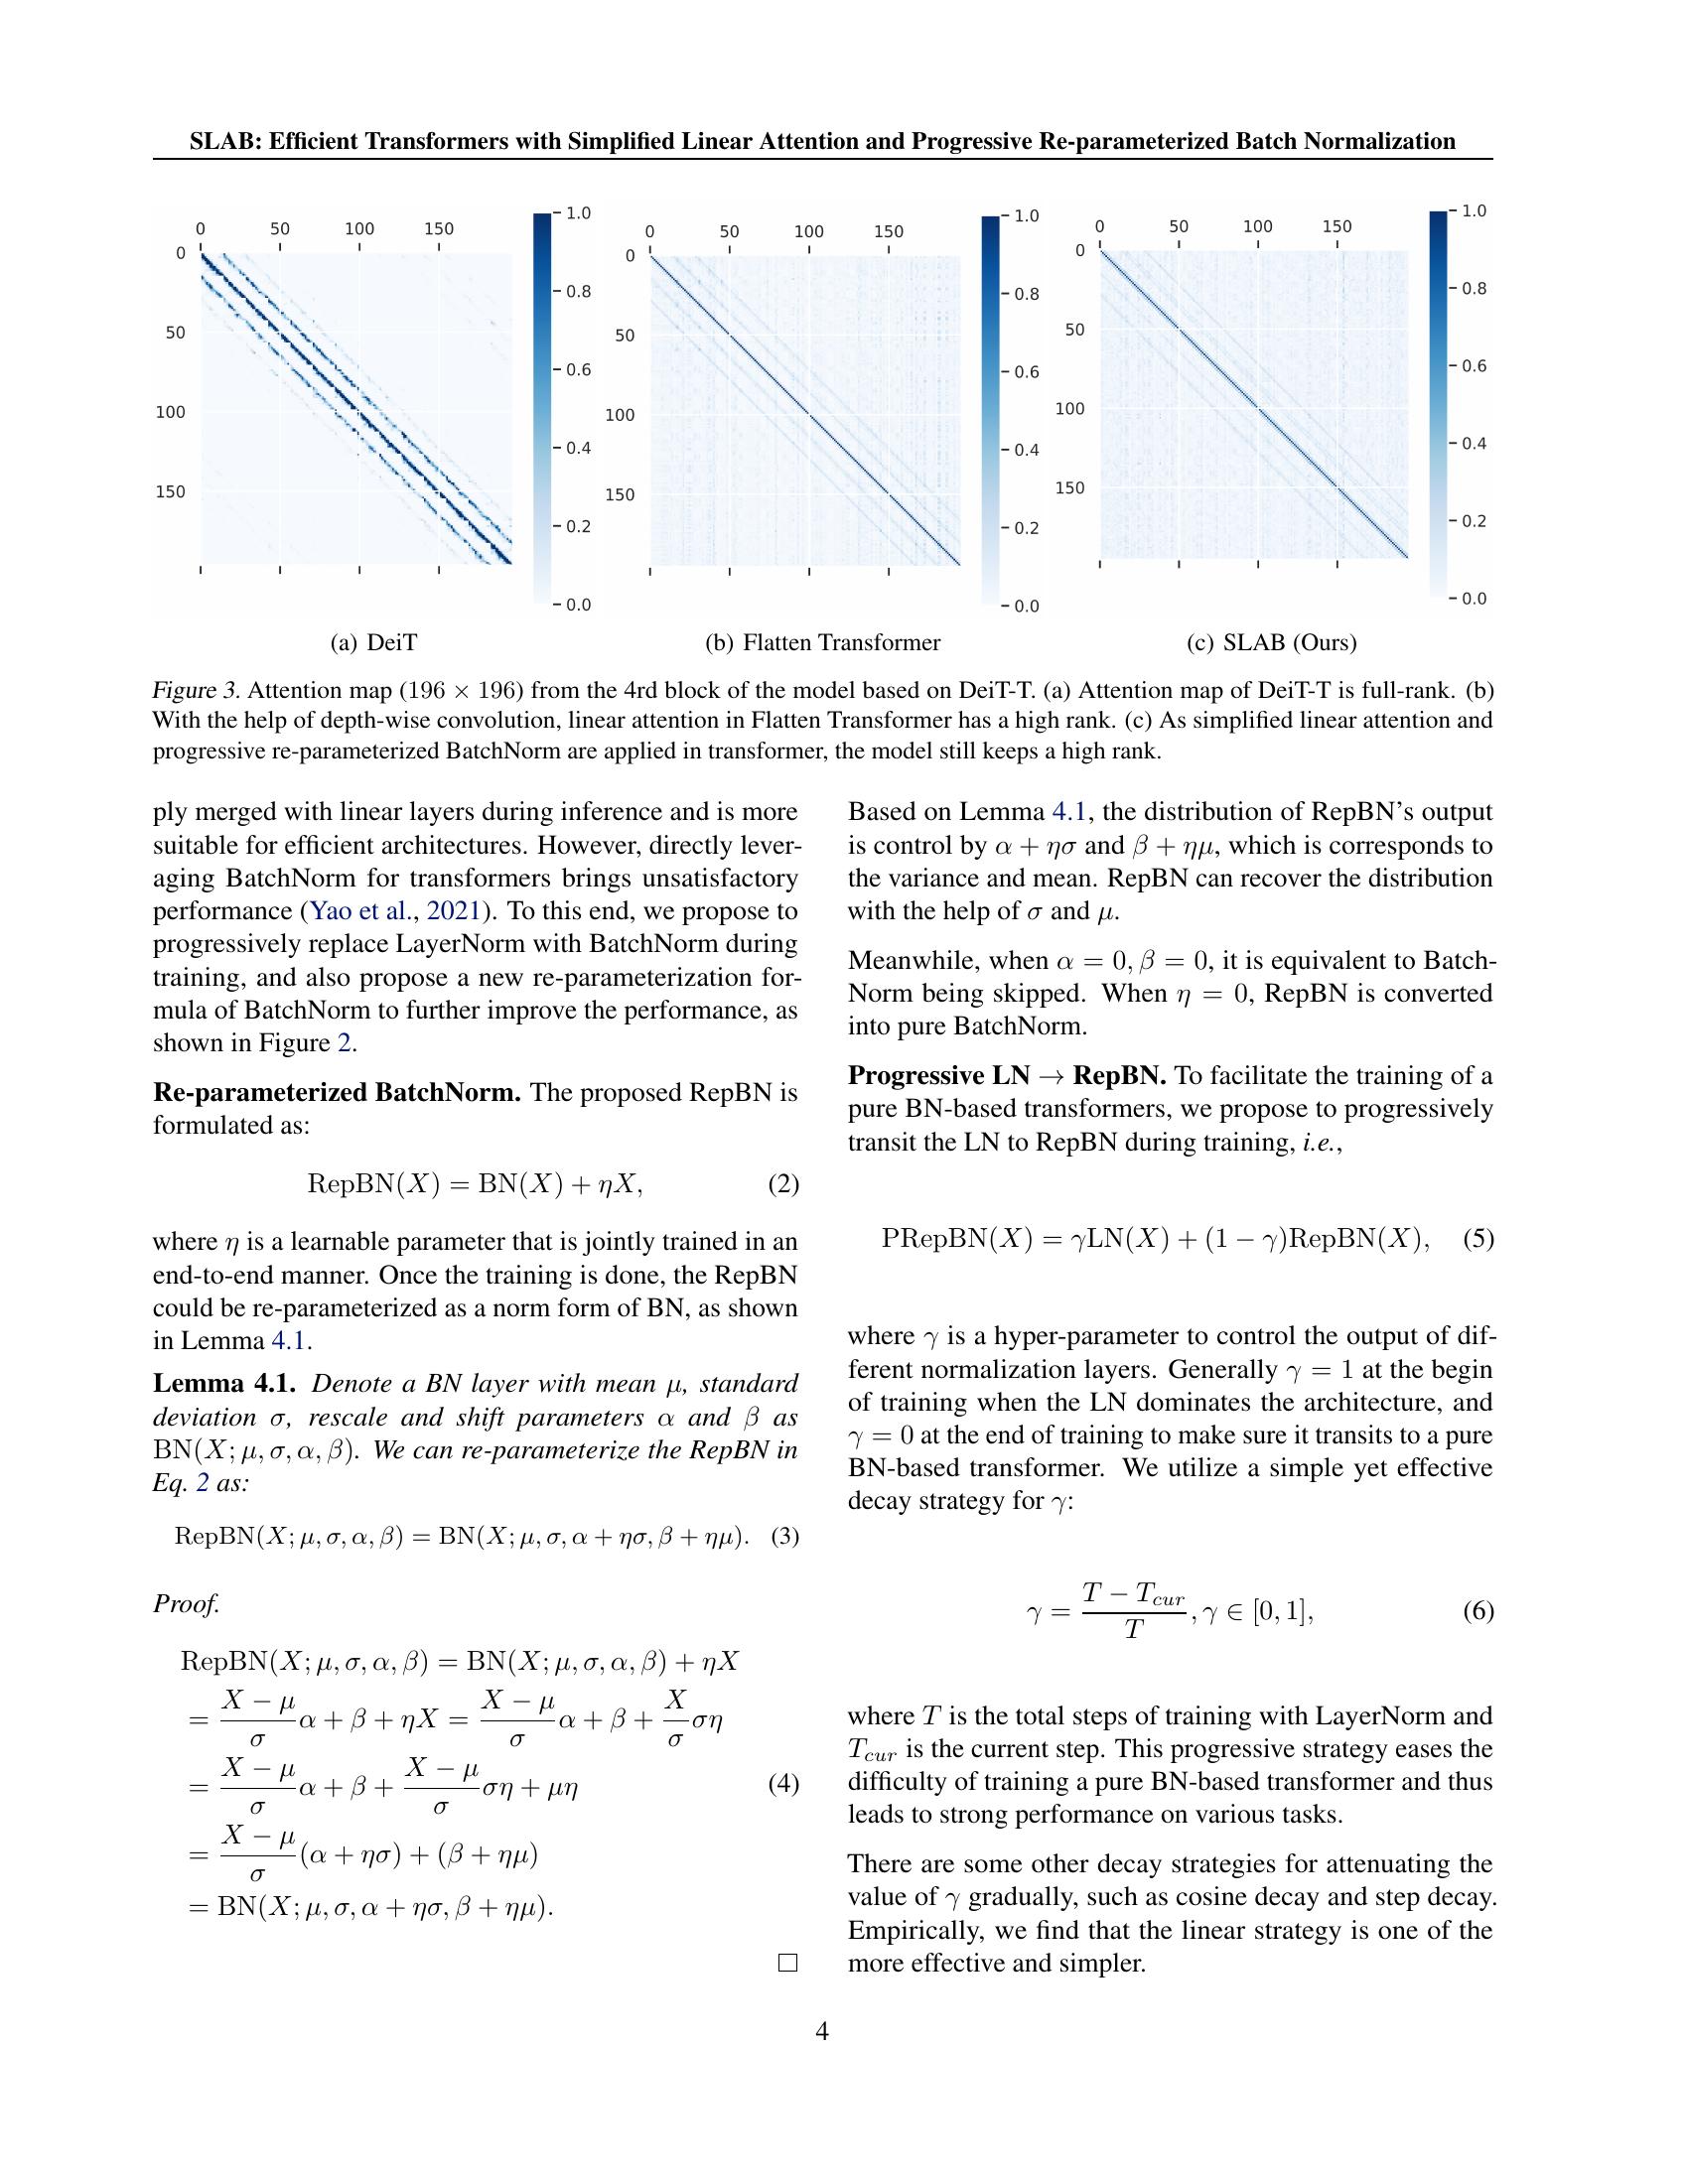
SLAB: Efficient Transformers with Simplified Linear Attention and ...

Paper page - MiniCPM-SALA: Hybridizing Sparse and Linear Attention for ...

SALAD: Achieve High-Sparsity Attention via Efficient Linear Attention ...
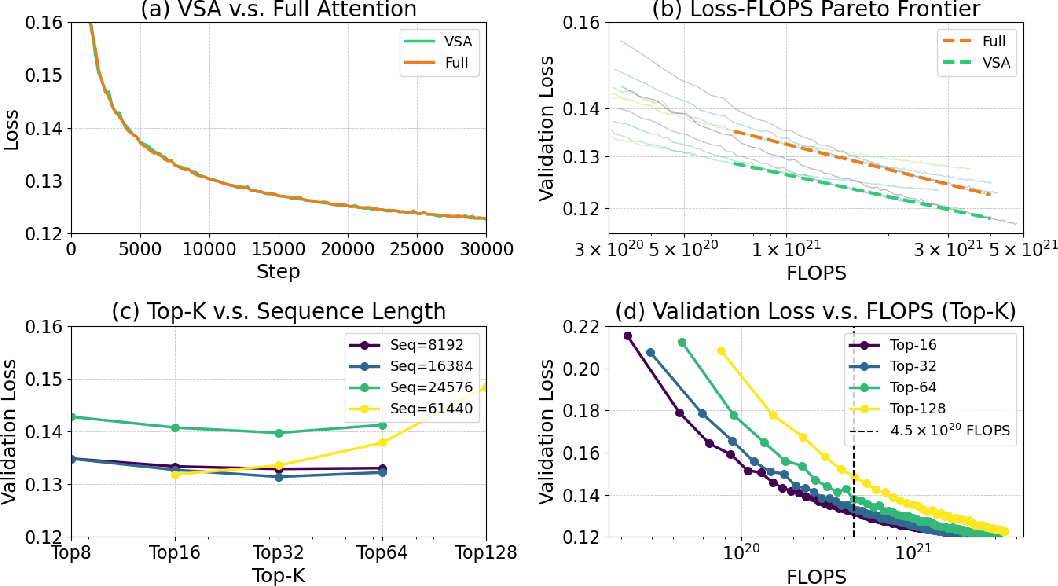
Figure 2 from VSA: Faster Video Diffusion with Trainable Sparse ...

SLA: Beyond Sparsity in Diffusion Transformers via Fine-Tunable Sparse ...

(PDF) Sparsifiner: Learning Sparse Instance-Dependent Attention for ...

SALAD: Achieve High-Sparsity Attention via Efficient Linear Attention ...

DiG: Scalable and Efficient Diffusion Models with Gated Linear ...
Advertisement Space (336x280)

Fusion of regional and sparse attention in Vision Transformers | AI ...

Log-Linear Attention for Transformers | PDF | Matrix (Mathematics ...

SALAD: Achieve High-Sparsity Attention via Efficient Linear Attention ...

Dynamic Sparse Attention For Scalable Transformer Acceleration | PDF ...
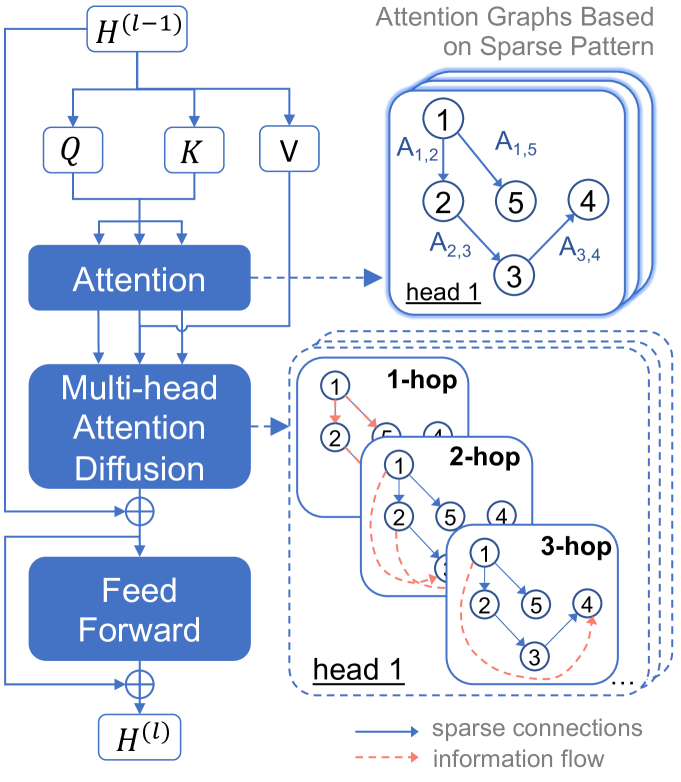
[2210.11794] Diffuser: Efficient Transformers with Multi-hop Attention ...

SLA: Beyond Sparsity in Diffusion Transformers via Fine-Tunable Sparse ...