
Speculative Decoding Making Language Models Generate Faster Without

Speculative Decoding - Making Language Models Generate Faster Without ...

Speculative Decoding - Making Language Models Generate Faster Without ...
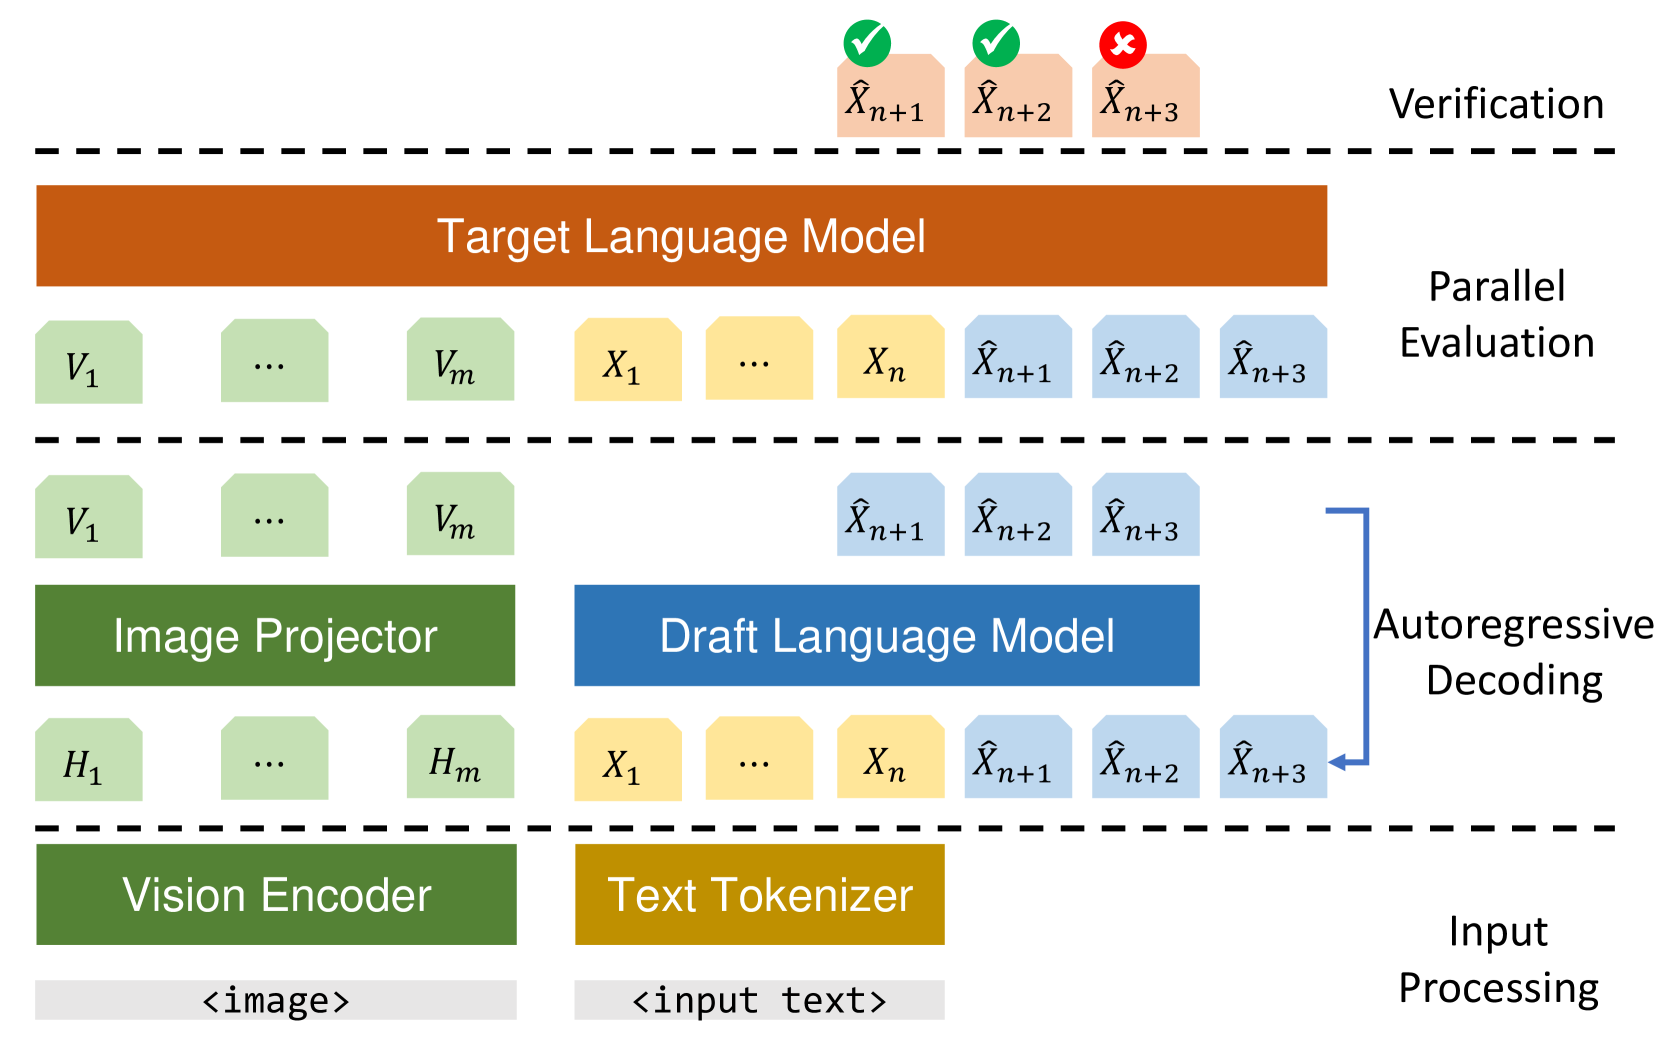
On Speculative Decoding for Multimodal Large Language Models | AI ...
Speculative Decoding Explained: Faster Inference Without Quality Loss
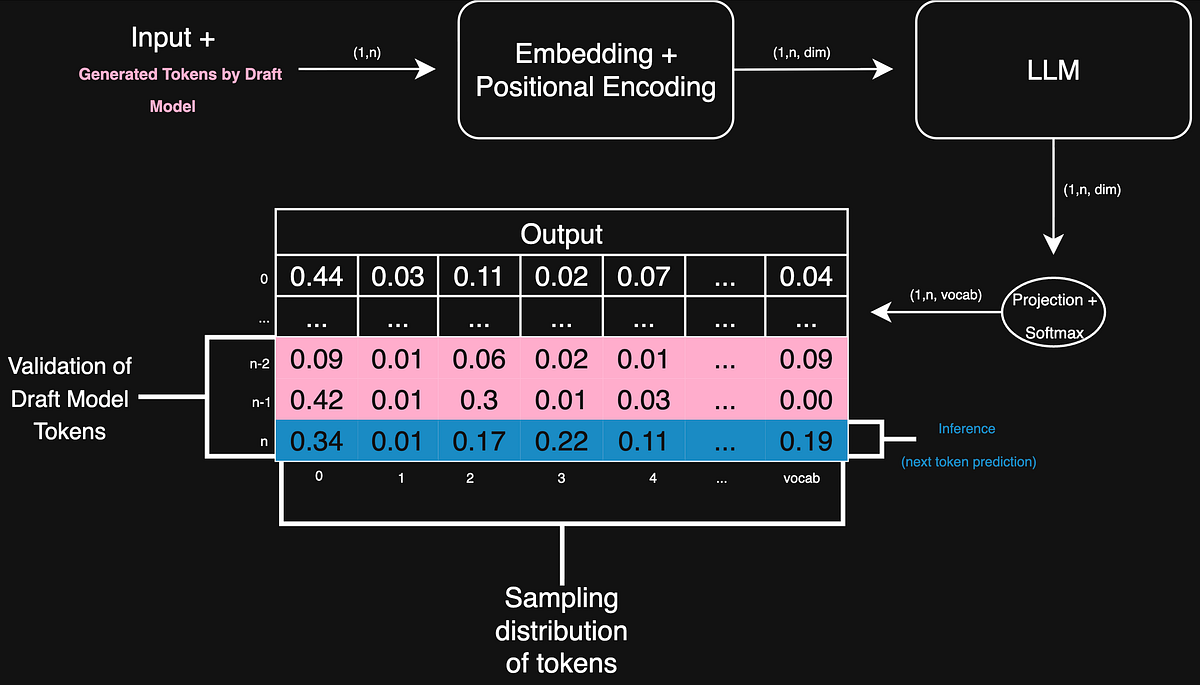
Speculative Decoding: How to Make Large Language Models Think Faster ...

Recurrent Drafter for Fast Speculative Decoding in Large Language Models

Self Speculative Decoding for Diffusion Large Language Models | AI ...

Recurrent Drafter for Fast Speculative Decoding in Large Language Models

🚀 Speculative Decoding: Small Models Guess, Big Models 3× Faster ...
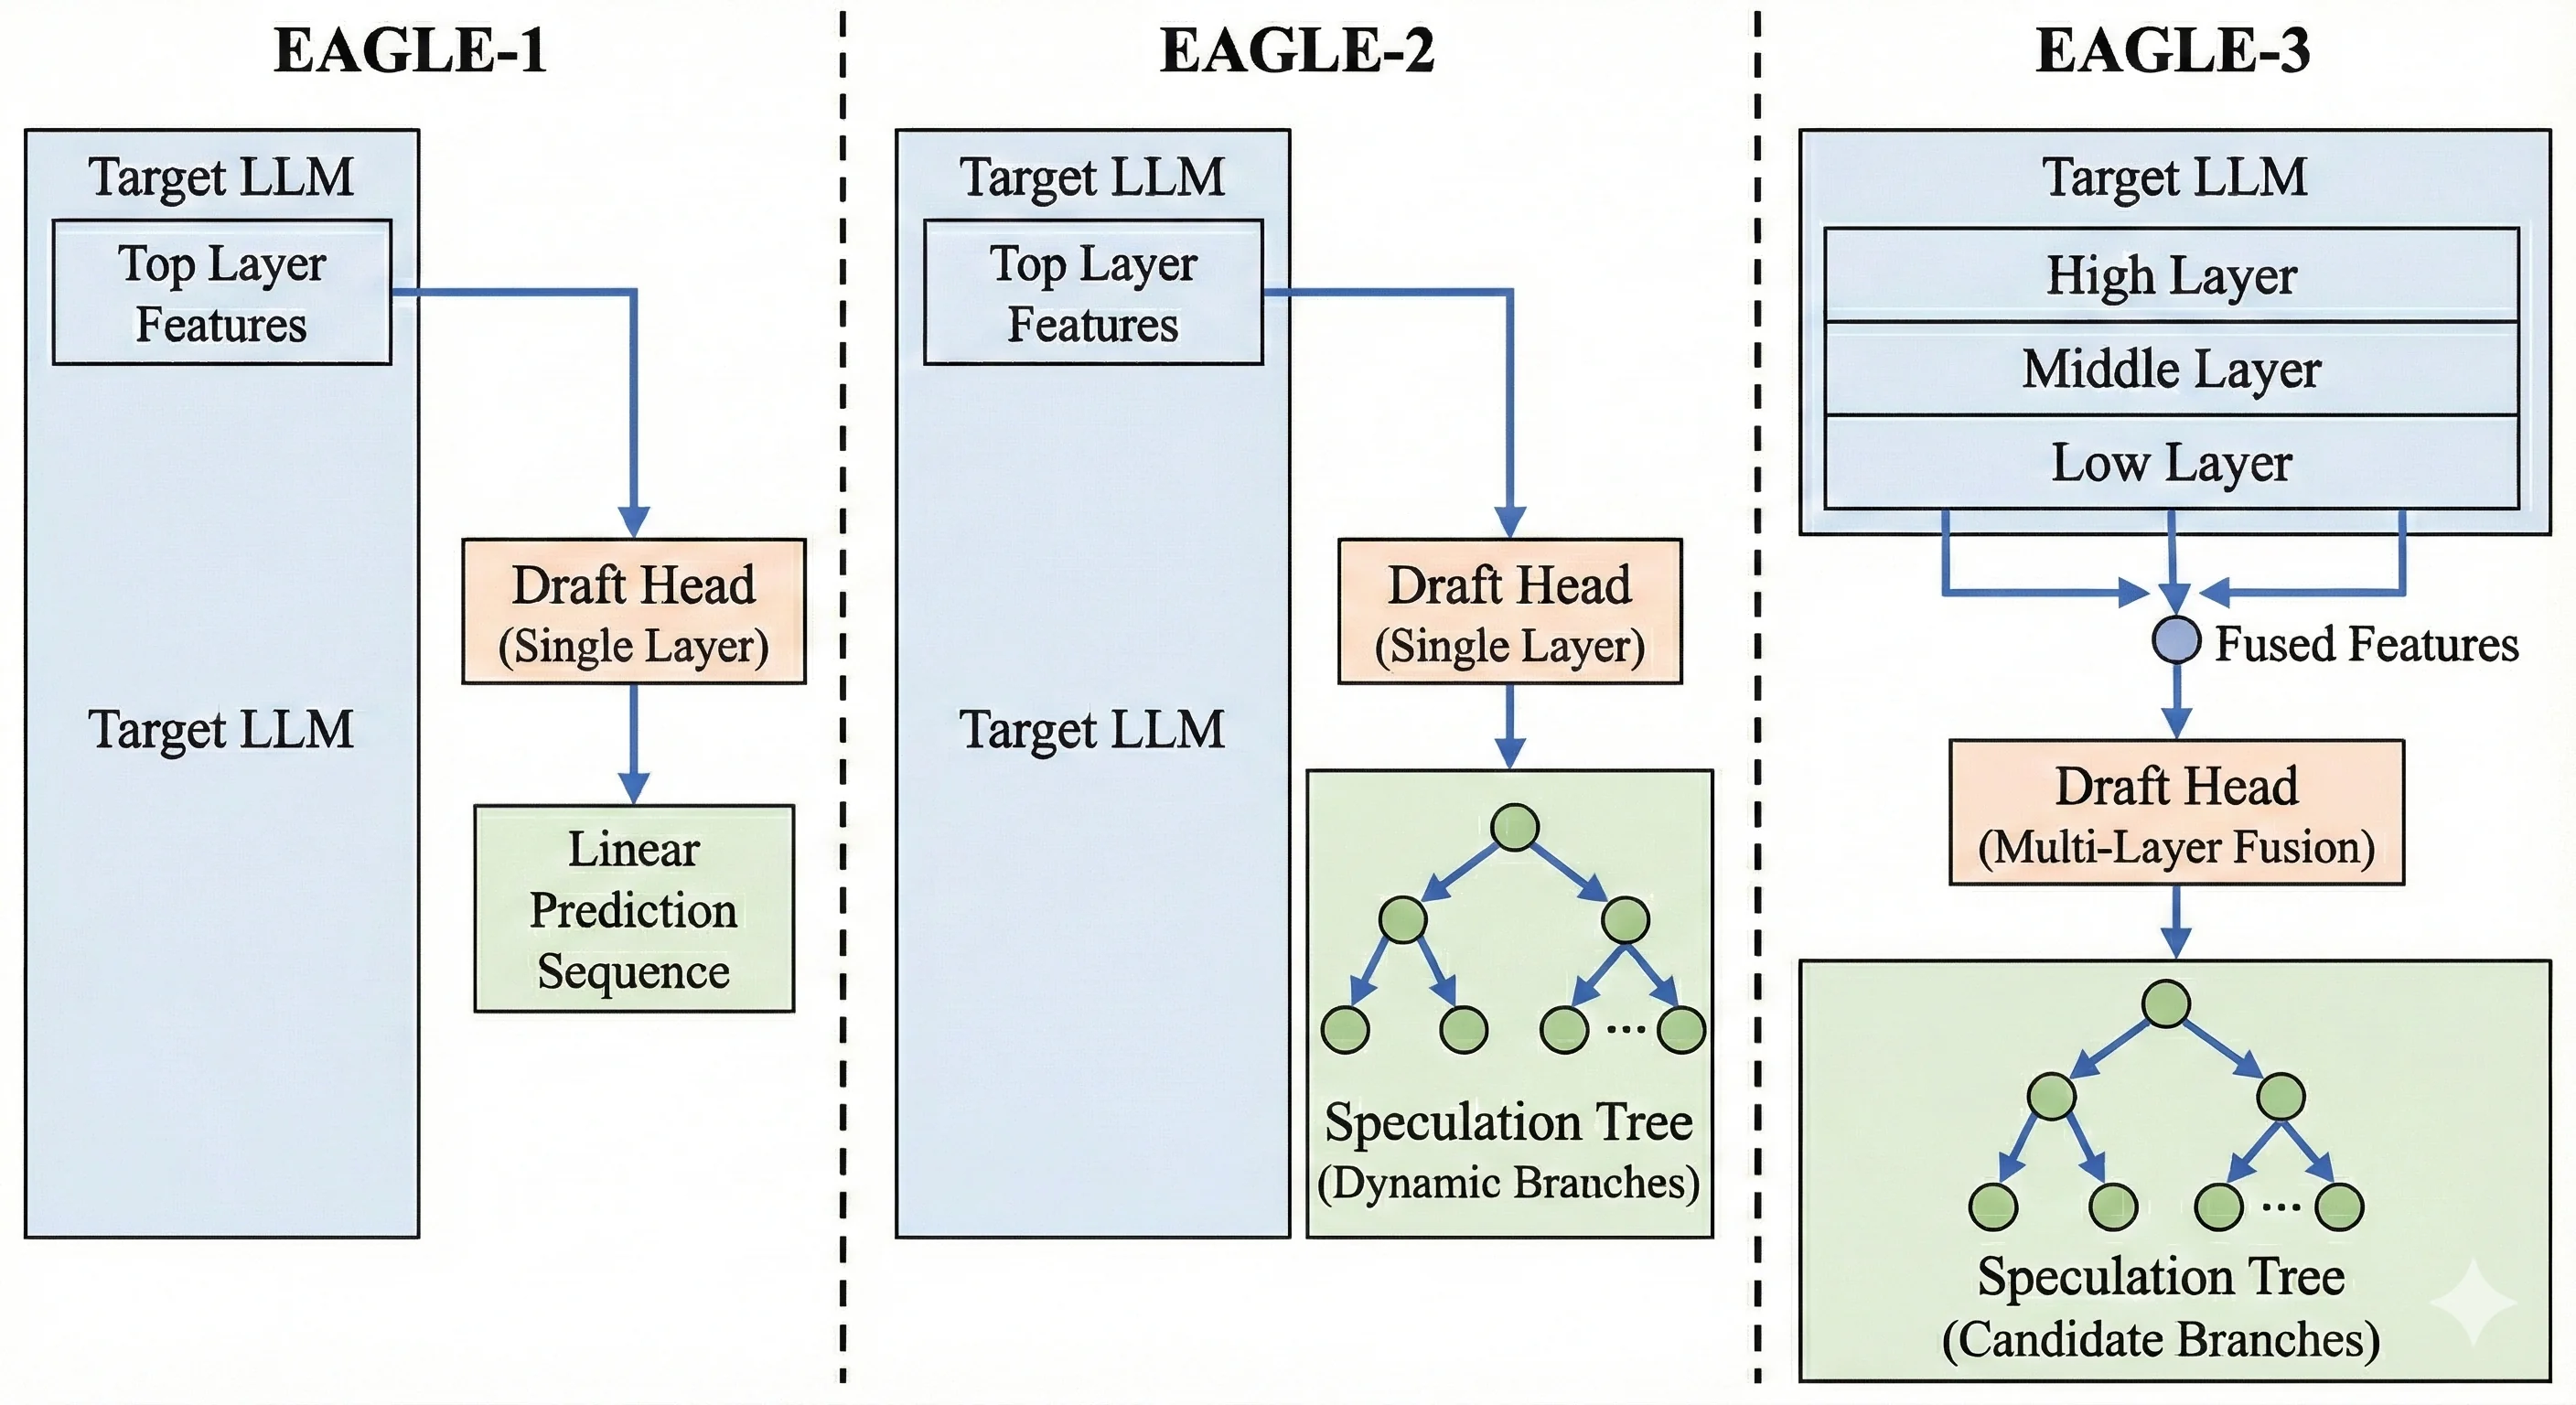
Speculative Decoding in vLLM: Complete Guide to Faster LLM Inference ...
Advertisement Space (300x250)
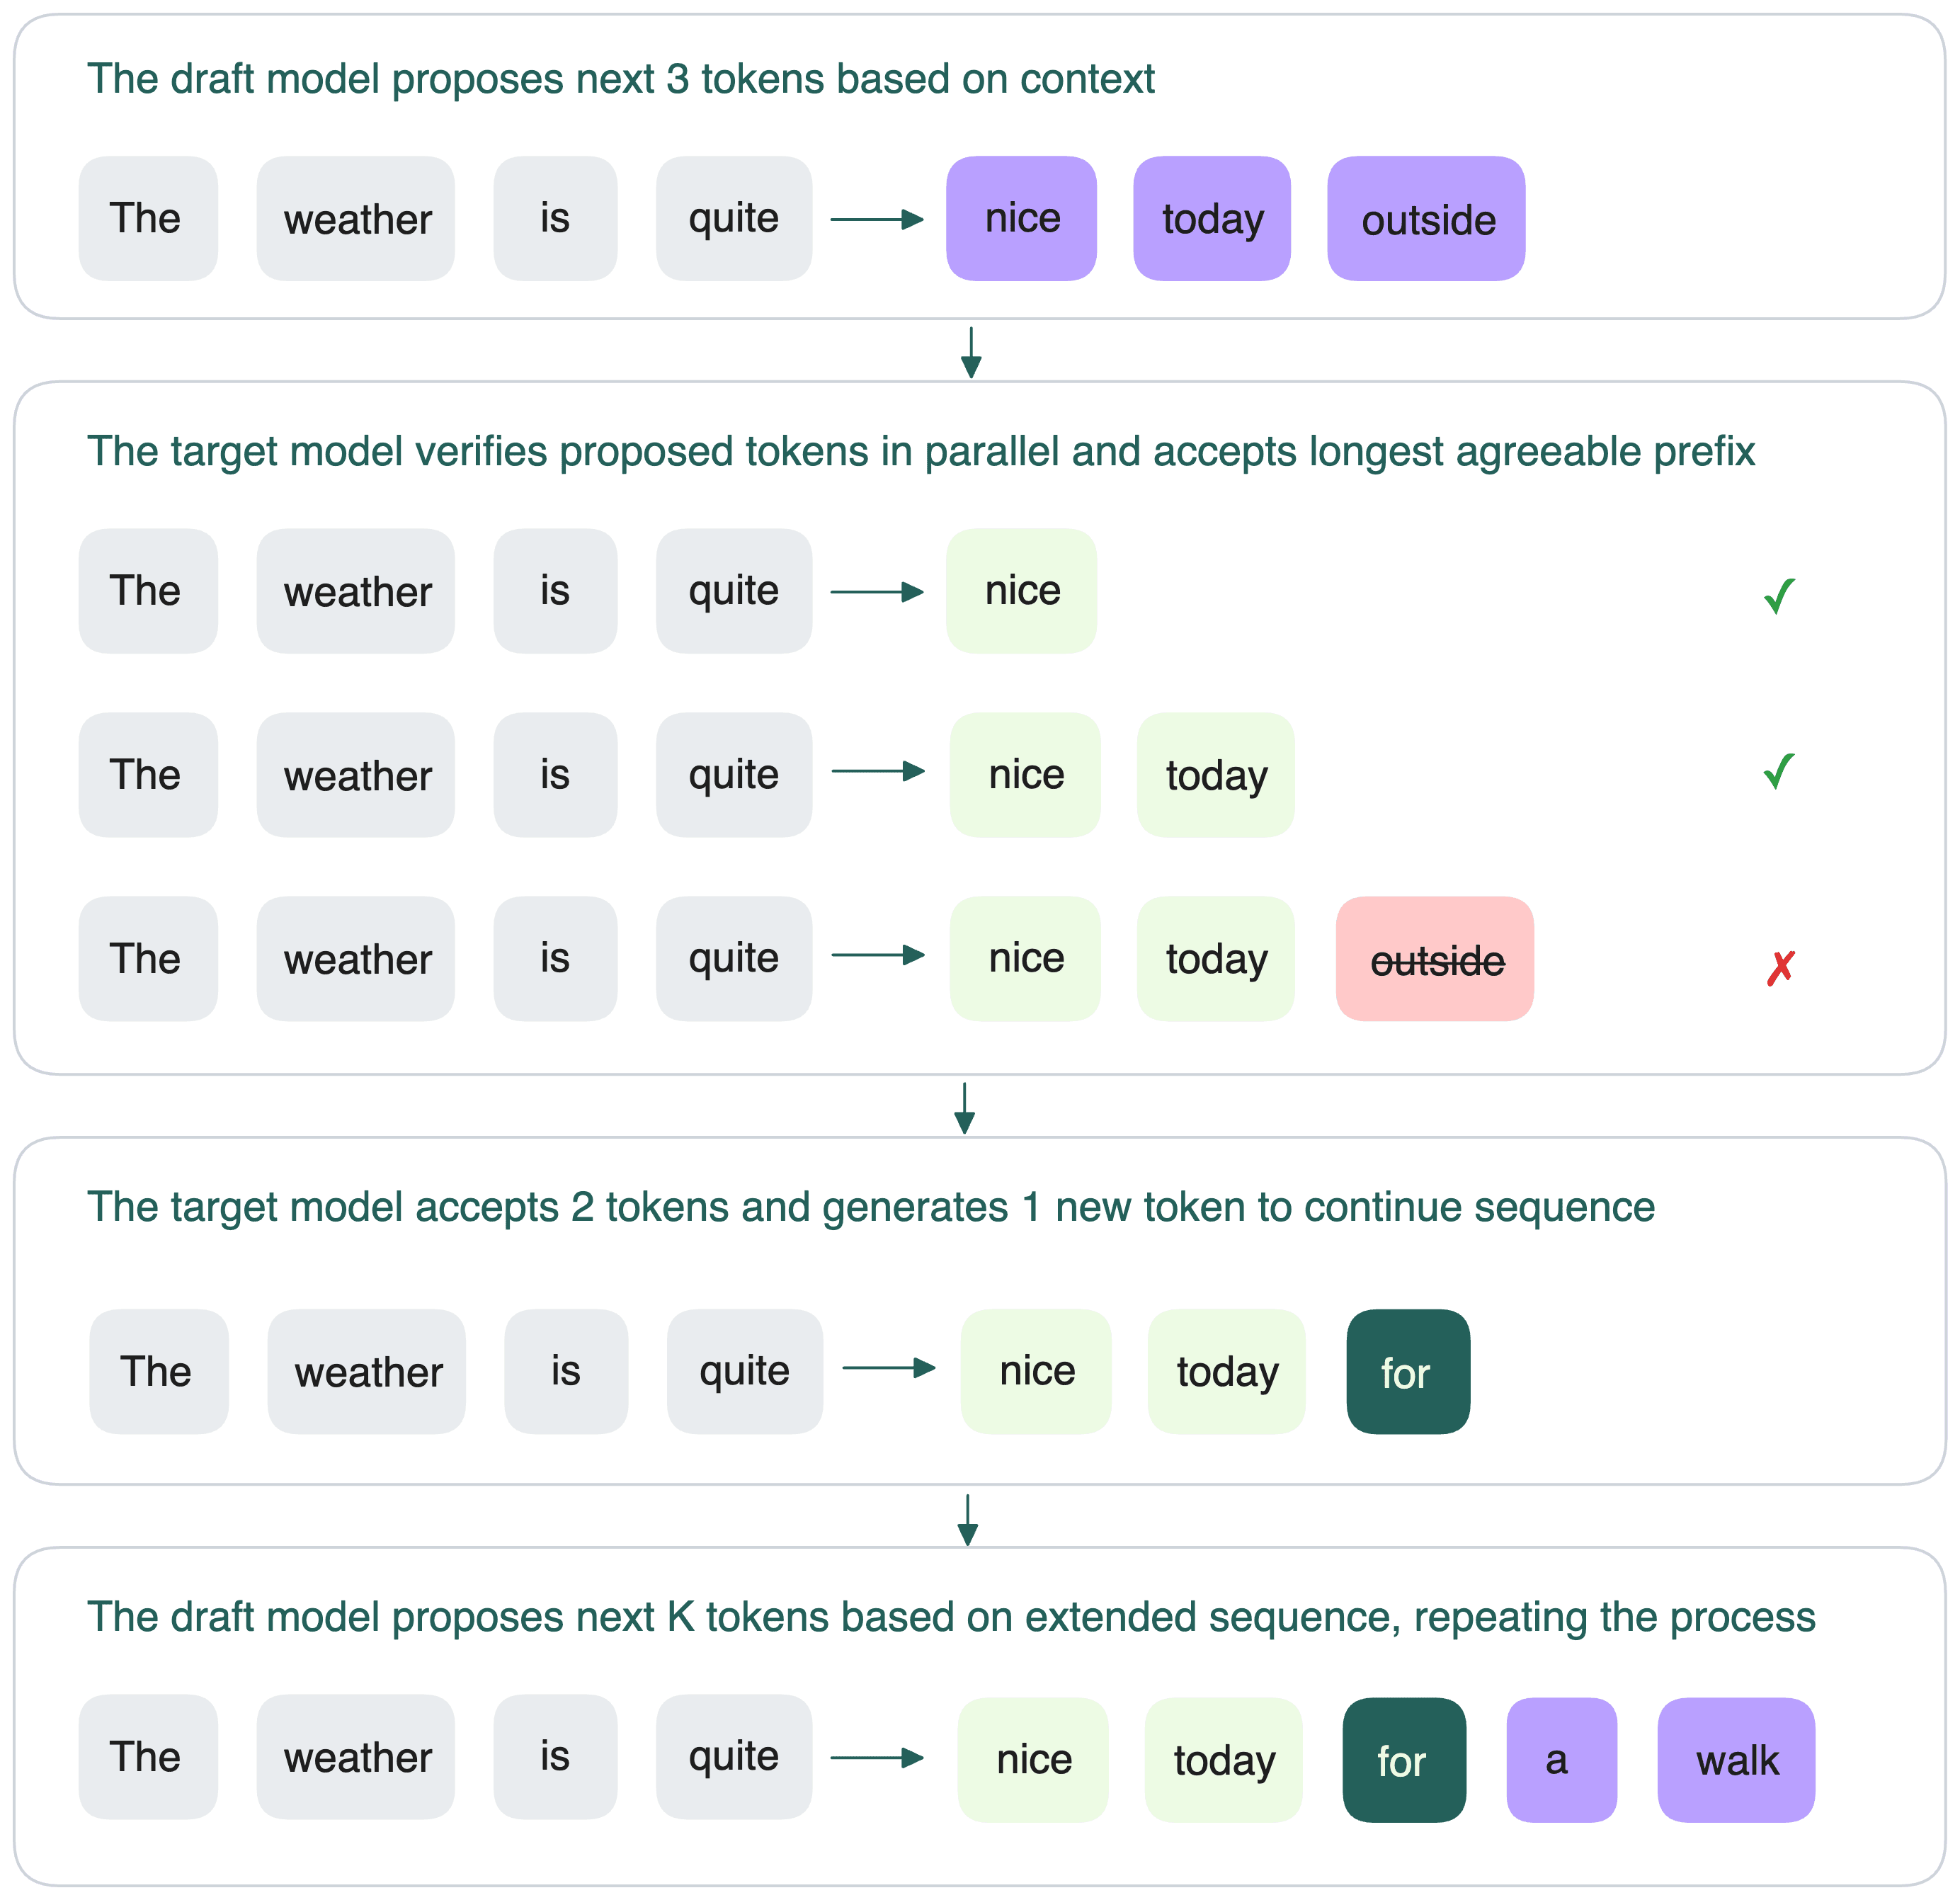
Get 3× Faster LLM Inference with Speculative Decoding Using the Right ...
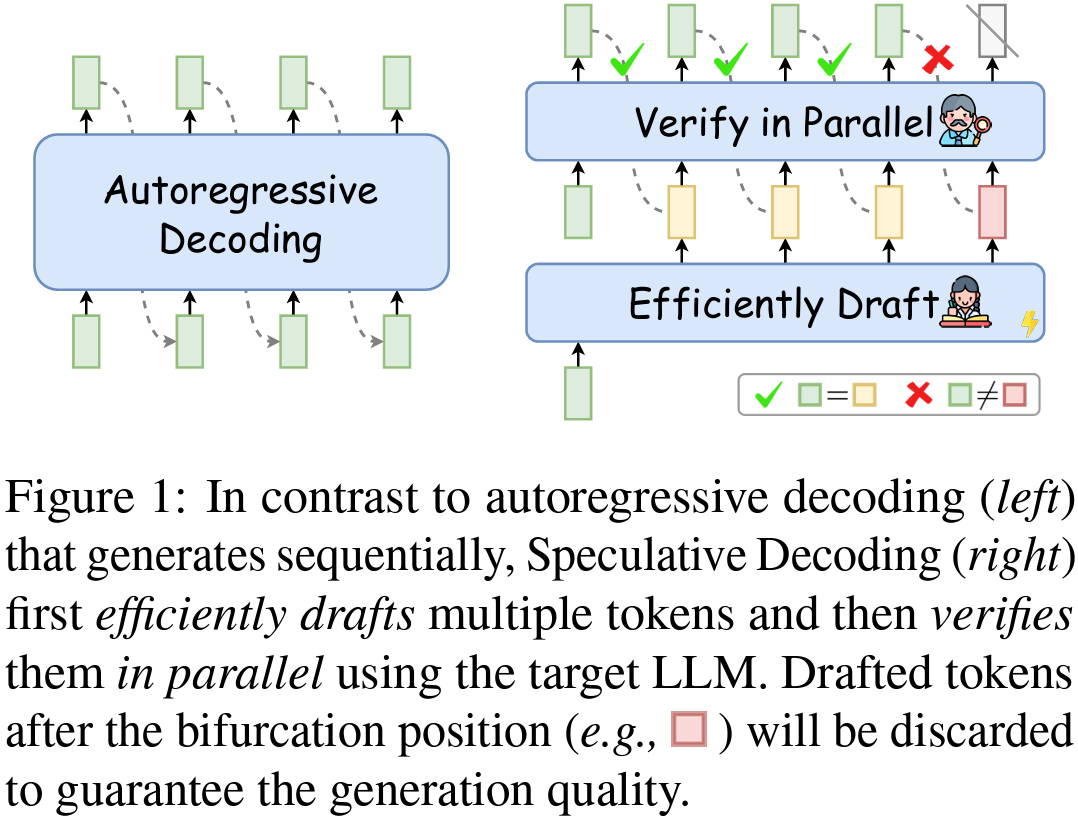
This AI Paper Unveils the Potential of Speculative Decoding for Faster ...

Faster inference with vLLM & speculative decoding | Red Hat Developer

Speculative Decoding: How AI Replies Faster Without Losing Quality | by ...

NeurIPS Speculative Diffusion Decoding for Accelerated Language Generation
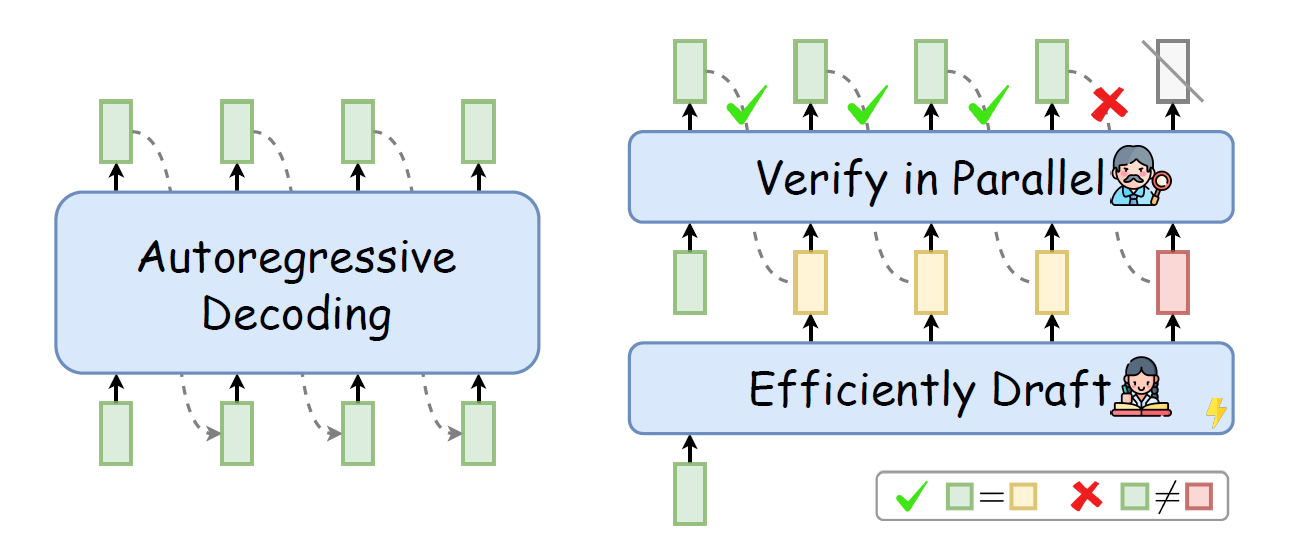
Decoding From Language Models | TensorTunes

[论文评述] SpecVLM: Fast Speculative Decoding in Vision-Language Models

Paper page - Optimizing Speculative Decoding for Serving Large Language ...

Faster Than Thought: How Speculative Decoding Speeds Up AI | by Rishabh ...

Paper page - SpecVLM: Fast Speculative Decoding in Vision-Language Models
Advertisement Space (336x280)

(PDF) Accelerating Large Language Model Decoding with Speculative Sampling

Dynamic Depth Decoding: Faster Speculative Decoding for LLMs | AI ...

Speculative Decoding: Get 14-17% Faster LLM Inference Without Changing ...

Speculative Decoding via Early-exiting for Faster LLM Inference with ...

This AI Paper Unveils the Potential of Speculative Decoding for Faster ...

(PDF) Accelerating Large Language Model Decoding with Speculative Sampling

Accelerating Large Language Model Decoding with Speculative Sampling
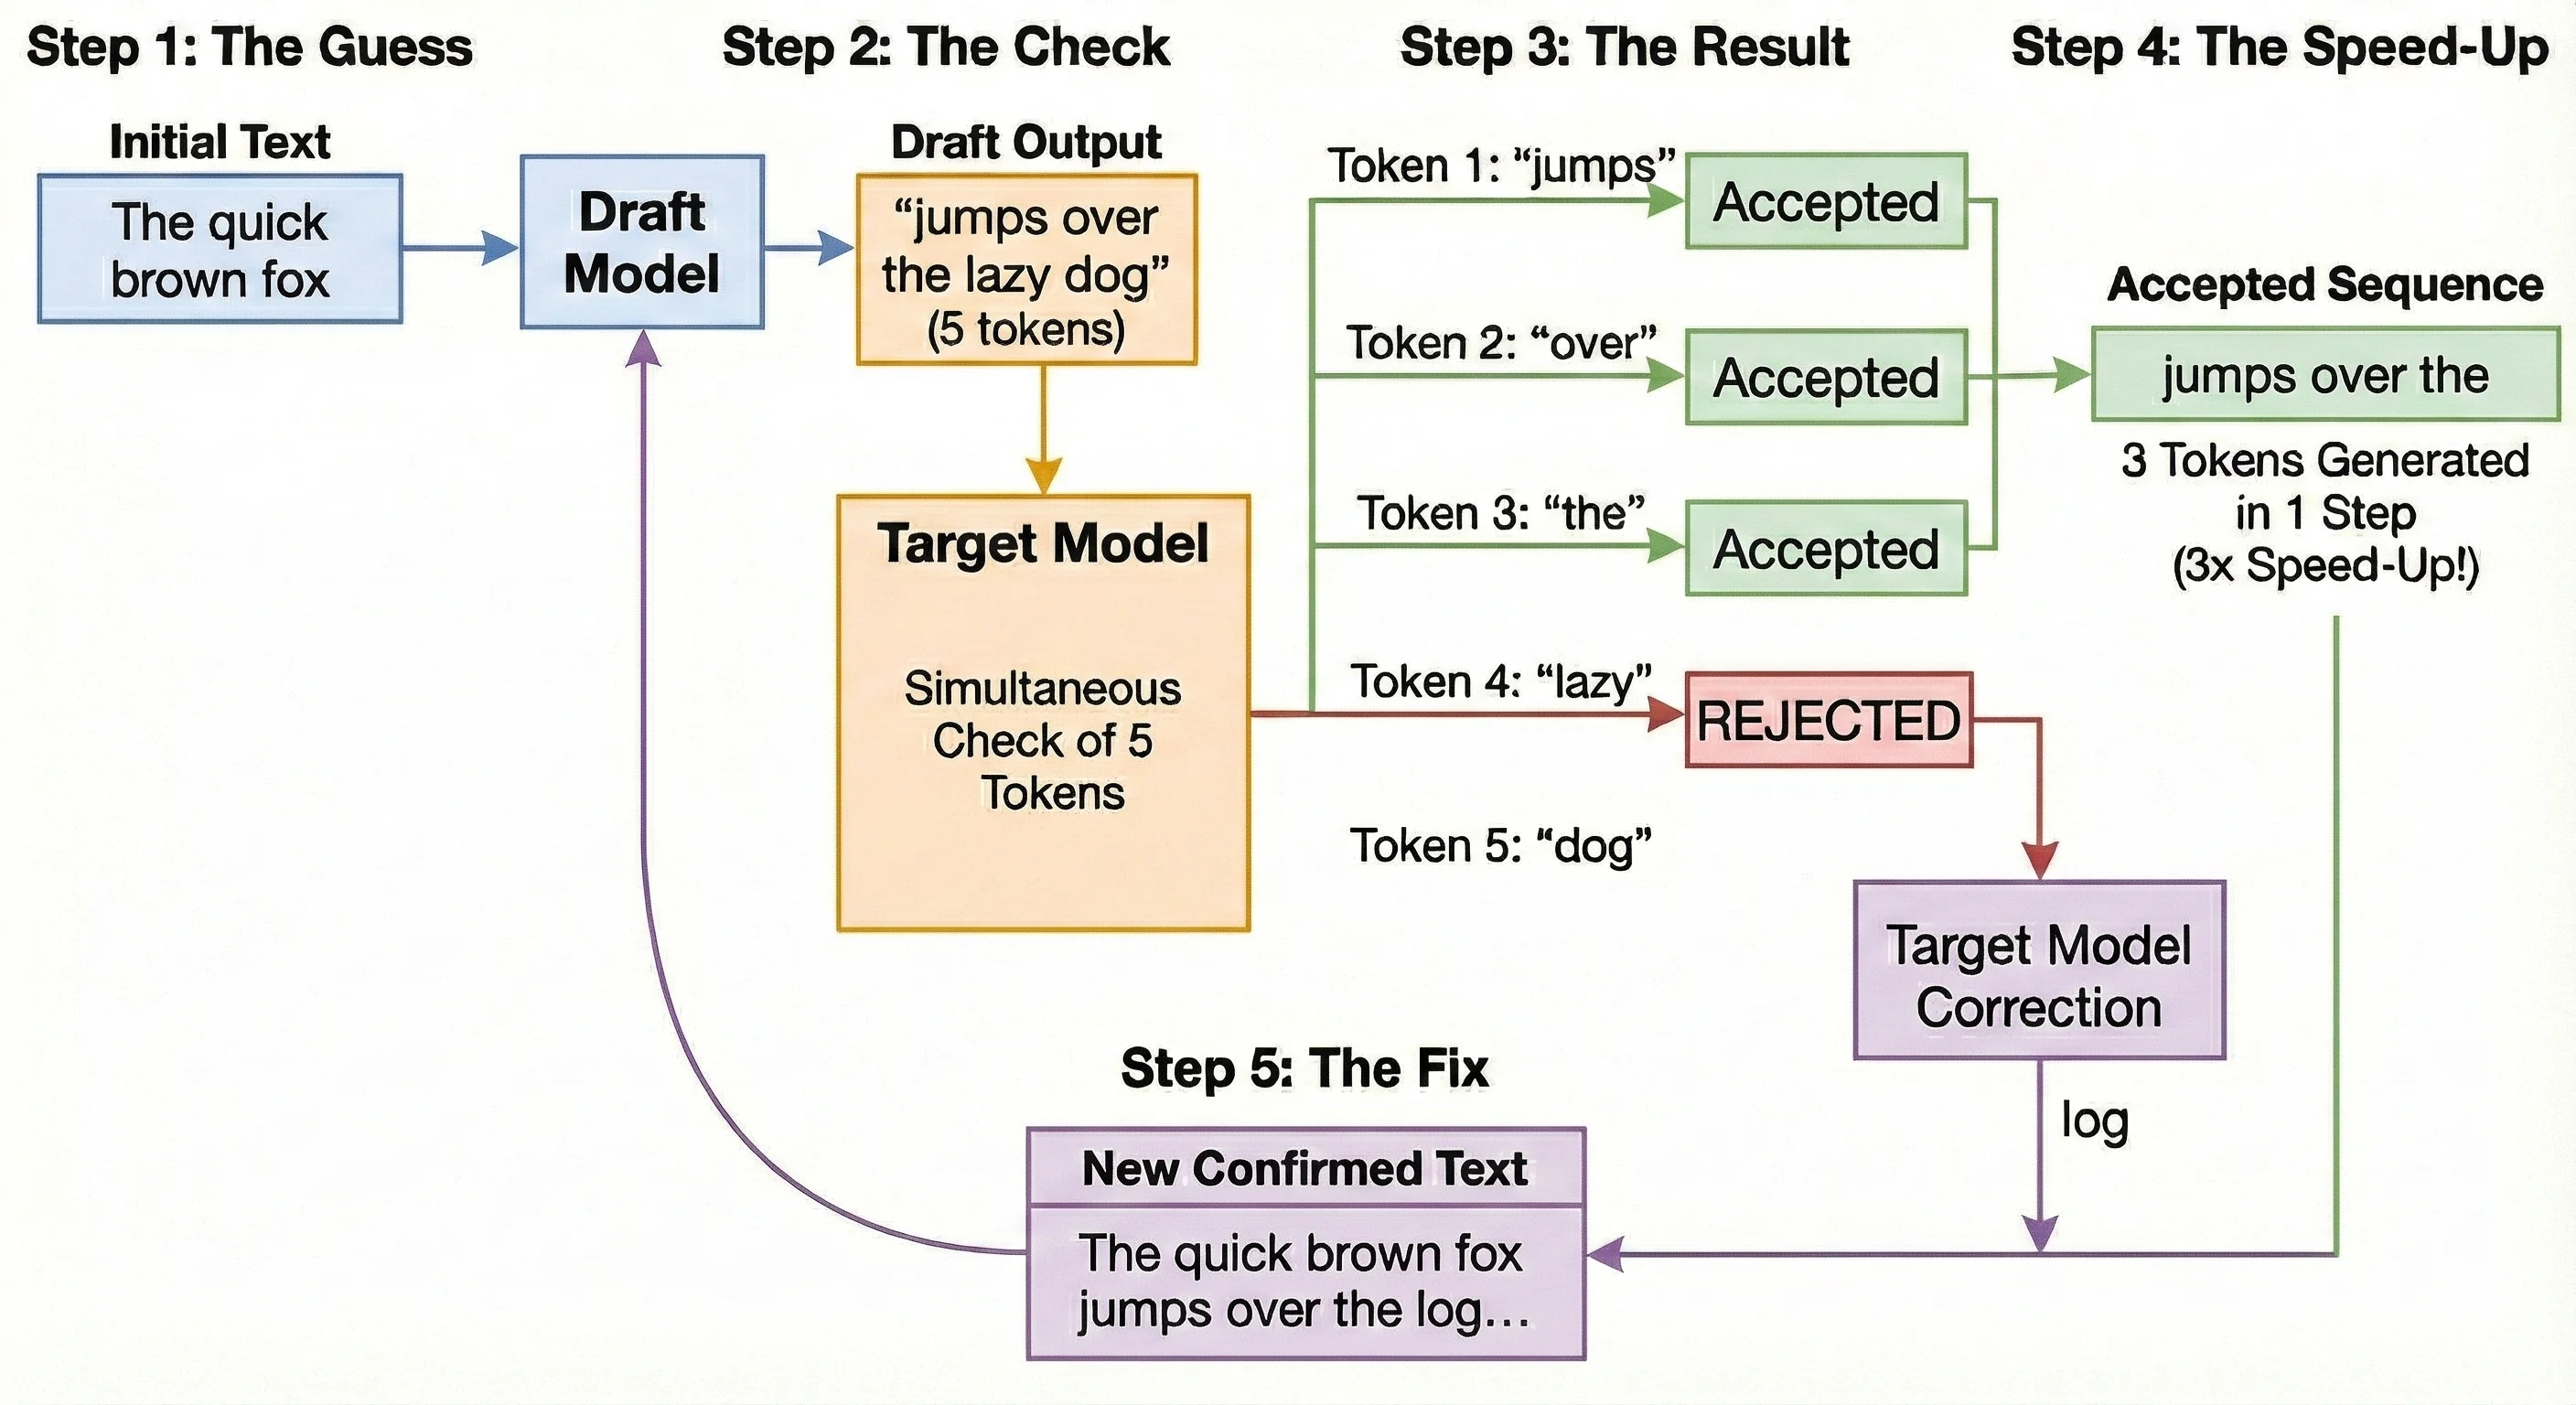
Speculative Decoding in vLLM: Complete Guide to Faster LLM Inference ...
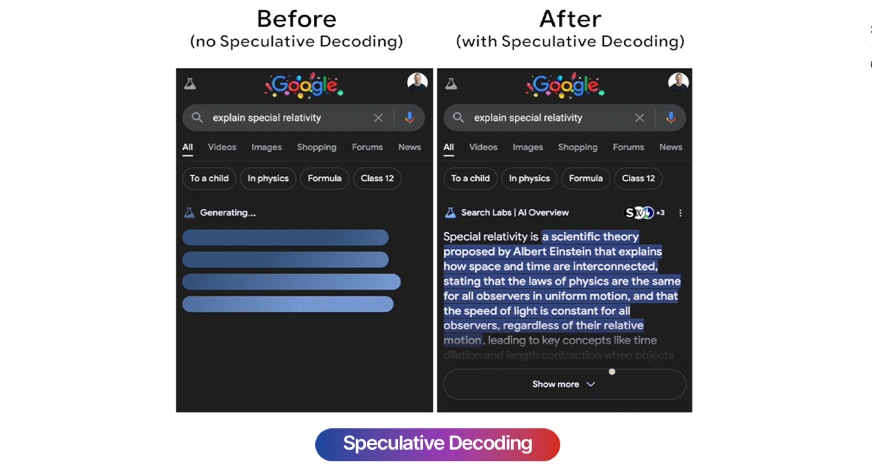
Speculative Decoding: How LLMs Generate Text 3x Faster

Accelerating Large Language Model Decoding with Speculative Sampling ...
Advertisement Space (336x280)

Graph-Structured Speculative Decoding | AI Research Paper Details
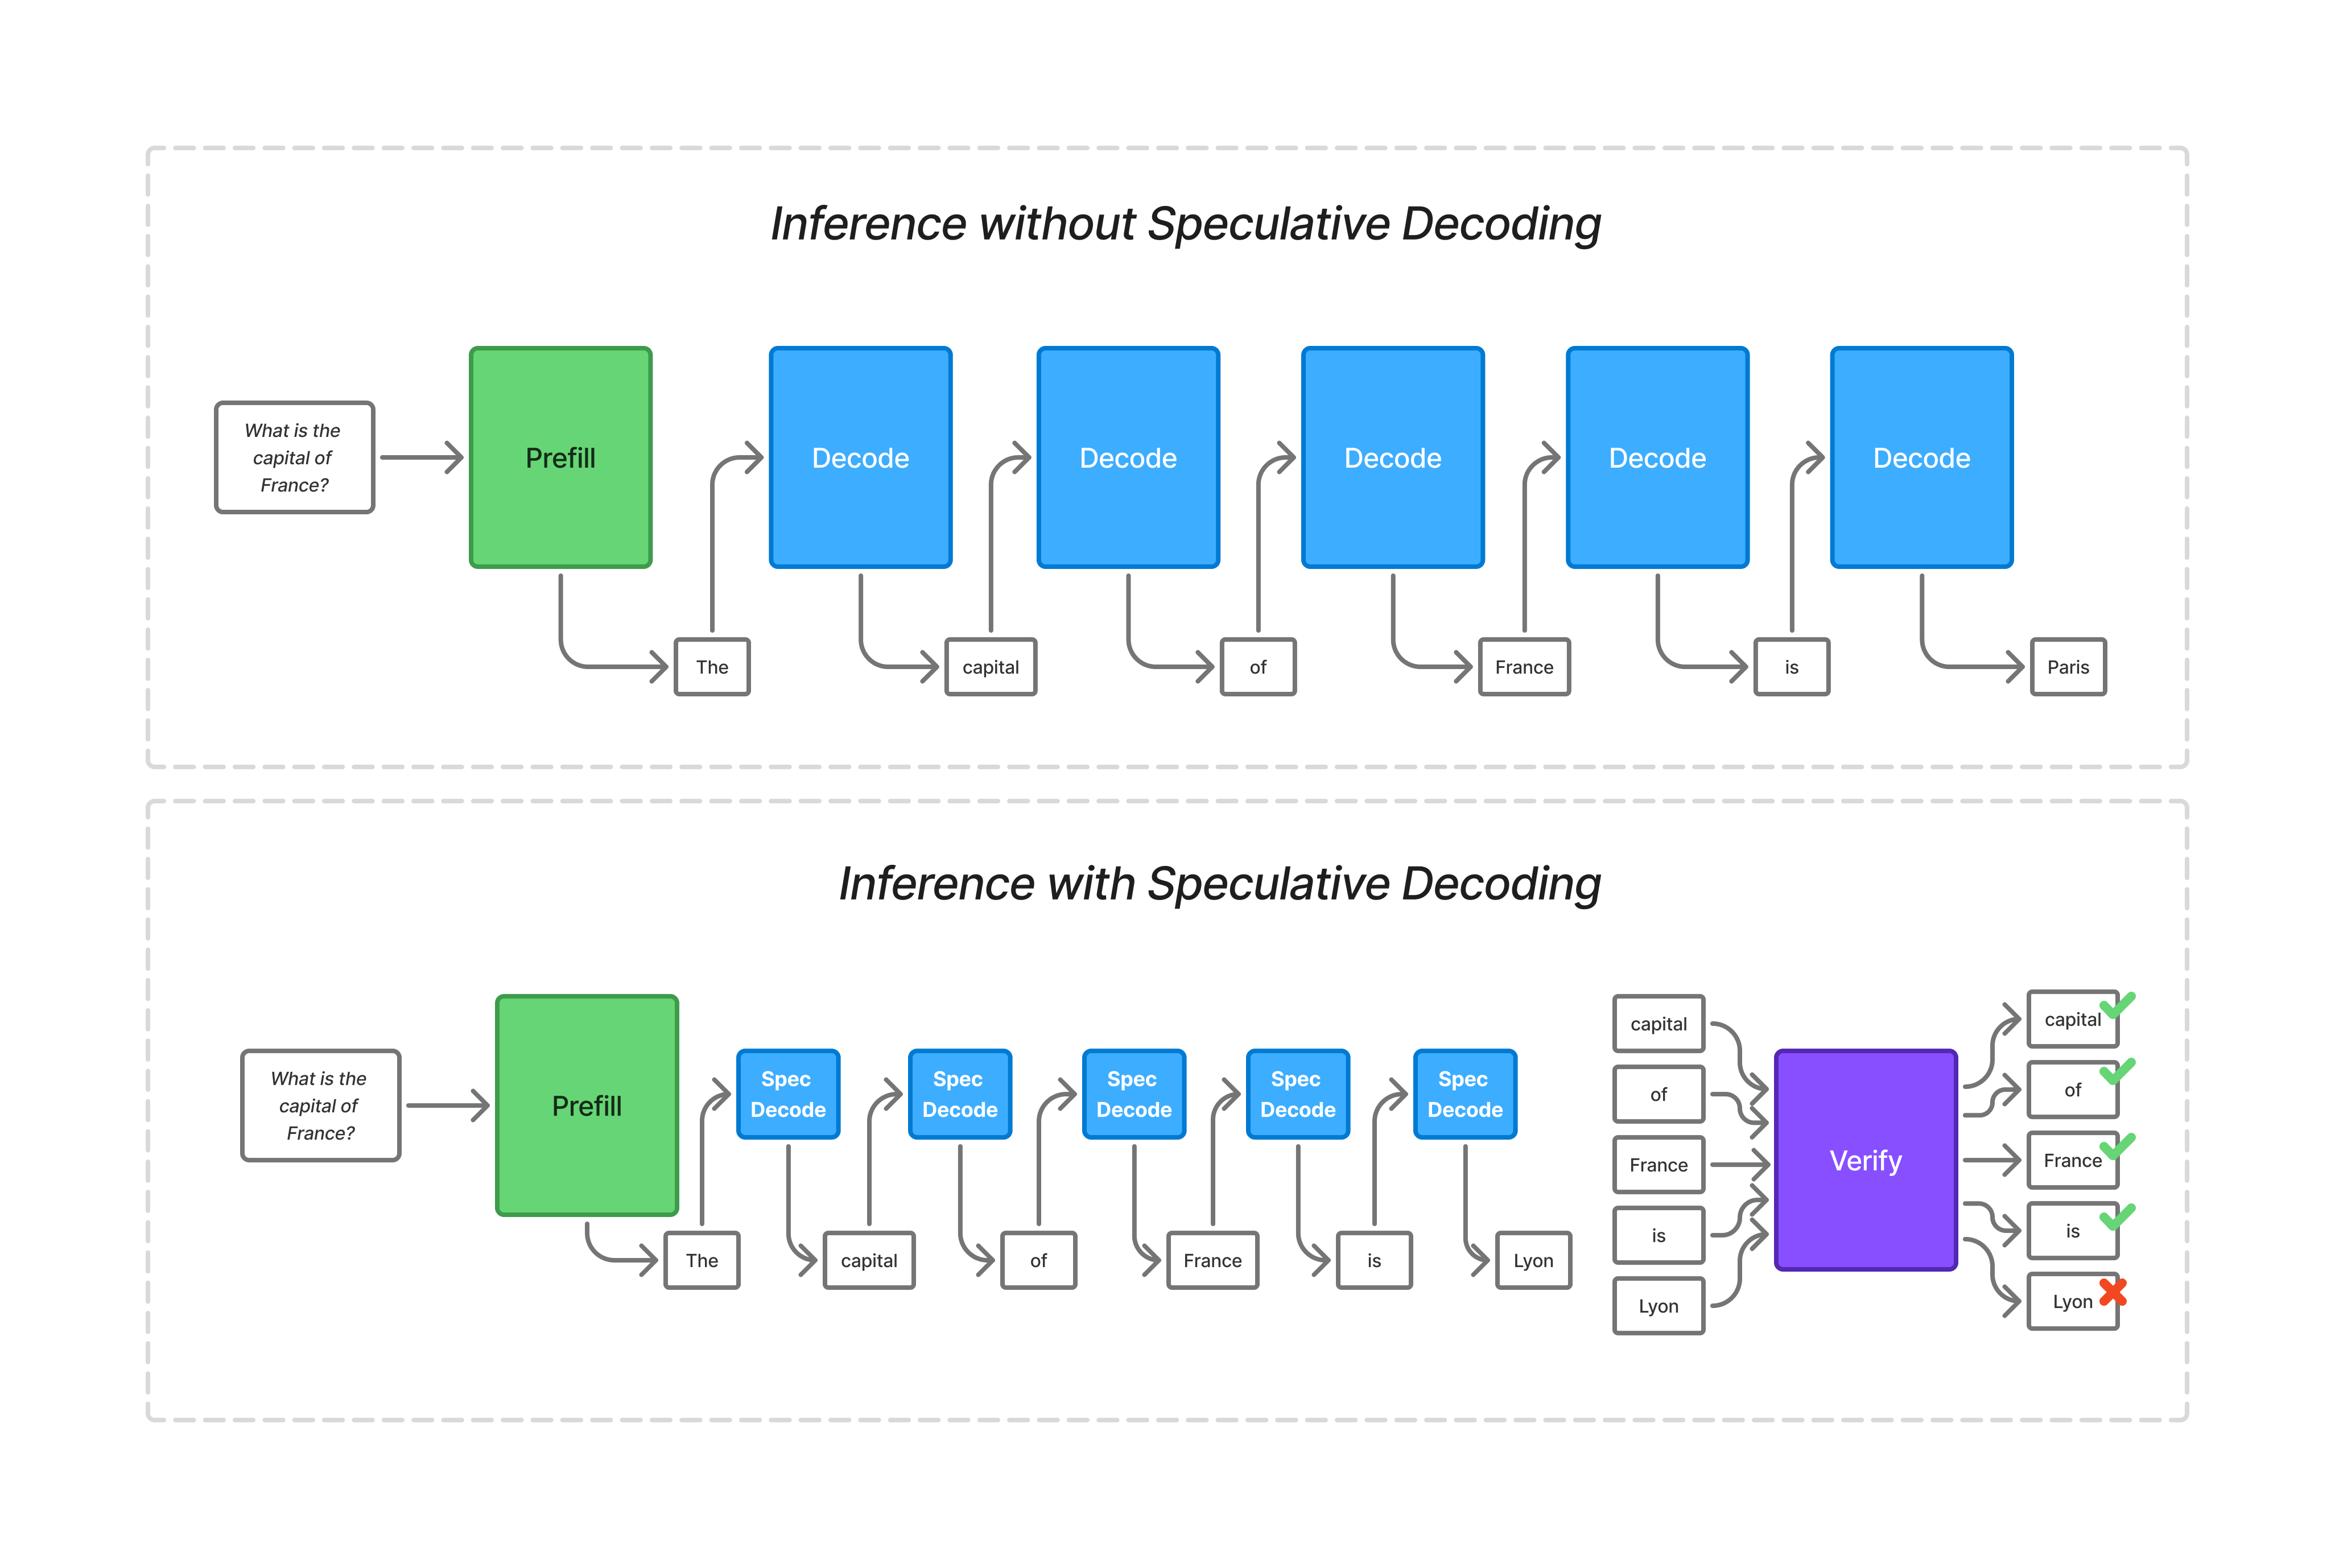
Low-Latency Inference with Speculative Decoding on d-Matrix Corsair and ...

Speculative Decoding: Unlocking Faster Inference in Transformers
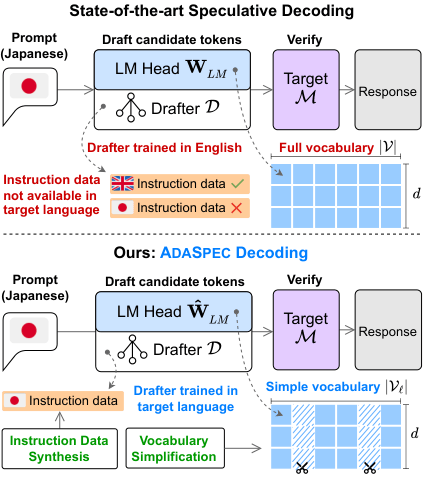
Nguyen Lab's Speculative Decoding Research Group

Boosting LLM Inference Speed Using Speculative Decoding | Towards Data ...

The Machine Learning Practitioner’s Guide to Speculative Decoding ...