
Splitwise Optimizing Llm Inference Pdf Graphics Processing Unit

Splitwise: Optimizing LLM Inference | PDF | Graphics Processing Unit ...

Optimizing LLM Inference with Sarathi-Serve | PDF | Graphics Processing ...

LLM Inference Sizing and Benchmarking | PDF | Graphics Processing Unit ...

Speeding Up LLM Inference Techniques | PDF | Graphics Processing Unit ...

Local LLM Inference and Fine-Tuning | PDF | Graphics Processing Unit ...

ExeGPT: Optimizing LLM Inference Scheduling | PDF | Graphics Processing ...

Energy Efficiency in LLM Inference | PDF | Graphics Processing Unit ...

Fast On-Device LLM Inference with NPUs | PDF | Graphics Processing Unit ...
Optimizing Cloud Inference Workloads | PDF | Graphics Processing Unit ...

2024LLM Inference Bench ArXiv | PDF | Graphics Processing Unit ...
Advertisement Space (300x250)

SLO-Aware GPU DVFS for LLM Efficiency | PDF | Graphics Processing Unit ...

BatchLLM: Optimizing LLM Inference | PDF | Cache (Computing) | Graphics ...

Optimizing 70B Model Inference on RTX 4090 | PDF | Graphics Processing ...

Networking 4 Inference | PDF | Graphics Processing Unit | Parallel ...

Optimize LLM Training & Inference Efficiency | PDF | Graphics ...

Fast Scaling for LLM Inference | PDF | Scalability | Graphics ...

Julien Simon - Deep Dive - Optimizing LLM Inference | PDF
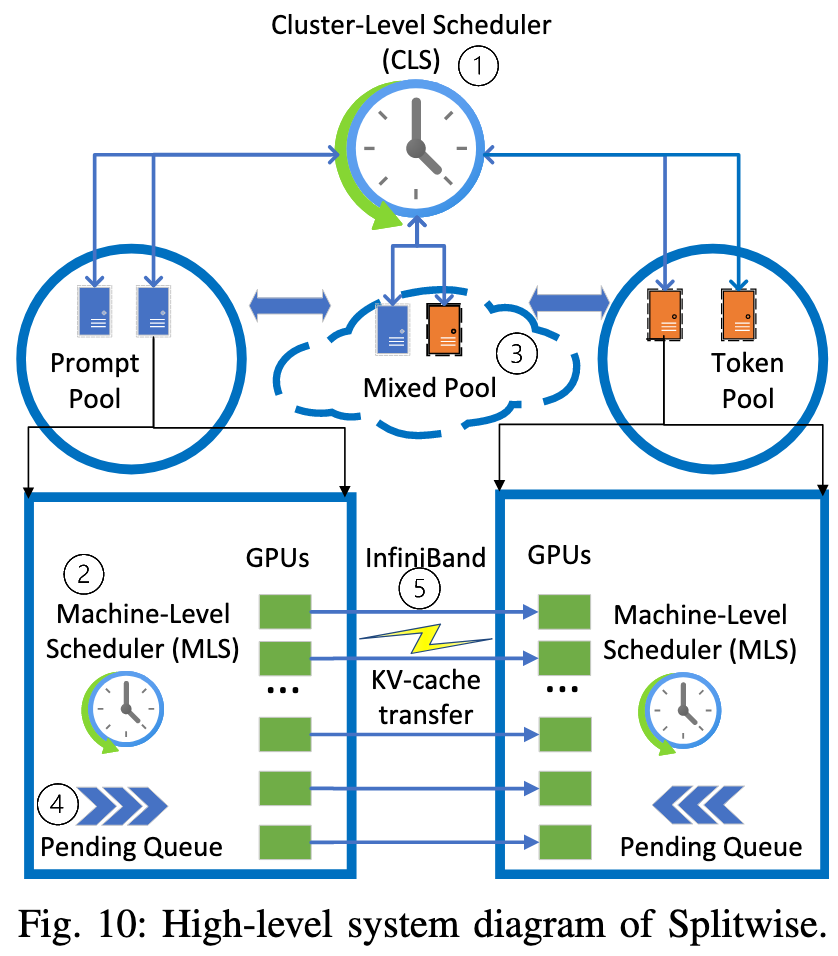
Splitwise Efficient Generative LLM Inference Using Phase Splitting ...

(PDF) Characterizing and Optimizing LLM Inference Workloads on CPU-GPU ...

Deep Dive Into LLM Inference Optimization Techniques | PDF | Cache ...
Advertisement Space (336x280)

High-Throughput LLM Inference Optimization | PDF | Parallel Computing ...

Tereffic: Highly Efficient Ternary LLM Inference On Fpga | PDF | Field ...

NeuPIMs: Accelerating LLM Inference | PDF | Parallel Computing ...

Energy-Efficient LLM Inference Strategies | PDF | Parallel Computing ...

Splitwise improves GPU usage by splitting LLM inference phases ...
LLM Inference Optimization by Chip Huyen | PDF
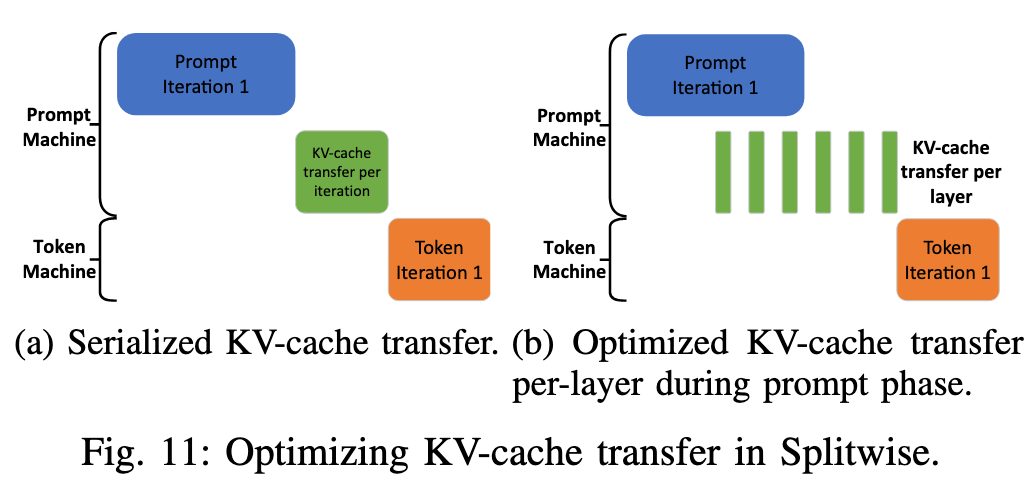
Splitwise Efficient Generative LLM Inference Using Phase Splitting ...

Optimizing LLM Training on Frontier | PDF | Parallel Computing ...
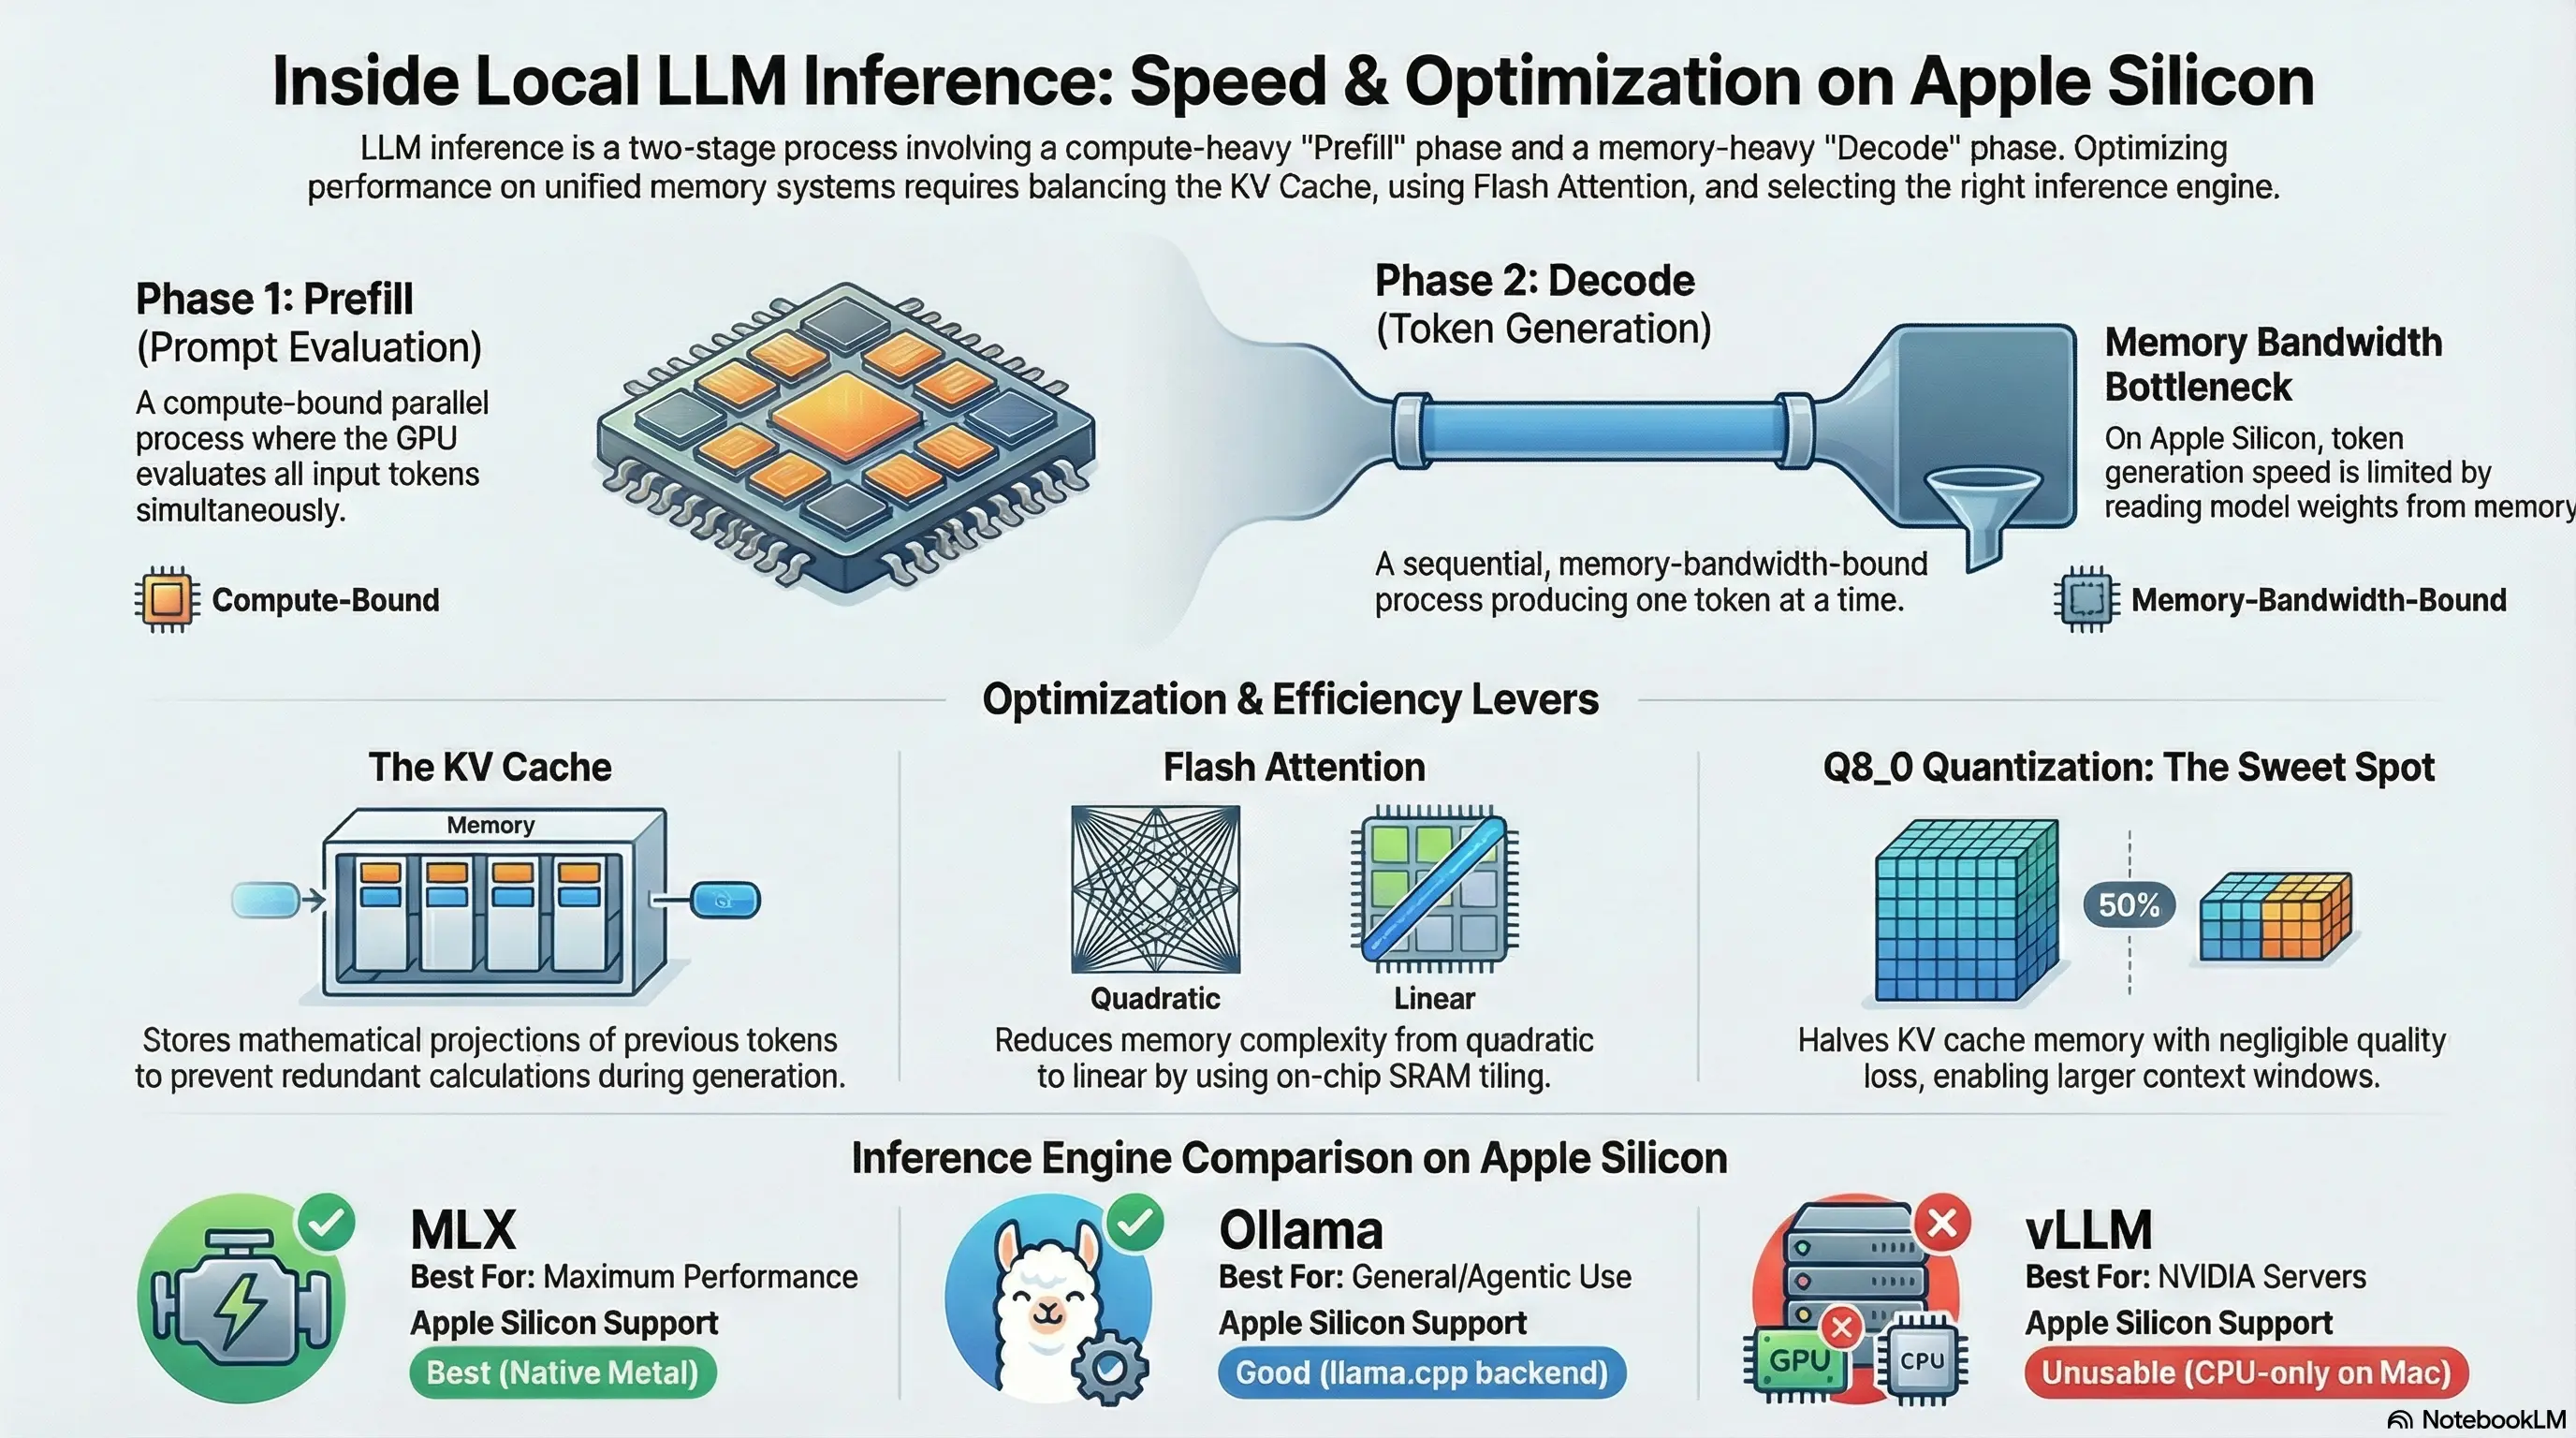
LLM Inference Internals: KV Cache, Flash Attention, and Optimizing for ...
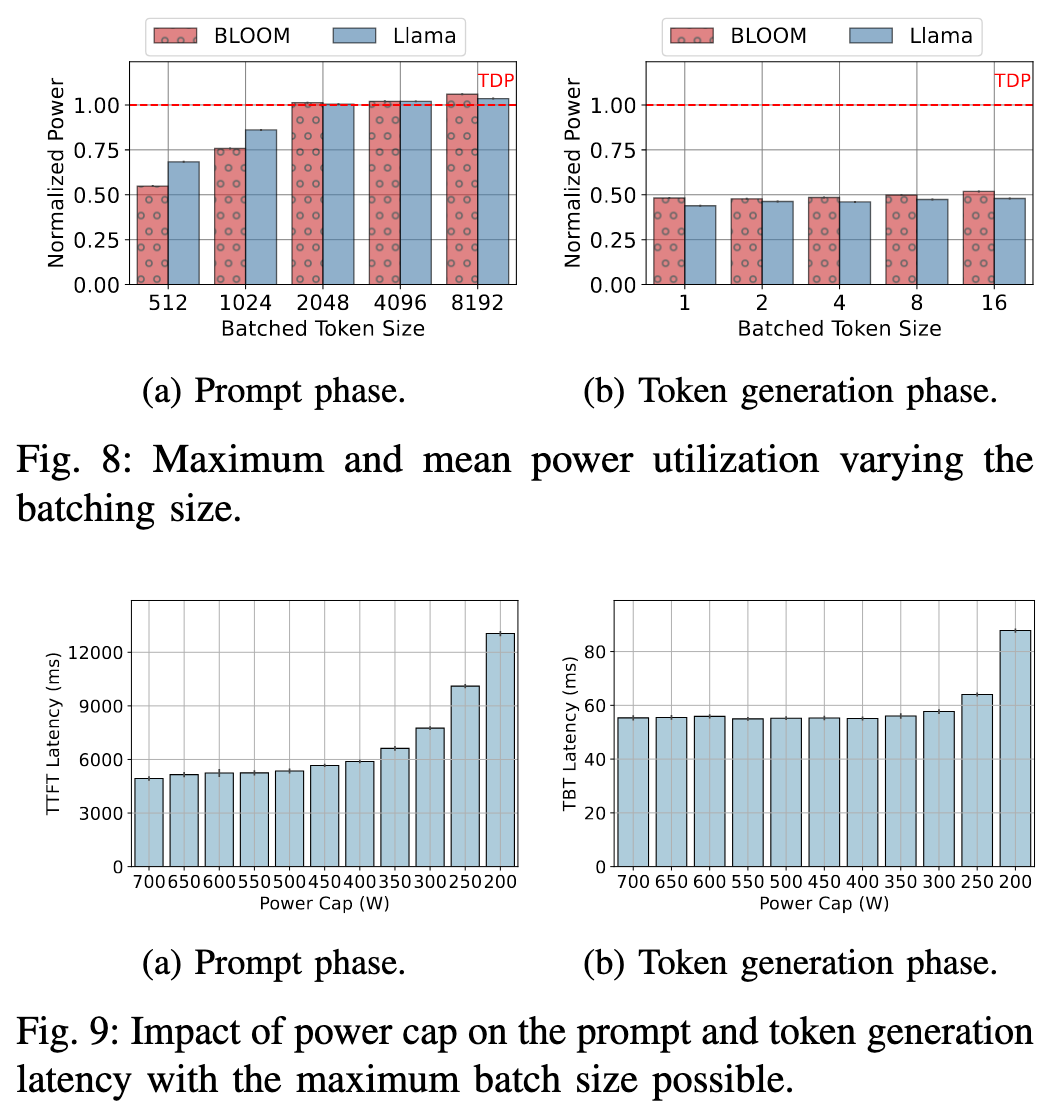
Splitwise Efficient Generative LLM Inference Using Phase Splitting ...
Advertisement Space (336x280)
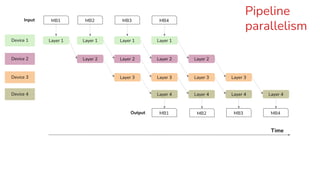
LLM Inference Optimization by Chip Huyen | PDF
LLM Inference Optimization by Chip Huyen | PDF
Optimizing LLM Inference Techniques by Gogo Work on Prezi

Splitwise improves GPU usage by splitting LLM inference phases ...

Optimizing AI Inference on GPUs | PDF | Deep Learning | Program ...
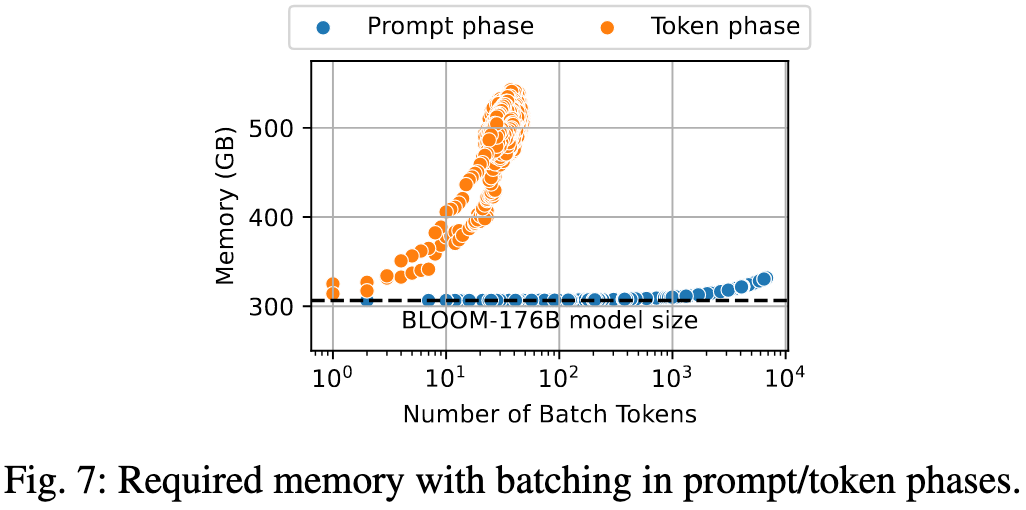
Splitwise Efficient Generative LLM Inference Using Phase Splitting ...