
Support Usecachefalse Issue 1422 Nvidiatensorrt Llm Github
Support use_cache=False · Issue #1422 · NVIDIA/TensorRT-LLM · GitHub
Support ChatGLM3 · Issue #270 · NVIDIA/TensorRT-LLM · GitHub
Support for `frequency_penalty` · Issue #275 · NVIDIA/TensorRT-LLM · GitHub
tensorrt 9.2 for Tensorrt llm 0.6? · Issue #3514 · NVIDIA/TensorRT · GitHub
TensorRT LLM Docker Issues · Issue #499 · NVIDIA/TensorRT-LLM · GitHub
support Qwen2-VL · Issue #2183 · NVIDIA/TensorRT-LLM · GitHub
LLM in TTS · Issue #2342 · NVIDIA/TensorRT-LLM · GitHub
support on V100 GPU · Issue #348 · NVIDIA/TensorRT-LLM · GitHub
Failed to run batch inference · Issue #42 · NVIDIA/TensorRT-LLM · GitHub
tensorrt_llm Import error · Issue #1408 · NVIDIA/TensorRT-LLM · GitHub
Advertisement Space (300x250)
bug: chatglm2-6b does not support build with tensor parallel · Issue ...
build_wheel.py error · Issue #2145 · NVIDIA/TensorRT-LLM · GitHub
[Feature]: AutoDeploy: GLM to LLM models for CI · Issue #11317 · NVIDIA ...
API Usage Error · Issue #1015 · NVIDIA/TensorRT-LLM · GitHub
done · Issue #2034 · NVIDIA/TensorRT-LLM · GitHub
Build failures · Issue #32 · NVIDIA/TensorRT-LLM · GitHub
Cache model in GitHub Actions cache · Issue #4 · NVIDIA/sphinx-llm · GitHub
PyTorch Nightly support in Dockerfile · Issue #2657 · NVIDIA/TensorRT ...
[Question] Support for Async Allreduce? · Issue #1389 · NVIDIA/TensorRT ...
[Feature Request] Support InternLM Model · Issue #86 · NVIDIA/TensorRT ...
Advertisement Space (336x280)
Will the setting "context_fmha" support "cross_attention" ? · Issue ...
pynvml version issue · Issue #2524 · NVIDIA/TensorRT-LLM · GitHub
Speed compare with vllm? · Issue #24 · NVIDIA/TensorRT-LLM · GitHub
llama2-13b build.py oom · Issue #346 · NVIDIA/TensorRT-LLM · GitHub
tensorrt_llm installation issue · Issue #867 · NVIDIA/TensorRT-LLM · GitHub
Unable to install TensorRT-LLM · Issue #2597 · NVIDIA/TensorRT-LLM · GitHub
When will 0.6.0 be released? · Issue #463 · NVIDIA/TensorRT-LLM · GitHub

NVIDIA TensorRT-LLM Roadmap 现已在 GitHub 上公开发布! - NVIDIA 技术博客

NVIDIA TensorRT-LLM Roadmap 现已在 GitHub 上公开发布! - NVIDIA 技术博客

NVIDIA TensorRT-LLM Now Supports Recurrent Drafting for Optimizing LLM ...
Advertisement Space (336x280)
GitHub - NVIDIA/TensorRT-LLM: TensorRT-LLM provides users with an easy ...
GitHub - lloydchang/NVIDIA-TensorRT-LLM: TensorRT-LLM provides users ...
How to use System Prompt Caching in version 0.8.0? · Issue #1426 ...
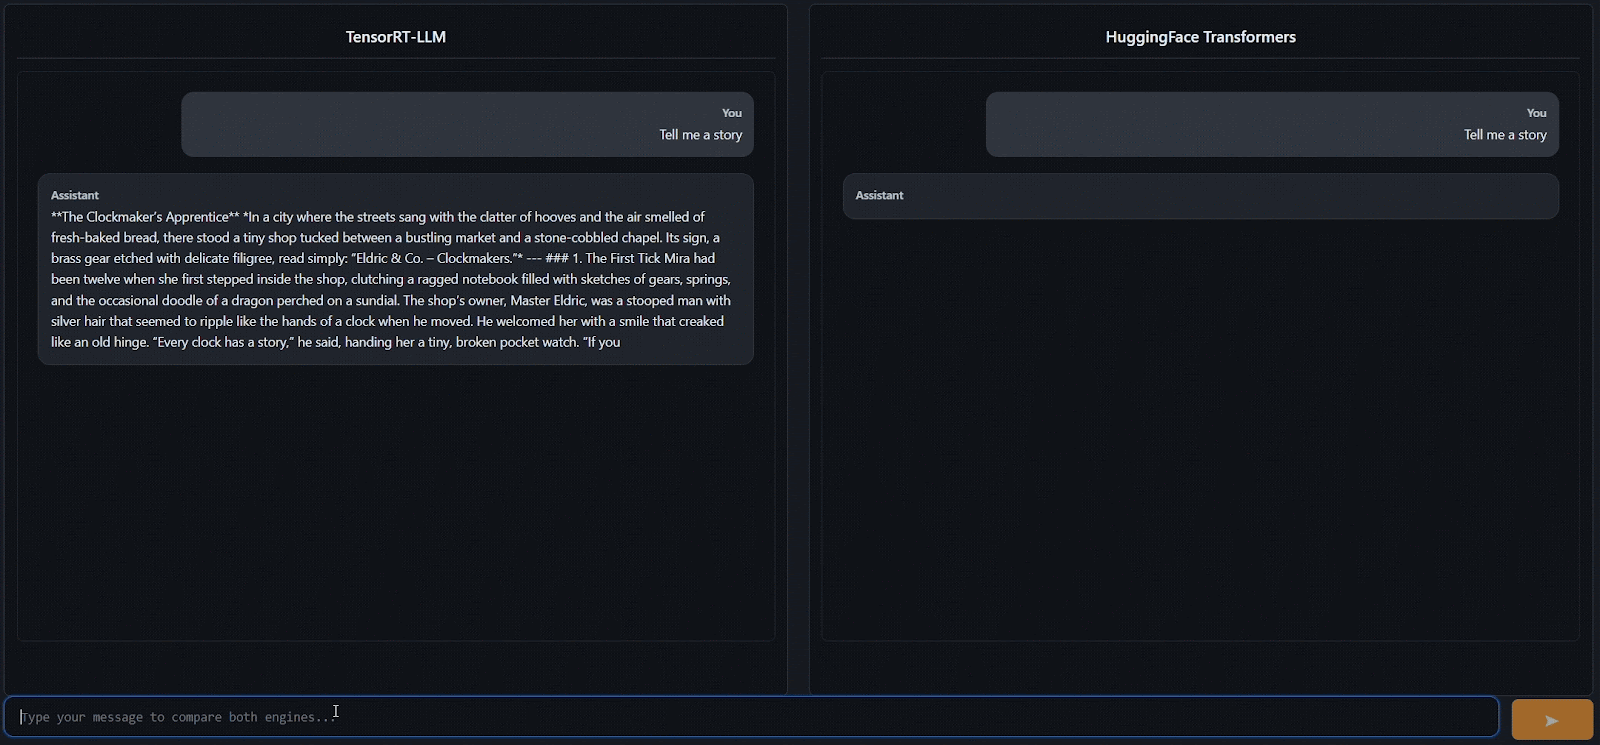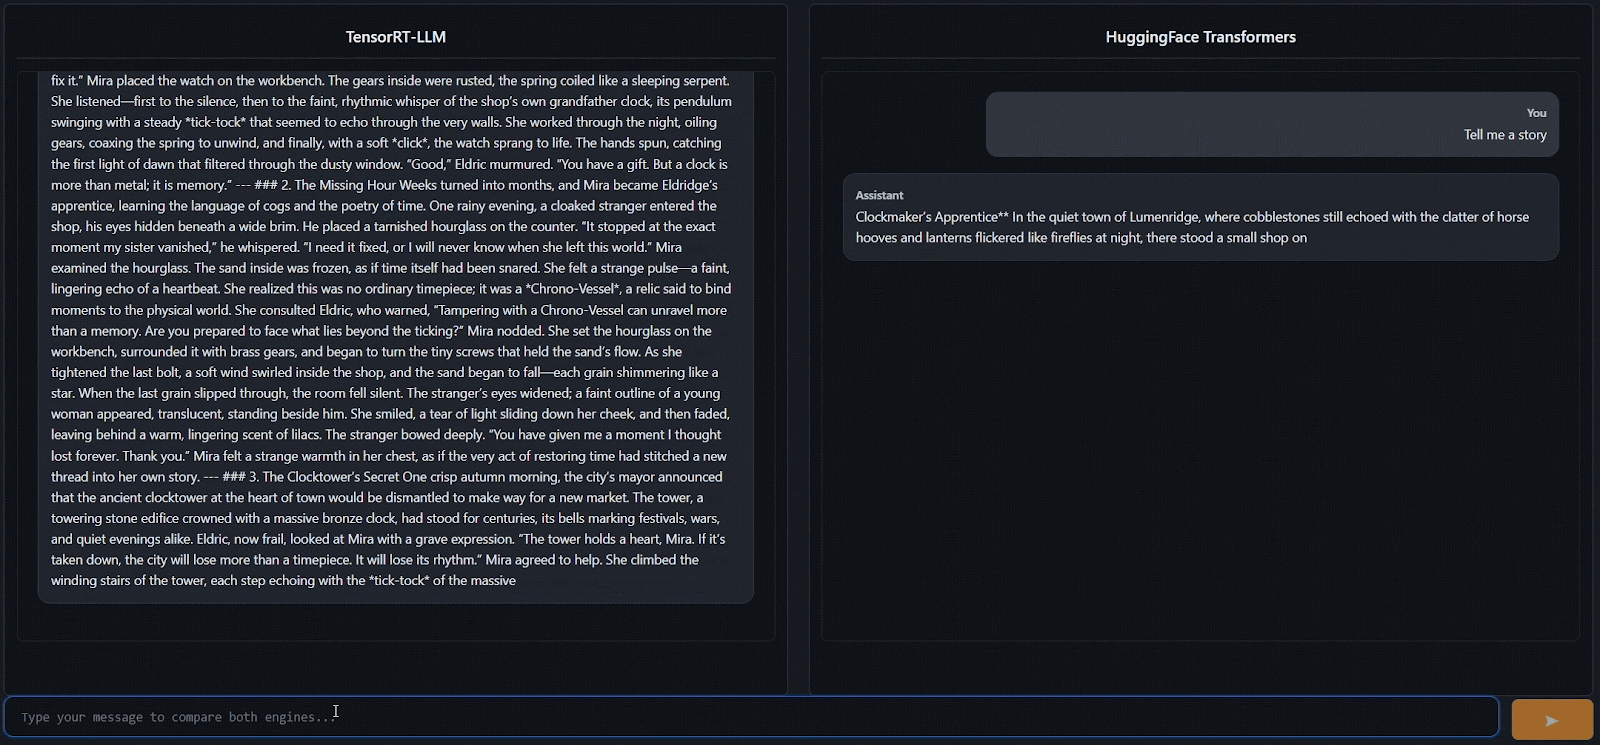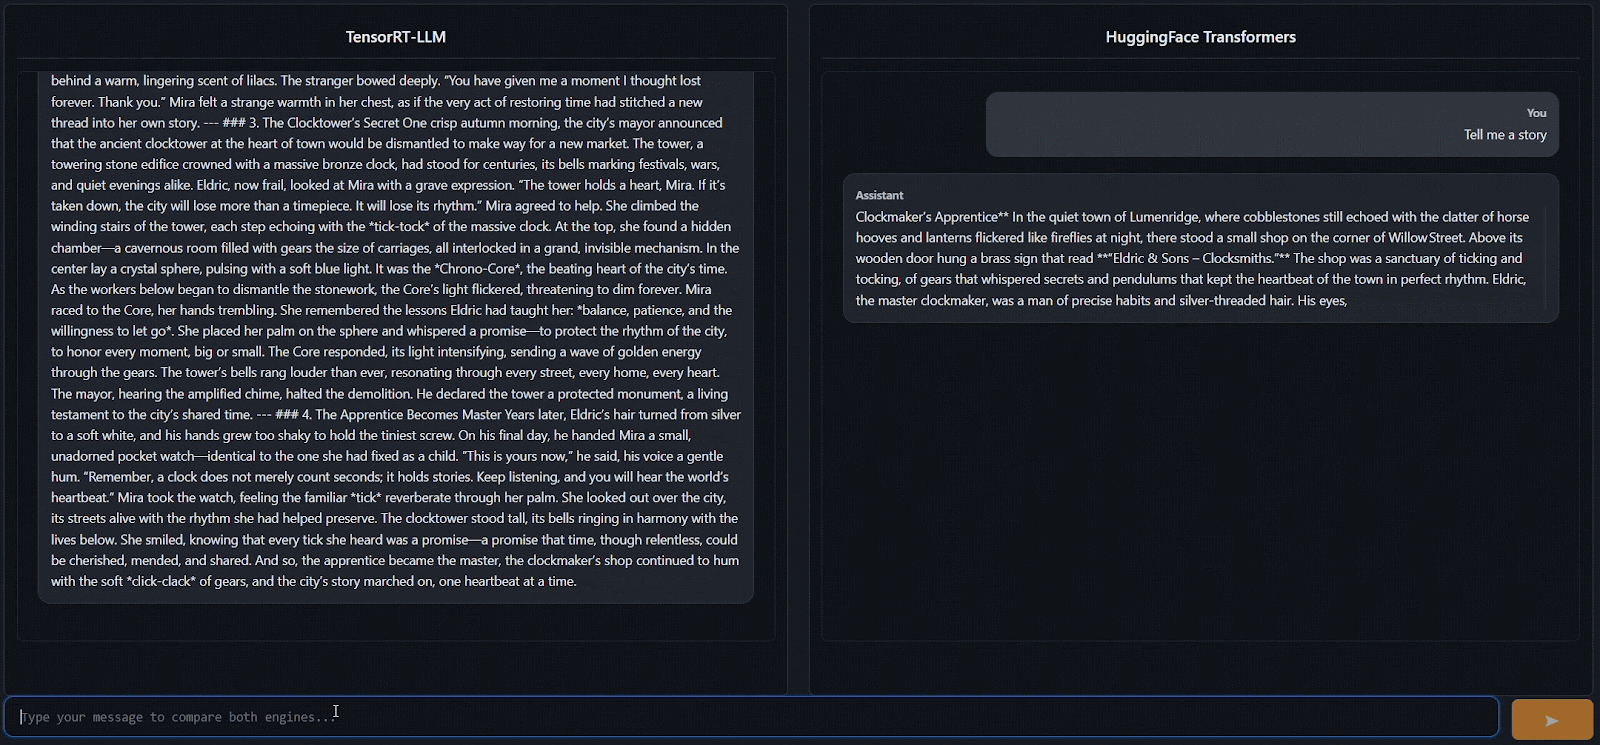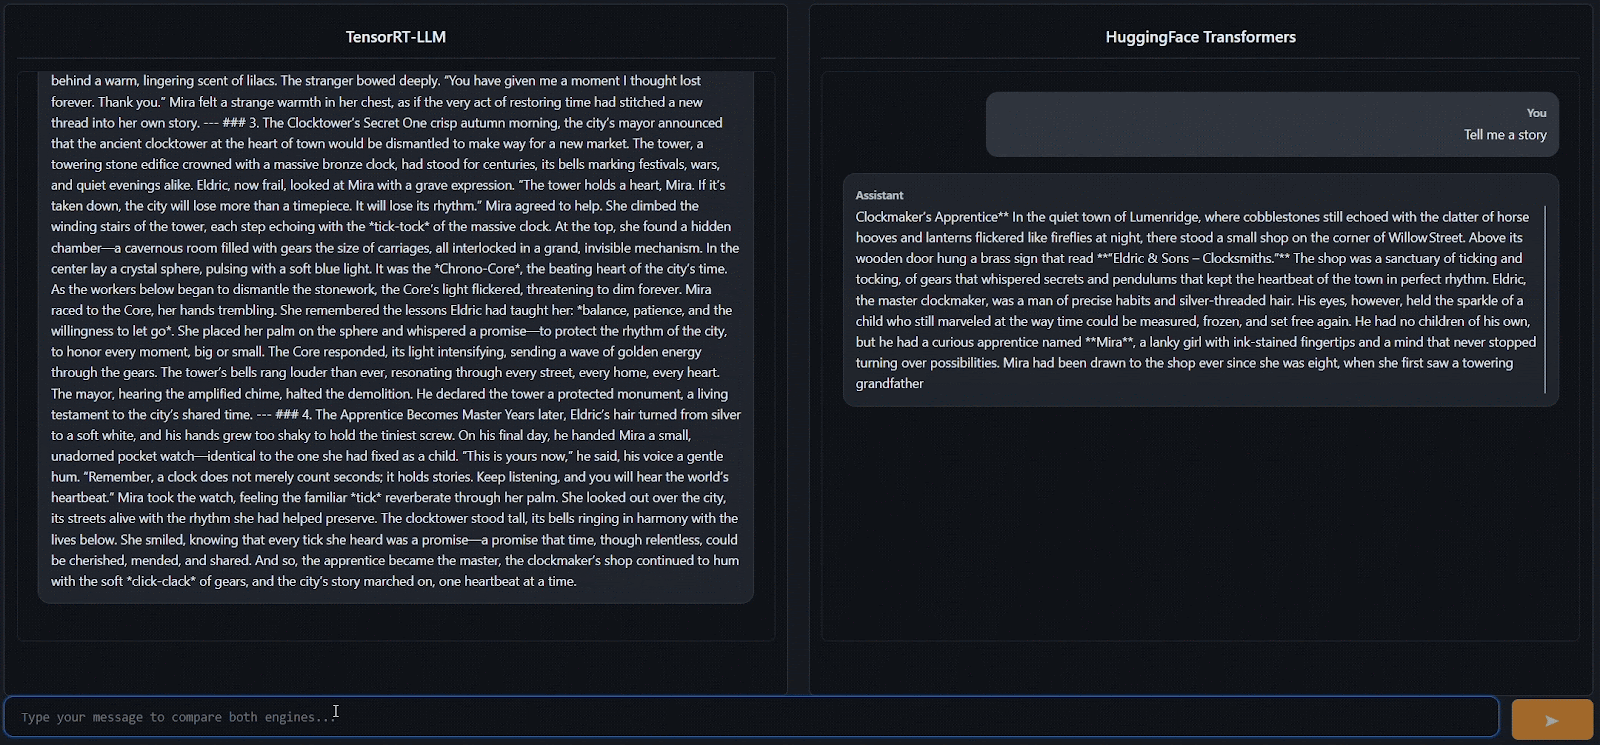
TensorRT LLM | NVIDIA Developer
failed to install tensorrt-llm==0.11.0.dev2024060400 · Issue #1764 ...
Smaller available space for paged KV cache compared with vLLM · Issue ...