
Table 1 From Contextual Cross Modal Attention For Audio Visual Deepfake
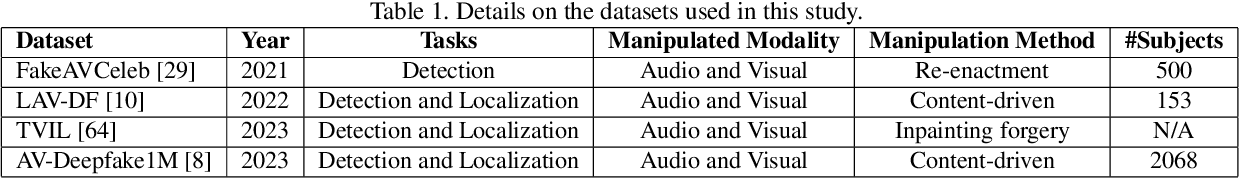
Table 1 from Contextual Cross-Modal Attention for Audio-Visual Deepfake ...

Table 1 from Cross Model Attention based Deep Learning for Multi Modal ...
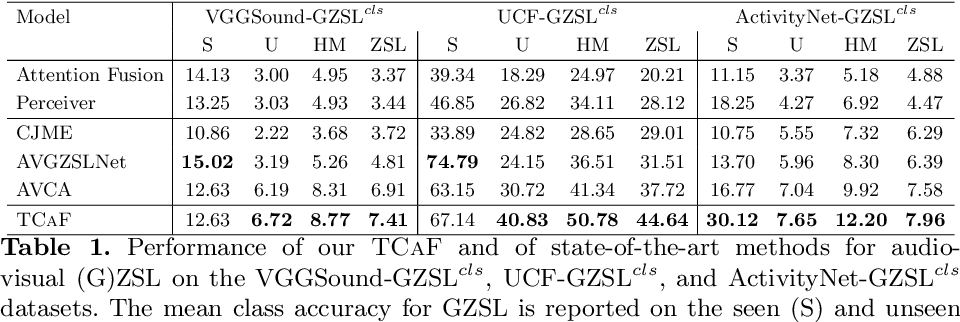
Table 1 from Temporal and cross-modal attention for audio-visual zero ...

Figure 1 from Contextual Cross-Modal Attention for Audio-Visual ...
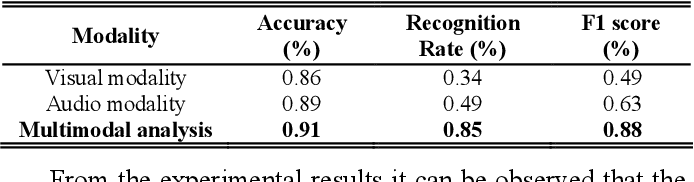
Table I from Active Speaker Recognition using Cross Attention Audio ...
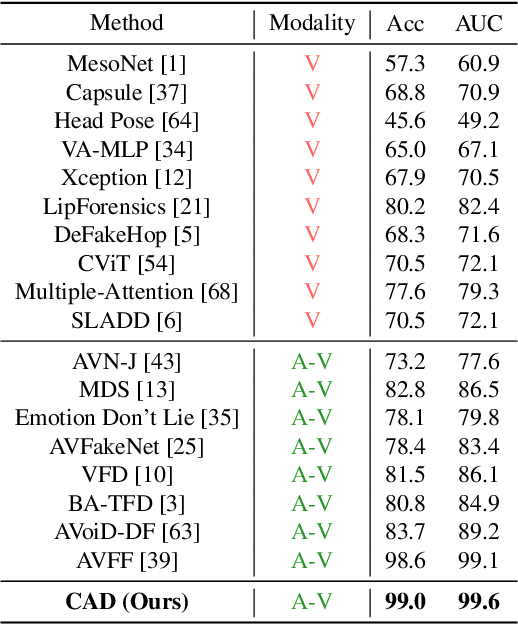
Table 1 from CAD: A General Multimodal Framework for Video Deepfake ...

Contextual Cross-Modal Attention for Audio-Visual Deepfake Detection ...
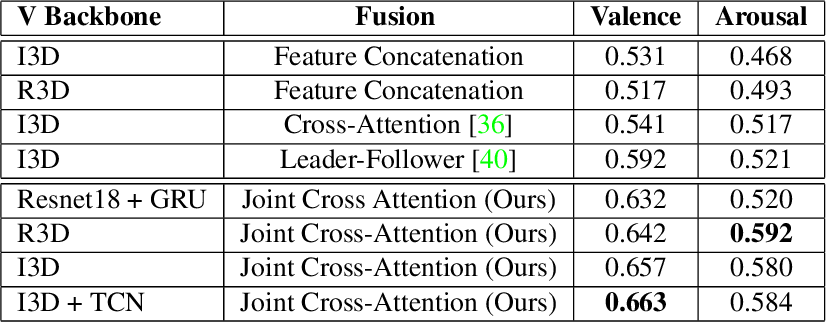
Table 1 from A Joint Cross-Attention Model for Audio-Visual Fusion in ...
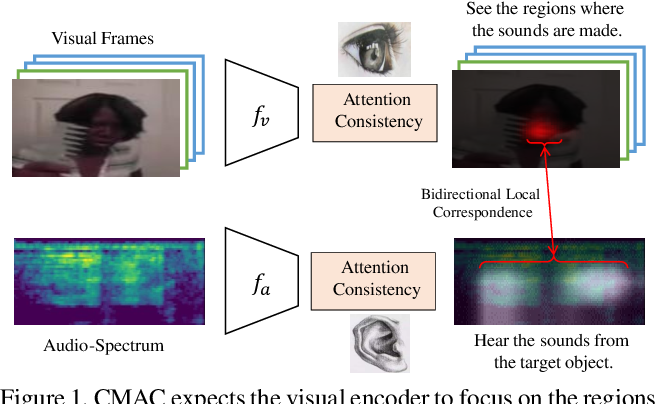
Figure 1 from Cross-Modal Attention Consistency for Video-Audio ...
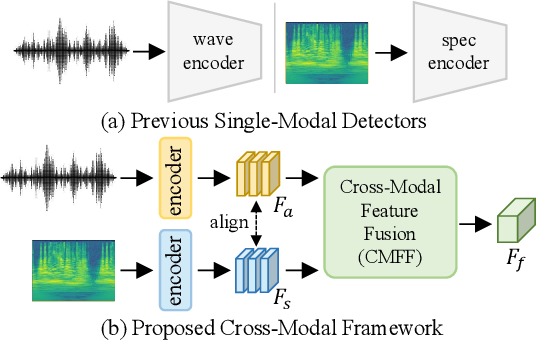
Figure 1 from Wave-Spectrogram Cross-Modal Aggregation for Audio ...
Advertisement Space (300x250)
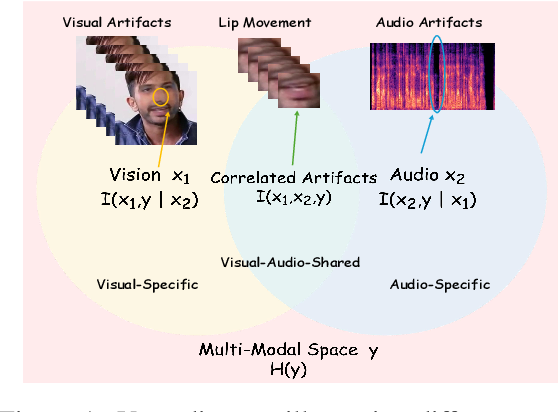
Figure 1 from CAD: A General Multimodal Framework for Video Deepfake ...
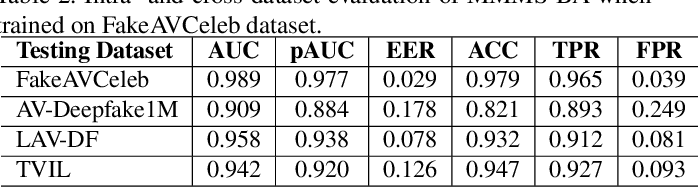
Contextual Cross-Modal Attention for Audio-Visual Deepfake Detection ...
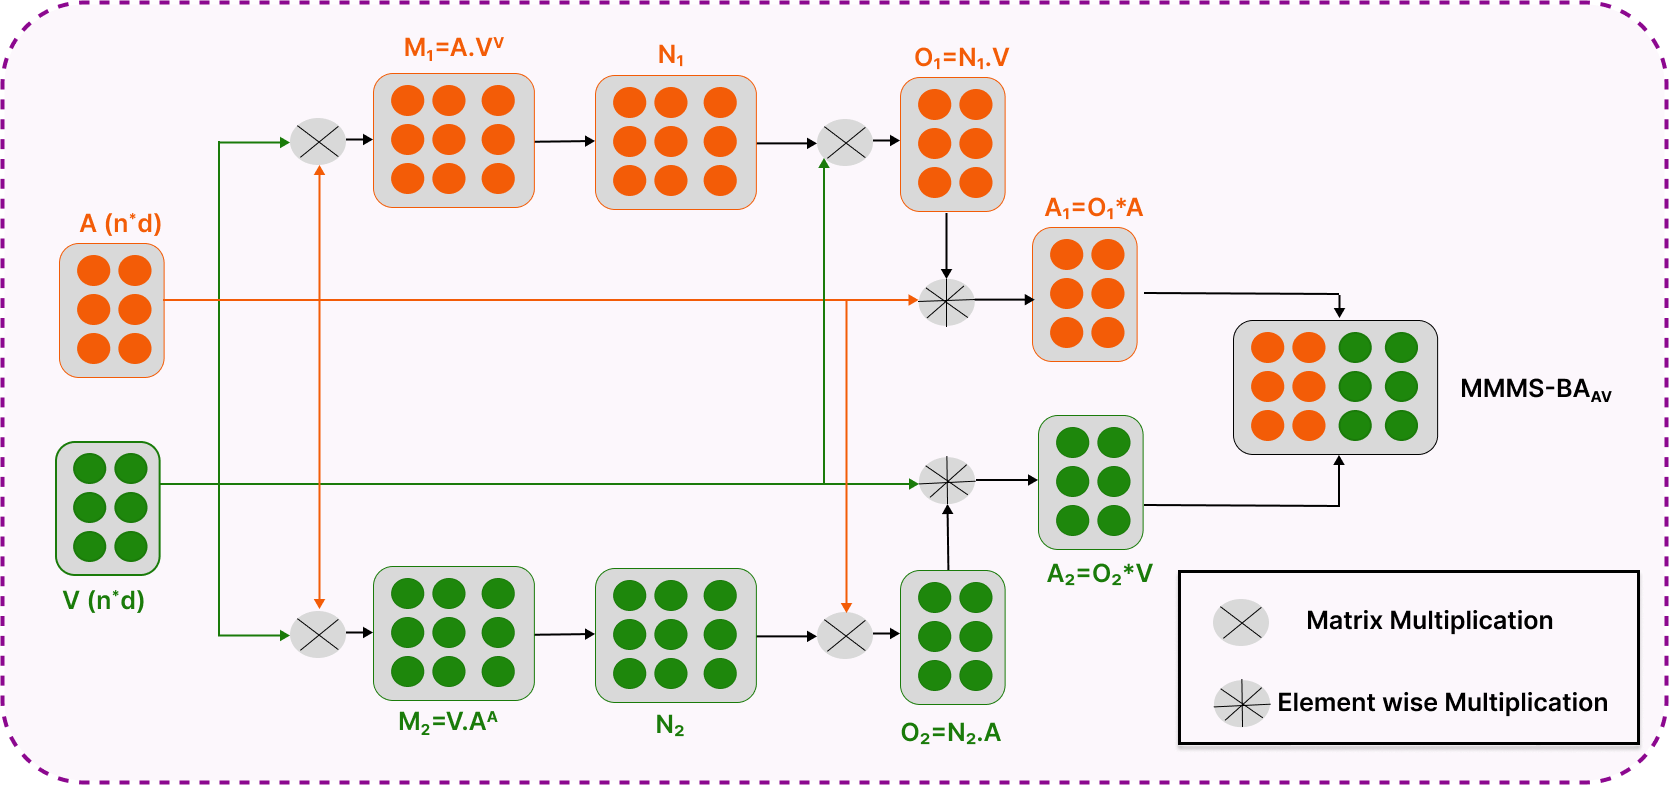
[2408.01532] Contextual Cross-Modal Attention for Audio-Visual Deepfake ...
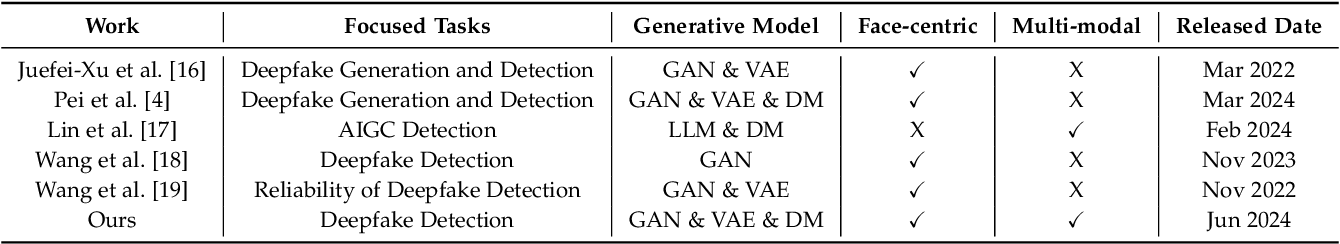
Table 1 from Evolving from Single-modal to Multi-modal Facial Deepfake ...
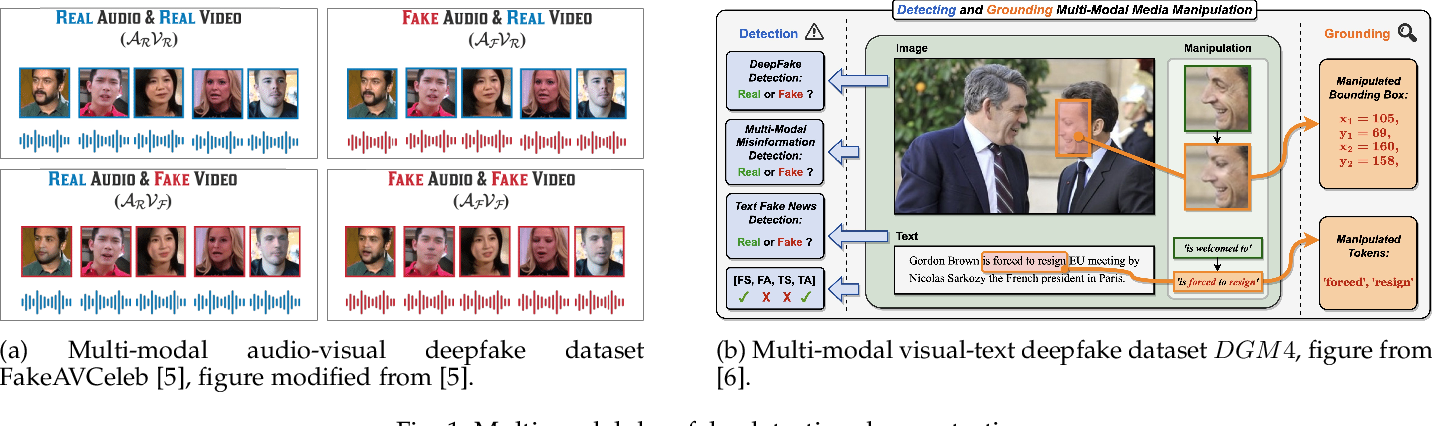
Table 1 from Evolving from Single-modal to Multi-modal Facial Deepfake ...
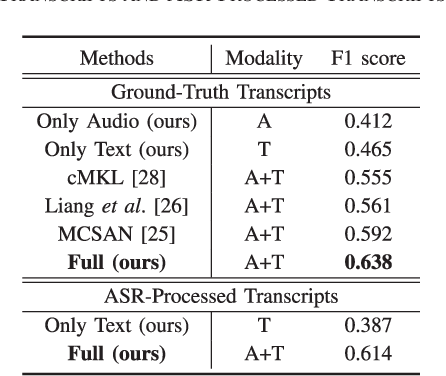
Table I from Contextual and Cross-Modal Interaction for Multi-Modal ...

Figure 1 from Cross-modal Attention Congruence Regularization for ...

MSCT: Differential Cross-Modal Attention for Deepfake Detection | AI ...

Figure 1 from Rethink Cross-Modal Fusion in Weakly-Supervised Audio ...

Figure 1 from DF-TransFusion: Multimodal Deepfake Detection via Lip ...
Advertisement Space (336x280)
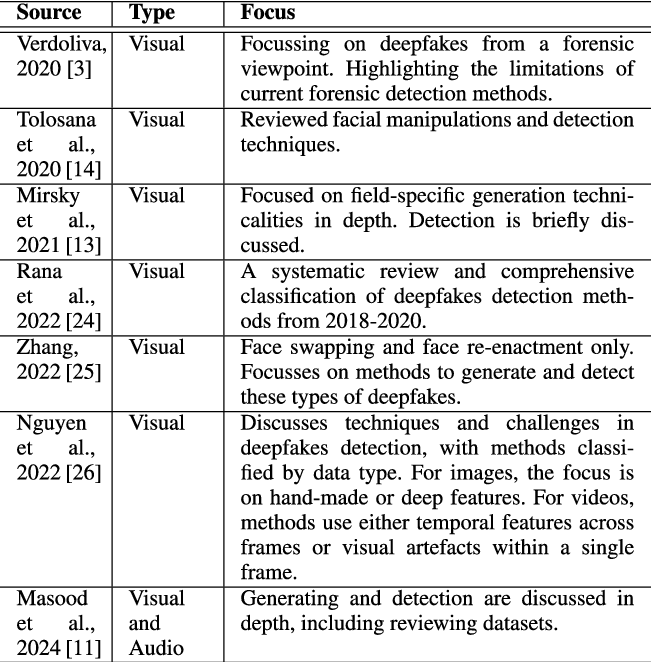
Table 1 from A Survey on the Detection and Impacts of Deepfakes in ...

Figure 2 from Incongruity-Aware Cross-Modal Attention for Audio-Visual ...

Figure 2 from Additive Cross-Modal Attention Network (ACMA) for ...

Figure 1 from Audiovisual Generalised Zero-shot Learning with Cross ...

Figure 1 from ADD: Frequency Attention and Multi-View based Knowledge ...
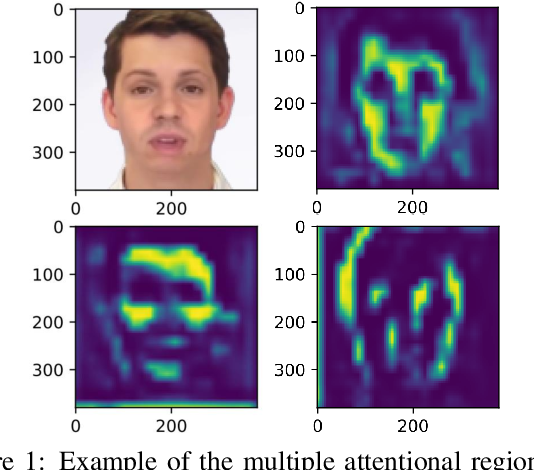
Figure 1 from Multi-attentional Deepfake Detection | Semantic Scholar

Figure 1 from Conversational Speech Recognition by Learning Audio ...
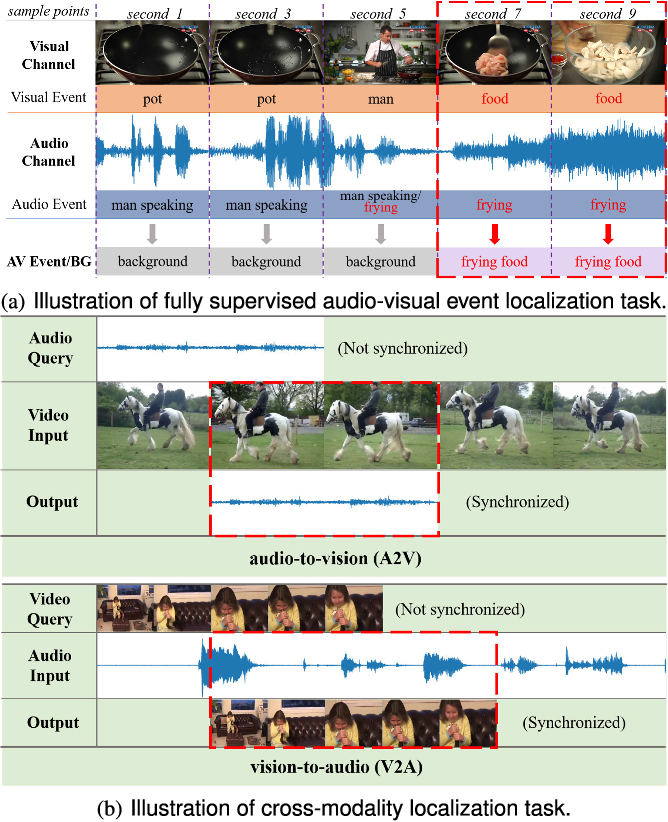
Figure 1 from Listen With Seeing: Cross-Modal Contrastive Learning for ...

Adaptive Inter-Modality Attention for Enhanced Cross-Domain Deepfake ...

Figure 2 from Temporal and cross-modal attention for audio-visual zero ...
Advertisement Space (336x280)
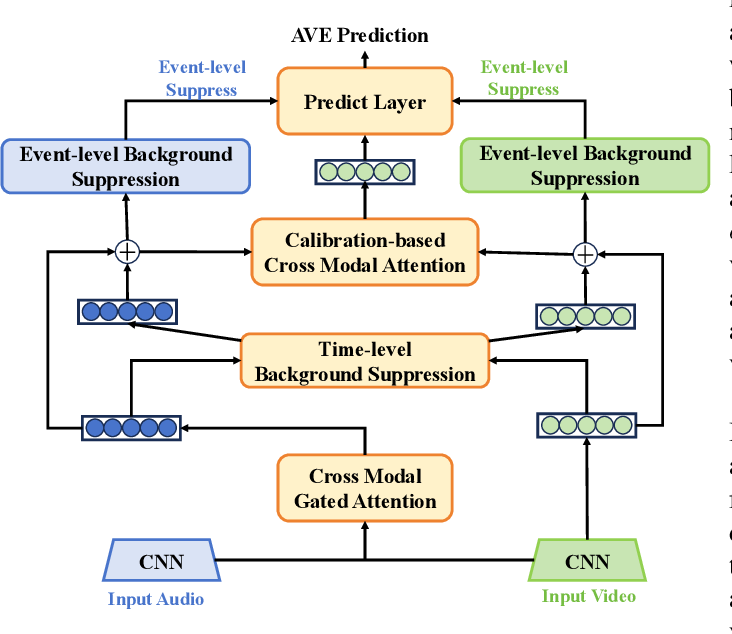
Figure 1 from C-CANet:Calibration-Based Cross-Modal Attention Network ...
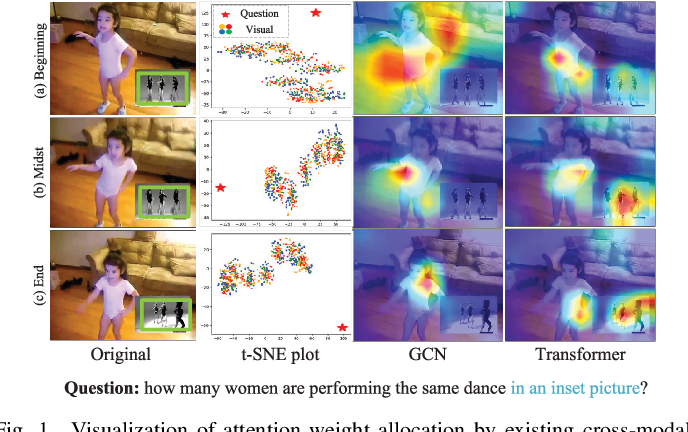
Figure 1 from Semantic Distance-Aware Cross-Modal Attention Mechanism ...
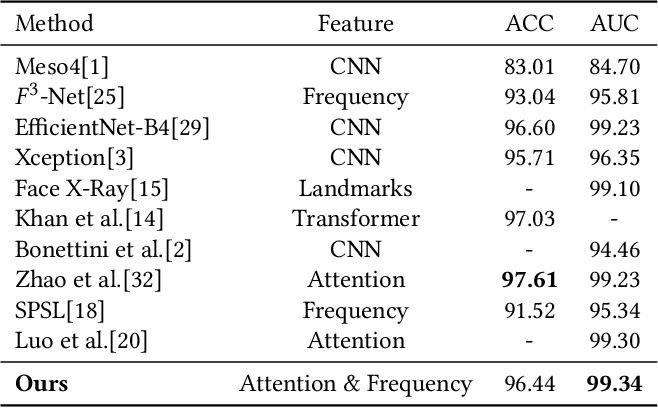
Table 1 from Exposing Deepfakes using Dual-Channel Network with Multi ...
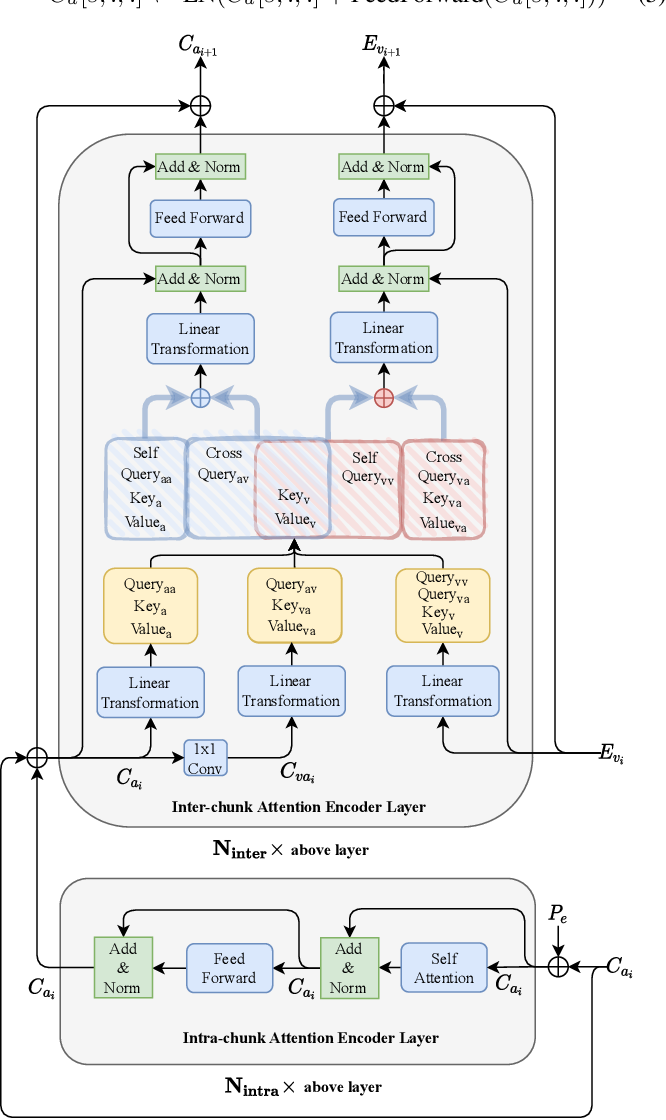
Figure 2 from Dual-Path Cross-Modal Attention for Better Audio-Visual ...
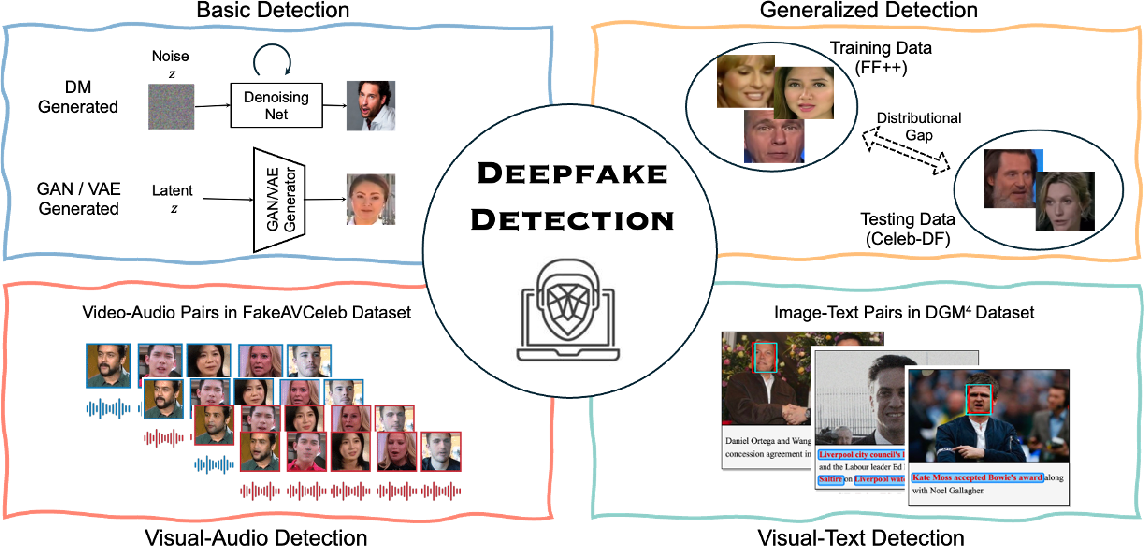
Figure 1 from Evolving from Single-modal to Multi-modal Facial Deepfake ...
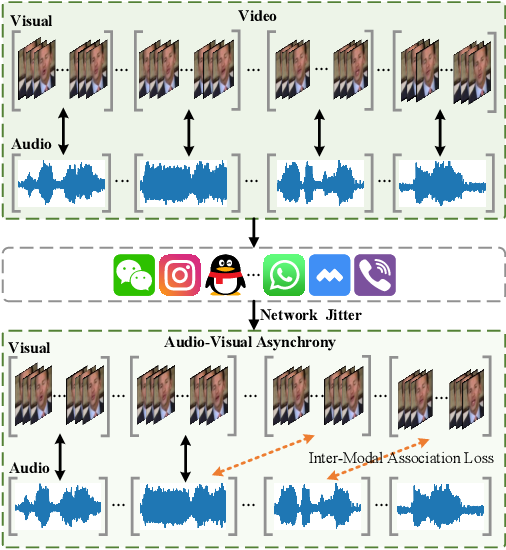
Figure 1 from Audio-Visual Asynchrony Mitigation: Cross-Modal Alignment ...