
Table 1 From Dual Level Collaborative Transformer For Image Captioning

Table 1 from Dual-Level Collaborative Transformer for Image Captioning ...

Figure 1 from Dual-Level Collaborative Transformer for Image Captioning ...

Figure 1 from Dual-Level Collaborative Transformer for Image Captioning ...
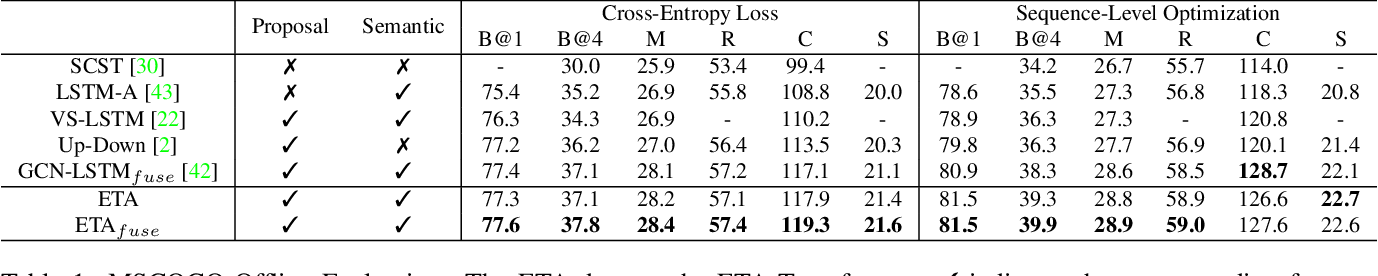
Table 1 from Entangled Transformer for Image Captioning | Semantic Scholar
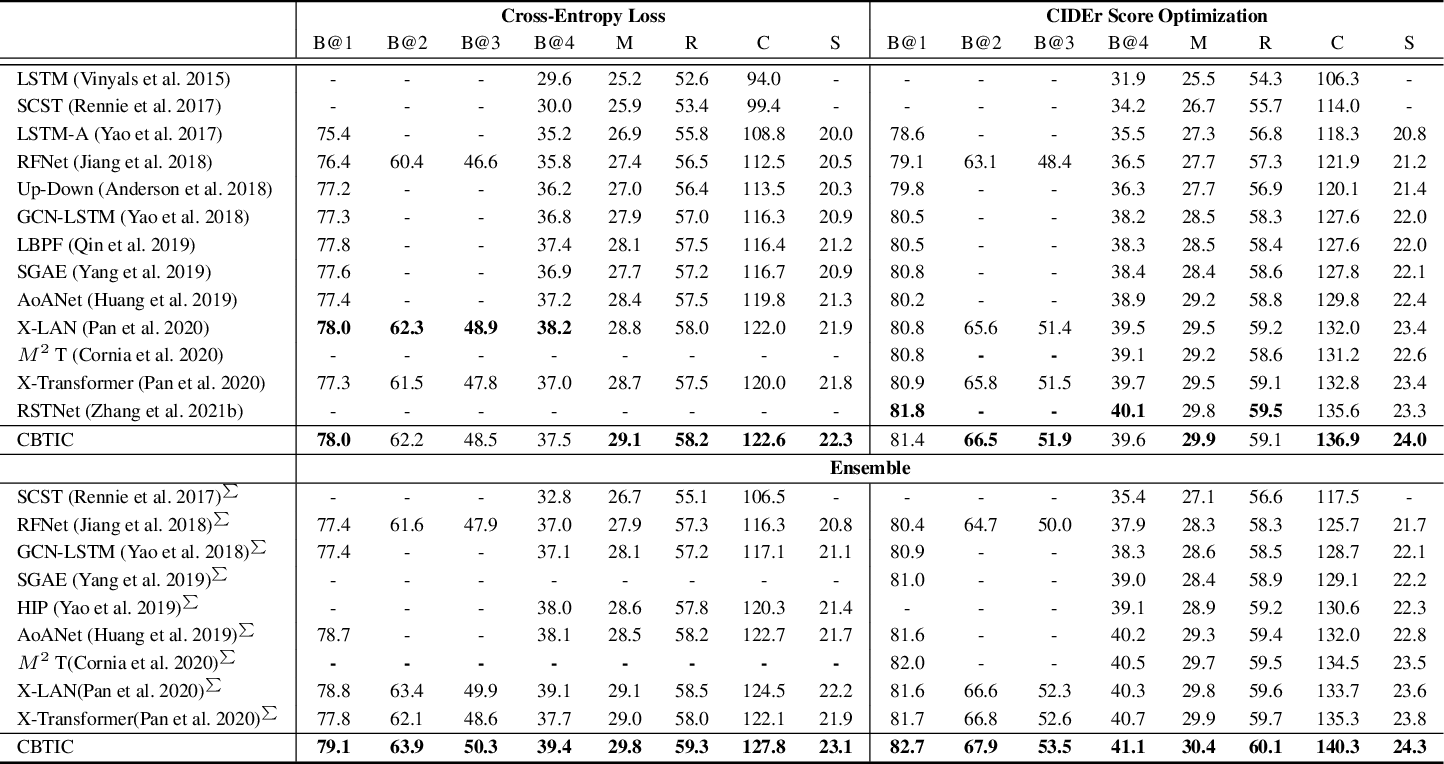
Table 1 from Compact Bidirectional Transformer for Image Captioning ...

Table 1 from Transformer based Multitask Learning for Image Captioning ...

Figure 1 from End-to-End Transformer Based Model for Image Captioning ...
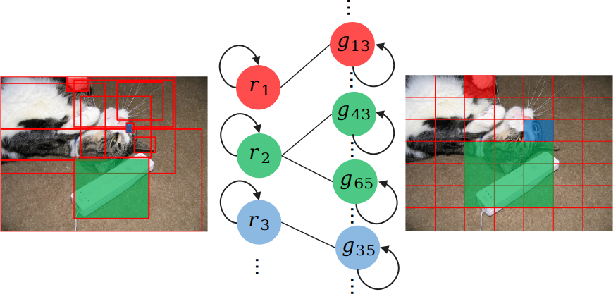
Figure 3 from Dual-Level Collaborative Transformer for Image Captioning ...

Figure 1 from Compact Bidirectional Transformer for Image Captioning ...

Figure 1 from Compact Bidirectional Transformer for Image Captioning ...
Advertisement Space (300x250)

Figure 1 from End-to-End Transformer Based Model for Image Captioning ...

Figure 1 from Dynamic Transformer for Image Captioning | Semantic Scholar

Dual-Level Collaborative Transformer for Image Captioning

Table 1 from Dual Path Transformer with Partition Attention | Semantic ...

Figure 1 from Dual-Level Decoupled Transformer for Video Captioning ...

Dual-visual collaborative enhanced transformer for image captioning ...

[2101.06462] Dual-Level Collaborative Transformer for Image Captioning

Table 1 from Dual-Stream Transformer for Generic Event Boundary ...

Table I from Remote Sensing Image Captioning Using Transformer Model ...
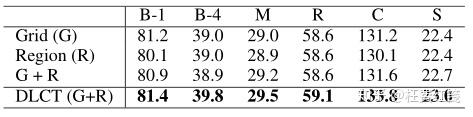
【AAAI2021】Dual-Level Collaborative Transformer for Image Captioning - 知乎
Advertisement Space (336x280)
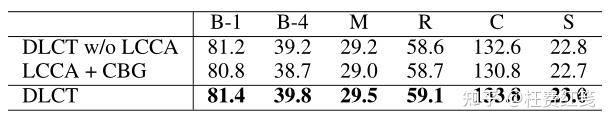
【AAAI2021】Dual-Level Collaborative Transformer for Image Captioning - 知乎

[2101.06462] Dual-Level Collaborative Transformer for Image Captioning
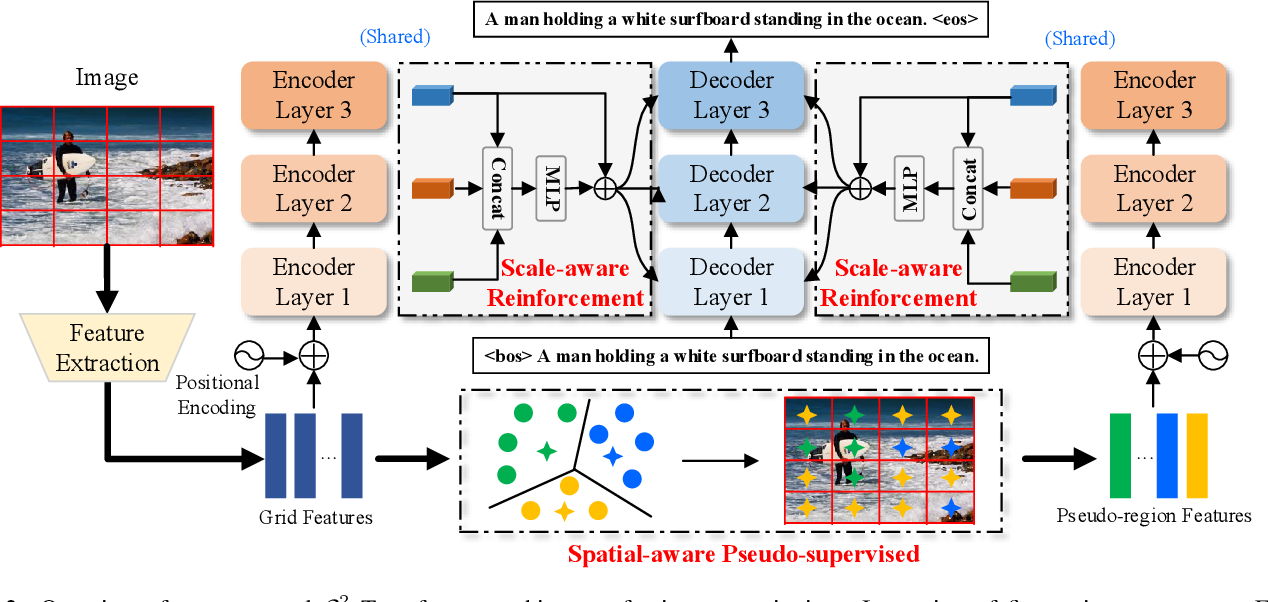
Figure 2 from S2 Transformer for Image Captioning | Semantic Scholar

Table 2 from GRIT: Faster and Better Image captioning Transformer Using ...

Figure 1 from GRIT: Faster and Better Image captioning Transformer ...

【AAAI2021】Dual-Level Collaborative Transformer for Image Captioning - 知乎

[论文评述] Dual-Stream Collaborative Transformer for Image Captioning

Dual-visual collaborative enhanced transformer for image captioning ...

Figure 1 from TVT: Two-View Transformer Network for Video Captioning ...

Figure 1 from CLIP-Driven Distinctive Interactive Transformer for Image ...
Advertisement Space (336x280)
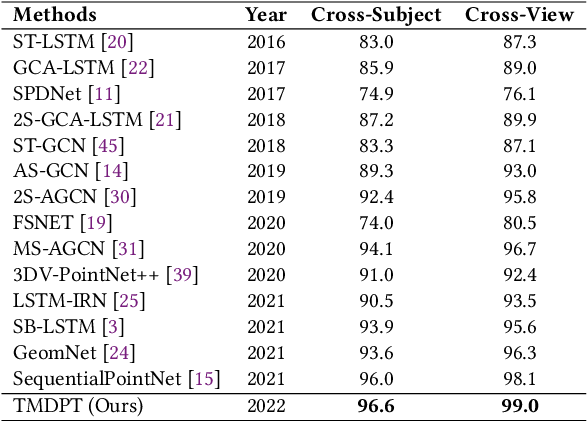
Table 1 from Two-stream Multi-level Dynamic Point Transformer for Two ...

Figure 1 from Dual-Branch Collaborative Transformer for Virtual Try-On ...
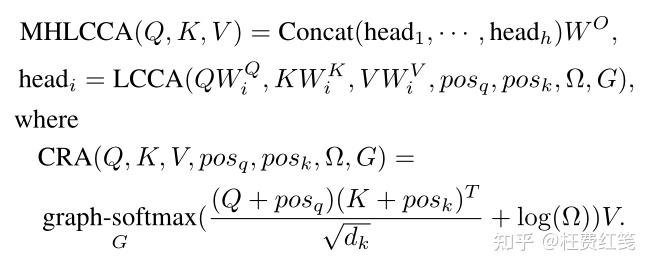
【AAAI2021】Dual-Level Collaborative Transformer for Image Captioning - 知乎

【AAAI2021】Dual-Level Collaborative Transformer for Image Captioning - 知乎
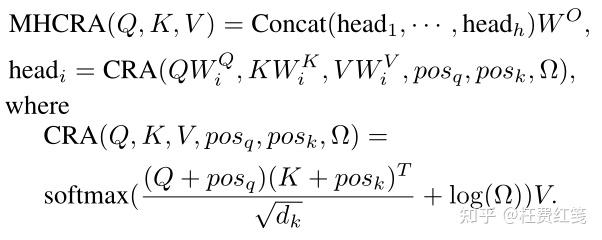
【AAAI2021】Dual-Level Collaborative Transformer for Image Captioning - 知乎

【AAAI2021】Dual-Level Collaborative Transformer for Image Captioning - 知乎