
Table 1 From Interpret Vision Transformers As Convnets With Dynamic
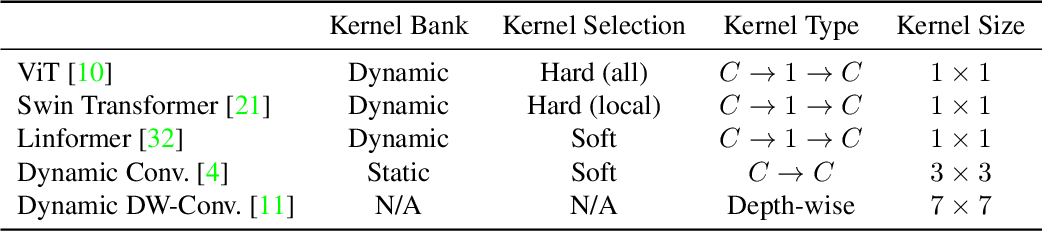
Table 1 from Interpret Vision Transformers as ConvNets with Dynamic ...
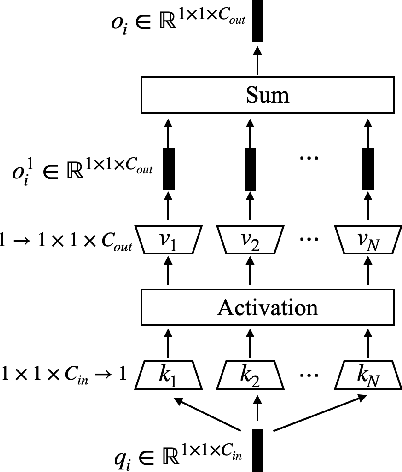
Figure 2 from Interpret Vision Transformers as ConvNets with Dynamic ...

Transformer 系列 Interpret Vision Transformers as ConvNets with Dynamic ...

Transformer 系列 Interpret Vision Transformers as ConvNets with Dynamic ...

[2309.10713] Interpret Vision Transformers as ConvNets with Dynamic ...

[2309.10713] Interpret Vision Transformers as ConvNets with Dynamic ...

Table 1 from Grafting Vision Transformers | Semantic Scholar

Table 1 from Exploring Self-Supervised Vision Transformers for Deepfake ...
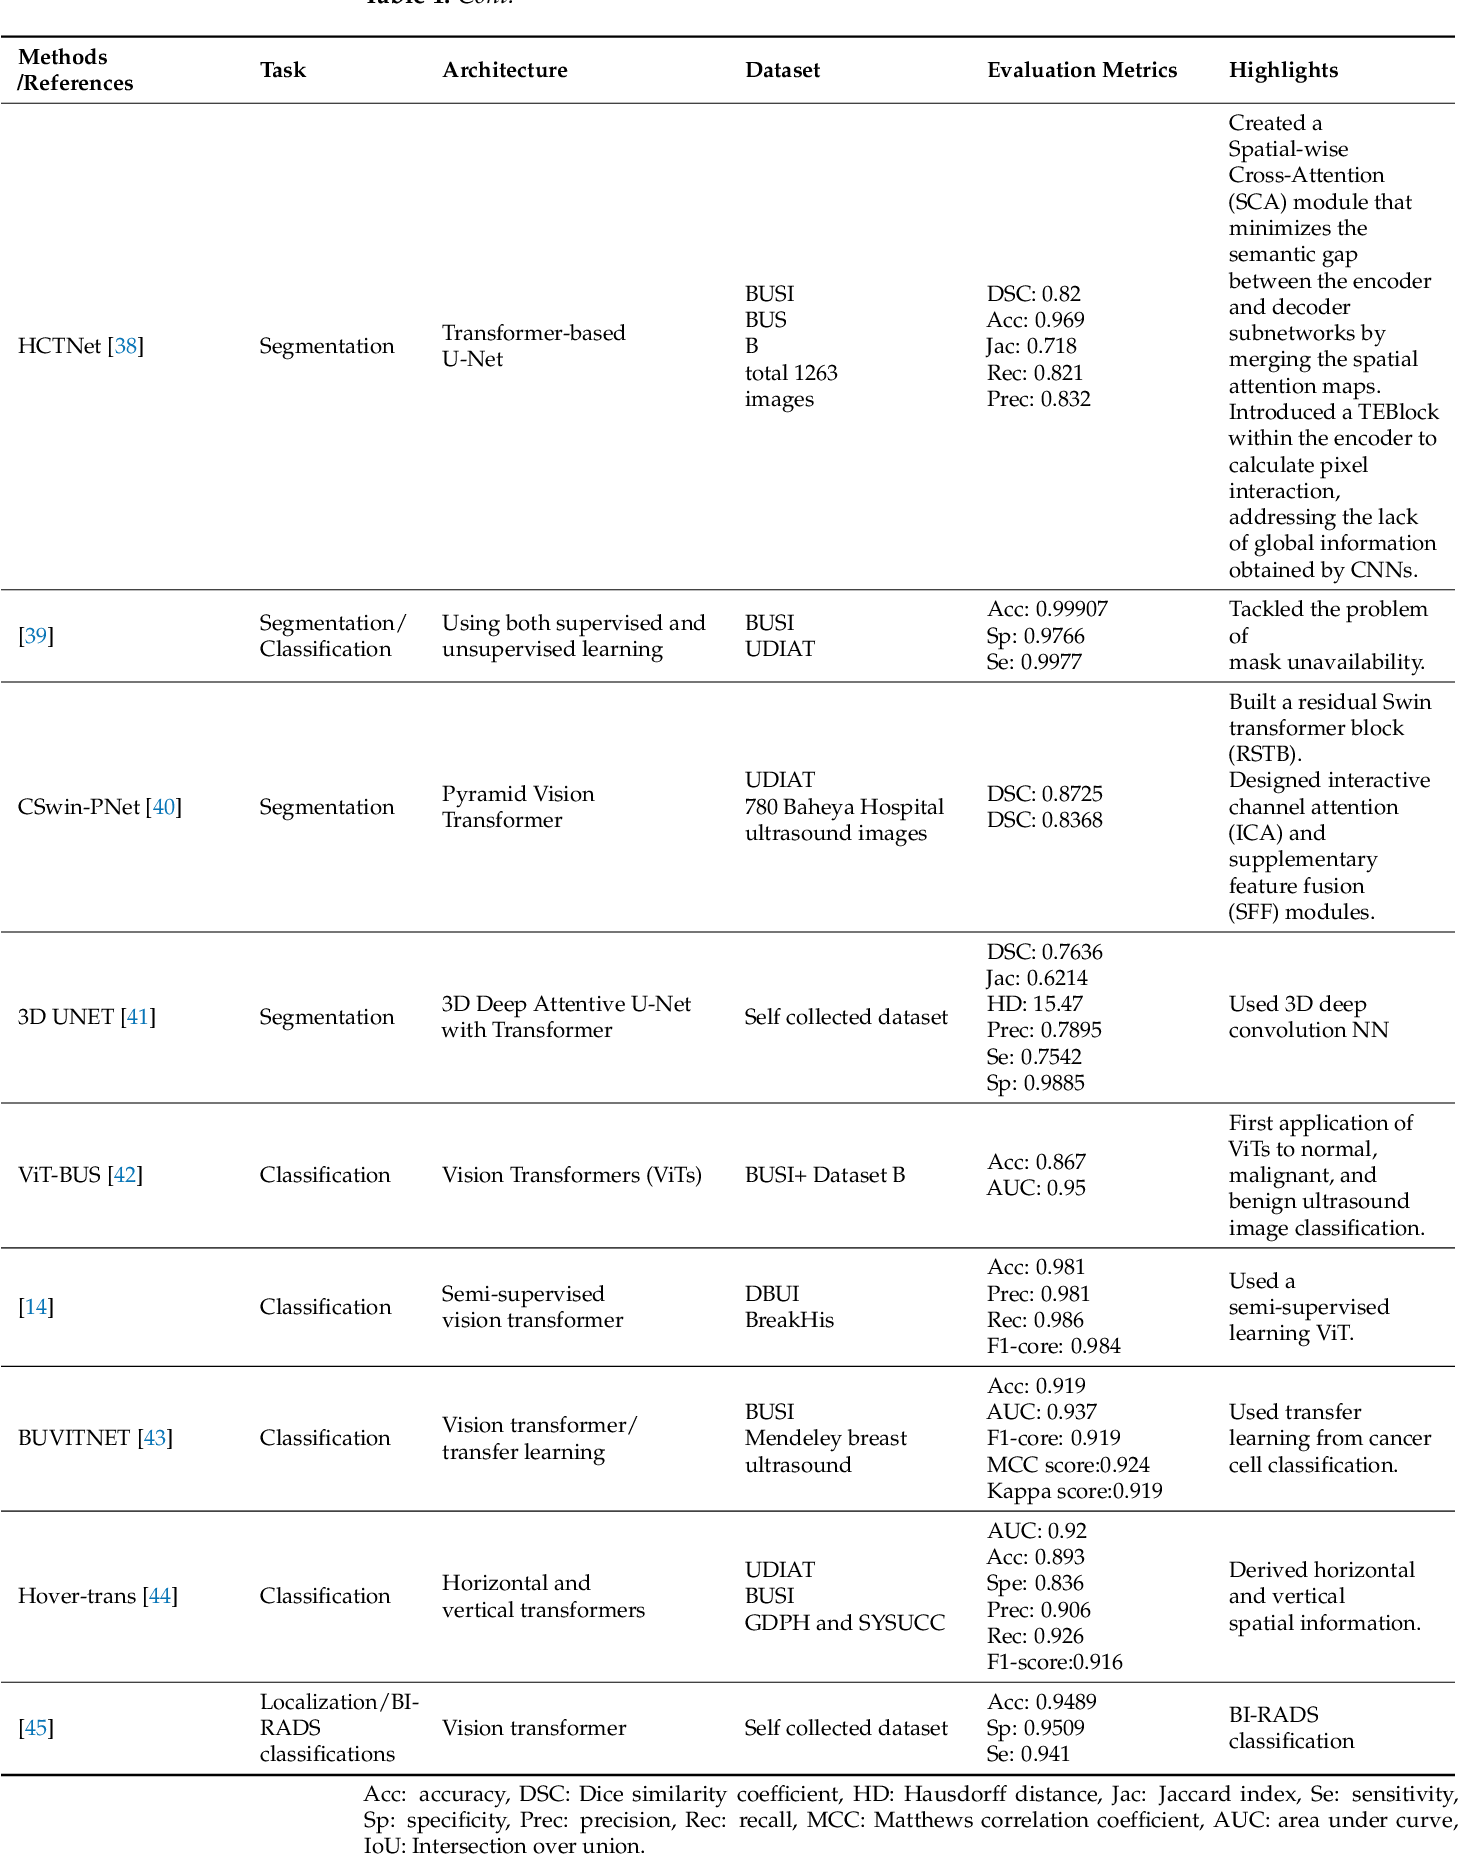
Table 1 from Ultrasound Image Analysis with Vision Transformers—Review ...

Table 1 from Learning Correlation Structures for Vision Transformers ...
Advertisement Space (300x250)
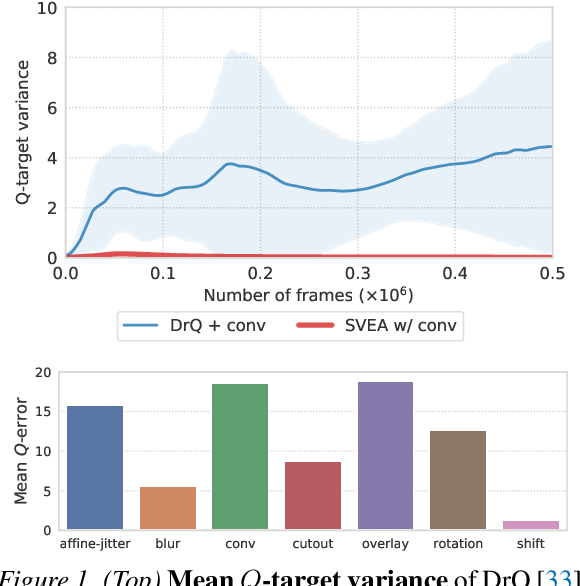
Figure 1 from Stabilizing Deep Q-Learning with ConvNets and Vision ...
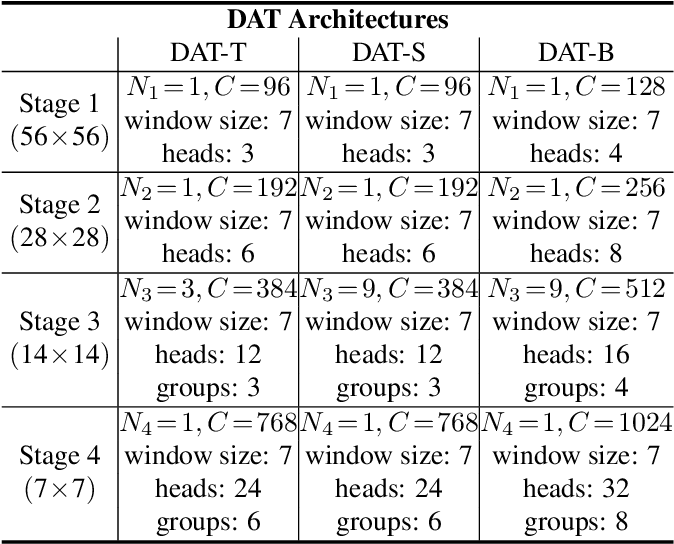
Table 1 from Vision Transformer with Deformable Attention | Semantic ...
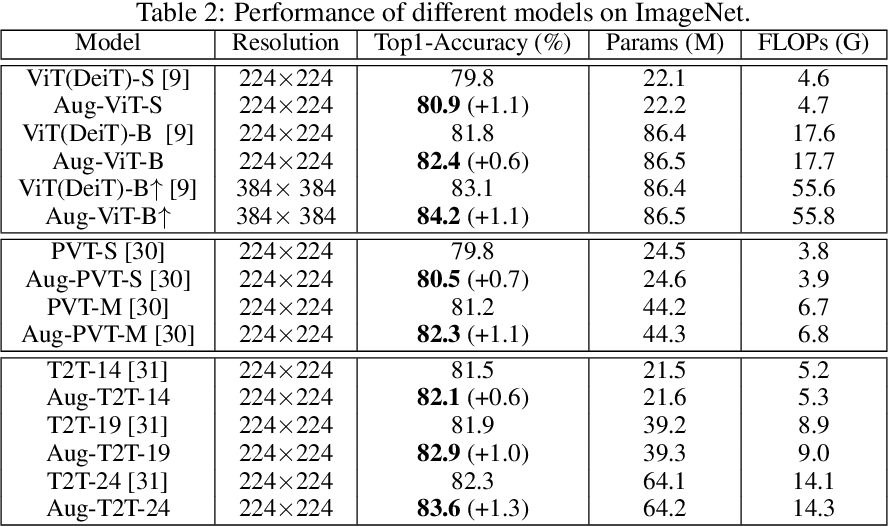
Table 1 from Augmented Shortcuts for Vision Transformers | Semantic Scholar

(PDF) DiT: Efficient Vision Transformers with Dynamic Token Routing

Figure 1 from Using Vision Transformers in 3-D Medical Image ...

Table 3 from Comparing Vision Transformers and Convolutional Neural ...

Figure 1 from A Comprehensive Study of Vision Transformers on Dense ...

Table 3 from Ultrasound Image Analysis with Vision Transformers—Review ...
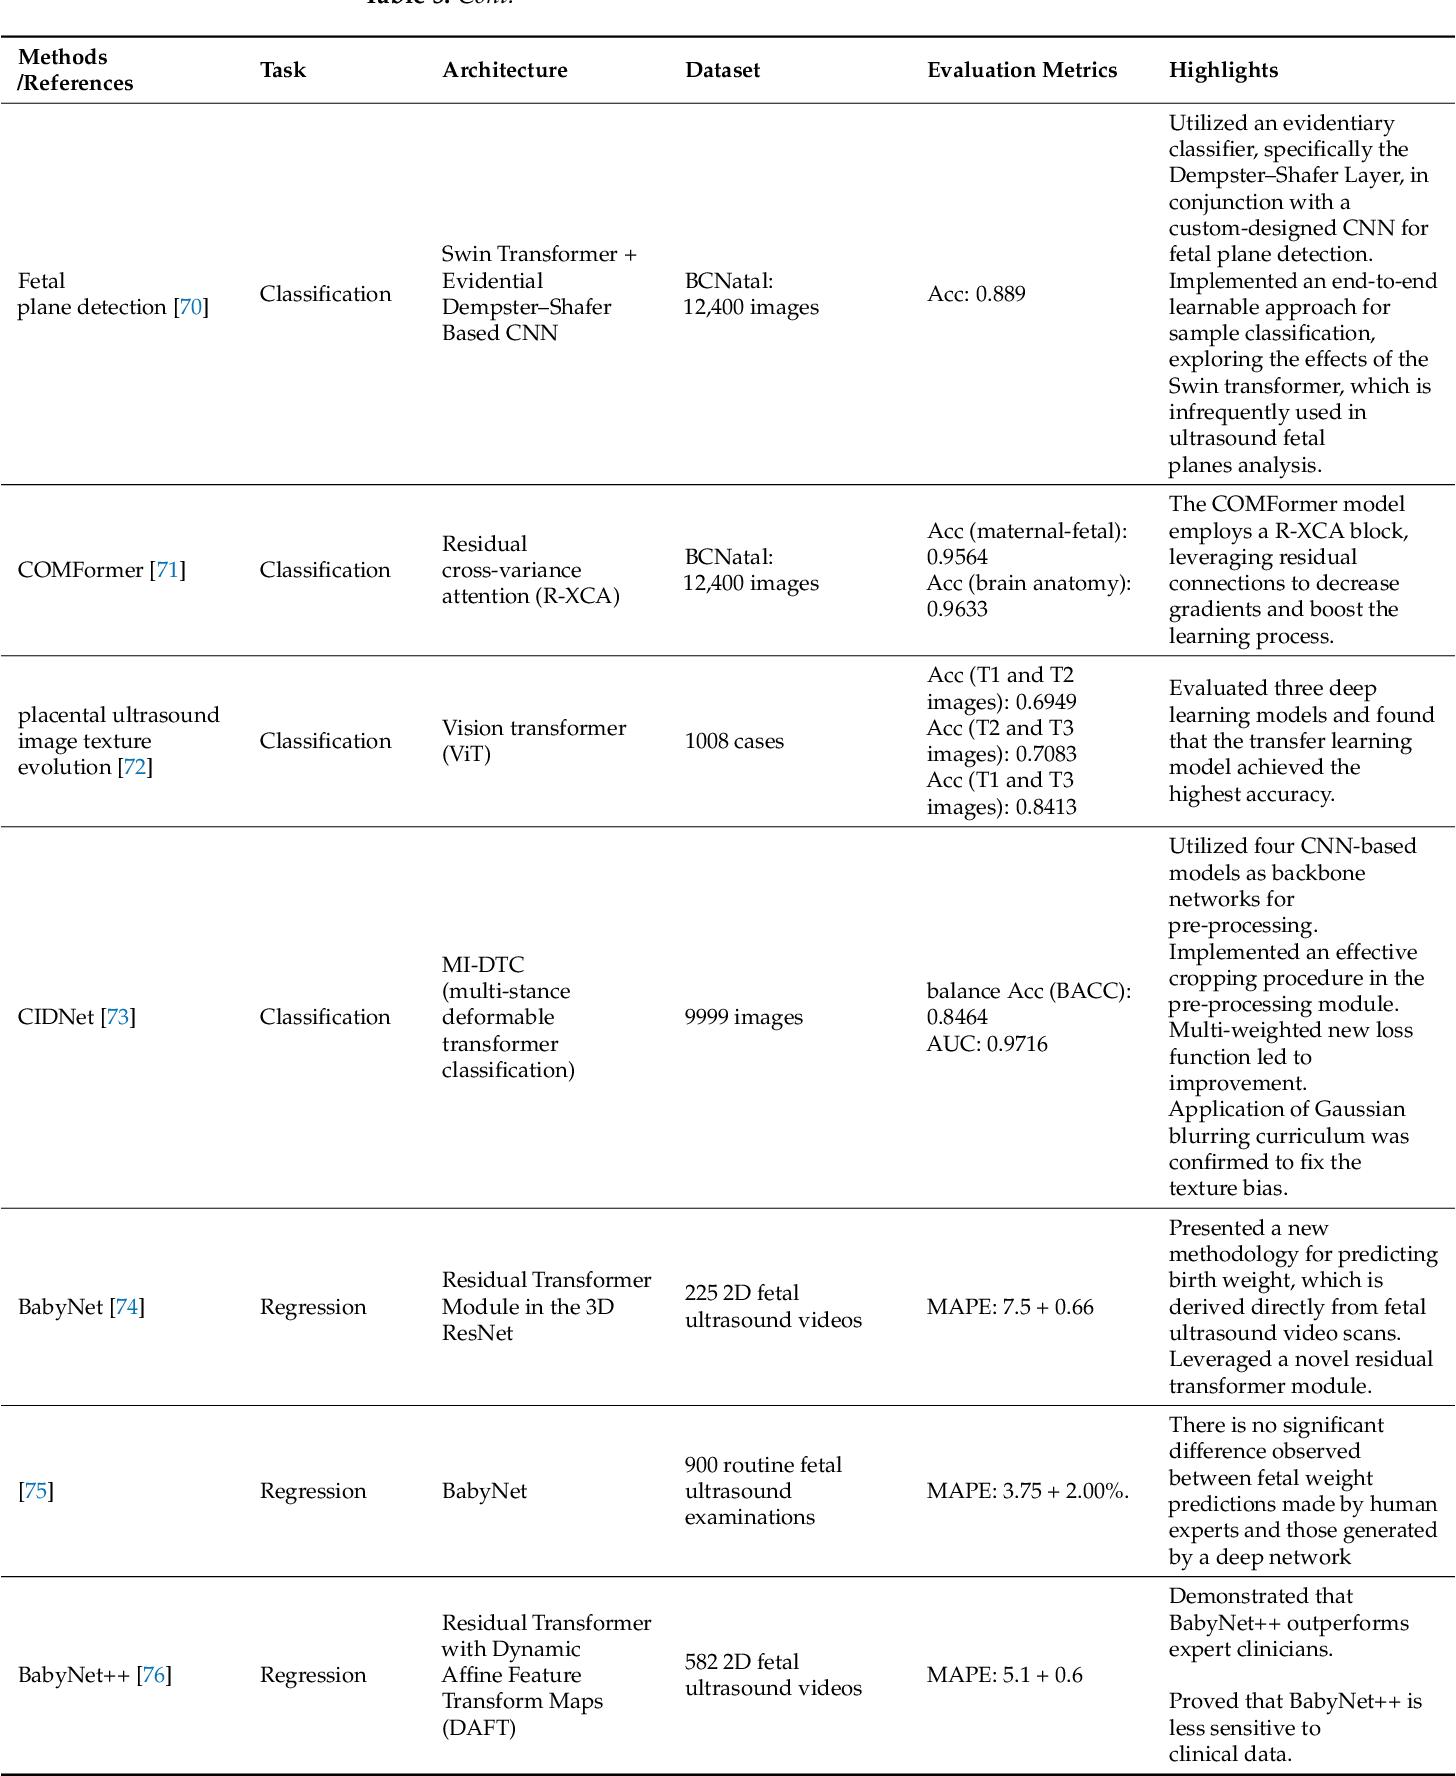
Table 5 from Ultrasound Image Analysis with Vision Transformers—Review ...
DynamicViT: Efficient Vision Transformers with Dynamic Token Sparsification
Advertisement Space (336x280)

LGViT: A Local and Global Vision Transformer with Dynamic Contextual ...

CVPR2023 Making Vision Transformers Efficient from A Token ...

(PDF) Dynamic Grained Encoder for Vision Transformers

DAT++: Spatially Dynamic Vision Transformer With Deformable Attention ...
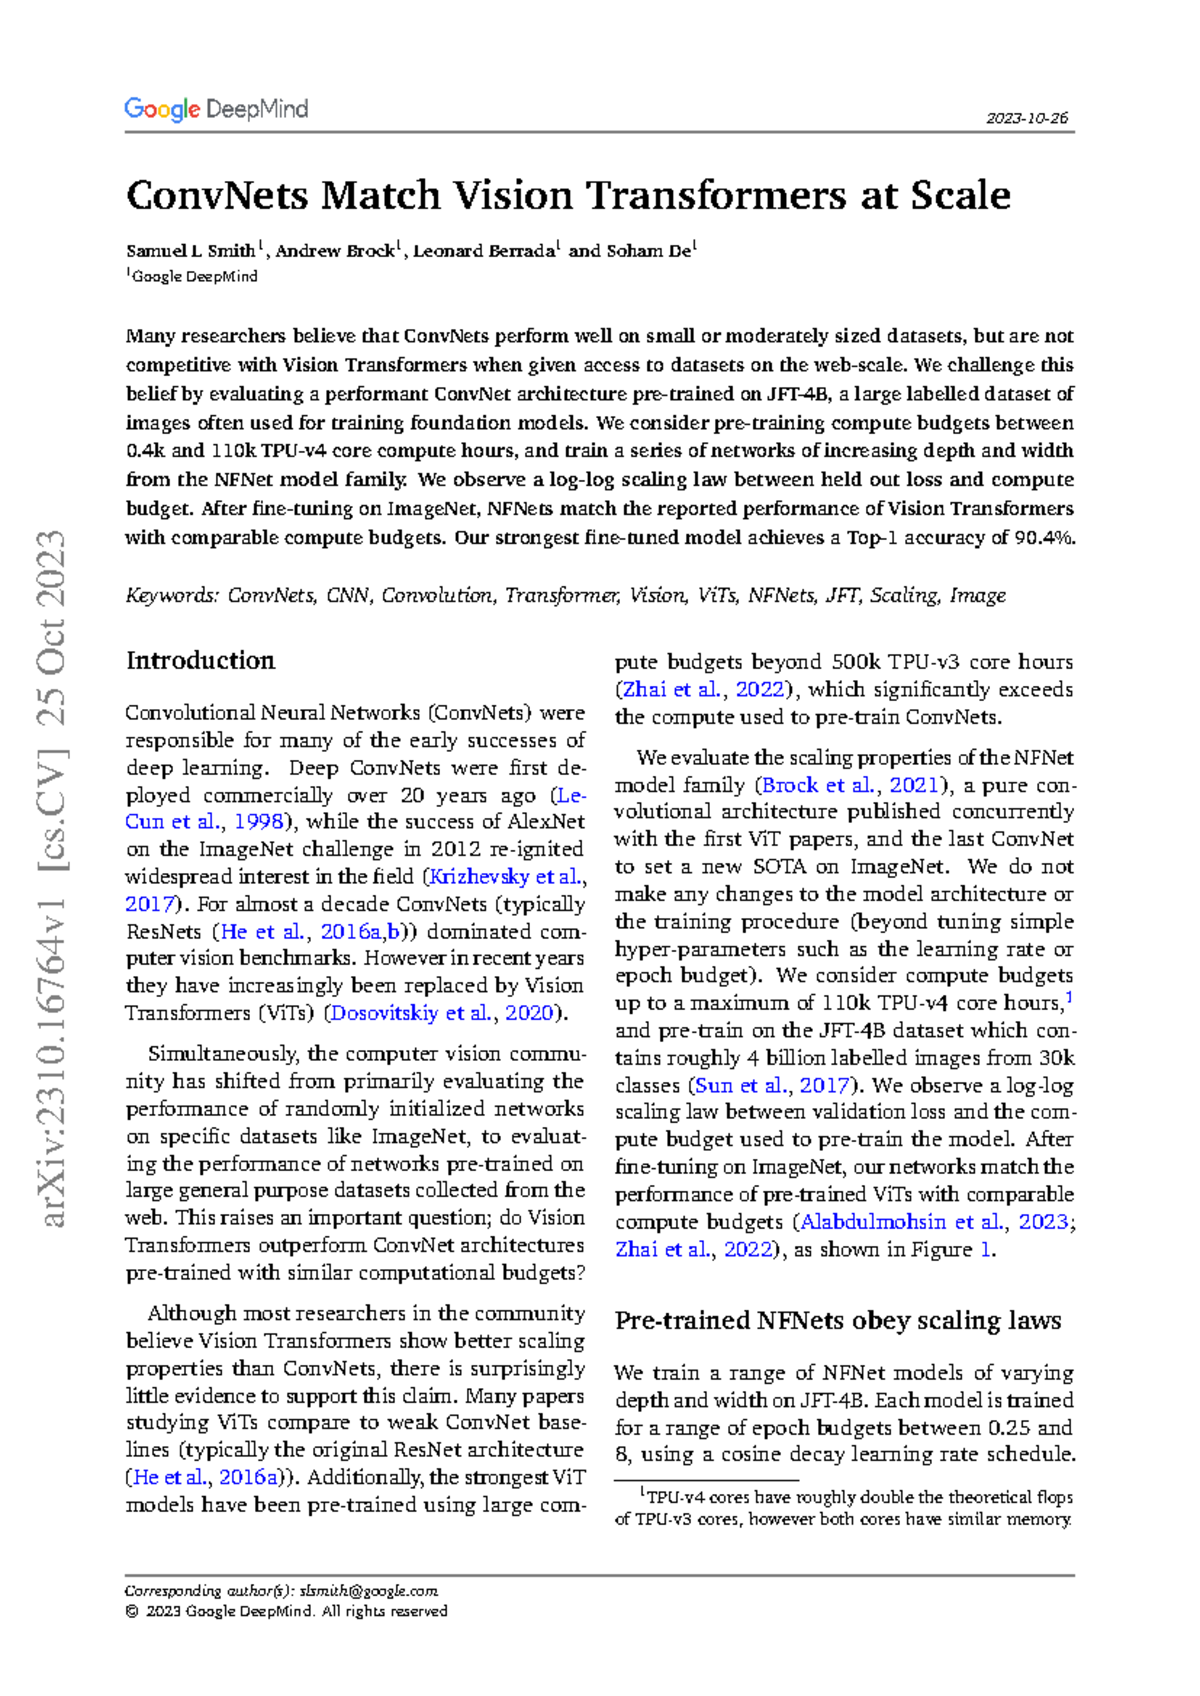
Conv Nets Match Vision Transformers at Scale - 2023-10- ConvNets Match ...

Paper page - ConvNets Match Vision Transformers at Scale

CVPR2023 Making Vision Transformers Efficient from A Token ...

Paper page - Stabilizing Deep Q-Learning with ConvNets and Vision ...

Figure 3 from An Overview of Vision Transformers for Image Processing ...
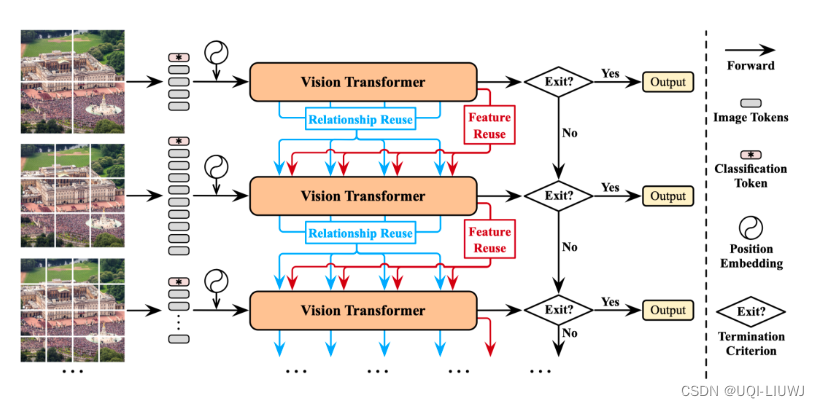
论文笔记:Not All Images are Worth 16x16 Words: Dynamic Vision Transformers ...
Advertisement Space (336x280)
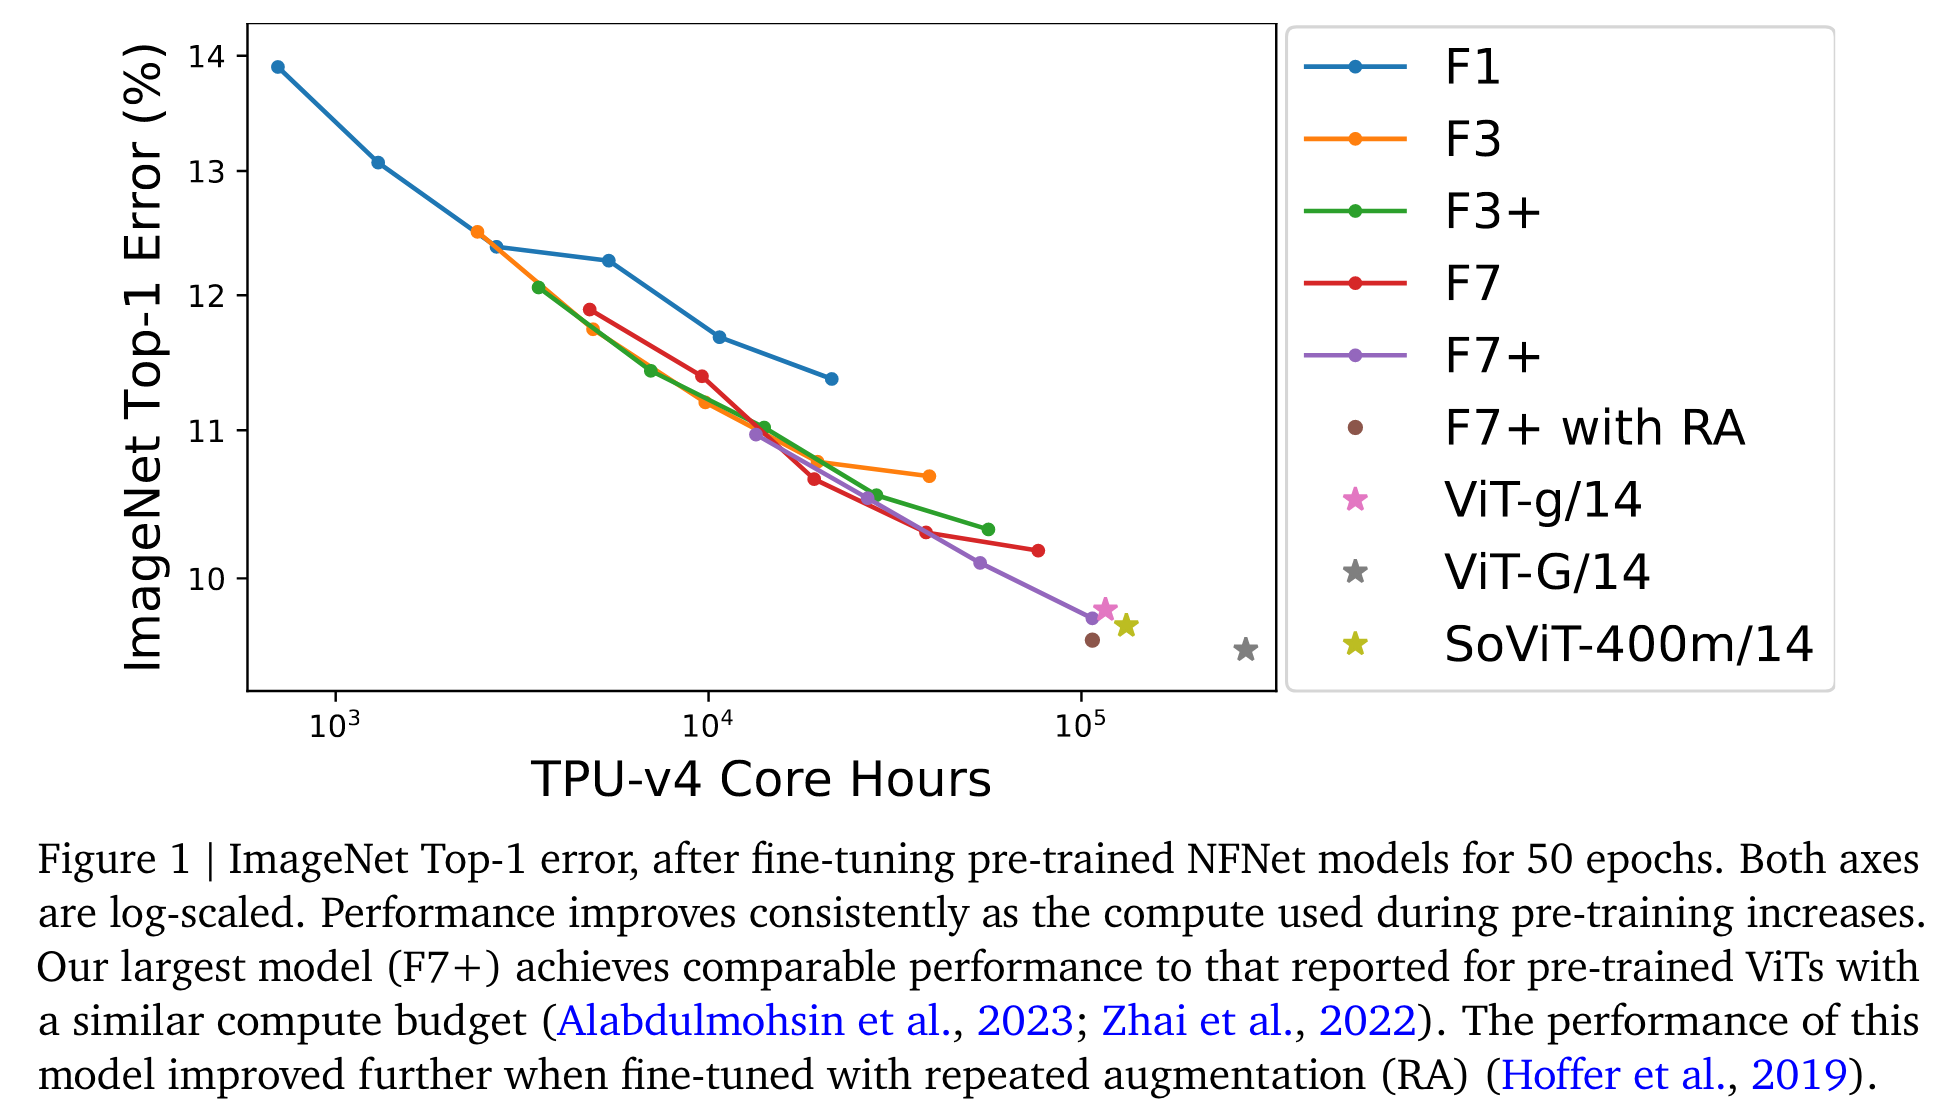
ConvNets Match Vision Transformers at Scale | Qiang Zhang

LGViT: A Local and Global Vision Transformer with Dynamic Contextual ...

Vision Transformers vs. Convolutional Neural Networks: Who Wins?
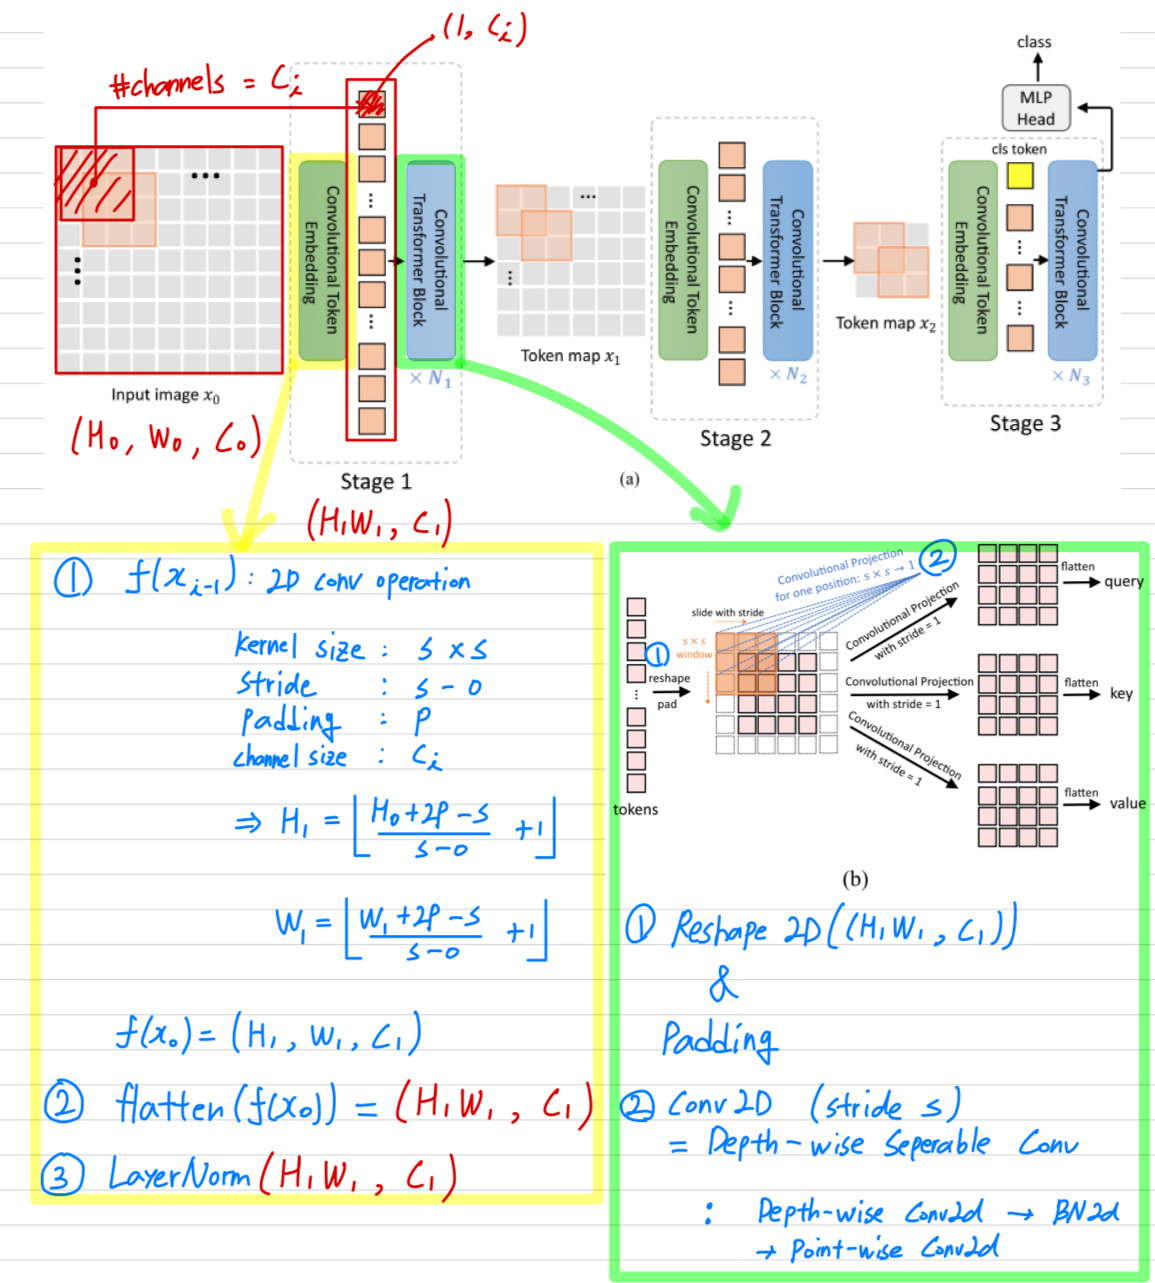
CvT: Introducing Convolutions to Vision Transformers
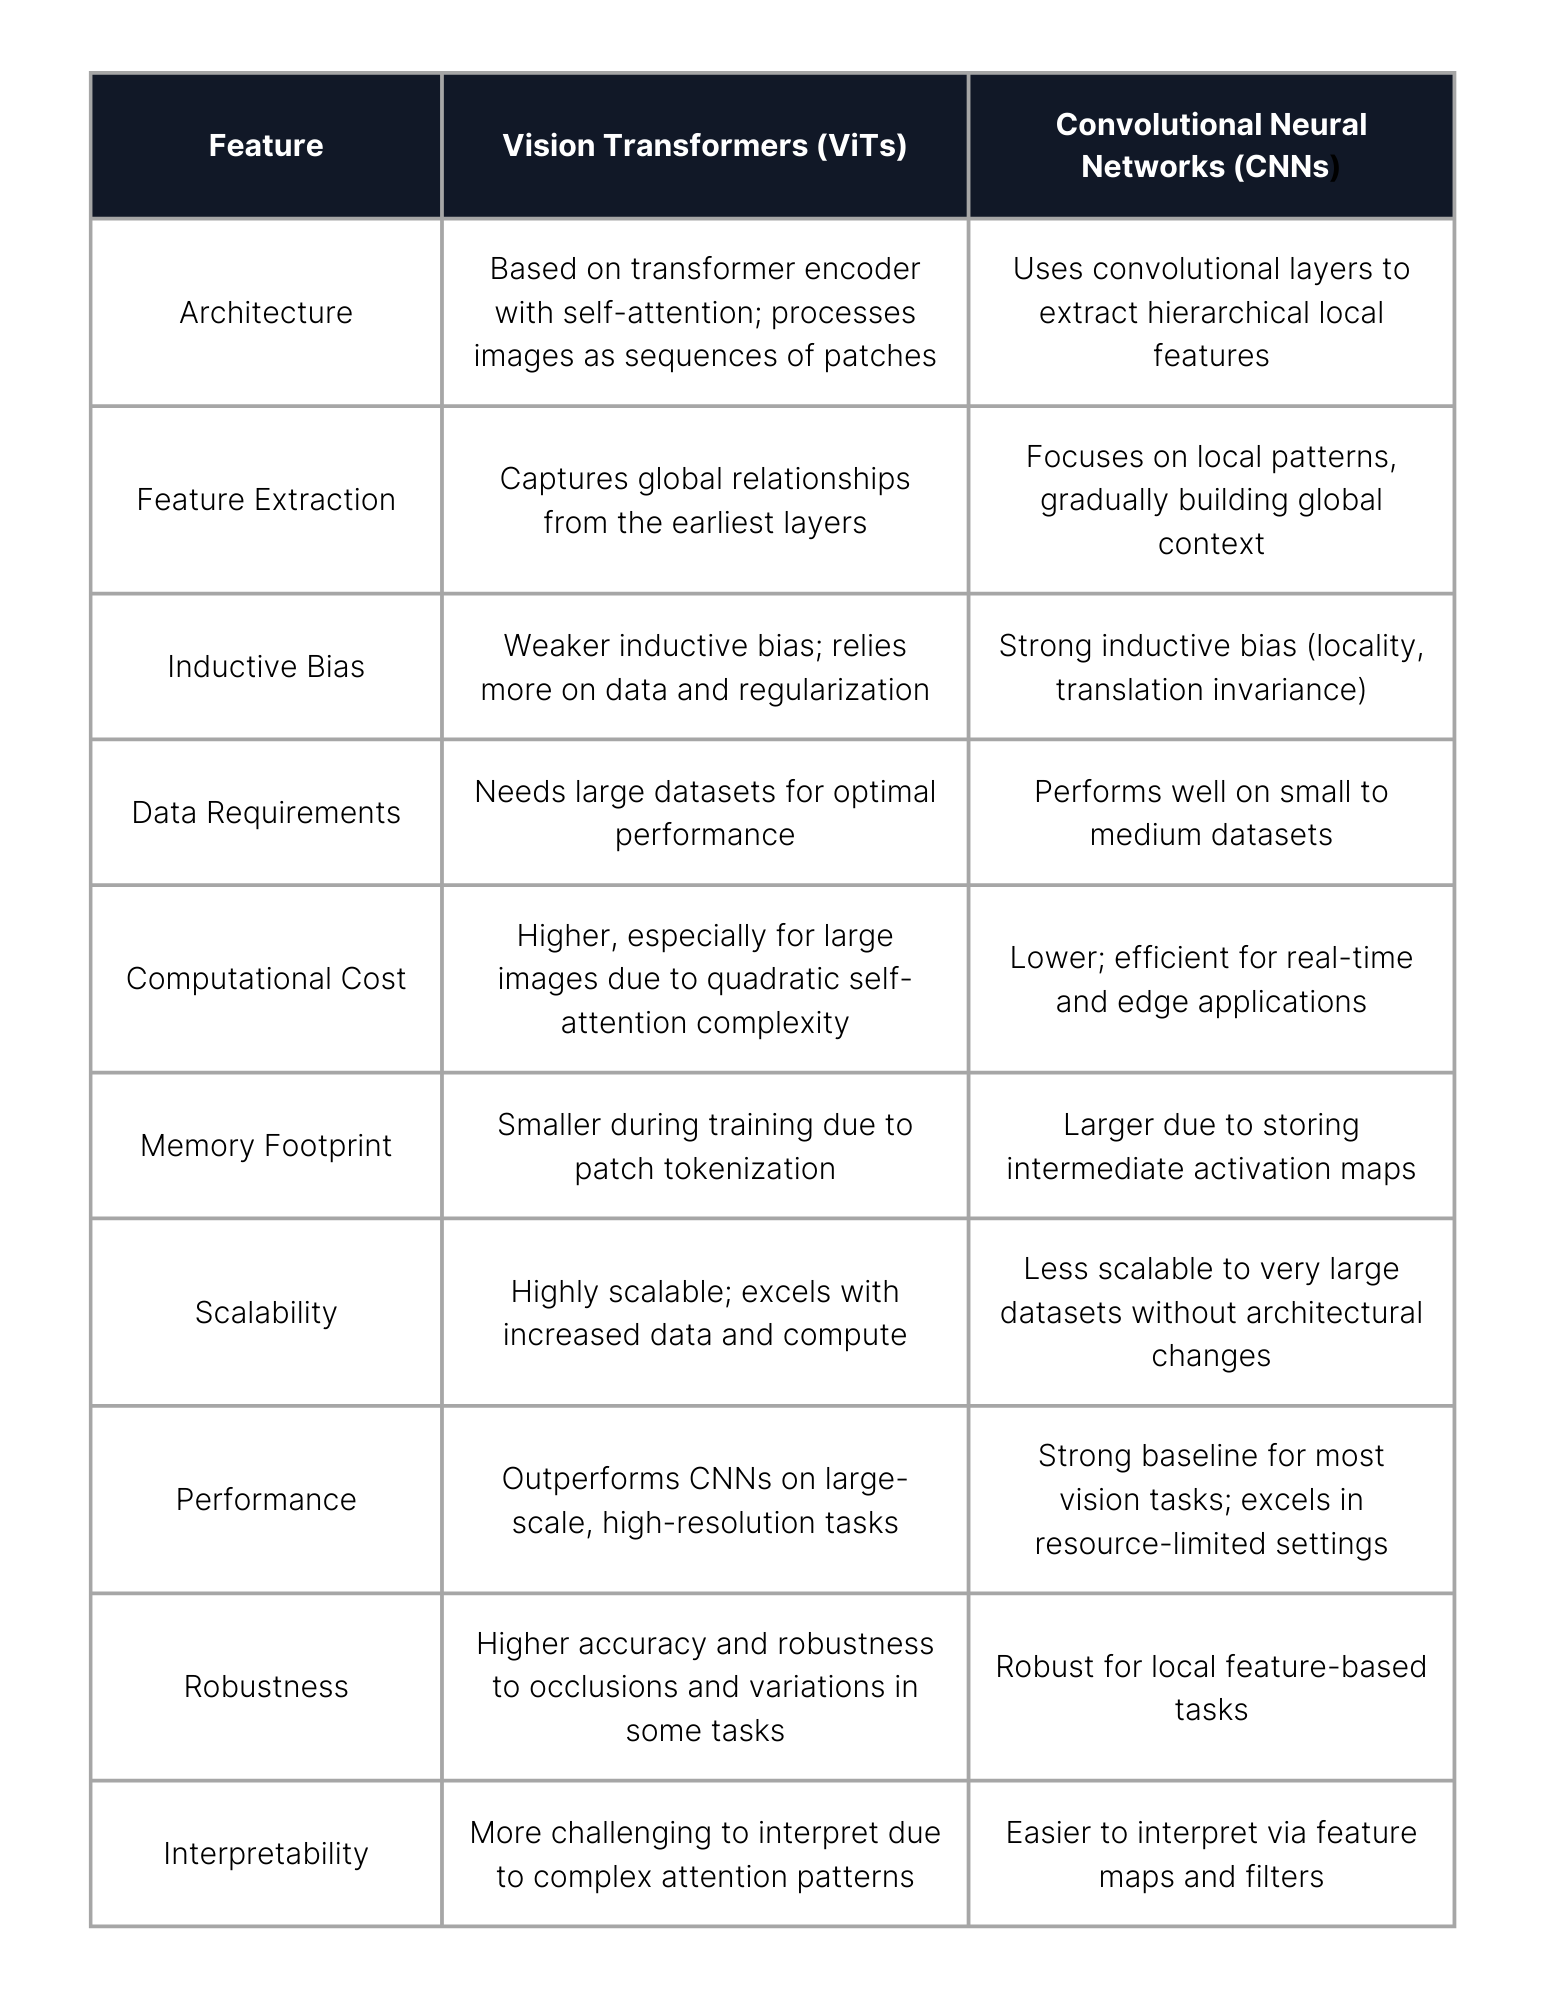
Vision Transformers Explained: The Future of Computer Vision?

Building a Vision Transformer from Scratch in PyTorch 🔥 - DEV Community