
Table 10 From Towards Local Visual Modeling For Image Captioning

Table 10 from Towards Local Visual Modeling for Image Captioning ...

Table 12 from Towards Local Visual Modeling for Image Captioning ...

Table 13 from Towards Local Visual Modeling for Image Captioning ...

Table 4 from Towards Local Visual Modeling for Image Captioning ...

Table 7 from Towards Local Visual Modeling for Image Captioning ...

Table 6 from Towards Local Visual Modeling for Image Captioning ...

Table 11 from Towards Local Visual Modeling for Image Captioning ...

Figure 1 from Towards Local Visual Modeling for Image Captioning ...

Figure 1 from Towards Local Visual Modeling for Image Captioning ...
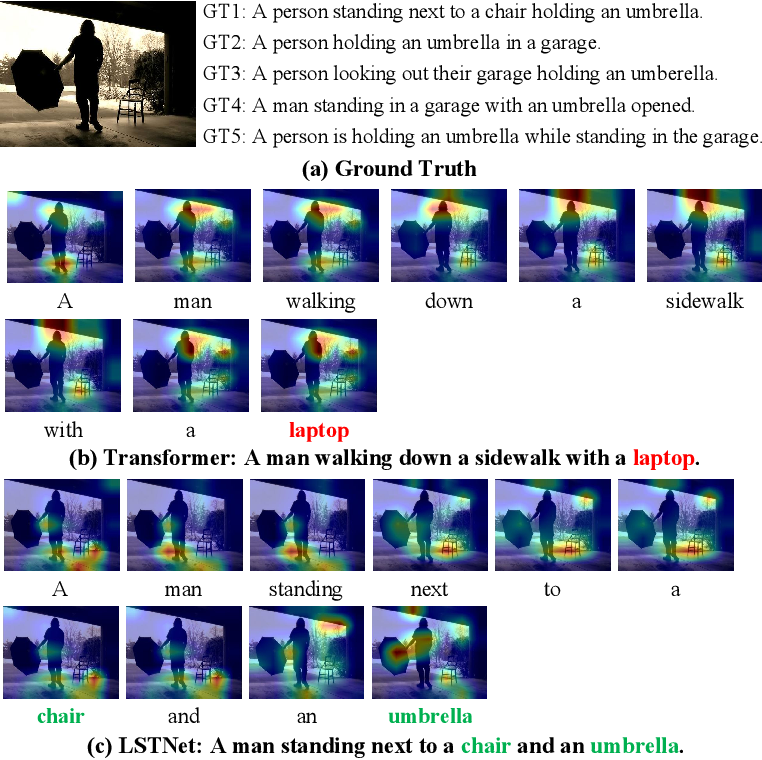
Figure 6 from Towards Local Visual Modeling for Image Captioning ...
Advertisement Space (300x250)

Figure 1 from Towards Local Visual Modeling for Image Captioning ...

Figure 2 from Towards Local Visual Modeling for Image Captioning ...

Towards Local Visual Modeling For Image Captioning | PDF

[2302.06098] Towards Local Visual Modeling for Image Captioning

GitHub - xmu-xiaoma666/LSTNet: Towards Local Visual Modeling for Image ...

Figure 1 from Efficient Modeling of Future Context for Image Captioning ...

Table 1 from Explore and Tell: Embodied Visual Captioning in 3D ...
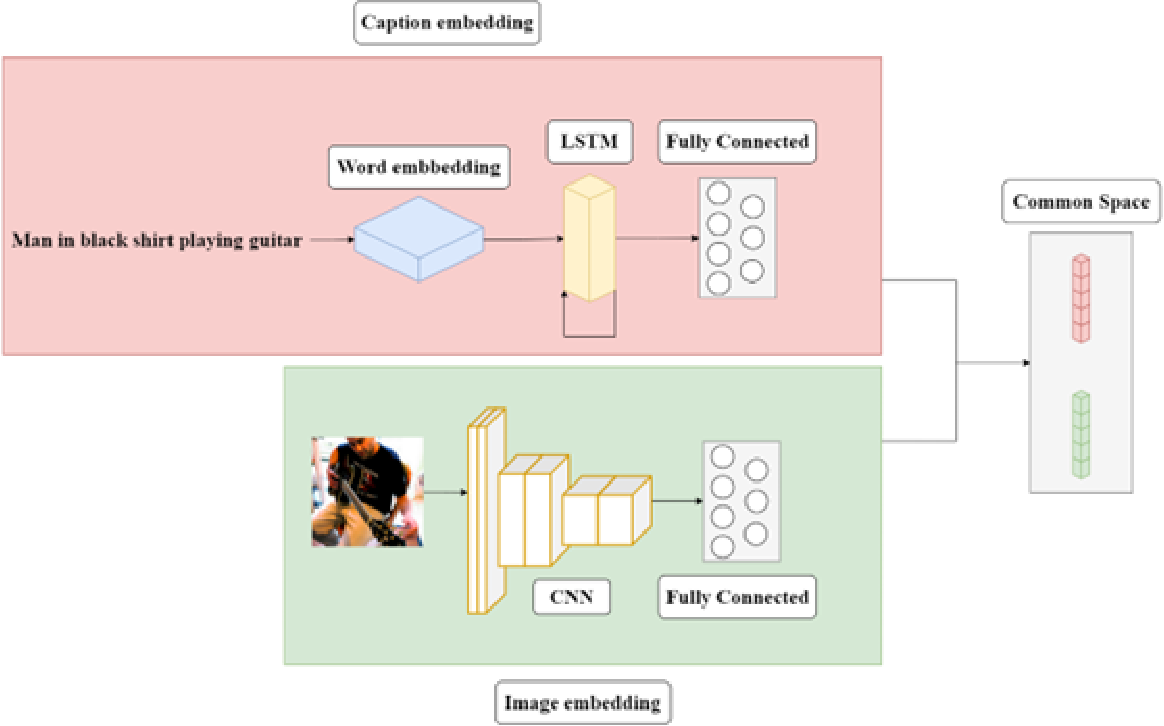
Figure 8 from Multi-modal reward for visual relationships-based image ...
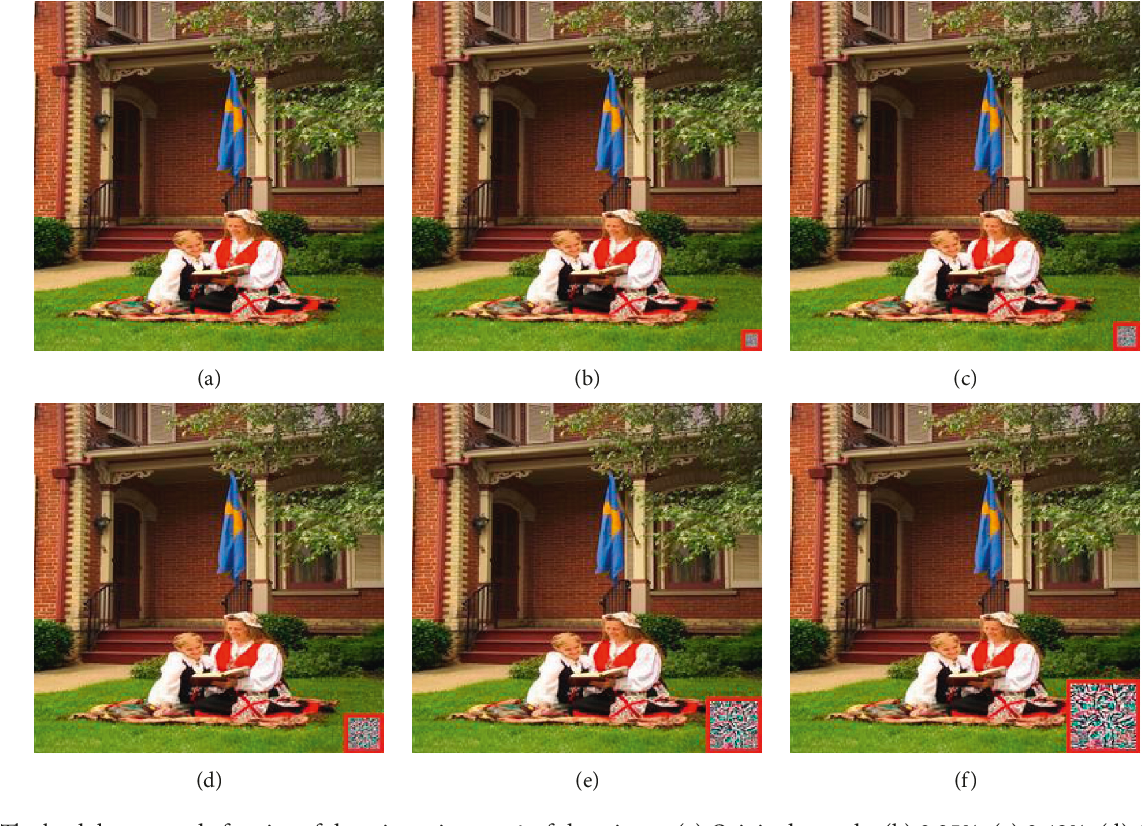
Figure 3 from Toward Backdoor Attacks for Image Captioning Model in ...
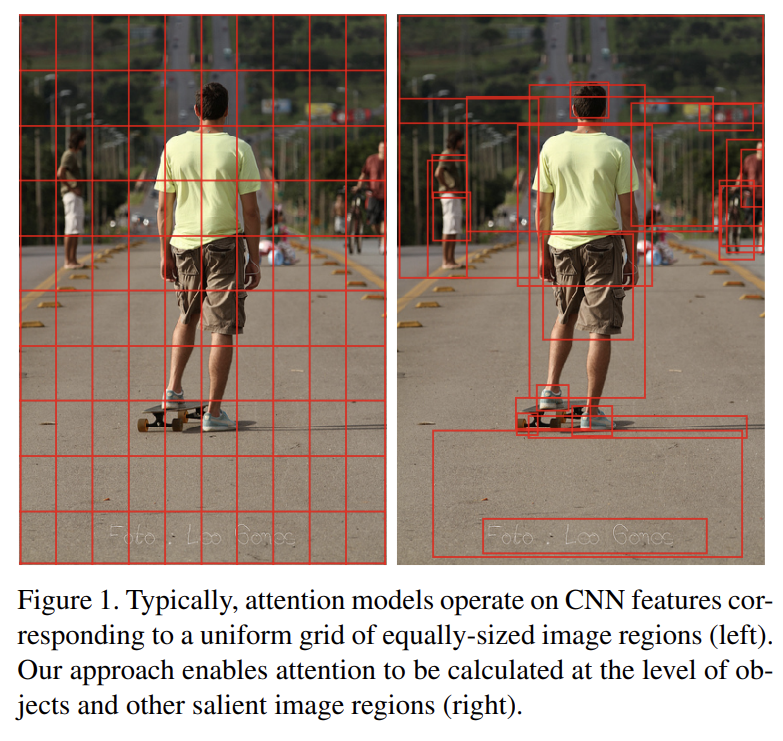
Bottom-Up and Top-Down Attention for Image Captioning and Visual ...
Advertisement Space (336x280)

Exploring Visual Relationship for Image Captioning

Diagram for the Visual Attention Image Captioning Model Architecture ...

Figure 1 from Toward Backdoor Attacks for Image Captioning Model in ...

Diagram for the Visual Attention Image Captioning Model Architecture ...
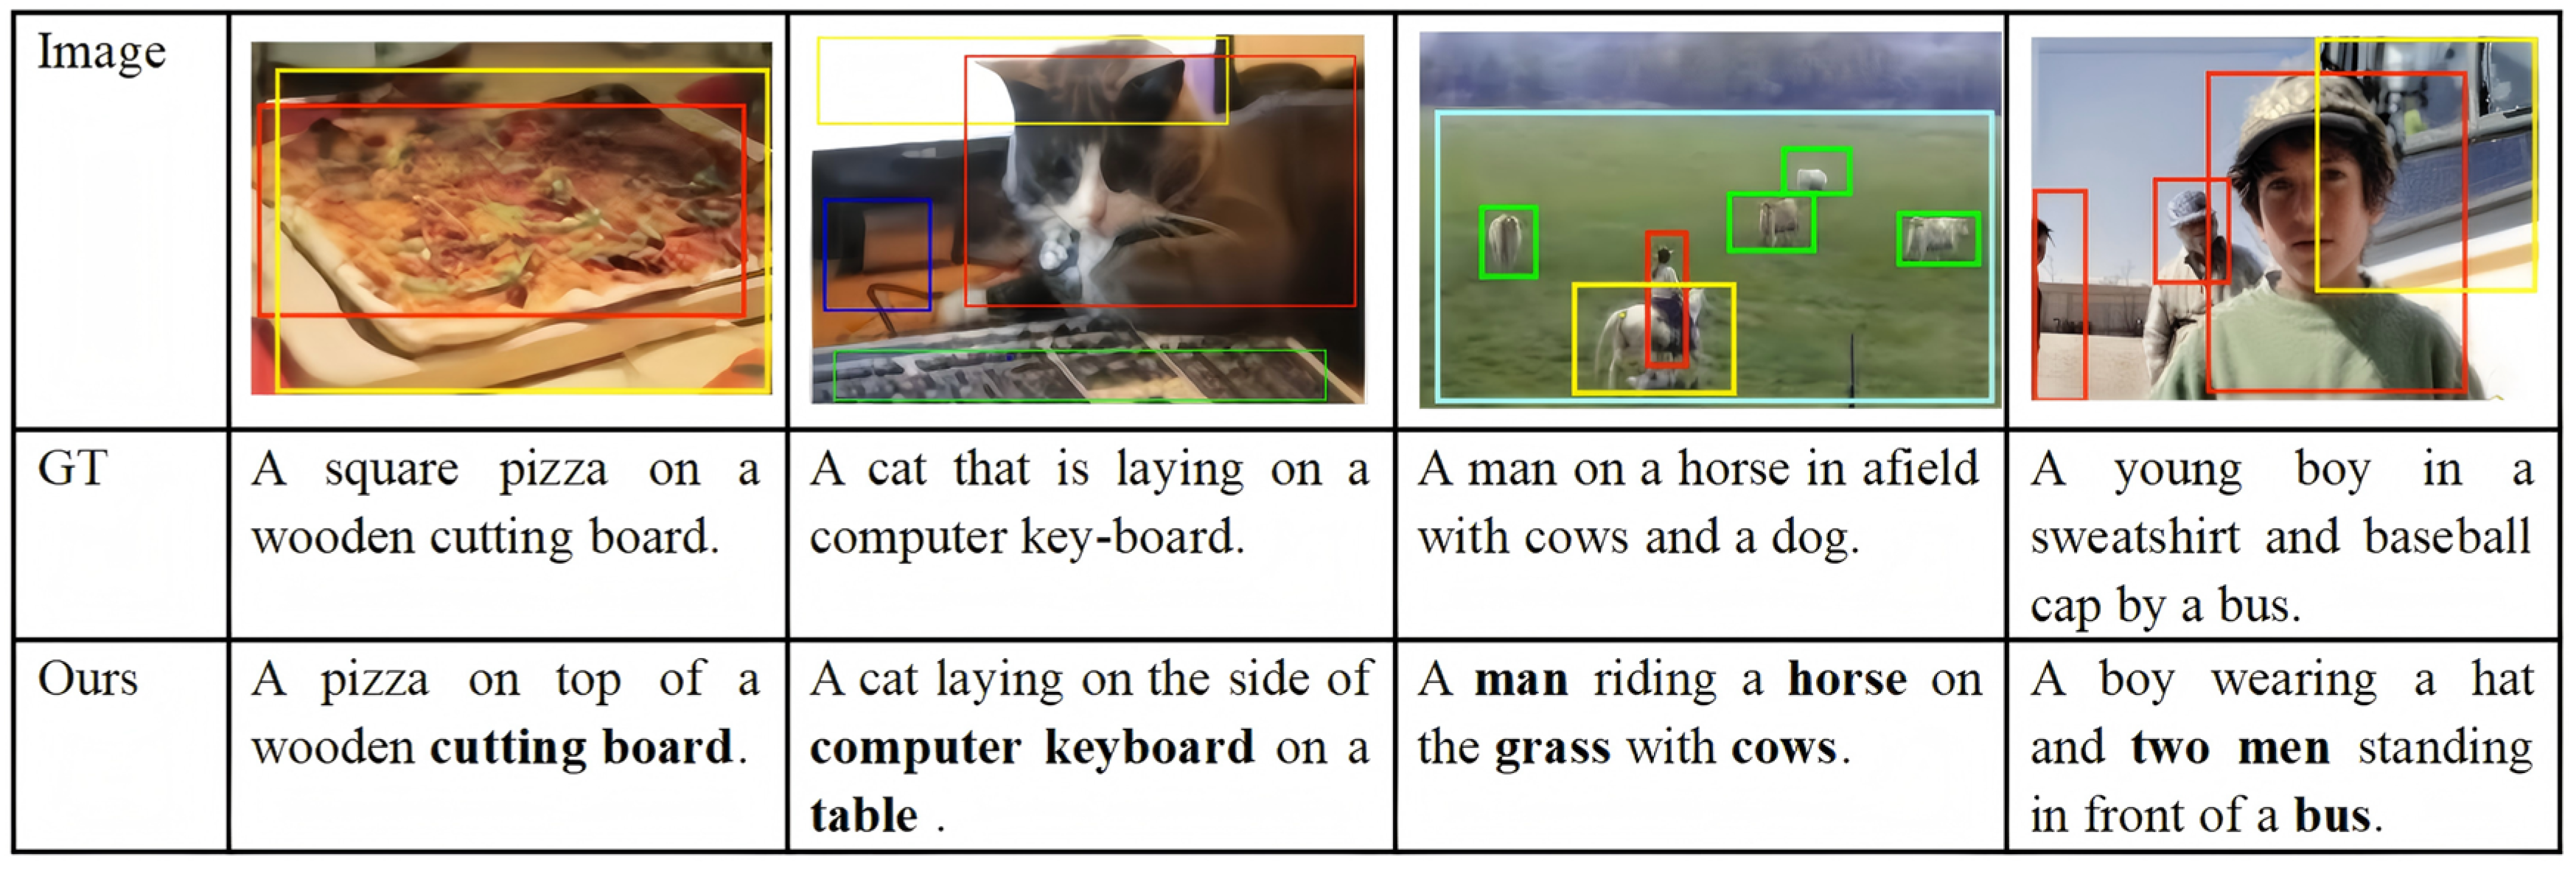
Image Captioning Method Based on CLIP-Combined Local Feature ...

Image Captioning Method Based on CLIP-Combined Local Feature ...

Table 2 from Vid2Seq: Large-Scale Pretraining of a Visual Language ...
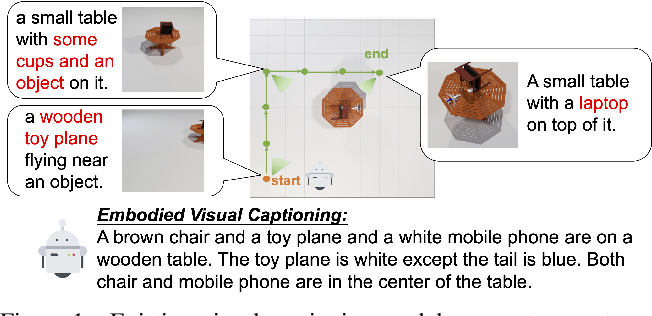
Figure 1 from Explore and Tell: Embodied Visual Captioning in 3D ...

Image Captioning by Translational Visual-to-Language Models | Towards ...

Table 3 from Vid2Seq: Large-Scale Pretraining of a Visual Language ...
Advertisement Space (336x280)

Table Showing Examples of Image Captioning and their Limit to fully de ...

Learning Visual Relation Priors for Image-Text Matching and Image ...

Visual-Text Reference Pretraining Model for Image Captioning - PMC

(PDF) A Concise and Varied Visual Features-Based Image Captioning Model ...

Visual‐Text Reference Pretraining Model for Image Captioning - Li ...
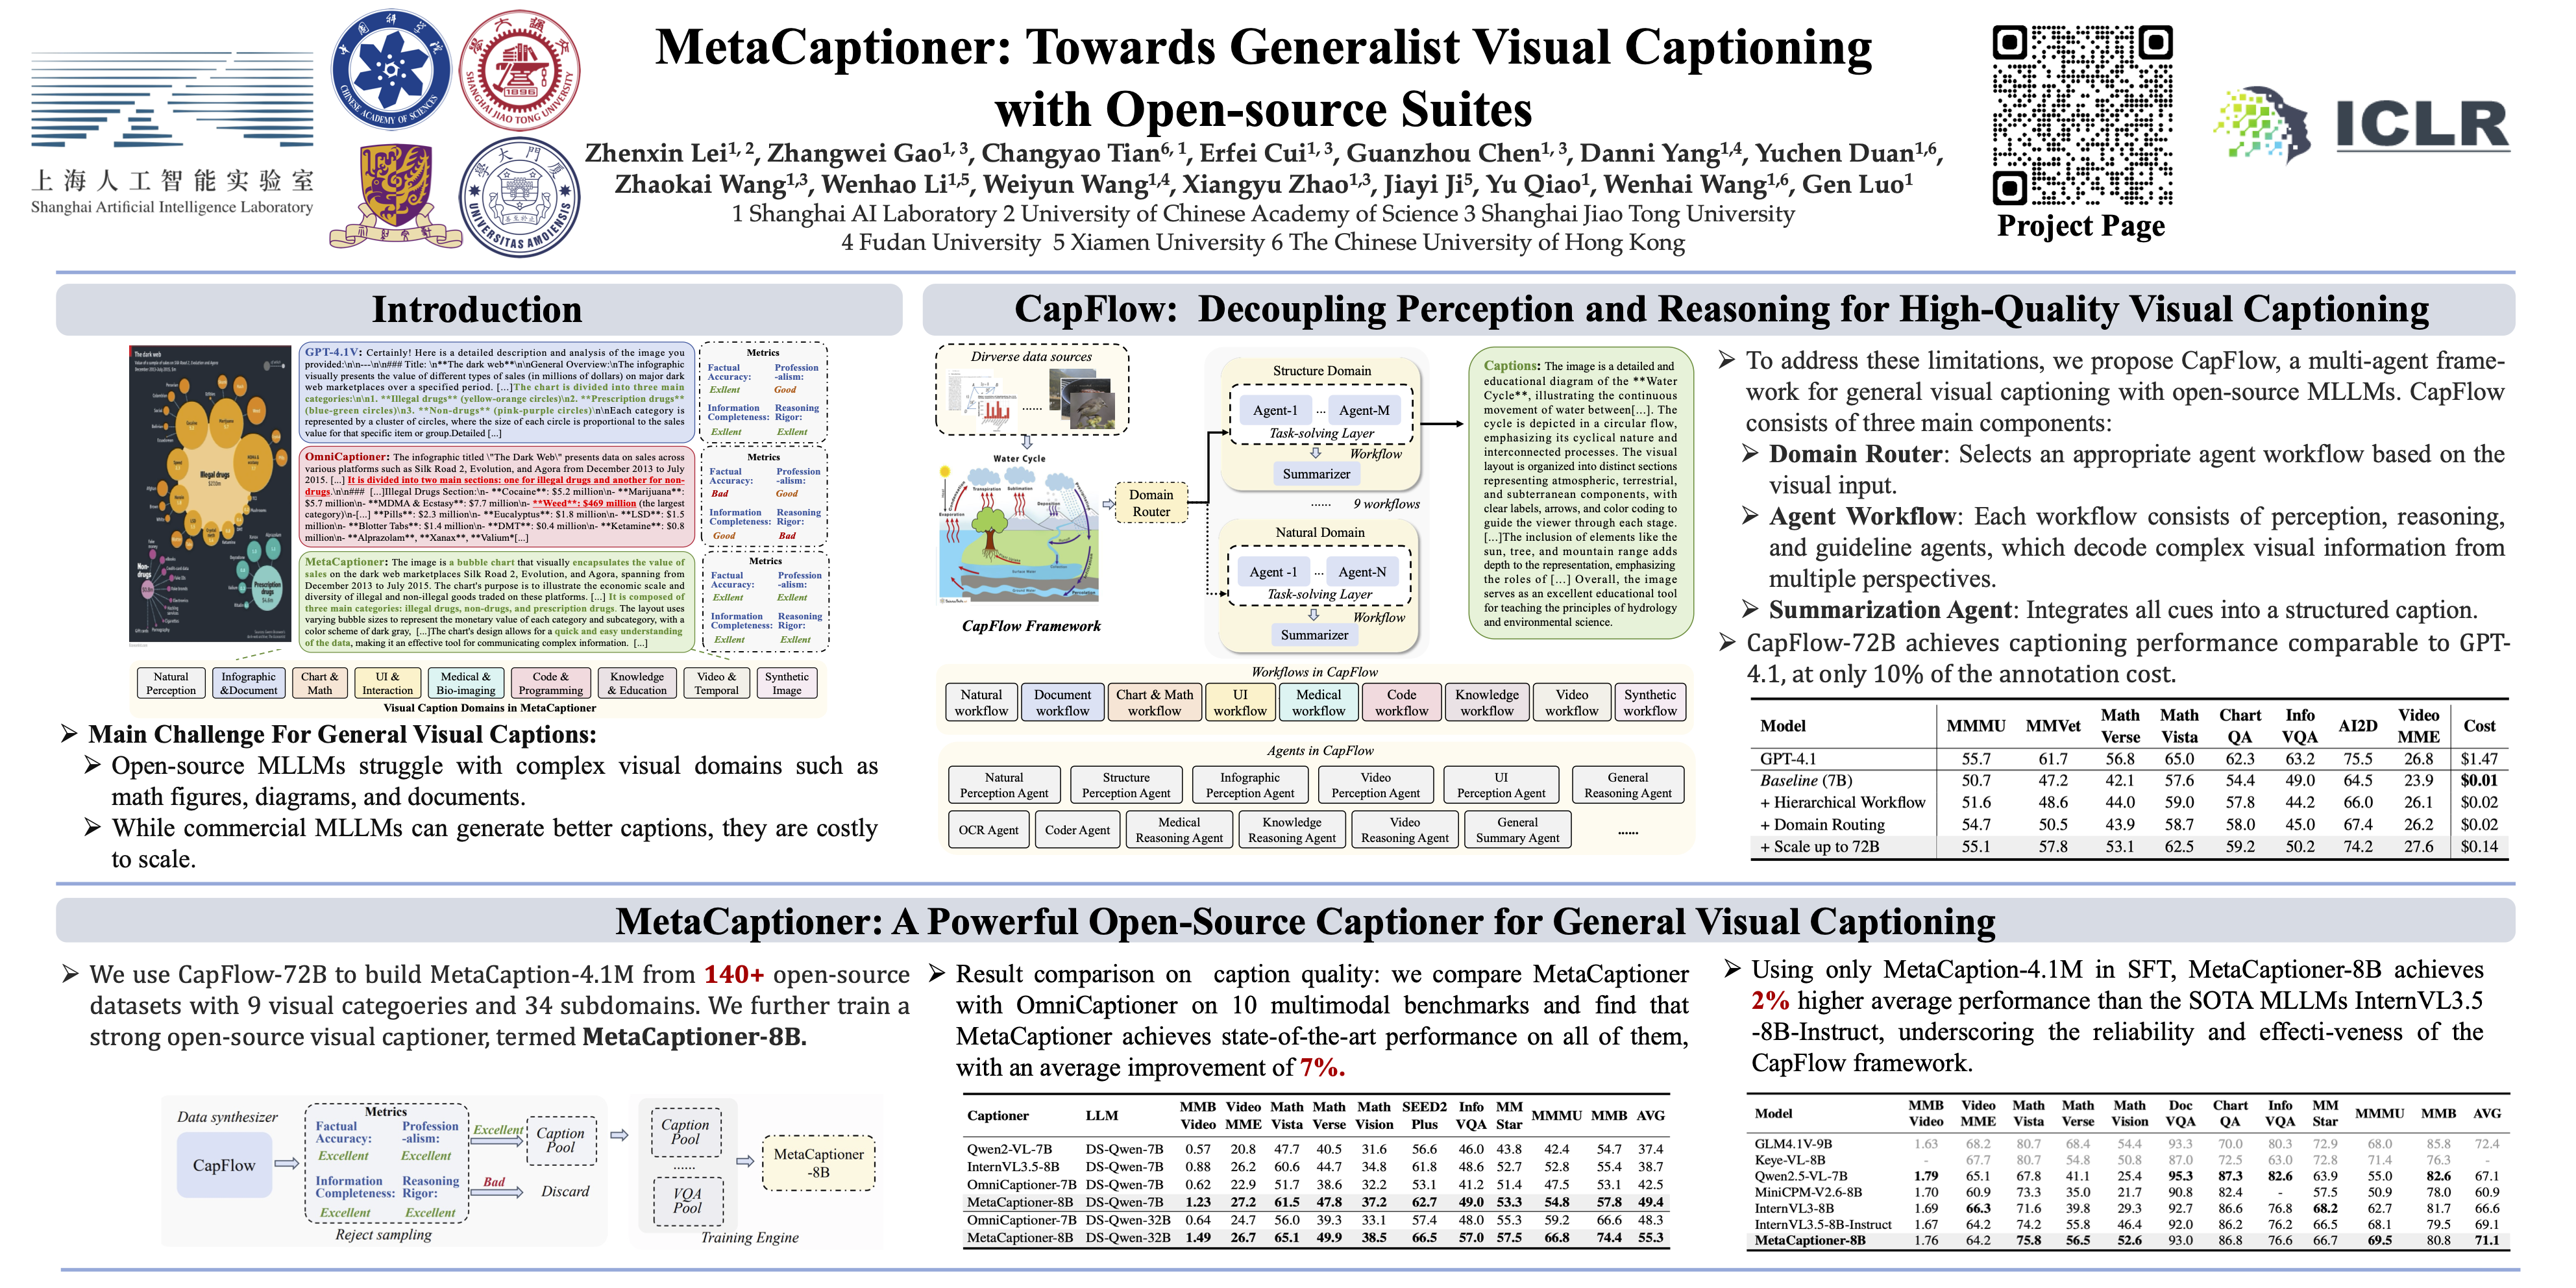
ICLR Poster MetaCaptioner: Towards Generalist Visual Captioning with ...