
Table 2 From Cross Modal Semantic Alignment Before Fusion For Two Pass

Table 2 from Cross-Modal Semantic Alignment before Fusion for Two-Pass ...

Figure 2 from Cross-Modal Semantic Alignment before Fusion for Two-Pass ...
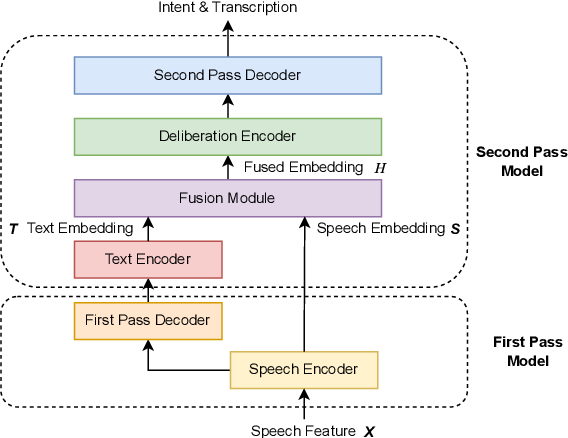
Figure 1 from Cross-Modal Semantic Alignment before Fusion for Two-Pass ...

Table 2 from Cross-Modal and Uni-Modal Soft-Label Alignment for Image ...

Table 2 from Cross-Modal Hybrid Feature Fusion for Image-Sentence ...

Table 2 from Uncertainty-Aware Cross-Modal Alignment for Hate Speech ...

Table 2 from Multi-Granularity Cross-modal Alignment for Generalized ...

Table 2 from A Cross-Modality Context Fusion and Semantic Refinement ...
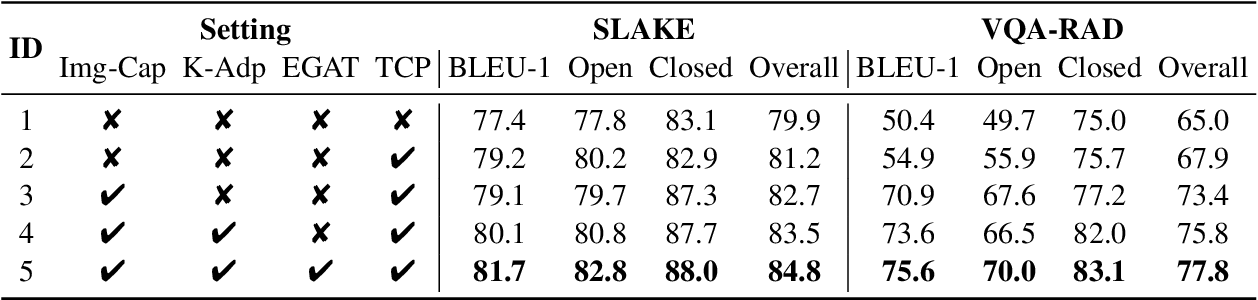
Table 2 from Multi-modal Concept Alignment Pre-training for Generative ...

Figure 2 from Cross-Modal and Uni-Modal Soft-Label Alignment for Image ...
Advertisement Space (300x250)

Figure 2 from A Multimodal Semantic Fusion Network with Cross-Modal ...

Figure 1 from CA_DeepSC: Cross-Modal Alignment for Multi-Modal Semantic ...

Table 2 from Cross-modal Generation and Alignment via Attribute-guided ...
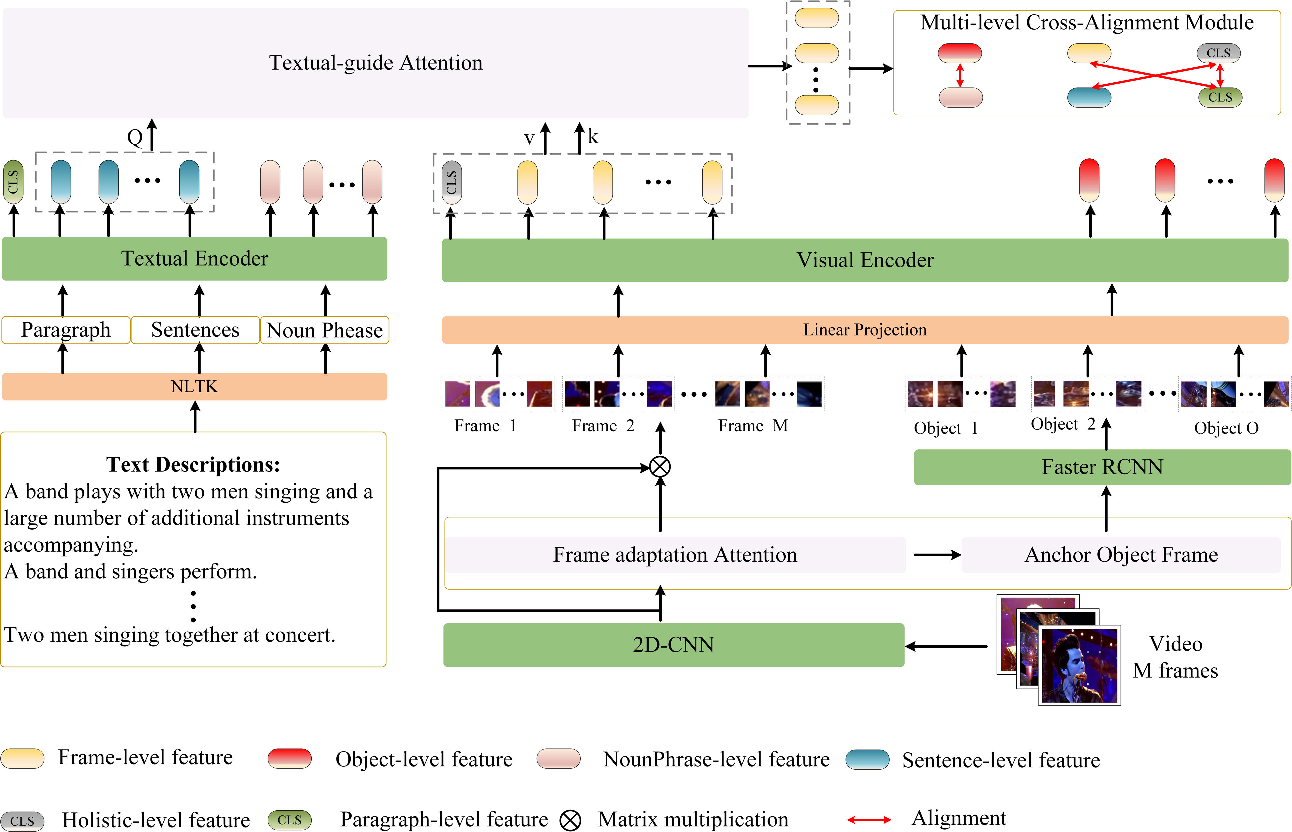
Figure 4 from Multilevel Semantic Interaction Alignment for Video–Text ...
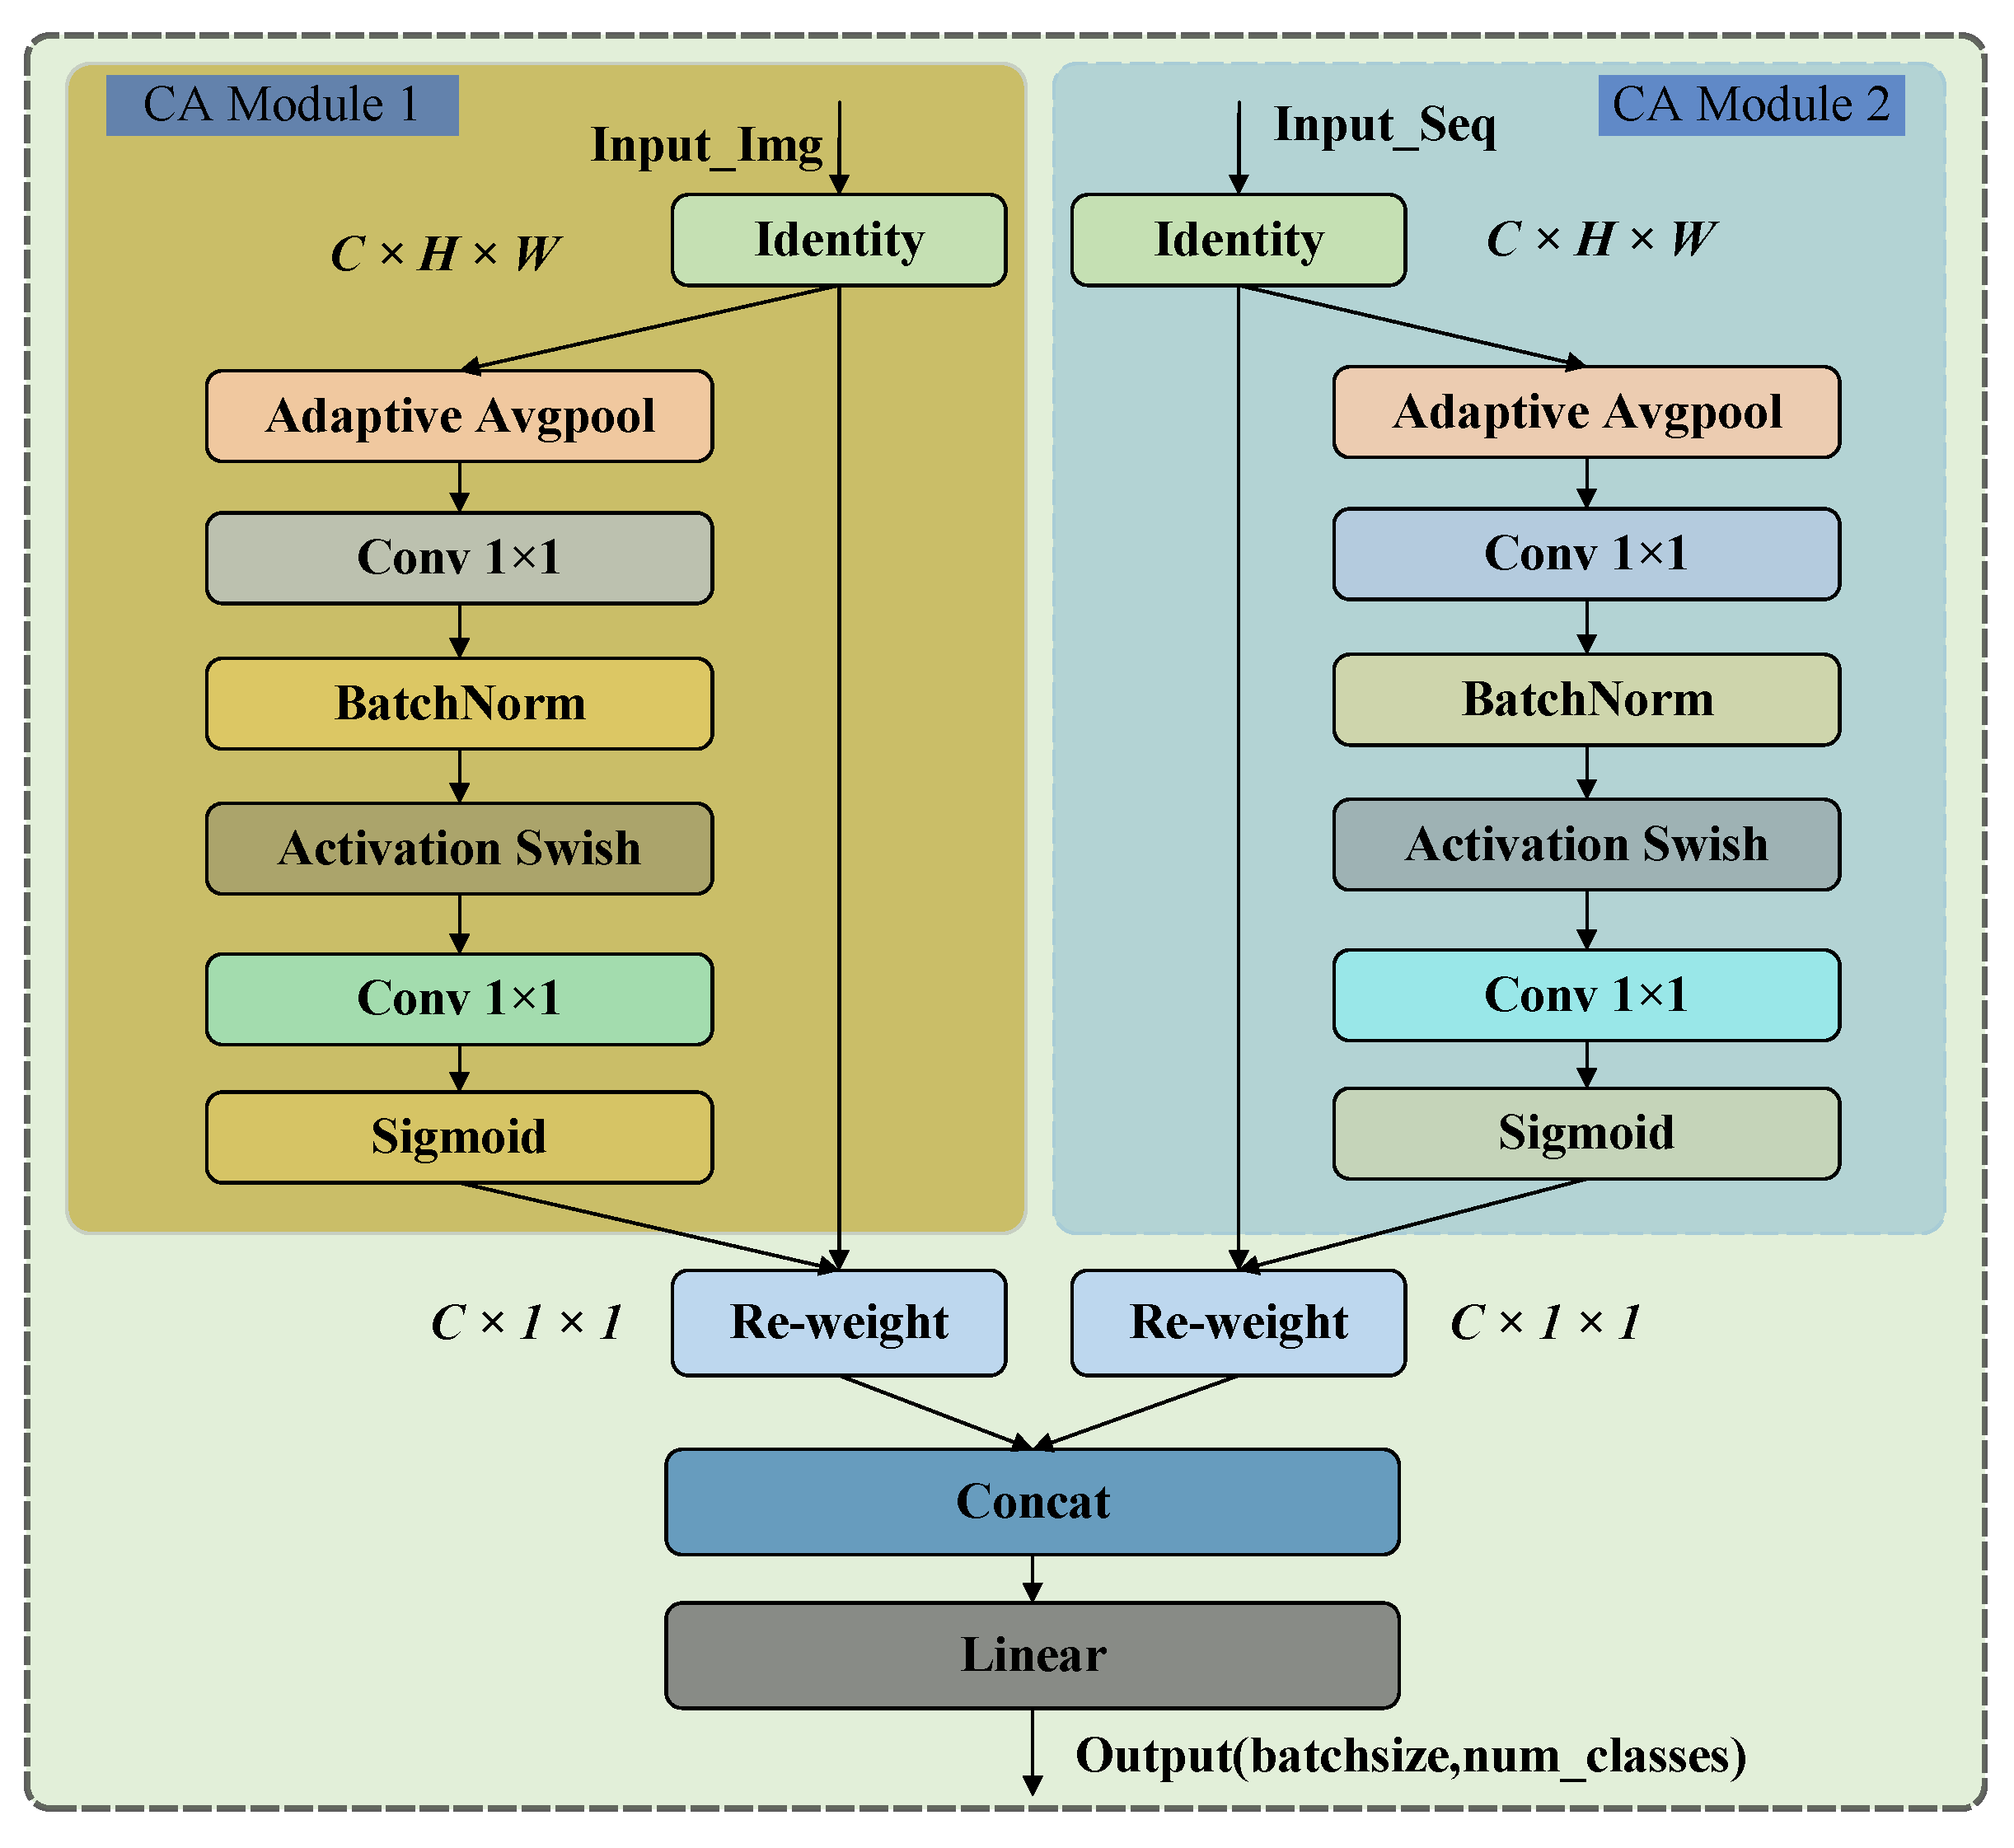
A Cross-Modal Semantic Alignment and Feature Fusion Method for Bionic ...

Table 5 from Cross-Modal and Uni-Modal Soft-Label Alignment for Image ...
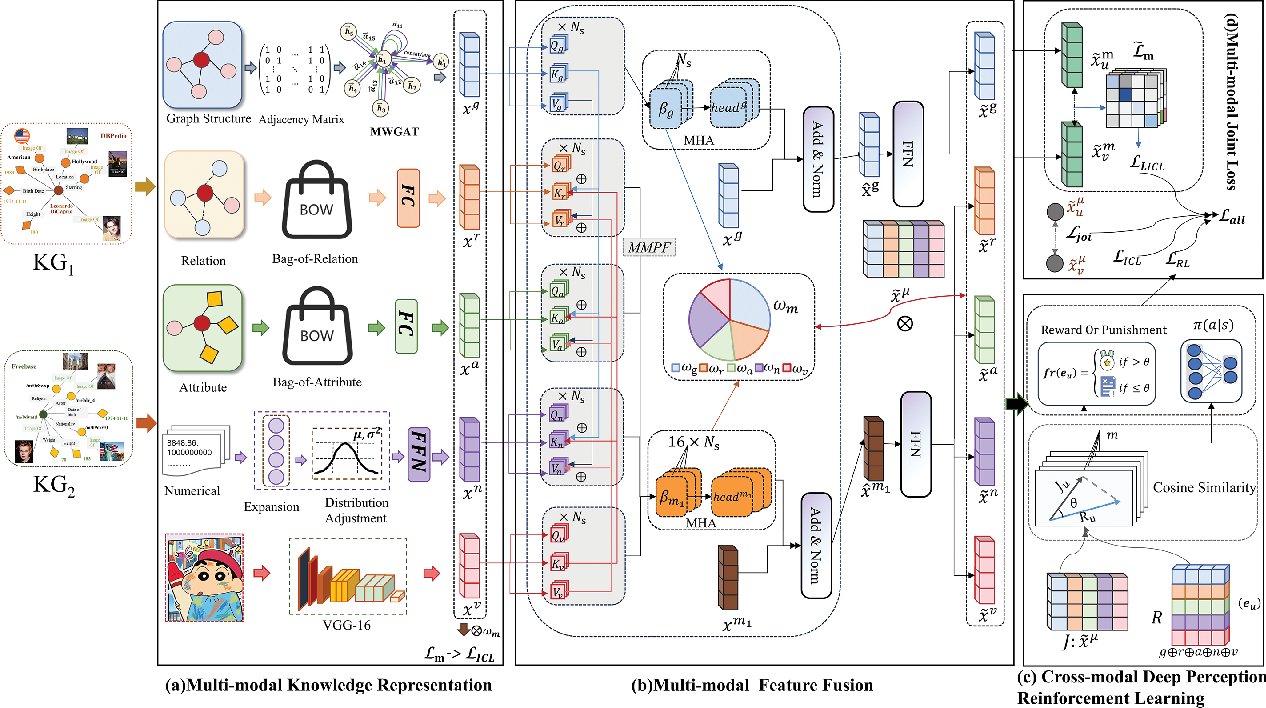
Figure 2 from Multi-Modal Pre-Synergistic Fusion Entity Alignment Based ...

Figure 1 from Dual Semantic Fusion Hashing for Multi-Label Cross-Modal ...

Figure 1 from Cross-modal Feature Alignment and Fusion for Composed ...

Figure 1 from Discrete Joint Semantic Alignment Hashing for Cross-Modal ...
Advertisement Space (336x280)

(PDF) A Cross-Modal Semantic Alignment and Feature Fusion Method for ...

Figure 1 from Cross-modal Feature Alignment and Fusion for Composed ...

Figure 2 from DELAN: Dual-Level Alignment for Vision-and-Language ...

Table II from A Multi-Level Alignment and Cross-Modal Unified Semantic ...

Figure 2 from Semantics-Enriched Cross-Modal Alignment for Complex ...
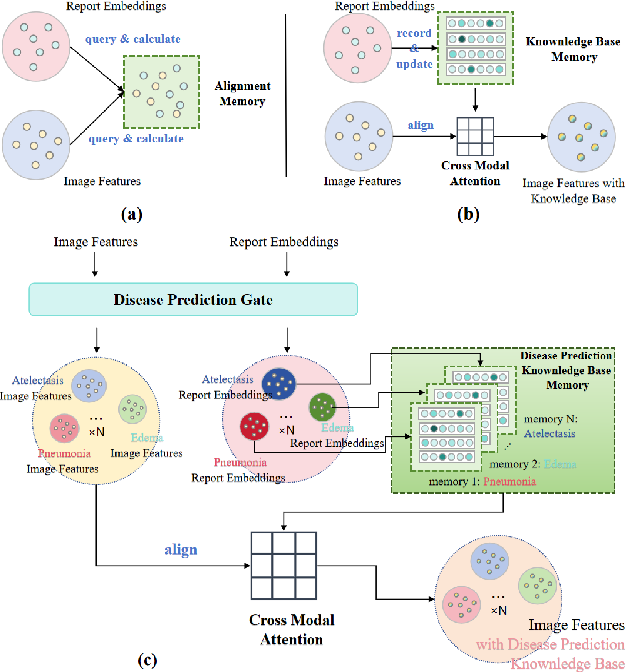
Figure 1 from Adaptive Semantic Alignment for Automated Radiology ...

Table 2 from From Feature Alignment to Multimodal Fusion: A Two-Stage ...
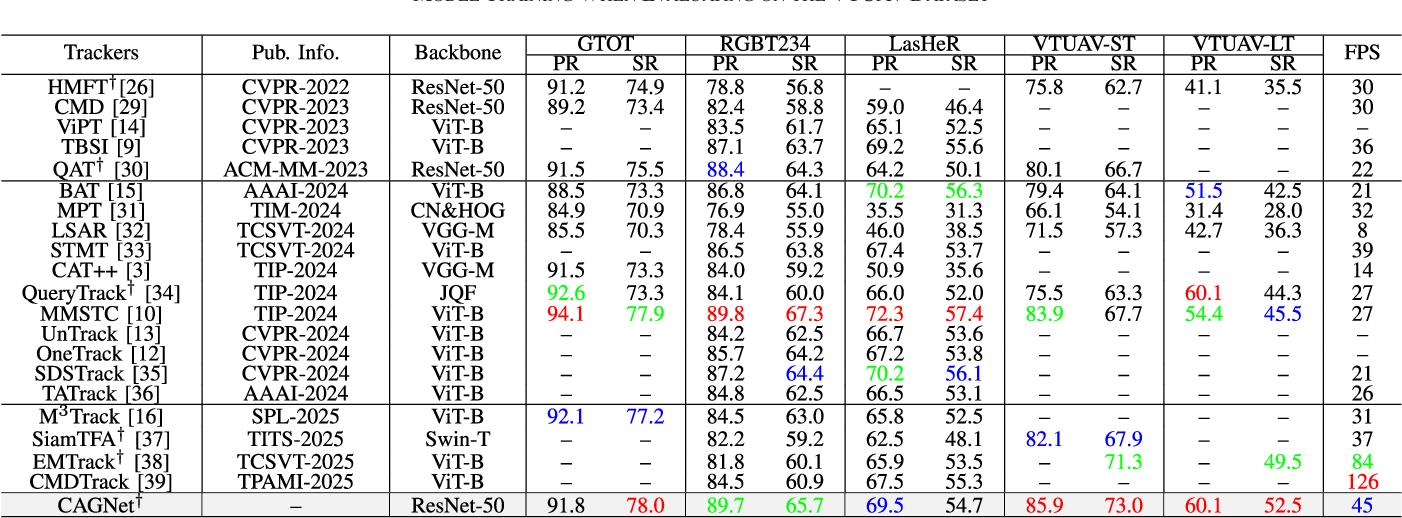
Table II from Cross-Modal Attention Guided Enhanced Fusion Network for ...

Figure 2 from Cross-Modality Gated Attention Fusion for Multimodal ...
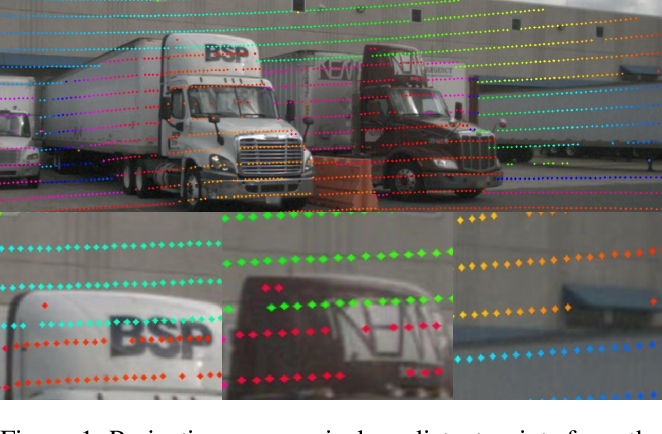
Figure 1 from Look Before You Fuse: 2D-Guided Cross-Modal Alignment for ...
Advertisement Space (336x280)

Table VII from Cross-modal Offset-guided Dynamic Alignment and Fusion ...

A Multimodal Semantic Fusion Network with Cross-Modal Alignment for ...
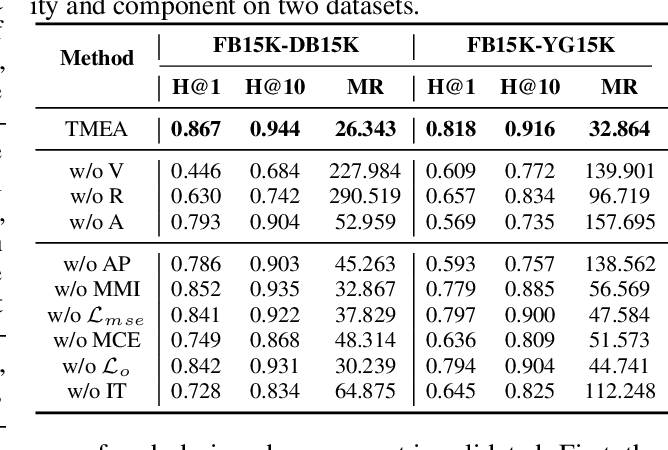
Table 2 from Tackling Uncertain Correspondences for Multi-Modal Entity ...

Table V from A Multi-Level Alignment and Cross-Modal Unified Semantic ...

Unsupervised multi-perspective fusing semantic alignment for cross ...

A Multimodal Semantic Fusion Network with Cross-Modal Alignment for ...