
Table 2 From What Makes Pre Trained Language Models Better Zerofew

Table 2 from What Makes Pre-trained Language Models Better Zero/Few ...

Table 2 from What Makes Pre-trained Language Models Better Zero-shot ...

Table 1 from What Makes Pre-trained Language Models Better Zero-shot ...

Table 11 from What Makes Pre-trained Language Models Better Zero-shot ...

Table 10 from What Makes Pre-trained Language Models Better Zero-shot ...

Table 5 from What Makes Pre-trained Language Models Better Zero-shot ...

Figure 2 from What Makes Pre-trained Language Models Better Zero-shot ...

Table 2 from Differentiable Prompt Makes Pre-trained Language Models ...

Table 2 from Making Pre-trained Language Models Better Few-shot ...
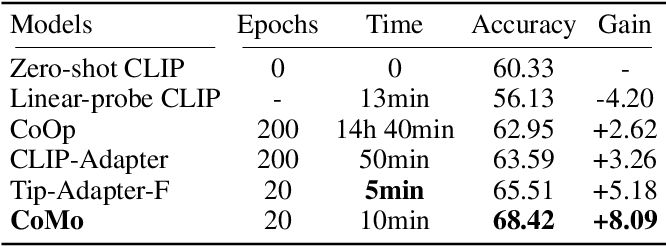
Table 2 from Collaboration of Pre-trained Models Makes Better Few-shot ...
Advertisement Space (300x250)

Figure 1 from What Makes Pre-trained Language Models Better Zero-shot ...

Figure 3 from What Makes Pre-trained Language Models Better Zero-shot ...

Table 2 from Making Pre-trained Language Models End-to-end Few-shot ...

Table 3 from Making Pre-trained Language Models Better Few-shot ...

What Makes Pre-trained Language Models Better Zero-shot Learners? - ACL ...

What Makes Pre-trained Language Models Better Zero/Few-shot Learners?

Figure 2 from Making Pre-trained Language Models Better Continual Few ...
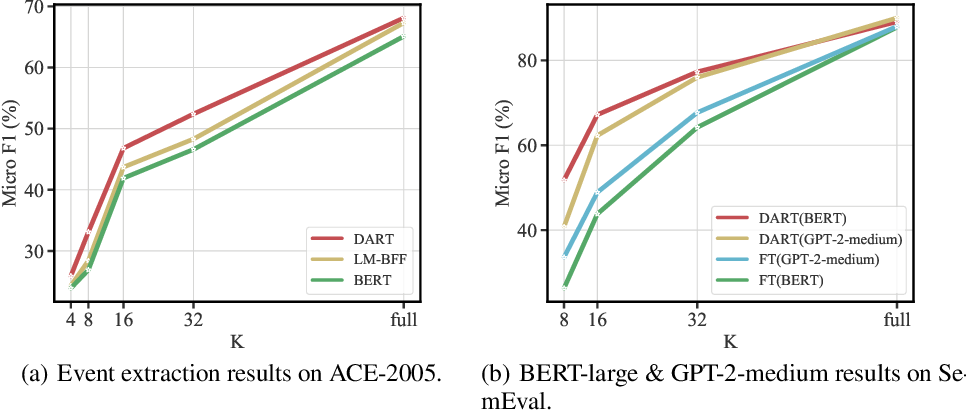
Figure 2 from Differentiable Prompt Makes Pre-trained Language Models ...
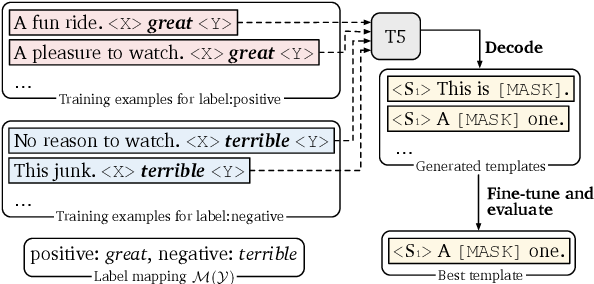
Figure 2 from Making Pre-trained Language Models Better Few-shot ...

Table 2 from Augmenting Pre-trained Language Models with QA-Memory for ...
Advertisement Space (336x280)

Table 2 from Controlling Pre-trained Language Models for Grade-Specific ...

Table 2 from Unleash The Power of Pre-Trained Language Models for ...
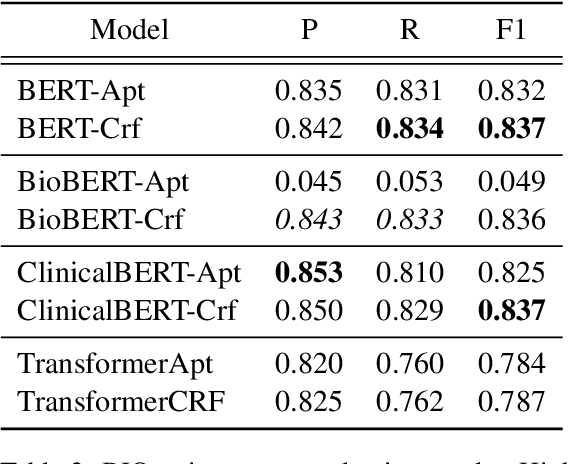
Table 2 from Exploring the Value of Pre-trained Language Models for ...

Table 2 from Making Pre-trained Language Models Great on Tabular ...

Table 2 from Are Large Pre-Trained Language Models Leaking Your ...

Table 2 from Defending Pre-trained Language Models as Few-shot Learners ...
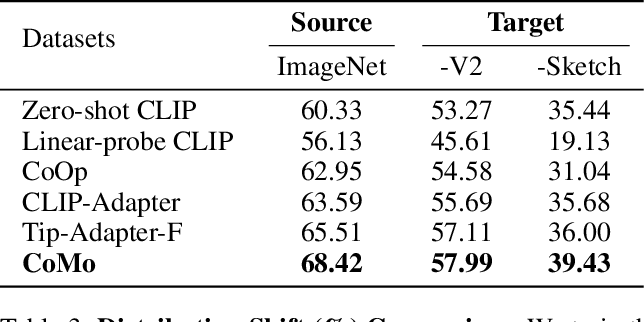
Table 3 from Collaboration of Pre-trained Models Makes Better Few-shot ...
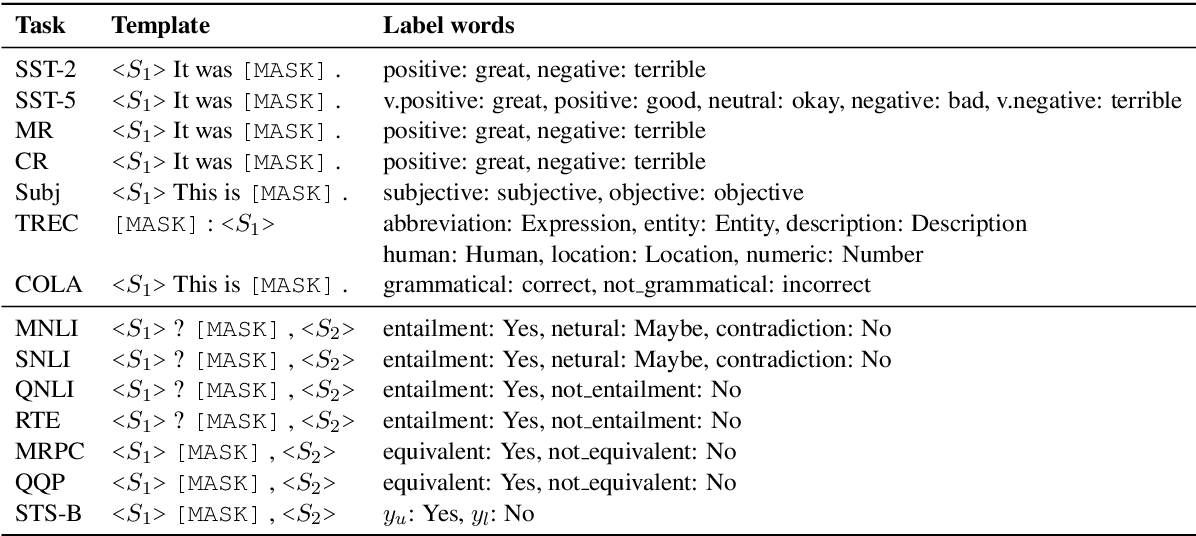
Table 1 from Making Pre-trained Language Models Better Few-shot ...

Table 1 from Making Pre-trained Language Models Better Learn Few-Shot ...

Figure 2 from Making Pre-trained Language Models Better Learn Few-Shot ...
Advertisement Space (336x280)
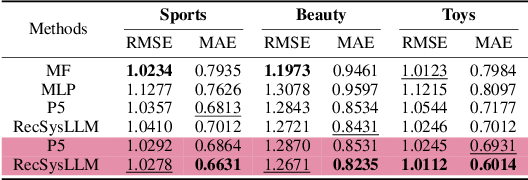
Table 2 from Leveraging Large Language Models for Pre-trained ...

Table 2 from Prompt Learning with Structured Semantic Knowledge Makes ...

Figure 1 from Differentiable Prompt Makes Pre-trained Language Models ...

Figure 2 from Making Pre-trained Language Models End-to-end Few-shot ...
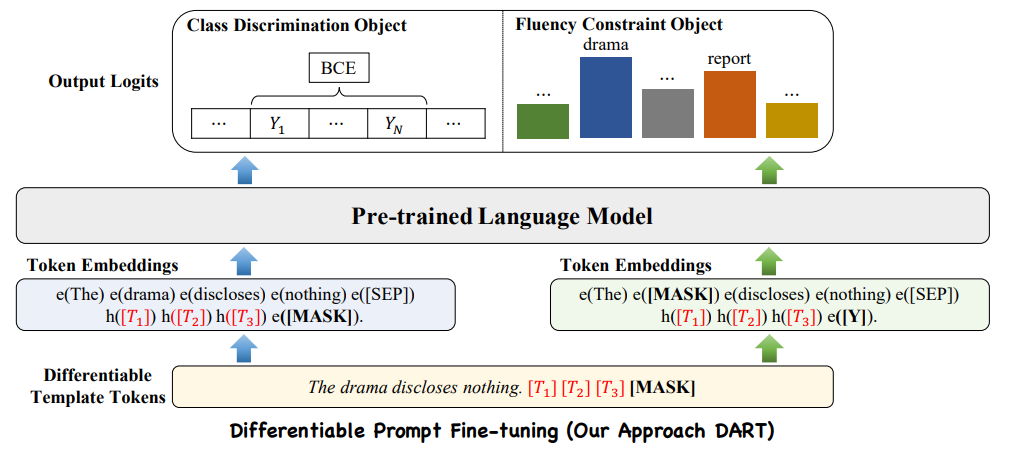
论文笔记:Differentiable Prompt Makes Pre-trained Language Models Better Few ...
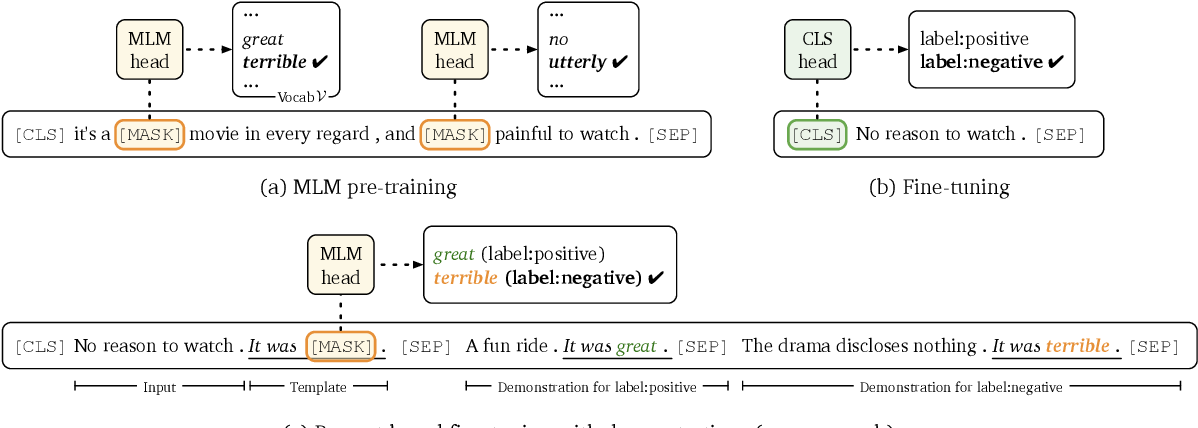
Figure 1 from Making Pre-trained Language Models Better Few-shot ...