
Table I From An Fpga Oriented Quantization Approach For Vision
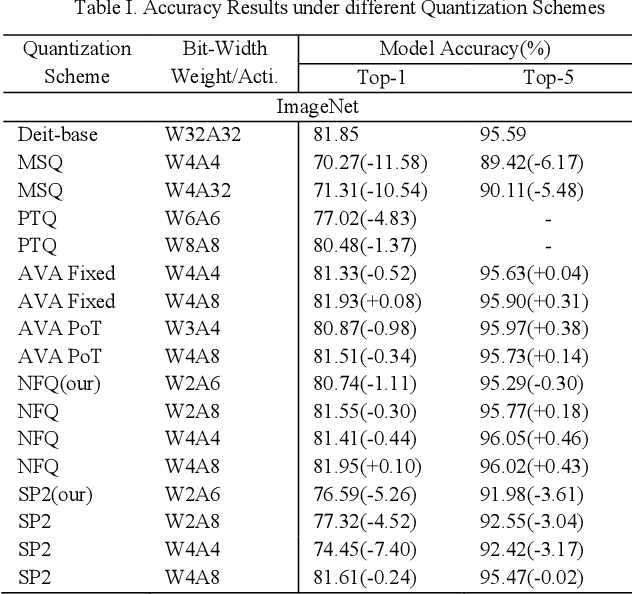
Table I from An FPGA-Oriented Quantization Approach for Vision ...
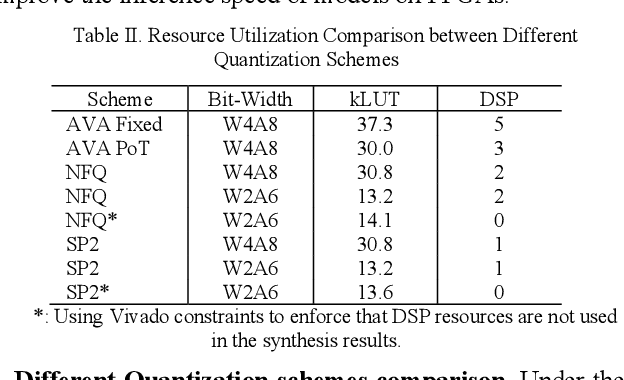
Table II from An FPGA-Oriented Quantization Approach for Vision ...
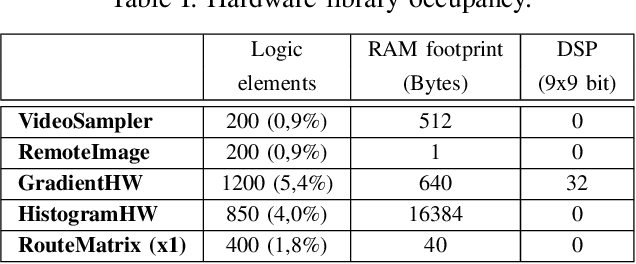
Table I from Reconfigurable FPGA architecture for computer vision ...
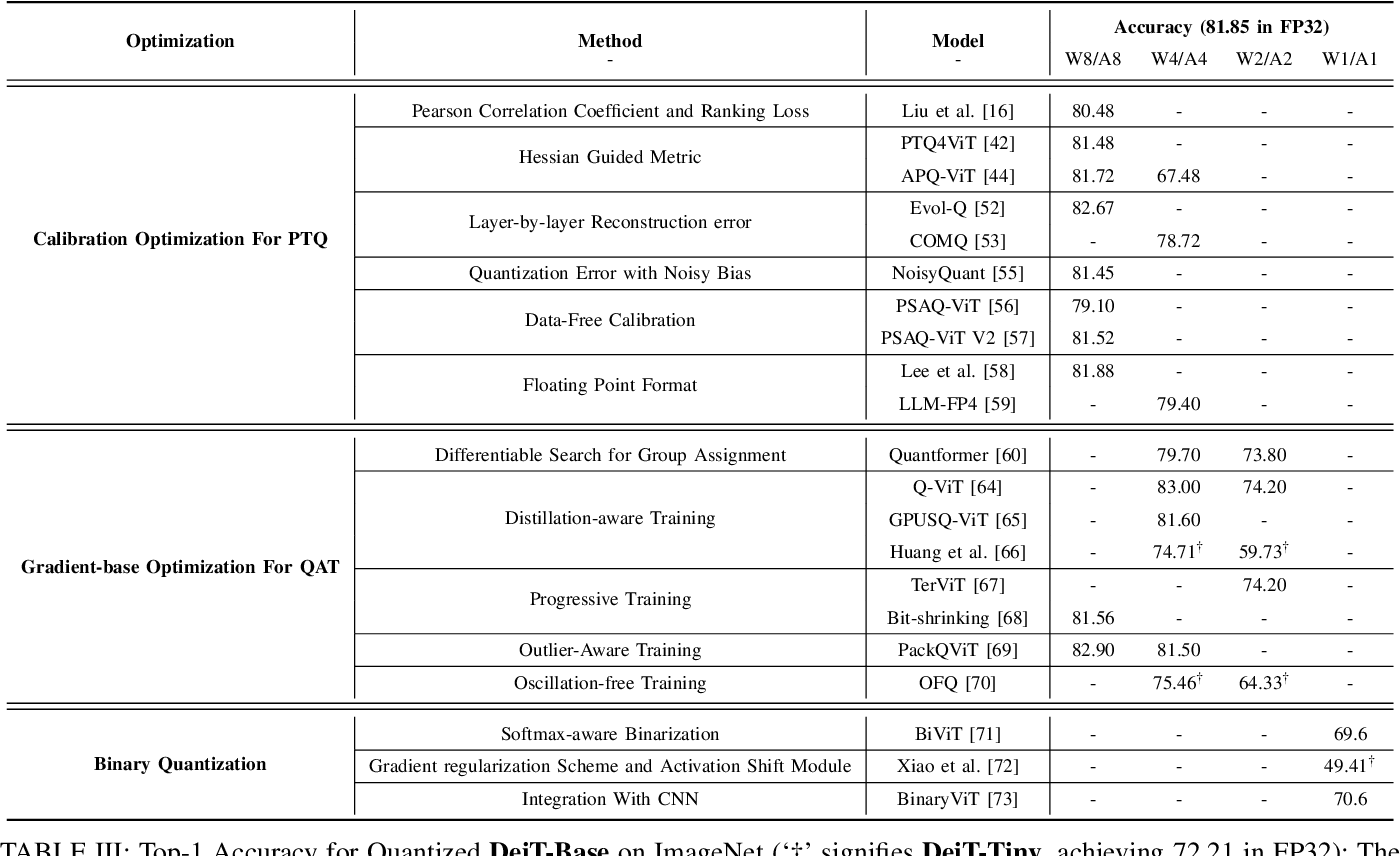
Table III from Model Quantization and Hardware Acceleration for Vision ...
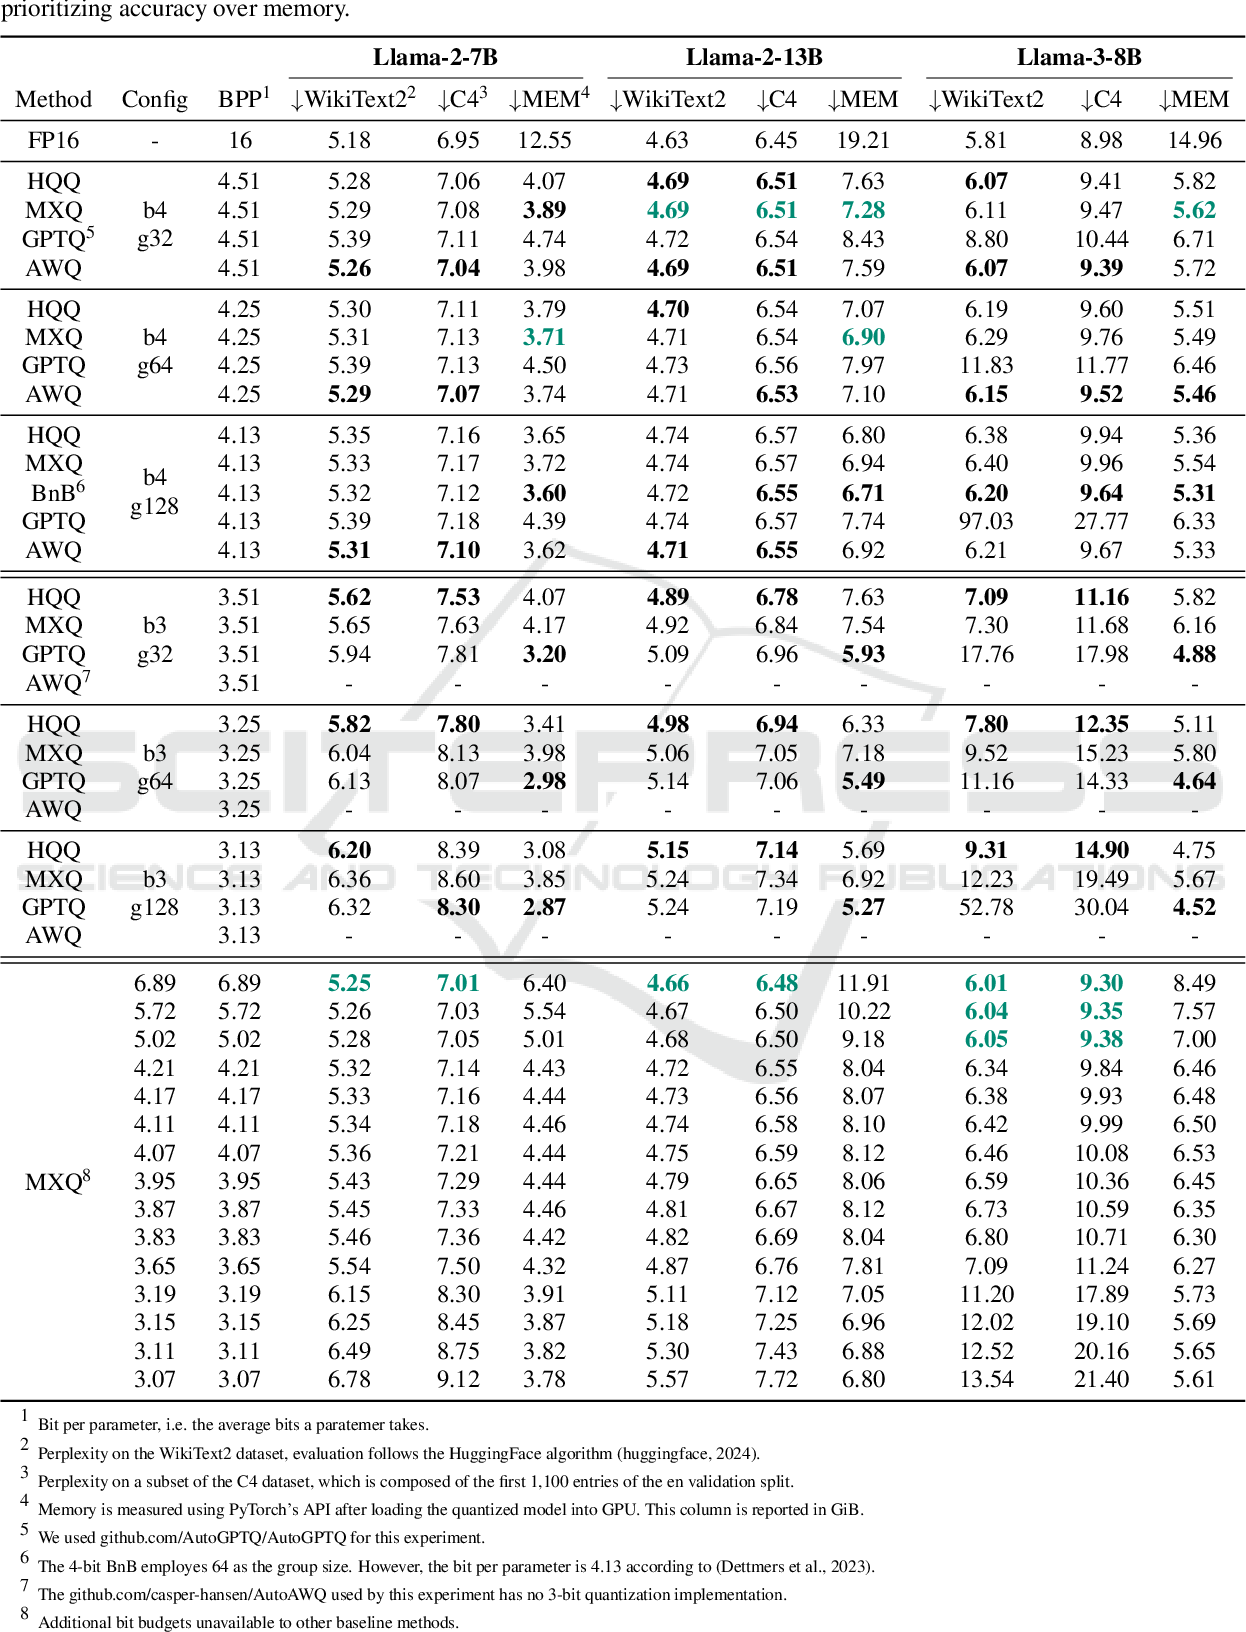
Table 2 from A Mixed Quantization Approach for Data-Free Quantization ...
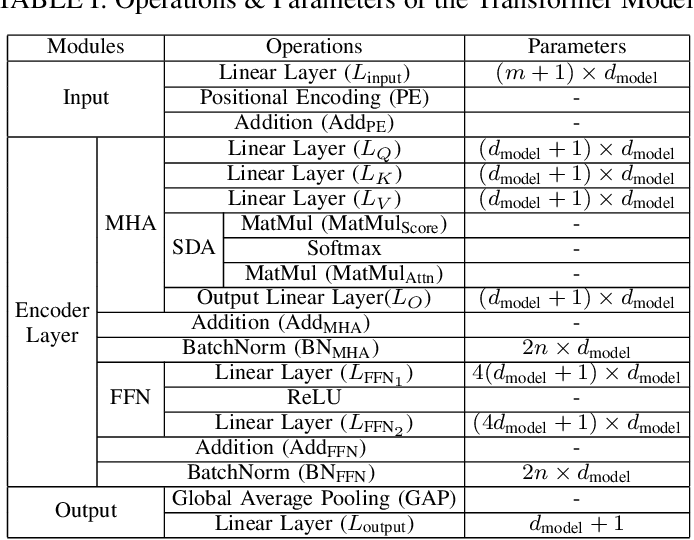
Table I from Integer-only Quantized Transformers for Embedded FPGA ...
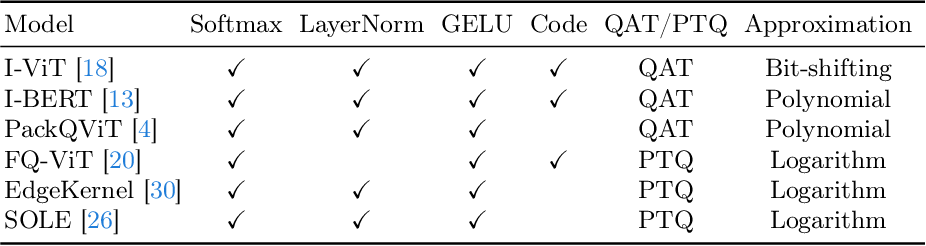
Table 1 from Mixed Non-linear Quantization for Vision Transformers ...
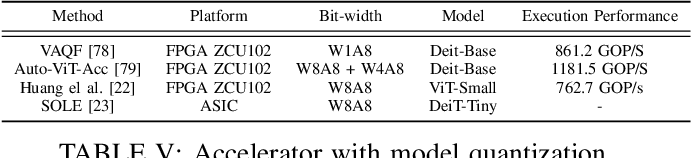
Table V from Model Quantization and Hardware Acceleration for Vision ...
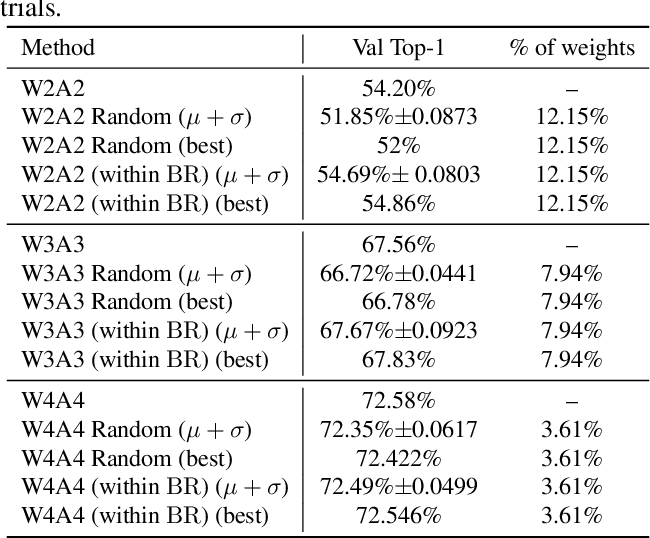
Table 1 from Oscillation-free Quantization for Low-bit Vision ...
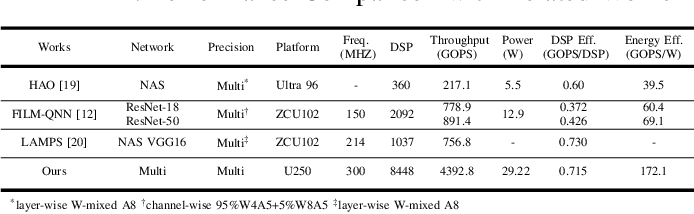
Table II from An FPGA-based Quantization and Acceleration Framework for ...
Advertisement Space (300x250)

Table 1 from Mixed Non-linear Quantization for Vision Transformers ...

Table III from Static Block Floating-Point Quantization for ...

Table I from Efficient Vision Transformers Optimized with Pruning and ...
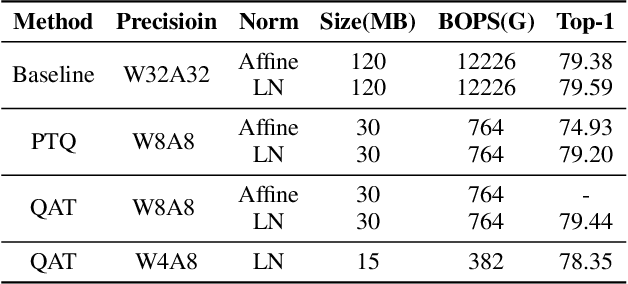
Table 2 from Systematic Quantization of Vision Models based on MLPs ...
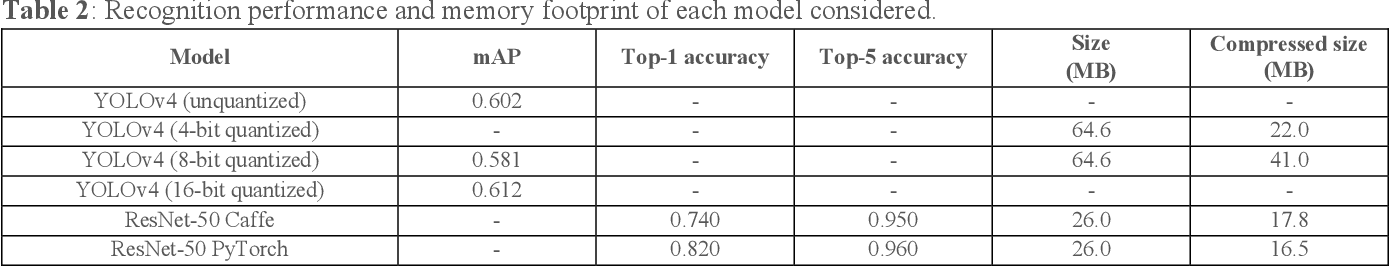
Table 2 from Image Quantization Tradeoffs in a YOLO-based FPGA ...
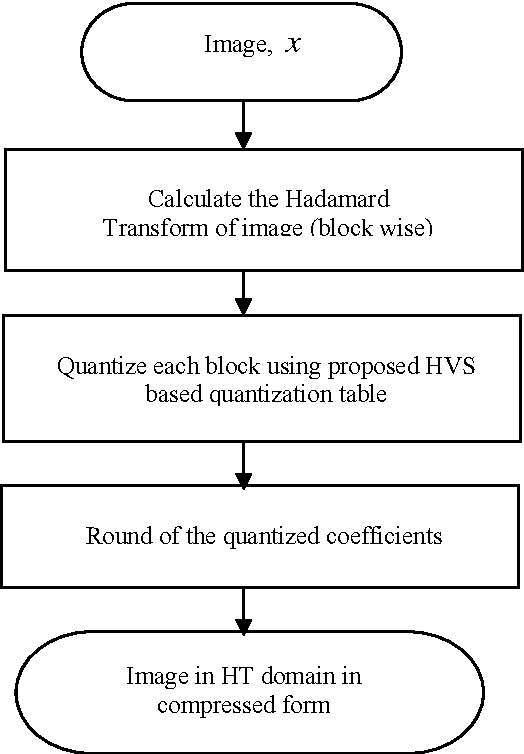
Figure 1 from Designing Quantization Table for Hadamard Transform based ...
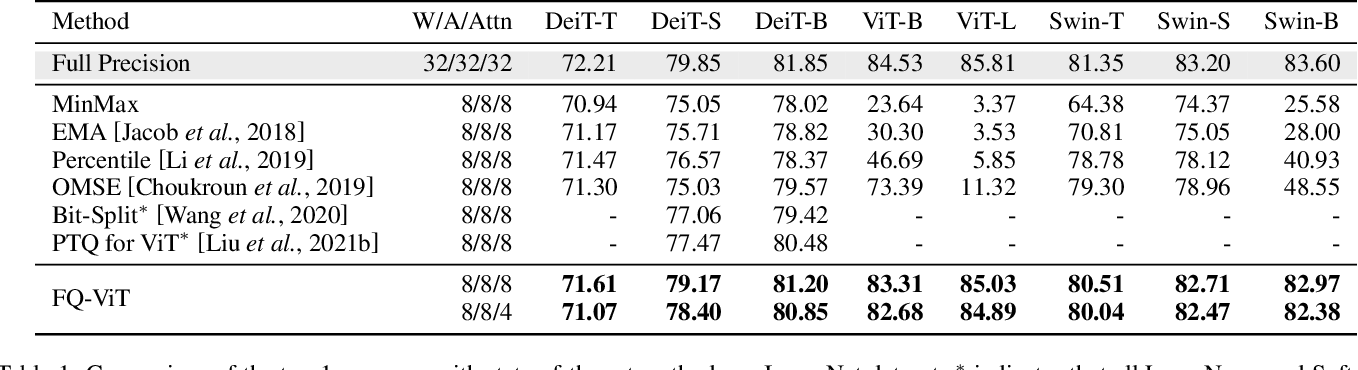
Table 1 from FQ-ViT: Post-Training Quantization for Fully Quantized ...
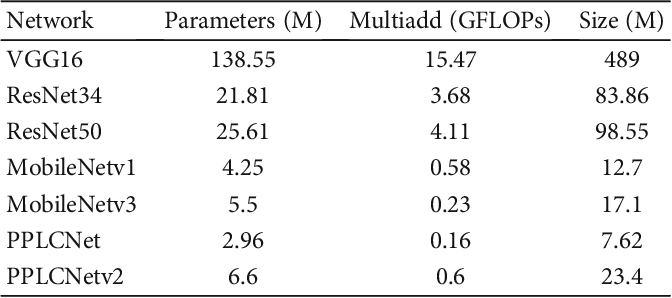
Table 1 from Custom Network Quantization Method for Lightweight CNN ...

Figure 1 from Fixed-point Quantization for Vision Transformer ...

Table 1 from OWQ: Outlier-Aware Weight Quantization for Efficient Fine ...
Advertisement Space (336x280)
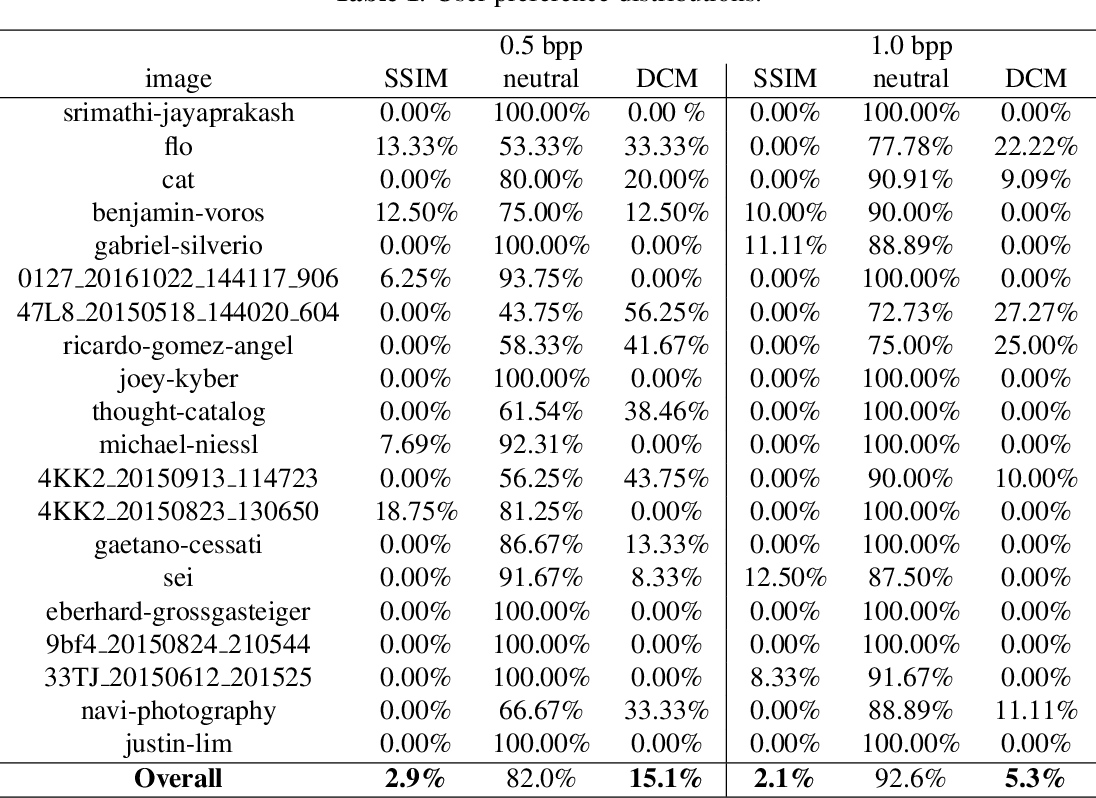
Table 1 from Differential Contrast Based Adaptive Quantization for ...
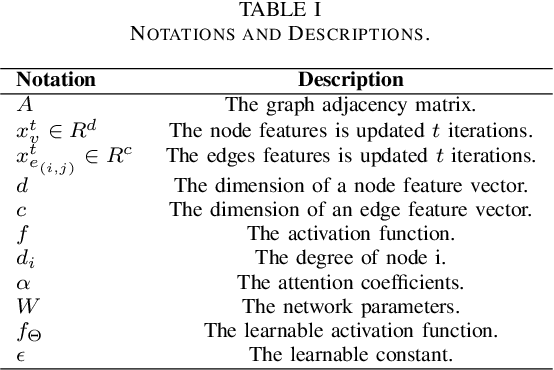
Table I from Topology-Aware Quantization Strategy via Personalized ...
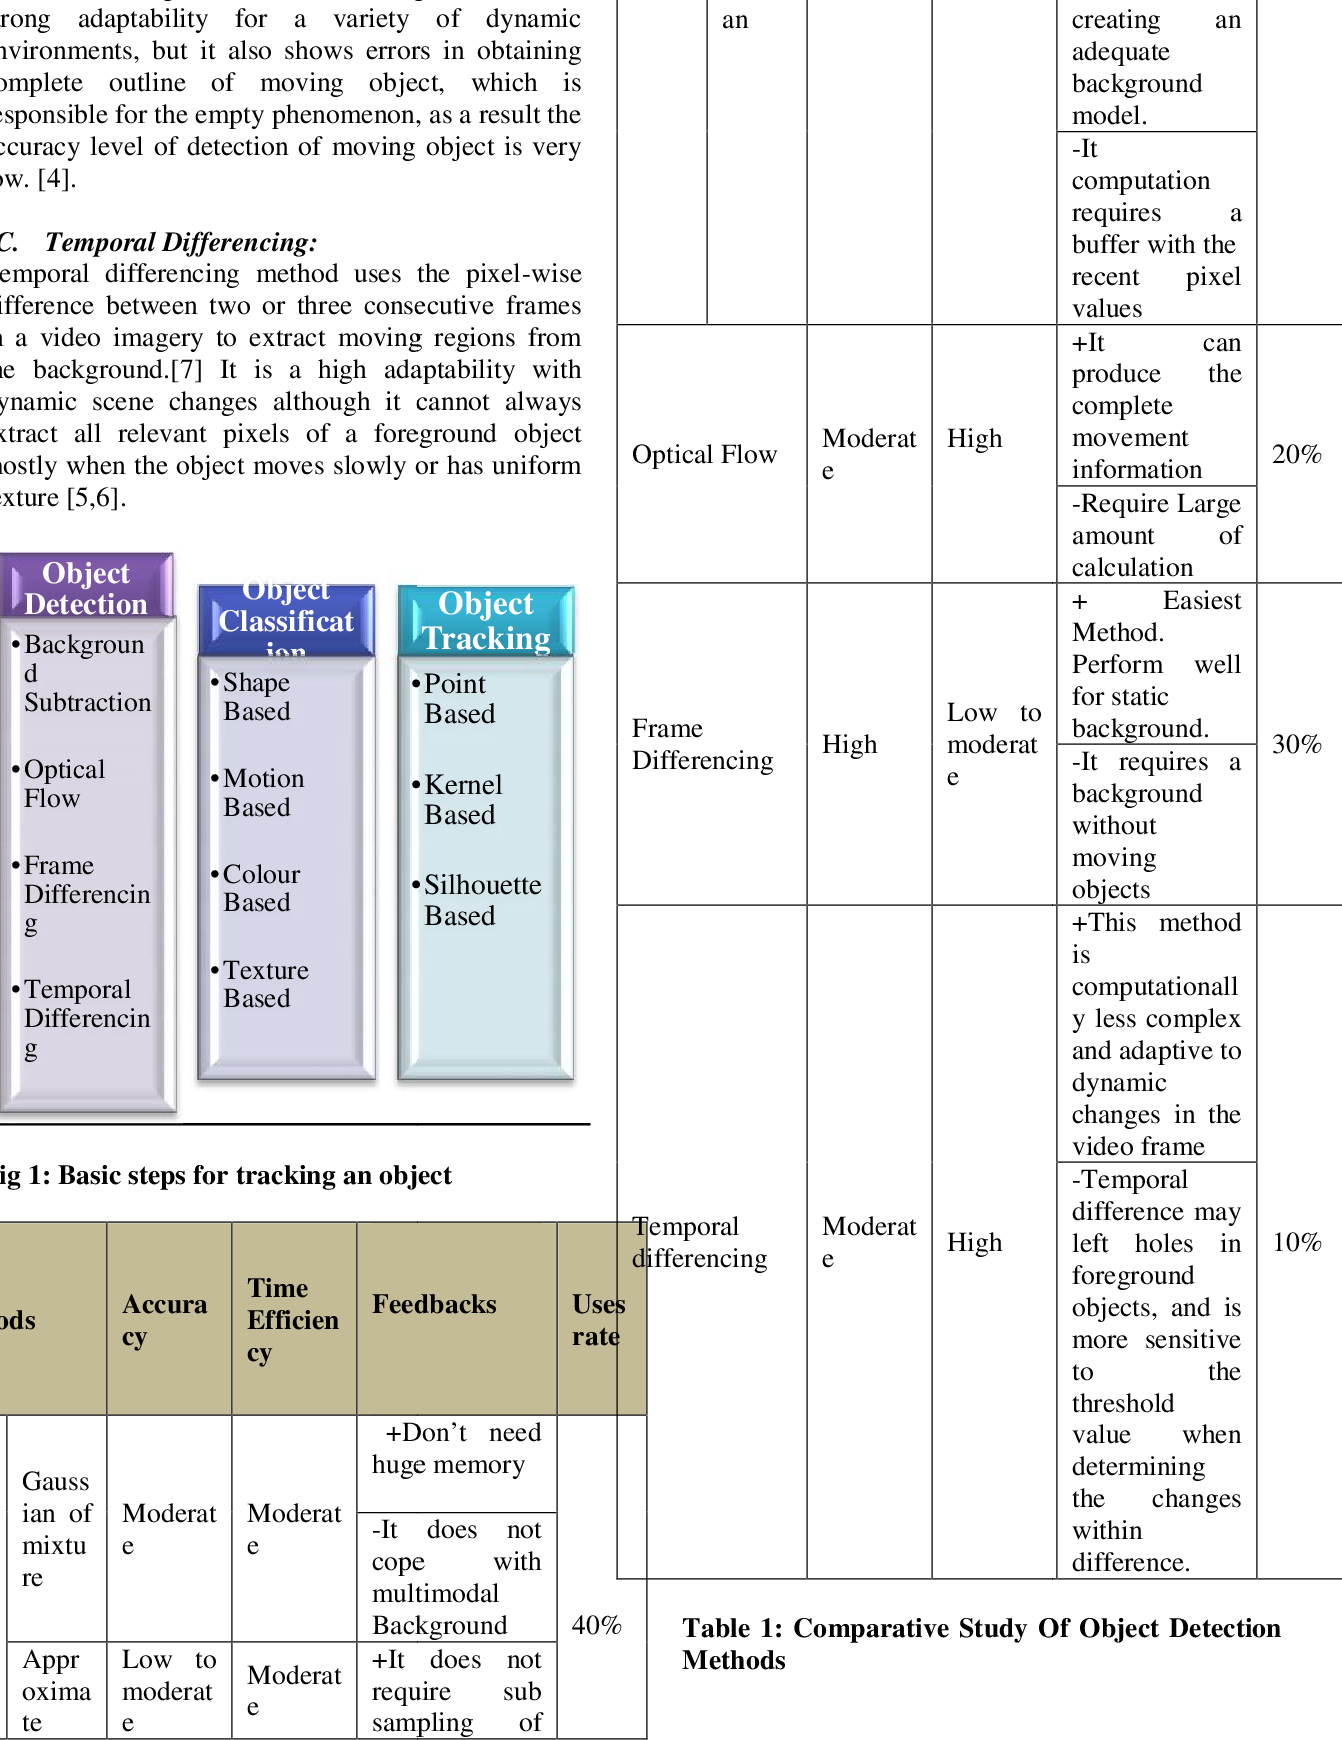
Table 1 from A Survey on FPGA Implementation of Object Detection and ...

(PDF) Scaled Quantization for the Vision Transformer
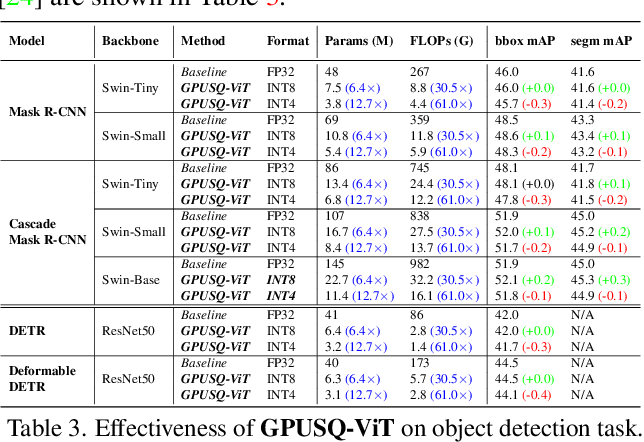
Table 3 from Boost Vision Transformer with GPU-Friendly Sparsity and ...
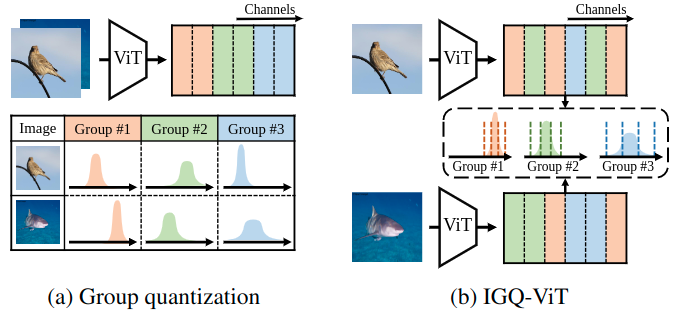
Instance-Aware Group Quantization for Vision Transformers
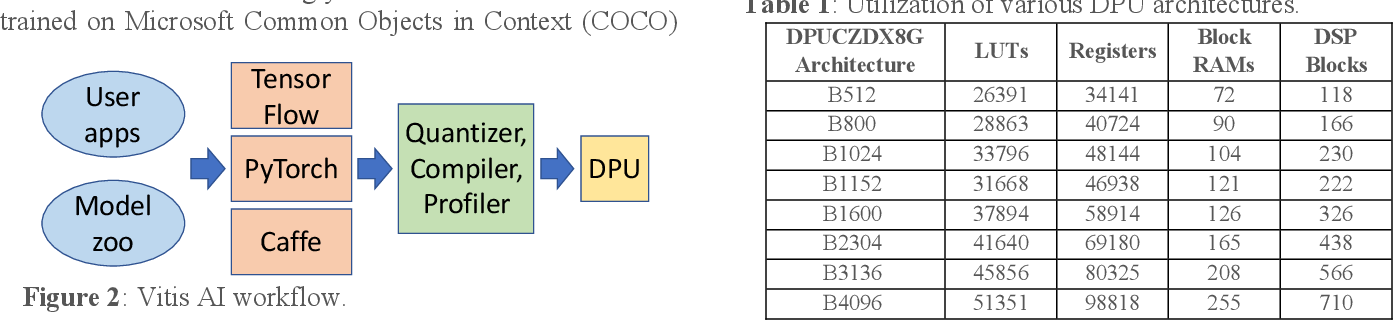
Figure 2 from Image Quantization Tradeoffs in a YOLO-based FPGA ...
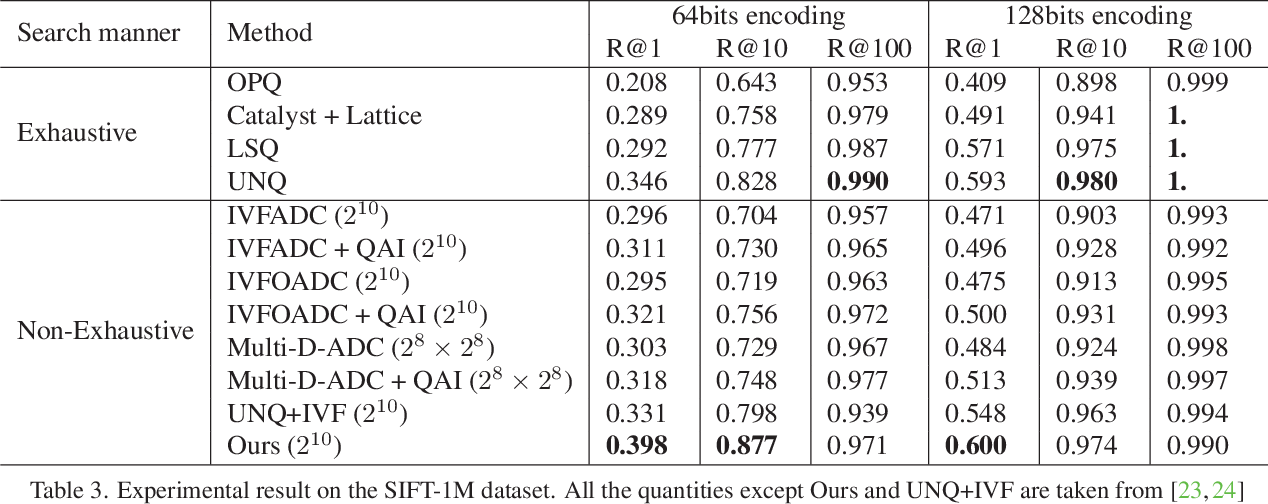
Table 3 from Disentangled Representation Learning for Unsupervised ...
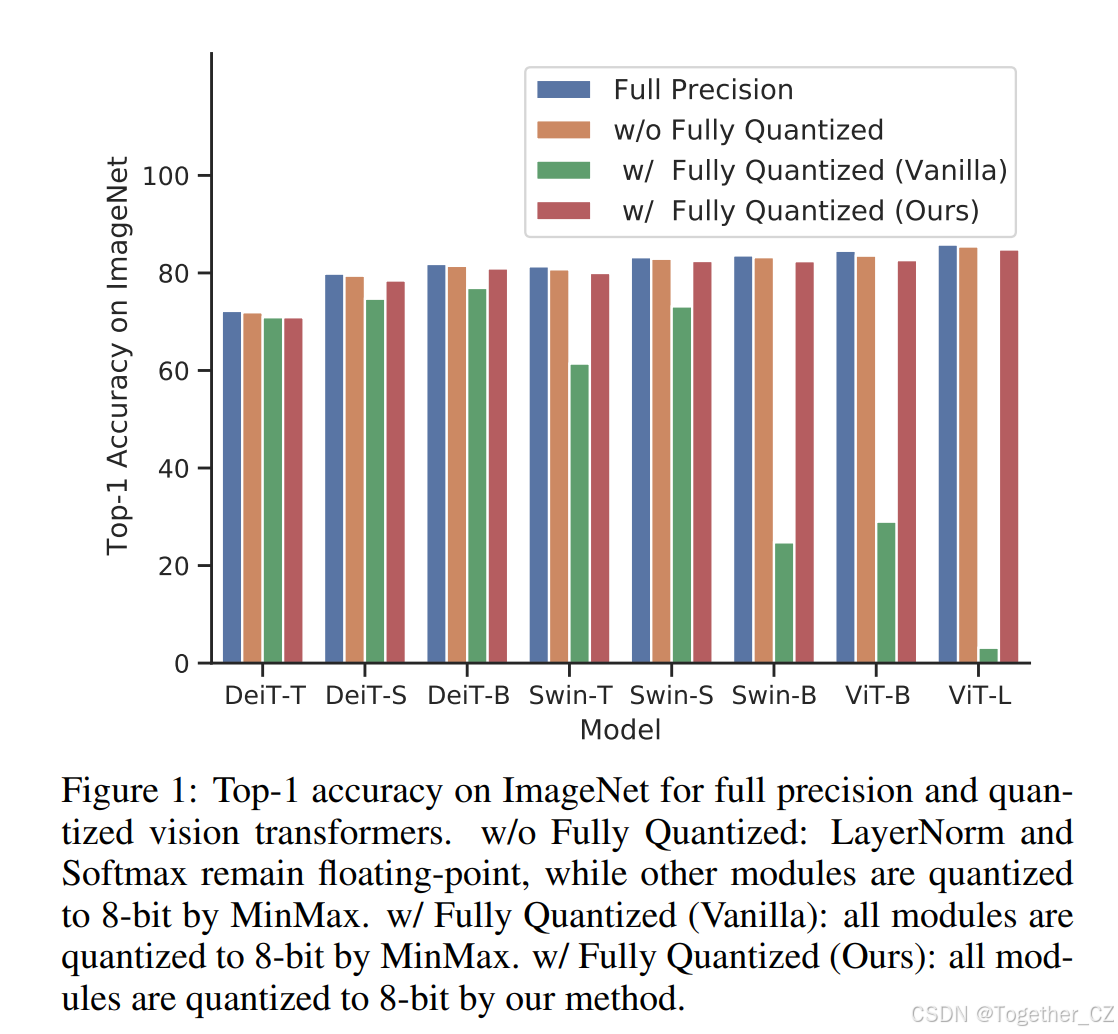
FQ-ViT: Post-Training Quantization for Fully Quantized Vision ...

CPT-V: A Contrastive Approach to Post-Training Quantization of Vision ...
Advertisement Space (336x280)

FQ-ViT: Post-Training Quantization for Fully Quantized Vision ...
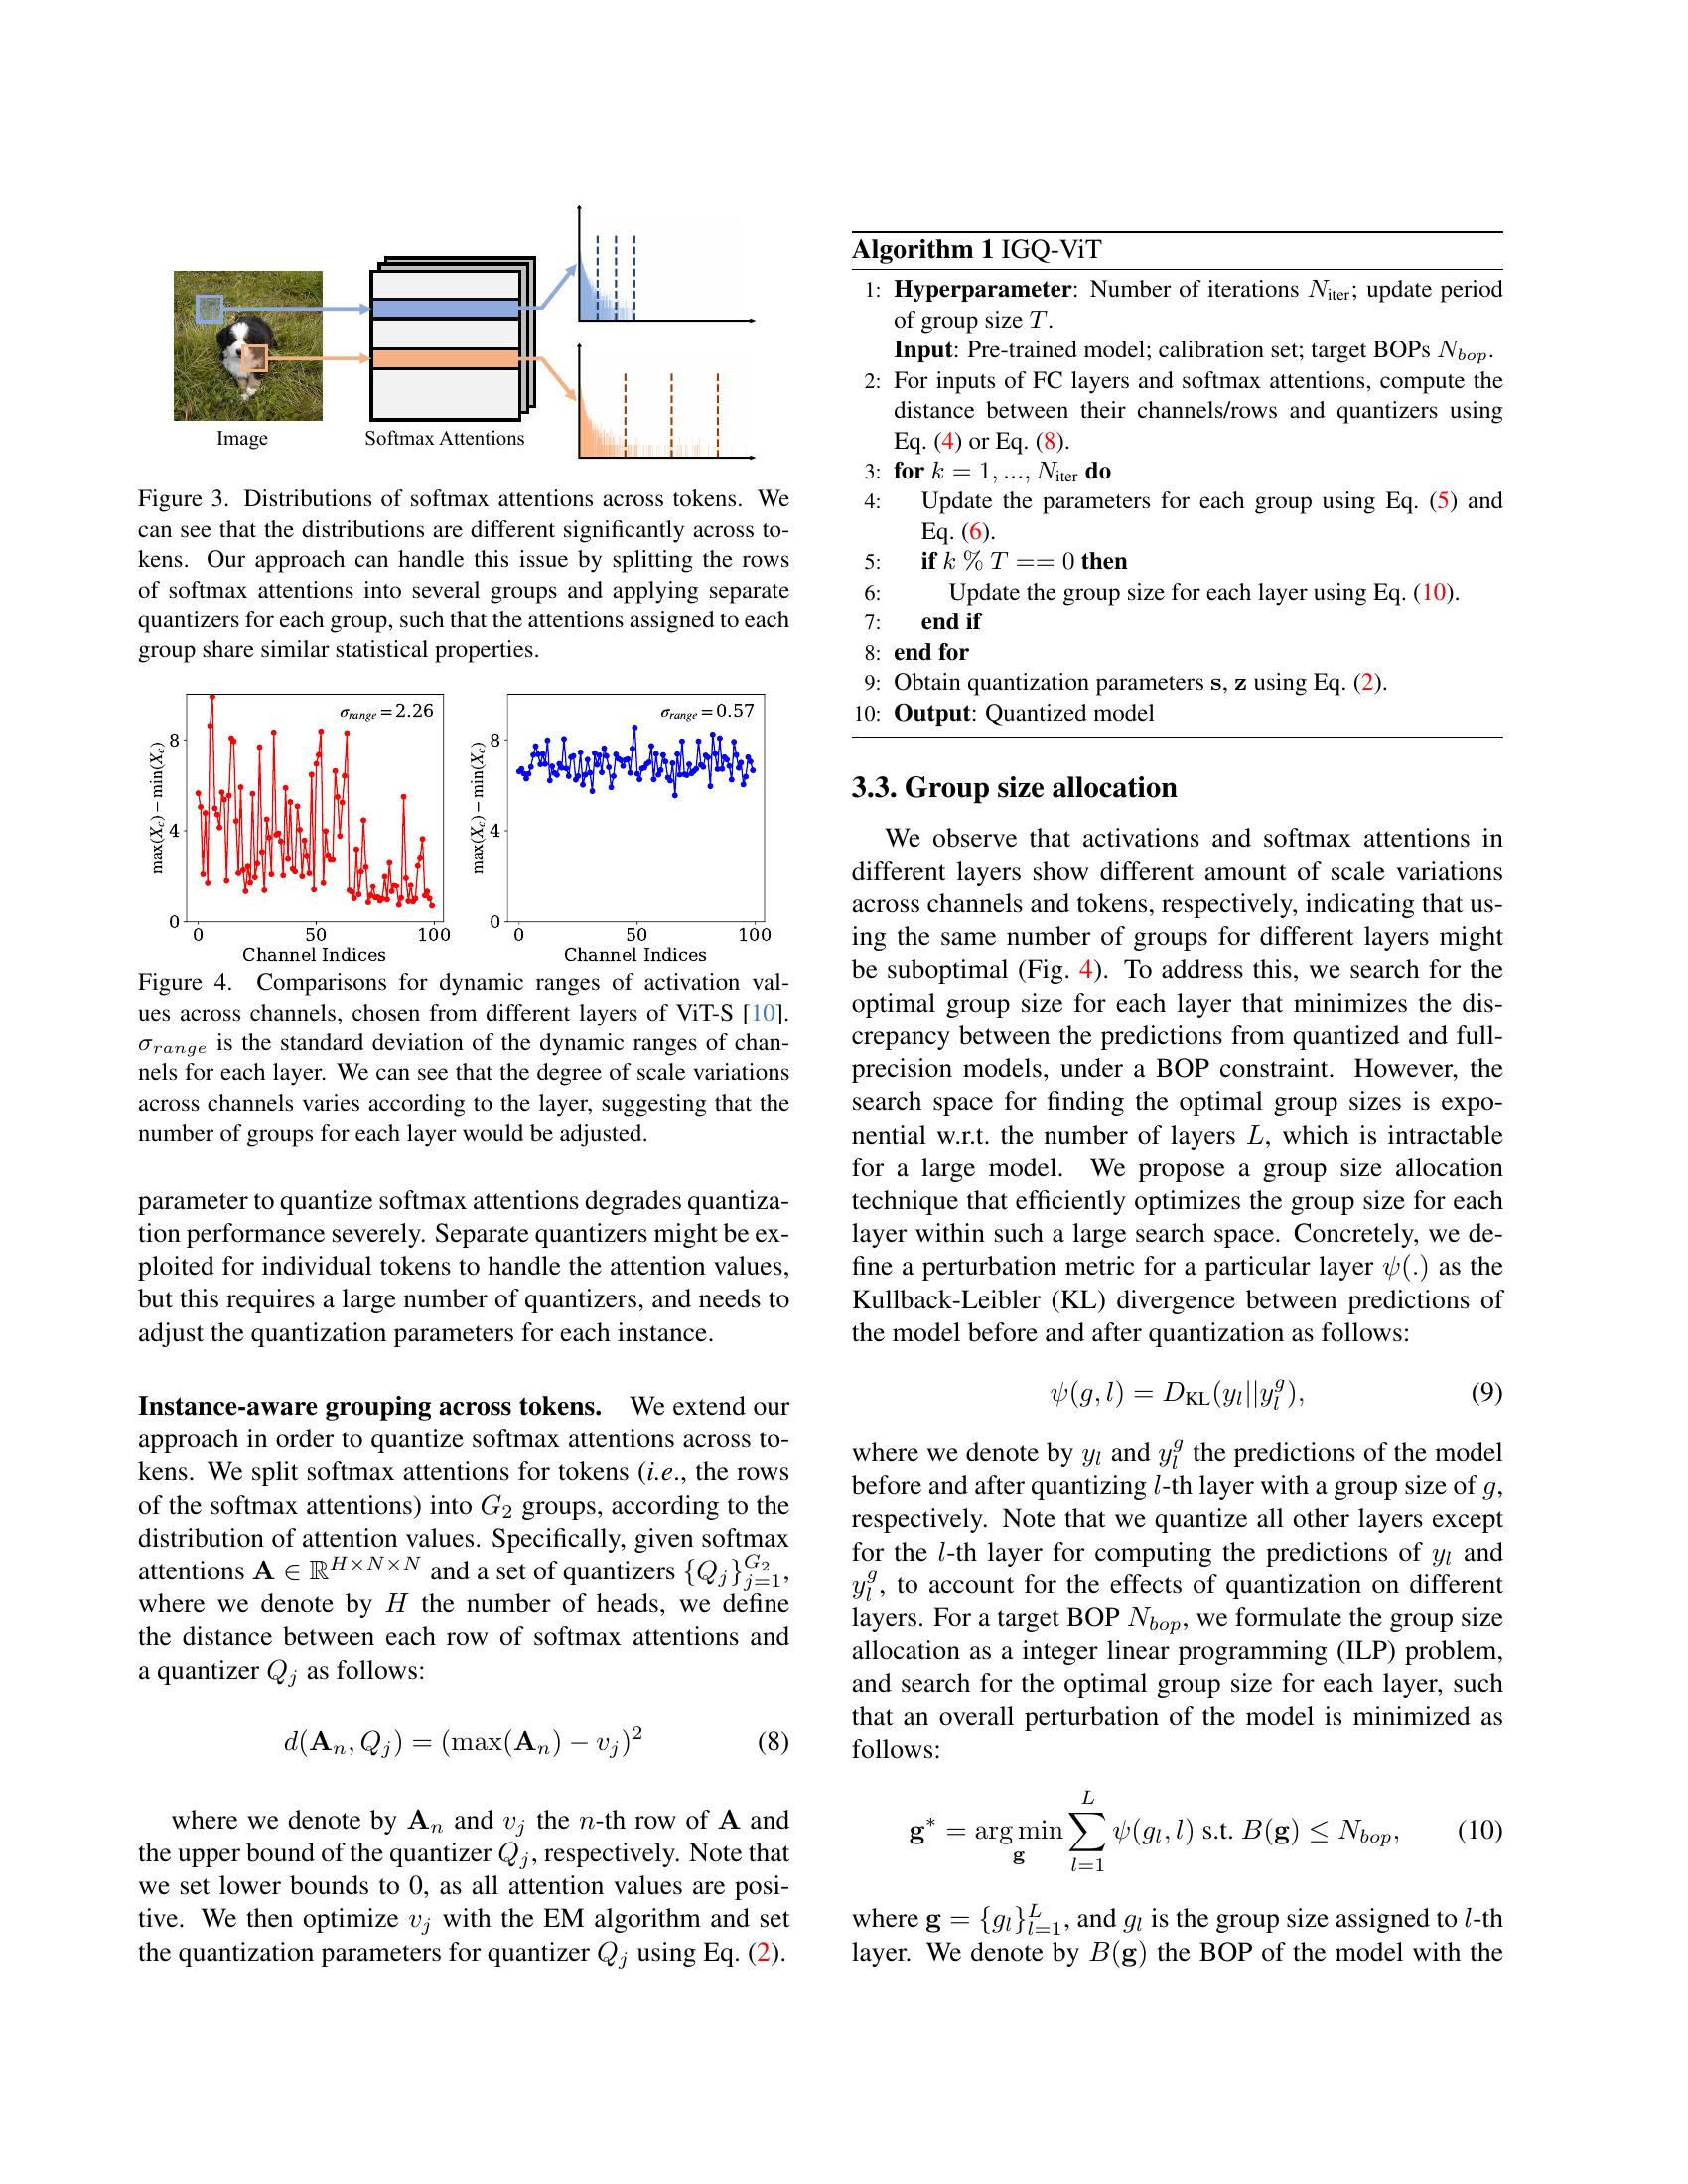
Instance-Aware Group Quantization for Vision Transformers - 智源社区论文
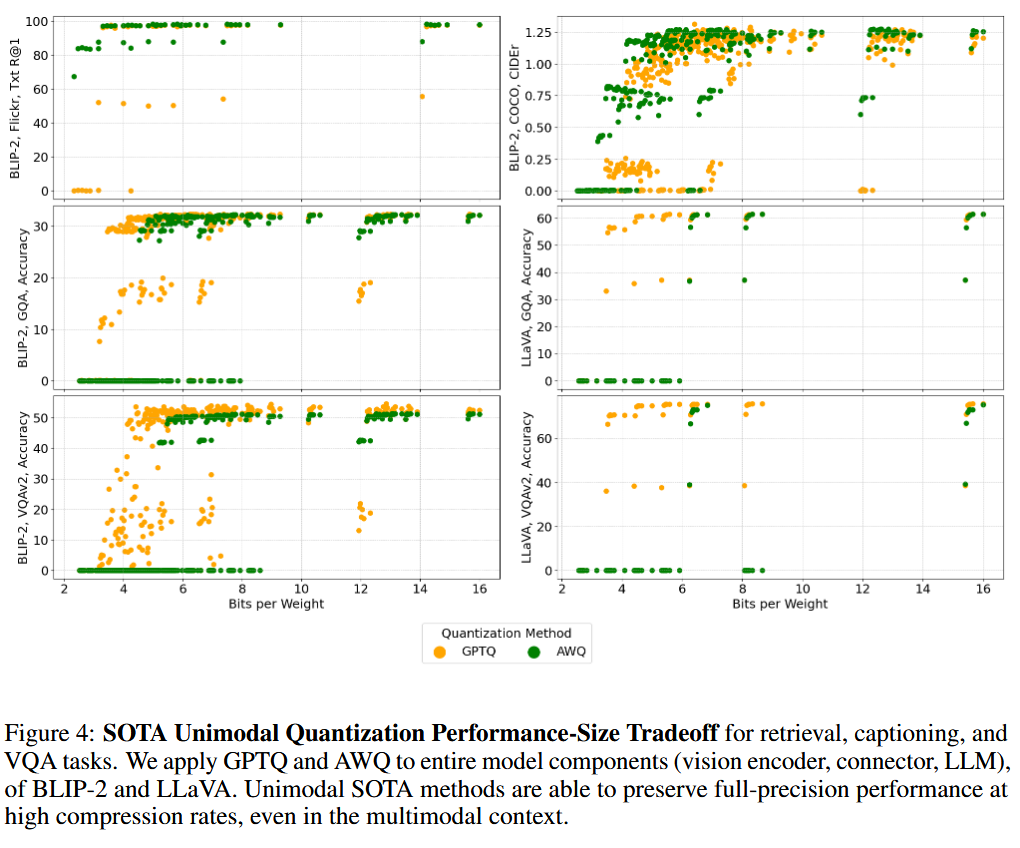
Towards Understanding Best Practices for Quantization of Vision ...

Fine-Grained Post-Training Quantization for Large Vision Language ...
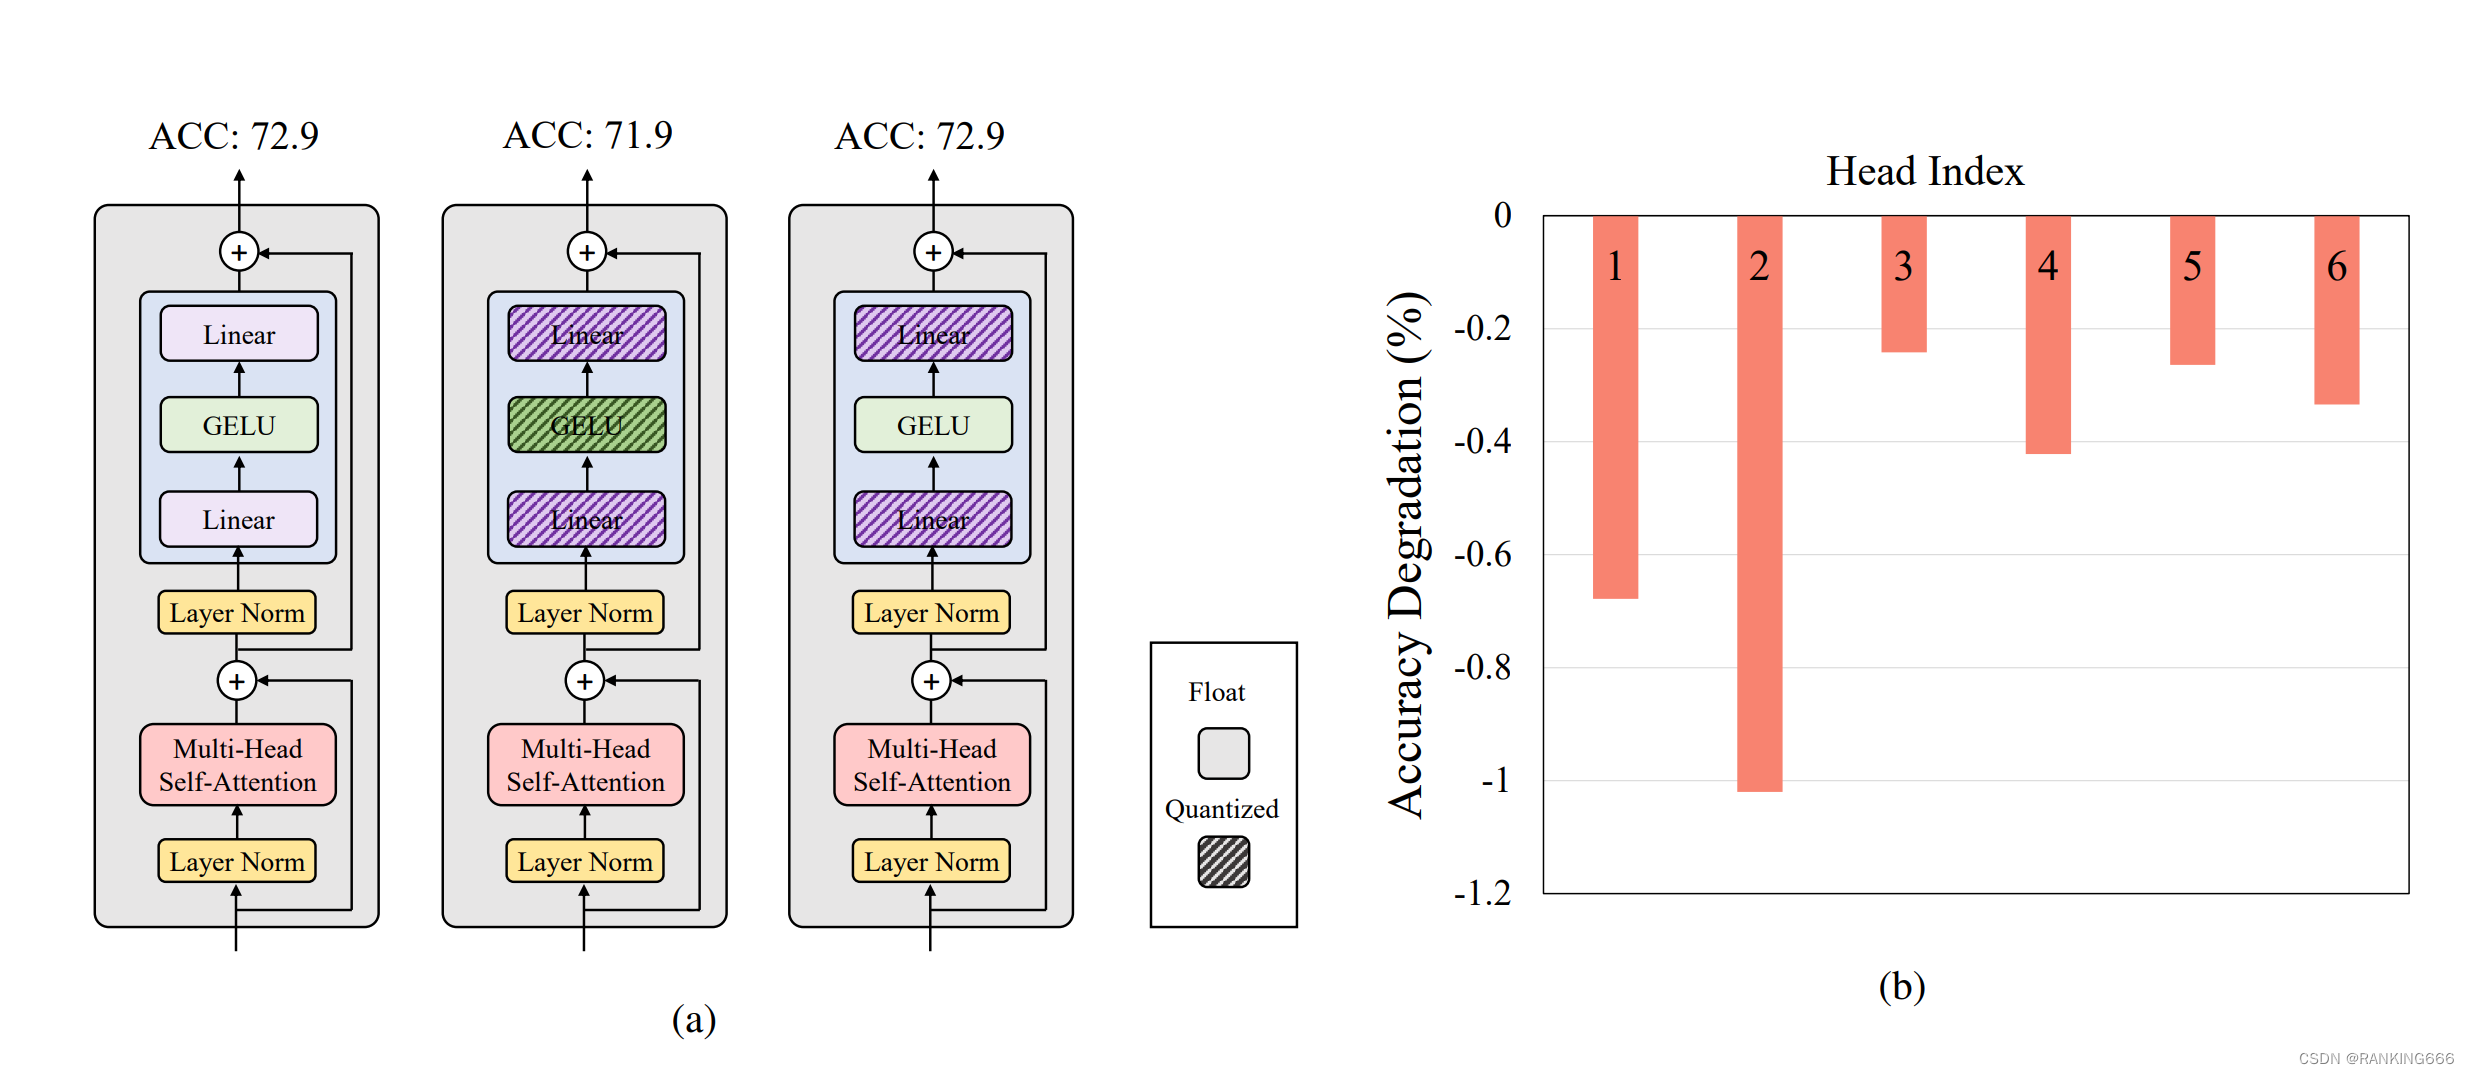
VIT quantization相关论文阅读_post-training quantization for vision ...

Variable Resolution Pixel Quantization for Low Power Machine Vision ...