
Tinylvlm Ehub Fast Lightweight Evaluation For Large Vision Language

TinyLVLM-eHub: Fast, Lightweight Evaluation for Large Vision-Language ...

(PDF) Adapting Lightweight Vision Language Models for Radiological ...

Adapting Lightweight Vision Language Models for Radiological Visual ...

[논문 리뷰] Unified Triplet-Level Hallucination Evaluation for Large Vision ...
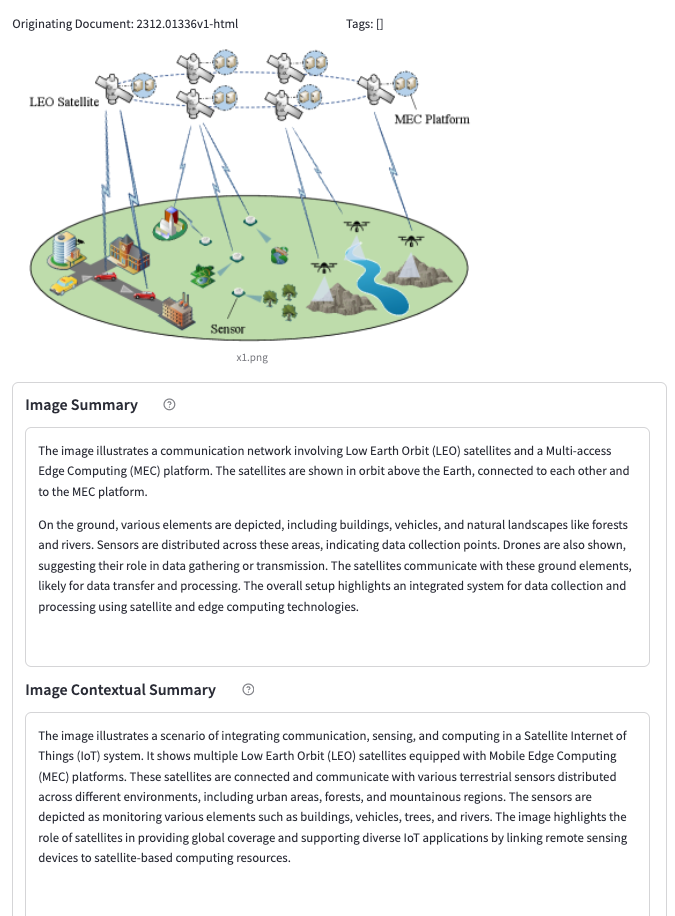
Enhancing Technical Document Triage: Large Vision Language Models for ...

Figure 2 from LVLM-EHub: A Comprehensive Evaluation Benchmark for Large ...

Figure 1 from LVLM-EHub: A Comprehensive Evaluation Benchmark for Large ...
TinyLVLM-eHub: Towards Comprehensive and Efficient Evaluation for Large ...
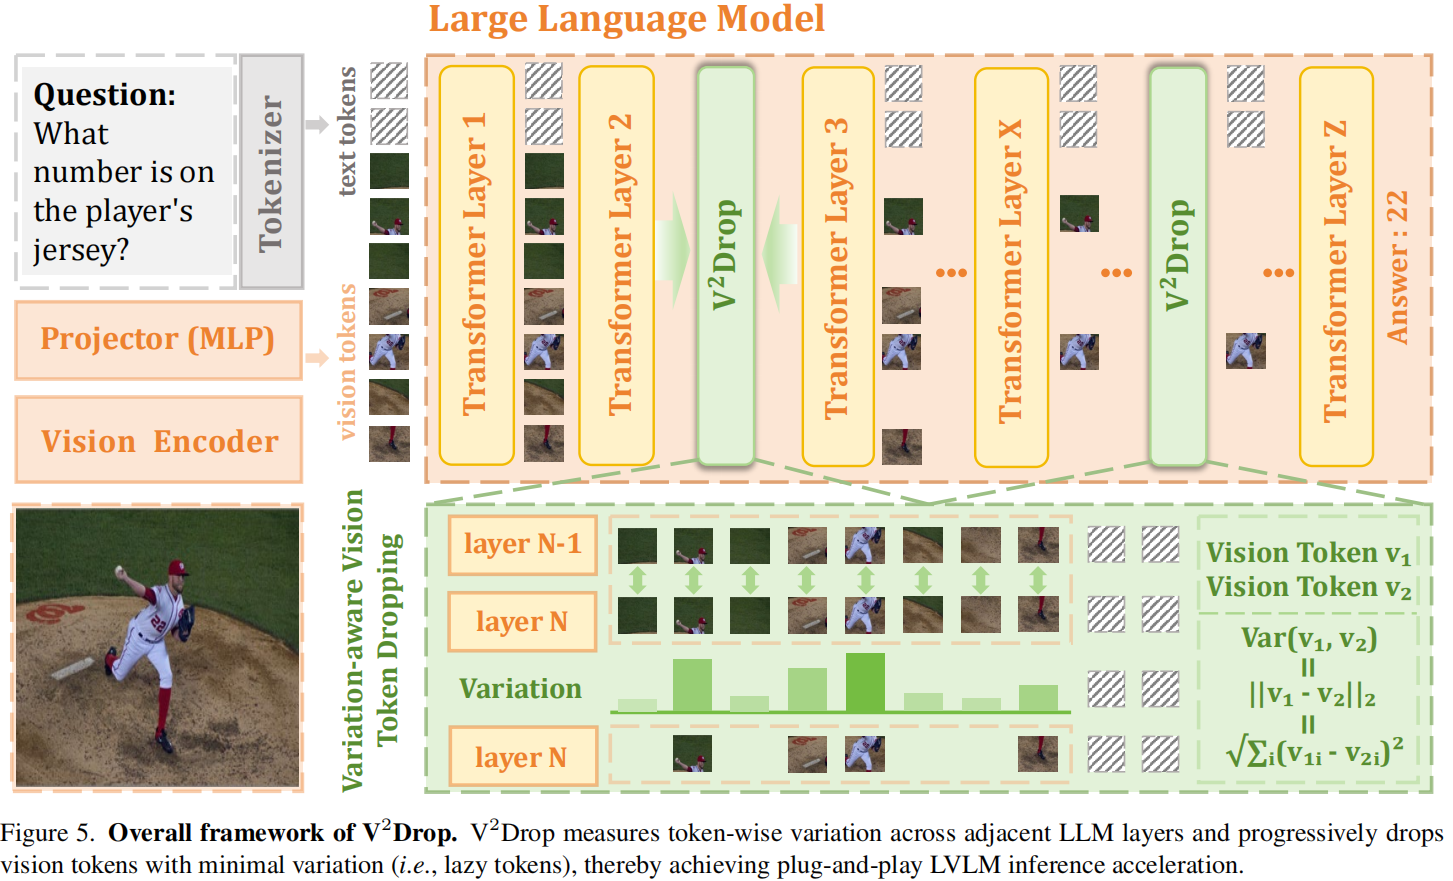
📝 Variation-aware Vision Token Dropping for Faster Large Vision ...

Paper page - LVLM-eHub: A Comprehensive Evaluation Benchmark for Large ...
Advertisement Space (300x250)

Large Vision Language Model(LVLM)的经典模型结构是怎样的? - 知乎

Vision Large Language Models (vLLMs)

Vision Large Language Models (vLLMs)

Paper page - FastVLM: Efficient Vision Encoding for Vision Language Models
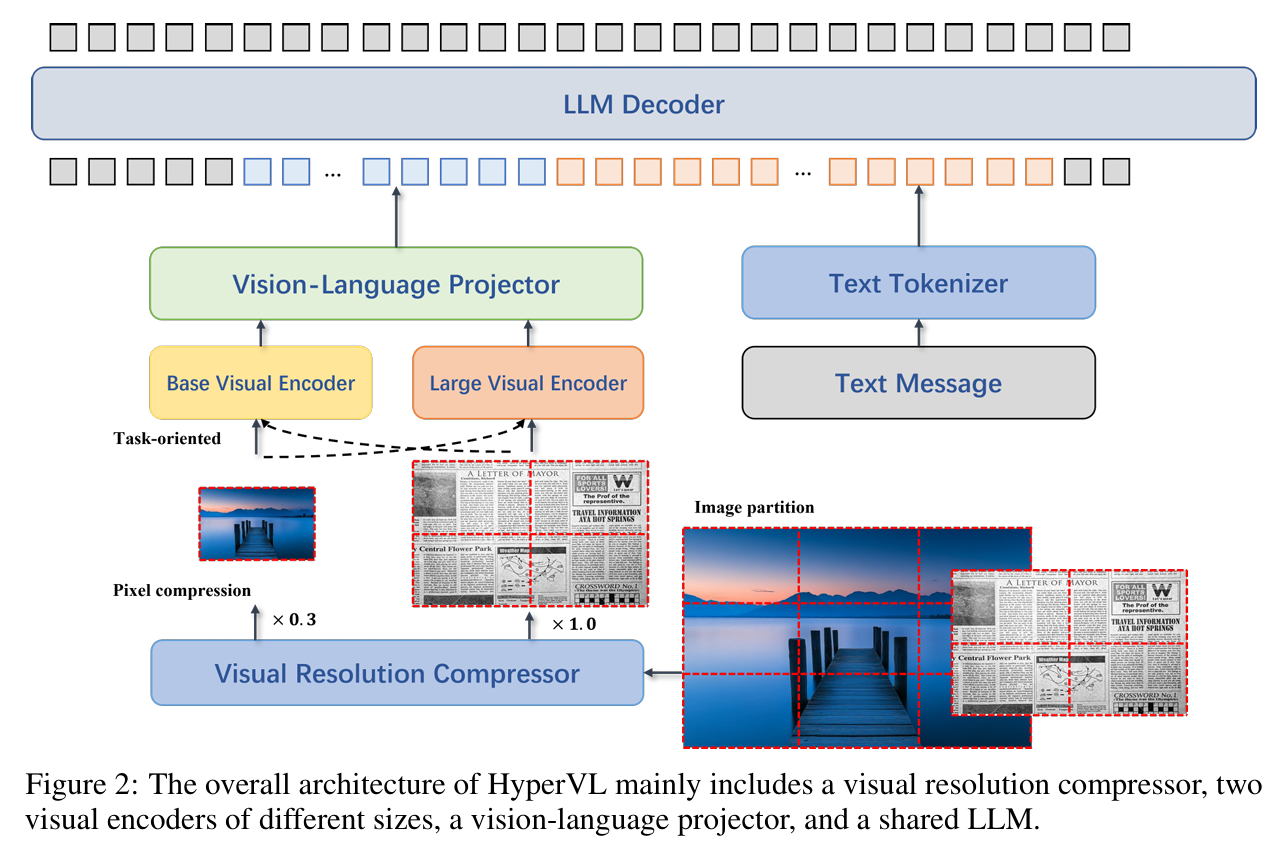
📝 HyperVL: An Efficient and Dynamic Multimodal Large Language Model for ...

Paper page - LVLM-Intrepret: An Interpretability Tool for Large Vision ...
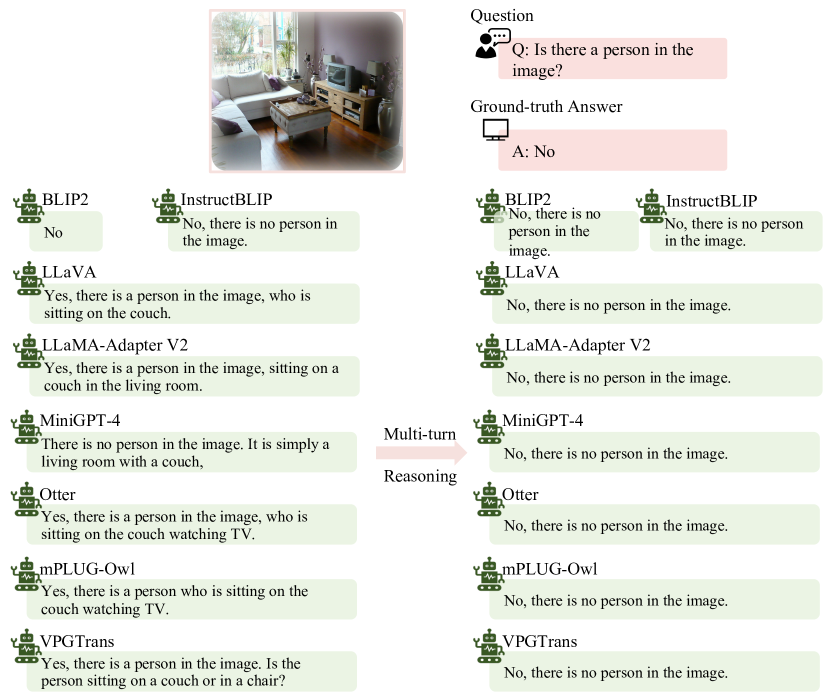
[2306.09265] LVLM-eHub: A Comprehensive Evaluation Benchmark for Large ...

Large Vision Language Model (LVLM) に関する最新知見まとめ (Part 1) - Speaker Deck
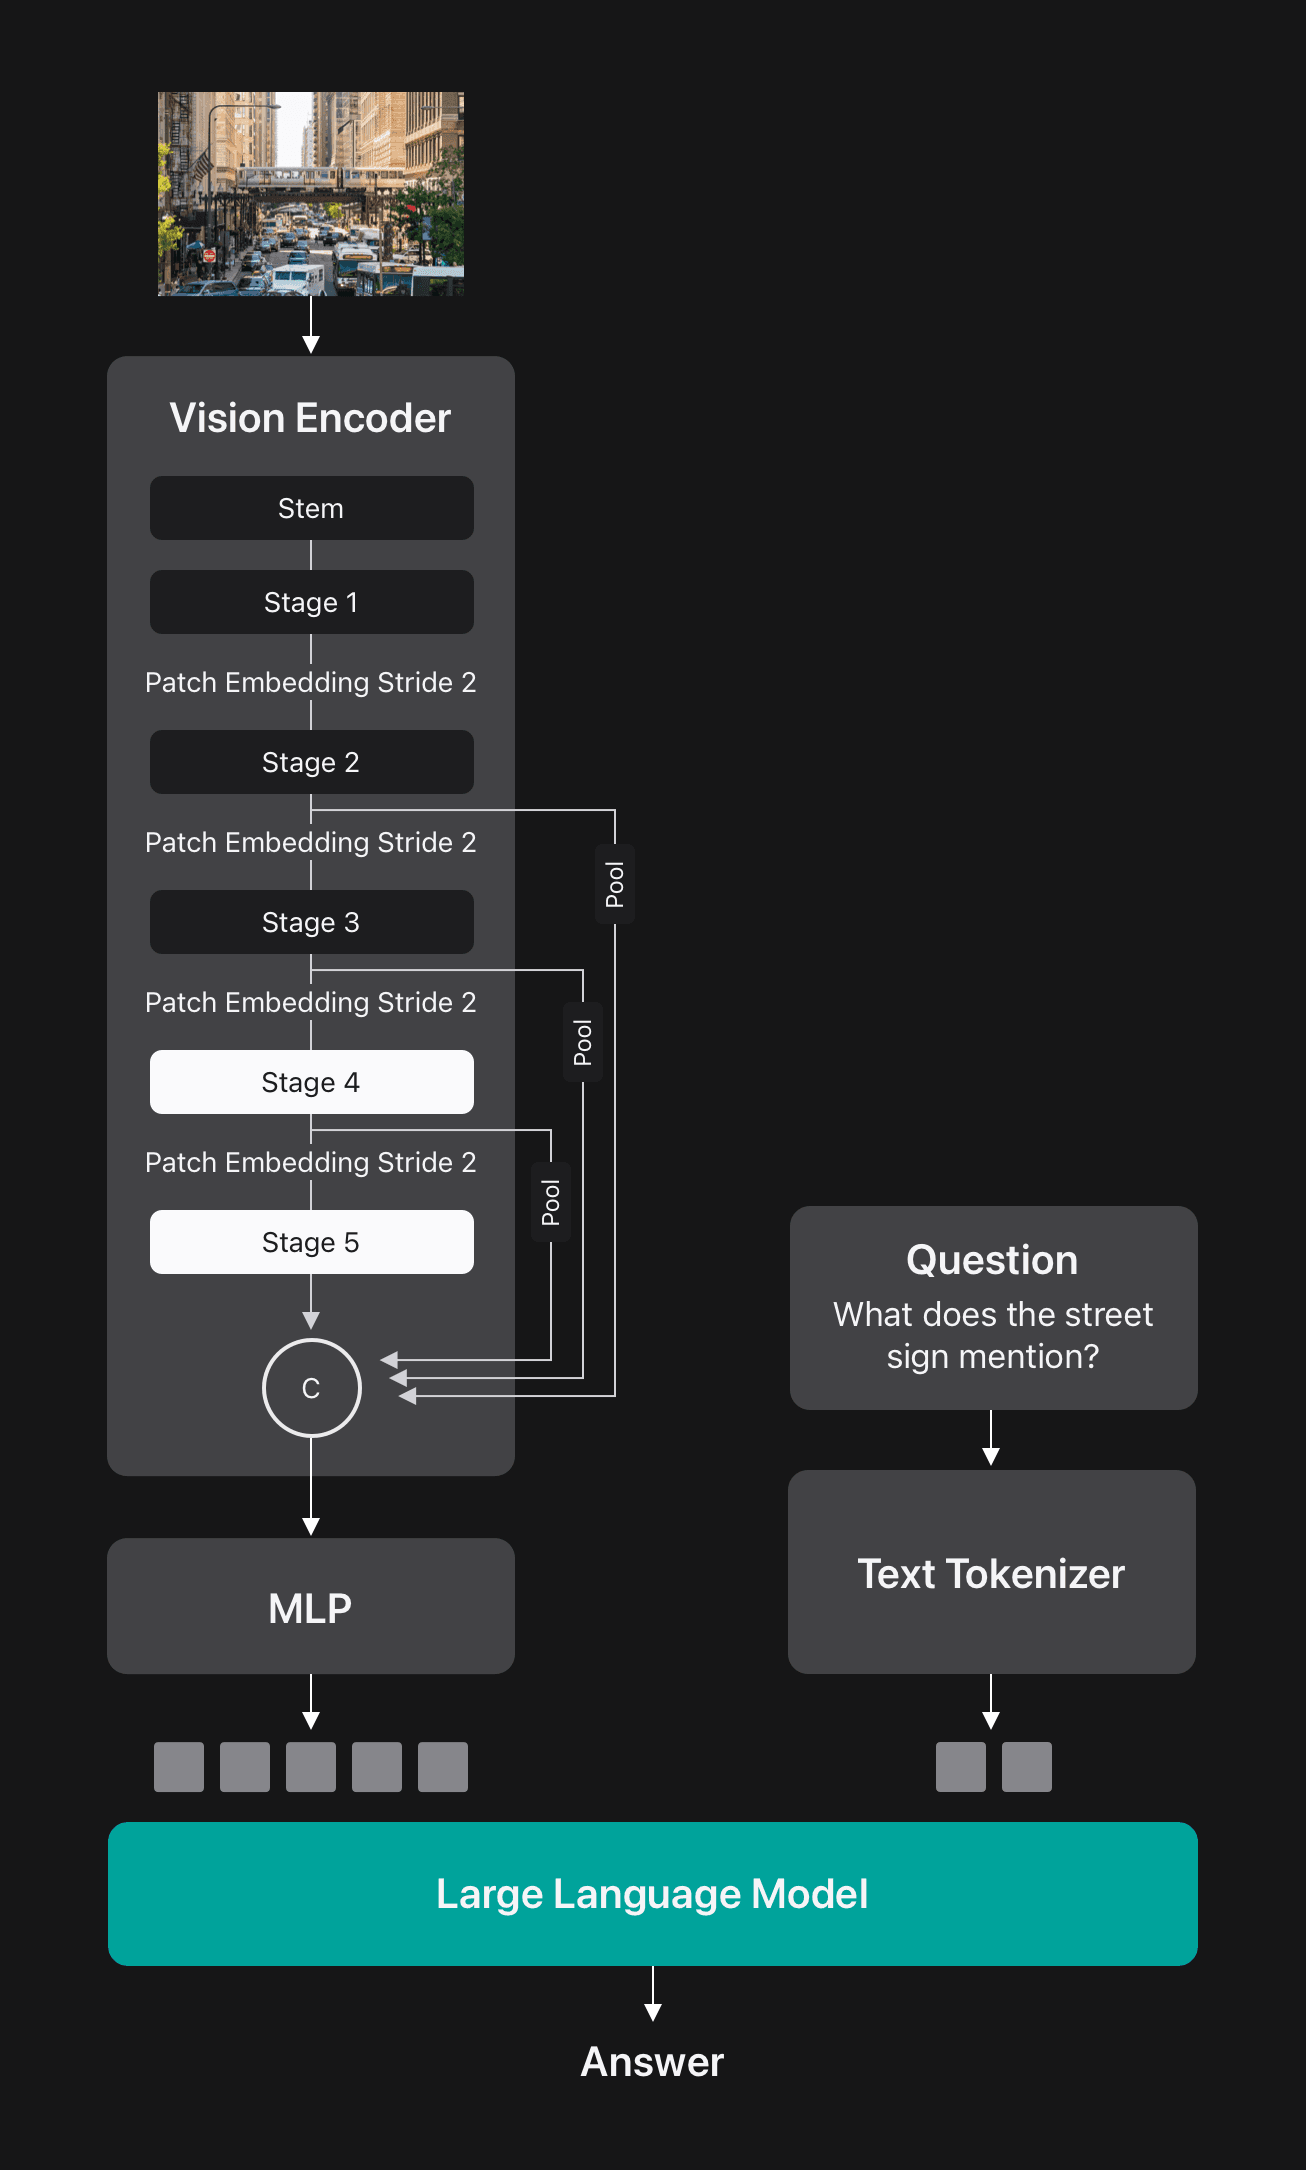
FastVLM: Efficient Vision Encoding for Vision Language Models - Apple ...
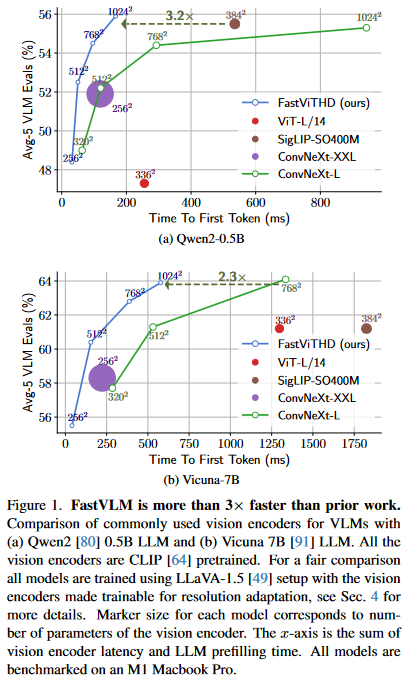
论文阅读笔记-FastVLM: Efficient Vision Encoding for Vision Language Models - 技术栈
Advertisement Space (336x280)

(PDF) LVLM_CSP: Accelerating Large Vision Language Models via ...

Large Vision Language Model (LVLM) に関する最新知見まとめ (Part 1) - Speaker Deck

Vision Large Language Models (vLLMs)

Holistic Evaluation of Vision Language Models (VHELM): Extending the ...
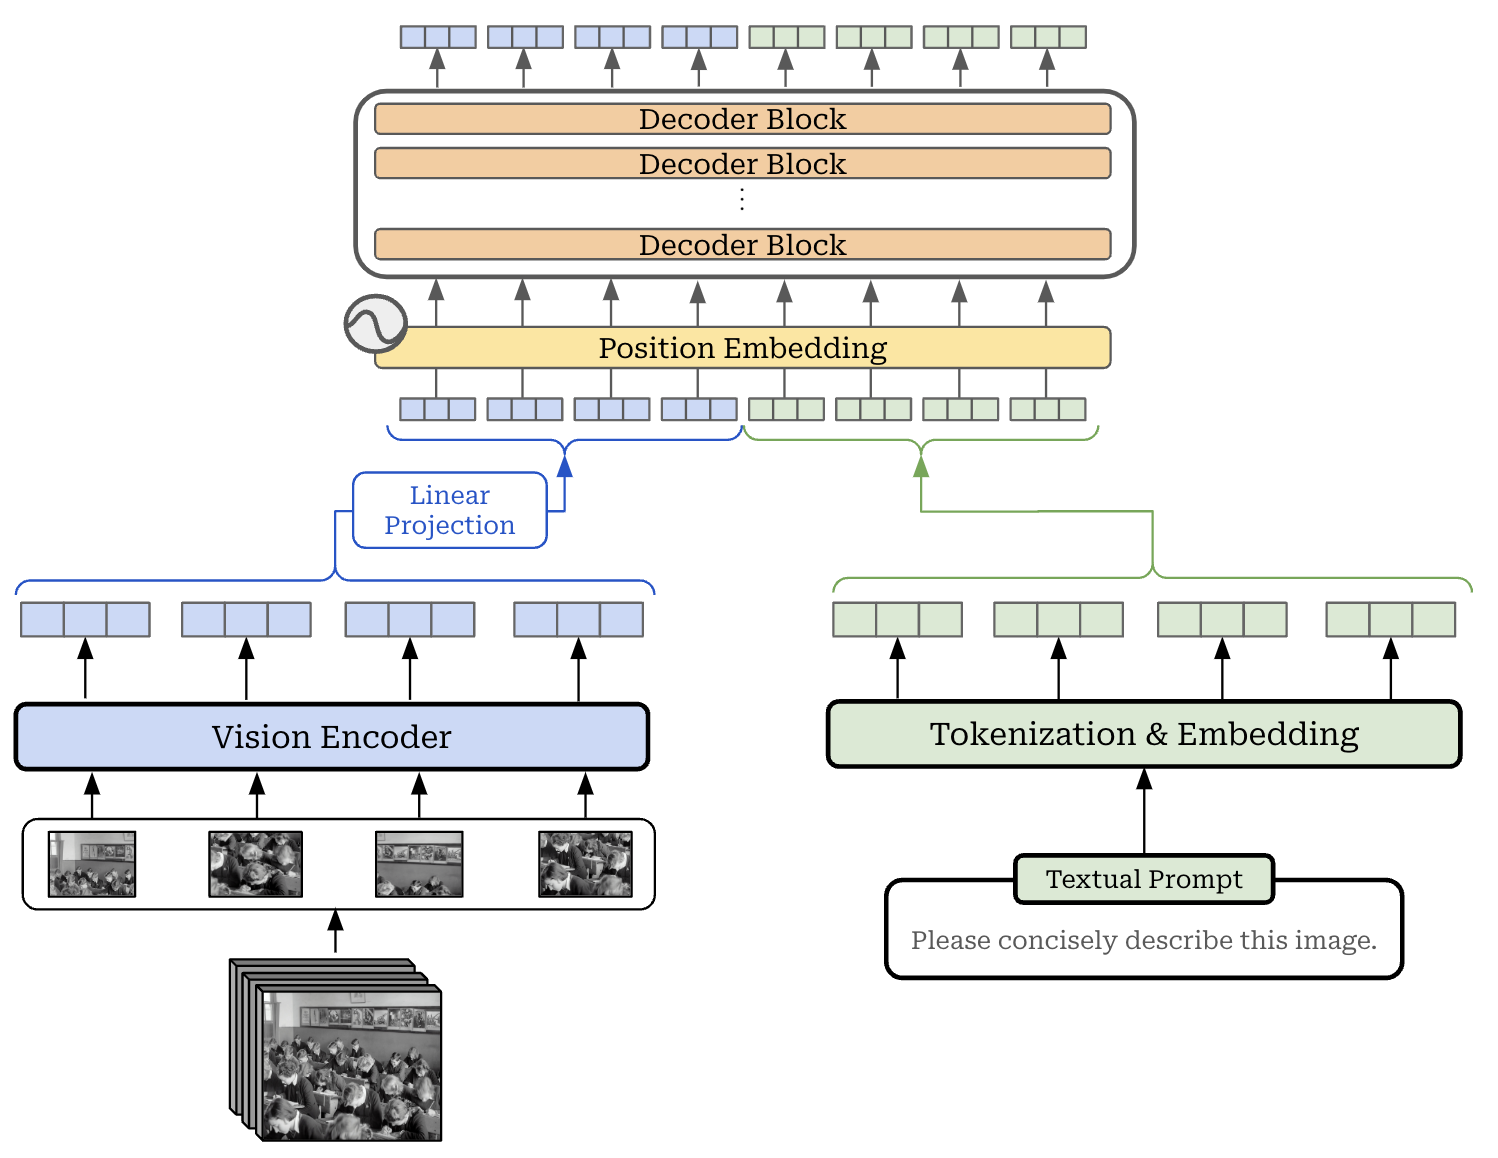
Vision Large Language Models (vLLMs)
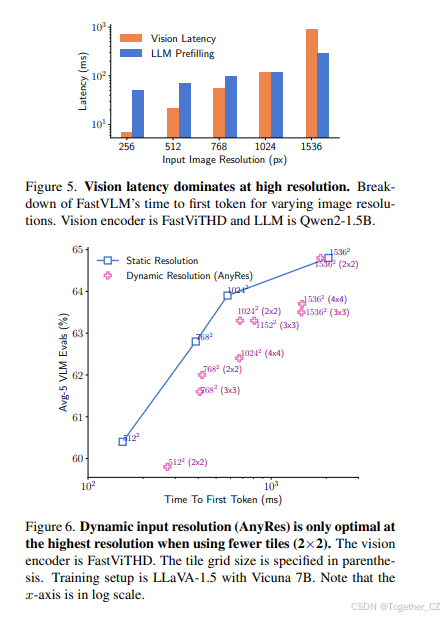
FastVLM: Efficient Vision Encoding for Vision Language Models——为视觉语言模型 ...

Vision Large Language Models (vLLMs)

Large Vision Language Model(LVLM)的经典模型结构是怎样的? - 知乎

VisionLLM: Large Language Model is also an Open-Ended Decoder for ...
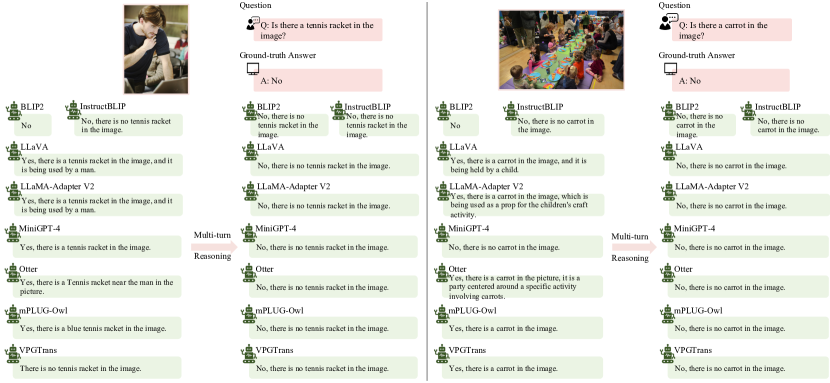
[2306.09265] LVLM-eHub: A Comprehensive Evaluation Benchmark for Large ...
Advertisement Space (336x280)

[論文レビュー] A Lightweight Large Vision-language Model for Multimodal ...

Variation-aware Vision Token Dropping for Faster Large Vision-Language ...
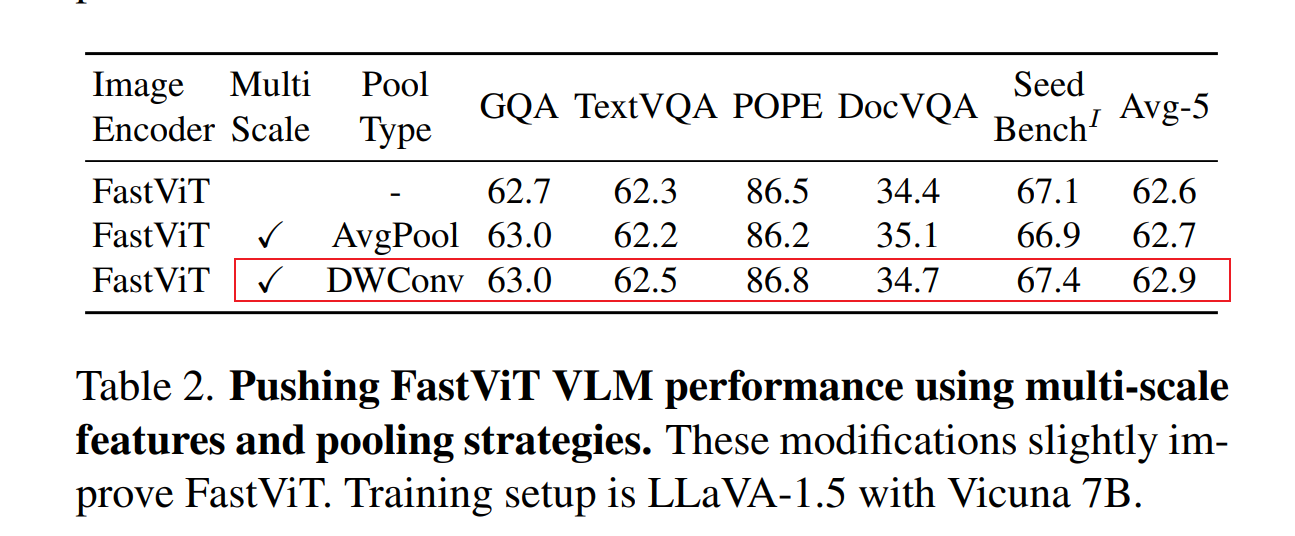
FastVLM: Efficient Vision Encoding for Vision Language Models论文阅读笔记 - 知乎
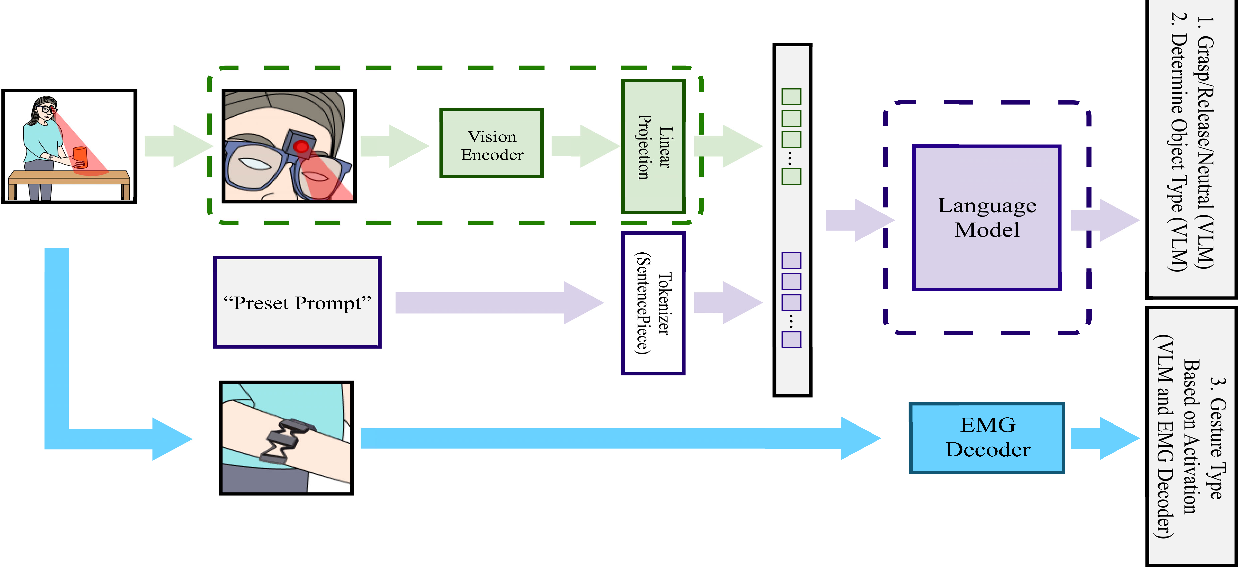
Figure 1 from Lightweight Vision Language Model-Guided Gesture ...
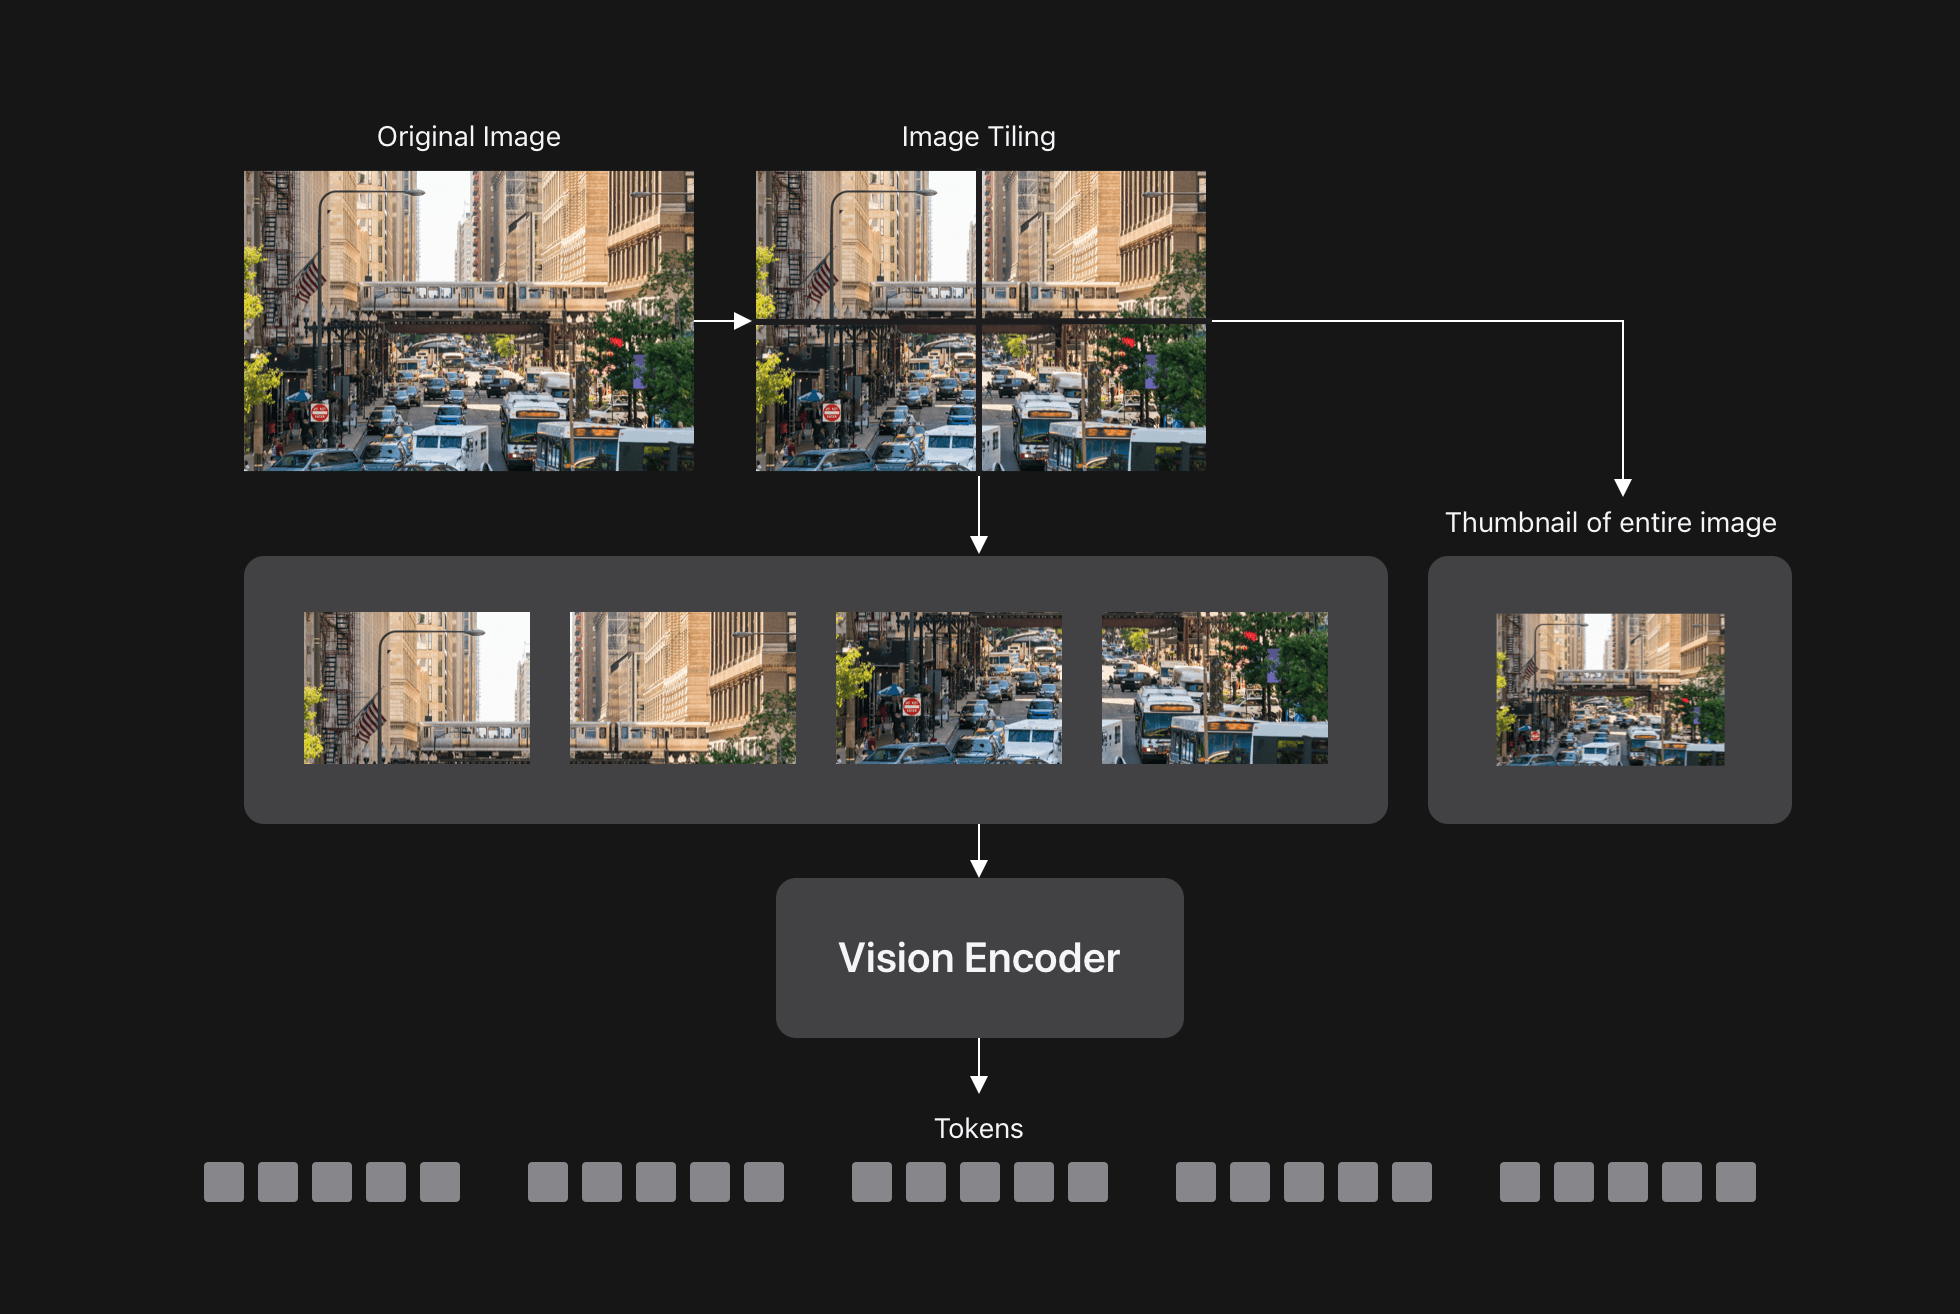
FastVLM: Efficient Vision Encoding for Vision Language Models - Apple ...

论文精读:Vary: Scaling up the Vision Vocabulary for Large Vision-Language ...