
Vector Quantized Vision Foundation Models For Object Centric Learning

Vector-Quantized Vision Foundation Models for Object-Centric Learning ...

[论文评述] Vector-Quantized Vision Foundation Models for Object-Centric ...
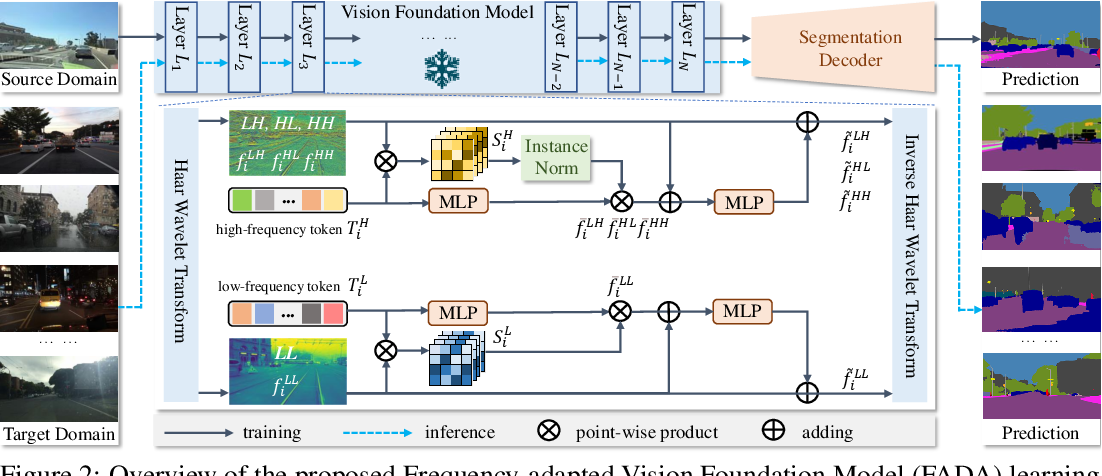
Figure 2 from Learning Frequency-Adapted Vision Foundation Model for ...

Exploring Autoregressive Vision Foundation Models for Image Compression ...

Distilling Diverse Vision Foundation Models to Improve Robot Learning ...

Forging Vision Foundation Models for Autonomous Driving: Challenges ...

InternVL: Scaling up Vision Foundation Models and Aligning for Generic ...

[논문 리뷰] Decoupled Prototype Matching with Vision Foundation Models for ...
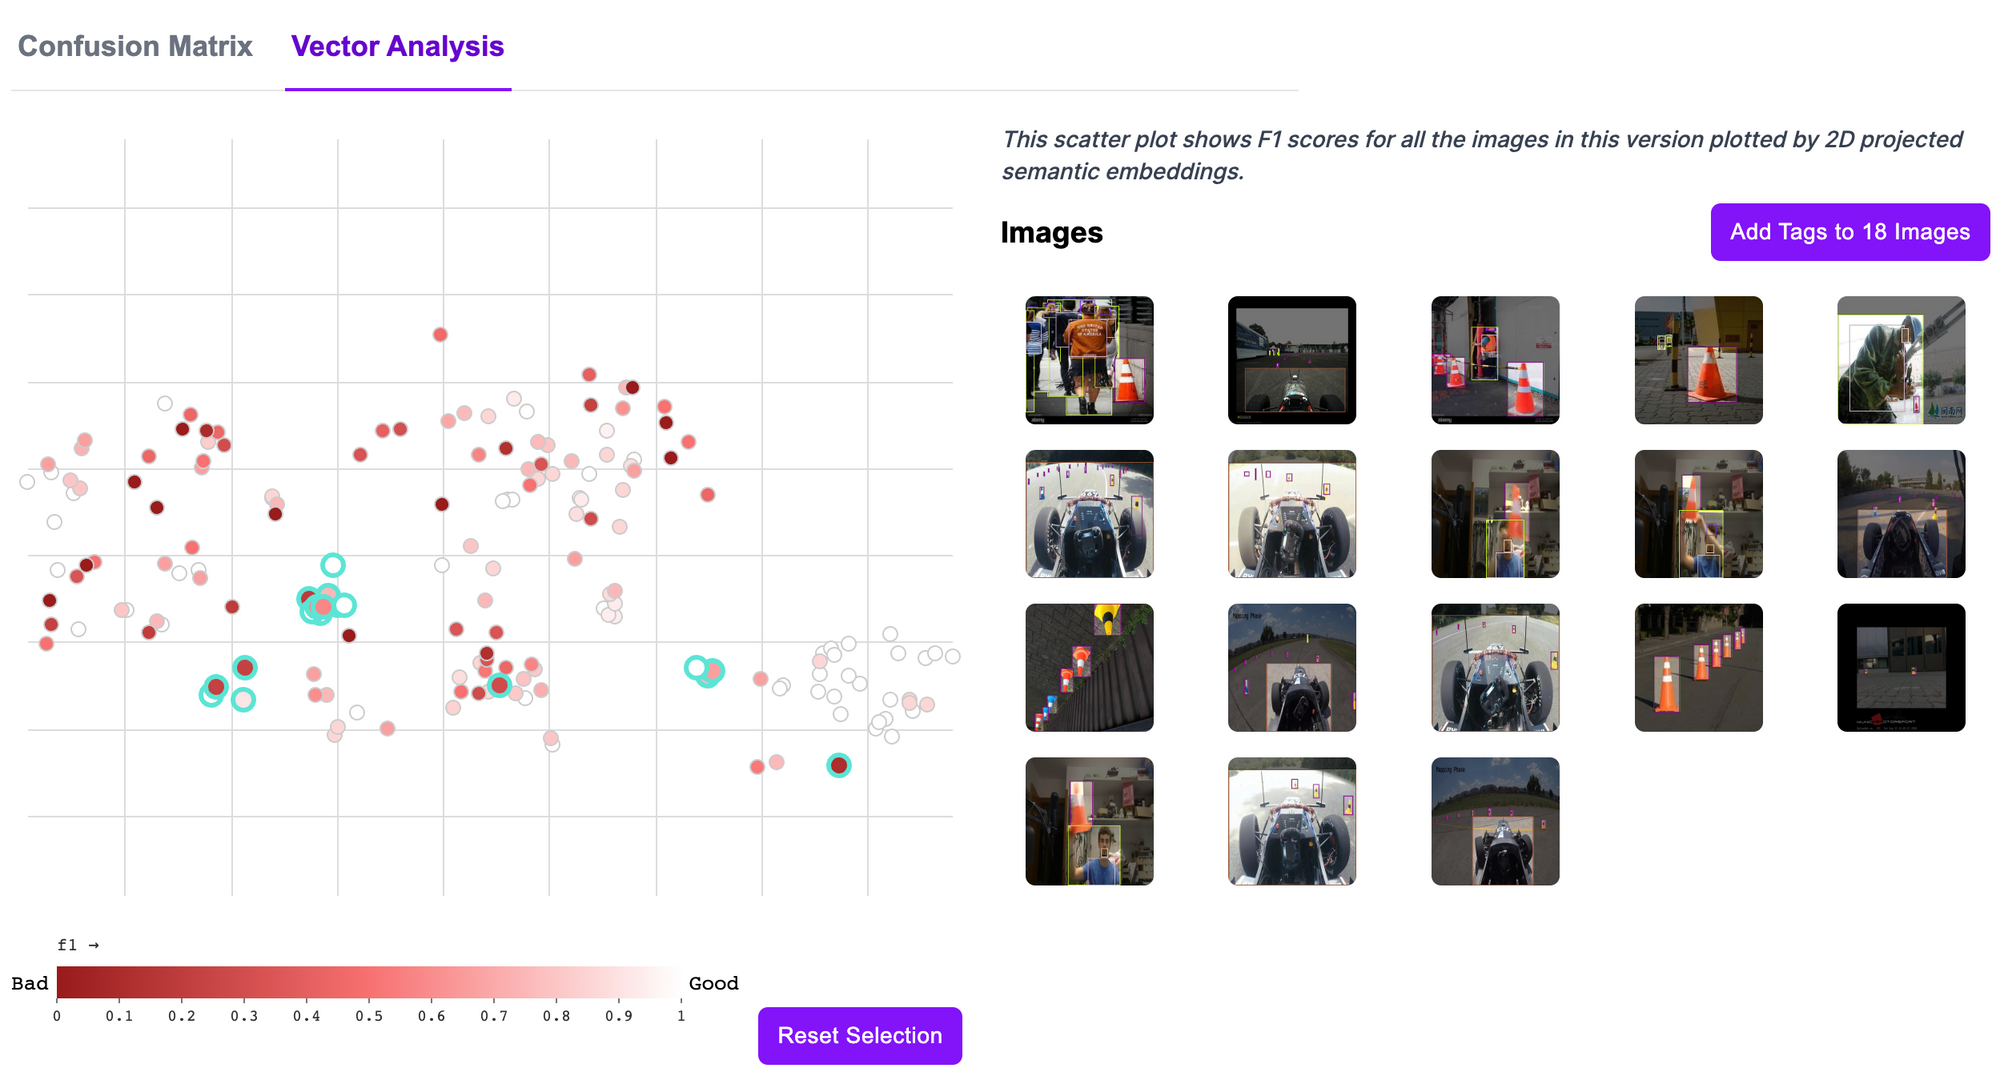
Use Cases for Computer Vision Foundation Models

Hierarchical Imitation Learning with Vector Quantized Models | DeepAI
Advertisement Space (300x250)
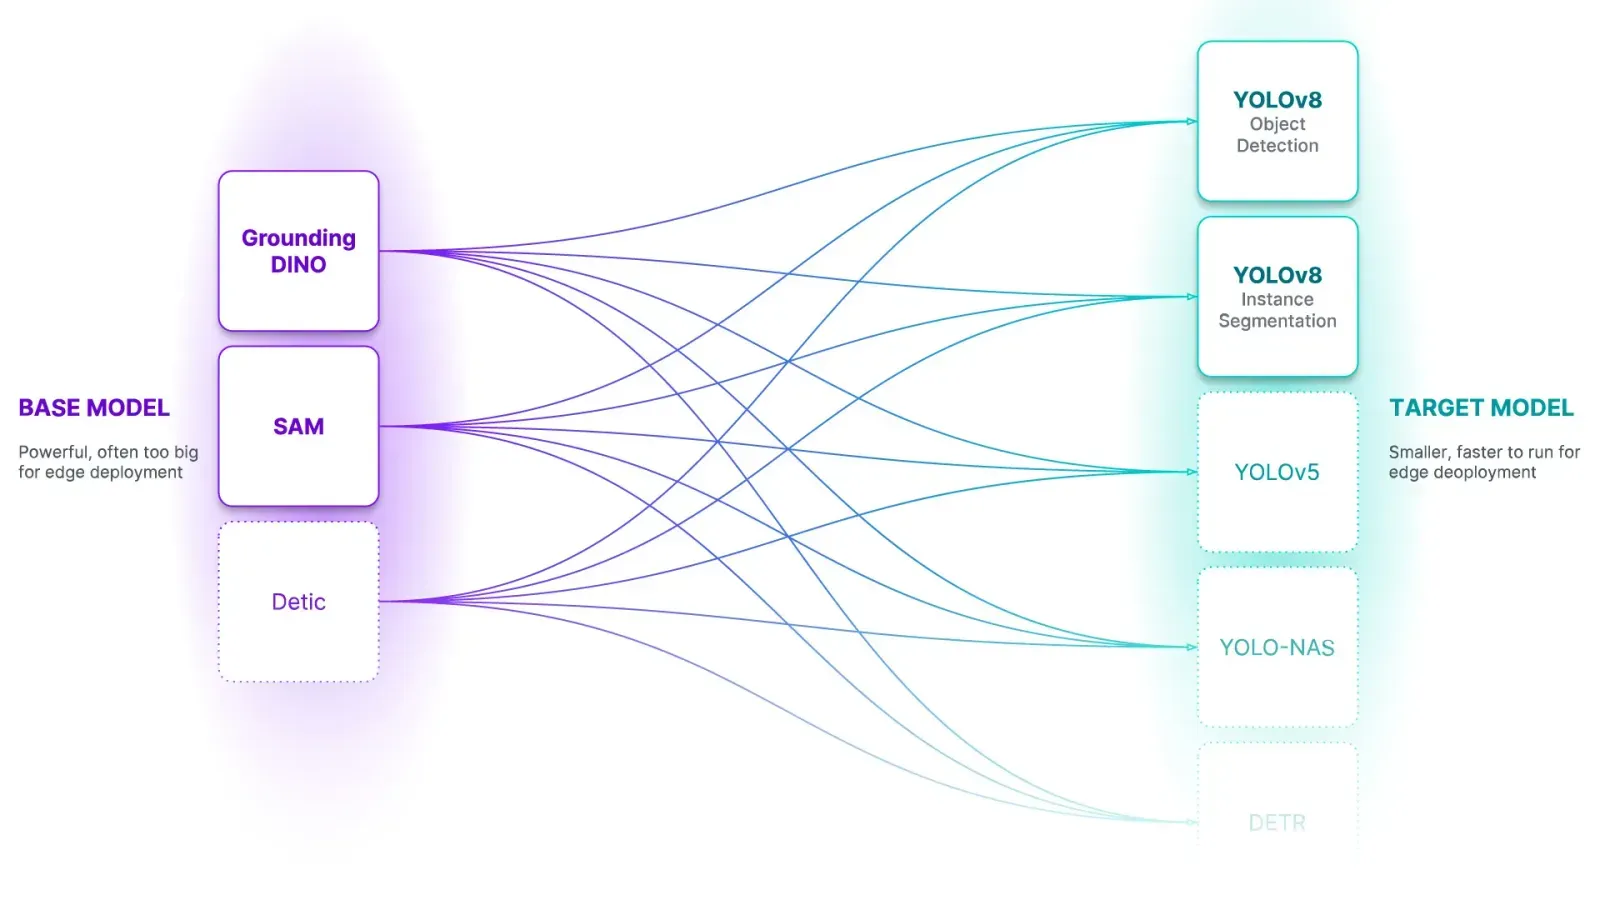
Use Cases for Computer Vision Foundation Models

Overview on the architecture for object learning and recognition [14 ...

General lightweight framework for vision foundation model supporting ...

Object-Centric Vision Token Pruning for Vision Language Models | AI ...
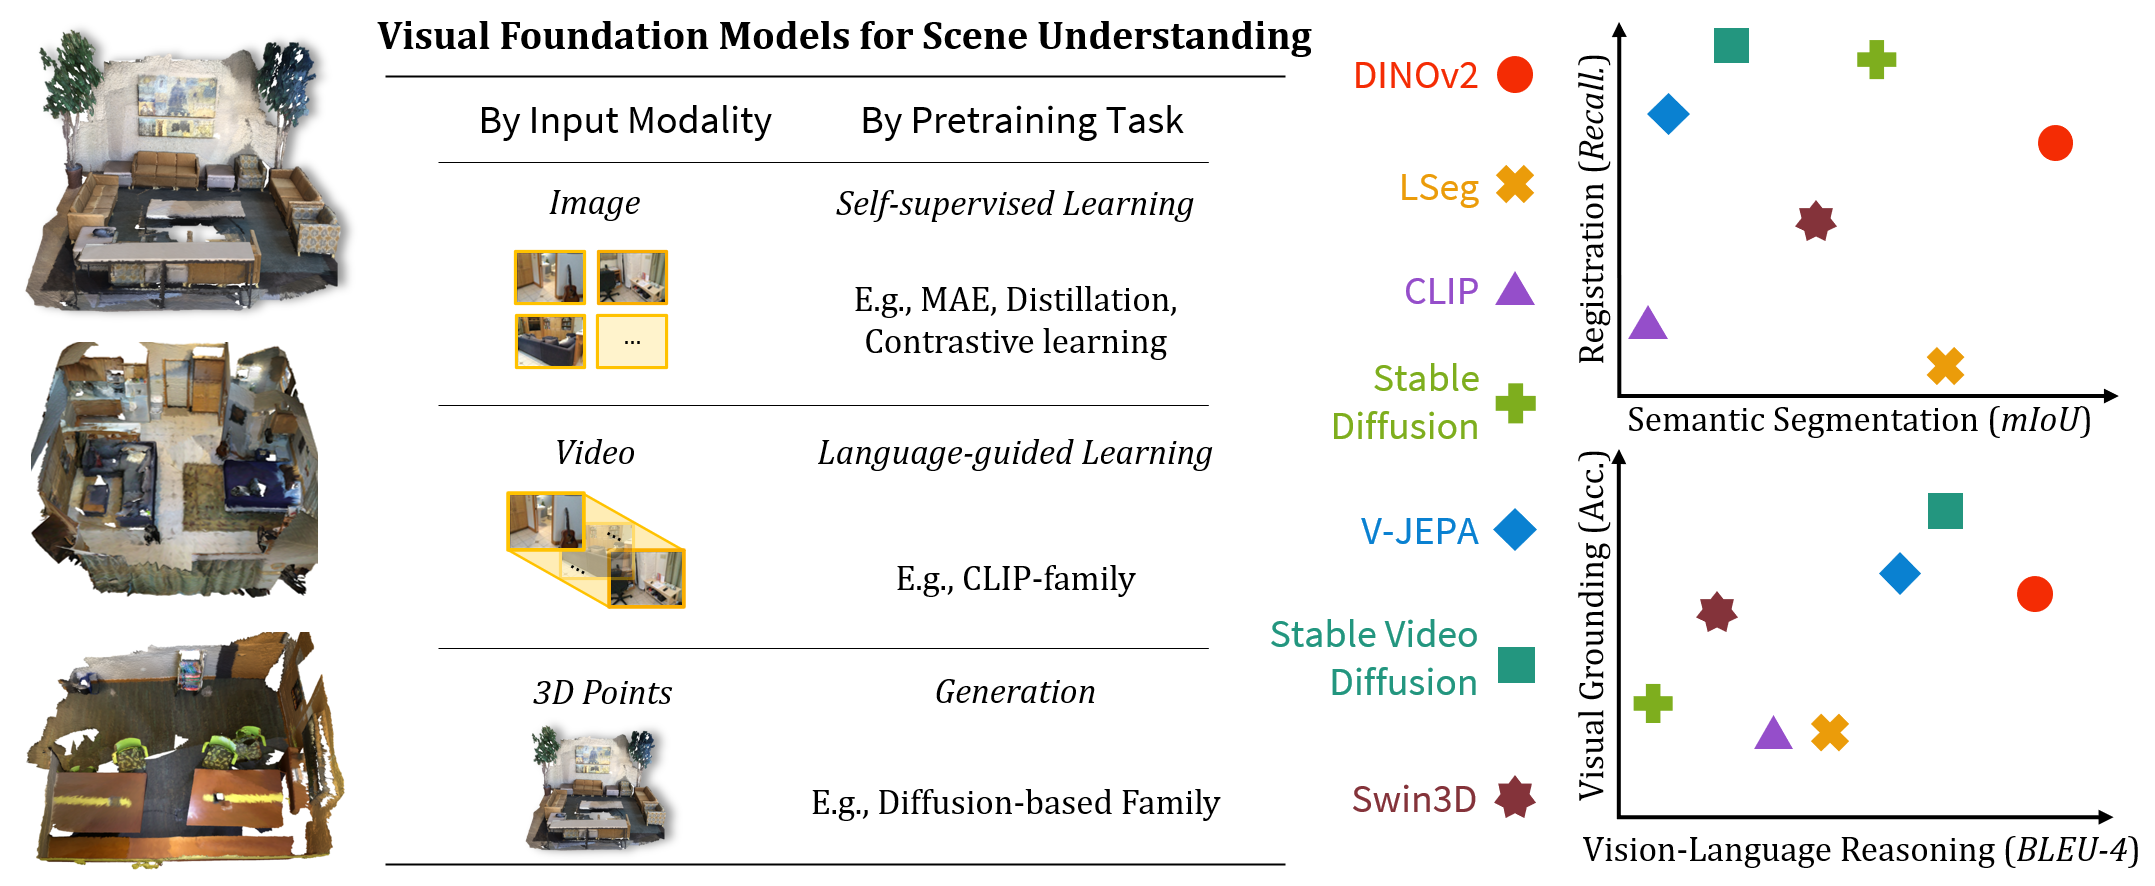
Lexicon3D: Probing Visual Foundation Models for Complex 3D Scene ...

Foundation Model for Visual Perception | Fundamental Vision Lab

The Foundation Models Reshaping Computer Vision – DevStream

Figure 1 from Linking vision and motion for self-supervised object ...

Full article: Learning global spatial information for multi-view object ...

[2312.09158] General Object Foundation Model for Images and Videos at Scale
Advertisement Space (336x280)

Figure 1 from Interpreting and Controlling Vision Foundation Models via ...

[论文评述] Vector Quantization Prompting for Continual Learning

Quantized Models for FoundationVision/Infinity – Hugging Face

Can Vision Foundation Models Navigate? Zero-Shot Real-World Evaluation ...

Learning Disentangled Representation in Object-Centric Models for ...

(PDF) Vision Foundation Models in Remote Sensing: A Survey

Foundation Model for Visual Perception | Fundamental Vision Lab

Aligned Vector Quantization for Edge-Cloud Collabrative Vision-Language ...

Object-Centric Multi-Task Learning for Human Instances

VQ-VLA: Improving Vision-Language-Action Models via Scaling Vector ...
Advertisement Space (336x280)

Robust Vision-Language-Action Models via Object-Centric Learning and ...

Quantized Models at Ryan Horsfall blog
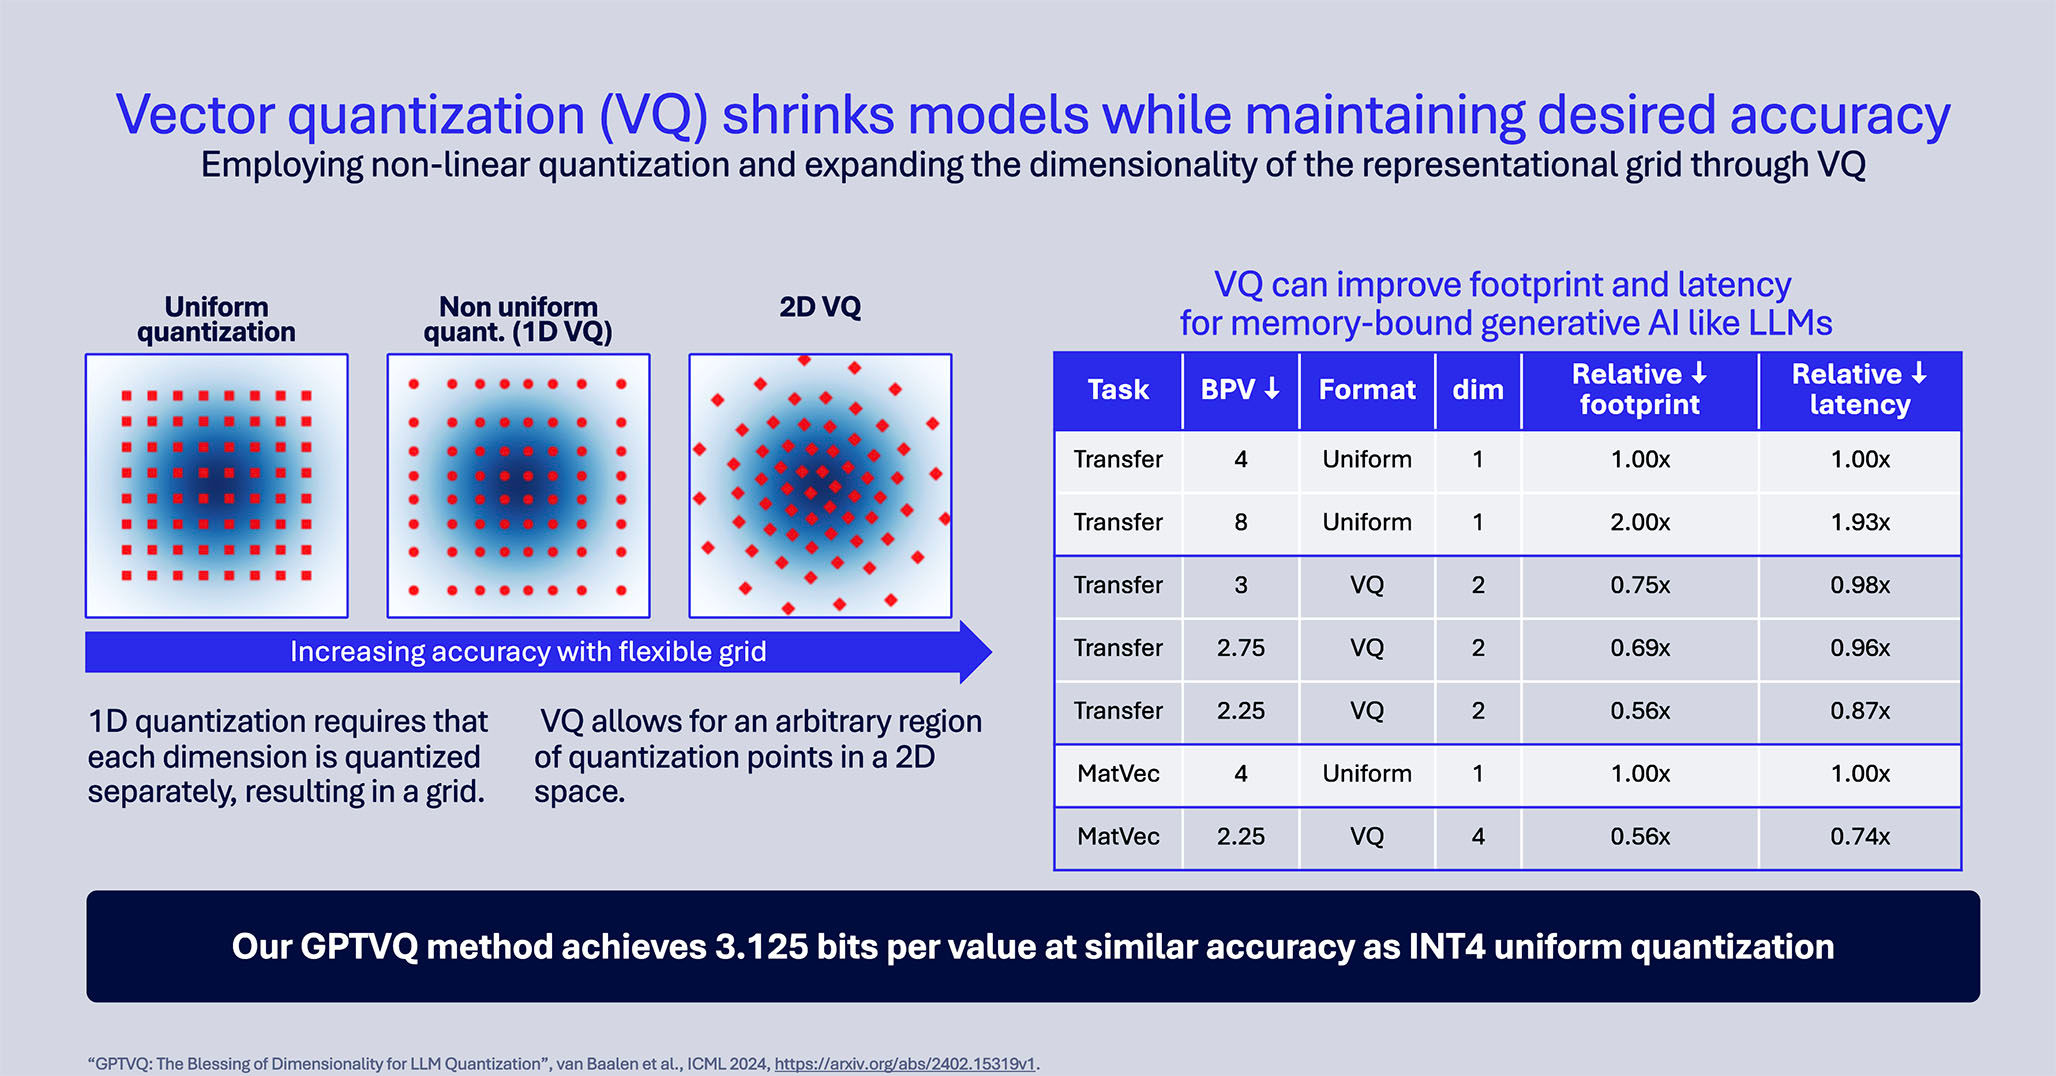
Quantization: Unlocking Scalability for Large Language Models - Edge AI ...
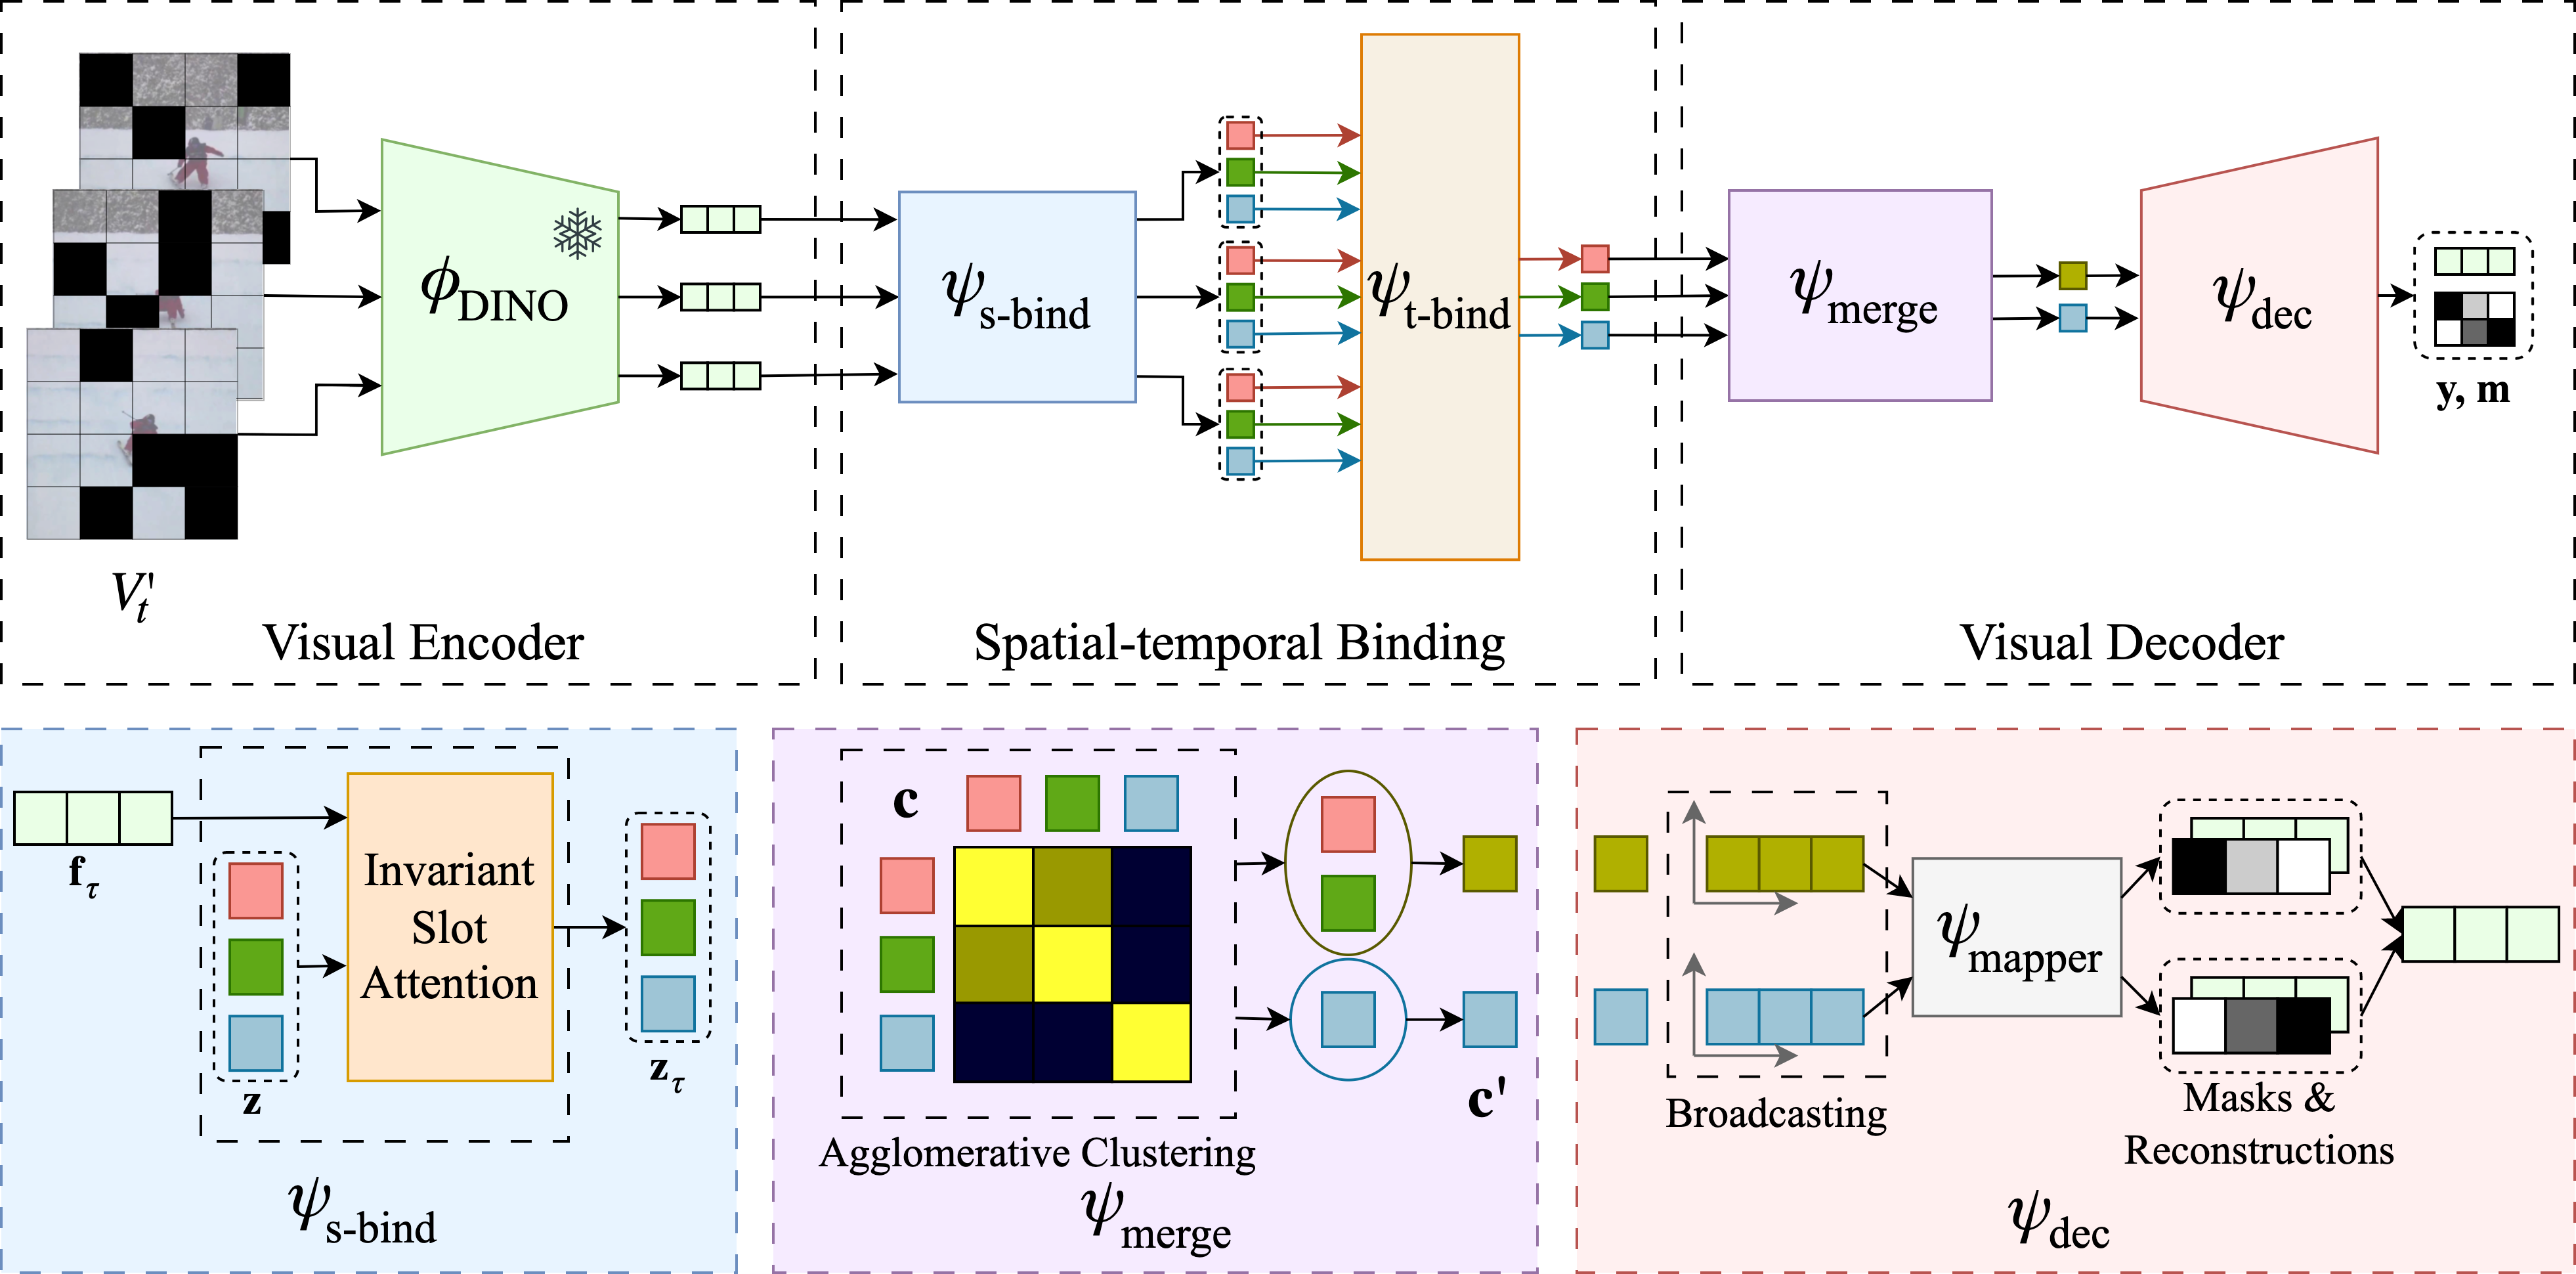
Self-supervised Object-Centric Learning for Videos

[Literature Review] Towards 3D Object-Centric Feature Learning for ...

Probing the 3D Awareness of Visual Foundation Models - Luigi Freda