
Vllm V1 Alpha Is Here 17x Faster Re Architected Core Significant

🚀 vLLM V1 Alpha is here: 1.7x Faster, Re-architected core & Significant ...

vLLM v1 Engine: How Faster Is It for RTX and Mid-Range GPUs?
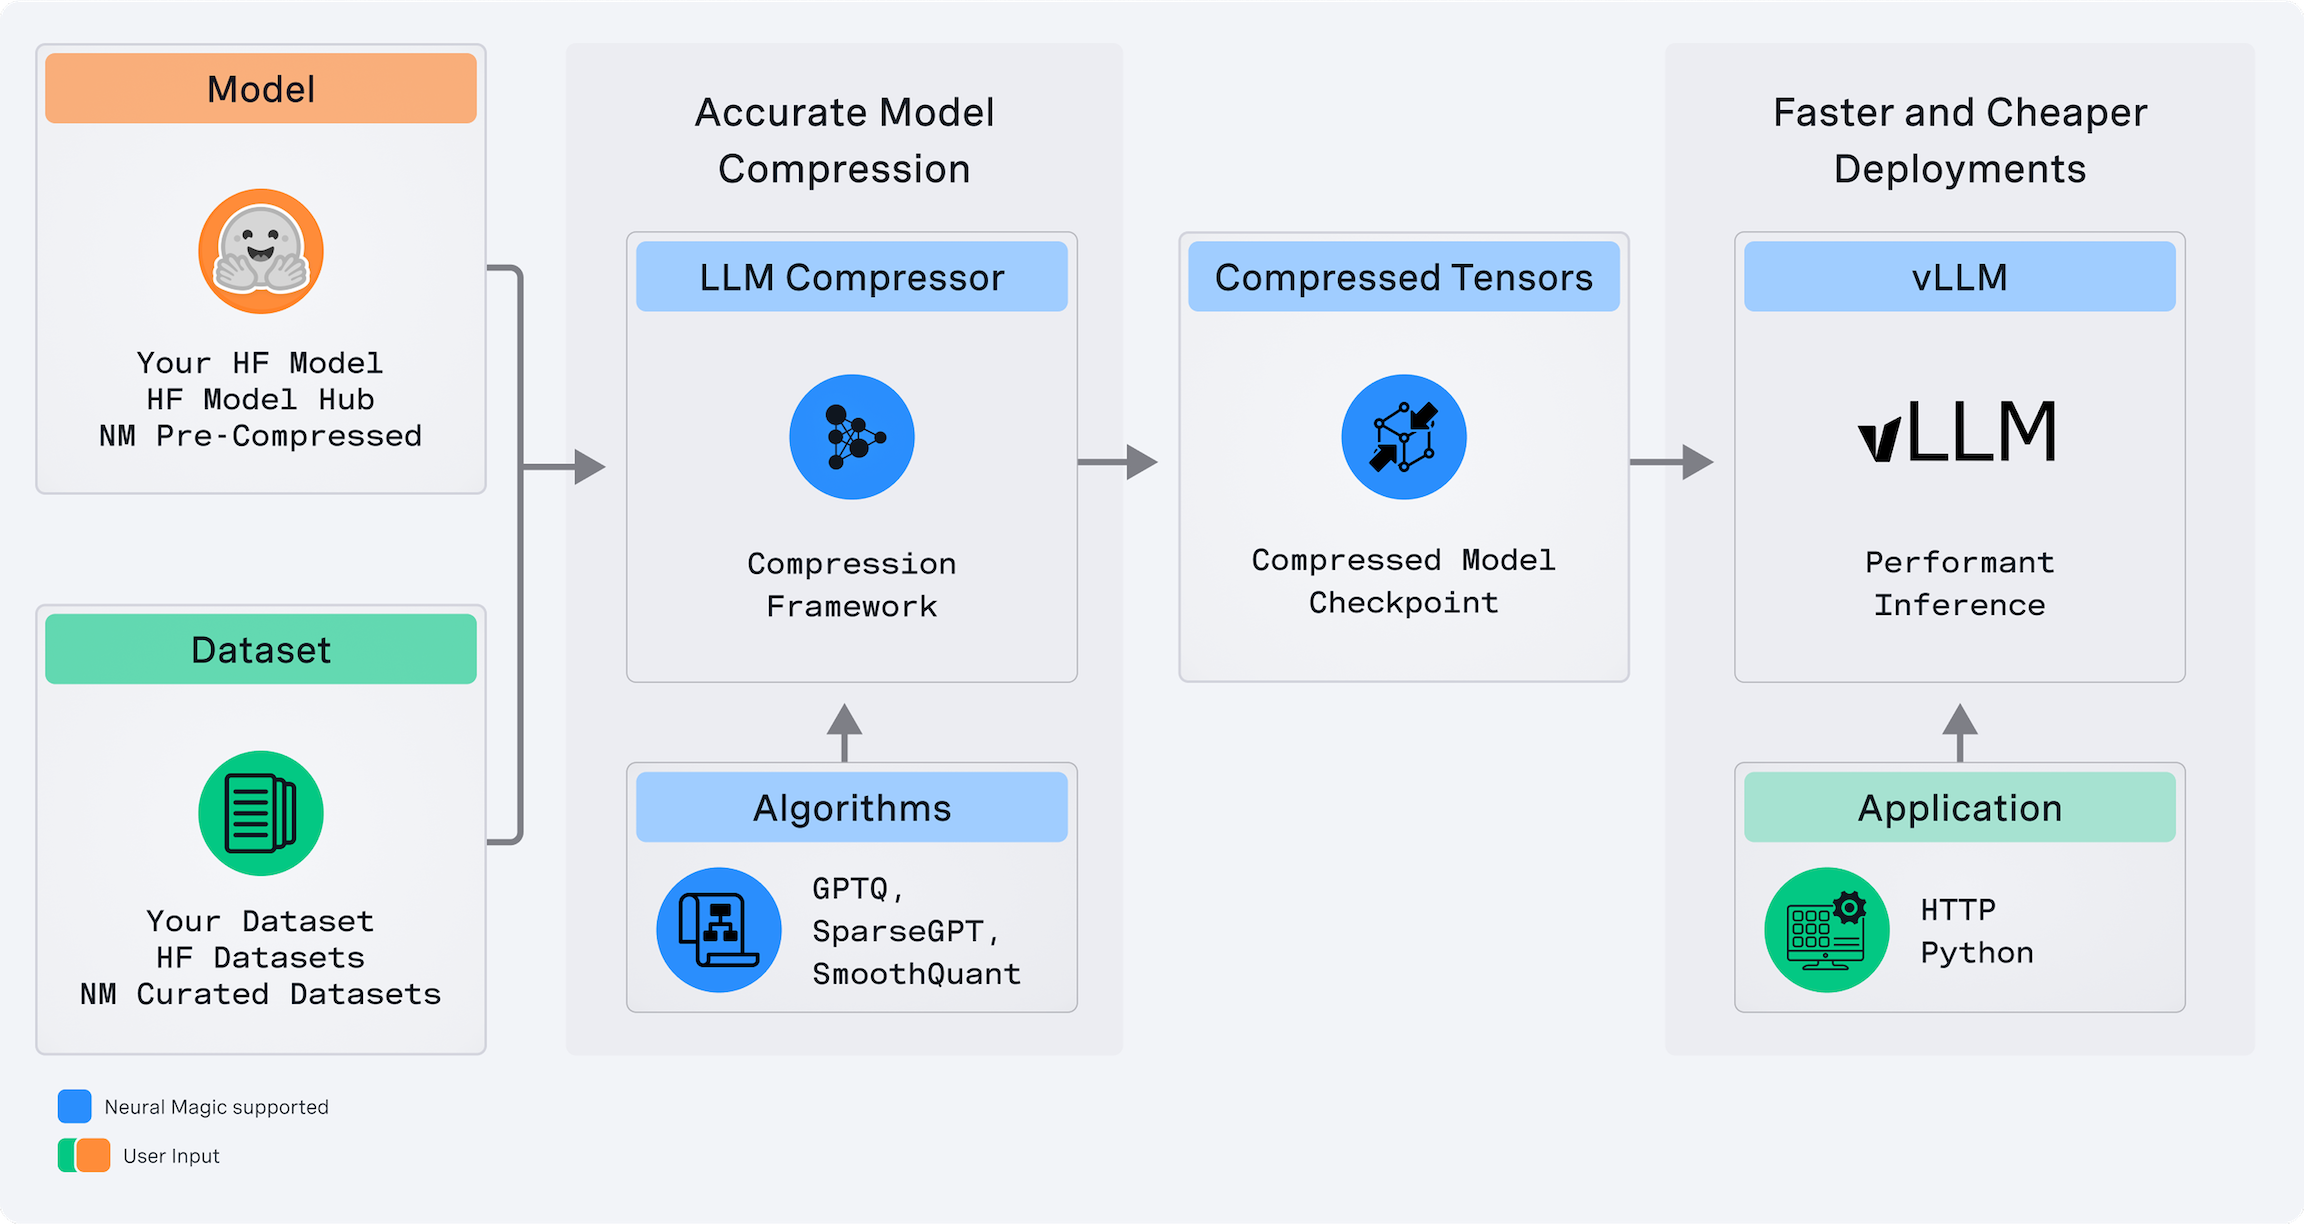
LLM Compressor is here: Faster inference with vLLM | Red Hat Developer

vLLM V1 Alpha: A major upgrade to vLLM's core architecture | Red Hat ...

vLLM V1 | OpenLM.ai

vLLM V1 重磅升级:核心架构全面革新-CSDN博客

(二) vllm v1 推理过程(单机单卡) - 知乎
vLLM V1: A Major Upgrade to vLLM's Core Architecture | vLLM Blog

🚀 vLLM v0.20.0 is here! I’m excited about TurboQuant! • 752 commits ...

vLLM v1 PD分离设计 - 知乎
Advertisement Space (300x250)
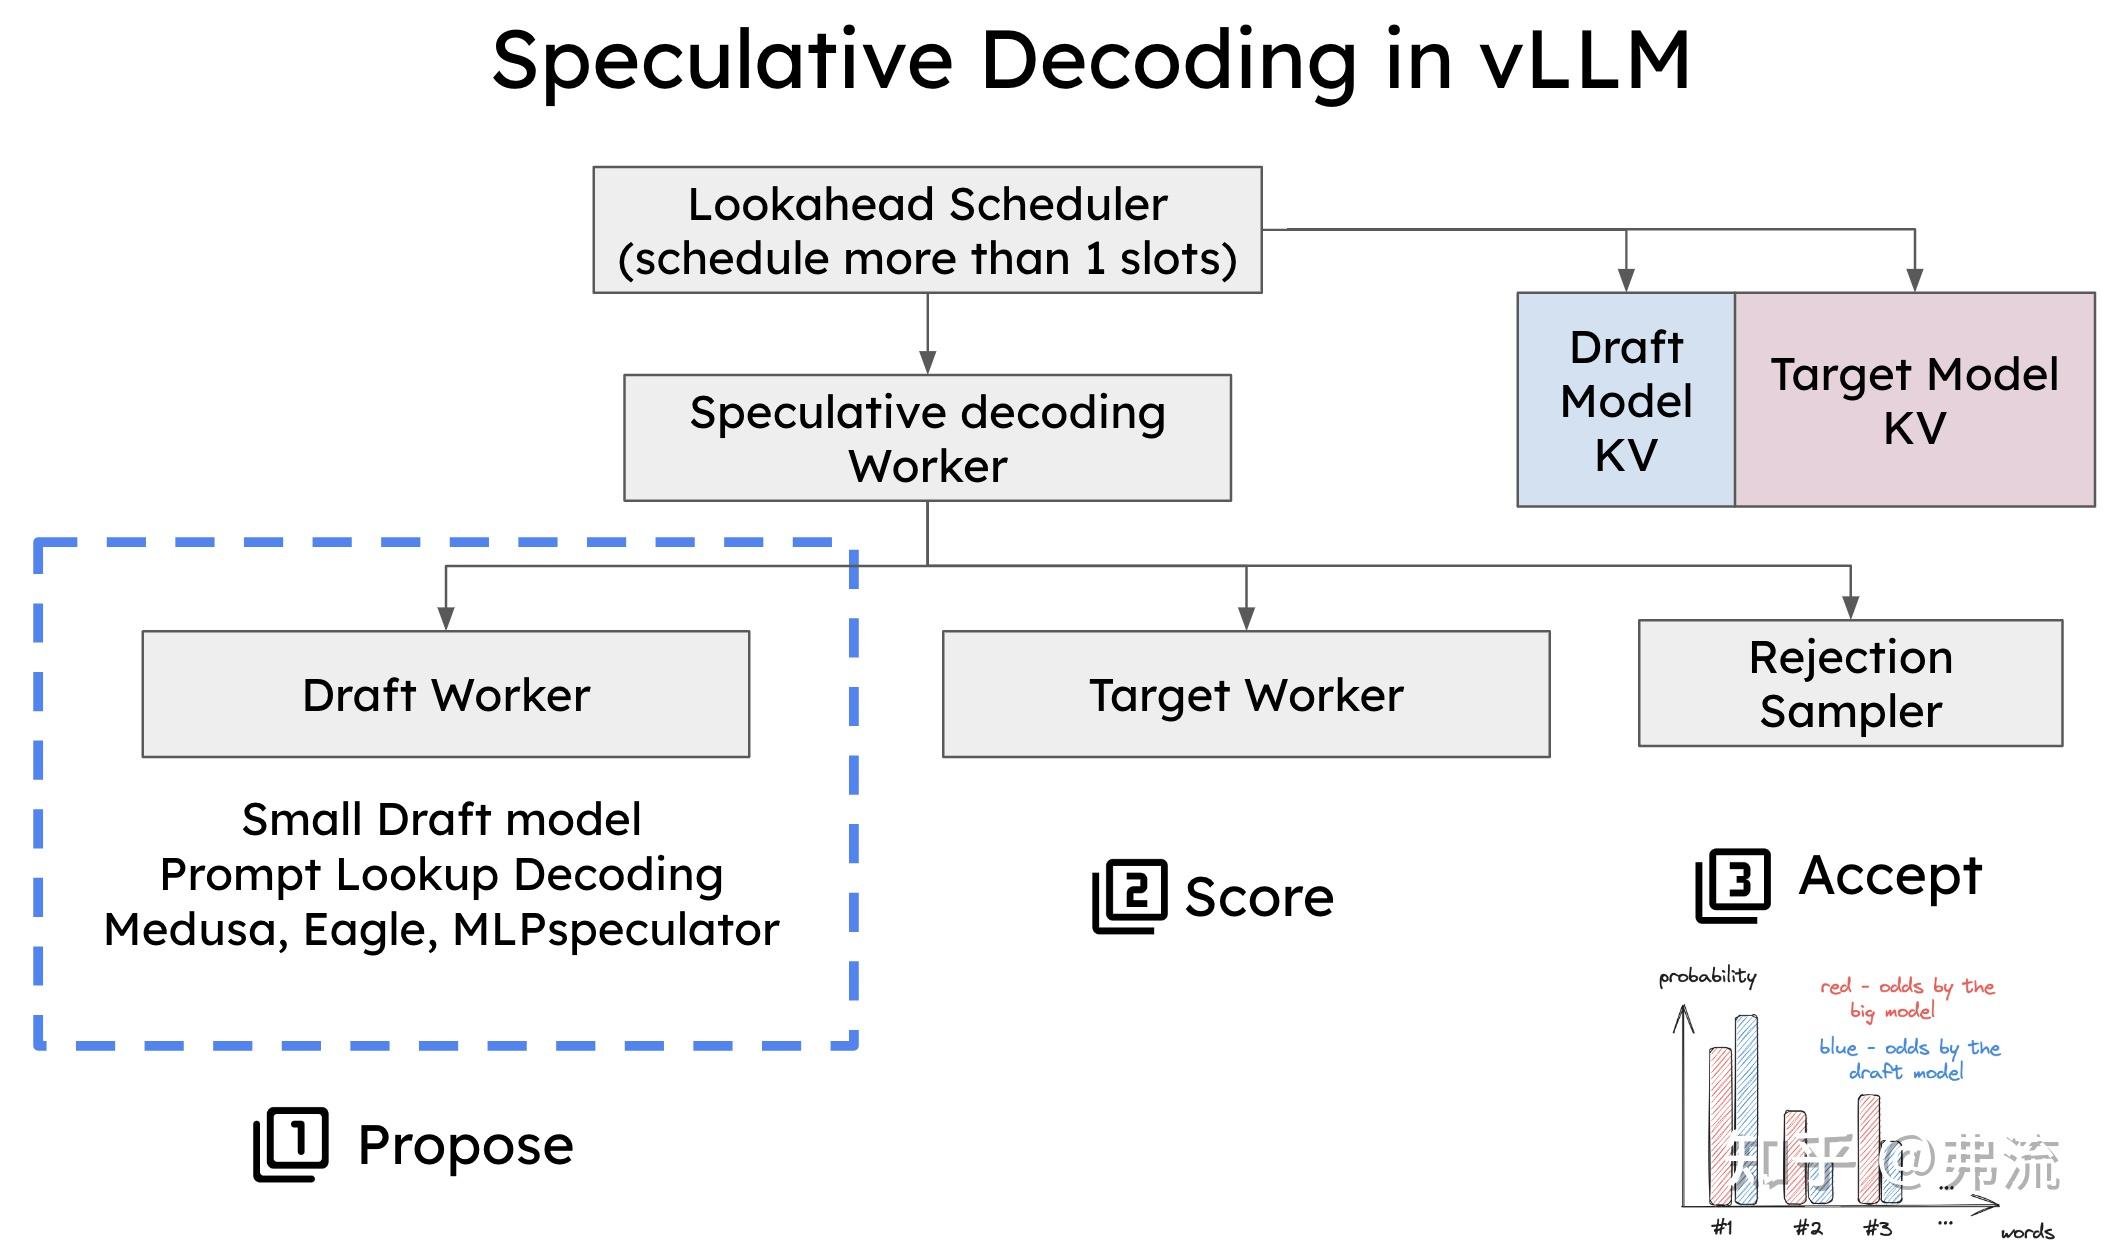
vLLM V1 源码解读(七):Speculative Decoding——让大模型一次验收多个 token - 知乎

vLLM V1 重磅升级:核心架构全面革新-CSDN博客

vLLM V1 源码阅读 - 知乎
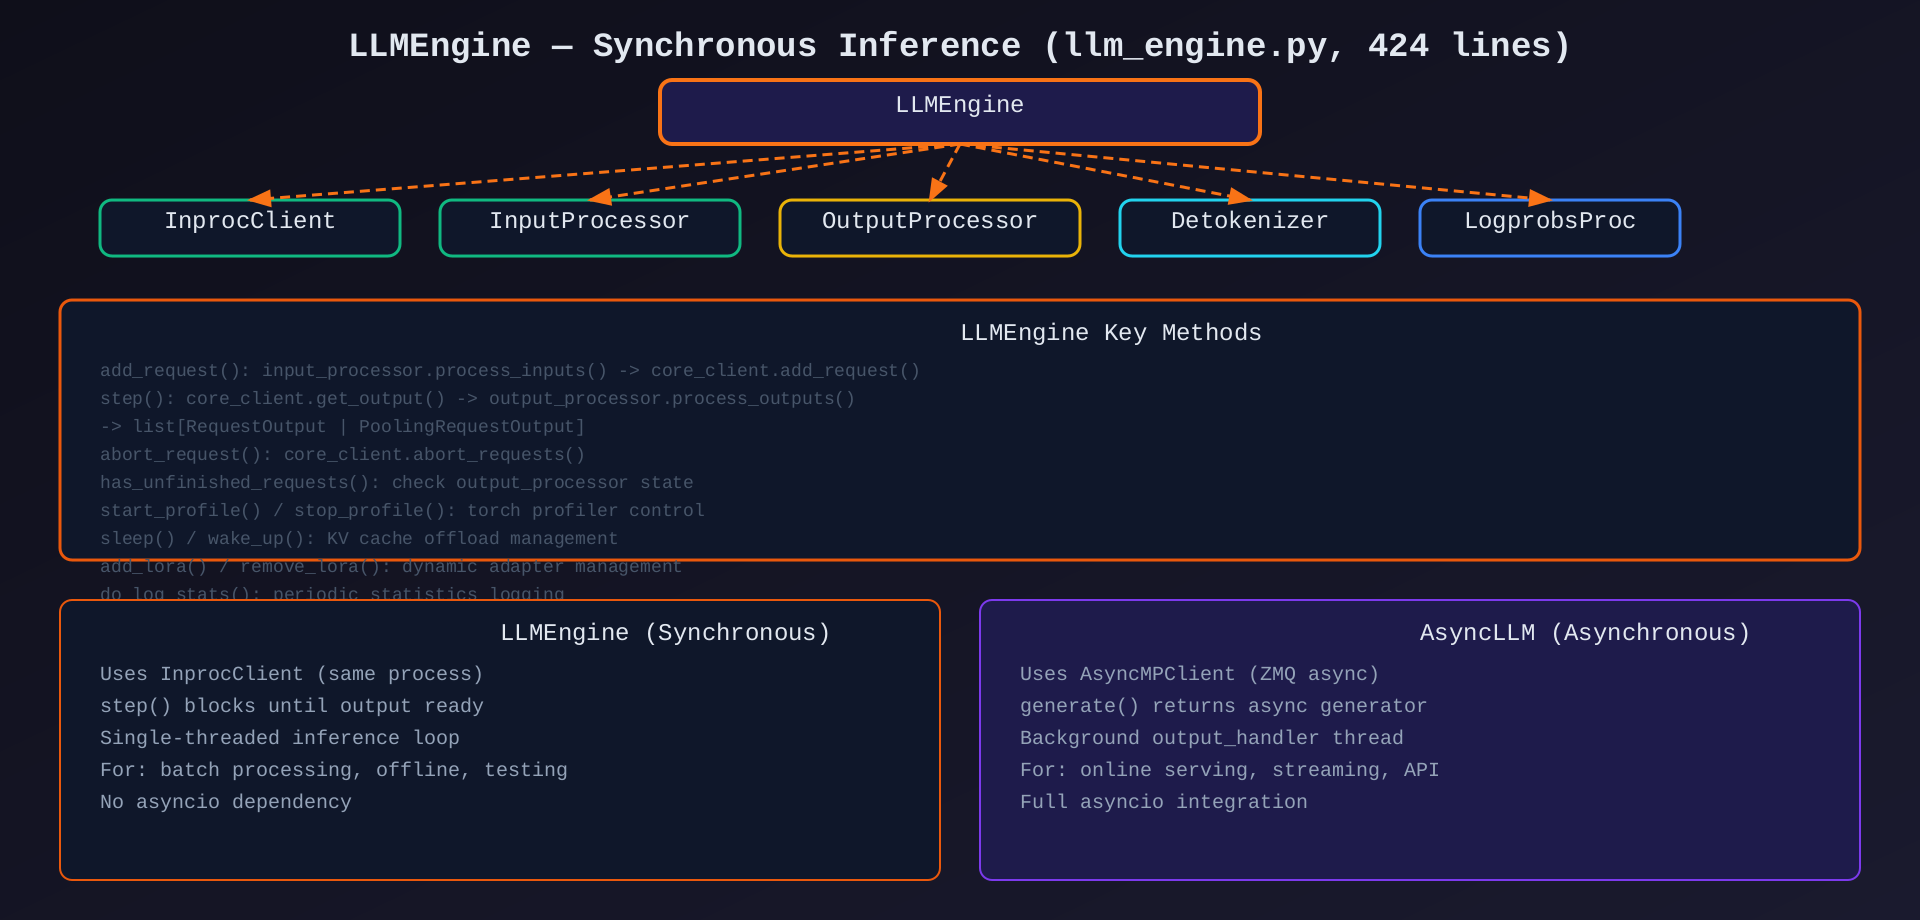
【vllm】 vLLM v1 Engine — 系统级架构深度分析(三) - 技术栈

【vllm】vLLM v1 Core — 系统级架构深度分析(四) - 技术栈
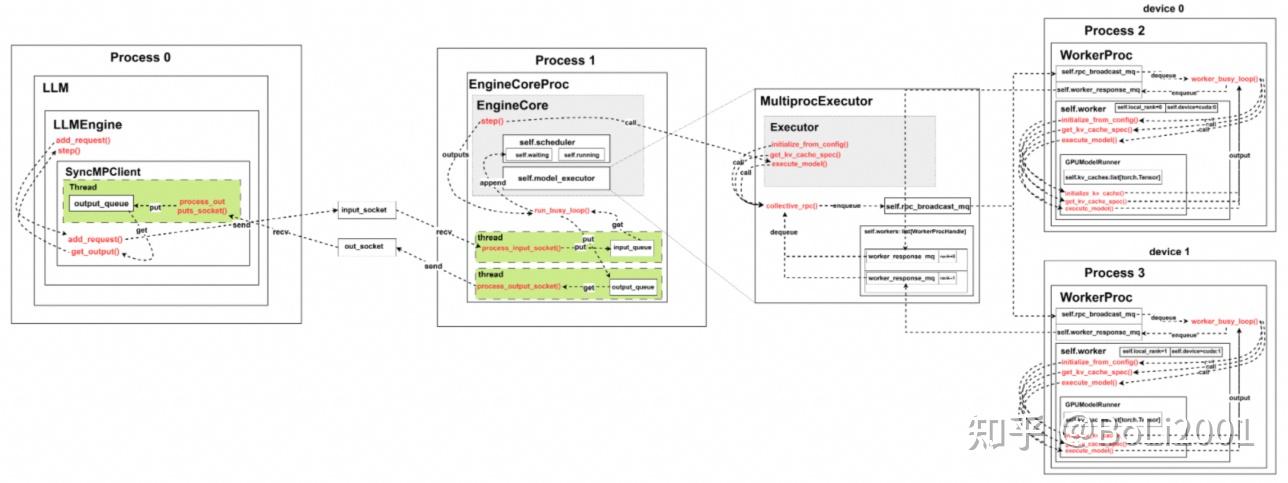
vLLM V1 源码阅读 - 知乎

vLLM V1 | OpenLM.ai
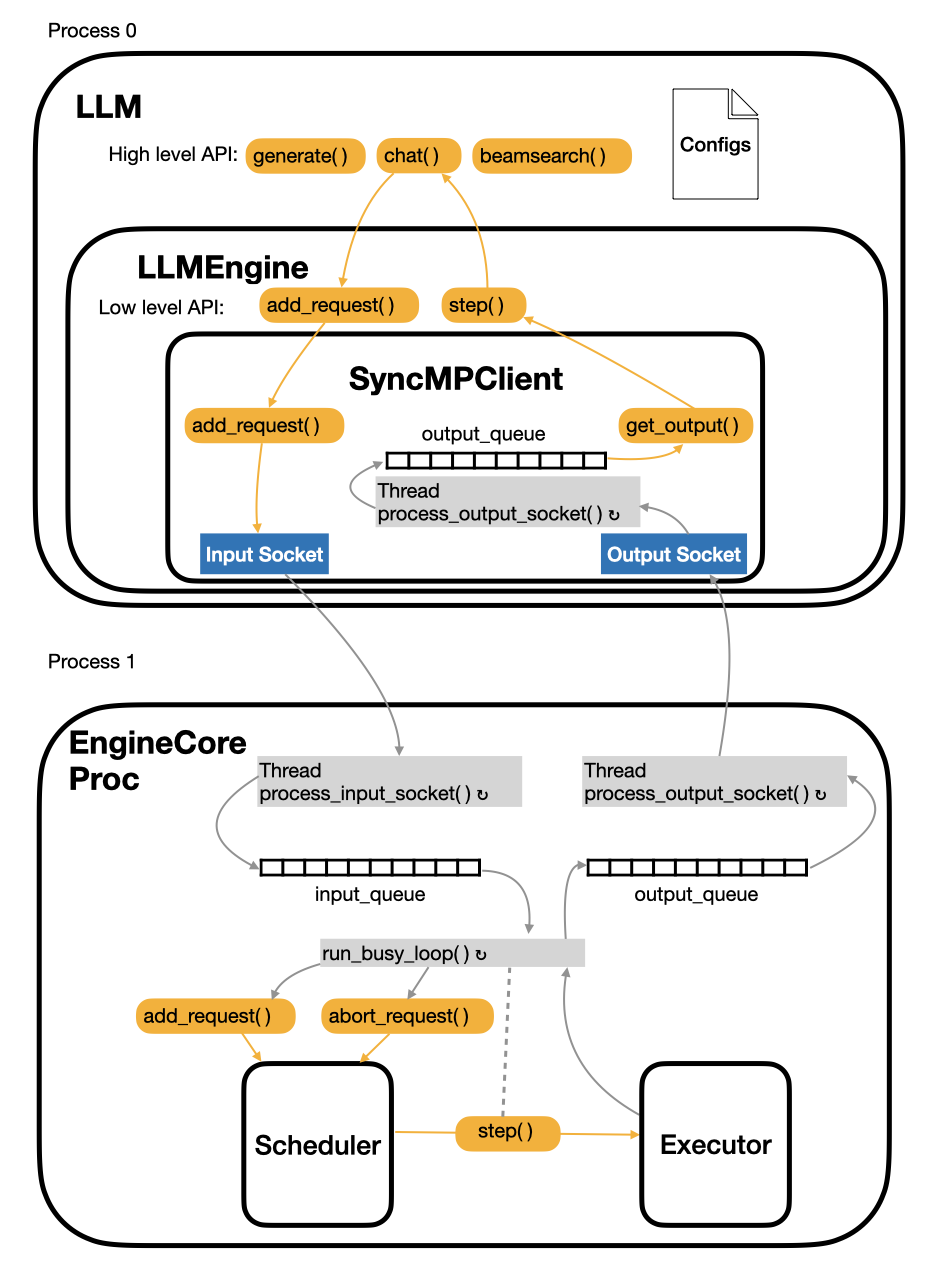
vLLM V1 Engine Design Ⅰ: The Excution Loop - Haisheng's Note Zoo

vLLM v1 PD分离设计 - 知乎

vLLM V1 整体流程|从请求到算子执行 - 知乎
Advertisement Space (336x280)
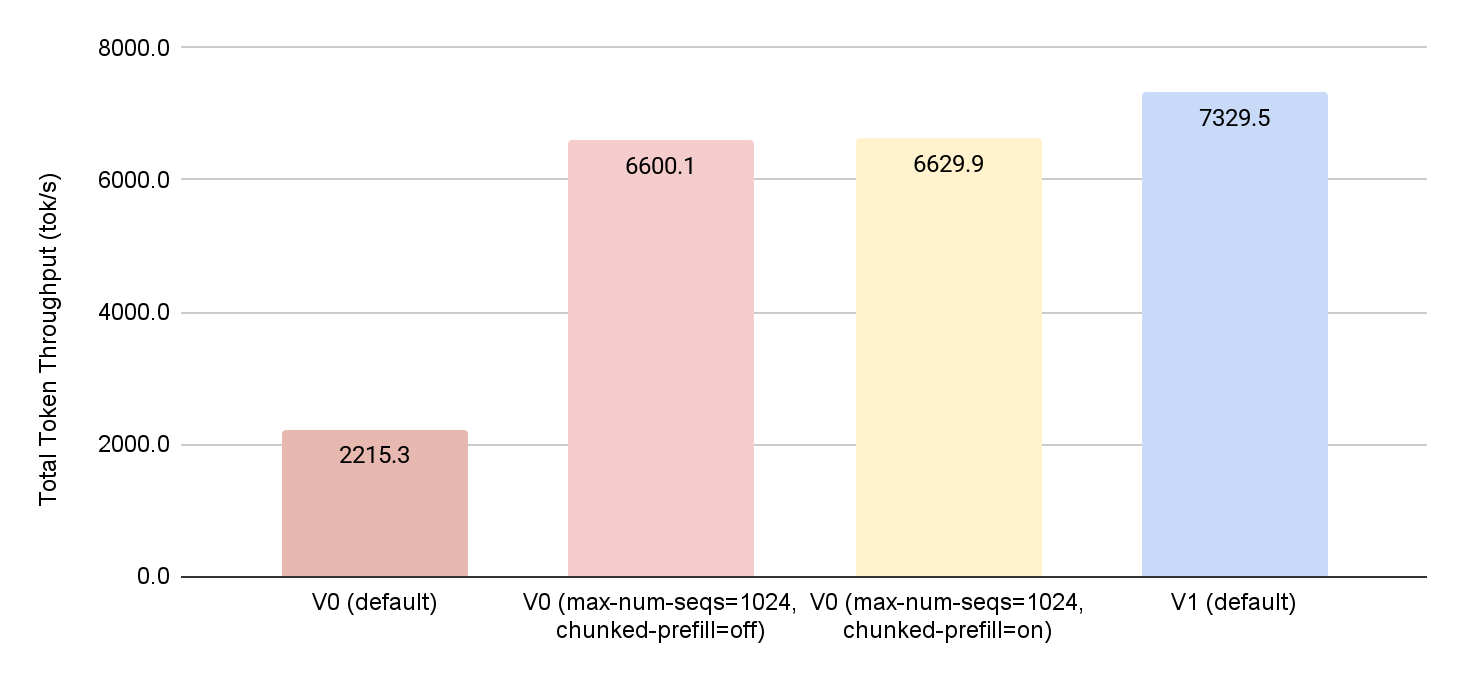
Enabling vLLM V1 on AMD GPUs With Triton – PyTorch
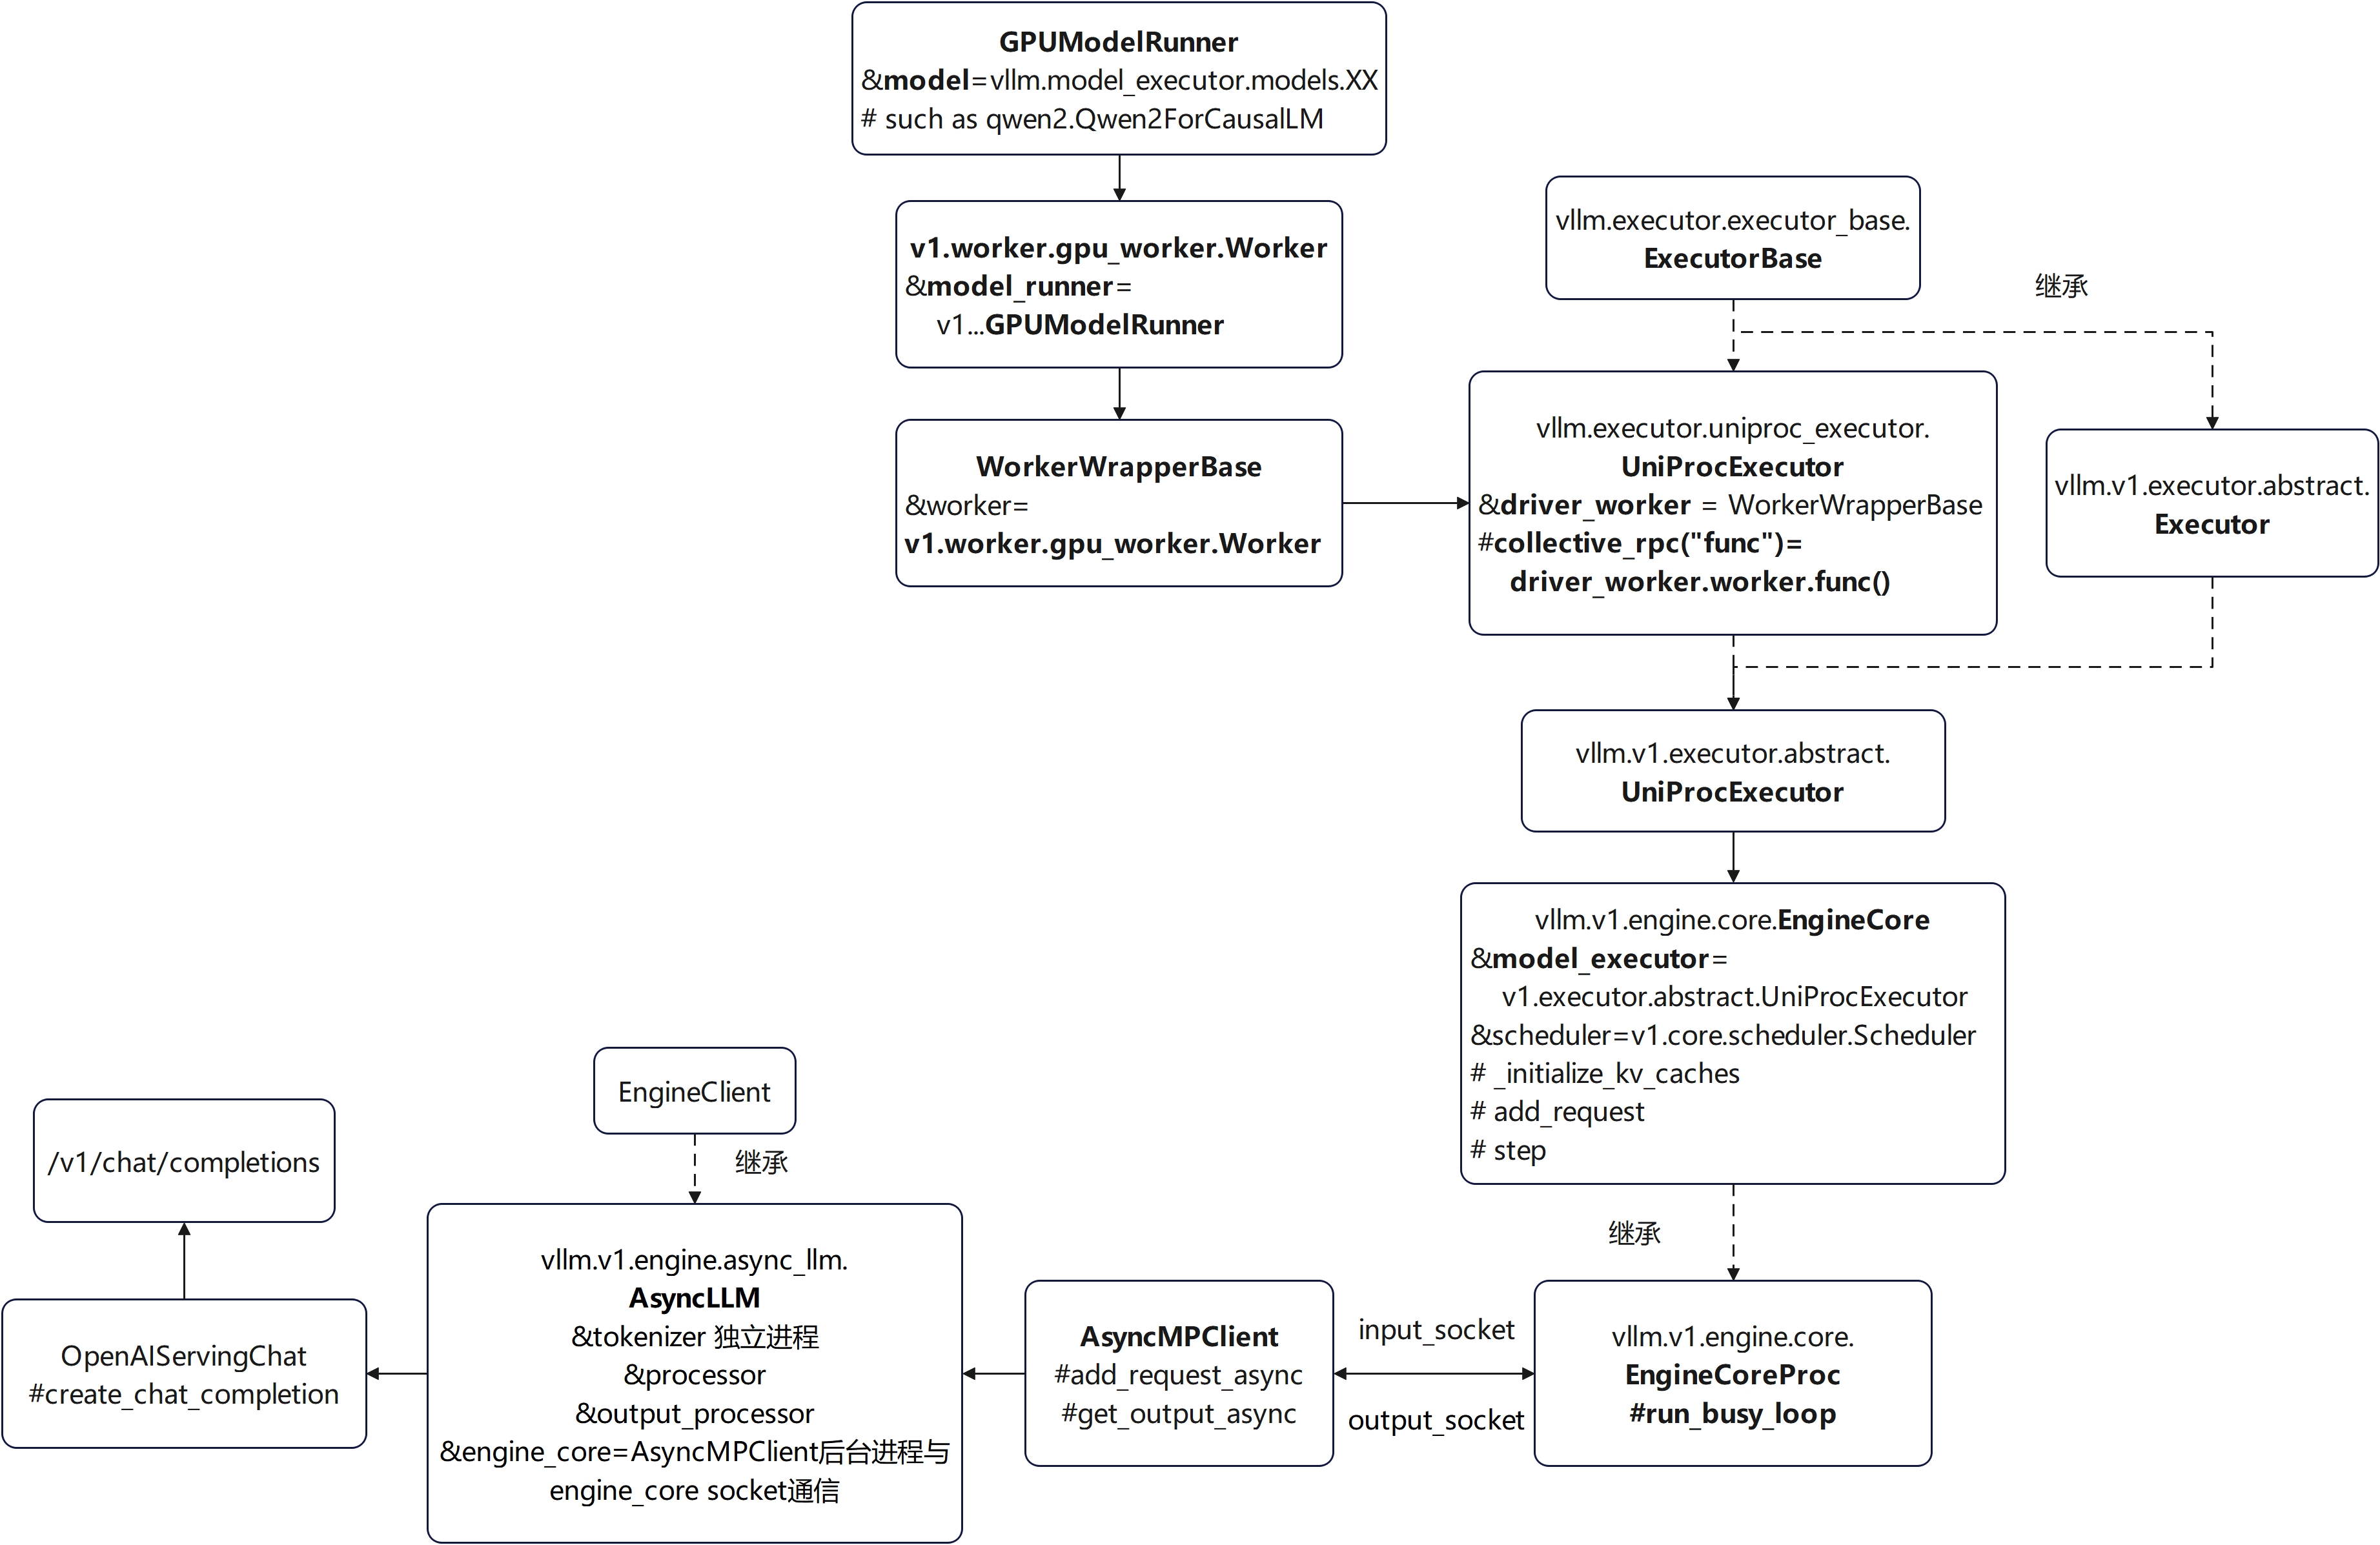
VLLM V1 serve在线推理基本流程_with `vllm serve`, you should provide the model ...

vLLM V1 ModelRunner详解 - 知乎

vLLM V1 代码走读,先睹为快!(1/2) - 知乎

(二) vllm v1 推理过程(单机单卡) - 知乎
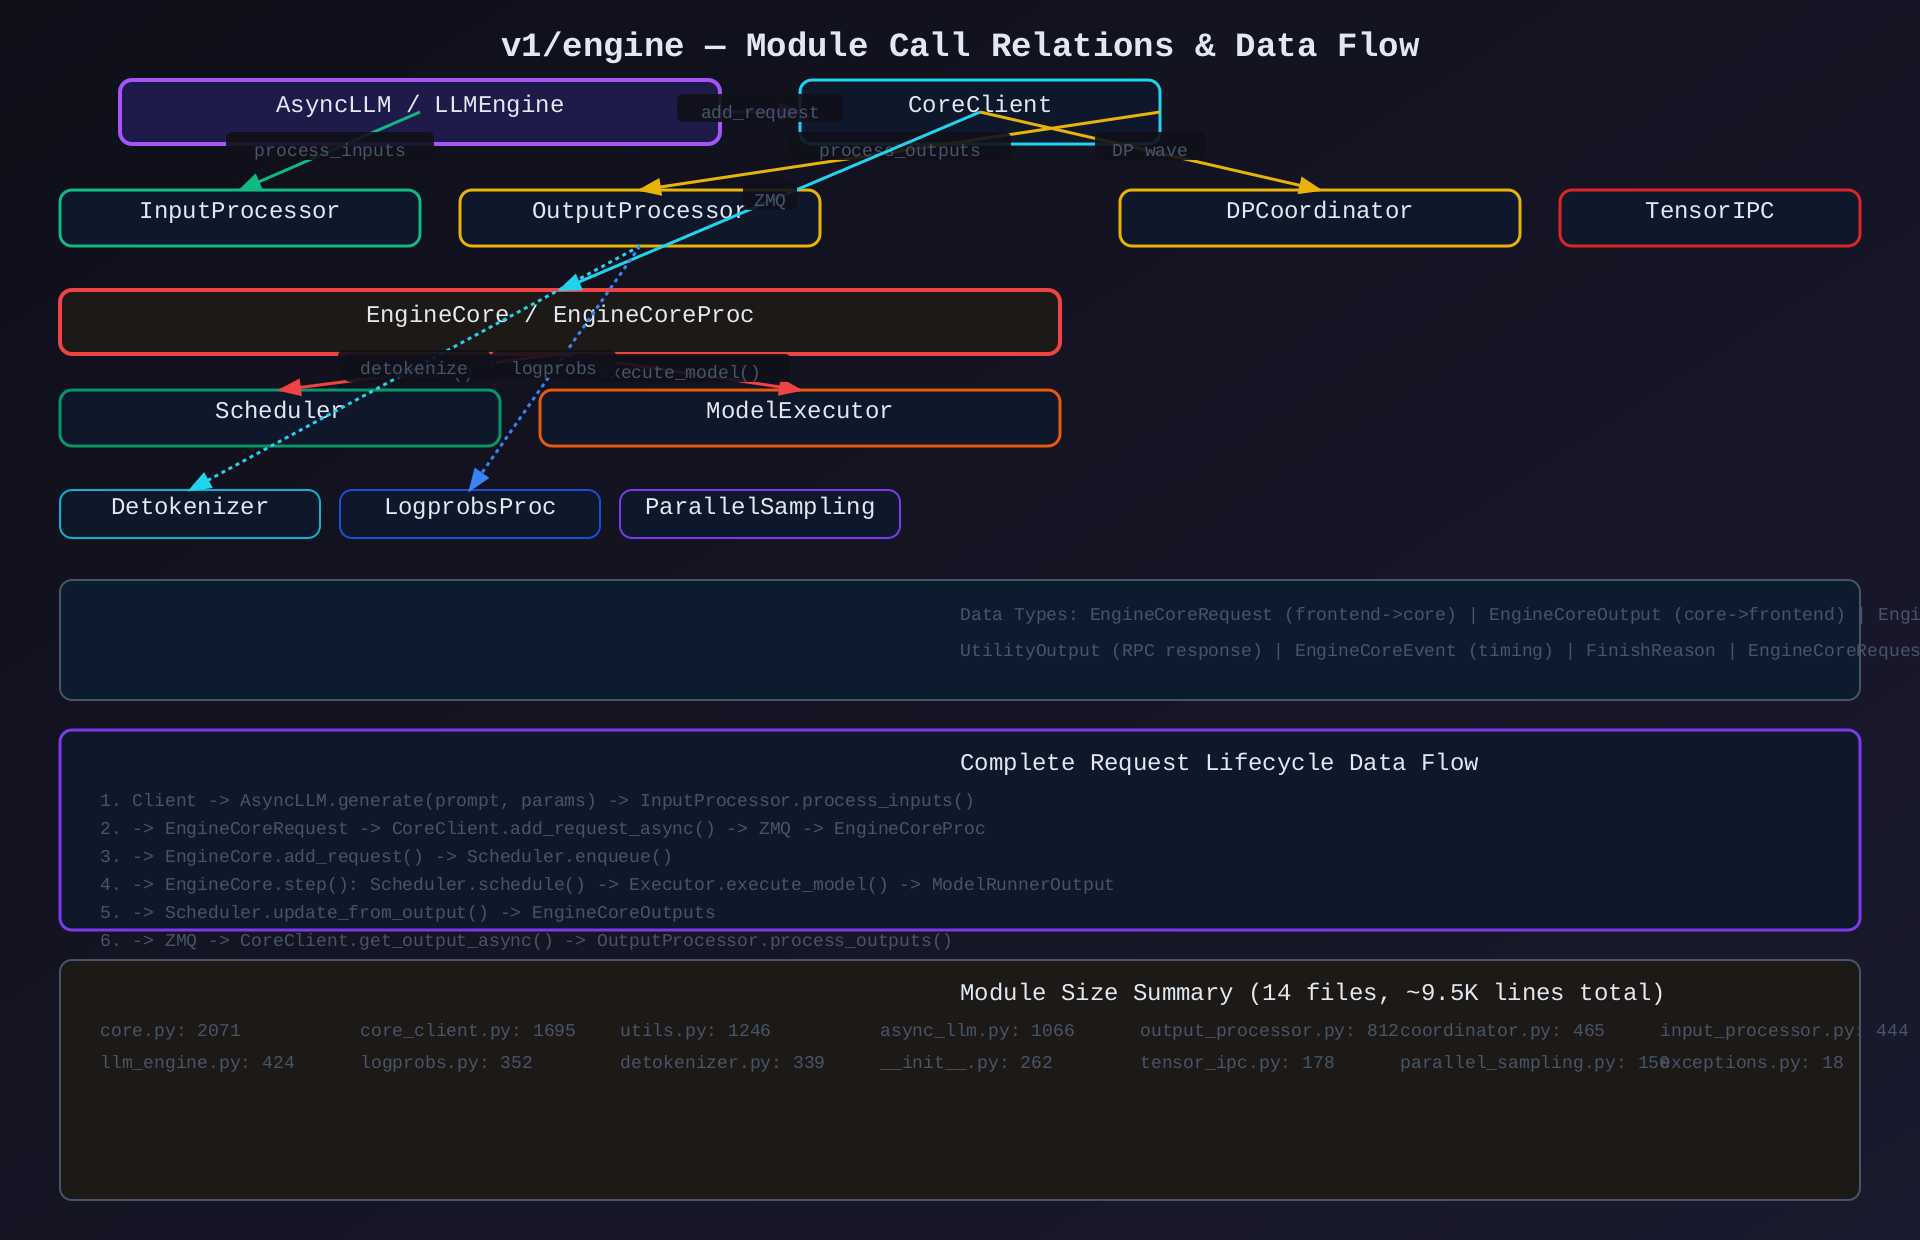
【vllm】 vLLM v1 Engine — 系统级架构深度分析(三) - 技术栈
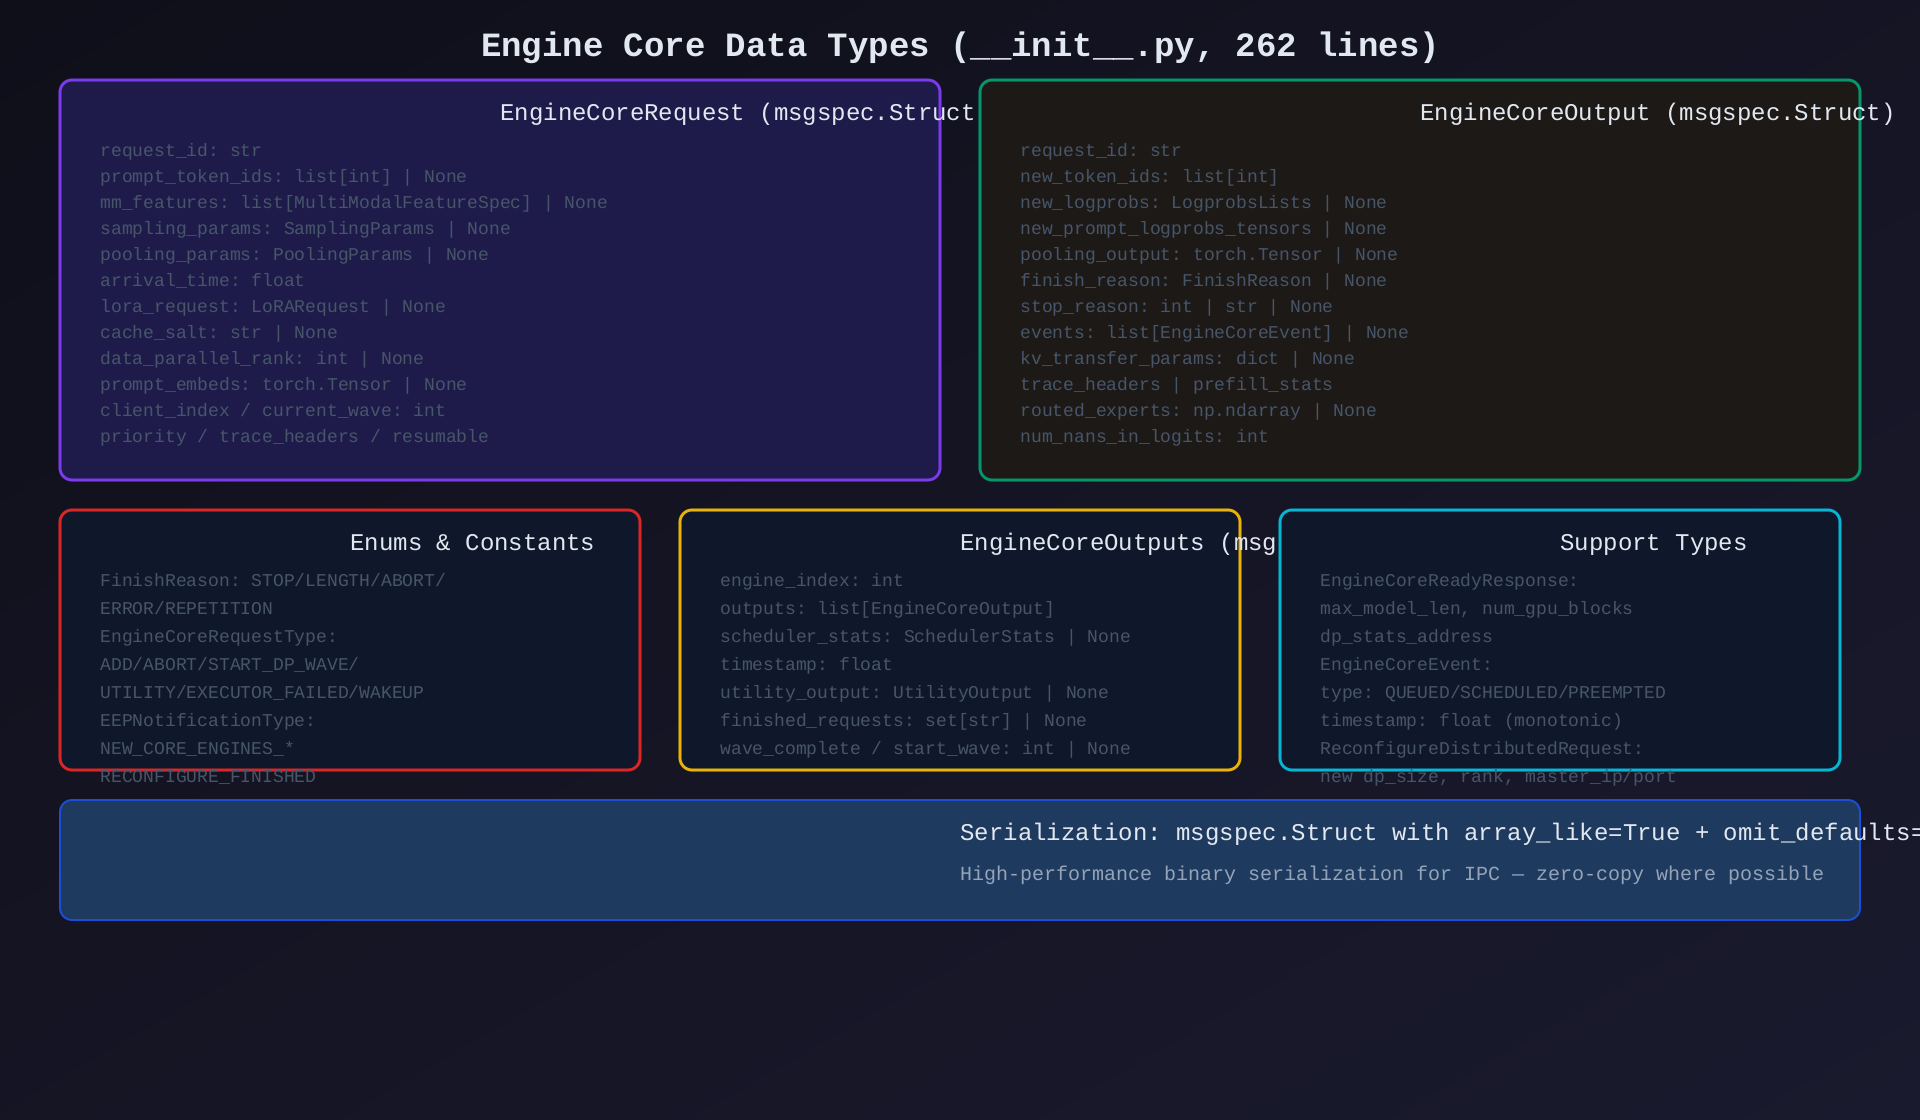
【vllm】 vLLM v1 Engine — 系统级架构深度分析(三) - 技术栈

vLLM V1 + AMD GPU:释放大模型推理性能新纪元! - 知乎
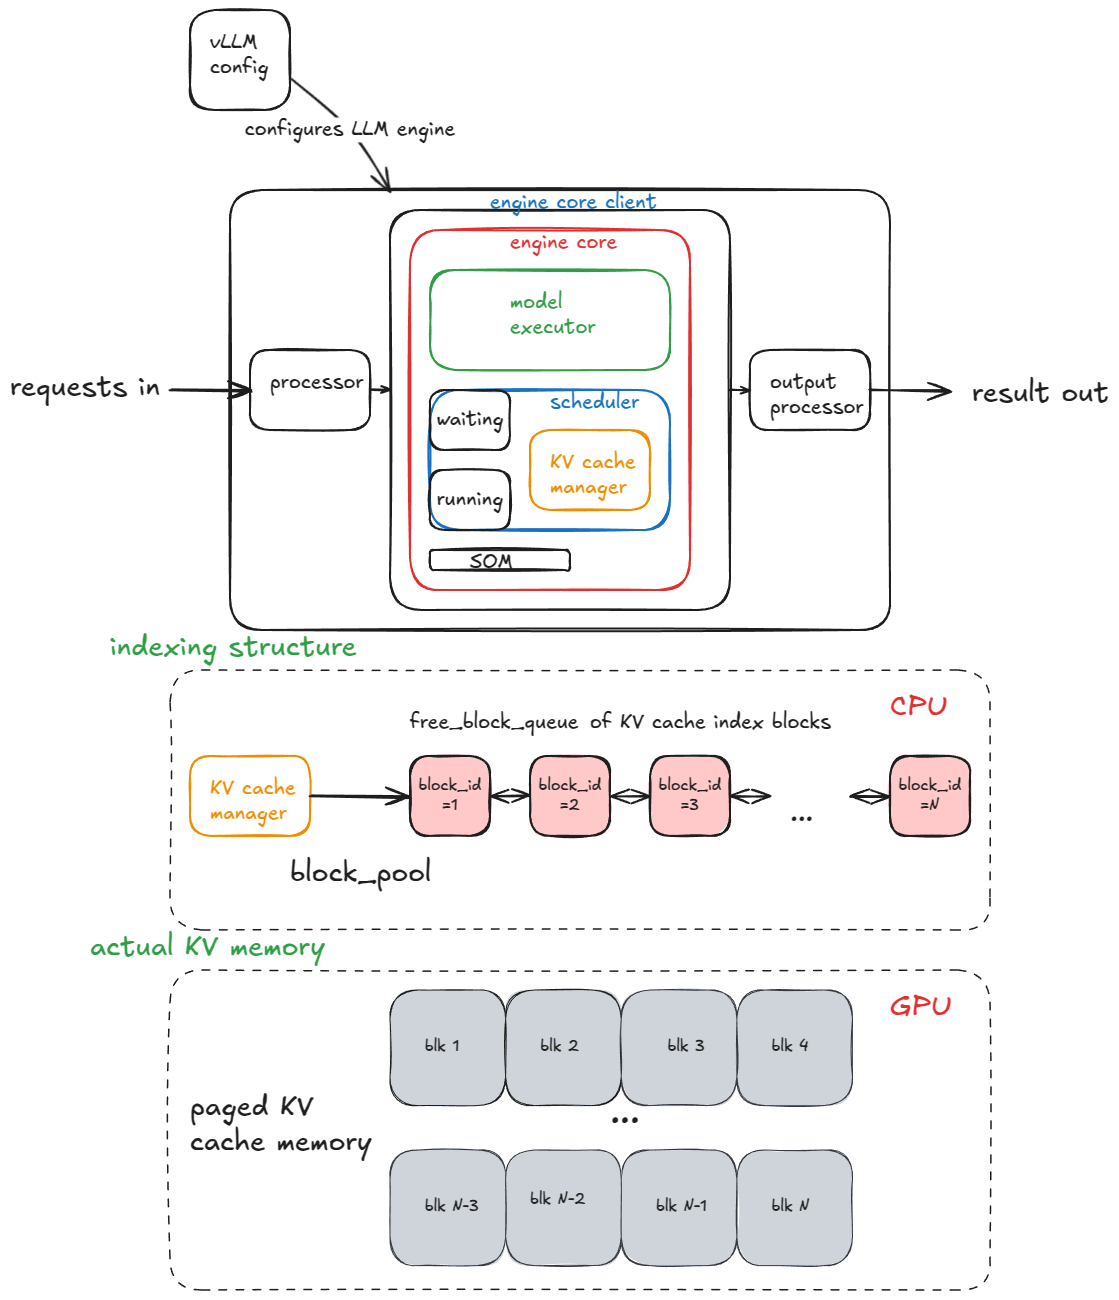
vLLM 내부: 초고처리량 LLM 추론 시스템의 해부 - Aleksa Gordić - RosettaLens 번역

vLLM V1重大更新 - 知乎
Advertisement Space (336x280)
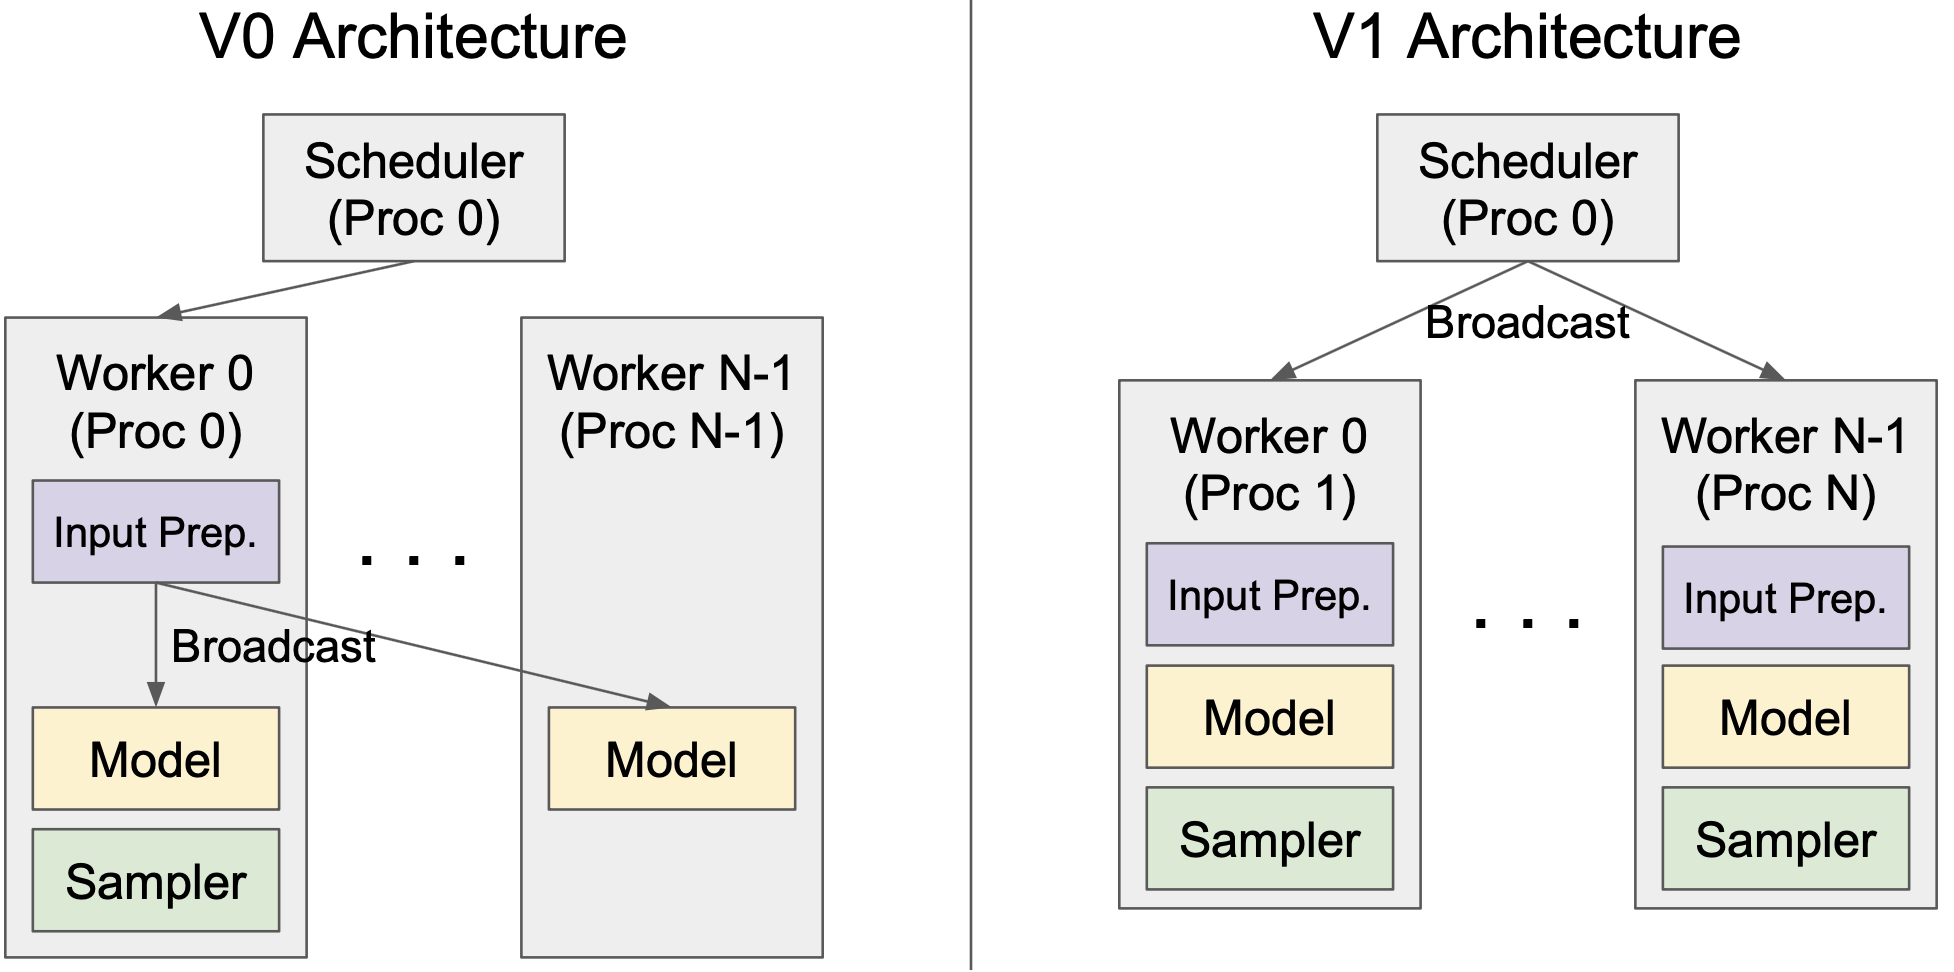
vLLM V1:vLLM 核心架构的一次重大升级 | vLLM 博客

AMD × vLLM Semantic Router: Building the System Intelligence Together ...
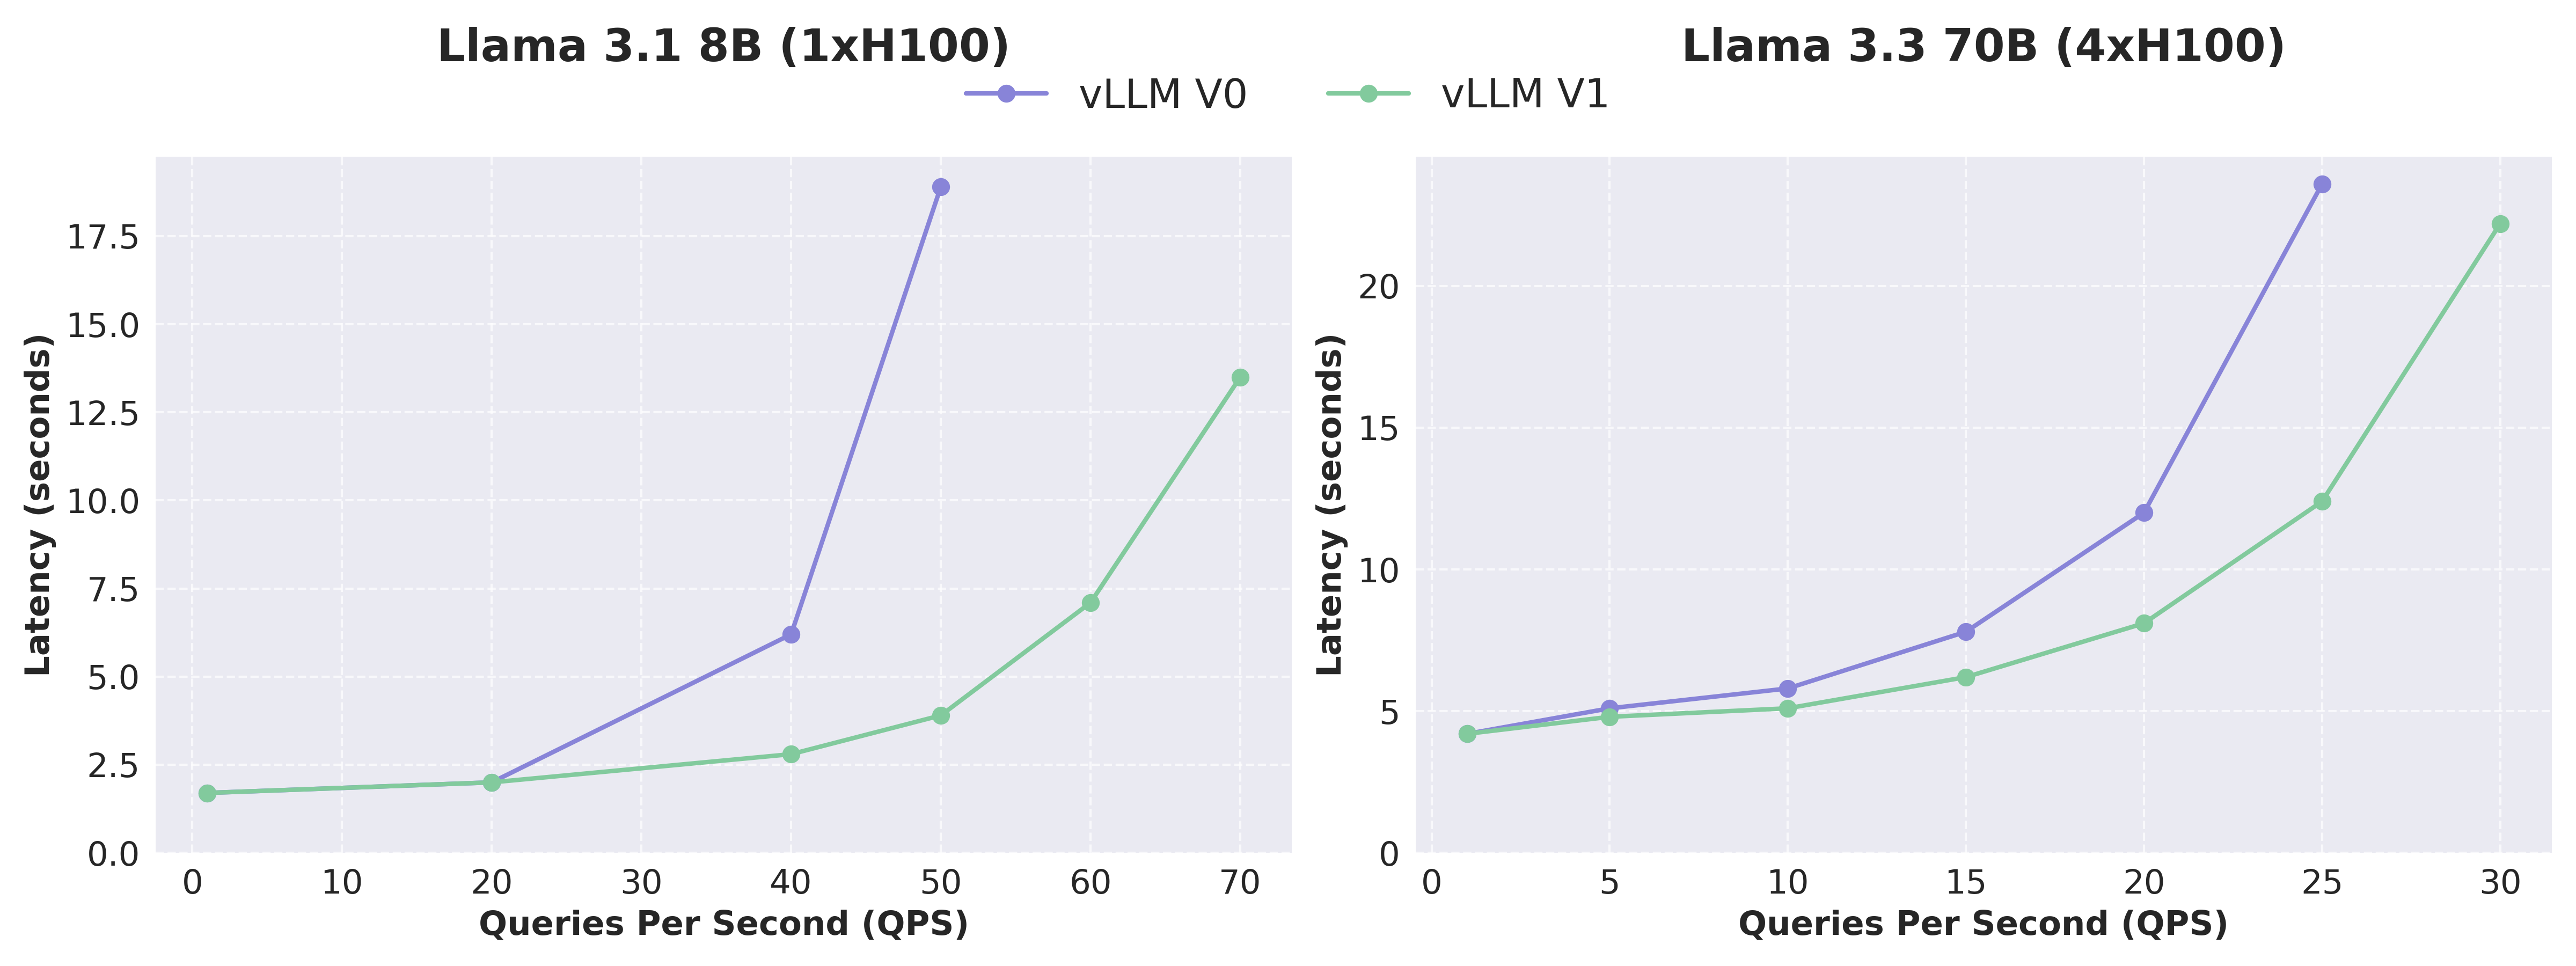
vLLM V1:vLLM 核心架构的一次重大升级 | vLLM 博客
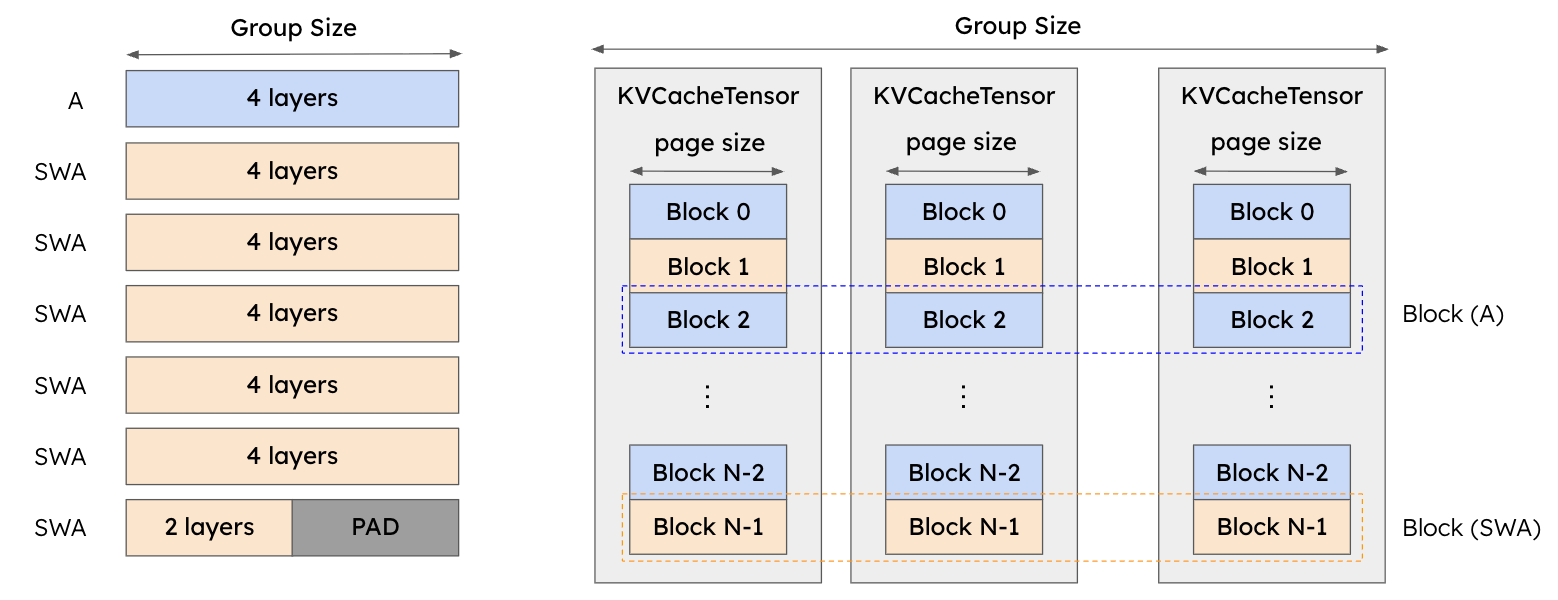
Hybrid Models as First-Class Citizens in vLLM – PyTorch

谈谈vLLM v1 - 知乎
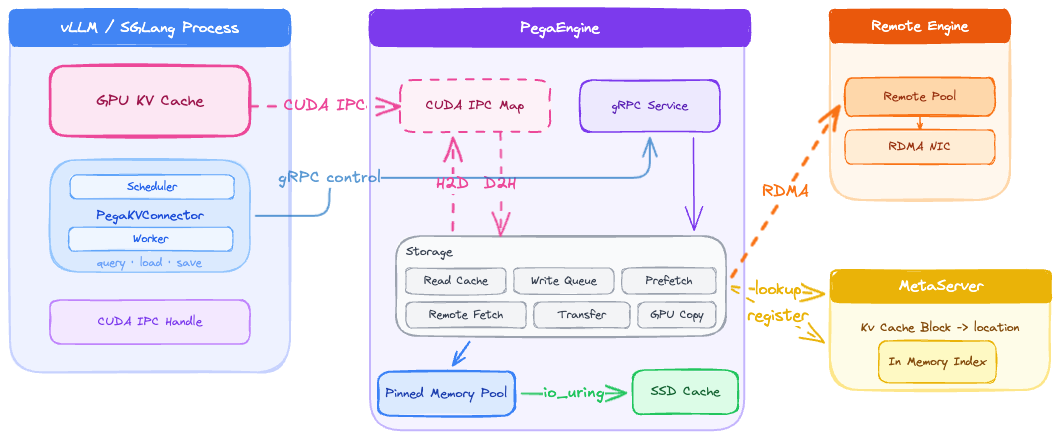
Blog | vLLM