
Weighted Reward Preference Optimization For Implicit Model Fusion Hf

Weighted-Reward Preference Optimization for Implicit Model Fusion · HF ...
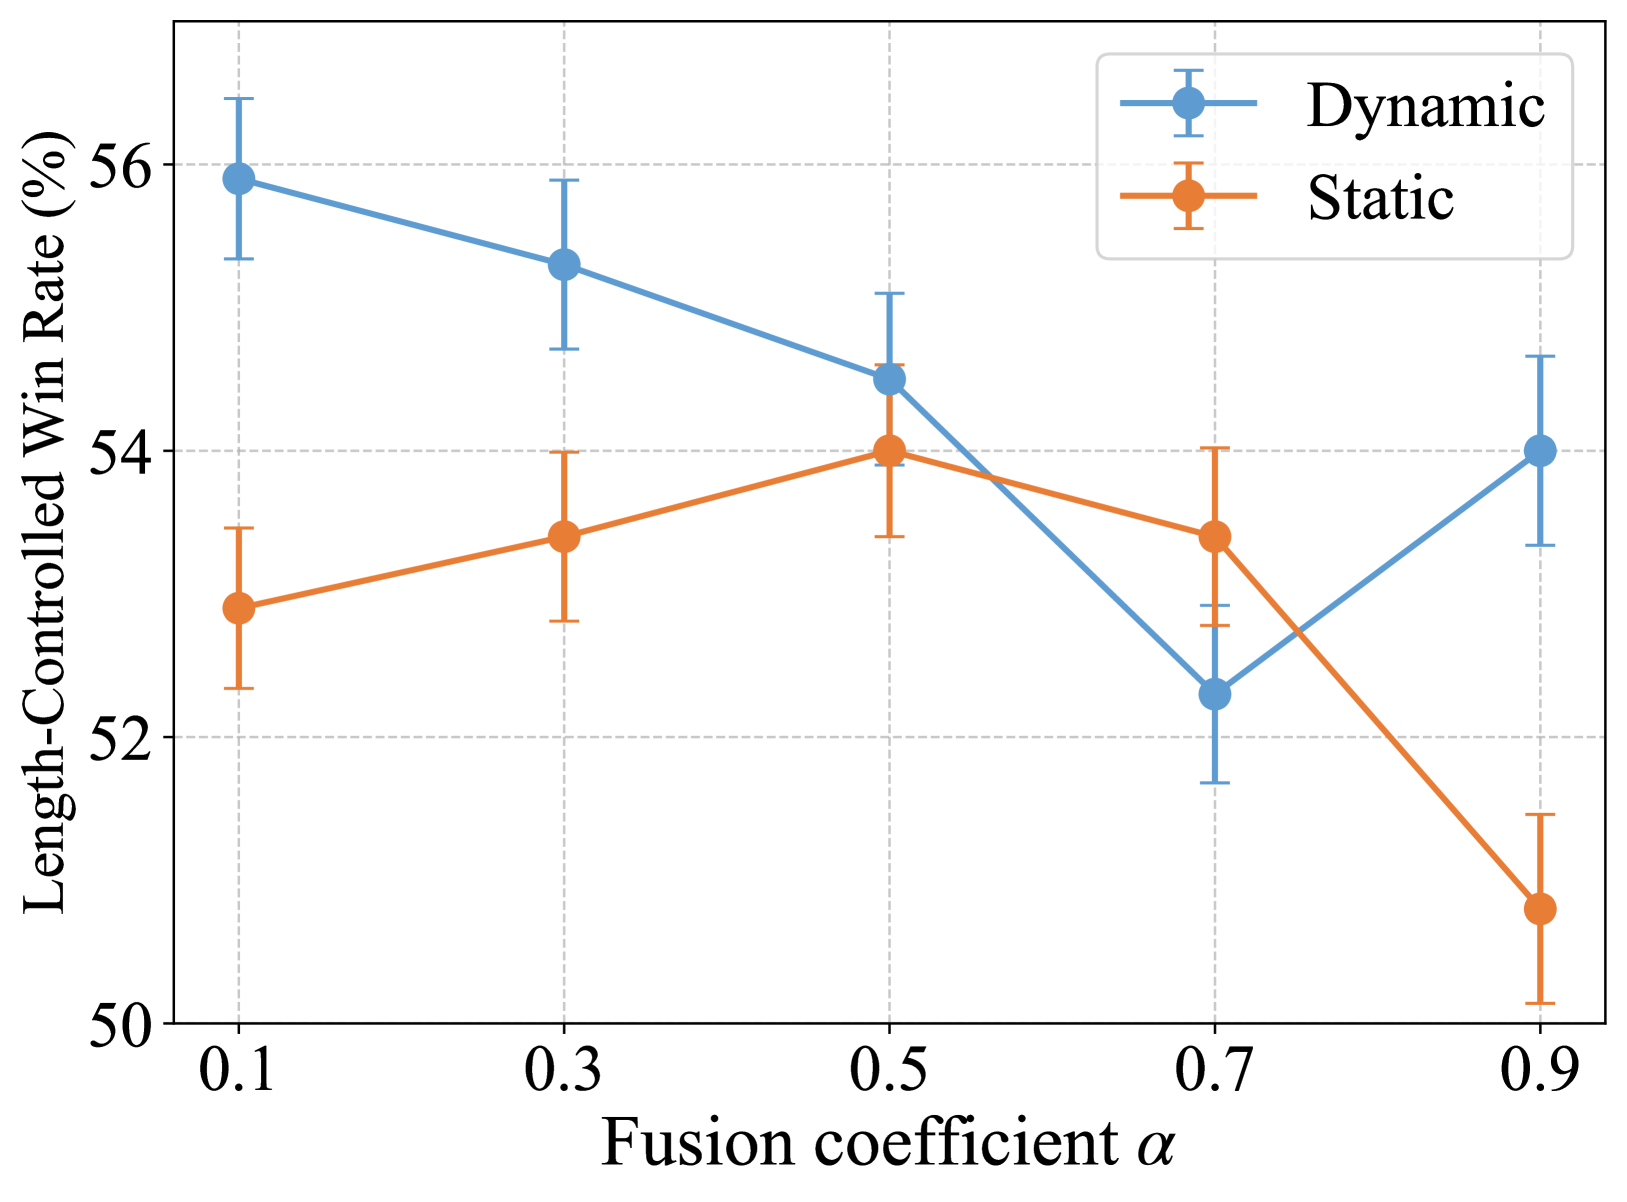
Weighted-Reward Preference Optimization for Implicit Model Fusion · HF ...

Weighted-Reward Preference Optimization for Implicit Model Fusion · HF ...

Weighted-Reward Preference Optimization for Implicit Model Fusion · HF ...

Weighted-Reward Preference Optimization for Implicit Model Fusion · HF ...

Weighted-Reward Preference Optimization for Implicit Model Fusion | AI ...
Weighted-Reward Preference Optimization for Implicit Model Fusion ...

Weighted-Reward Preference Optimization for Implicit Model Fusion

FuseChat-3.0: Preference Optimization for Implicit Model Fusion

ICLR Poster Weighted-Reward Preference Optimization for Implicit Model ...
Advertisement Space (300x250)
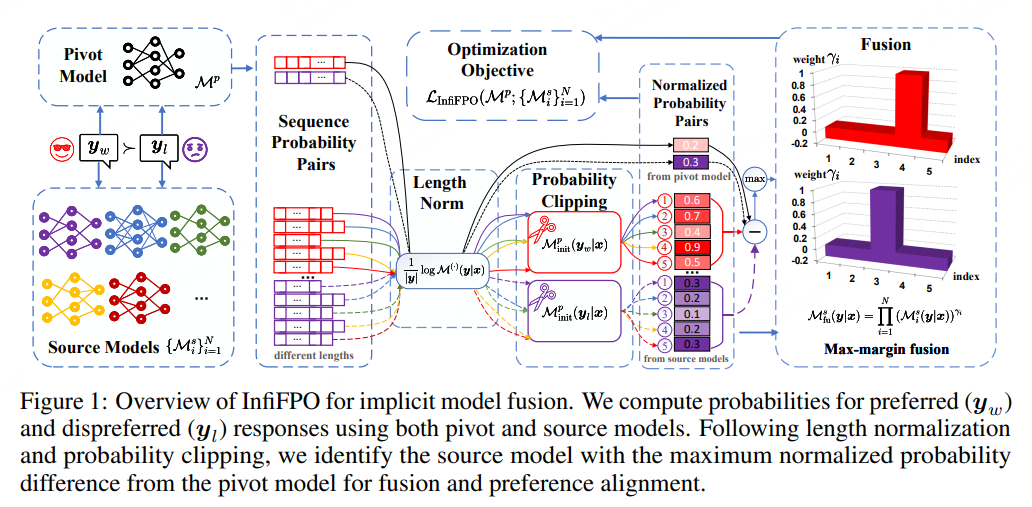
2025-NIPS-InfiFPO: Implicit Model Fusion via Preference Optimization in ...

Paper page - Weighted-Reward Preference Optimization for Implicit Model ...

Paper page - InfiFPO: Implicit Model Fusion via Preference Optimization ...

Weighted-Reward Preference Optimization for LLM Fusion | PDF | Applied ...
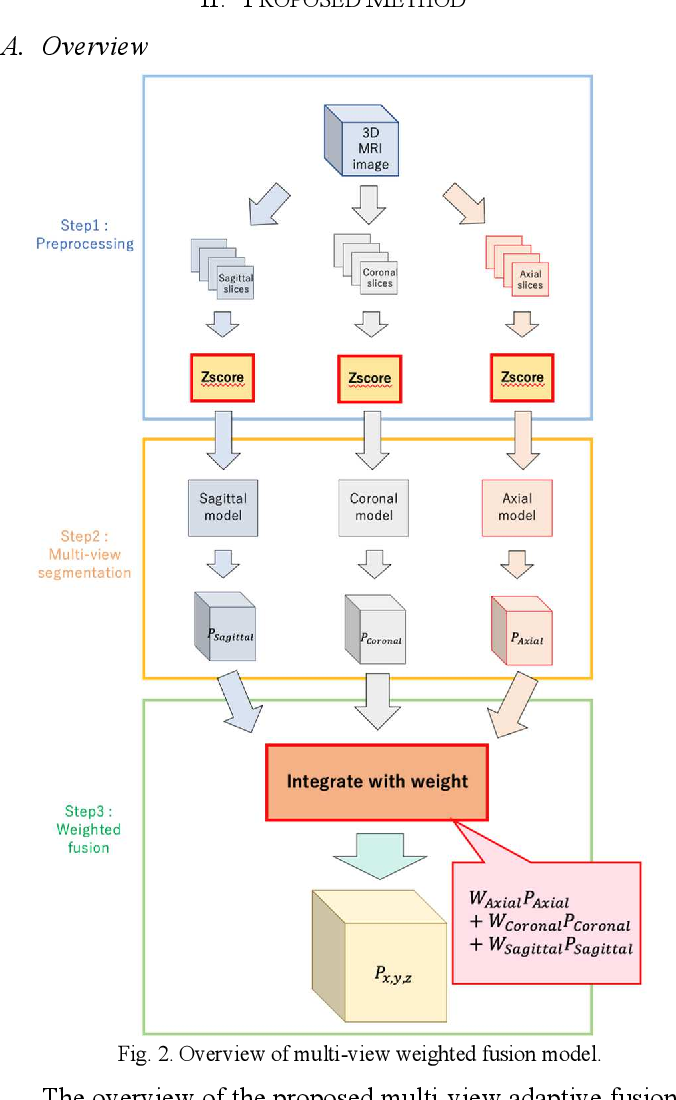
Figure 2 from A Multi-View Weighted Fusion Model for Segmentation of ...

[論文レビュー] SWEPO: Simultaneous Weighted Preference Optimization for Group ...

A Weighted Feature Fusion Model for Unsteady Aerodynamic Modeling at ...
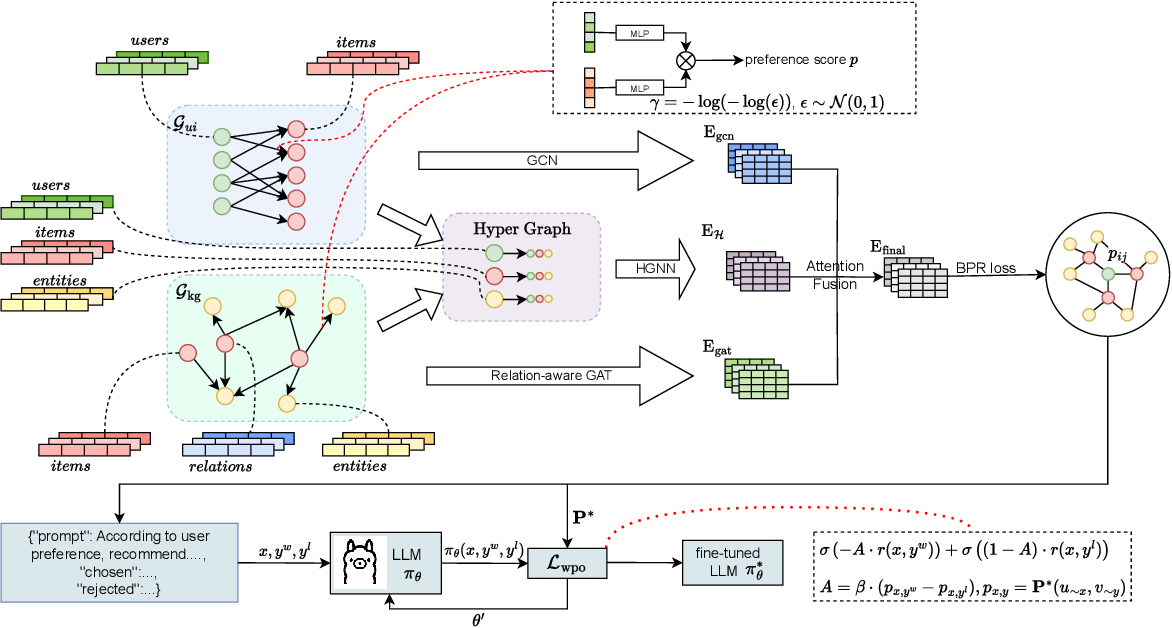
Figure 1 from A Weighted Preference Optimization Service Recommendation ...
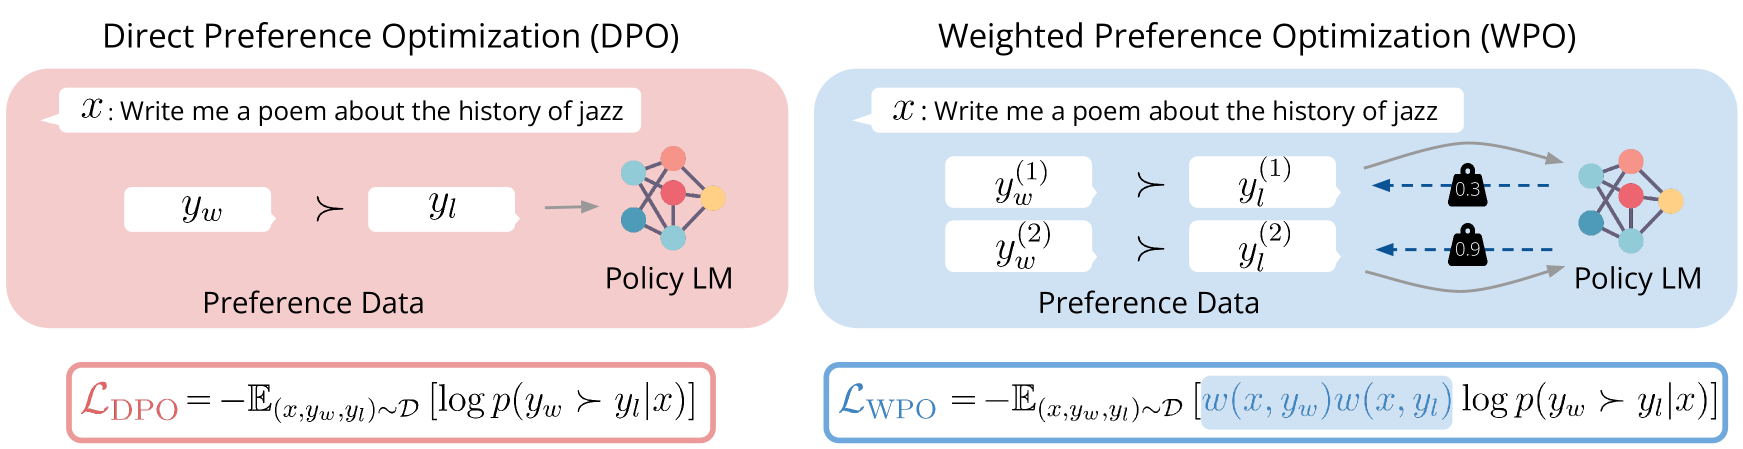
WPO: Enhancing RLHF with Weighted Preference Optimization

WPO: Enhancing RLHF with Weighted Preference Optimization | AI Research ...
Advertisement Space (336x280)

HAF-RM: A Hybrid Alignment Framework for Reward Model Training

[논문 리뷰] HAF-RM: A Hybrid Alignment Framework for Reward Model Training

Why is Your Language Model a Poor Implicit Reward Model? | AI Research ...

HAF-RM: A Hybrid Alignment Framework for Reward Model Training | AI ...

On the Limited Generalization Capability of the Implicit Reward Model ...

Paper page - WPO: Enhancing RLHF with Weighted Preference Optimization
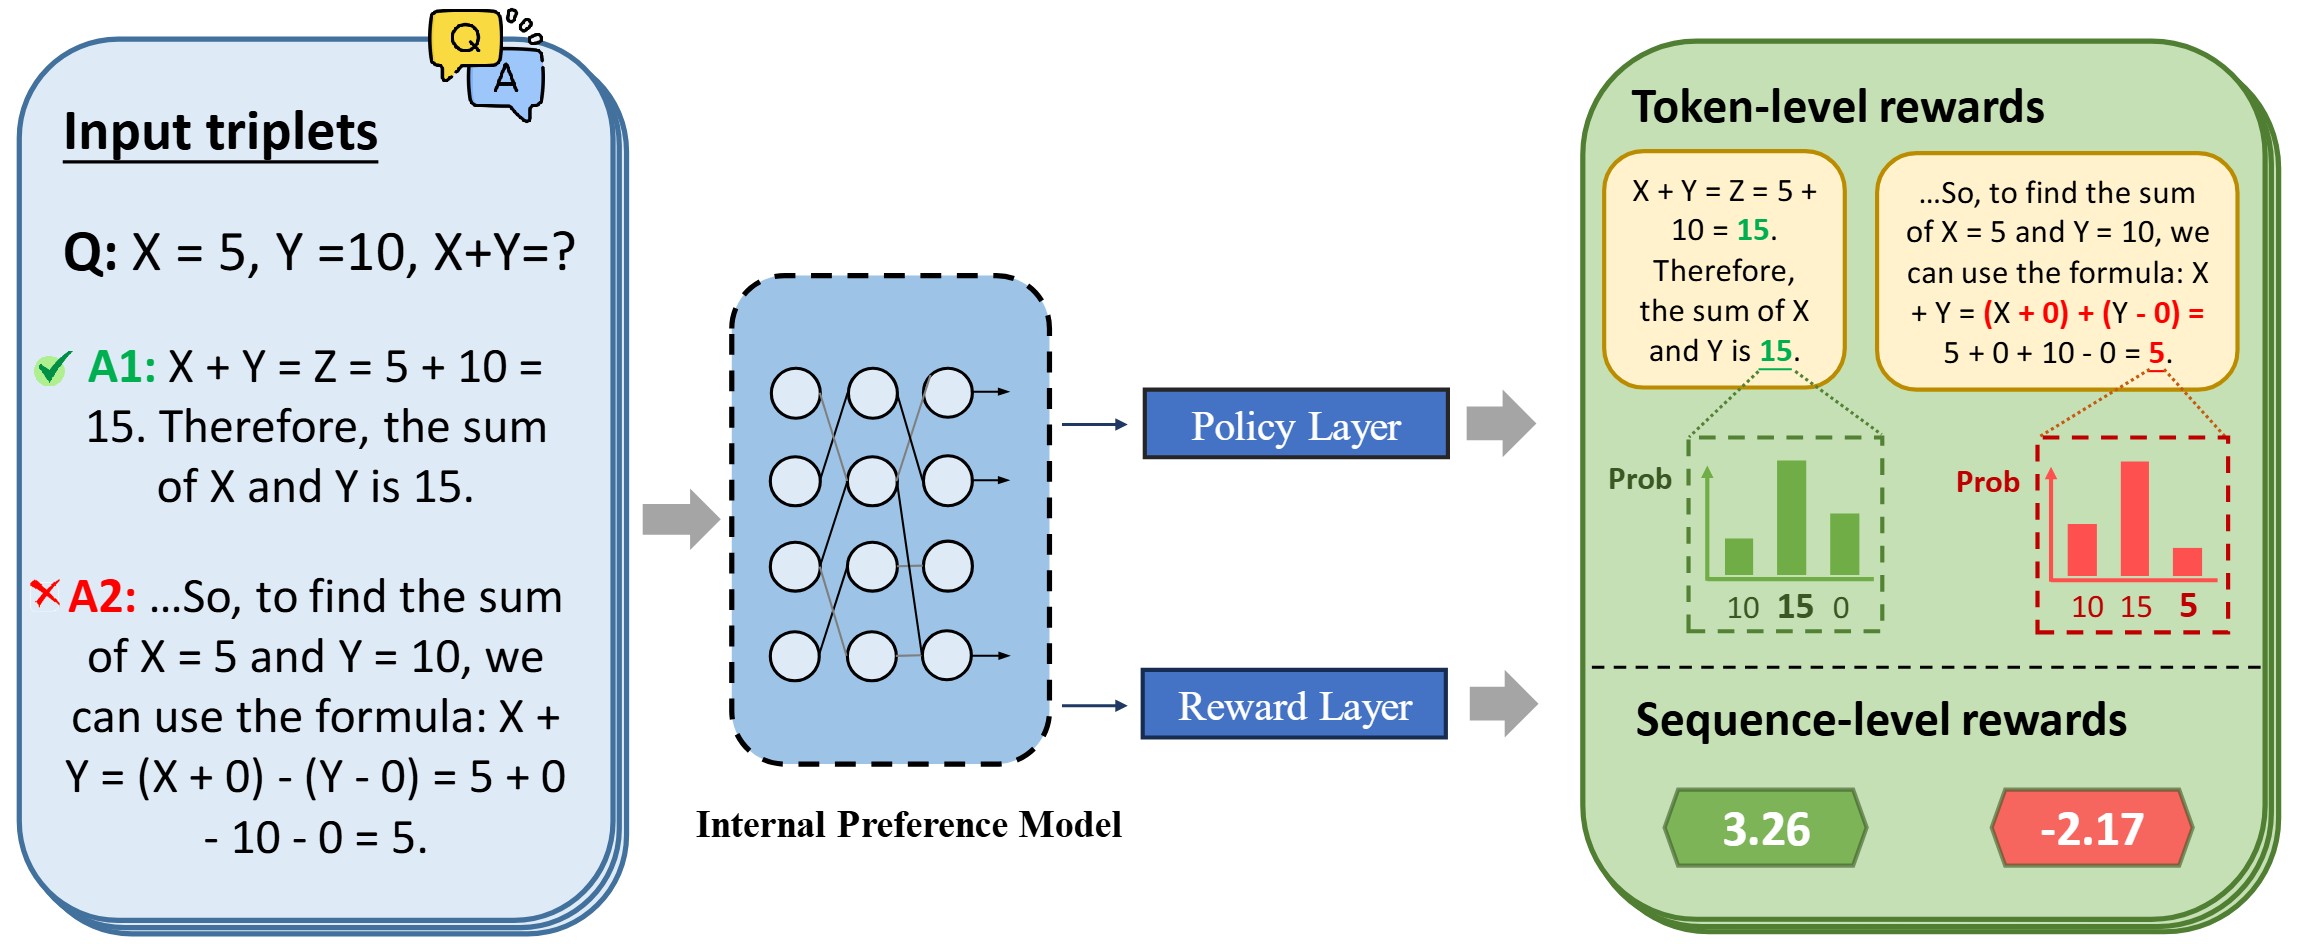
HAF-RM: A Hybrid Alignment Framework for Reward Model Training

DreamPRM: Domain-Reweighted Process Reward Model for Multimodal ...

Weighted evidence (more is better) and 95% CI for each model feature in ...

(PDF) Diffusion Model as a Noise-Aware Latent Reward Model for Step ...
Advertisement Space (336x280)
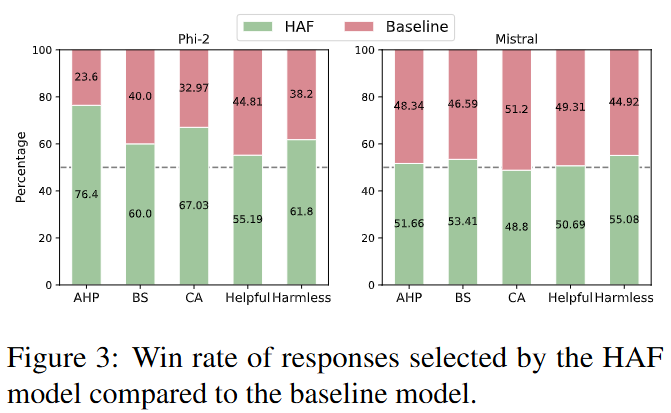
HAF-RM: A Hybrid Alignment Framework for Reward Model Training

Direct Preference Optimization (DPO): Your Language Model is Secretly a ...
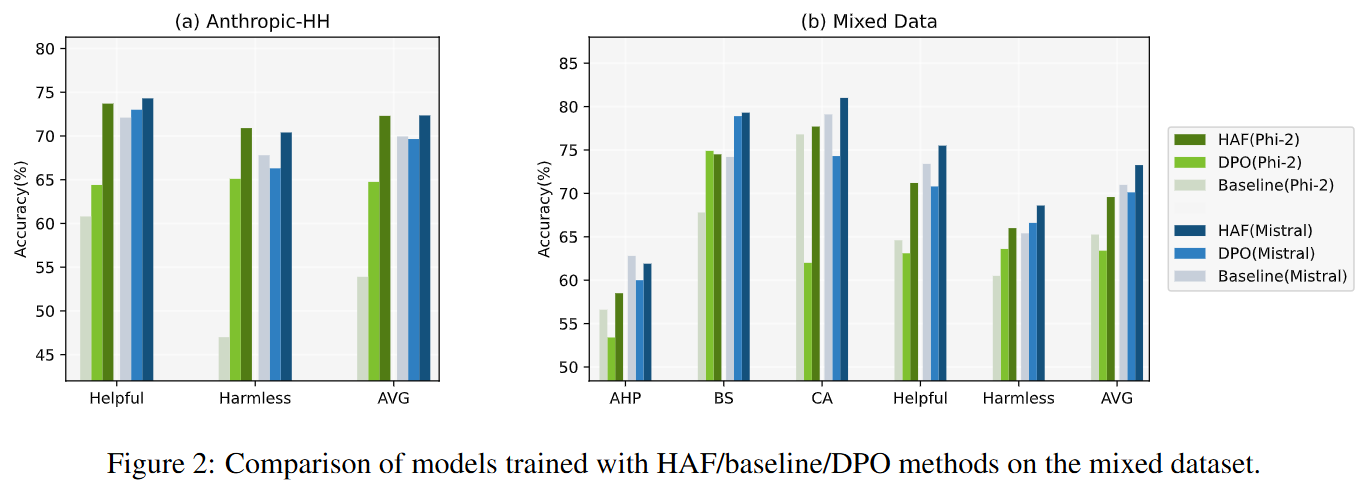
HAF-RM: A Hybrid Alignment Framework for Reward Model Training

Weighted evidence (more is better) and 95% CI for each model feature in ...

On the Limited Generalization Capability of the Implicit Reward Model ...

Framework of the locally weighted fusion of model outcomes. | Download ...