
1 Multi View Transformer For 3d Visual Grounding
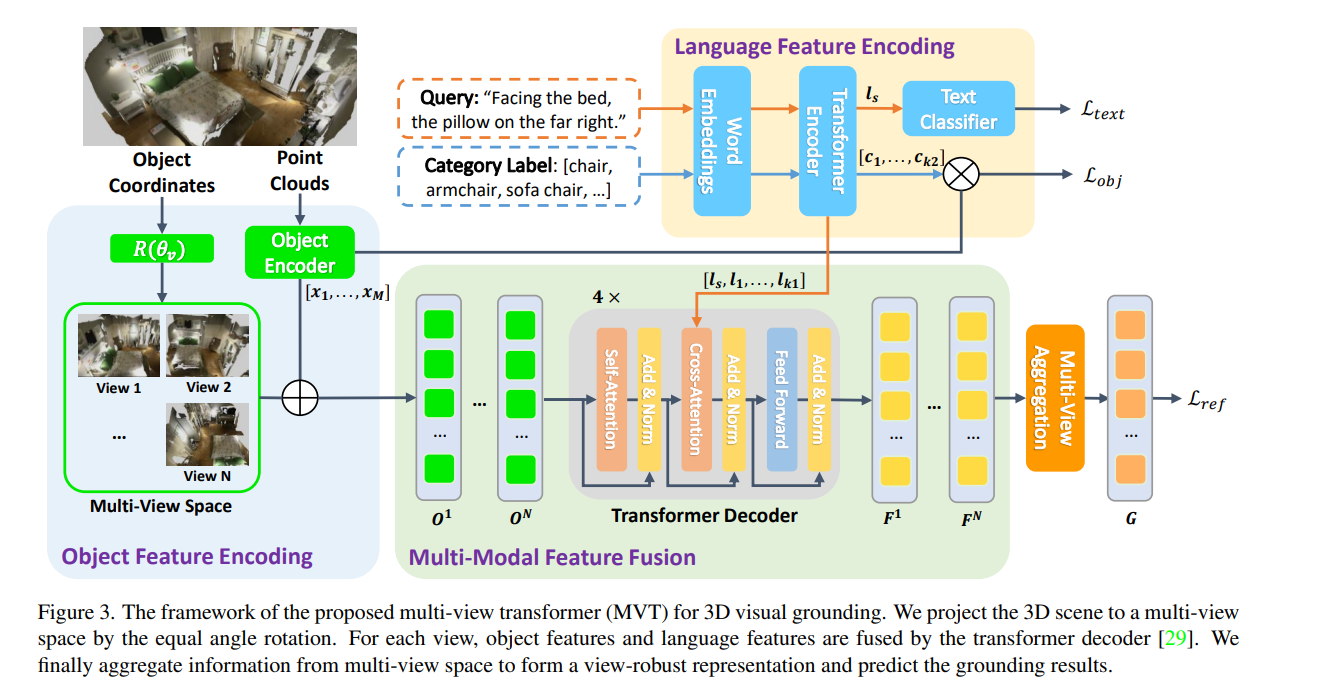
[1] Multi-View Transformer for 3D Visual Grounding 论文精读 - 爱和九九 - 博客园

(PDF) Multi-View Transformer for 3D Visual Grounding
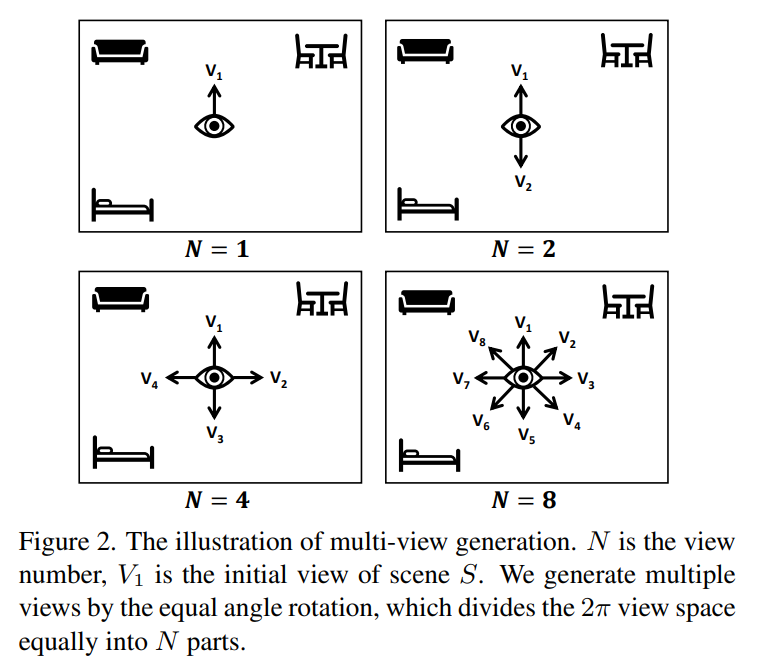
[1] Multi-View Transformer for 3D Visual Grounding 论文精读 - 爱和九九 - 博客园

Figure 2 from Multi-View Transformer for 3D Visual Grounding | Semantic ...

UniT3D: A Unified Transformer for 3D Dense Captioning and Visual Grounding
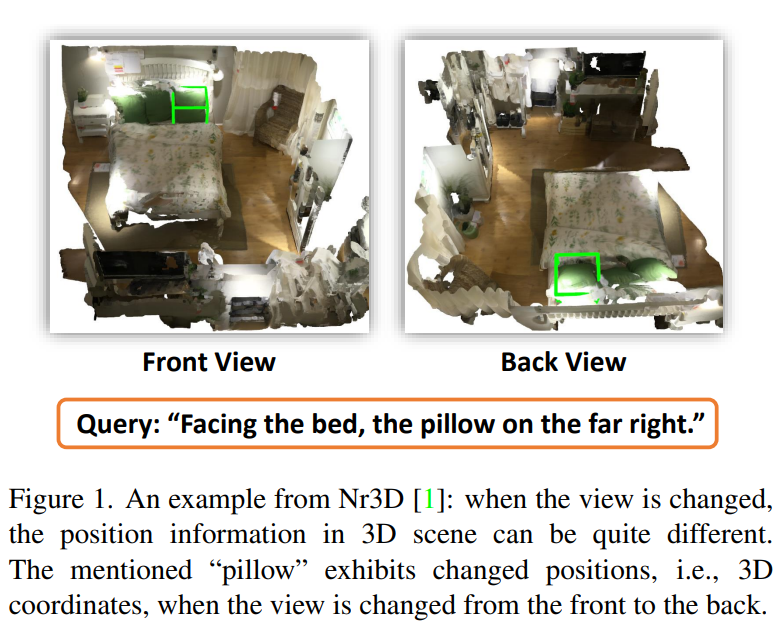
[1] Multi-View Transformer for 3D Visual Grounding 论文精读 - 爱和九九 - 博客园
[1] Multi-View Transformer for 3D Visual Grounding 论文精读 - 爱和九九 - 博客园

MiKASA: Multi-Key-Anchor & Scene-Aware Transformer for 3D Visual Grounding

MiKASA: Multi-Key-Anchor & Scene-Aware Transformer for 3D Visual Grounding

Figure 1 from ViewRefer: Grasp the Multi-view Knowledge for 3D Visual ...
Advertisement Space (300x250)

Figure 1 from MVT: Multi-view Vision Transformer for 3D Object ...

MVGGT: Multimodal Visual Geometry Grounded Transformer for Multiview 3D ...

MVGGT: Multimodal Visual Geometry Grounded Transformer for Multiview 3D ...
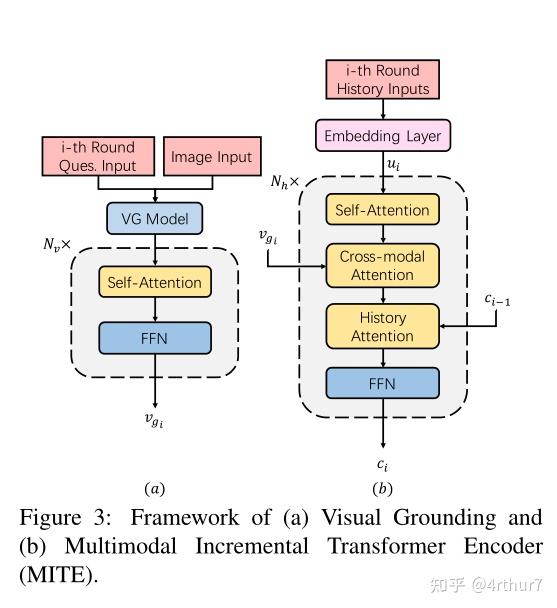
Multimodal Incremental Transformer with Visual Grounding for Visual ...

Figure 3 from A Transformer-based Framework for Visual Grounding on 3D ...
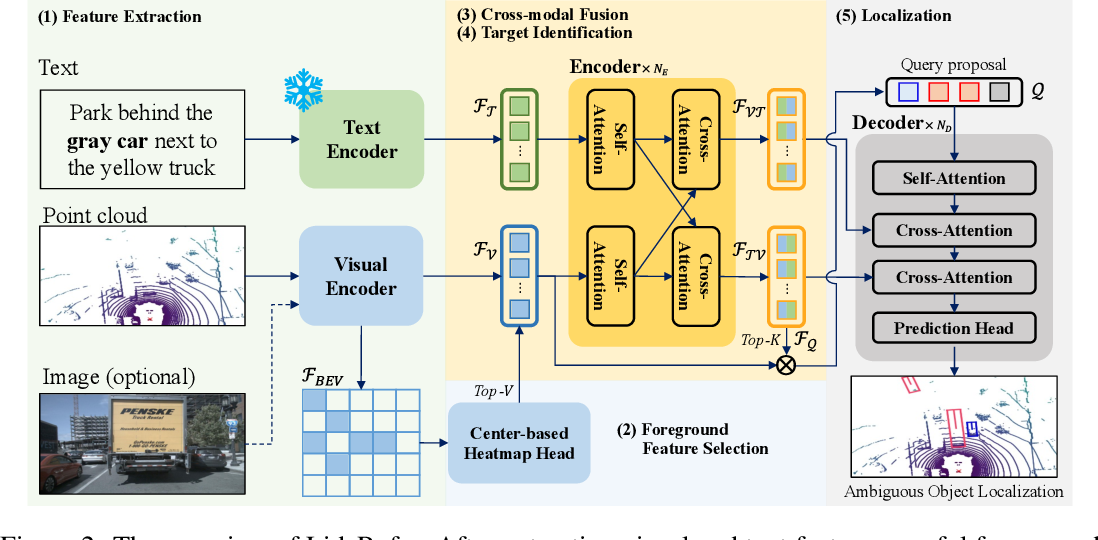
Figure 2 from LidaRefer: Outdoor 3D Visual Grounding for Autonomous ...

MVGGT: Multimodal Visual Geometry Grounded Transformer for Multiview 3D ...

Figure 1 from Group Multi-View Transformer for 3D Shape Analysis With ...
GitHub - sega-hsj/MVT-3DVG: Multi-View Transformer for 3D Visual ...

VLM-Grounder: A VLM Agent for Zero-Shot 3D Visual Grounding
Advertisement Space (336x280)

Table 1 from Weakly-Supervised 3D Visual Grounding based on Visual ...

A Unified Framework for 3D Point Cloud Visual Grounding | DeepAI

Multiple Consistent 2D-3D Mappings for Robust Zero-Shot 3D Visual Grounding

Figure 1 from Cross3DVG: Cross-Dataset 3D Visual Grounding on Different ...

(PDF) LidaRefer: Outdoor 3D Visual Grounding for Autonomous Driving ...

Figure 1 from Weakly-Supervised 3D Visual Grounding based on Visual ...

Bootstrapping vision–language transformer for monocular 3D visual ...

ViGiL3D: A Linguistically Diverse Dataset for 3D Visual Grounding

Paper page - Unified Representation Space for 3D Visual Grounding

Bootstrapping vision–language transformer for monocular 3D visual ...
Advertisement Space (336x280)
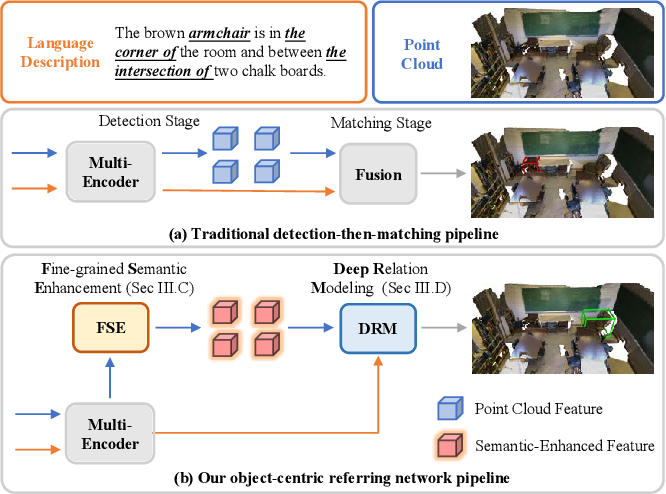
Figure 1 from Boosting 3D Visual Grounding by Object-Centric Referring ...
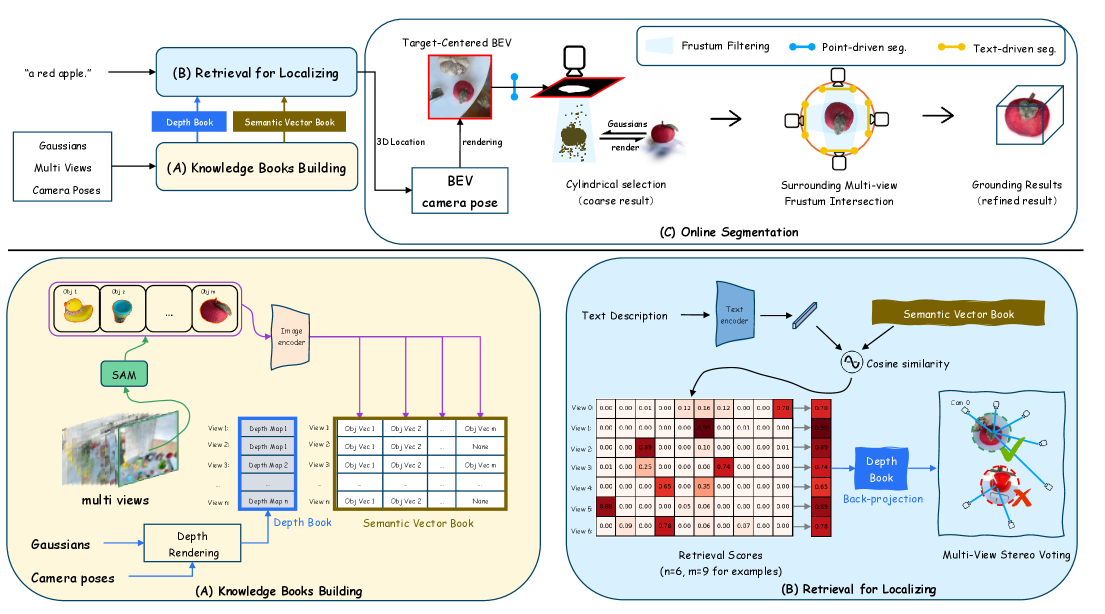
Zero-Shot Visual Grounding in 3D Gaussians via View Retrieval | AI ...

GitHub - ChenBarryHu/TransformerVG: TransformerVG - 3D Visual Grounding ...

Figure 2 from Multimodal Incremental Transformer with Visual Grounding ...

Paper page - UniT3D: A Unified Transformer for 3D Dense Captioning and ...

Figure 1 from Visual Grounding with Transformers | Semantic Scholar