
231207910 Promptbench A Unified Library For Evaluation Of Large
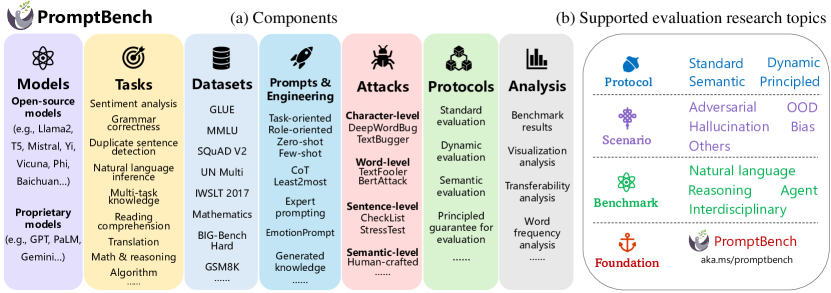
[2312.07910] PromptBench: A Unified Library for Evaluation of Large ...

PromptBench: A Unified Library for Evaluation of Large Language Models ...
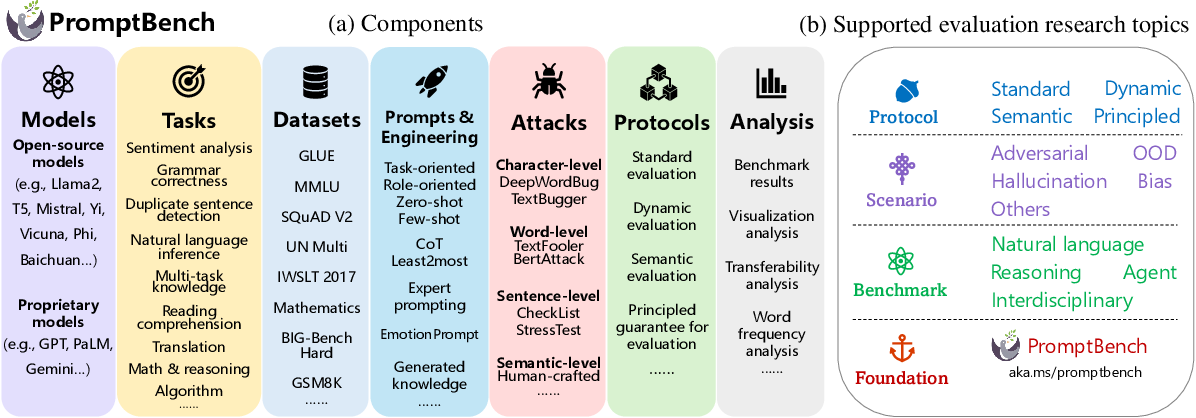
Figure 1 from PromptBench: A Unified Library for Evaluation of Large ...

PromptBench: A Unified Library for Evaluation of Large Language Models ...

Paper page - PromptBench: A Unified Library for Evaluation of Large ...
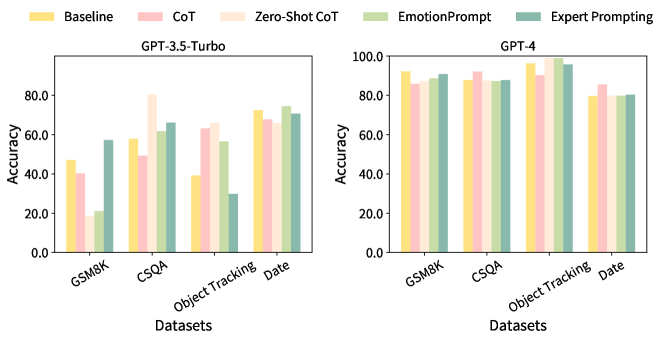
[2312.07910] PromptBench: A Unified Library for Evaluation of Large ...
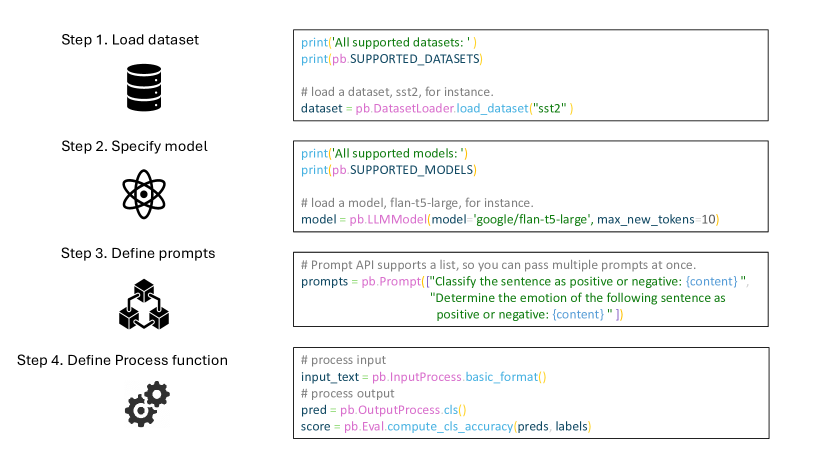
[2312.07910] PromptBench: A Unified Library for Evaluation of Large ...
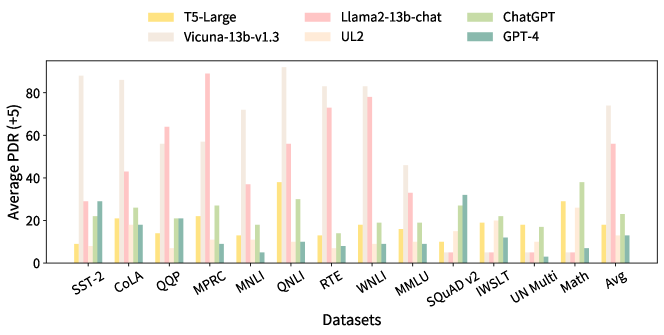
[2312.07910] PromptBench: A Unified Library for Evaluation of Large ...
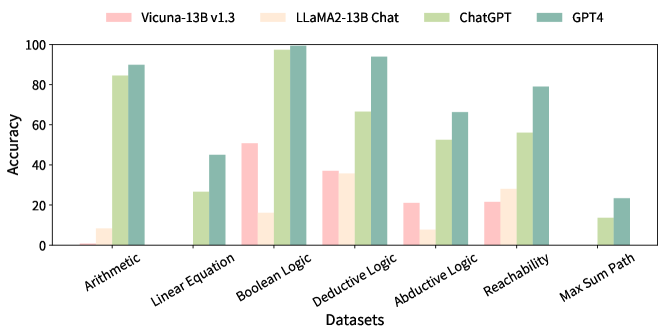
[2312.07910] PromptBench: A Unified Library for Evaluation of Large ...

PromptBench: A Unified Library for Evaluation of Large Language Models ...
Advertisement Space (300x250)
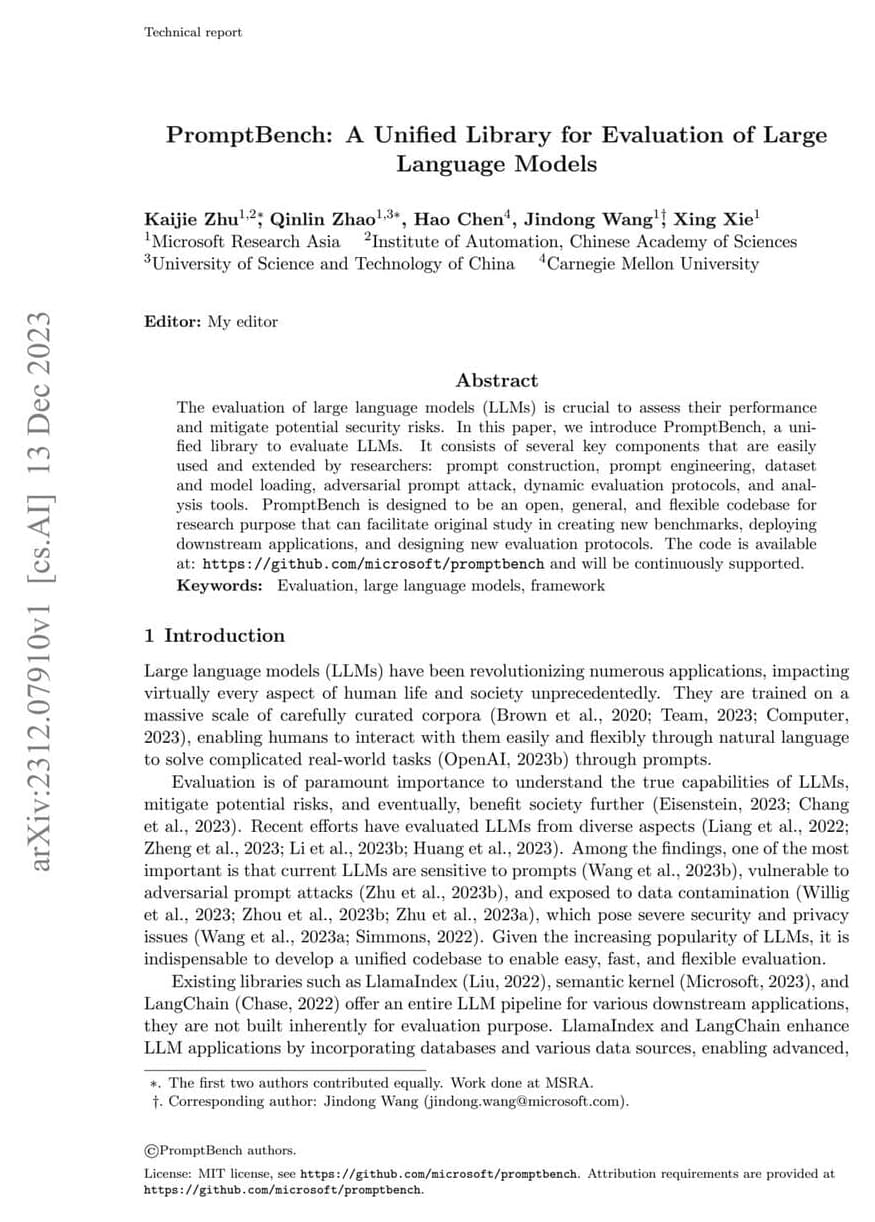
Largebench a unified library for large language models – Lifeboat News ...

RoTBench: A Multi-Level Benchmark for Evaluating the Robustness of ...

Vending-Bench: A Benchmark for Long-Term Coherence of Autonomous Agents ...
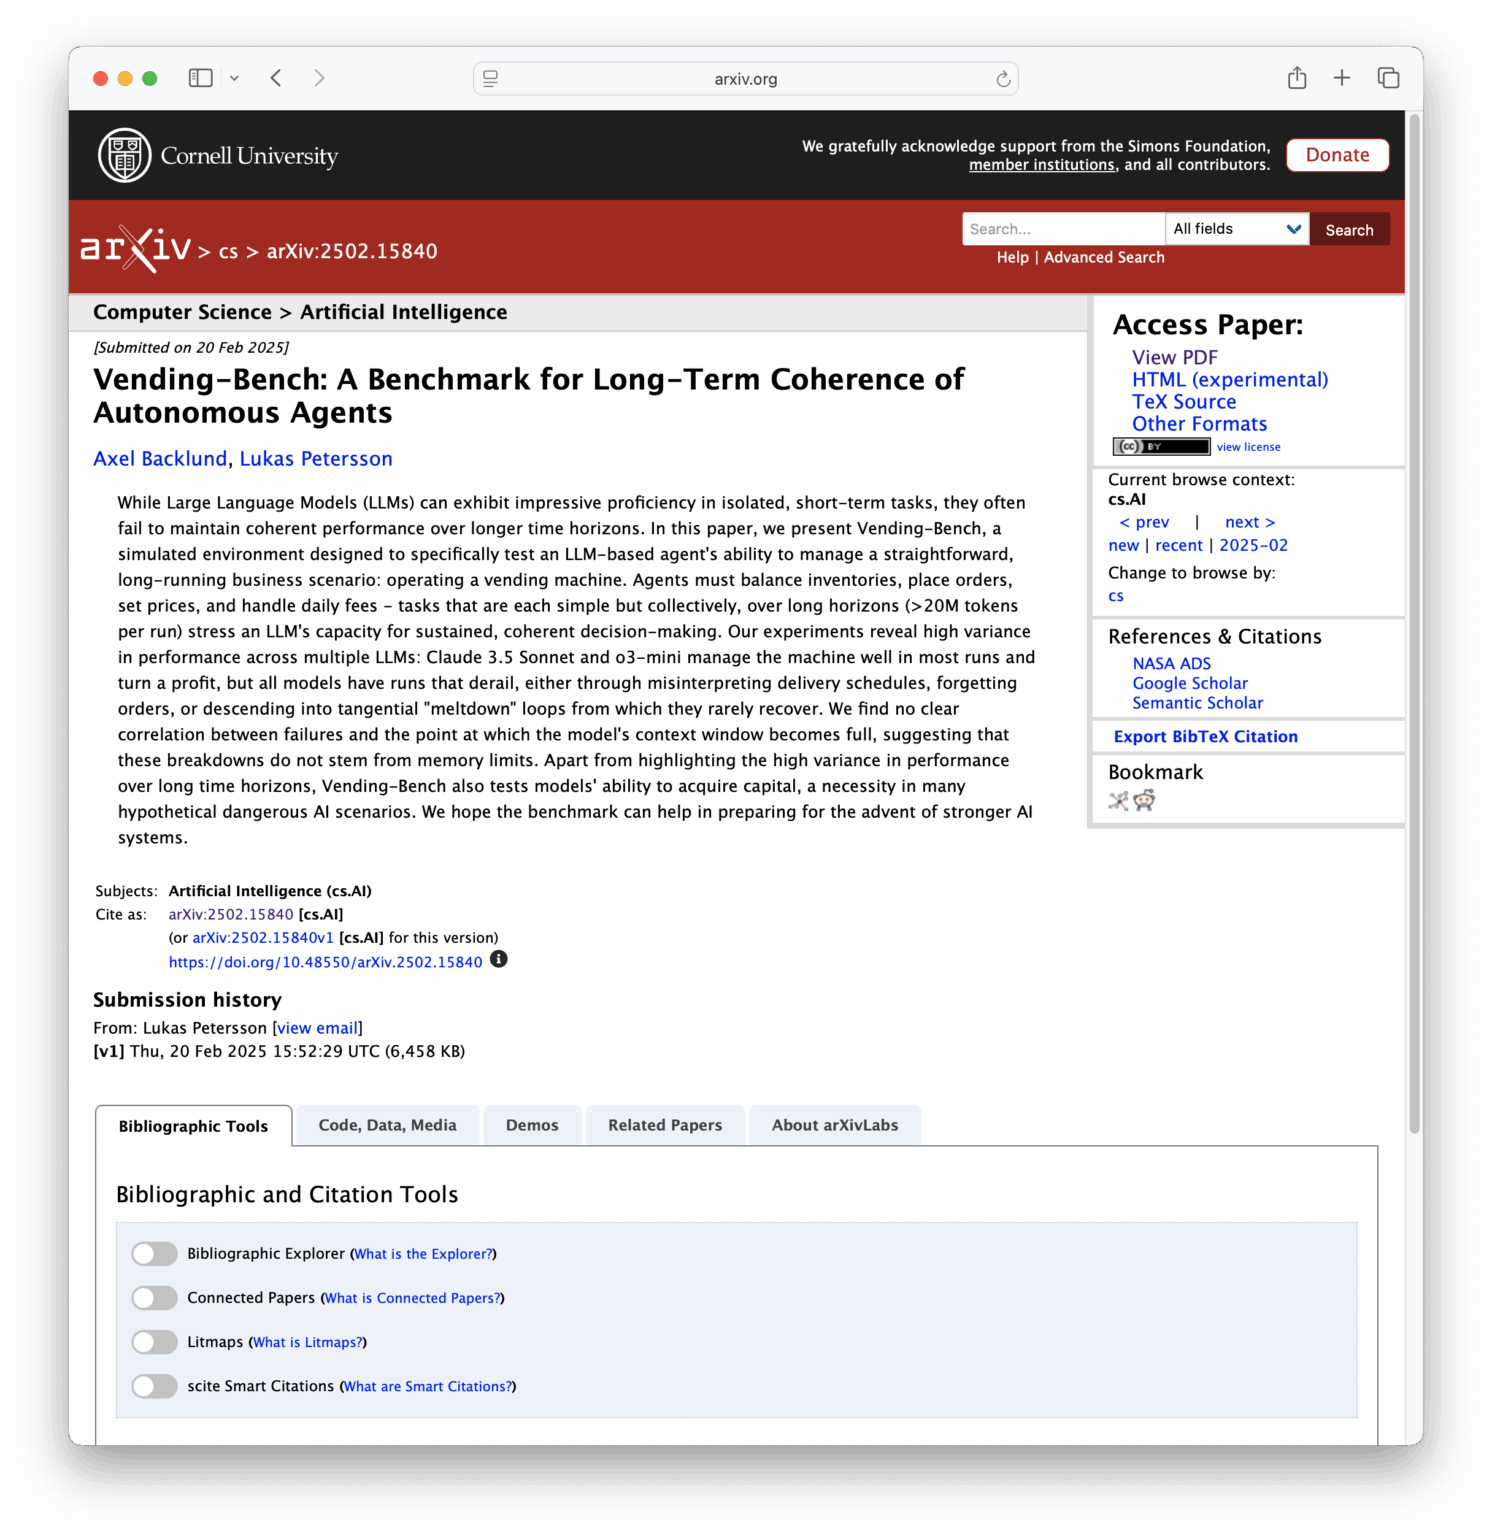
Vending-Bench: A Benchmark for Long-Term Coherence of Autonomous Agents ...
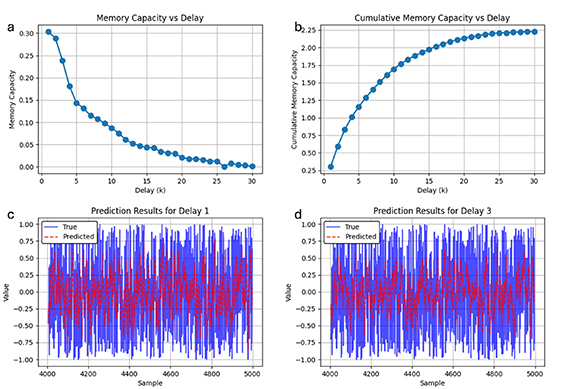
RCbench: a unified framework for benchmarking reservoir computing ...

PromptBench: Towards Evaluating the Robustness of Large Language Models ...

Figure 2 from PromptBench: Towards Evaluating the Robustness of Large ...
GitHub - hertera1/promptbench: An robustness evaluation framework for ...

PromptBench: Evaluating AI Effectively 📌 PromptBench is a comprehensive ...

Figure 1 from PCEBench: A Multi-Dimensional Benchmark for Evaluating ...
Advertisement Space (336x280)
Promptbench - Versatile LLM Evaluation and Prompt Engineering Toolkit ...
GitHub - hertera1/promptbench: An robustness evaluation framework for ...

Mastering LLM Evaluation with PromptBench

Paper page - PromptBench: Towards Evaluating the Robustness of Large ...

Table 2 from PromptBench: Towards Evaluating the Robustness of Large ...
PromptBench: Benchmarks for adversarial prompts on large language ...
GitHub - hertera1/promptbench: An robustness evaluation framework for ...
GitHub - hertera1/promptbench: An robustness evaluation framework for ...

PromptBench: Towards Evaluating the Robustness of Large Language Models ...

MPBench: A Comprehensive Multimodal Reasoning Benchmark for Process ...
Advertisement Space (336x280)

PromptBench: Towards Evaluating the Robustness of Large Language Models ...

Table 1 from PromptBench: Towards Evaluating the Robustness of Large ...
UniToolBench: A Benchmark for Tool-Augmented LLMs in Cross-Domain ...
philosopher033427615/TheBigPromptLibrary: A collection of prompts ...
AutoDFBench 1.0: A Benchmarking Framework for Digital Forensic Tool ...

[2306.04528] PromptBench: Towards Evaluating the Robustness of Large ...