
Paper Page Promptbench A Unified Library For Evaluation Of Large

Paper page - PromptBench: A Unified Library for Evaluation of Large ...

PromptBench: A Unified Library for Evaluation of Large Language Models ...

PromptBench: A Unified Library for Evaluation of Large Language Models ...
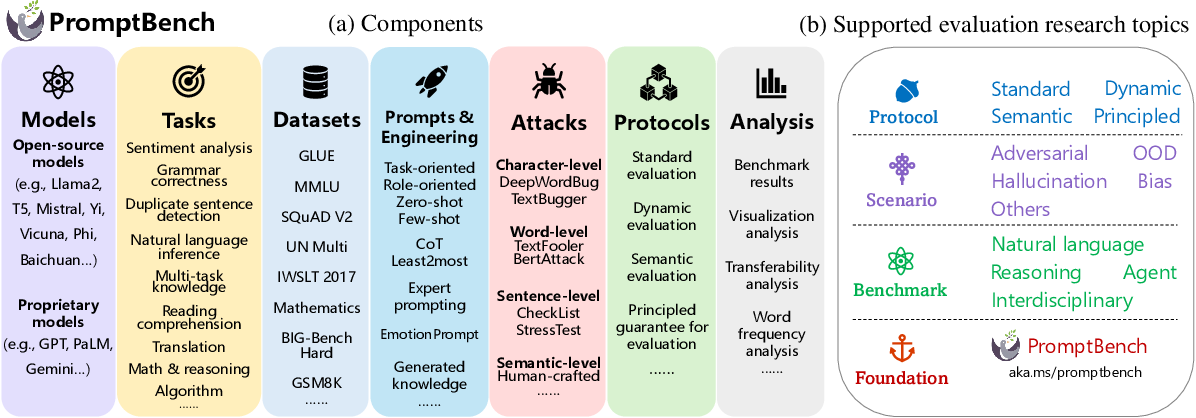
Figure 1 from PromptBench: A Unified Library for Evaluation of Large ...
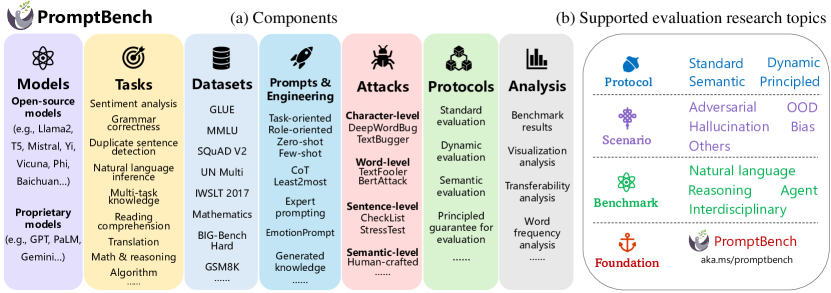
[2312.07910] PromptBench: A Unified Library for Evaluation of Large ...
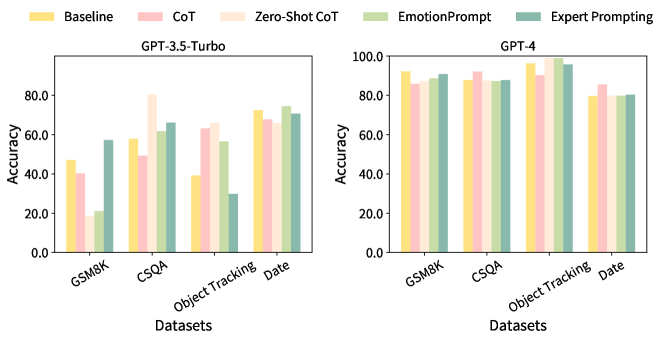
[2312.07910] PromptBench: A Unified Library for Evaluation of Large ...
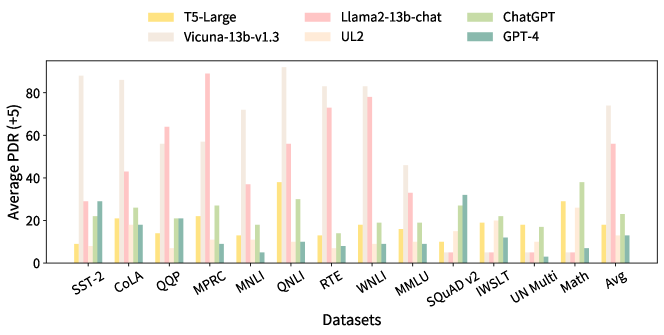
[2312.07910] PromptBench: A Unified Library for Evaluation of Large ...
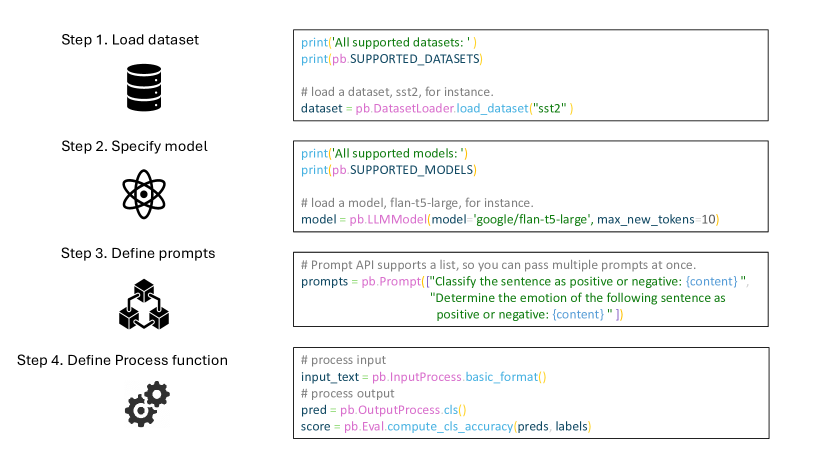
[2312.07910] PromptBench: A Unified Library for Evaluation of Large ...

PromptBench: A Unified Library for Evaluation of Large Language Models ...
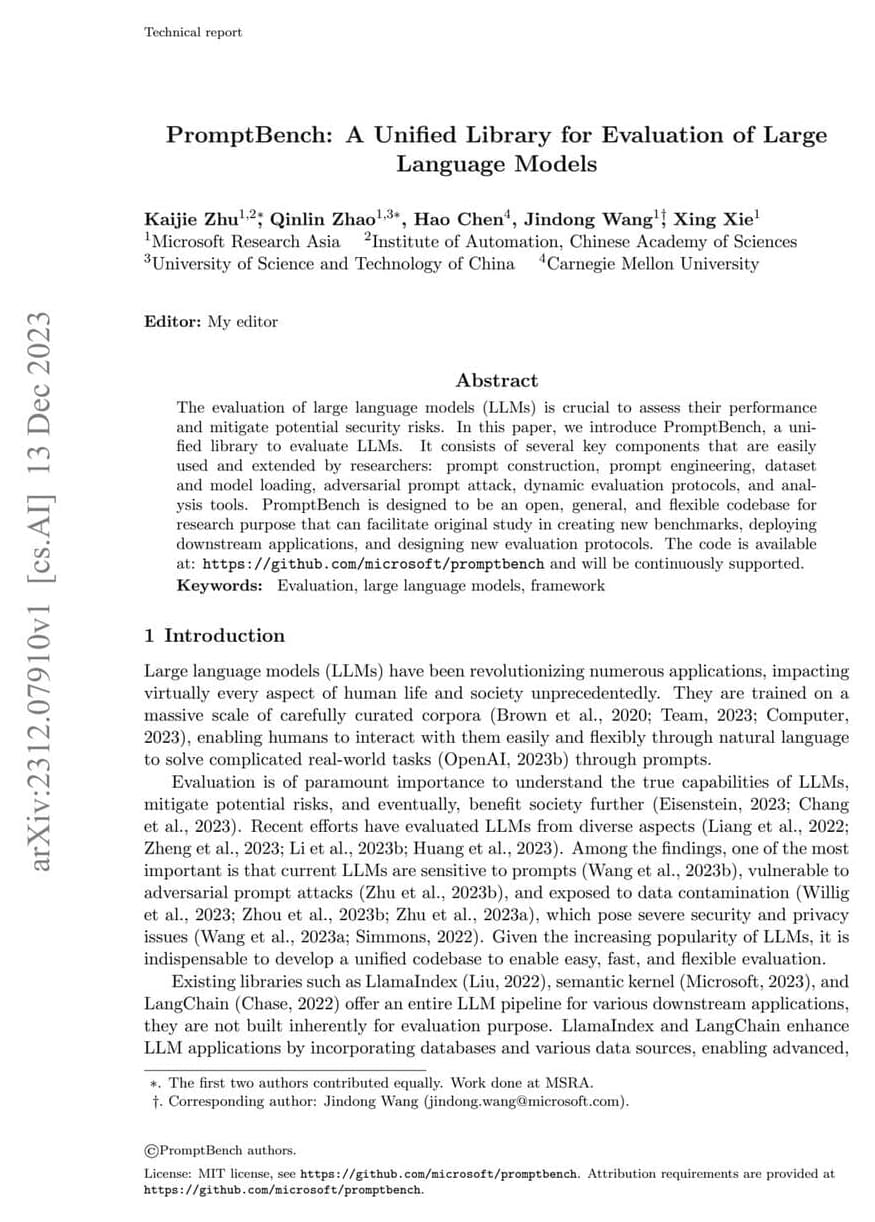
Largebench a unified library for large language models – Lifeboat News ...
Advertisement Space (300x250)

Paper page - BenchHub: A Unified Benchmark Suite for Holistic and ...

Paper page - LitBench: A Benchmark and Dataset for Reliable Evaluation ...

Paper page - Vending-Bench: A Benchmark for Long-Term Coherence of ...

Paper page - SeedBench: A Multi-task Benchmark for Evaluating Large ...

Paper page - PromptBench: Towards Evaluating the Robustness of Large ...

[논문 리뷰] Evalverse: Unified and Accessible Library for Large Language ...

Paper page - TaskBench: Benchmarking Large Language Models for Task ...

Paper page - MacroBench: A Novel Testbed for Web Automation Scripts via ...

Evaluation of Prompt Engineering on the Performance of a Large Language ...

Paper page - TableBench: A Comprehensive and Complex Benchmark for ...
Advertisement Space (336x280)

Paper page - τ-bench: A Benchmark for Tool-Agent-User Interaction in ...

RoTBench: A Multi-Level Benchmark for Evaluating the Robustness of ...

ML in 2 Paper: PromptBench - Towards Evaluating the Robustness of Large ...

PromptBench: Towards Evaluating the Robustness of Large Language Models ...

Figure 2 from PromptBench: Towards Evaluating the Robustness of Large ...
GitHub - hertera1/promptbench: An robustness evaluation framework for ...

PromptBench: Evaluating AI Effectively 📌 PromptBench is a comprehensive ...

Figure 1 from PCEBench: A Multi-Dimensional Benchmark for Evaluating ...
GitHub - hertera1/promptbench: An robustness evaluation framework for ...
GitHub - hertera1/promptbench: An robustness evaluation framework for ...
Advertisement Space (336x280)
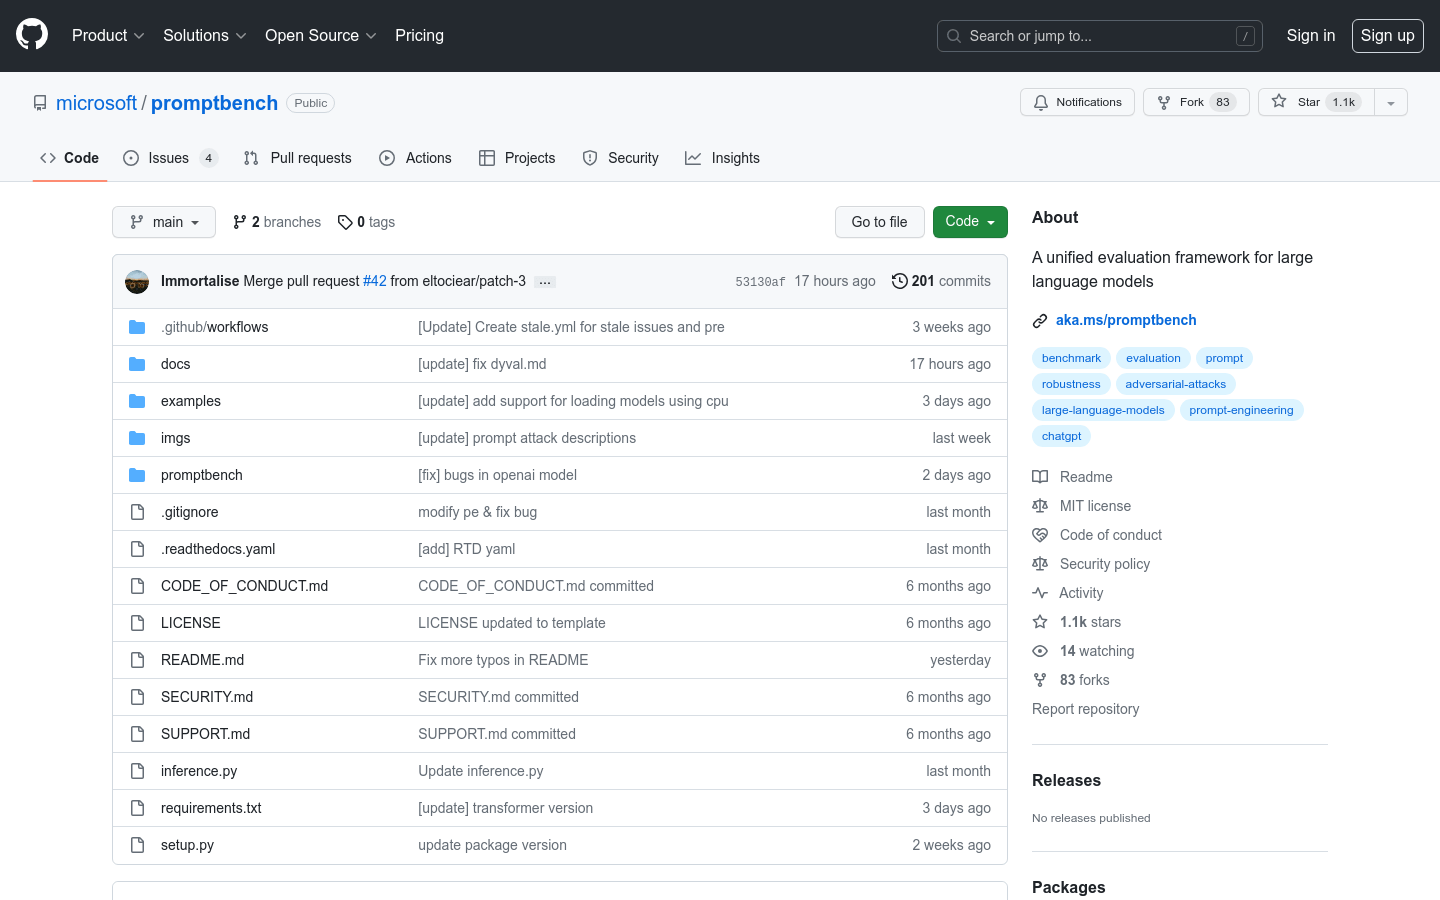
Promptbench - Versatile LLM Evaluation and Prompt Engineering Toolkit ...

MPBench: A Comprehensive Multimodal Reasoning Benchmark for Process ...
GitHub - hertera1/promptbench: An robustness evaluation framework for ...

Paper page - VerifyBench: Benchmarking Reference-based Reward Systems ...

PromptBench: Towards Evaluating the Robustness of Large Language Models ...

PromptBench: Towards Evaluating the Robustness of Large Language Models ...