
231211420 Tuning Layernorm In Attention Towards Efficient Multi

[2312.11420] Tuning LayerNorm in Attention: Towards Efficient Multi ...
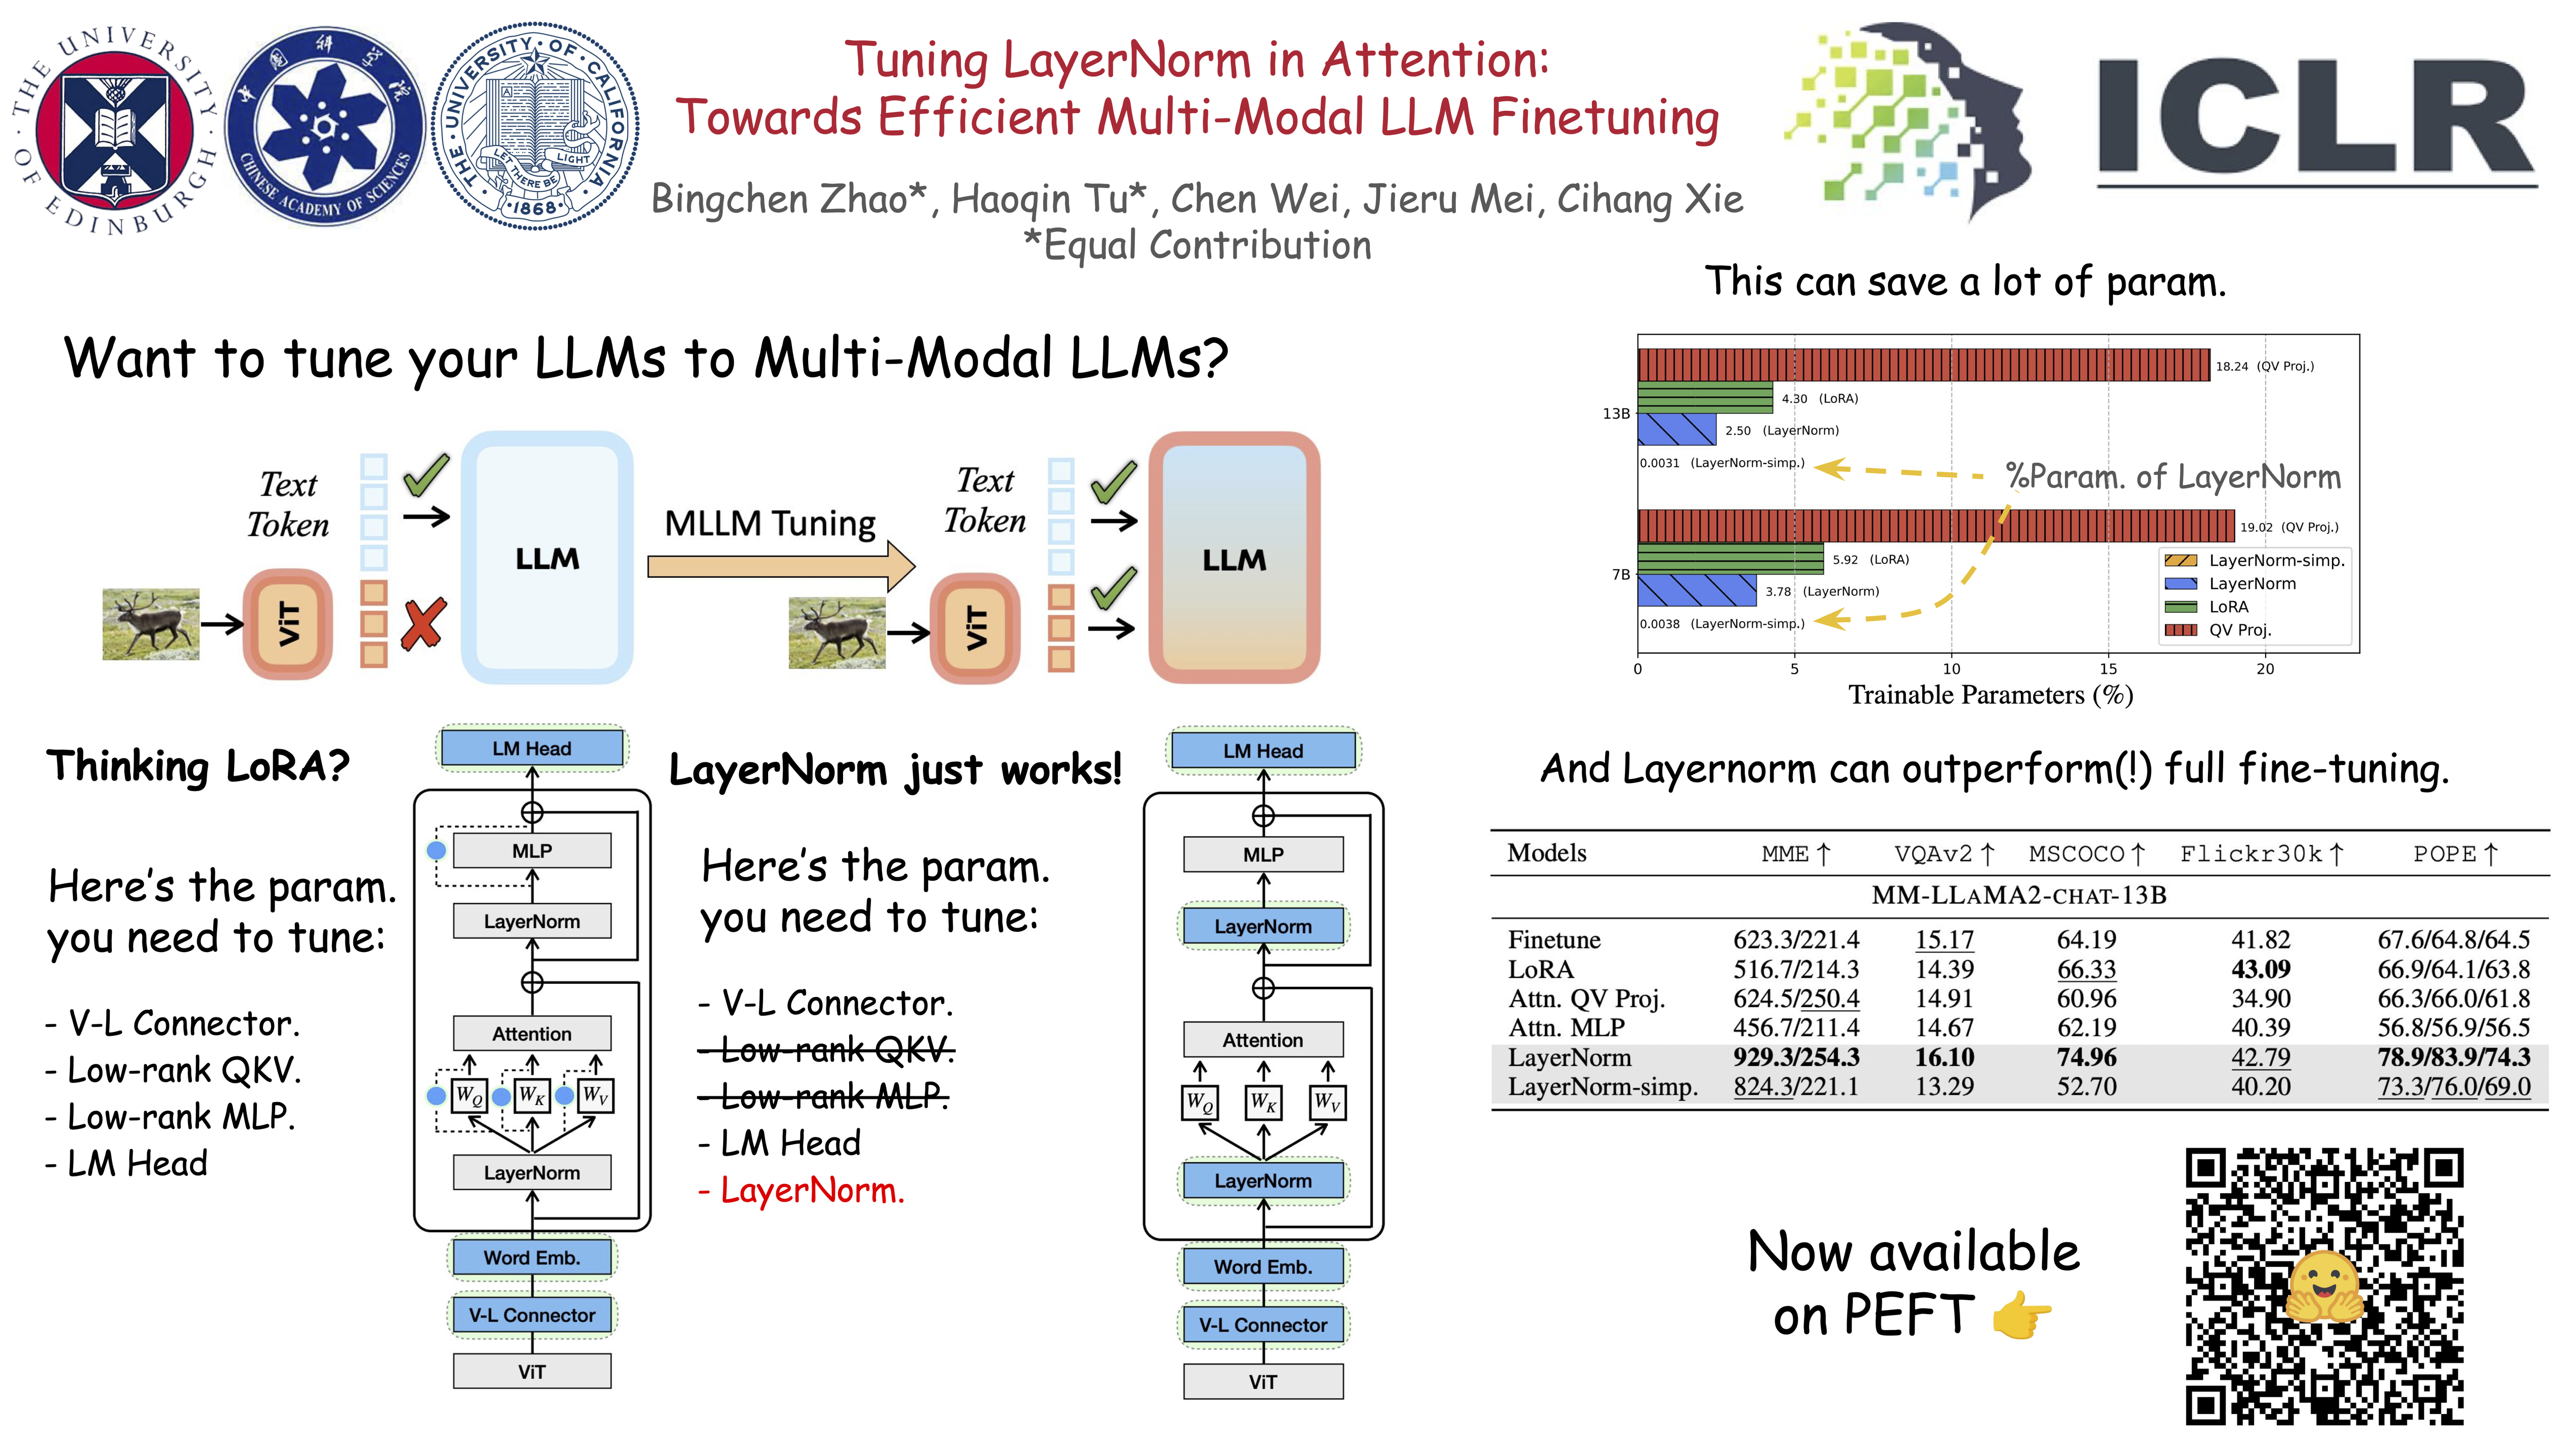
ICLR Poster Tuning LayerNorm in Attention: Towards Efficient Multi ...

Paper page - Tuning LayerNorm in Attention: Towards Efficient Multi ...

[2312.11420] Tuning LayerNorm in Attention: Towards Efficient Multi ...

[2312.11420] Tuning LayerNorm in Attention: Towards Efficient Multi ...

[2312.11420] Tuning LayerNorm in Attention: Towards Efficient Multi ...

[2312.11420] Tuning LayerNorm in Attention: Towards Efficient Multi ...

[2312.11420] Tuning LayerNorm in Attention: Towards Efficient Multi ...

[2312.11420] Tuning LayerNorm in Attention: Towards Efficient Multi ...

TUNING LAYERNORM IN ATTENTION TOWARDS EFFI CIENT MULTI MODAL LLM ...
Advertisement Space (300x250)
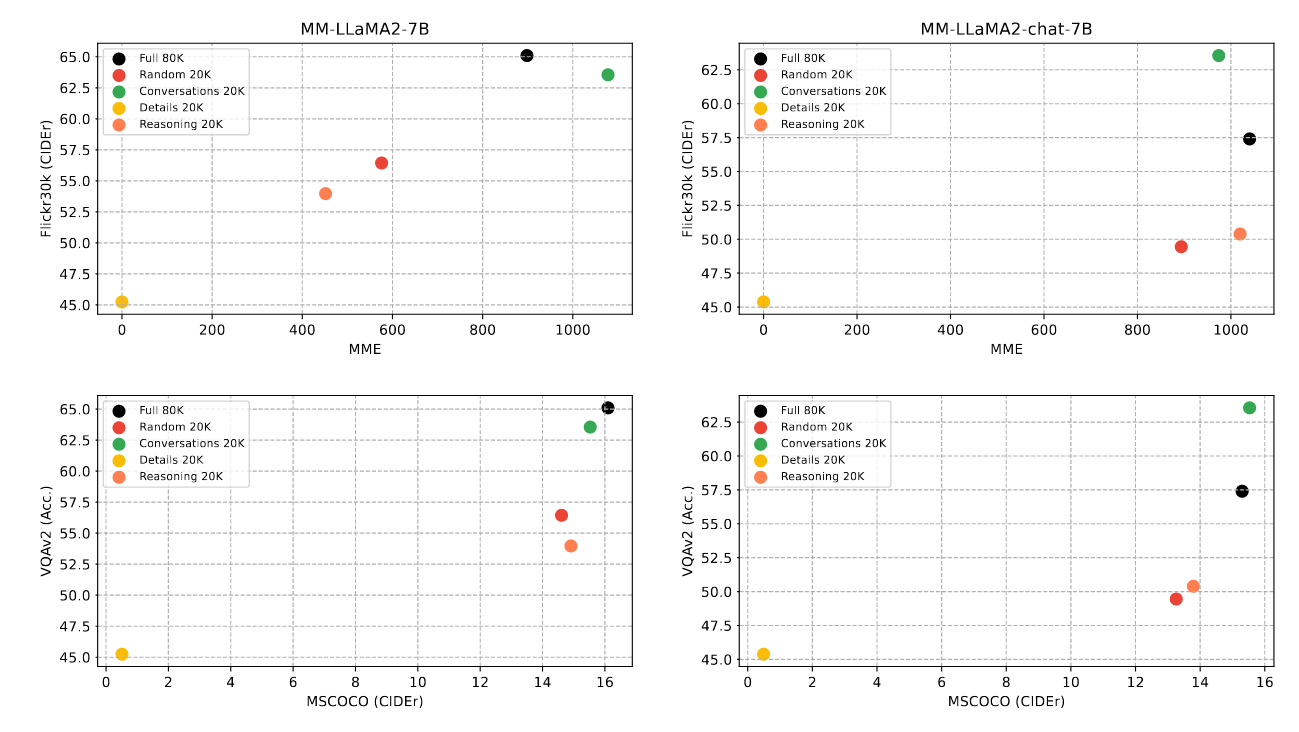
Tuning LayerNorm in Attention: Towards Efficient Multi-Modal LLM ...
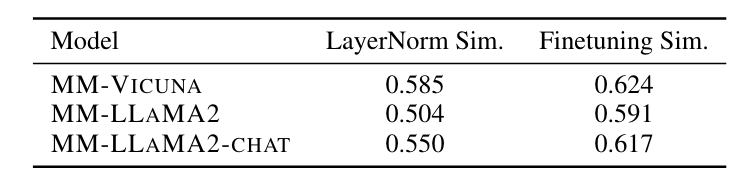
Tuning LayerNorm in Attention: Towards Efficient Multi-Modal LLM ...
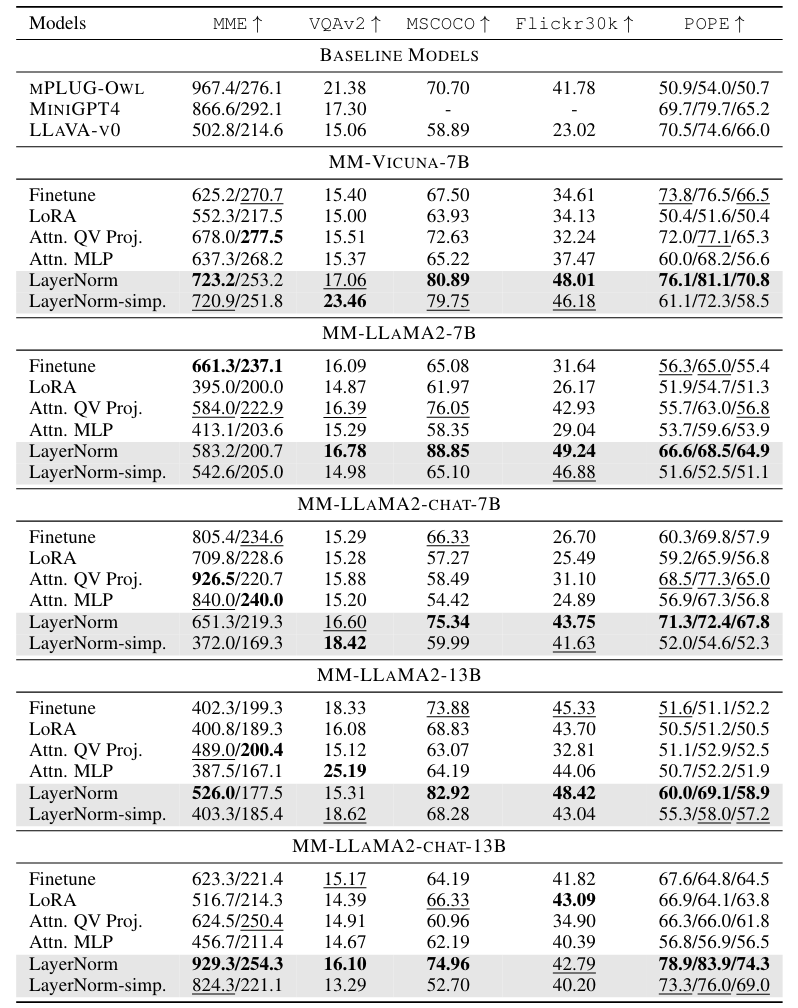
Tuning LayerNorm in Attention: Towards Efficient Multi-Modal LLM ...
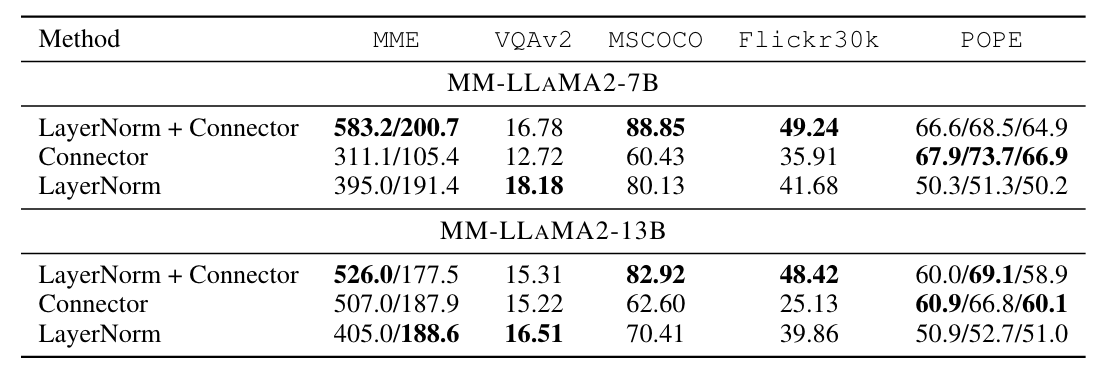
Tuning LayerNorm in Attention: Towards Efficient Multi-Modal LLM ...
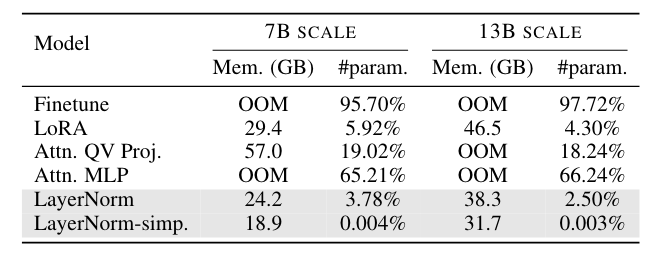
Tuning LayerNorm in Attention: Towards Efficient Multi-Modal LLM ...

Concept Drift Guided LayerNorm Tuning for Efficient Multimodal Metaphor ...

(PDF) On the Expressivity Role of LayerNorm in Transformers' Attention

[논문 리뷰] Hierarchical and Step-Layer-Wise Tuning of Attention Specialty ...

Efficiency in Focus: LayerNorm as a Catalyst for Fine-tuning Medical ...

About LayerNorm Variants in the Original Transformer Paper, and Some ...
Advertisement Space (336x280)

MuxTune: Efficient Multi-Task LLM Fine-Tuning in Multi-Tenant ...

LayerBoost: Layer-Aware Attention Reduction for Efficient LLMs

Efficiency in Focus: LayerNorm as a Catalyst for Fine-tuning Medical ...

Efficiency in Focus: LayerNorm as a Catalyst for Fine-tuning Medical ...

A Multiple Attention Layer-shareable Method for Link Prediction in ...

[P] Historical Tidbits about Transformers: About LayerNorm Variants in ...

LayerNorm 在 Transformers 中对注意力的作用研究 - 知乎
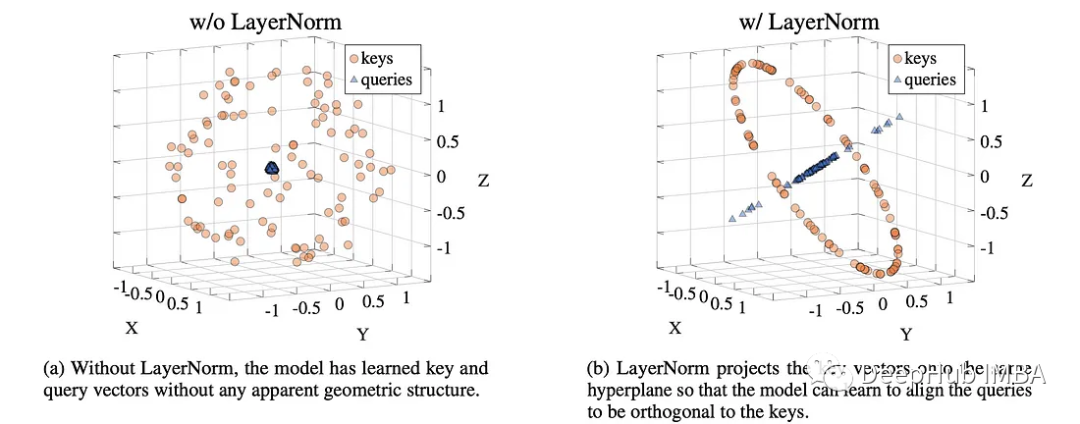
LayerNorm 在 Transformers 中对注意力的作用研究-阿里云开发者社区

[논문 리뷰] You can remove GPT2's LayerNorm by fine-tuning
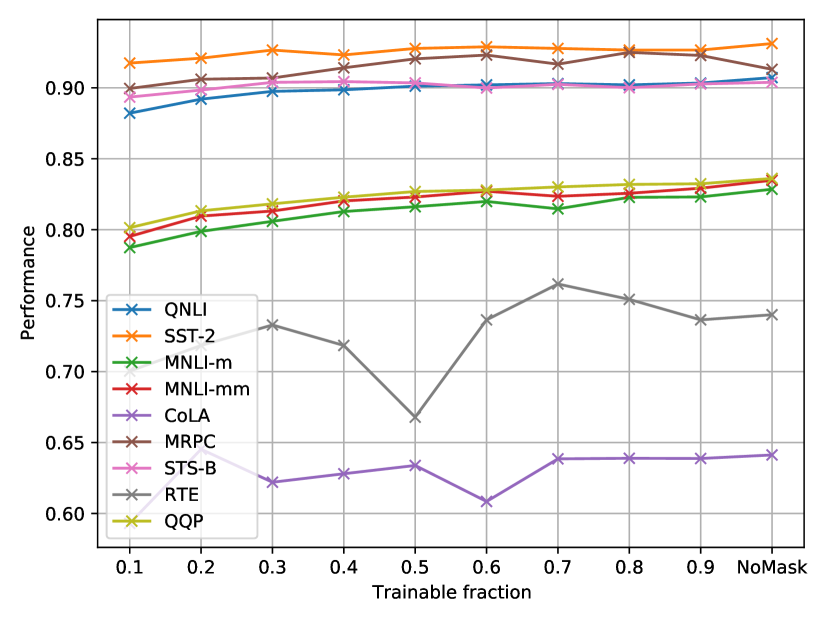
[2403.20284] LayerNorm: A key component in parameter-efficient fine-tuning
Advertisement Space (336x280)
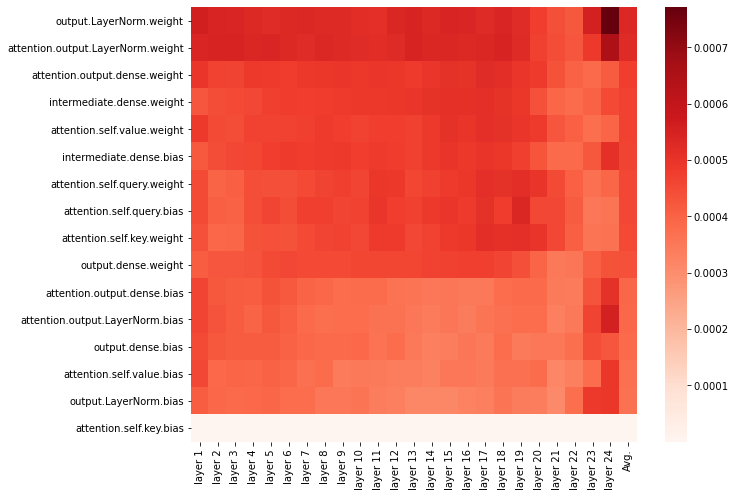
[2403.20284] LayerNorm: A key component in parameter-efficient fine-tuning

Figure 1 from LayerNorm: A key component in parameter-efficient fine ...
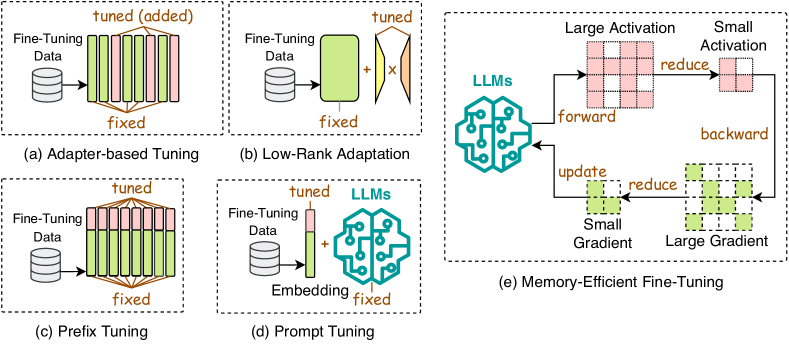
[2312.03863] Efficient Large Language Models: A Survey

A Multi-Layer Attention Knowledge Tracking Method with Self-Supervised ...

Figure 1 from The Expressive Power of Tuning Only the Norm Layers ...
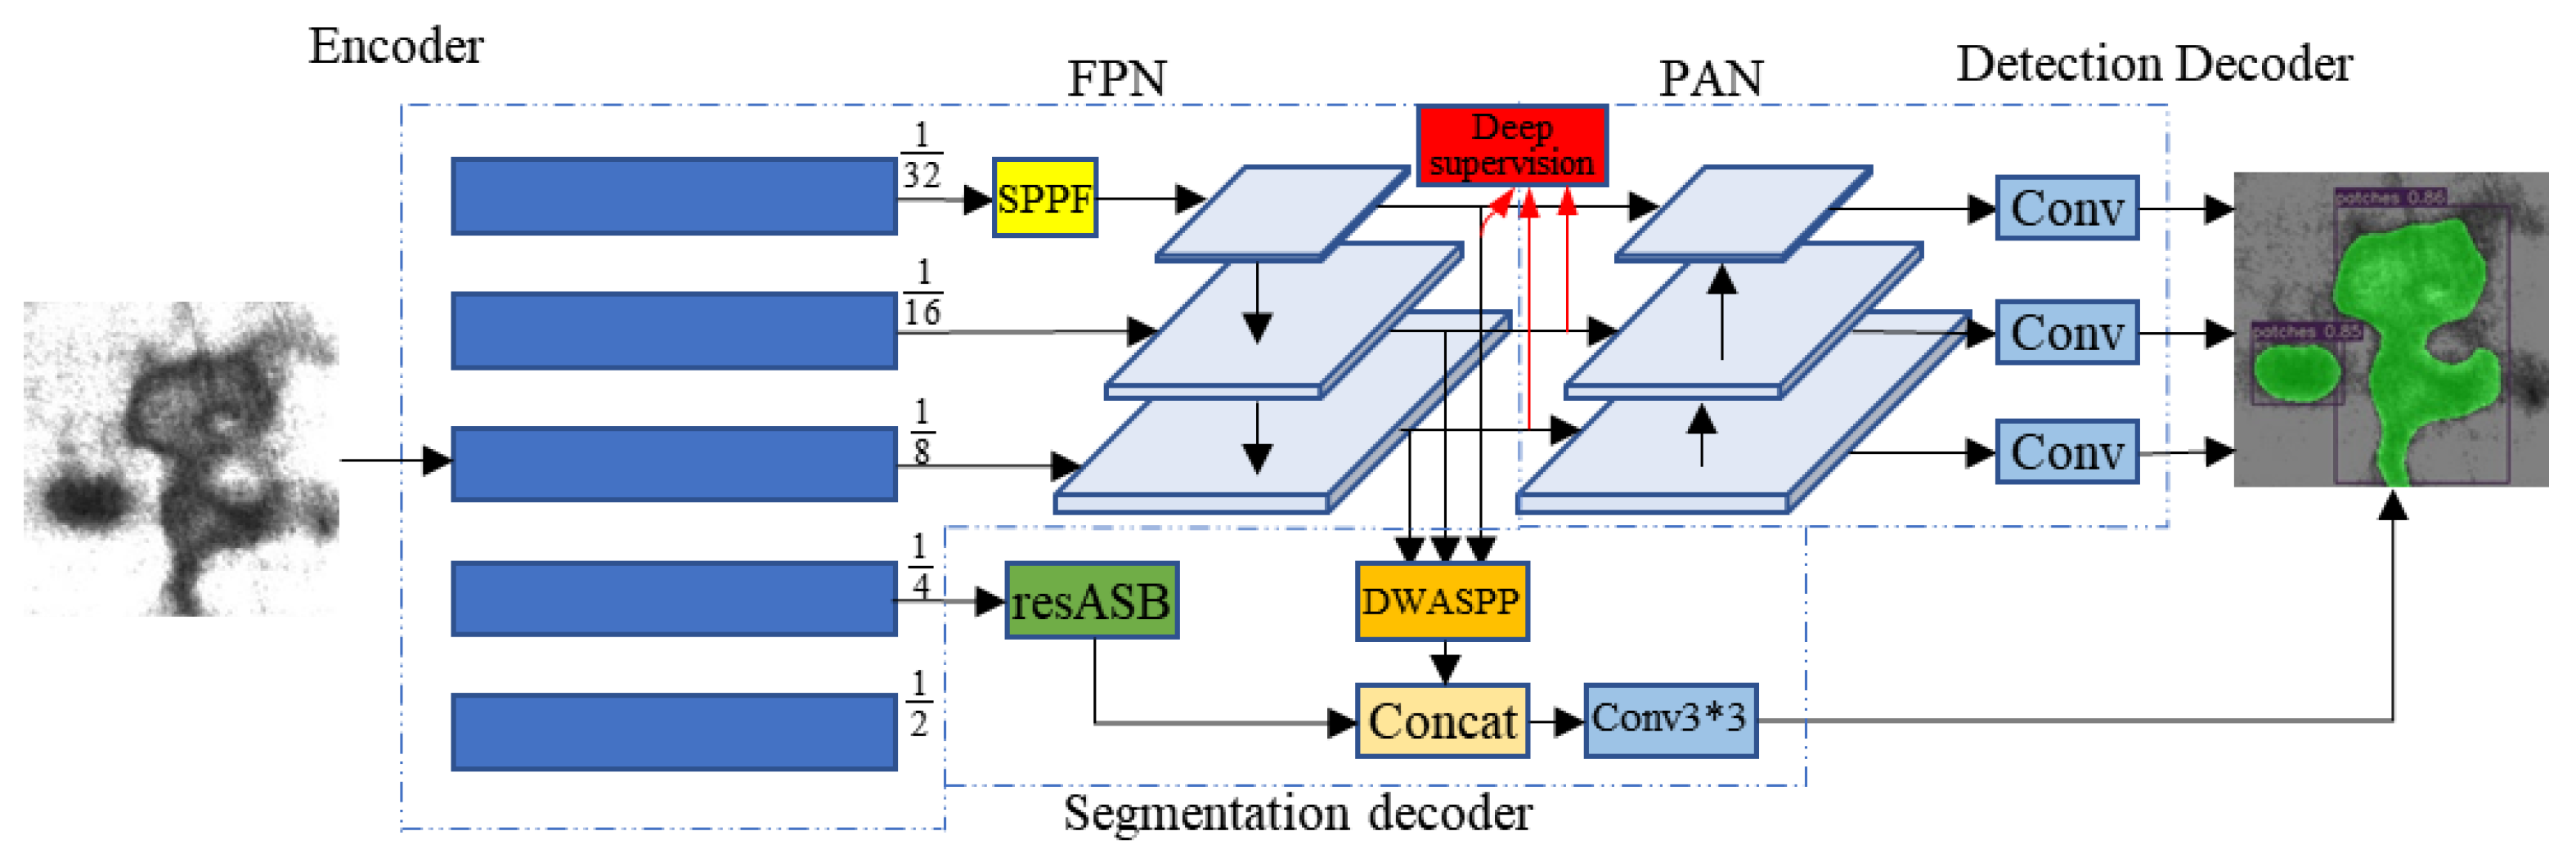
An Efficient End-to-End Multitask Network Architecture for Defect ...