
Accelerating Rl Post Training With Speculative Decoding In Nemo Rl
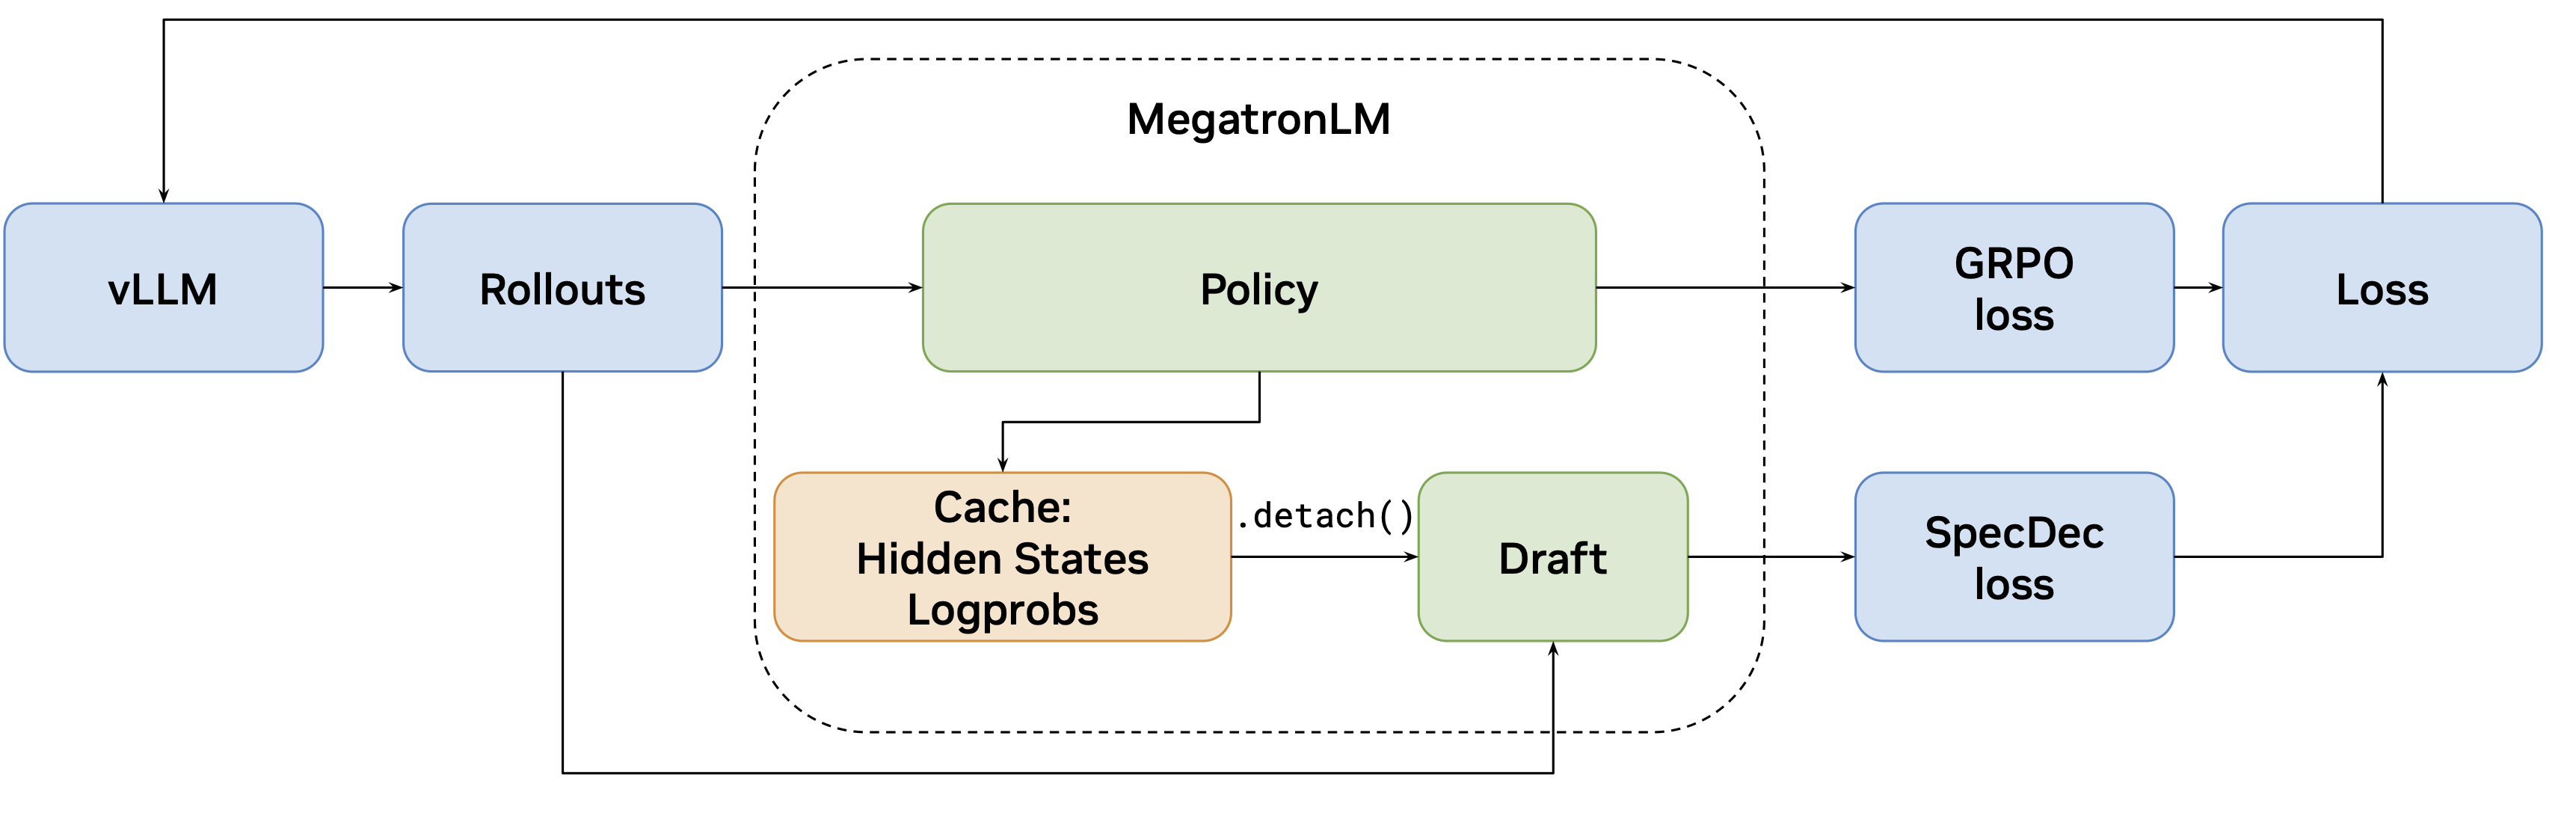
Accelerating RL Post-Training with Speculative Decoding in NeMo RL ...
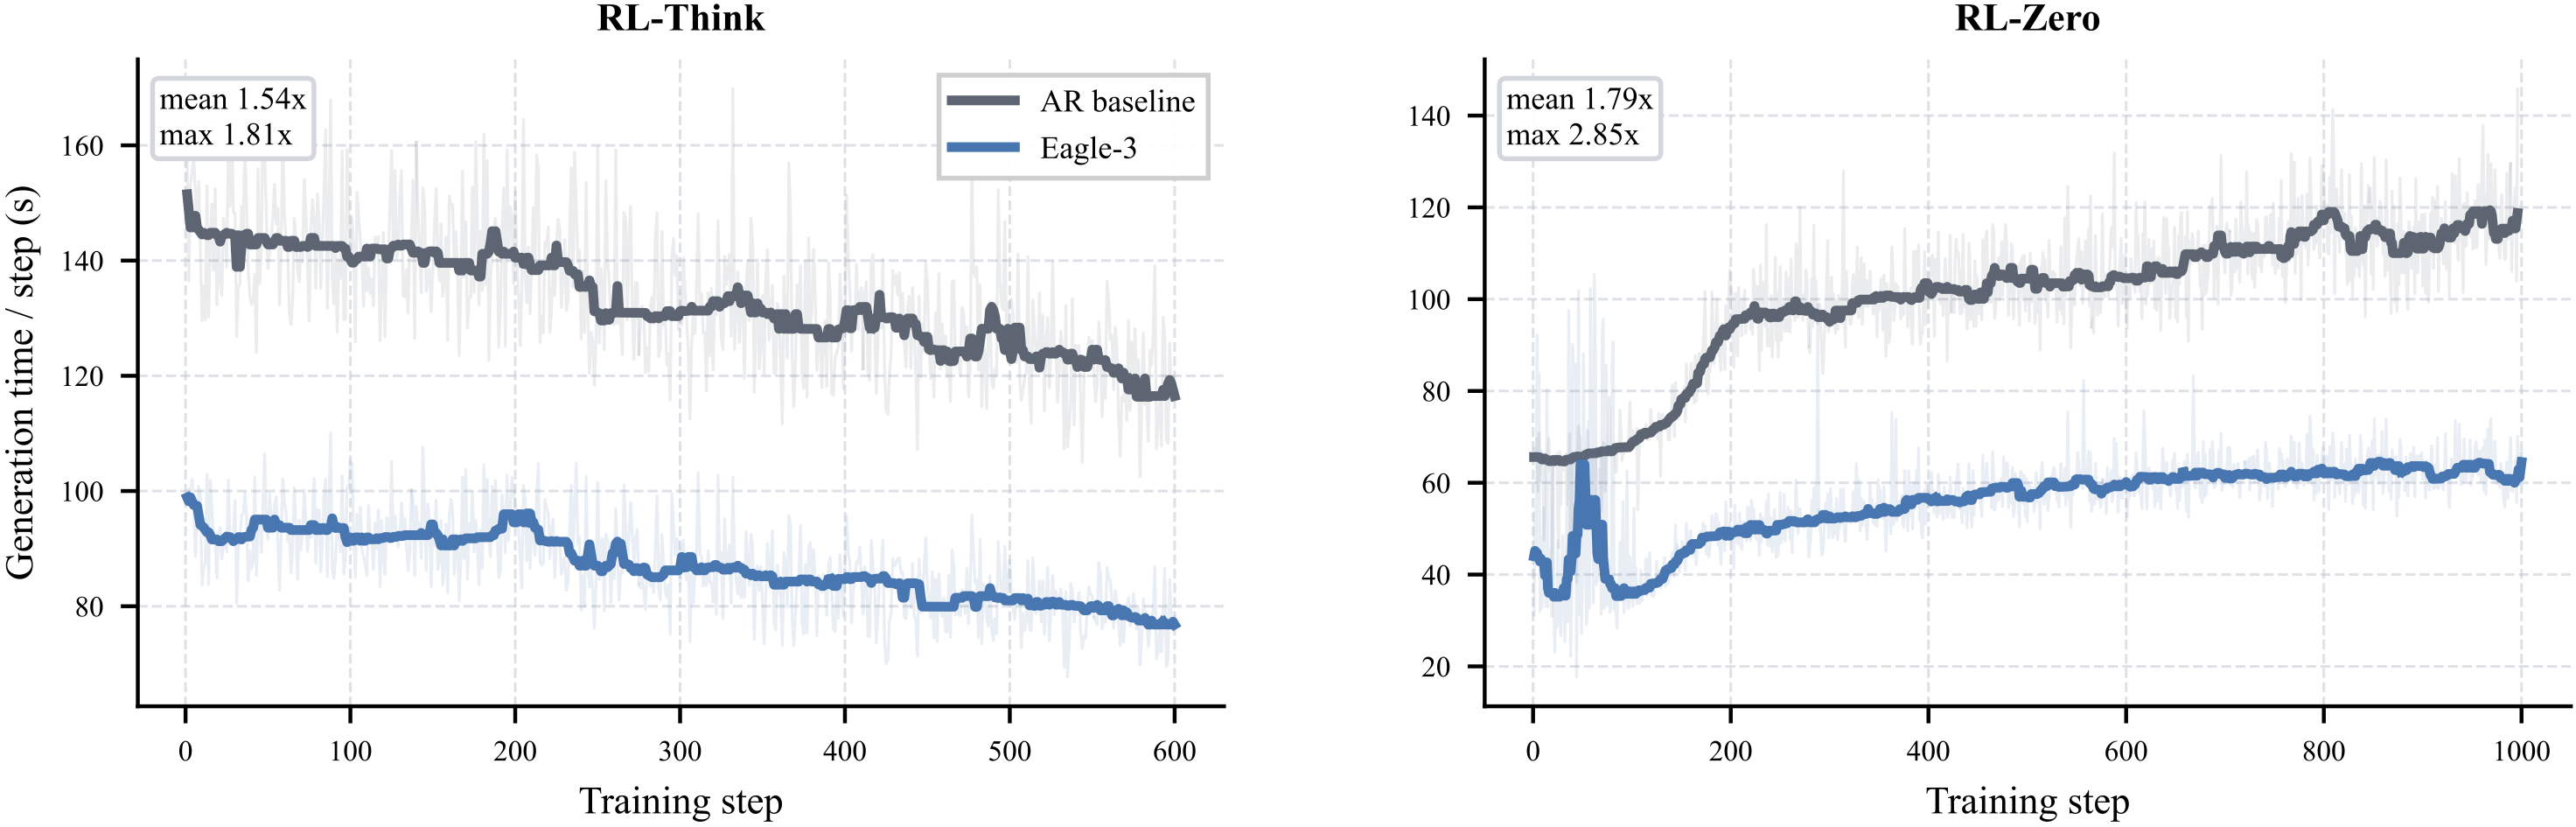
Accelerating RL Post-Training with Speculative Decoding in NeMo RL ...
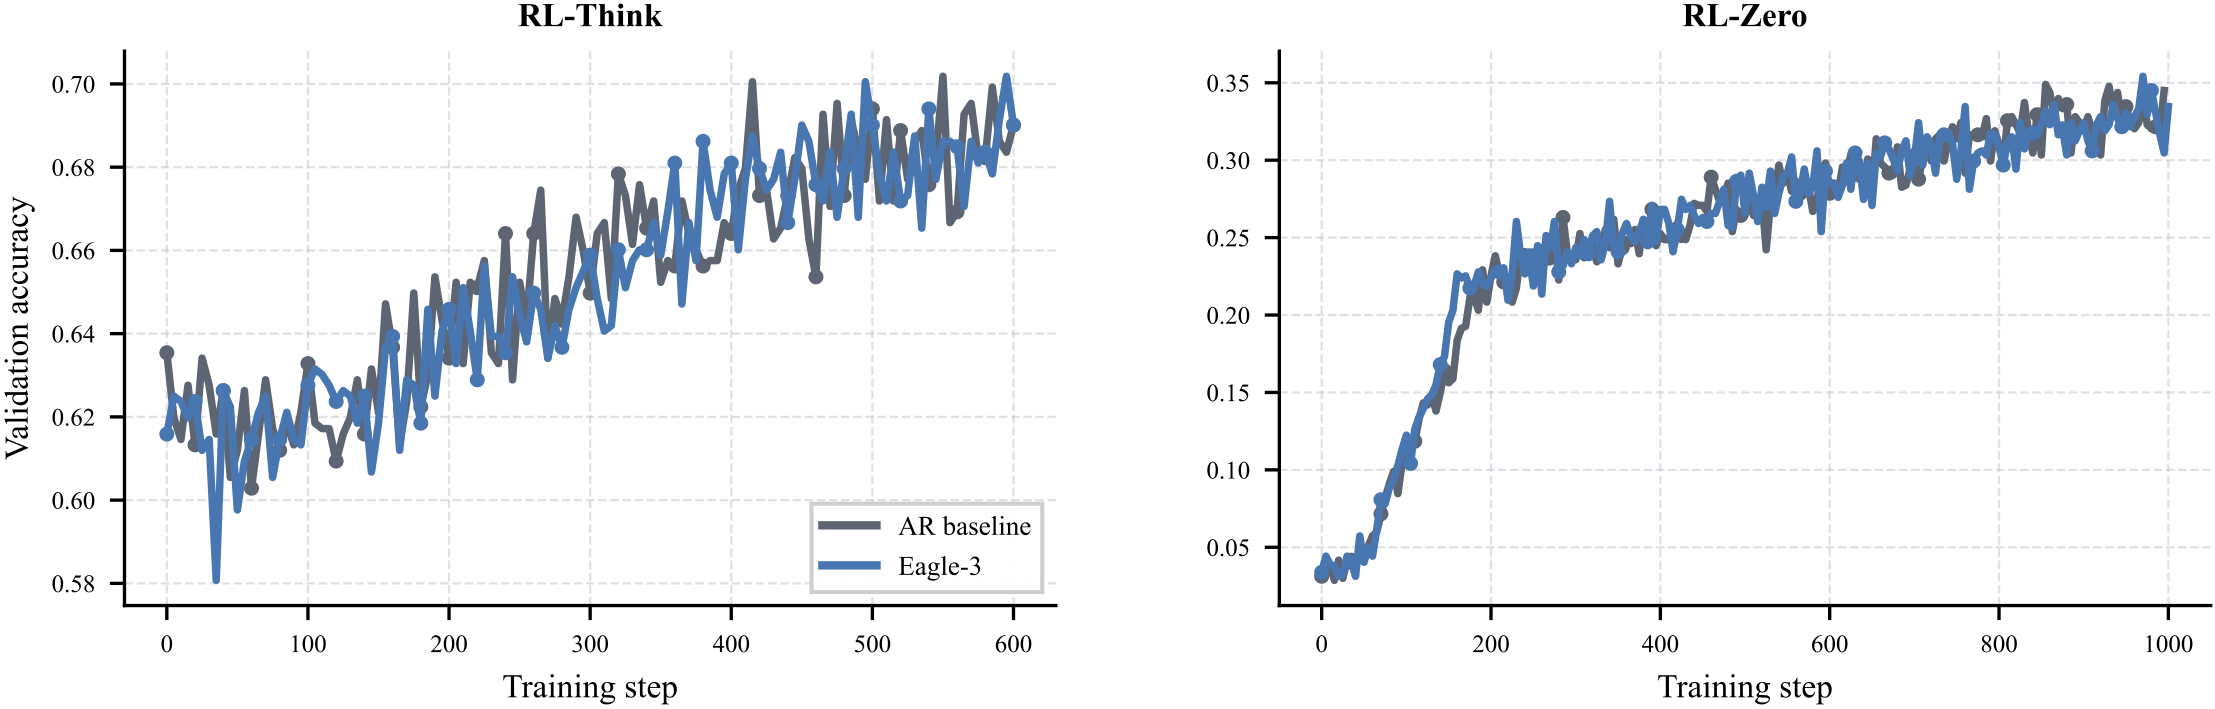
Accelerating RL Post-Training with Speculative Decoding in NeMo RL ...
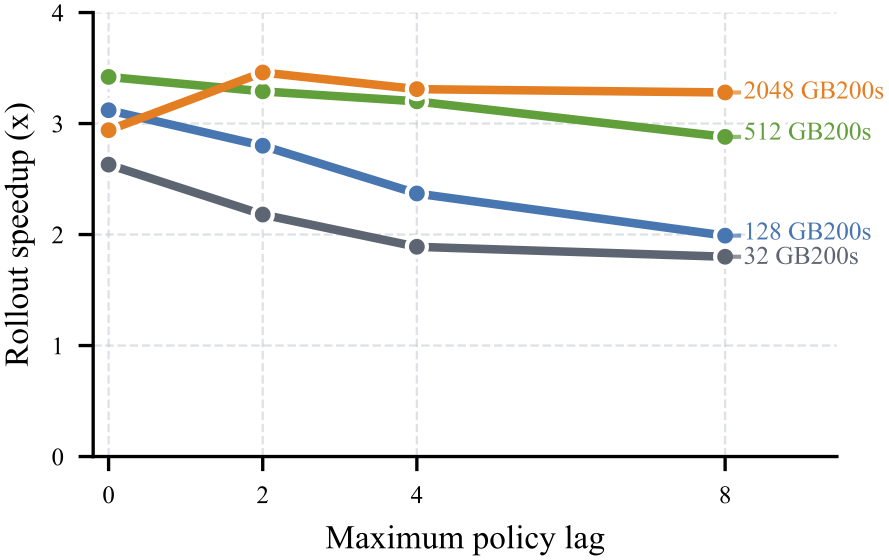
Accelerating RL Post-Training with Speculative Decoding in NeMo RL ...
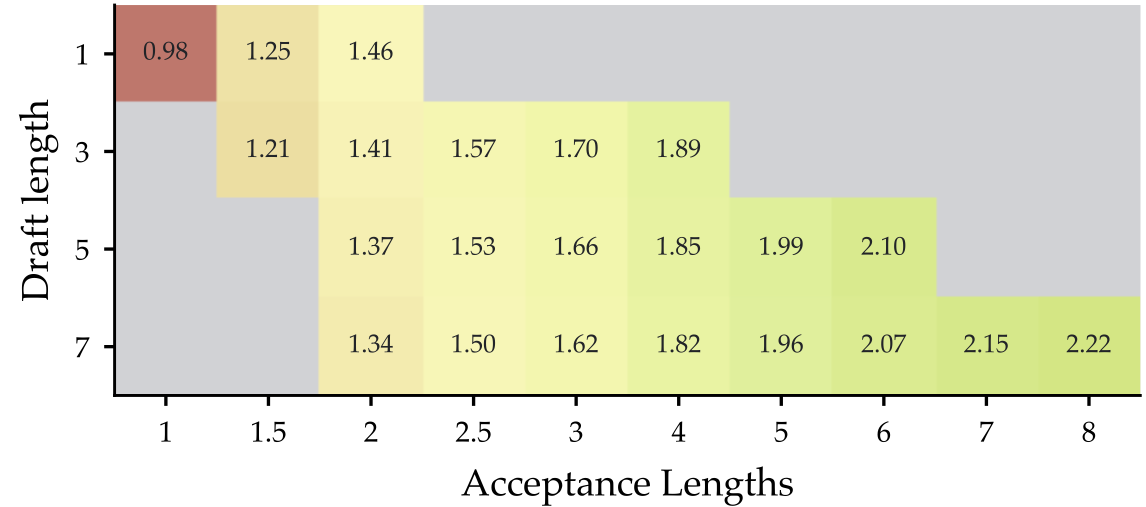
Accelerating RL Post-Training with Speculative Decoding in NeMo RL ...

A New NVIDIA Research Shows Speculative Decoding in NeMo RL Achieves 1. ...
A New NVIDIA Research Shows Speculative Decoding in NeMo RL Achieves 1. ...

A New NVIDIA Research Shows Speculative Decoding in NeMo RL Achieves 1. ...
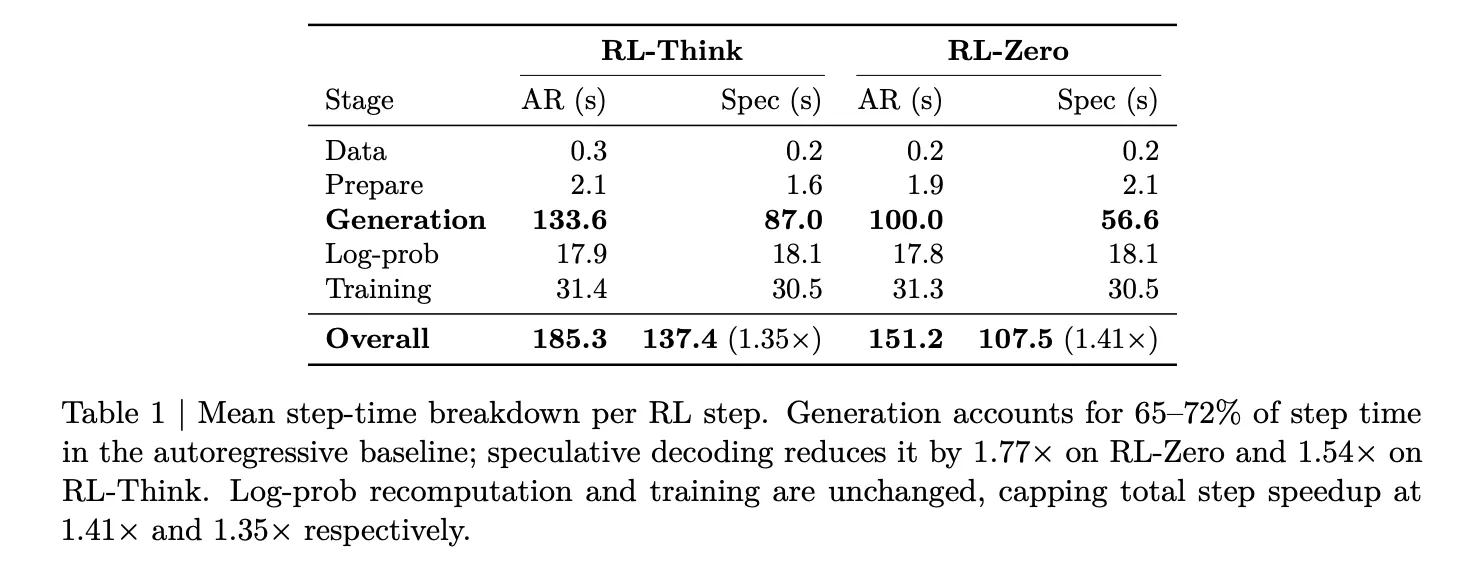
A New NVIDIA Research Shows Speculative Decoding in NeMo RL Achieves 1. ...
A New NVIDIA Analysis Exhibits Speculative Decoding in NeMo RL Achieves ...
Advertisement Space (300x250)

NVIDIA NeMo RL Accelerates Reasoning Model Training With End to End FP8 ...

NVIDIA NeMo RL Speculative Decoding: 1.8×… | gentic.news
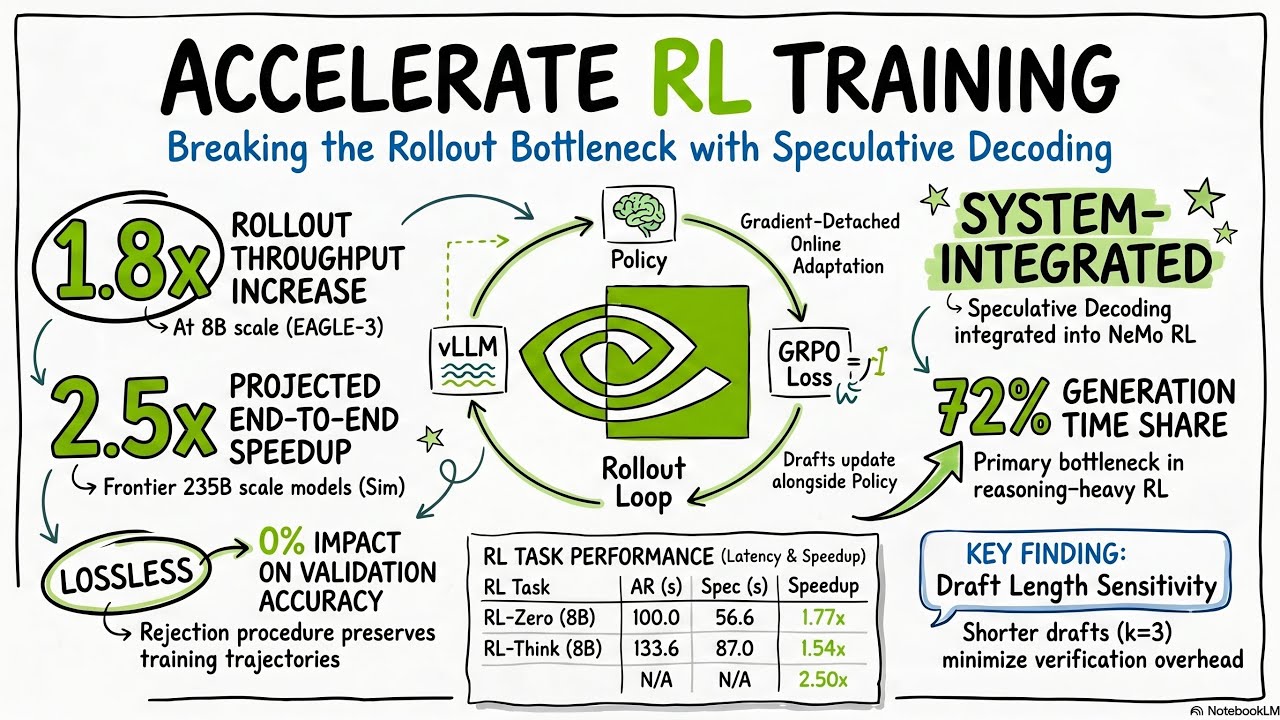
Speculative Decoding for Accelerated RL Post-Training Rollouts - YouTube
NVIDIA NeMo RL Speculative Decoding: 1.8×… | gentic.news

Distribution-Aware Speculative Decoding Accelerates RL Rollouts | OJO
NVIDIA Achieves 2.5x RL Training Speedup with System-Integrated ...

NVIDIA NeMo RL Achieves 48% Speedup with End-to-End FP8 Precision ...

Beat the long tail: Distribution-Aware Speculative Decoding for RL ...

Taming the Long-Tail: Efficient Reasoning RL Training with Adaptive Drafter
Accelerate RL rollouts by up to 50% with distribution-aware speculative ...
Advertisement Space (336x280)

Accelerate RL rollouts by up to 50% with distribution-aware speculative ...

NVIDIA NeMo Gym - RL Agent Training Datasets - a mindchain Collection

How memory is consumed during nemo RL GRPO training - Guoliang(Gavin ...
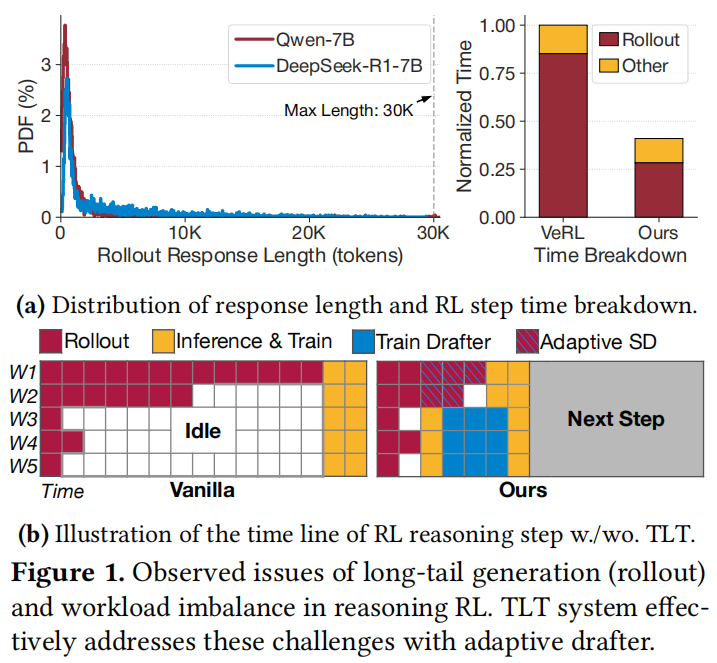
📝 Taming the Long-Tail: Efficient Reasoning RL Training with Adaptive ...
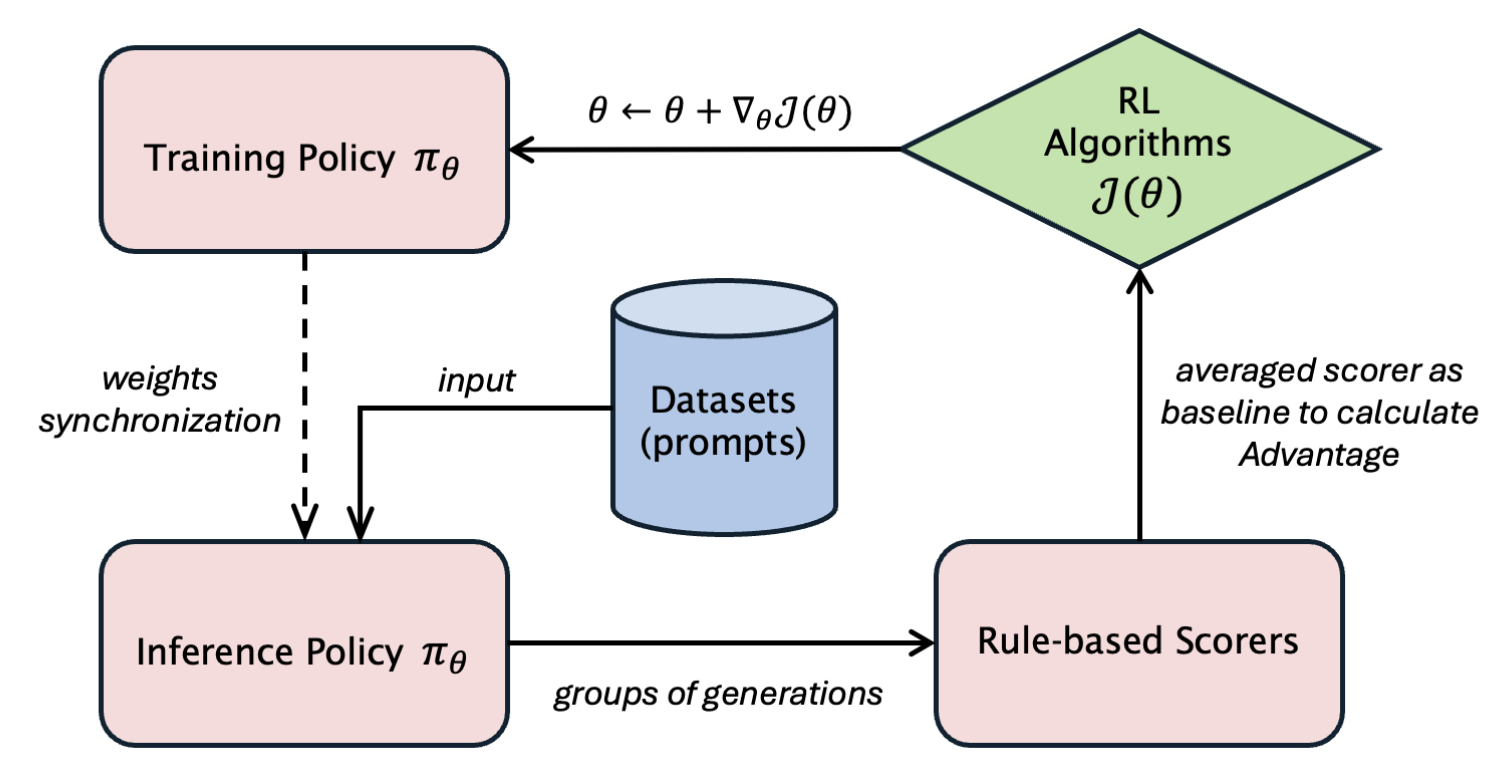
Efficient RL Training - Optimizing Memory Usage in verl · Biao's Blog
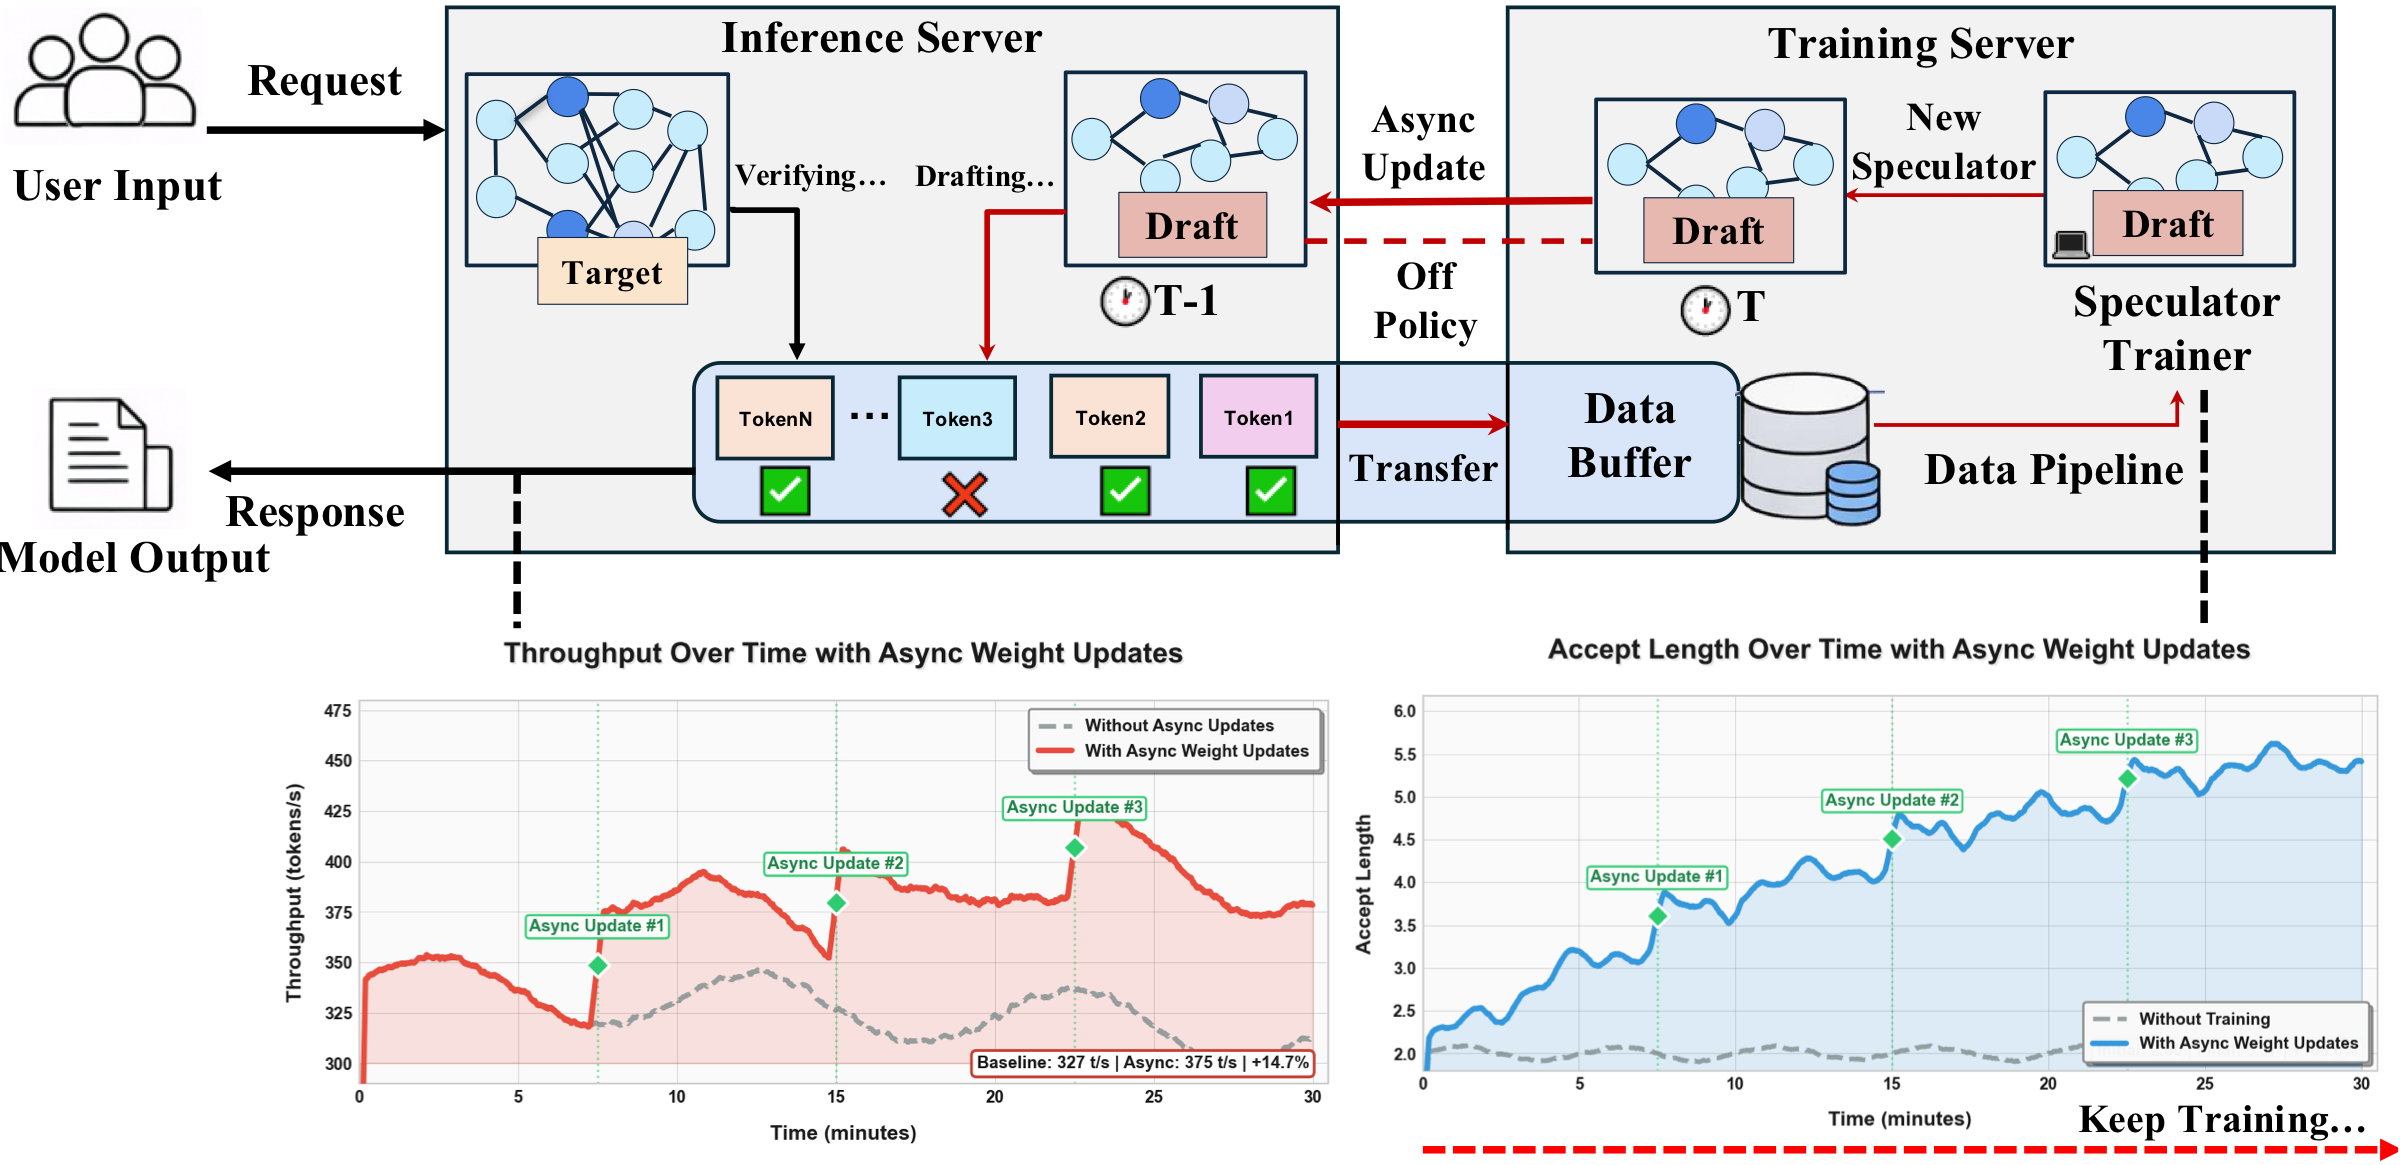
Aurora: When RL Meets Adaptive Speculative Training

(PDF) Accelerating LLM Inference with Staged Speculative Decoding
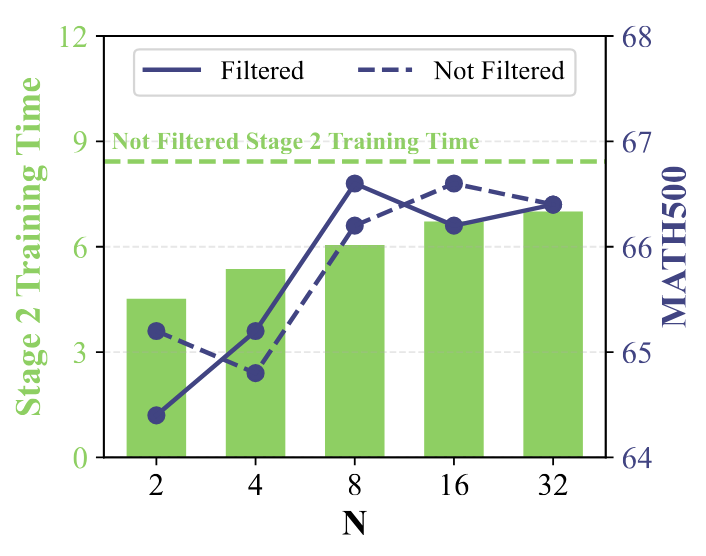
Accelerating RL for LLM Reasoning with Optimal Advantage Regression ...
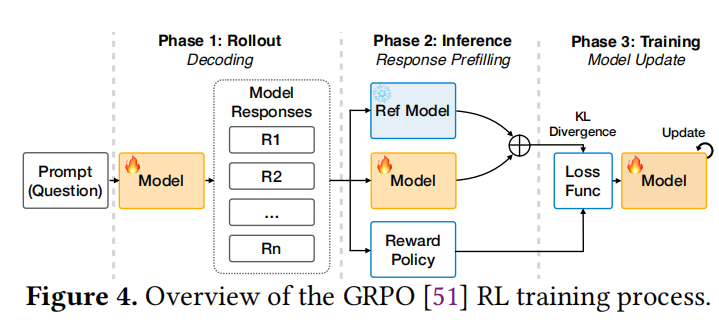
📝 Taming the Long-Tail: Efficient Reasoning RL Training with Adaptive ...
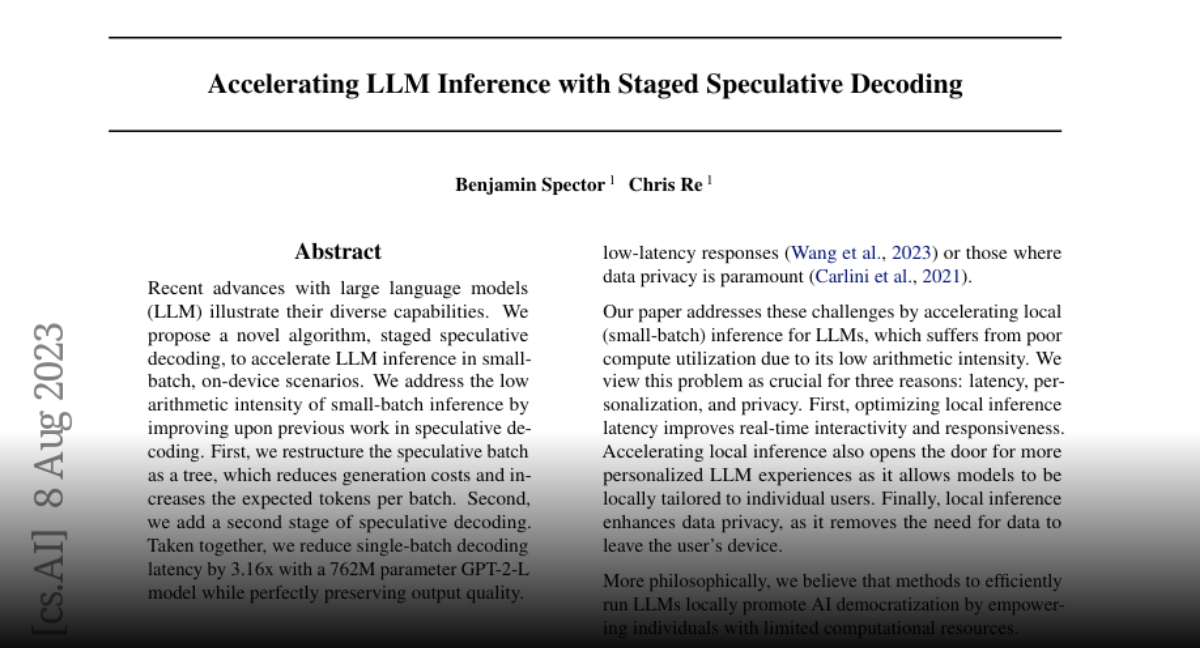
Paper page - Accelerating LLM Inference with Staged Speculative Decoding
Advertisement Space (336x280)

The process used for training the cipher model and decoding RL text to ...

D^2SD: Accelerating Speculative Decoding with Dual Diffusion Draft ...

(PDF) Accelerate Speculative Decoding with Sparse Computation in ...
[논문 리뷰] LLMZero: Discovering Adaptive Training Strategies for RL Post ...

Fine-tuning & RL For LLMs: Intro to Post training Module 1: Post ...

(PDF) Accelerating LLM Inference with Lossless Speculative Decoding ...