
Aligning Visual Foundation Encoders To Tokenizers For Diffusion Models
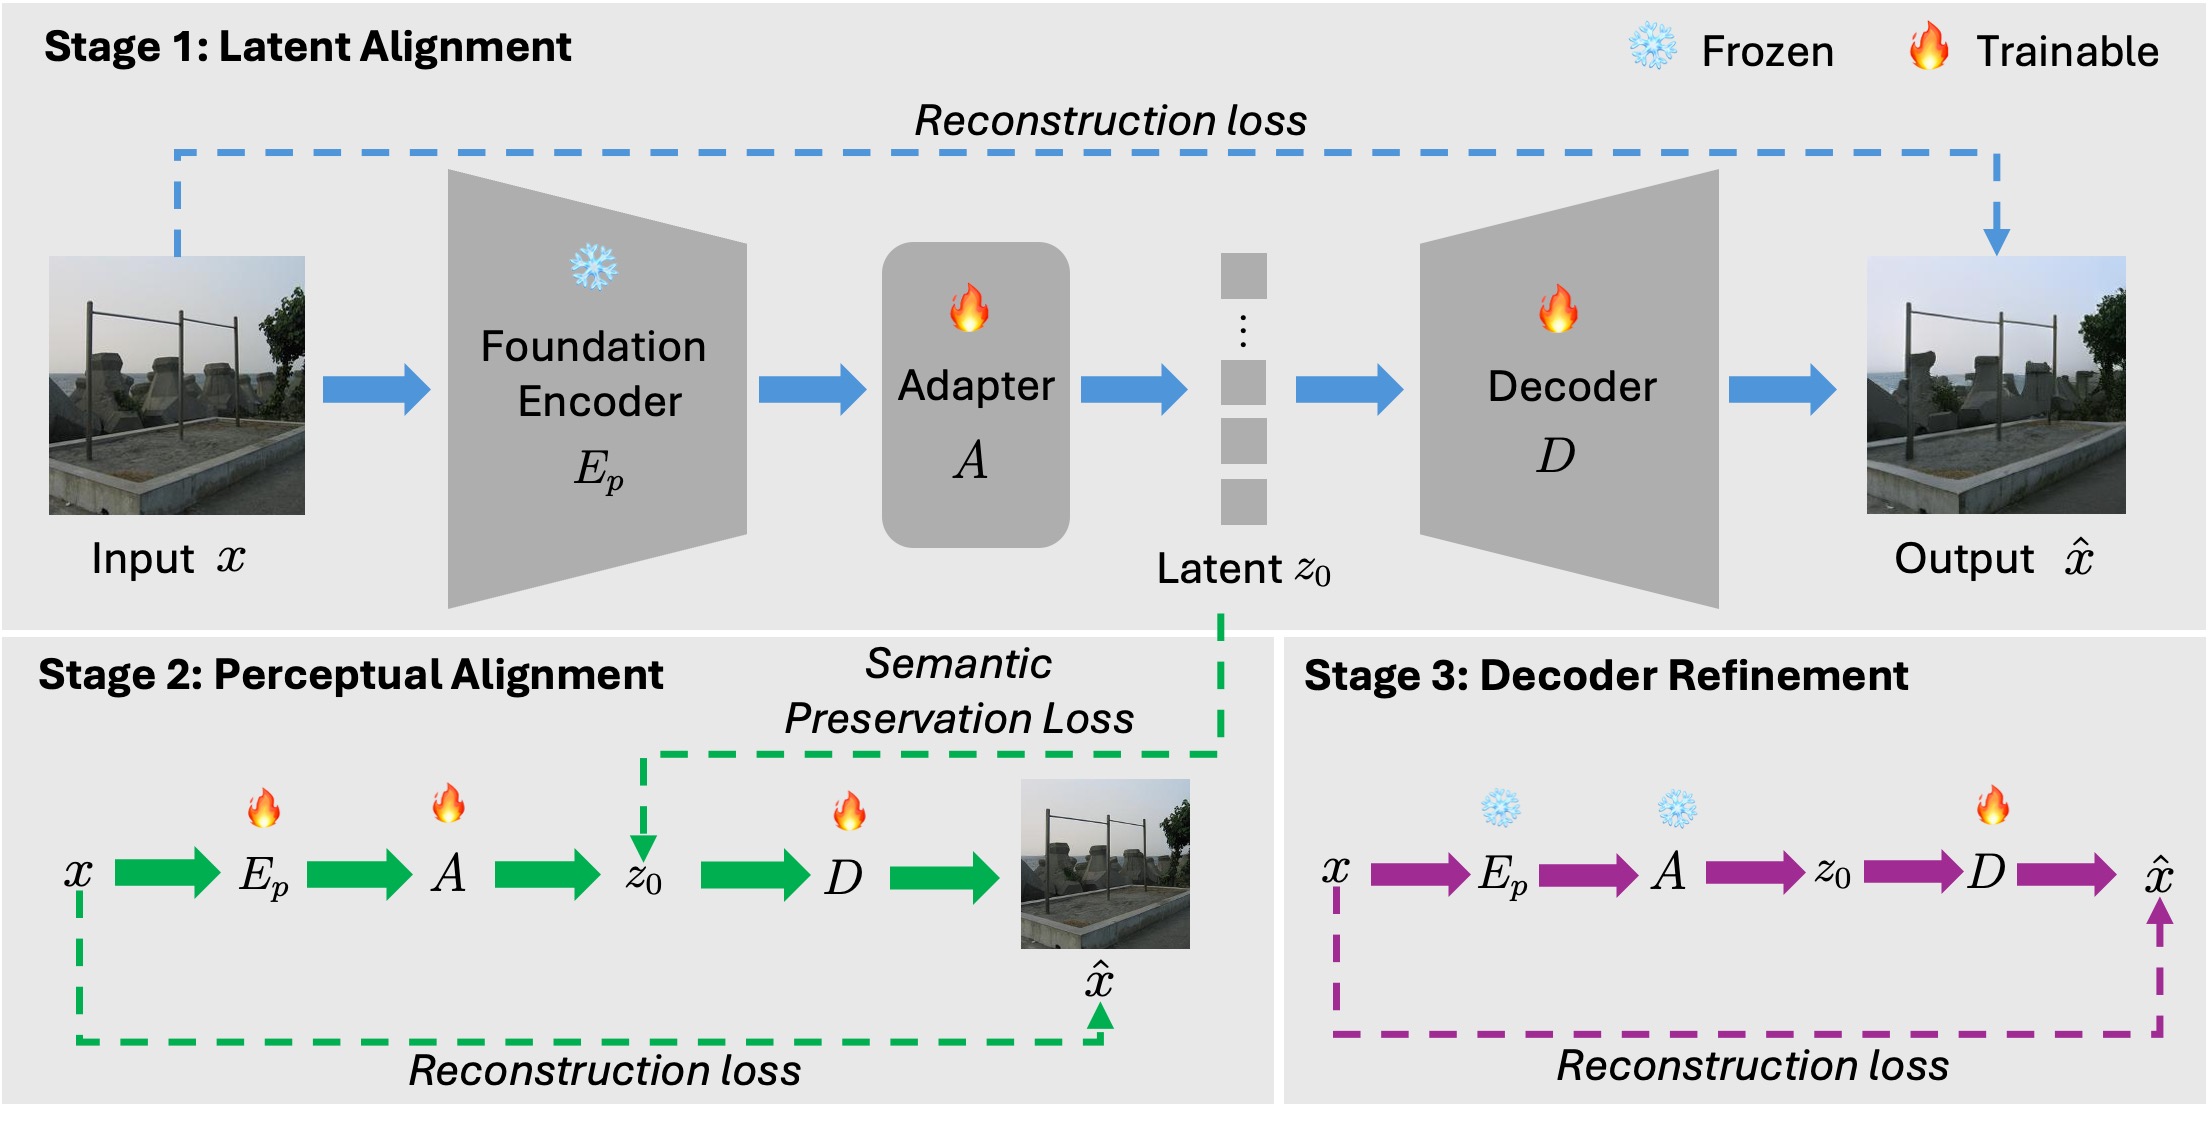
Aligning Visual Foundation Encoders to Tokenizers for Diffusion Models

Aligning Visual Foundation Encoders to Tokenizers for Diffusion Models ...
Aligning Visual Foundation Encoders to Tokenizers for Diffusion Models ...
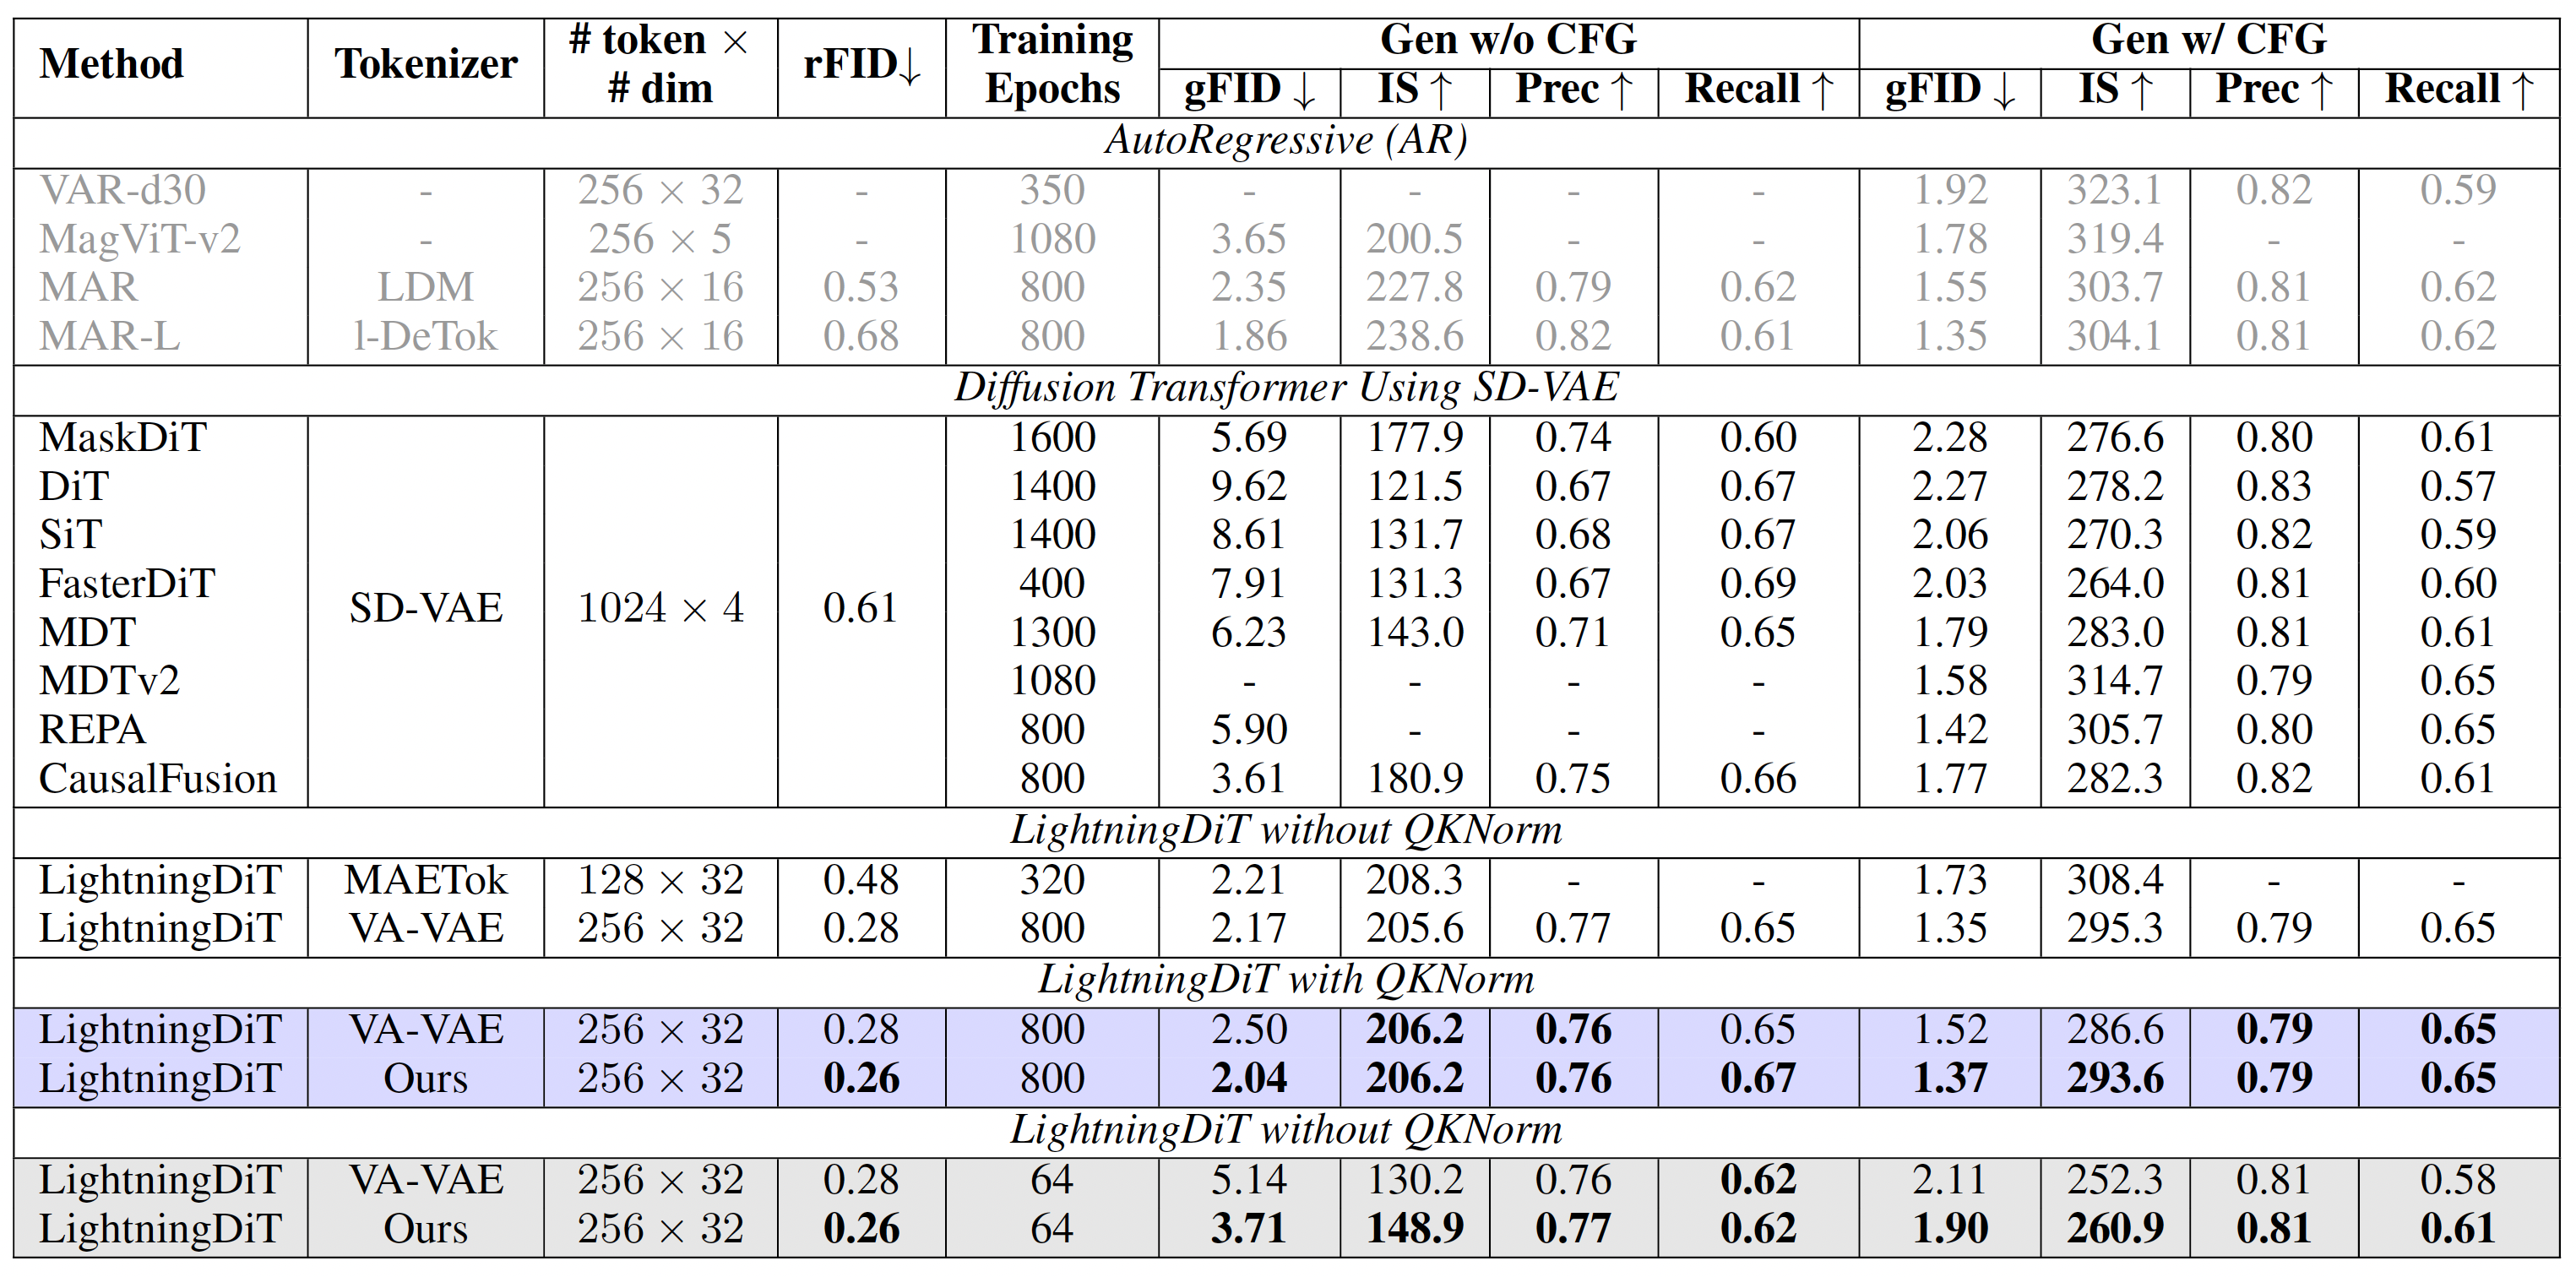
Aligning Visual Foundation Encoders to Tokenizers for Diffusion Models
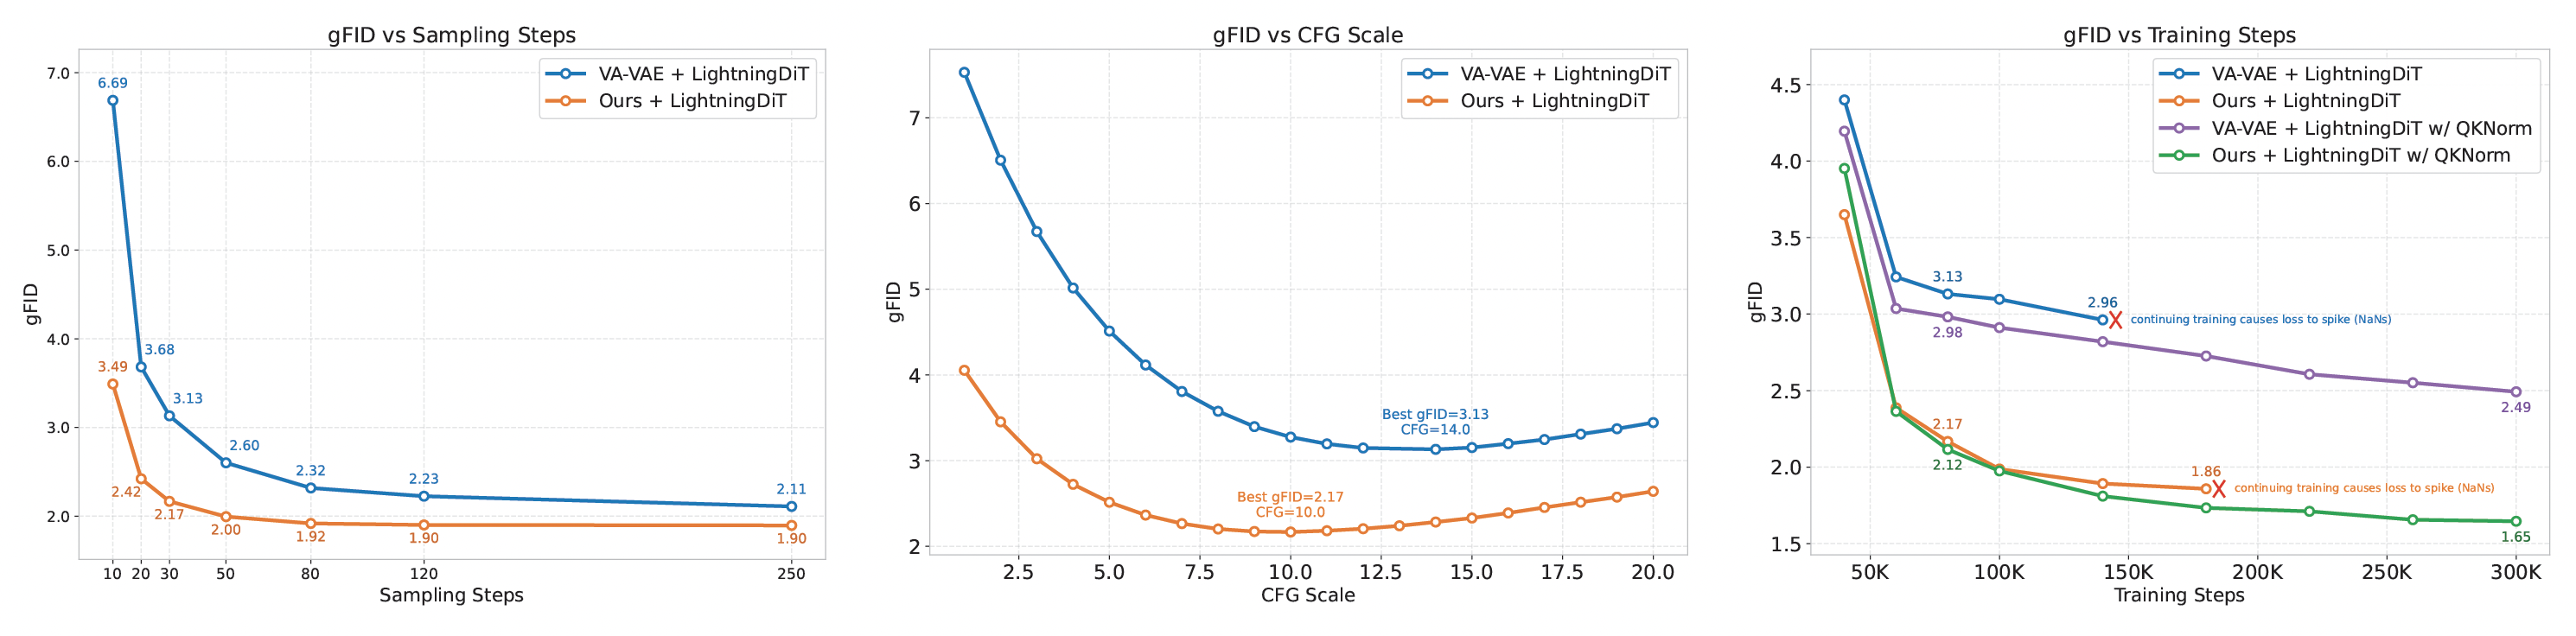
Aligning Visual Foundation Encoders to Tokenizers for Diffusion Models

[论文评述] Aligning Visual Foundation Encoders to Tokenizers for Diffusion ...

ICLR Poster Aligning Visual Foundation Encoders to Tokenizers for ...

(PDF) Vision Foundation Models as Effective Visual Tokenizers for ...

Vision Foundation Models Can Be Good Tokenizers for Latent Diffusion ...

VFM-VAE: Vision Foundation Models Can Be Good Tokenizers for Latent ...
Advertisement Space (300x250)
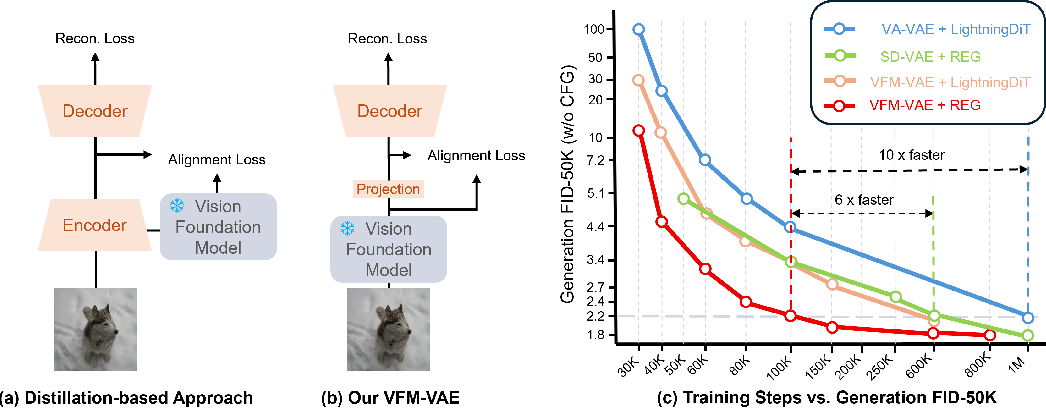
Figure 1 from Vision Foundation Models Can Be Good Tokenizers for ...

Repurposing Geometric Foundation Models for Multi-view Diffusion

NeurIPS Poster Vision Foundation Models as Effective Visual Tokenizers ...

Diffusion Large Language Models for Visual Speech Recognition

Paper page - Vision Foundation Models Can Be Good Tokenizers for Latent ...

InternVL: Scaling up Vision Foundation Models and Aligning for Generic ...

Paper page - Vision Foundation Models as Effective Visual Tokenizers ...

Repurposing Geometric Foundation Models for Multi-view Diffusion

Stateful Visual Encoders for Vision-Language Models | AI Research Paper ...

(PDF) Masked Autoencoders Are Effective Tokenizers for Diffusion Models
Advertisement Space (336x280)

Repurposing Geometric Foundation Models for Multi-view Diffusion

VFM-VAE: Vision Foundation Models Can Be Good Tokenizers for Latent ...
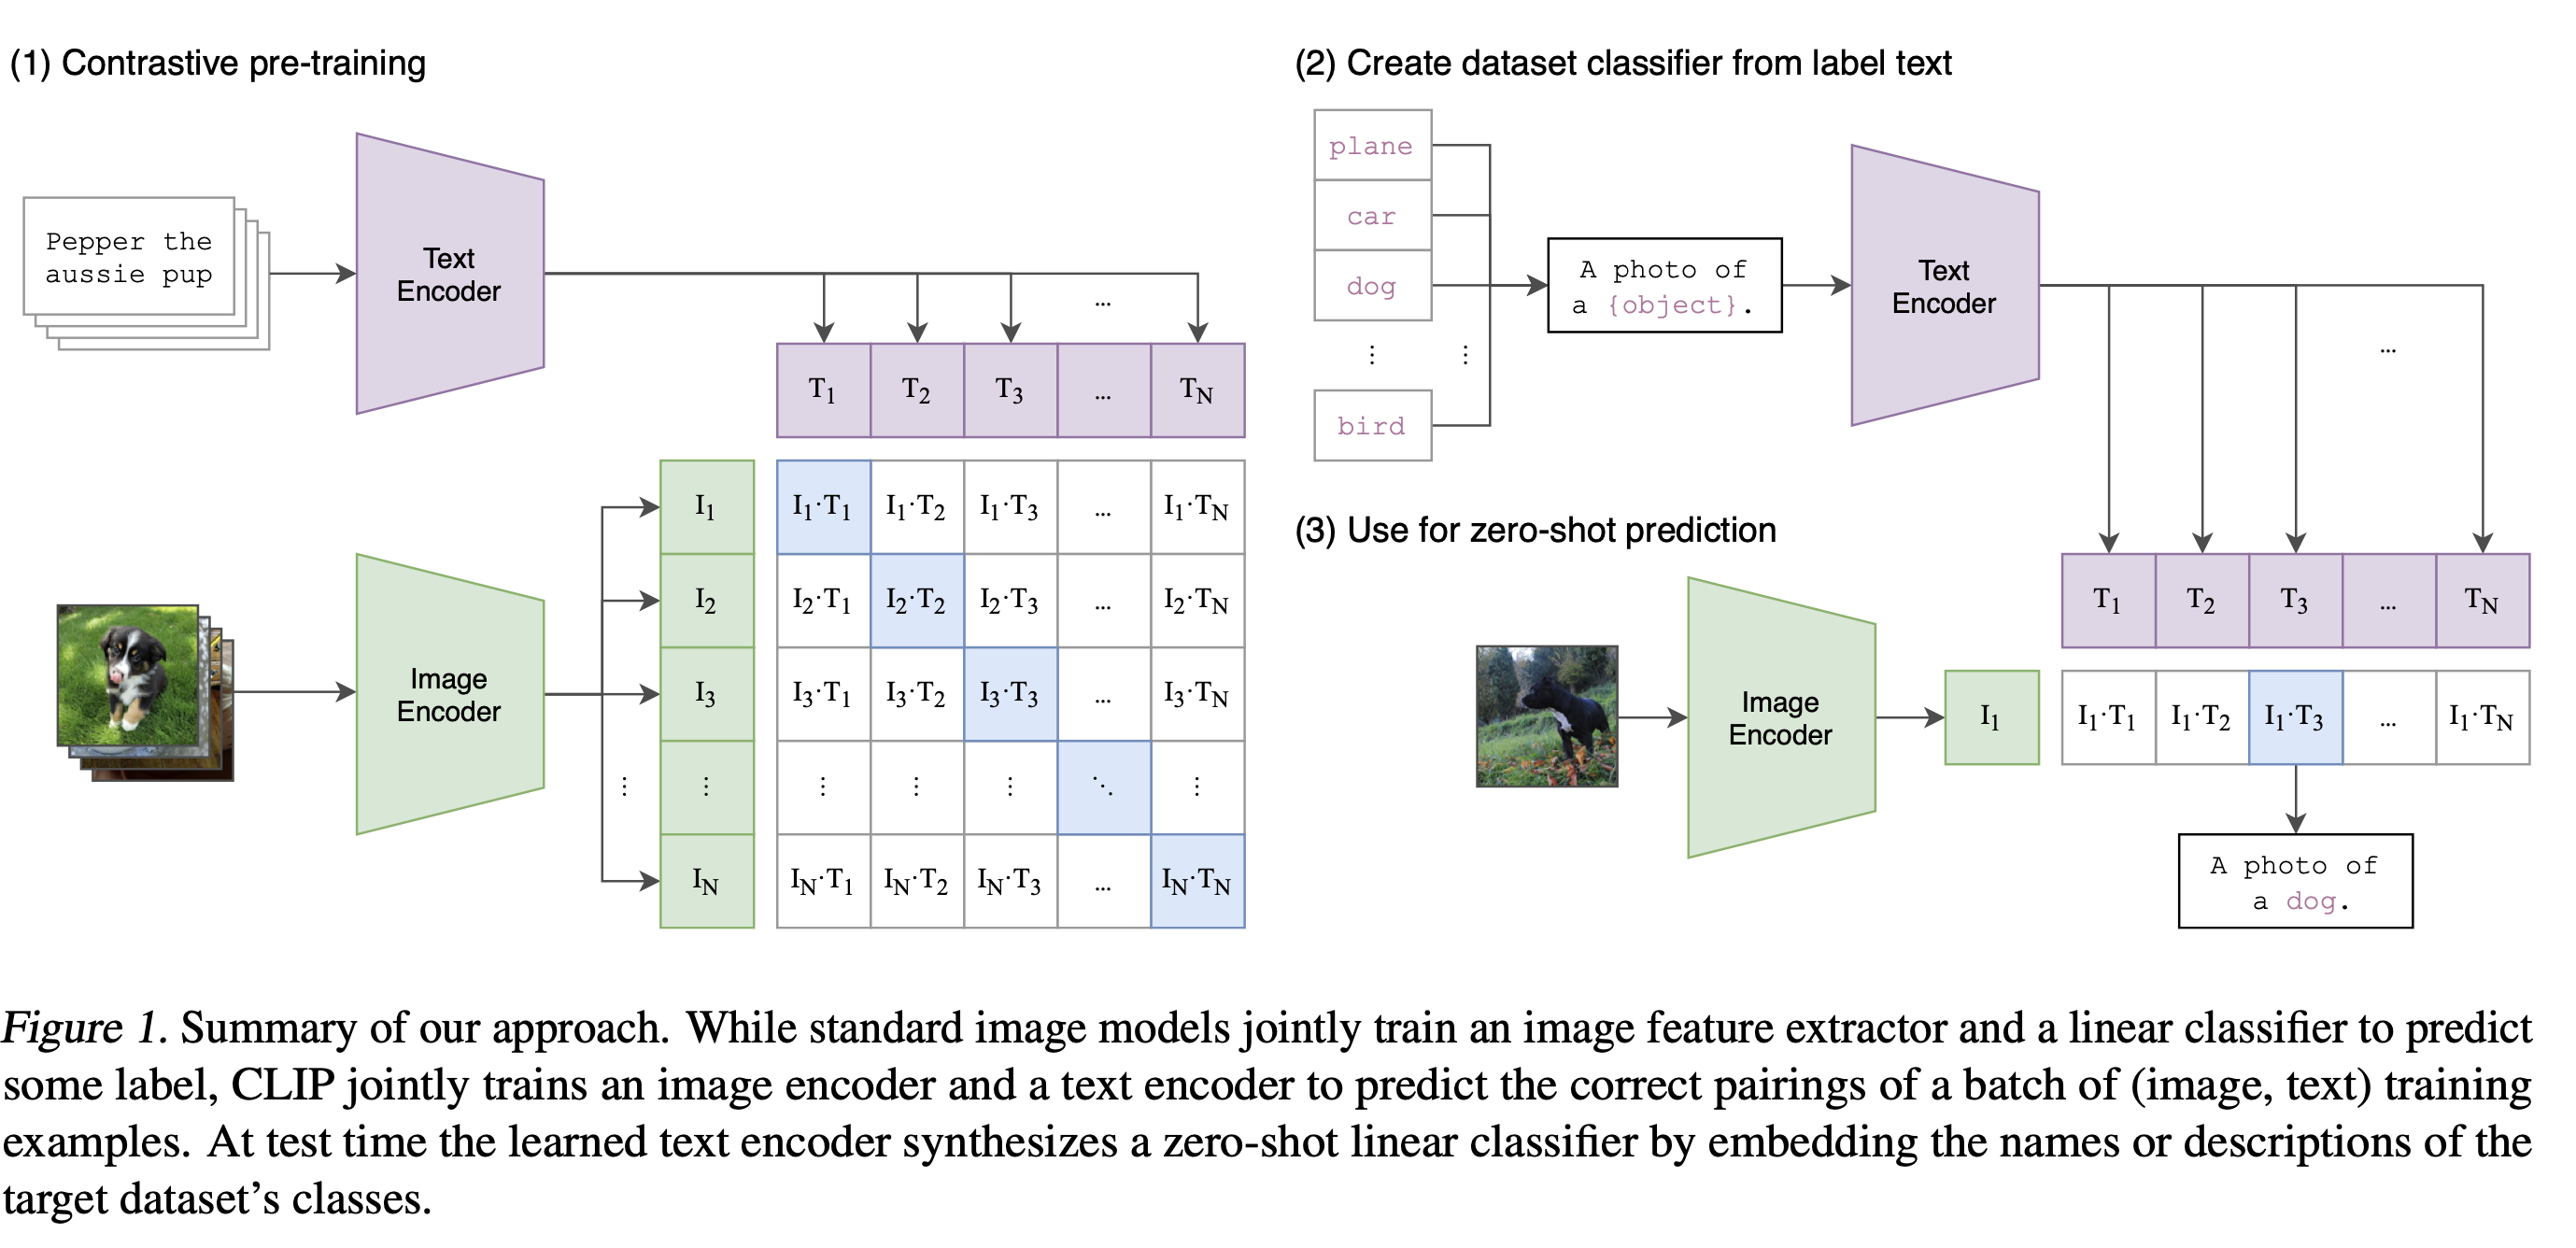
[CoCa] dual encoder for visual Foundation model

Lotus: A Diffusion-based Visual Foundation Model for Dense Geometry ...

Our arxiv paper "Lotus Diffusion-based Visual Foundation Model for High ...

Towards Scalable Pre-training of Visual Tokenizers for Generation | AI ...

Improving In-Context Learning in Diffusion Models with Visual Context ...

Figure 1 from Encoder-Decoder Diffusion Language Models for Efficient ...

Learnings from Scaling Visual Tokenizers for Reconstruction and ...

Towards Scalable Pre-training of Visual Tokenizers for Generation
Advertisement Space (336x280)

Training methodologies and ethical alignment of diffusion models for ...

Masked Autoencoders Are Effective Tokenizers for Diffusion Models——掩码自 ...

[Literature Review] Foundation Visual Encoders Are Secretly Few-Shot ...

Aligning Neuronal Coding of Dynamic Visual Scenes with Foundation ...
Visual Foundation Models (VFMs) Explained | Encord

Lotus: Diffusion-based Visual Foundation Model for High-quality Dense ...